

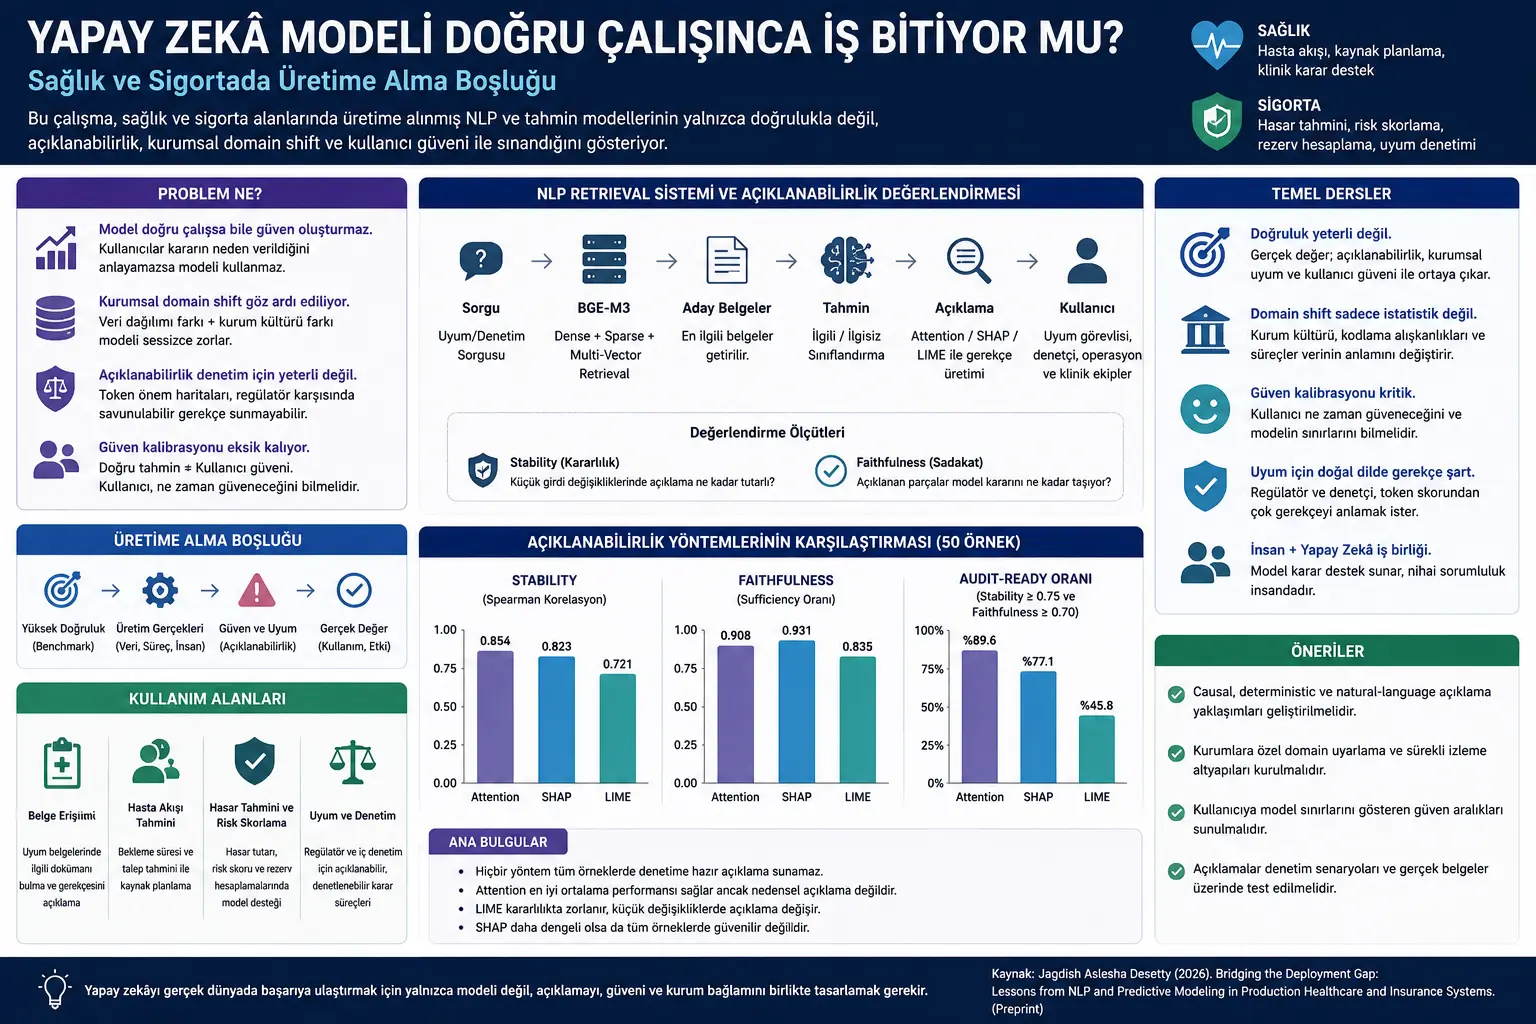
Maşın öyrənməsi modelləri benchmark testlərində yüksək nəticə göstərə bilər. Lakin bir modeli xəstəxana, sığorta şirkəti və ya tənzimləmə təzyiqi altındakı korporativ sistemlərdə işlətmək tamam başqa problemdir. Çünki real dünyada verilənlər dağınıqdır, istifadəçilər ehtiyatlıdır və qərarların hüquqi və əməliyyat nəticələri var.
Bu tədqiqat iki istehsal təcrübəsi üzərindən bu fərqi araşdırır. Birinci sistem böyük korporativ müştəri üçün hazırlanmış uyğunluğa həssas NLP əsaslı sənəd əldəetmə sistemidir. İkinci təcrübə isə səhiyyə və sığorta sahəsində 15 korporativ müştəriyə yayılan proqnoz modelləridir. Bu sistemlər texniki baxımdan uğursuz olmayıb; lakin izah edilə bilmə, qurumlararası verilənlər fərqləri və istifadəçi etimadı baxımından gözlənilməz maneələrlə qarşılaşıb.
Tədqiqatın əsas mesajı aydındır: Süni intellekt istehsal mühitində yalnız düzgün proqnoz verməli deyil. Eyni zamanda qərarını izah edə bilməli, müxtəlif qurumların verilən yaratma üsullarına uyğunlaşmalı və istifadəçilərə hansı vəziyyətdə modelə etibar edə biləcəklərini anlamağa imkan verən qərar mühiti təqdim etməlidir.
Problem Nədir?
Süni intellekt ədəbiyyatında istehsala keçid problemi çox vaxt verilənlər paylanmasının dəyişməsi, infrastruktur çatışmazlığı, kiçik təlim dəsti və ya model performansının azalması kimi texniki başlıqlarla izah edilir. Bunlar vacibdir; lakin bu tədqiqat başqa problemə diqqət çəkir: Model düzgün işləsə belə, insanların ondan istifadə etməsi üçün kifayət qədər əsas olmaya bilər.
Səhiyyə və sığorta sistemlərində modelin çıxışı yalnız texniki skor deyil. Pasiyentin gözləmə müddəti proqnozu resurs planlaşdırılmasına təsir edə bilər. Sığorta zərəri proqnozu ehtiyat hesablamasında istifadə oluna bilər. Sənəd əldəetmə sistemi uyğunluq auditində tənzimləyici qarşısında müdafiə edilməli nəticələr yarada bilər. Buna görə “model neçə faiz doğrudur?” sualı təkbaşına yetərsiz qalır.
Uyğunluq auditi kontekstində problem daha da kəskindir. Sənəd əldəetmə sistemi müəyyən sənədi 0,87 etibar skoru ilə əlaqəli hesab etdikdə bu skor uyğunluq mütəxəssisi üçün yetərli izah deyil. Uyğunluq mütəxəssisinin ehtiyacı budur: Bu sənəd hansı müddəa, hansı anlayış və ya hansı tənzimləyici əsas səbəbindən gətirilib? Eyni sorğu kiçik dəyişikliklə verildikdə eyni məntiqlə eyni nəticə izah edilə biləcəkmi?
Buna görə tədqiqatın mərkəzindəki problem “model uğursuzdurmu?” deyil. Daha çətin sual budur: Model düzgün nəticə yaratdıqda belə, bu nəticəni audit edilə bilən, institusional kontekstə uyğunlaşdırıla bilən və insan qərar proseslərinə etibarlı şəkildə yerləşdirilə bilən hala gətirə bilirikmi?
Metod Nə Təklif Edir?
Tədqiqat yeni alqoritm təklif etməkdən daha çox istehsal təcrübələrindən çıxan üç əsas problem sahəsini sistemli şəkildə sənədləşdirir. Birinci problem izah edilə bilmə boşluğudur. Model nəticə verə bilər; lakin bu nəticənin uyğunluq, audit və ya tənzimləmə kontekstində müdafiə edilə bilən izahını yarada bilməyə bilər.
İkinci problem institusional domain shift adlandırıla biləcək vəziyyətdir. Domain shift modelin təlim aldığı verilənlər paylanması ilə istehsalda qarşılaşdığı verilənlər paylanması arasındakı fərqdir. Lakin tədqiqatın vurğuladığı fərq yalnız statistik deyil. Səhiyyə və sığorta qurumları verilənləri fərqli şəkildə yaradır, kodlaşdırır, emal edir və şərh edir. Məsələn, ICD-10 diaqnoz kodlarının istifadə tezliyi yalnız pasiyent populyasiyasını deyil, qurumun sənədləşdirmə mədəniyyətini də əks etdirə bilər.
Üçüncü problem etimad kalibrasiyasıdır. Model düzgün proqnozlar yarada bilər; lakin praktiklər, klinisyenlər, aktuarilər və ya əməliyyat qrupları hansı vəziyyətdə bu proqnoza etibar etməli olduqlarını bilmirsə, model istifadə olunmaz. Etimad düzgünlükdən avtomatik yaranmır. İstifadəçi modelin hansı sərhədlər daxilində işlədiyini və öz ekspert qərarı ilə necə birlikdə istifadə olunacağını başa düşməlidir.
Tədqiqatın empirik hissəsi izah edilə bilmə problemini ölçmək üçün BGE-M3 əsaslı NLP modeli üzərində üç post-hoc izah üsulunu müqayisə edir: Attention, LIME və SHAP. Post-hoc izah model öyrədildikdən sonra modelin qərarını izah etməyə çalışan üsulları ifadə edir. Təcrübə MultiNLI verilənlər dəstinin government və slate növlərindən 50 nümunə istifadə olunaraq aparılır.
İzahlar iki meyar üzrə qiymətləndirilir: stability və faithfulness. Stability kiçik giriş dəyişikliklərində izahın nə qədər ardıcıl qaldığını ölçür. Faithfulness isə izahda vacib deyilən tokenların modelin qərarını həqiqətən daşıyıb-daşımadığını ölçür. Tədqiqat bu iki meyarı birləşdirərək audit-ready, yəni auditə hazır izah nisbətini hesablayır.
Formullar Nəyi İzah Edir?
Tədqiqatda izah keyfiyyətini ölçmək üçün iki əsas anlayışdan istifadə olunur: stability və faithfulness. Bunlar oxucuya sadə şəkildə belə izah edilə bilər.
Stability eyni və ya çox az dəyişdirilmiş girişlərdə izah skorlarının oxşar qalıb-qalmadığını ölçür. Tədqiqatda bu oxşarlıq token əhəmiyyət sıralamaları arasındakı Spearman korrelyasiyası ilə qiymətləndirilir.
Burada \(E_i\) və \(E_j\) eyni nümunənin kiçik dəyişikliklərə məruz qalmış müxtəlif versiyaları üçün yaradılan token əhəmiyyət skorlarını; \(\rho_{\text{Spearman}}\) isə sıralama oxşarlığını təmsil edir. İzah kiçik dəyişikliklərdə tamamilə dəyişirsə, audit kontekstində etibarlı sayılması çətinləşir.
Faithfulness izahın həqiqətən model qərarını daşıyan məlumatı tutub-tutmadığını ölçür. Tədqiqatda sufficiency yanaşmasından istifadə olunur: Yalnız ən vacib hesab edilən ilk 5 token saxlanıldıqda modelin orijinal qərar etimadı nə qədər qorunur?
Burada \(P_{\text{original}}(\hat{y})\) modelin tam mətnlə verdiyi proqnoz etimadını; \(P_{\text{top-5 tokens}}(\hat{y})\) isə yalnız izah üsulunun seçdiyi ən vacib tokenlar saxlanıldıqda modelin eyni proqnoza verdiyi etimadı göstərir. Nisbət yüksəkdirsə, izah üsulunun seçdiyi hissələr modelin qərarında həqiqətən təsirli ola bilər.
Tədqiqatın audit-ready meyarı iki həddin birlikdə təmin edilməsinə əsaslanır:
Yəni izahın auditə hazır sayılması üçün həm kiçik dəyişikliklərə qarşı kifayət qədər sabit olması, həm də model qərarını daşıyan məlumatı kifayət qədər yaxşı tutması lazımdır.
Tədqiqatın əsas istehsal dərsi də sadə şəkildə belə ümumiləşdirilə bilər:
Bu son iki ifadə tədqiqatda sözbəsöz tənlik kimi yer almır; məqalənin əsas ideyasını Verianla oxucusu üçün sadələşdirən redaksiya göstəriciləridir.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
Cədvəl və şəklin əsas mesajı mövcud izah üsullarının istehsal uyğunluğu tələbini tam qarşılamamasıdır. Attention üsulu ən yüksək audit-ready nisbətinə çatır: faiz 89,6. Bu ilk baxışda güclü görünür; lakin uyğunluq auditi baxımından hələ də təxminən hər 10 nümunədən 1-də izahın gözlənilən həddi qarşılamadığı deməkdir.
LIME üsulu xüsusilə stability tərəfində çətinlik çəkir. Orta stability dəyəri 0,721 olaraq bildirilir və 0,75 həddinin altında qalır. Bu, kiçik ifadə dəyişikliklərində token əhəmiyyət sıralamasının nəzərəçarpacaq şəkildə dəyişə bildiyini göstərir. Audit kontekstində eyni qərarın müxtəlif vaxtlarda fərqli izah edilməsi ciddi etibarlılıq problemidir.
SHAP daha balanslı görünür. Faithfulness dəyəri yüksəkdir və stability ortalaması LIME-dan daha yaxşıdır. Lakin tədqiqatın vurğuladığı məqam ortalamanın kifayət etməməsidir. Bəzi nümunələrdə izah audit həddinin altına düşürsə, istehsal mühitində bu vəziyyət yenə risk yaradır.
Şəkildə üç fərqli baxış birlikdə verilir: izah sabitliyi, izahın model qərarını daşıma gücü və iki meyarı eyni anda təmin edən nümunələrin nisbəti. Bu üçlü qiymətləndirmə vacibdir; çünki yalnız “izah yaxşı görünürmü?” sualı əvəzinə “eyni qalırmı, qərarı həqiqətən daşıyırmı və auditdə müdafiə edilə bilərmi?” sualları birlikdə verilir.
Tədqiqatın vizual nəticələri texniki izah edilə bilmə ilə auditə hazır izah edilə bilmə arasında fərq olduğunu göstərir. Bir üsul token əhəmiyyət xəritəsi verə bilər; lakin bu xəritə uyğunluq mütəxəssisinin tənzimləyici qarşısında istifadə edə biləcəyi təbii, ardıcıl və səbəbli əsaslandırmaya çevrilmirsə, real istehsal ehtiyacını qarşılamır.
Təcrübələr Necə Aparılıb?
Təcrübələrdə BGE-M3 adlı müasir retrieval embedding modelindən istifadə olunur. BGE-M3 dense retrieval, sparse retrieval və multi-vector retrieval xüsusiyyətlərini dəstəkləyən, uzun sənəd emalı qabiliyyətinə görə korporativ sənəd əldəetmə sistemlərinə uyğun model kimi nəzərdən keçirilir.
Tədqiqat real uyğunluq sənədləri əvəzinə ictimaiyyətə açıq MultiNLI verilənlər dəstinin government və slate növlərindən proxy kimi istifadə edir. Bu növlər rəsmi və ya strukturlaşdırılmış mətnlərə daha yaxın göründüyü üçün uyğunluq sənədi əldəetmə təcrübəsinə bənzədilir. Premise hissəsi sənəd, hypothesis hissəsi uyğunluq sorğusu kimi nəzərdən keçirilir. Entailment əlaqəsi uyğun sənəd, contradiction və ya neutral əlaqəsi isə uyğun olmayan sənəd kimi düşünülür.
Ümumilikdə 50 nümunə üzərində üç izah üsulu sınaqdan keçirilir. Attention üçün son transformer qatındakı diqqət çəkilərindən istifadə olunur. LIME yerli xətti izah yaratmaq üçün 75 perturbation nümunəsi ilə işlədilir. SHAP isə partition əsaslı Shapley dəyər təxmini ilə token əhəmiyyətlərini yaradır.
Stability təcrübəsində eyni girişi təkrar-təkrar işlətmək əvəzinə kiçik perturbationlar edilir. Bəzi sözlər silinir, nəzarətli sinonim dəyişiklikləri edilir və ya durğu işarələri azca dəyişdirilir. Beləliklə, izahın kiçik mətn dəyişiklikləri qarşısında nə qədər sabit qaldığı ölçülür.
Faithfulness təcrübəsində izah üsulunun ən vacib hesab etdiyi ilk 5 token saxlanılır və modelin orijinal proqnoz etimadının nə qədər qorunduğu ölçülür. Əgər model yalnız bu tokenlarla eyni qərara bənzər etimadla çata bilirsə, izah daha faithful hesab olunur.
Nəticələr Attention-ın faiz 89,6, SHAP-in faiz 77,1, LIME-ın isə faiz 45,8 audit-ready nisbətinə çatdığını göstərir. Lakin tədqiqatın şərhi aydındır: Ən yaxşı üsulun belə bütün nümunələrdə etibarlı uyğunluq izahı təmin edə bilməməsi istehsal sistemləri üçün ciddi tədqiqat boşluğuna işarə edir.
Nəticələr Nəyi Göstərir?
Birinci nəticə izah edilə bilmə probleminin yalnız texniki vizuallaşdırma problemi olmamasıdır. Uyğunluq kontekstində izah texniki komandanın anlayacağı token əhəmiyyət skorundan ibarət ola bilməz. Auditor və ya uyğunluq mütəxəssisi qərarın tənzimləyici əsasını təbii dildə və müdafiə edilə bilən şəkildə ifadə edə bilməlidir.
İkinci nəticə Attention-ın ölçülən meyarlarda ən yaxşı nəticəni verməsinə baxmayaraq təkbaşına yetərli olmamasıdır. Attention xəritəsi modelin hansı hissələrə fokuslandığını göstərə bilər; lakin bu, modelin niyə həmin qərarı verdiyini səbəbli şəkildə izah etmək demək deyil.
Üçüncü nəticə LIME-ın uyğunluq kontekstində ciddi stability problemi daşımasıdır. Kiçik mətn dəyişiklikləri izahı nəzərəçarpacaq şəkildə dəyişdirirsə, eyni qərarın müxtəlif sorğularda fərqli əsaslarla izah olunması riski yaranır. Bu vəziyyət hüquqi və ya uyğunluq auditinin olduğu sahələrdə qəbuledilməz ola bilər.
Dördüncü nəticə SHAP-in daha güclü, lakin hələ də kifayət qədər etibarlı olmamasıdır. Orta performansın yaxşı görünməsi hər nümunədə audit həddinin qarşılandığı demək deyil. İstehsal uyğunluğu orta uğurdan çox səhvsizliyə və ardıcıllığa yaxın gözlənti yaradır.
Beşinci nəticə domain shift probleminin qurum mədəniyyəti ilə əlaqəli ola bilməsidir. Səhiyyə və sığorta qurumlarında eyni verilən sahəsi fərqli mənalar daşıya bilər. Kodlaşdırma vərdişləri, zərərin qiymətləndirilməsi siyasətləri, sənədləşdirmə mədəniyyəti və əməliyyat prosesləri verilənlərin quruluşunu dəyişdirir. Bu fərqi yalnız statistik yenidən çəkiləndirmə ilə aradan qaldırmaq çətin ola bilər.
Altıncı nəticə düzgünlüyün etimadı avtomatik yaratmamasıdır. İstifadəçilər modelin nə zaman etibarlı olduğunu, hansı sərhədlərinin olduğunu və öz ekspert qərarları ilə necə birlikdə istifadə olunacağını anlamadıqda, düzgün proqnozlar belə istifadə edilməyə bilər.
Bu Niyə Vacibdir?
Bu tədqiqat süni intellektin real dünyaya keçidində adətən nəzərdən qaçan bir məqamı görünən edir: Modelin işləməsi sistemin faydalı olduğu demək deyil. Xüsusilə səhiyyə və sığorta kimi yüksək təsirli sahələrdə model çıxışının izah edilə bilən, audit edilə bilən, qurum kontekstinə uyğunlaşdırıla bilən və istifadəçi tərəfindən mənalandırıla bilən olması lazımdır.
Səhiyyədə yanlış və ya izah edilə bilməyən tövsiyə pasiyent axınına, resurs istifadəsinə və ya klinik qərara təsir edə bilər. Sığortada izah edilə bilməyən risk skoru müştəri münasibətlərini, zərər idarəetməsini və ya uyğunluq auditini çətinləşdirə bilər. Uyğunluq sistemlərində isə sənədi niyə gətirdiyini izah edə bilməyən retrieval modeli texniki baxımdan düzgün olsa belə, tənzimləyici qarşısında müdafiə edilə bilməz hala gələ bilər.
Tədqiqat eyni zamanda “izah edilə bilən süni intellekt” müzakirəsinin praktik tərəfini gücləndirir. İzah üsulu yalnız tədqiqat məqaləsində yaxşı görünən qrafik yaratmamalıdır. Real istifadəçiyə, real qərar anında, real qurum dilində mənalı əsas təqdim etməlidir.
Buna görə gələcək tədqiqatların yalnız daha yüksək benchmark skoru hədəfləməsi yetərli deyil. Causal, deterministic və natural-language explanation kimi ümumiləşdirilə biləcək üçlü ehtiyac önə çıxır: izah səbəbli əsasa malik olmalı, eyni girişə oxşar şərtlərdə ardıcıl davranmalı və texniki olmayan maraqlı tərəflərin istifadə edə biləcəyi təbii dildə təqdim edilməlidir.
Diqqət Edilməli Məqamlar
Birinci diqqət məqamı tədqiqatın preprint olmasıdır. Tapıntılar rəyçi qiymətləndirməsindən sonra dəyişə bilər. Buna görə nəticələr yekunlaşmış akademik standart kimi deyil, istehsal təcrübəsinə əsaslanan güclü tədqiqat çağırışı kimi oxunmalıdır.
İkinci diqqət məqamı təcrübə nümunəsinin məhdud olmasıdır. İzah edilə bilmə təcrübəsi 50 nümunə üzərində və MultiNLI verilənlər dəstinin müəyyən növləri ilə aparılıb. Bu verilənlər real uyğunluq sənədlərinin əvəzinə proxy kimi istifadə edilib. Real səhiyyə və ya sığorta uyğunluq sənədləri ilə daha geniş qiymətləndirmə aparılmalıdır.
Üçüncü diqqət məqamı təcrübənin downstream task accuracy əvəzinə izah keyfiyyətinə fokuslanmasıdır. İstifadə olunan təsnifat başlığı fine-tune edilməyib; məqsəd modelin əsas tapşırıq uğurunu deyil, izah üsullarının stability və faithfulness xüsusiyyətlərini sınaqdan keçirməkdir. Bu dizayn XAI qiymətləndirməsi baxımından mənalı olsa da, nəticələr birbaşa bütün istehsal performansına ümumiləşdirilməməlidir.
Dördüncü diqqət məqamı Attention nəticəsinin yanlış şərh edilməməsidir. Attention-ın yüksək audit-ready nisbəti attention çəkilərinin həqiqi səbəbli izah olduğu demək deyil. Tədqiqat bunu xüsusilə vurğulayır: Diqqət xəritəsi modelin fokuslandığı hissələri göstərə bilər, lakin qərarın əsasını tam izah etməyə bilər.
Beşinci diqqət məqamı səhiyyə və sığorta tətbiqlərində insan nəzarətinin məcburi olmasıdır. Bu tip sistemlər qərar dəstəyi aləti kimi nəzərdən keçirilməli; klinik, hüquqi, maliyyə və ya sığorta qərarlarında təkbaşına avtomatik hakimiyyətə çevrilməməlidir.
Nəticə
Bu tədqiqat süni intellekt sistemlərinin istehsala keçirilməsində kritik fərqi aydınlaşdırır: Modelin düzgün işləməsi yetərli deyil. Səhiyyə və sığorta kimi yüksək təsirli sahələrdə model eyni zamanda izah edilə bilən, audit edilə bilən, qurum kontekstinə uyğun və istifadəçi etimadını düzgün şəkildə kalibrə edə bilən olmalıdır.
Eksperimental nəticələr Attention, SHAP və LIME kimi geniş istifadə olunan post-hoc izah üsullarının mühüm məhdudiyyətlərə malik olduğunu göstərir. Attention ən yüksək audit-ready nisbətinə çatsa da, səbəbli izah təqdim etmir. SHAP daha balanslı görünsə də, bütün nümunələrdə etibarlı deyil. LIME isə xüsusilə stability baxımından uyğunluq auditi üçün zəif qalır.
Tədqiqatın istehsal təcrübələrindən çıxan daha geniş dərs də vacibdir. İnstitusional domain shift yalnız verilənlər paylanması fərqi deyil; qurumların verilənləri yaratma, kodlaşdırma və şərh etmə formasından doğan struktur fərqdir. İstifadəçi etimadı da yalnız düzgünlükdən yaranmır; istifadəçi modelin sərhədlərini və qərar prosesindəki yerini başa düşməlidir.
Verianla baxımından tədqiqatın əsas mesajı budur: Süni intellekti real dünyaya daşımaq yalnız modeli deploy etmək deyil. Həqiqi istehsal uğuru izah edilə bilmə, institusional kontekst, istifadəçi etimadı və audit edilə bilən qərar proseslərinin birlikdə dizayn edilməsini tələb edir.
Mənbə və Metod Qeydi
Bu məzmun Jagdish Aslesha Desetty tərəfindən hazırlanmış “Bridging the Deployment Gap: Lessons from NLP and Predictive Modeling in Production Healthcare and Insurance Systems” adlı preprint tədqiqata əsasən hazırlanıb. Tədqiqat səhiyyə və sığorta istehsal sistemlərində NLP əsaslı sənəd əldəetmə, proqnoz modelləri, izah edilə bilmə üsulları, institusional domain shift, istifadəçi etimadı və audit-readiness problemlərini nəzərdən keçirir.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla yayım xəttinə uyğun şəkildə sadələşdirilib və orijinal Azərbaycan dilli redaksiya məqaləsinə çevrilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib