

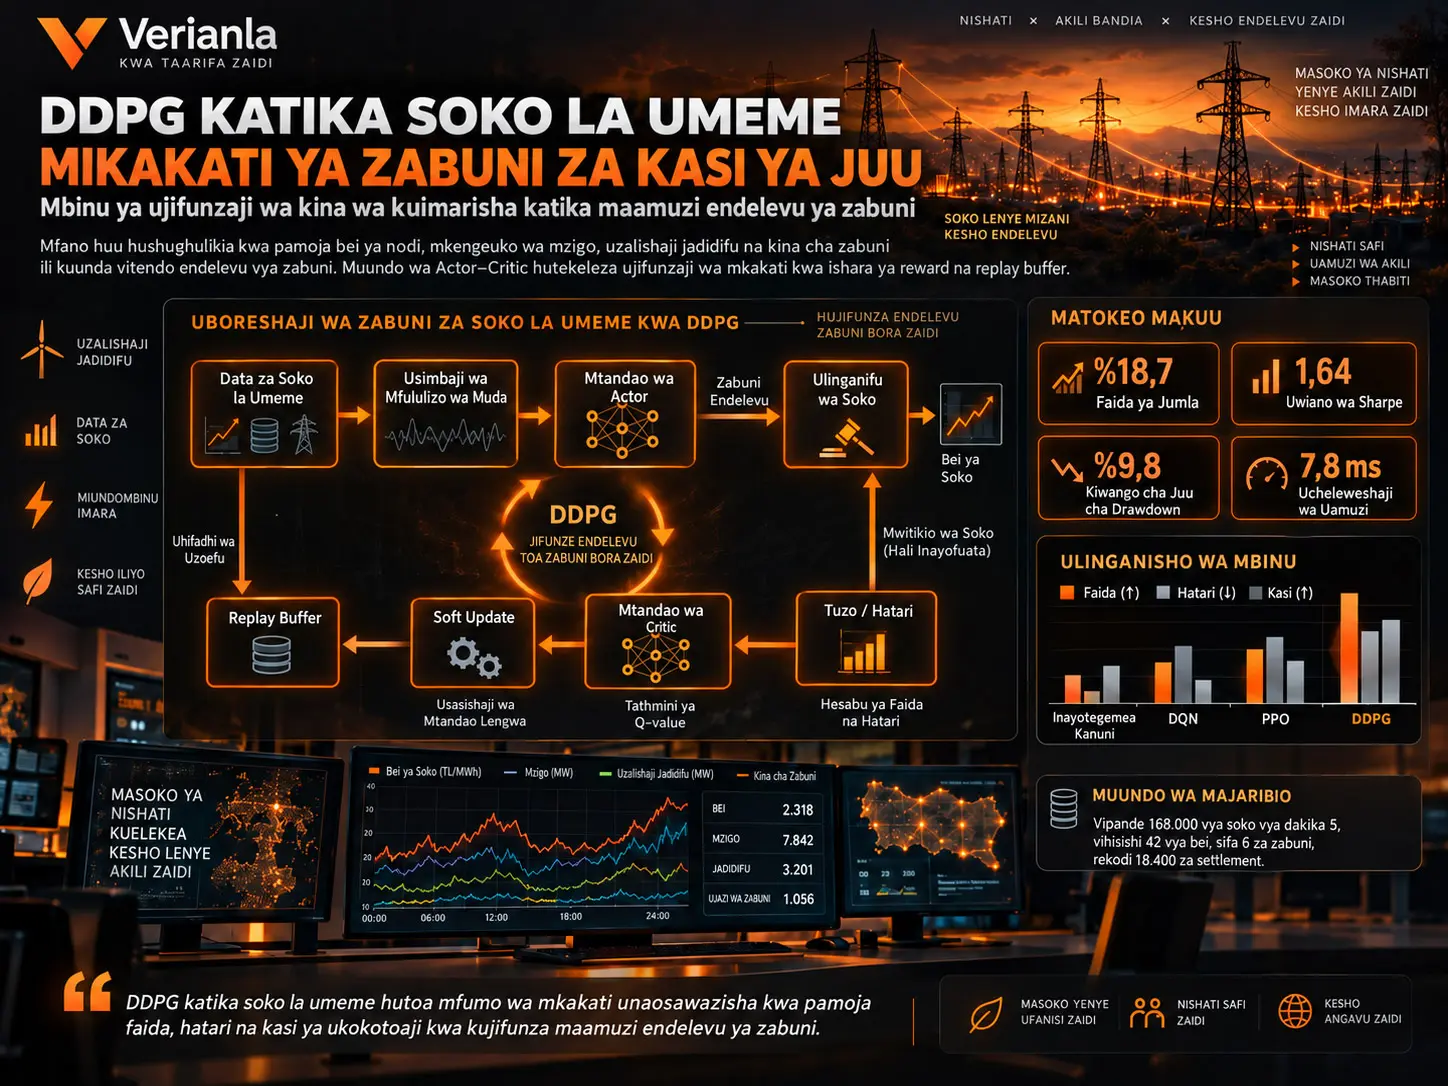
Katika masoko ya umeme, bei, mzigo, uzalishaji wa nishati jadidifu na kina cha biashara vinaweza kubadilika kwa pamoja katika vipindi vifupi vya muda. Utafiti huu unachunguza kama maamuzi endelevu kama bei ya zabuni na kiasi cha zabuni yanaweza kujifunzwa kwa kutumia Deep Deterministic Policy Gradient (DDPG) katika mazingira haya yenye vigezo vingi. Mfumo uliopendekezwa hubadilisha bei ya umeme ya ukingo wa nodi, mkengeuko wa mzigo, uzalishaji wa nishati jadidifu, kina cha zabuni na data ya nafasi halisi kuwa uwakilishi wa mfululizo wa muda; mtandao wa Actor huzalisha vitendo endelevu vya zabuni, huku mtandao wa Critic ukikadiria thamani inayotarajiwa ya vitendo hivyo. Mapato, mkengeuko wa execution, shinikizo la inventory na volatiliti ya bei hutathminiwa pamoja katika reward function moja.
Mazingira ya majaribio yana vipande 168.000 vya muda wa soko vya dakika 5, vigezo 42 vya bei, vipengele sita vya zabuni na rekodi 18.400 za settlement. Chanzo kinaripoti kwa DDPG mapato limbikizi ya %18,7, uwiano wa Sharpe wa 1,64, maximum drawdown ya %9,8 na wastani wa ucheleweshaji wa uamuzi wa 7,8 ms. Katika mazingira hayo hayo ya majaribio, DDPG inaripotiwa kupata mapato limbikizi na uwiano wa Sharpe ulio juu zaidi, pamoja na maximum drawdown ya chini zaidi kuliko DQN, PPO na mbinu za zabuni za rule-based.
Hata hivyo, dhana ya “masafa ya juu” katika utafiti huu inapaswa kutafsiriwa kwa uangalifu. Kwa kuwa hali za soko zinawakilishwa kwa vipande vya dakika 5, jaribio haliko katika kiwango sawa cha muda na HFT ya limit-order-book ya mikrosekunde inayotumika katika masoko ya hisa na kripto. Thamani ya 7,8 ms inaonyesha ucheleweshaji wa kukokotoa uamuzi wa modeli; kipindi cha sampuli za data ya soko ni dakika 5. Aidha, kwa kuwa chanzo cha data hakielezi wazi ni soko gani halisi la umeme linalohusika na hyperparameter nyingi muhimu za mafunzo hazijaripotiwa wazi, uwezo wa kuzalisha upya matokeo kwa kujitegemea ni mdogo.
Deep Deterministic Policy Gradient (DDPG) ni mbinu ya Actor–Critic ya ujifunzaji wa kuimarisha, model-free na off-policy, iliyoundwa kwa nafasi za vitendo endelevu. Actor huzalisha kitendo kinachopaswa kufanywa katika hali fulani ya soko; Critic hukadiria thamani inayotarajiwa ya jozi hiyo ya hali–kitendo. Experience replay na target networks zinazosasishwa polepole hutumiwa kuimarisha uthabiti wa mafunzo.
| Kipengele | Thamani iliyoripotiwa katika chanzo |
|---|---|
| Eneo la soko | Maamuzi endelevu ya zabuni katika soko la umeme |
| Mbinu kuu | Deep Deterministic Policy Gradient (DDPG) |
| Kipande cha muda wa soko | 168.000 vipande vya time slice vya dakika 5 |
| Vigezo vya bei | 42 |
| Vipengele vya zabuni | 6 |
| Rekodi ya settlement | 18.400 |
| Mbinu zilizolinganishwa | Rule-based, DQN, PPO, DDPG |
| Mapato limbikizi ya DDPG | %18,7 |
| Uwiano wa Sharpe wa DDPG | 1,64 |
| Maximum drawdown ya DDPG | %9,8 |
| Ucheleweshaji wa uamuzi wa DDPG | 7,8 ms |
Kwa nini uamuzi wa zabuni katika soko la umeme unachukuliwa kama tatizo la udhibiti endelevu?
Tatizo la kawaida la uainishaji hutoa chaguo bainifu kama “nunua”, “uza” au “subiri”. Katika utaratibu wa zabuni wa soko la umeme, uamuzi mara nyingi huwa changamano zaidi. Mfumo unapaswa kuamua bei ya zabuni na kiasi cha nishati kinachotolewa, huku pia ukitii mipaka ya uwezo, nafasi na hatari.
Kwa hiyo nafasi ya vitendo inaweza kujumuisha ukubwa endelevu kama:
- kiasi cha nguvu kinachotolewa,
- mkengeuko wa bei,
- marekebisho ya nafasi,
- kiwango cha kupunguza hatari
kama ukubwa endelevu.
Mbinu kama DQN kimsingi hutegemea uchaguzi wa vitendo bainifu. Ili kutumia nafasi endelevu ya zabuni kwa DQN, vitendo lazima vigawanywe katika vikasha fulani. Hili linaweza kupunguza azimio katika hali ambapo bei na kiasi vinapaswa kurekebishwa kwa wakati mmoja kwa kiwango cha kina.
Faida kuu ya DDPG ni kwamba mtandao wa Actor huzalisha moja kwa moja kitendo cha nambari kilicho endelevu.
Mzunguko wa jumla wa uendeshaji wa utafiti
Kielelezo 1 katika chanzo kinaonyesha mfumo katika sehemu kuu tano:
Ingizo la data → uundaji wa hali → pato la sera → mwingiliano wa soko → usasishaji wa vigezo.
Katika hatua ya kwanza, mfumo hupokea mitiririko ya soko kama:
- bei ya ukingo wa nodi,
- matokeo ya biashara,
- mkengeuko wa mzigo,
- uzalishaji wa nishati jadidifu
mitiririko hiyo ya soko huingia kwenye mfumo.
Baada ya shughuli za sliding window na normalization, data hubadilishwa kuwa state representation ya pamoja. Actor Network huzalisha bidding action endelevu kutokana na hali hiyo. Zabuni hutathminiwa katika moduli ya matching ya soko. Mapato na risk feedback yanayotokea hutumiwa na Critic, na uzoefu huandikwa kwenye replay buffer. Kisha vigezo vya Actor, Critic na target network husasishwa.
DDPG Hujifunzaje Zabuni za Soko la Umeme?
Msingi wa DDPG una mitandao miwili ya neva. Actor hubadilisha hali ya soko kuwa kitendo. Critic hujaribu kukokotoa thamani ya zabuni iliyozalishwa na Actor katika hali ya sasa ya soko.
Kazi ya Actor kwa muhtasari ni kujifunza ulinganifu:
\[ \text{piyasa durumu} \rightarrow \text{teklif fiyatı ve miktarı} \]
ndilo ulinganifu unaolengwa kujifunzwa.
Critic, kwa kutumia:
\[ Q(s,a) \]
hukadiria katika hali fulani \(s\) thamani ya muda mrefu inayotarajiwa ya kitendo \(a\) kilichotekelezwa.
Dirisha la muda
Modeli haitumii tu uchunguzi wa sasa wa soko. Huweka vipande \(L\) vya mwisho vya muda katika dirisha moja:
\[ S_t= \{x_{t-L+1},x_{t-L+2},\ldots,x_t\} \]
Hapa \(x_t\) inawakilisha uchunguzi wa sasa wa soko, na \(S_t\) inawakilisha state window ya kihistoria wakati wa uamuzi.
Lengo ni kujifunza mienendo ya bei ya muda mfupi, msongamano wa biashara na mabadiliko ya mzigo kutokana na muundo wa karibu wa kihistoria badala ya nukta moja pekee.
Makundi manne ya msingi ya vipengele
Utafiti hugawa maingizo katika makundi manne:
- Bei: bei za nodi na mkengeuko wa bei,
- Biashara: kiasi cha biashara, foleni ya zabuni na taarifa ya execution,
- Kizuizi: uwezo na mipaka ya zabuni,
- Volatiliti: vigezo vinavyowakilisha msukosuko wa soko.
Vigezo hivi tofauti hubadilishwa kuwa nafasi ya pamoja ya representation kwa:
\[ z_t= \sigma (W_p p_t+W_v v_t+W_c c_t+W_r r_t+b) \]
ndivyo vigezo hivyo hubadilishwa.
Hatua hii inalenga kupeleka taarifa za bei, biashara, vikwazo na volatiliti kwenye mtandao wa sera kwa ukubwa wa pamoja.
Uwekaji wa uzani kwa taarifa za kihistoria
Modeli haiunganishi vipengele pekee; pia huongeza trend ya kihistoria, feedback ya biashara na taarifa ya constraint ndani ya state:
\[ h_t= \sum_{i=0}^{L-1}\alpha_i z_{t-i} + \beta\Delta q_t + \gamma\Delta m_t + \eta(z_t\odot u_t) \]
Usemi huu huruhusu sehemu tofauti za historia ya karibu kupewa uzani tofauti na mabadiliko ya kiasi/bei kuingizwa katika hali ya uamuzi.
Kwa Nini Usimbaji wa Mfululizo wa Muda Unatumika?
Bei ya umeme, mkengeuko wa mzigo na uzalishaji wa nishati jadidifu vinaweza kuwa na maana kwa uamuzi si kwa thamani zake za sasa tu, bali pia kutokana na njia vilivyofuata katika vipande kadhaa vya muda.
Kwa hiyo utafiti wa chanzo huunda muundo wa temporal representation wa hatua nne:
- uchimbaji wa muundo wa muda wa ndani,
- attention aggregation,
- gated fusion,
- policy input mapping.
Utaratibu wa Attention
Haitegemewi kwamba kila kipande cha muda wa zamani kitakuwa muhimu kwa kiwango sawa kwa zabuni ya sasa. Katika chanzo, uzani wa attention huhesabiwa kama:
\[ \alpha_{t,j} = \frac {\exp(q_tk_j^{T}/\sqrt{d_k})} {\sum_m\exp(q_tk_m^{T}/\sqrt{d_k})} \]
ndivyo uzani huo unavyohesabiwa.
Kisha uwakilishi wa kihistoria:
\[ c_t= \sum_{j=t-L+1}^{t} \alpha_{t,j}e_j \]
huunganishwa ndani ya context vector moja.
Kwa njia hii, sehemu zenye maana zaidi kwa uamuzi, kama mruko wa bei au msongamano wa biashara katika historia ya karibu, zinalengwa kupewa uzani mkubwa zaidi.
Hatari na Mapato Huunganishwaje Katika Reward Function Moja?
Ikiwa algoriti ya ujifunzaji wa kuimarisha itafunzwa kuongeza faida pekee, inaweza kuzalisha zabuni zenye ukali kupita kiasi katika muda mfupi. Kwa hiyo reward function ya utafiti haipunguzi tu mapato ya biashara, bali pia mkengeuko wa execution, hatari ya inventory na volatiliti ya bei.
Katika chanzo reward imeundwa kama:
\[ r_t= m_t(\pi_t^{clr}-\pi_t^{bid}) -\lambda_1|a_t-m_t| -\lambda_2\max(0,|e_{t+1}|-\bar e) -\lambda_3 Var(\pi_{t-w:t}) \]
ndivyo reward function hiyo imeundwa.
Hapa sehemu ya kwanza ni kipengele cha mapato kinachotokana na tofauti kati ya kiasi cha biashara kilichotekelezwa na bei za clearing na bidding.
Vipengele vinavyofuata hutumia adhabu kwa mtiririko huu:
- mkengeuko wa execution / action,
- nafasi halisi inayozidi kikomo kinachoruhusiwa,
- variance ya juu ya bei
na hutumia adhabu kwa vipengele hivyo.
Kwa hivyo modeli hujaribu kujifunza si tu swali “ni kitendo gani kinatoa mapato mengi zaidi?”, bali pia “ninawezaje kupunguza hatari ya nafasi na volatiliti huku nikizalisha mapato?”
Usanifu wa Actor–Critic Unasasishwaje?
Uzalishaji wa zabuni endelevu
Mtandao wa Actor huzalisha kitendo endelevu kati ya mipaka fulani ya chini na juu:
\[ a_t= \Gamma(W_an_t+b_a) \]
na katika chanzo scaling function imetolewa kama:
\[ \Gamma(x)= l+ \frac{u-l}{2}(1+\tanh(x)) \]
ndivyo scaling function hiyo imetolewa.
Kwa njia hii, pato ghafi la mtandao wa neva linaweza kubadilishwa kuwa safu ya zabuni inayoruhusiwa na soko.
Makadirio ya thamani ya Critic
Critic hukadiria thamani ya hali ya sasa ya soko na zabuni iliyochaguliwa na Actor kwa:
\[ q_t=Q(y_t,a_t;\theta^Q) \]
ndivyo Critic hukadiria thamani hiyo.
Target network
Kwa kuwa market reward ya hatua moja inaweza kuwa na volatiliti ya juu, chanzo hutumia target Actor na target Critic:
\[ \hat q_t= r_t+ \gamma Q'(y_{t+1}, \mu'(y_{t+1});\theta^{Q'}) \]
Badala ya kubadilisha kabisa target networks kwa wakati mmoja na online networks, soft update hutumika:
\[ \theta^{Q'} \leftarrow \tau\theta^Q+(1-\tau)\theta^{Q'} \]
\[ \theta^{\mu'} \leftarrow \tau\theta^\mu+(1-\tau)\theta^{\mu'} \]
Mbinu hii inalenga kuzuia thamani lengwa kubadilika kwa kasi kupita kiasi wakati wa mafunzo.
Mbinu na Matokeo ya Utafiti
Muundo wa data ya majaribio
Katika chanzo, mkusanyiko wa data ya majaribio unaelezwa kuwa:
- vipande 168.000 vya muda wa soko vya dakika 5,
- vigezo 42 vya bei,
- 6 bidding feature,
- 18.400 settlement record
ndivyo mkusanyiko huo wa data unavyofafanuliwa.
State input inajumuisha node marginal price, mkengeuko wa mzigo wa wakati halisi, kina cha zabuni, uzalishaji wa nishati jadidifu na nafasi halisi.
Hata hivyo, chanzo hakielezi wazi mkusanyiko wa data umetoka katika soko gani halisi la umeme, eneo gani la kijiografia au kipindi gani kamili cha tarehe. Majaribio yanafanywa ndani ya “unified matching environment”.
DDPG ilitoa matokeo gani?
| Modeli | Mapato Limbikizi | Sharpe | Maximum Drawdown | Ucheleweshaji wa Uamuzi |
|---|---|---|---|---|
| Rule-based | %11,6 | 1,02 | %14,8 | 5,9 ms |
| DQN | %14,2 | 1,21 | %12,9 | 6,8 ms |
| PPO | %16,1 | 1,39 | %11,4 | 8,6 ms |
| DDPG | %18,7 | 1,64 | %9,8 | 7,8 ms |
Katika jaribio la chanzo, DDPG ina mapato limbikizi na uwiano wa Sharpe wa juu zaidi na pia maximum drawdown ya chini zaidi.
Mbinu ya rule-based hutoa uamuzi kwa kasi zaidi kwa 5,9 ms, lakini ina matokeo dhaifu zaidi kwenye vipimo vya utendaji na hatari. Ucheleweshaji wa 7,8 ms wa DDPG ni wa chini kuliko thamani ya 8,6 ms ya PPO, lakini wa juu kuliko DQN na mbinu ya rule-based.
Je, “7,8 ms” ina maana ya HFT halisi?
Thamani hii inaonyesha tu ucheleweshaji wa kukokotoa/inference wa modeli. Data ya market state katika utafiti imepangwa kwa vipande vya dakika 5.
Kwa hiyo:
Uchunguzi wa soko wa dakika 5 + 7,8 ms model inference
haupaswi kulinganishwa moja kwa moja na mifumo ya HFT ya dhamana inayofanya kazi kwa masasisho endelevu ya limit-order-book katika kiwango cha mikrosekunde.
Katika muktadha wa soko la umeme, utafiti huu unapaswa kusomwa kwa usahihi zaidi kama tatizo la bidding control la vipindi vifupi, lenye kasi na lenye vitendo endelevu.
Modeli ilijibu kwa nguvu zaidi katika hali gani za soko?
Kielelezo 5 cha chanzo kinaonyesha unit-time return heat map kulingana na mkengeuko wa bei na kina cha biashara kilichonormalishwa.
Eneo lenye mwitikio mkubwa:
- spread chanya: takriban %0,8–%1,6,
- normalize transaction depth: 0,55–0,72
limejikita katika safu hiyo.
Katika eneo hili, wastani wa mapato kwa kitengo cha muda unaripotiwa kuwa 0,041–0,048.
Katika seli ya kilele:
- return: 0,052,
- action intensity: 0,81
ndizo thamani zilizotolewa.
Kinyume chake, mkengeuko wa bei unaposhuka chini ya %0,3 au transaction depth chini ya 0,30, action output ya modeli hupungua kwa kiasi kinachoonekana.
Matokeo haya yanaonyesha kwamba sera iliyojifunza hutumia spread na kina cha soko pamoja badala ya kuzalisha zabuni ya juu kabisa katika hali zote za volatiliti.
Mapato ya kila wiki
Katika Kielelezo 6 cha chanzo, kwa DDPG katika wiki 12 za majaribio:
- median ya mapato ya kila wiki: 0,31,
- quartile ya chini: 0,27,
- quartile ya juu: 0,36,
- wiki ya chini zaidi: 0,18,
- wiki ya juu zaidi: 0,44
zimeripotiwa.
Mgawanyo wa DQN na PPO pia unaonekana kuwa chanya kwa kiasi kikubwa, huku katika mbinu ya rule-based ncha ya chini ikishuka chini ya sifuri.
Hata hivyo, kwa sababu kuna uchunguzi wa wiki 12 pekee na marudio ya random-seed hayajaripotiwa, matokeo haya ya boxplot hayapaswi kutafsiriwa kama uhakika wa kitakwimu au ubora uliothibitishwa katika vipindi tofauti vya soko.
Majaribio ya ablation yanaonyesha nini?
| Muundo wa Modeli | Mapato | Sharpe | Drawdown | Ucheleweshaji |
|---|---|---|---|---|
| Modeli kamili | %18,7 | 1,64 | %9,8 | 7,8 ms |
| Bila usimbaji wa mfululizo wa muda | %15,8 | 1,34 | %12,6 | 7,3 ms |
| Bila adhabu ya hatari | %17,2 | 1,22 | %13,7 | 7,7 ms |
| Bila target smoothing | %16,0 | 1,31 | %12,8 | 7,6 ms |
| Bila priority sampling | %16,4 | 1,36 | %12,1 | 7,5 ms |
Mfano mmoja ulio wazi zaidi wa matokeo ya ablation ni kipengele cha risk penalty. Adhabu ya hatari ikiondolewa, mapato hubaki juu kiasi kwa %17,2, lakini maximum drawdown huongezeka kutoka %9,8 hadi %13,7 na uwiano wa Sharpe hushuka kutoka 1,64 hadi 1,22.
Matokeo haya yanaunga mkono mtazamo kwamba katika muundo wa utafiti haitoshi kuongeza mapato ghafi pekee na kwamba marekebisho ya hatari ndani ya reward yanaathiri kwa kiasi kikubwa tabia ya mkakati.
Priority sampling
Badala ya replay sampling ya kawaida, chanzo kinafafanua uzani wa sampuli unaotumia upya wa muda, temporal-difference error na risk exposure:
\[ \omega_i= \frac{ (\nu_i+\kappa_1|\delta_i|+\kappa_2r_i^{risk})^\zeta }{ \sum_{j=1}^{N} (\nu_j+\kappa_1|\delta_j|+\kappa_2r_j^{risk})^\zeta } \]
Kwa njia hii, lengo ni kuhakikisha sampuli zenye volatiliti ya juu, prediction error kubwa au risk kubwa zinaendelea kuonekana zaidi katika batch za mafunzo.
Kizuizi cha mwendelezo wa kitendo
Utafiti huongeza regularization term ya ziada kwenye usasishaji wa Actor ili kuadhibu kuruka sana kati ya zabuni zinazofuatana:
\[ \|\mu(y_i)-\mu(y_{i-1})\|_2^2 \]
Lengo la sehemu hii ni kupunguza mabadiliko makali yasiyo ya lazima ya bei au kiasi cha zabuni kati ya maamuzi yanayofuatana wakati mfumo unatafuta ongezeko la mapato.
Je, Mapato ya Juu Zaidi ya DDPG Yanaweza Kutarajiwa Vivyo Hivyo Katika Soko Halisi?
Hapana. Utafiti unaripoti kwamba katika unified matching environment fulani, DDPG ilifanya vizuri kuliko mbinu nyingine tatu. Matokeo haya hayawezi kuhamishwa moja kwa moja kwa masoko yote halisi ya umeme au masoko yenye mifumo tofauti ya udhibiti.
Kuna sababu kadhaa:
- Chanzo mahususi cha soko na eneo la kijiografia la mkusanyiko wa data hakijaelezwa wazi.
- Masoko tofauti ya umeme yanaweza kuwa na sheria tofauti za zabuni, settlement na uwezo.
- Modeli ina muundo wa single-agent.
- Ubadilikaji wa kimkakati wa washiriki washindani wa soko haujaigwa kikamilifu.
- Chanzo chenyewe kinakubali kuwa muundo wa extreme-tail shock unapaswa kushughulikiwa kwa undani zaidi katika reward model.
- Cross-region na cross-market validation hazijafanywa.
- Marudio ya random-seed na confidence intervals hayajaripotiwa.
- Sehemu muhimu ya hyperparameter za msingi za mafunzo haijatolewa kwa thamani za nambari.
Dokezo kuhusu kauli ya “drawdown ya chini kwa %13,2”
Katika sehemu ya hitimisho, chanzo kinasema maximum drawdown imepungua kwa %13,2. Hata hivyo, katika Jedwali 4, thamani za maximum drawdown ni %14,8 kwa Rule-based, %12,9 kwa DQN, %11,4 kwa PPO na %9,8 kwa DDPG.
Kutokana na jedwali hili moja kwa moja:
- tofauti ya Rule-based → DDPG: pointi 5,0 za asilimia,
- tofauti ya DQN → DDPG: pointi 3,1 za asilimia,
- tofauti ya PPO → DDPG: pointi 1,6 za asilimia
zinakokotolewa.
Kwa kuwa chanzo hakielezi thamani ya %13,2 imekokotolewa dhidi ya msingi gani wa kulinganisha, Verianla hairudii uwiano huo kama matokeo huru ya utendaji.
Vipengele imara vya utafiti
- Kuunda tatizo la bidding katika soko la umeme kama nafasi ya vitendo endelevu.
- Kuunganisha vigezo vya bei, biashara, vizuizi na hatari katika muundo mmoja wa state.
- Kuunganisha Actor–Critic, replay buffer na target network na mazingira ya soko yenye mzunguko uliofungwa.
- Kuripoti drawdown na latency pamoja na mapato.
- Kutoa kwa pamoja ulinganisho wa DQN, PPO na rule-based.
- Kufanya jaribio la ablation kwa moduli nne muhimu.
Vikwazo vikuu vya kimetodolojia
- Market input inayofafanuliwa kama “HFT” kuwakilishwa kwa vipande vya muda vya dakika 5.
- Kutofafanuliwa vya kutosha soko na tarehe ambazo data ilitoka.
- Mgawanyo wa train/validation/test kutotolewa kwa undani.
- Vipimo vya tabaka za usanifu wa mtandao wa Actor na Critic kutoripotiwa.
- Kukosekana kwa thamani muhimu kama learning rate, discount factor, soft-update coefficient na uwezo wa replay-buffer.
- Muundo wa exploration noise kutofafanuliwa kwa undani.
- Mchakato wa hyperparameter tuning wa modeli za kulinganisha kutotolewa.
- Kutoripoti random seed nyingi na confidence interval.
- Mgawanyo wa majaribio wa wiki 12 kuwa mdogo kwa kuwakilisha tawala za muda mrefu za soko.
- Mbinu ya single-agent kuwakilisha kwa kiwango kidogo tabia ya kimkakati ya washindani.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Exploration of deep deterministic policy gradient algorithm in high-frequency trading strategy in power market
Mwandishi: Yunpeng Feng.
Taasisi: School of Automation Science and Engineering, South China University of Technology, Guangzhou, Guangdong, China.
Jarida: Ingegneria Sismica – International Journal of Earthquake Engineering.
Juzuu / toleo: Volume 43 / Issue 2; kwenye PDF Anno XLIII – Num. 2 – 2026.
Kurasa: 1–23.
Tarehe ya kuchapishwa: 30 Aprili 2026.
DOI: 10.65102/is2026549.
Leseni: Kwa mujibu wa sera rasmi ya copyright ya jarida, Creative Commons Attribution 4.0 International (CC BY 4.0).
Aina ya utafiti: Modeli ya bidding endelevu ya soko la umeme inayotegemea Deep reinforcement learning; jaribio linganishi na ablation analysis ndani ya unified matching environment.
Mbinu kuu: Deep Deterministic Policy Gradient; Actor–Critic; target networks; experience replay; priority sampling; temporal feature encoding; attention aggregation; gated feature fusion.
Ulinganisho mkuu: DQN, PPO na rule-based bidding.
Matokeo makuu: Katika jaribio la chanzo, DDPG ilionyesha mapato limbikizi ya %18,7, uwiano wa Sharpe wa 1,64, maximum drawdown ya %9,8 na wastani wa decision latency wa 7,8 ms.
Data: Vipande 168.000 vya market time slice vya dakika 5, vigezo 42 vya bei, bidding feature sita na 18.400 settlement record.
Onyo kuhusu asili ya data: Ingawa chanzo kinaeleza aina za data ya ingizo kwa undani, hakiripoti wazi jina la soko mahususi la umeme, eneo la kijiografia na kipindi kamili cha tarehe.
Onyo la istilahi ya HFT: Kwa kuwa state slices za dakika 5 zinatumika, dhana ya masafa ya juu katika utafiti huu haipaswi kusawazishwa moja kwa moja na ufafanuzi wa HFT wa limit-order-book wa mikrosekunde katika masoko ya dhamana.
Onyo la uzalishaji upya: Kwa kuwa hyperparameter nyingi za msingi, ukubwa wa mtandao, random seed na utaratibu wa kina wa kugawa data haujaripotiwa, uzalishaji upya wa kujitegemea ni mdogo.
Onyo la utendaji: Chanzo kina kauli “maximum back-off decreases by 13.2%”; hata hivyo Jedwali 4 haliungi mkono wazi thamani ya marejeo ya asilimia hii. Kwa hiyo maelezo ya Verianla yanatumia moja kwa moja thamani za jedwali.
Uwezo wa kujumlisha: Matokeo yamewekewa mipaka na unified matching environment na muundo wa data wa makala; hayapaswi kutafsiriwa kama utendaji wa biashara ya moja kwa moja katika soko halisi la umeme.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *