

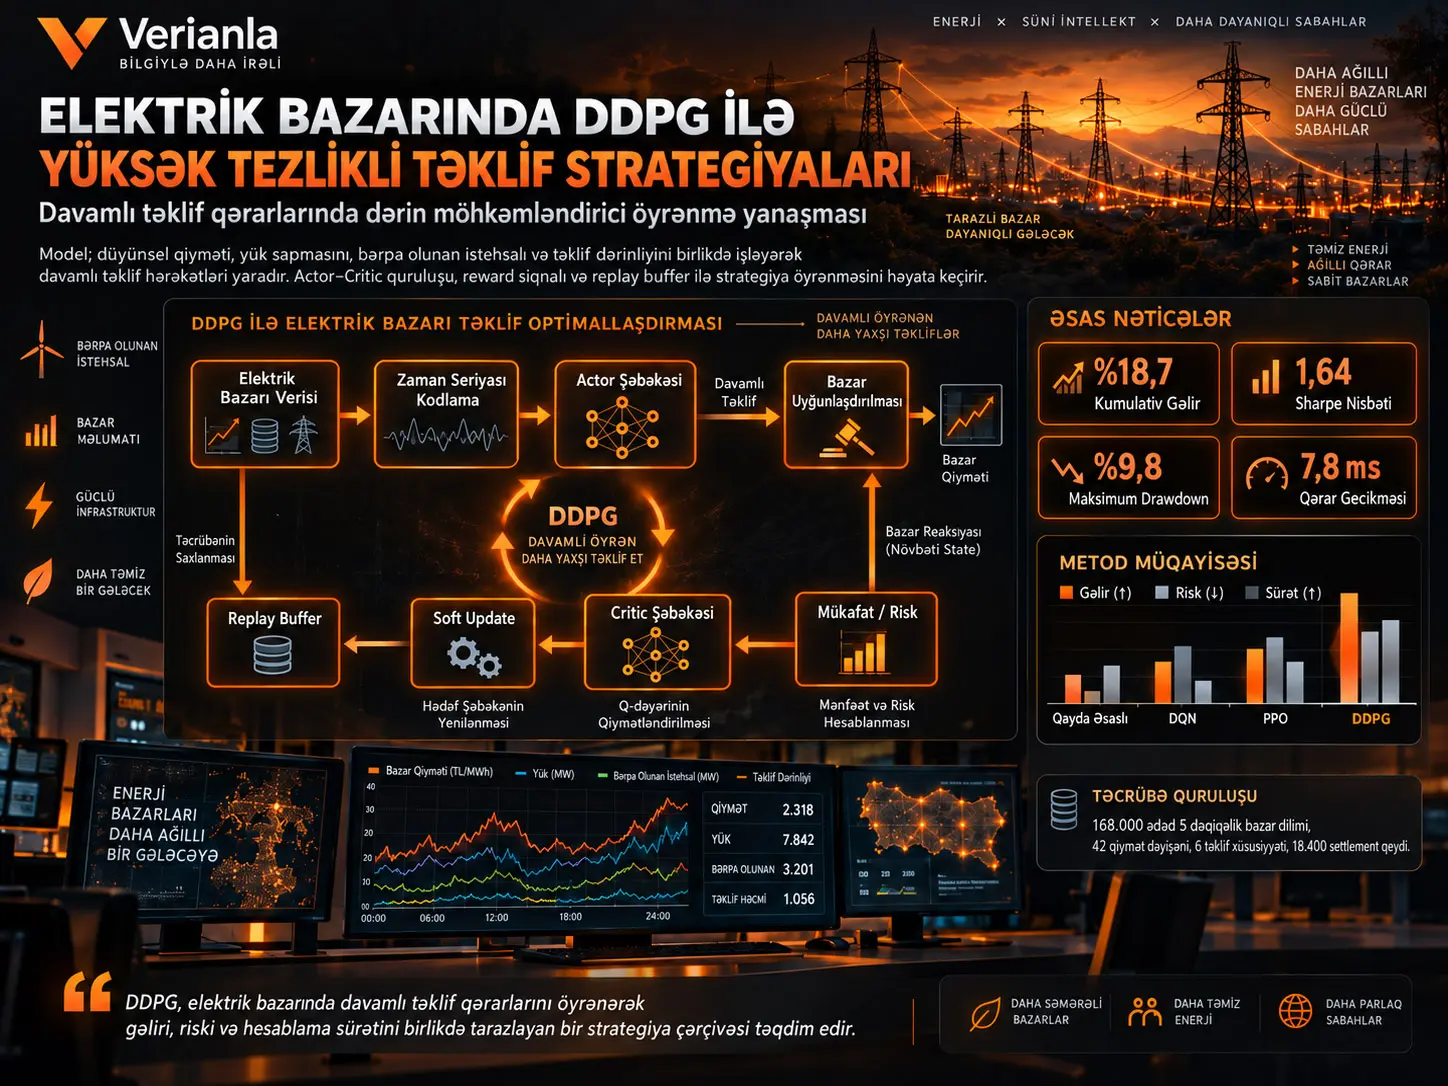
Elektrik bazarlarında qiymət, yük, bərpa olunan enerji istehsalı və əməliyyat dərinliyi qısa zaman intervallarında birlikdə dəyişə bilər. Bu tədqiqat bu çoxdəyişənli mühitdə təklif qiyməti və təklif miqdarı kimi davamlı qərarların Deep Deterministic Policy Gradient (DDPG) ilə öyrənilib-öyrənilə bilməyəcəyini araşdırır. Təklif olunan sistem düyün marjinal elektrik qiyməti, yük sapması, bərpa olunan istehsal, təklif dərinliyi və xalis mövqe məlumatlarını zaman sırası təsvirinə çevirir; Actor şəbəkəsi davamlı təklif hərəkətləri yaradır, Critic şəbəkəsi isə bu hərəkətlərin gözlənilən dəyərini qiymətləndirir. Gəlir, execution sapması, inventar təzyiqi və qiymət volatilliyi eyni reward funksiyasında birlikdə qiymətləndirilir.
Təcrübə mühiti 168.000 ədəd 5 dəqiqəlik bazar zaman dilimi, 42 qiymət dəyişəni, altı təklif xüsusiyyəti və 18.400 settlement qeydi ehtiva edir. Mənbədə DDPG üçün %18,7 kumulyativ gəlir, 1,64 Sharpe nisbəti, %9,8 maksimum drawdown və 7,8 ms orta qərar gecikməsi bildirilir. Eyni təcrübə mühitində DDPG-nin DQN, PPO və qayda əsaslı təklif üsullarından daha yüksək kumulyativ gəlir və Sharpe nisbəti, daha aşağı maksimum drawdown əldə etdiyi göstərilir.
Bununla belə, tədqiqatdakı “yüksək tezlik” anlayışı diqqətlə şərh edilməlidir. Bazar vəziyyətləri 5 dəqiqəlik dilimlərlə təmsil olunduğuna görə təcrübə səhm və kriptovalyuta bazarlarında istifadə olunan mikro-saniyə səviyyəli limit-əmr-kitabı HFT-si ilə eyni zaman miqyasında deyil. 7,8 ms dəyəri modelin qərar hesablama gecikməsini ifadə edir; bazar məlumatlarının nümunələmə intervalı isə 5 dəqiqədir. Bundan əlavə, məlumat mənbəyinin hansı real elektrik bazarına aid olduğu və bir çox kritik təlim hiperparametri açıq şəkildə bildirilmədiyindən nəticələrin müstəqil şəkildə yenidən istehsalı məhduddur.
Deep Deterministic Policy Gradient (DDPG), davamlı hərəkət fəzaları üçün hazırlanmış model-free, off-policy Actor–Critic möhkəmləndirici öyrənmə yanaşmasıdır. Actor müəyyən bazar vəziyyətində hansı hərəkətin ediləcəyini yaradır; Critic isə bu vəziyyət–hərəkət cütünün gözlənilən dəyərini qiymətləndirir. Experience replay və yavaş yenilənən target networks təlim sabitliyini dəstəkləmək üçün istifadə olunur.
| Element | Mənbədə bildirilən dəyər |
|---|---|
| Bazar sahəsi | Elektrik bazarında davamlı təklif qərarları |
| Əsas üsul | Deep Deterministic Policy Gradient (DDPG) |
| Bazar zaman dilimi | 168.000 ədəd 5 dəqiqəlik time slice |
| Qiymət dəyişənləri | 42 |
| Təklif xüsusiyyətləri | 6 |
| Settlement qeydi | 18.400 |
| Müqayisə edilən üsullar | Rule-based, DQN, PPO, DDPG |
| DDPG kumulyativ gəliri | %18,7 |
| DDPG Sharpe nisbəti | 1,64 |
| DDPG maksimum drawdown | %9,8 |
| DDPG qərar gecikməsi | 7,8 ms |
Elektrik bazarında təklif qərarı niyə davamlı idarəetmə problemi kimi nəzərdən keçirilir?
Klassik təsnifat problemi yalnız “al”, “sat” və ya “gözlə” kimi diskret seçimlər yaradır. Elektrik bazarının təklif mexanizmində isə qərar çox vaxt daha mürəkkəbdir. Sistem həm təklif qiymətini, həm də təklif edilən enerji miqdarını müəyyən etməli, eyni zamanda güc, mövqe və risk məhdudiyyətlərinə əməl etməlidir.
Buna görə hərəkət fəzası:
- təklif edilən güc miqdarı,
- qiymət sapması,
- mövqe tənzimlənməsi,
- riskin azaldılması səviyyəsi
kimi davamlı kəmiyyətlərdən ibarət ola bilər.
DQN kimi üsullar əsasən diskret hərəkət seçiminə söykənir. Davamlı təklif fəzasını DQN ilə istifadə etmək üçün hərəkətlərin müəyyən qutulara bölünməsi tələb olunur. Bu isə qiymət və miqdarın eyni anda incə miqyasda tənzimlənməli olduğu hallarda ayırdetməni azalda bilər.
DDPG-nin əsas üstünlüyü Actor şəbəkəsinin birbaşa davamlı ədədi hərəkət yaratmasıdır.
Tədqiqatın ümumi əməliyyat dövrü
Mənbənin Şəkil 1-də sistemi beş əsas bölmə şəklində göstərilir:
Məlumat girişi → vəziyyətin yaradılması → siyasət çıxışı → bazarla qarşılıqlı əlaqə → parametr yenilənməsi.
İlk mərhələdə sistemə:
- düyün marjinal qiyməti,
- əməliyyat nəticələri,
- yük sapması,
- bərpa olunan istehsal
kimi bazar axınları daxil olur.
Məlumatlar sliding window və normalization əməliyyatlarından sonra ortaq state representation-a çevrilir. Actor Network bu vəziyyətdən davamlı bidding action yaradır. Təklif bazarın matching modulunda qiymətləndirilir. Yaranan gəlir və risk feedback-i Critic tərəfindən istifadə olunur və təcrübə replay buffer-a yazılır. Daha sonra Actor, Critic və target network parametrləri yenilənir.
DDPG Elektrik Bazarı Təkliflərini Necə Öyrənir?
DDPG-nin əsasında iki sinir şəbəkəsi dayanır. Actor bazar vəziyyətini hərəkətə çevirir. Critic isə Actor tərəfindən yaradılan təklifin mövcud bazar şəraitində nə qədər dəyərli olduğunu hesablamağa çalışır.
Actor-un vəzifəsi təxminən:
\[ \text{piyasa durumu} \rightarrow \text{teklif fiyatı ve miktarı} \]
uyğunluğunu öyrənməkdir.
Critic isə:
\[ Q(s,a) \]
funksiyası ilə müəyyən \(s\) vəziyyətində yerinə yetirilən \(a\) hərəkətinin gözlənilən uzunmüddətli dəyərini təxmin edir.
Zaman pəncərəsi
Model yalnız mövcud bazar müşahidəsindən istifadə etmir. Son \(L\) zaman dilimini bir pəncərəyə yerləşdirir:
\[ S_t= \{x_{t-L+1},x_{t-L+2},\ldots,x_t\} \]
Burada \(x_t\) mövcud bazar müşahidəsini, \(S_t\) isə qərar anındakı tarixi state window-u təmsil edir.
Məqsəd qısamüddətli qiymət hərəkətləri, əməliyyat intensivliyi və yük dəyişikliklərinin yalnız tək nöqtədən deyil, yaxın keçmişdəki nümunəsindən öyrənilməsidir.
Dörd əsas xüsusiyyət qrupu
Tədqiqat girişləri dörd kateqoriyaya ayırır:
- Qiymət: düyün qiymətləri və qiymət sapmaları,
- Əməliyyat: əməliyyat həcmi, təklif növbəsi və execution məlumatı,
- Məhdudiyyət: güc və təklif limitləri,
- Volatillik: bazar dalğalanmasını təmsil edən dəyişənlər.
Bu heterogen dəyişənlər ortaq representation fəzasına:
\[ z_t= \sigma (W_p p_t+W_v v_t+W_c c_t+W_r r_t+b) \]
ilə çevrilir.
Bu əməliyyat qiymət, əməliyyat, məhdudiyyət və volatillik məlumatlarının siyasət şəbəkəsinə ortaq ölçüdə ötürülməsini hədəfləyir.
Tarixi məlumatın çəkiləndirilməsi
Model yalnız xüsusiyyətləri birləşdirmir; tarixi trendi, əməliyyat feedback-ini və constraint məlumatını da state-ə əlavə edir:
\[ h_t= \sum_{i=0}^{L-1}\alpha_i z_{t-i} + \beta\Delta q_t + \gamma\Delta m_t + \eta(z_t\odot u_t) \]
Bu ifadə yaxın keçmişin müxtəlif hissələrinə fərqli çəkilər verilməsinə və həcm/qiymət dəyişikliklərinin qərar vəziyyətinə daxil edilməsinə imkan yaradır.
Zaman Sırası Kodlaşdırması Niyə İstifadə Olunur?
Elektrik qiyməti, yük sapması və bərpa olunan istehsal yalnız mövcud dəyərləri ilə deyil, bir neçə zaman dilimi boyunca izlədikləri trayektoriya səbəbindən də qərar baxımından məna daşıya bilər.
Mənbə tədqiqat buna görə dörd mərhələli temporal representation quruluşu yaradır:
- yerli zaman nümunəsinin çıxarılması,
- attention aggregation,
- gated fusion,
- policy input mapping.
Attention mexanizmi
Keçmişdəki hər zaman diliminin mövcud təklif baxımından eyni dərəcədə əhəmiyyətli olması gözlənilmir. Mənbədə attention çəkisi:
\[ \alpha_{t,j} = \frac {\exp(q_tk_j^{T}/\sqrt{d_k})} {\sum_m\exp(q_tk_m^{T}/\sqrt{d_k})} \]
şəklində hesablanır.
Daha sonra keçmiş təsvirlər:
\[ c_t= \sum_{j=t-L+1}^{t} \alpha_{t,j}e_j \]
ilə vahid context vector daxilində birləşdirilir.
Beləliklə, yaxın keçmişdəki qiymət sıçrayışı və ya əməliyyat intensivliyi kimi qərar baxımından daha mənalı hissələrin daha yüksək çəki alması hədəflənir.
Risk və Gəlir Eyni Reward Funksiyasında Necə Birləşdirilir?
Möhkəmləndirici öyrənmə alqoritmi yalnız mənfəəti maksimumlaşdıracaq şəkildə öyrədilsə, qısa müddətdə həddindən artıq aqressiv təkliflər yarada bilər. Buna görə tədqiqatın reward funksiyası yalnız əməliyyat gəlirini deyil, execution sapmasını, inventory riskini və qiymət volatilliyini də cəzalandırır.
Mənbədə reward:
\[ r_t= m_t(\pi_t^{clr}-\pi_t^{bid}) -\lambda_1|a_t-m_t| -\lambda_2\max(0,|e_{t+1}|-\bar e) -\lambda_3 Var(\pi_{t-w:t}) \]
şəklində qurulmuşdur.
Burada birinci hissə həyata keçirilən əməliyyat həcmi ilə clearing və bidding qiyməti arasındakı fərqdən yaranan gəlir komponentidir.
Sonrakı terminlər müvafiq olaraq:
- execution / action sapması,
- icazə verilən həddi aşan xalis mövqe,
- yüksək qiymət dispersiyası
üçün cəza tətbiq edir.
Beləliklə, model yalnız “ən yüksək gəlir hansı hərəkətdədir?” sualını deyil, “gəlir əldə edərkən mövqe və volatillik riskini necə məhdudlaşdıra bilərəm?” sualını da öyrənməyə çalışır.
Actor–Critic Arxitekturası Necə Yenilənir?
Davamlı təklif istehsalı
Actor şəbəkəsi davamlı hərəkəti müəyyən aşağı və yuxarı sərhədlər arasında yaradır:
\[ a_t= \Gamma(W_an_t+b_a) \]
və mənbədə miqyaslama funksiyası:
\[ \Gamma(x)= l+ \frac{u-l}{2}(1+\tanh(x)) \]
şəklində verilir.
Beləliklə, sinir şəbəkəsinin xam çıxışı bazarın icazə verdiyi təklif intervalına çevrilə bilər.
Critic dəyər təxmini
Critic mövcud bazar vəziyyəti ilə Actor tərəfindən seçilən təklifin dəyərini:
\[ q_t=Q(y_t,a_t;\theta^Q) \]
ilə təxmin edir.
Target network
Bir addımlıq market reward yüksək volatilliyə malik ola bildiyindən mənbə target Actor və target Critic istifadə edir:
\[ \hat q_t= r_t+ \gamma Q'(y_{t+1}, \mu'(y_{t+1});\theta^{Q'}) \]
Target şəbəkələrin online şəbəkələrlə eyni anda tam dəyişdirilməsi əvəzinə soft update tətbiq olunur:
\[ \theta^{Q'} \leftarrow \tau\theta^Q+(1-\tau)\theta^{Q'} \]
\[ \theta^{\mu'} \leftarrow \tau\theta^\mu+(1-\tau)\theta^{\mu'} \]
Bu yanaşma hədəf dəyərlərin təlim zamanı həddən artıq sürətlə dəyişməsini məhdudlaşdırmağı hədəfləyir.
Tədqiqatın Metodu və Nəticələri
Təcrübə məlumat quruluşu
Mənbədə təcrübə məlumat dəsti:
- 168.000 ədəd 5 dəqiqəlik bazar zaman dilimi,
- 42 qiymət dəyişəni,
- 6 bidding feature,
- 18.400 settlement record
kimi təsvir edilir.
State input; node marginal price, real vaxt yük sapması, təklif dərinliyi, bərpa olunan istehsal və xalis mövqedən ibarətdir.
Lakin mənbədə məlumat dəstinin hansı real elektrik bazarından gəldiyi, coğrafi bölgəsi və əhatə etdiyi dəqiq tarix intervalı açıq şəkildə göstərilmir. Təcrübələr “unified matching environment” daxilində aparılır.
DDPG hansı nəticələri verdi?
| Model | Kumulyativ Gəlir | Sharpe | Maksimum Drawdown | Qərar Gecikməsi |
|---|---|---|---|---|
| Rule-based | %11,6 | 1,02 | %14,8 | 5,9 ms |
| DQN | %14,2 | 1,21 | %12,9 | 6,8 ms |
| PPO | %16,1 | 1,39 | %11,4 | 8,6 ms |
| DDPG | %18,7 | 1,64 | %9,8 | 7,8 ms |
Mənbə təcrübəsində DDPG ən yüksək kumulyativ gəlir və Sharpe nisbətinə, eyni zamanda ən aşağı maksimum drawdown-a malikdir.
Qayda əsaslı üsul 5,9 ms ilə ən sürətli qərarı yaratsa da, performans və risk ölçülərində daha zəif nəticə göstərir. DDPG-nin 7,8 ms gecikməsi PPO-nun 8,6 ms dəyərindən aşağı, DQN və rule-based üsullarından isə yüksəkdir.
“7,8 ms” real HFT deməkdirmi?
Bu dəyər yalnız modelin hesablama/inference gecikməsidir. Tədqiqatdakı market state məlumatları 5 dəqiqəlik dilimlərlə təşkil olunur.
Buna görə:
5 dəqiqəlik bazar müşahidəsi + 7,8 ms model inference
quruluşu mikro-saniyə səviyyəsində davamlı limit-order-book yenilənmələri ilə işləyən qiymətli kağız HFT sistemləri ilə birbaşa müqayisə edilməməlidir.
Elektrik bazarı kontekstində tədqiqat daha düzgün olaraq qısa zaman intervallı, sürətli və davamlı bidding control problemi kimi oxunmalıdır.
Model hansı bazar şəraitində daha güclü reaksiya verdi?
Mənbənin Şəkil 5-də qiymət sapması və normallaşdırılmış əməliyyat dərinliyinə görə unit-time return heat map göstərilir.
Yüksək reaksiya bölgəsi:
- müsbət spread: təxminən %0,8–%1,6,
- normalized transaction depth: 0,55–0,72
intervalında cəmlənir.
Bu bölgədə orta vahid-zaman gəliri 0,041–0,048 kimi bildirilir.
Pik hüceyrədə:
- return: 0,052,
- action intensity: 0,81
dəyərləri verilir.
Bunun əksinə olaraq qiymət sapması %0,3-dən və ya transaction depth 0,30-dan aşağı düşdükdə modelin action output-u nəzərəçarpacaq dərəcədə azalır.
Bu nəticə öyrənilmiş siyasətin bütün volatillik vəziyyətlərində maksimum təklif yaratmaq əvəzinə spread və bazar dərinliyindən birlikdə istifadə etdiyini göstərir.
Həftəlik gəlirlər
Mənbənin Şəkil 6-dakı 12 test həftəsində DDPG üçün:
- median həftəlik gəlir: 0,31,
- aşağı kvartil: 0,27,
- yuxarı kvartil: 0,36,
- ən aşağı həftə: 0,18,
- ən yüksək həftə: 0,44
kimi bildirilir.
DQN və PPO paylanmaları da əsasən müsbət görünür, rule-based üsulda isə aşağı uc sıfırın altına enir.
Bununla belə, yalnız 12 həftəlik müşahidə və bildirilməyən random-seed təkrarları səbəbindən bu boxplot nəticələri statistik qətiyyət və ya fərqli bazar dövrlərində zəmanətli üstünlük kimi şərh edilməməlidir.
Ablation təcrübələri nə göstərir?
| Model Quruluşu | Gəlir | Sharpe | Drawdown | Gecikmə |
|---|---|---|---|---|
| Tam model | %18,7 | 1,64 | %9,8 | 7,8 ms |
| Zaman sırası kodlaşdırması olmadan | %15,8 | 1,34 | %12,6 | 7,3 ms |
| Risk cəzası olmadan | %17,2 | 1,22 | %13,7 | 7,7 ms |
| Target smoothing olmadan | %16,0 | 1,31 | %12,8 | 7,6 ms |
| Priority sampling olmadan | %16,4 | 1,36 | %12,1 | 7,5 ms |
Ablation nəticələrinin ən aydın nümunələrindən biri risk penalty komponentidir. Risk cəzası çıxarıldıqda gəlir %17,2 ilə nisbətən yüksək qalır, lakin maksimum drawdown %9,8-dən %13,7-yə yüksəlir və Sharpe nisbəti 1,64-dən 1,22-yə enir.
Bu nəticə tədqiqat dizaynında yalnız xam gəliri maksimumlaşdırmağın kifayət etmədiyi və reward daxilindəki risk düzəlişinin strategiya davranışına əhəmiyyətli dərəcədə təsir etdiyi fikrini dəstəkləyir.
Priority sampling
Mənbə adi replay sampling əvəzinə zaman yeniliyi, temporal-difference error və risk exposure istifadə edən nümunələmə çəkisi müəyyən edir:
\[ \omega_i= \frac{ (\nu_i+\kappa_1|\delta_i|+\kappa_2r_i^{risk})^\zeta }{ \sum_{j=1}^{N} (\nu_j+\kappa_1|\delta_j|+\kappa_2r_j^{risk})^\zeta } \]
Beləliklə, yüksək volatillik, yüksək prediction error və ya yüksək risk daşıyan nümunələrin təlim batch-lərində daha görünən saxlanması hədəflənir.
Hərəkət davamlılığı məhdudiyyəti
Tədqiqat Actor yenilənməsinə ardıcıl təkliflər arasındakı böyük sıçrayışları cəzalandıran əlavə regularization termini daxil edir:
\[ \|\mu(y_i)-\mu(y_{i-1})\|_2^2 \]
Bu terminin məqsədi gəlir artımı axtarılarkən təklif qiyməti və ya miqdarının ardıcıl qərarlar arasında lazımsız şəkildə kəskin dəyişməsini azaltmaqdır.
DDPG-nin Daha Yüksək Gəliri Real Bazarda Eyni Şəkildə Gözlənilə bilərmi?
Xeyr. Tədqiqat müəyyən unified matching environment daxilində DDPG-nin digər üç üsuldan daha yaxşı performans verdiyini bildirir. Bu nəticə bütün real elektrik bazarlarına və ya fərqli tənzimləyici quruluşa malik bazarlara avtomatik olaraq ümumiləşdirilə bilməz.
Bunun bir neçə səbəbi var:
- Məlumat dəstinin konkret bazar və coğrafi mənbəyi açıq şəkildə müəyyən edilməyib.
- Fərqli elektrik bazarlarının təklif, settlement və güc qaydaları dəyişə bilər.
- Model single-agent quruluşundadır.
- Rəqib bazar iştirakçılarının strateji adaptasiyası tam modelləşdirilmir.
- Extreme-tail shock quruluşunun reward modelində daha ətraflı nəzərə alınmalı olduğunu mənbənin özü qəbul edir.
- Cross-region və cross-market doğrulama aparılmayıb.
- Random-seed təkrarları və confidence intervals bildirilməyib.
- Əsas təlim hiperparametrlərinin mühüm hissəsi ədədi olaraq göstərilmir.
“%13,2 daha aşağı drawdown” ifadəsi ilə bağlı qeyd
Mənbə mətnin nəticə bölməsində maksimum geri çəkilmənin %13,2 azaldığını bildirir. Lakin Cədvəl 4-də maksimum drawdown dəyərləri Rule-based üçün %14,8, DQN üçün %12,9, PPO üçün %11,4 və DDPG üçün %9,8-dir.
Bu cədvəldən birbaşa:
- Rule-based → DDPG fərqi: 5,0 faiz bəndi,
- DQN → DDPG fərqi: 3,1 faiz bəndi,
- PPO → DDPG fərqi: 1,6 faiz bəndi
hesablanır.
Mənbə %13,2 dəyərinin hansı müqayisə bazasına görə hesablandığını göstərmədiyinə görə Verianla bu nisbəti müstəqil performans nəticəsi kimi təkrar etmir.
Tədqiqatın güclü tərəfləri
- Elektrik bazarı bidding problemini davamlı hərəkət fəzası kimi modelləşdirməsi.
- Qiymət, əməliyyat, məhdudiyyət və risk dəyişənlərini eyni state quruluşunda birləşdirməsi.
- Actor–Critic, replay buffer və target network quruluşunu qapalı dövrə bazar mühiti ilə birləşdirməsi.
- Gəlirlə yanaşı drawdown və latency bildirməsi.
- DQN, PPO və rule-based müqayisələrinin birlikdə verilməsi.
- Dörd mühüm modul üçün ablation təcrübəsinin aparılması.
Əsas metodoloji məhdudiyyətlər
- “HFT” kimi müəyyən edilən market input-un 5 dəqiqəlik zaman dilimləri ilə təmsil olunması.
- Məlumatın hansı bazardan və tarixlərdən gəldiyinin kifayət qədər açıqlanmaması.
- Train/validation/test bölgüsünün ətraflı verilməməsi.
- Actor və Critic şəbəkə arxitekturasının qat ölçülərinin bildirilməməsi.
- Learning rate, discount factor, soft-update coefficient və replay-buffer tutumu kimi əsas dəyərlərin çatışmaması.
- Exploration noise quruluşunun ətraflı açıqlanmaması.
- Müqayisə modellərinin hyperparameter tuning prosesinin verilməməsi.
- Birdən çox random seed və confidence interval bildirilməməsi.
- 12 həftəlik test paylanmasının uzunmüddətli bazar rejimlərini təmsil etmək üçün məhdud olması.
- Single-agent yanaşmasının strateji rəqib davranışını məhdud təmsil etməsi.
Mənbə və Metod Qeydi
Özgün başlıq: Exploration of deep deterministic policy gradient algorithm in high-frequency trading strategy in power market
Müəllif: Yunpeng Feng.
Qurum: School of Automation Science and Engineering, South China University of Technology, Guangzhou, Guangdong, China.
Jurnal: Ingegneria Sismica – International Journal of Earthquake Engineering.
Cild / say: Volume 43 / Issue 2; PDF üzərində Anno XLIII – Num. 2 – 2026.
Səhifələr: 1–23.
Nəşr tarixi: 30 Aprel 2026.
DOI: 10.65102/is2026549.
Lisenziya: Jurnalın rəsmi copyright siyasətinə görə Creative Commons Attribution 4.0 International (CC BY 4.0).
Tədqiqat növü: Deep reinforcement learning əsaslı davamlı elektrik bazarı bidding modeli; unified matching environment daxilində müqayisəli təcrübə və ablation analizi.
Əsas üsul: Deep Deterministic Policy Gradient; Actor–Critic; target networks; experience replay; priority sampling; temporal feature encoding; attention aggregation; gated feature fusion.
Əsas müqayisələr: DQN, PPO və rule-based bidding.
Əsas nəticə: Mənbə təcrübəsində DDPG %18,7 kumulyativ gəlir, 1,64 Sharpe nisbəti, %9,8 maksimum drawdown və 7,8 ms orta decision latency göstərib.
Məlumat: 168.000 ədəd 5 dəqiqəlik market time slice, 42 qiymət dəyişəni, altı bidding feature və 18.400 settlement record.
Məlumat mənşəyi xəbərdarlığı: Mənbə məlumat giriş növlərini ətraflı açıqlasa da, konkret elektrik bazarının adını, coğrafi bölgəni və tam tarix intervalını açıq şəkildə bildirmir.
HFT terminologiyası xəbərdarlığı: 5 dəqiqəlik state dilimləri istifadə olunduğuna görə tədqiqatdakı yüksək tezlik anlayışı qiymətli kağız bazarlarındakı mikro-saniyə limit-order-book HFT tərifi ilə birbaşa eyniləşdirilməməlidir.
Reproduksiya xəbərdarlığı: Bir çox əsas hiperparametr, şəbəkə ölçüsü, random seed və ətraflı məlumat bölmə proseduru bildirilmədiyindən müstəqil reproduksiya məhduddur.
Performans xəbərdarlığı: Mənbədə “maximum back-off decreases by 13.2%” ifadəsi var; lakin Cədvəl 4 bu faizin istinad dəyərini açıq şəkildə dəstəkləmir. Buna görə Verianla izahında birbaşa cədvəl dəyərlərindən istifadə olunub.
Ümumiləşdirilə bilmə: Nəticələr məqalədəki unified matching environment və məlumat quruluşu ilə məhdudlaşır; real elektrik bazarında canlı əməliyyat performansı kimi şərh edilməməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib