

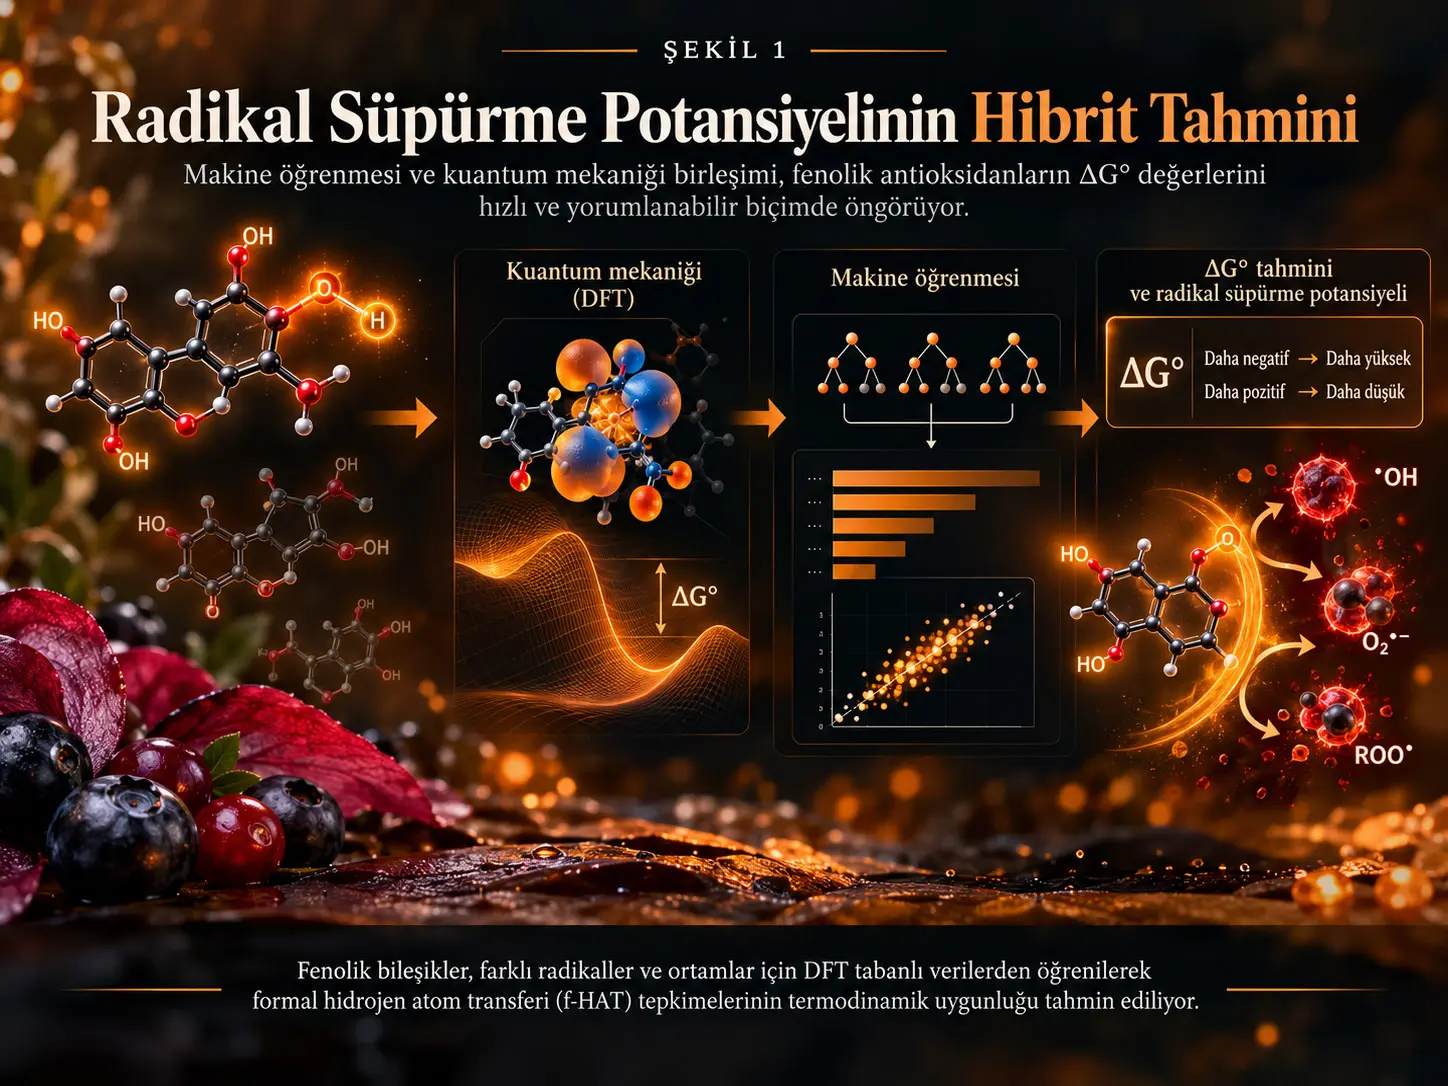
Bu çalışma, fenolik antioksidanların radikallerle gerçekleştirdiği formal hidrojen atom transferi reaksiyonlarının standart Gibbs serbest reaksiyon enerjisini, kuantum kimyasal hesaplamaların tamamını her yeni sistem için yeniden çalıştırmadan tahmin etmeyi amaçlamaktadır. Araştırmada kullanılan hibrit strateji, yoğunluk fonksiyoneli teorisiyle hesaplanmış ΔG° değerlerini kimyasal tanımlayıcılarla birleştirerek denetimli makine öğrenmesi modellerine girdi sağlayan hesaplamalı bir tarama yaklaşımıdır. Veri tabanı 71 molekül, 207 reaksiyon bölgesi, 10 radikal ve gaz fazı, su ile benzenden oluşan üç ortam için toplam 6210 ΔG° değerini kapsamaktadır. Test edilen modeller arasında Random Forest, yaklaşık 0.94 test R² değeri ve yaklaşık 2.7 kcal mol−1 MAE ile en güçlü mutlak hata performansını göstermiştir. Bununla birlikte başarı, incelenen kimyasal alanla sınırlıdır; fenolik anyonlar, seyrek yapısal motifler ve yeterince temsil edilmeyen reaksiyon bölgeleri model için belirgin hata kaynaklarıdır.
Araştırmanın temel bilimsel hedefi bir molekülün klinik veya biyolojik olarak “iyi bir antioksidan” olduğunu doğrudan belirlemek değildir. Tahmin edilen büyüklük, formal hidrojen atom transferinin termodinamik elverişliliğini temsil eden standart Gibbs serbest reaksiyon enerjisidir. Dolayısıyla çalışma, radikal süpürme davranışının belirli bir mekanizmasını ve termodinamik bileşenini hızla ön elemeden geçirebilecek hesaplamalı bir araç geliştirmektedir; kinetik, biyoyararlanım, metabolizma, toksisite ve gerçek biyolojik etkinlik bu modelin doğrudan çıktıları değildir.
Formal Hidrojen Atom Transferi (f-HAT) Nedir?
Formal hidrojen atom transferi, bir antioksidandan radikale bir proton ile bir elektronun toplamda bir hidrojen atomuna karşılık gelecek biçimde aktarılmasıyla radikalin indirgenmesini sağlayan radikal süpürme mekanizmalarından biridir. Çalışmada fenolik bileşiklerin radikal süpürme potansiyeli, bu reaksiyonun standart Gibbs serbest reaksiyon enerjisi üzerinden termodinamik olarak değerlendirilmiştir.
Kaynak çalışmada f-HAT reaksiyonu genel olarak aşağıdaki biçimde gösterilmektedir:
\[ H_nA + R^{\bullet} \rightarrow H_{n-1}A^{\bullet} + RH \]
Burada \(H_nA\) hidrojen bağışlayan antioksidanı, \(R^{\bullet}\) başlangıçtaki radikali, \(H_{n-1}A^{\bullet}\) hidrojen kaybından sonra oluşan antioksidan kökenli radikal ürünü ve \(RH\) indirgenmiş radikal partnerini ifade eder. Araştırmanın makine öğrenmesi hedefi, bu dönüşüm için hesaplanan standart Gibbs serbest reaksiyon enerjisi \( \Delta G^\circ \) değeridir.
\(\Delta G^\circ\), yalnız bir O–H veya C–H bağının ne kadar güçlü olduğunu değil, reaksiyonun başlangıç ve son durumlarının toplam termodinamik enerji farkını temsil eder. Bu nedenle çalışma, yalnız bağ ayrışma enerjisine dayanan bir sıralamanın ötesine geçerek belirli antioksidan, reaksiyon bölgesi, radikal ve ortam kombinasyonunun tümünü tahmin problemine dahil etmektedir.
Neden yalnız bağ ayrışma enerjisi yeterli görülmedi?
Bağ ayrışma enerjisi, hidrojen bağışlayan bağın gücü hakkında yararlı bilgi verir. Bununla birlikte tek başına radikal partnerini hesaba katmaz ve belirli bir reaksiyonun ekzergonik veya endergonik olup olmadığını doğrudan ayırmak için gerekli referans durumunu sağlayamaz. Ayrıca çözgen polaritesi değiştiğinde reaksiyon enerjisi de değişebilir. Çalışmanın ΔG° yaklaşımı bu nedenle molekülü, reaksiyon bölgesini, radikali ve ortamı aynı termodinamik problem içinde ele almaktadır.
Bu Çalışmada Makine Öğrenmesi Neden Kullanıldı?
Makine öğrenmesi, çok sayıda molekül, reaksiyon bölgesi, radikal ve ortam kombinasyonu için tekrarlanması gereken kuantum kimyasal ΔG° hesaplarının hesaplama yükünü azaltabilecek hızlı bir ön eleme modeli oluşturmak için kullanılmıştır. Modelin amacı kuantum mekaniğini ortadan kaldırmak değil, kuantum kimyasal verilerden öğrenerek hangi sistemlerin daha ayrıntılı hesaplamaya öncelik verilmesi gerektiğini belirlemeye yardımcı olmaktır.
Bir molekül için tek bir değer hesaplamak yerine her reaksiyon bölgesinin farklı radikallerle ve farklı ortamlarda değerlendirilmesi gerektiğinde kombinasyon sayısı hızla büyür. Araştırmacılar bu problemi önce güvenilir bir DFT veri tabanı oluşturarak, ardından bu veri tabanındaki kimyasal örüntüleri makine öğrenmesine aktararak ele almıştır.
- Fenolik bileşikler ve antosiyanidinler için reaksiyon bölgelerinin belirlenmesi.
- Her uygun reaksiyon bölgesi için farklı radikaller ve üç ortam altında DFT tabanlı ΔG° değerlerinin hesaplanması.
- Molekül ve radikaller için RDKit sayısal tanımlayıcılarının oluşturulması.
- Ortam, bölge, radikal ve yapısal sınıf gibi kategorik değişkenlerin one-hot kodlanması.
- Farklı regresyon algoritmalarının leave-one-molecule-out protokolüyle değerlendirilmesi.
- R², MAE ve RMSE ile tahmin doğruluğunun ölçülmesi.
- En uygun Random Forest modelinde özellik öneminin incelenmesi.
DFT veri tabanı nasıl oluşturuldu?
Veri tabanı antosiyanidinler ve daha basit fenolik bileşiklerden oluşan iki temel molekül grubunu içermektedir. Antosiyanidinlerde OH ve CH reaksiyon bölgeleri değerlendirilirken basit fenolik bileşiklerde çalışma f-HAT açısından daha reaktif kabul edilen OH bölgelerine odaklanmıştır. Basit fenollerde doymamış CH bölgelerinin radikal adükt oluşumu gibi farklı mekanizmalarla reaksiyona girebilmesi nedeniyle bu yollar çalışmanın kapsamı dışında bırakılmıştır.
Moleküler geometriler Gaussian16 kullanılarak M06-2X meta-hibrit yoğunluk fonksiyoneli ve 6-31G(d) baz setiyle optimize edilmiştir. En kararlı konformer, duruma göre CREST 3.0 ile veya aday yapıların kimyasal değerlendirmesiyle seçilmiştir. Termal düzeltmeler ve Gibbs serbest enerjileri için aynı teori düzeyinde analitik frekans hesapları yapılmış; istatistiksel mekanik değerlendirmeleri 298 K ve 1 atm koşullarında yürütülmüştür.
Daha sonra tek-nokta elektronik enerji hesapları M06-2X/6-311+G(d,p) düzeyinde gerçekleştirilmiştir. Gaz fazına ek olarak su polar ortamı, benzen ise apolar ortamı temsil etmiş; çözünme etkileri SMD sürekli çözgen modeliyle ele alınmıştır. Kaynağın kullandığı birleşik hesaplama düzeyi şu biçimde verilmektedir:
\[ \mathrm{(SMD)\!-\!M06\!-\!2X/6\!-\!311+G(d,p)//M06\!-\!2X/6\!-\!31G(d)} \]
Sonuçta 71 molekül üzerinde toplam 207 reaksiyon bölgesinin, 10 farklı radikal ve üç ortamla kombinasyonu 6210 standart Gibbs serbest reaksiyon enerjisi üretmiştir.
Makine öğrenmesi hangi bilgileri gördü?
Her molekül ve radikal için RDKit 2025.03.4 kullanılarak 106 sayısal kimyasal tanımlayıcı hesaplanmıştır. Bu tanımlayıcılar van der Waals yüzey alanı ile ilişkili özellikleri, elektronik özellikleri, yapısal bilgileri ve deneysel anlam taşıyan kategorileri kapsayan gruplara ayrılmıştır. Model yalnız molekülün genel kimyasal yapısını değil, reaksiyon bölgesini, radikal partnerini ve ortamı da öğrenebilmiştir.
Sayısal değişkenlerin yanında ortam, reaksiyon bölgesi, radikal, molekül grubu ve SMILES temelli yapısal sınıflandırmalar one-hot encoding ile kodlanmıştır. Tahmin amacı taşımayan kimlik alanları çıkarılmış, özellikler standartlaştırılmış ve dört regresyon yaklaşımı karşılaştırılmıştır: doğrusal regresyon, Random Forest, Gradient Boosting ve çok katmanlı algılayıcı regresyonu.
Uygulama Python 3.12.7 ve scikit-learn 1.7.2 üzerinde yürütülmüştür. Kaynak, aksi belirtilmeyen durumlarda scikit-learn varsayılan hiperparametrelerinin kullanıldığını ve hiperparametre optimizasyonunun yalnız en iyi performans gösteren model için yapıldığını bildirmektedir. Ana PDF, seçilen optimize edilmiş Random Forest'ın bütün nihai hiperparametrelerini tek tek listelememektedir; ayrıntılı optimizasyon sonuçları çevrimiçi ek materyal/depo tarafında sunulmuştur.
Leave-One-Molecule-Out Doğrulaması Neden Önemlidir?
Leave-one-molecule-out doğrulaması, test edilen molekülün bütün reaksiyon bölgelerini eğitim verisinden birlikte çıkararak modelin daha önce görmediği bir moleküle genelleme yeteneğini ölçmeye çalışır. Aynı molekülün farklı reaksiyon bölgelerinin eğitim ve test kümelerine aynı anda girdiği rastgele satır bölmesinden daha katı bir değerlendirmedir.
Her döngüde 71 molekülden biri tamamen test için ayrılmış, diğer 70 molekül üzerinde model eğitilmiş ve dışarıda bırakılan molekülün bütün kayıtları tahmin edilmiştir. Bu tasarım, belirli bir molekülün başka bölgelerinden öğrenilmiş çok yakın bilgilerin test skorunu yapay biçimde yükseltmesini azaltmaktadır.
Çalışmanın yaptığı kontrol deneyi bu farkı doğrudan göstermektedir. Aynı molekülün farklı satırlarının eğitim ve test tarafına düşmesine izin veren rastgele satır bölmesinde optimize edilmiş model \(R^2=0.9960\) ve MAE \(=0.84\) kcal mol−1 değerine ulaşmıştır. Buna karşılık molekülün tamamını dışarıda bırakan ana değerlendirme yaklaşık \(R^2=0.94\) ve MAE \(=2.74\) kcal mol−1 düzeyindedir. Daha yüksek rastgele-bölme skoru modelin gerçek genellemesinin daha iyi olduğunu değil, test probleminin çok daha kolay hale geldiğini göstermektedir.
Öğrenme eğrisi ne gösterdi?
Araştırmacılar, yüksek LOMO performansının küçük veri kümesinde aşırı uyumdan kaynaklanıp kaynaklanmadığını araştırmak için molekül sayısını değiştirerek ek öğrenme eğrileri oluşturmuştur. 20, 40, 60 ve 70 eğitim molekülü için havuzlanmış test R² değerleri sırasıyla 0.862, 0.917, 0.933 ve 0.943 olarak raporlanmıştır. Genel eğilim, eğitim molekülü sayısı arttıkça performansın yükseldiğini ve daha sonra yüksek performanslı bir bölgeye yaklaştığını göstermektedir.
Çalışmanın Yöntemi ve Bulguları
Performans metrikleri
Model performansı test R², ortalama mutlak hata (MAE), kök ortalama kare hata (RMSE) ve tahminlerin standart sapması gibi ölçülerle değerlendirilmiştir. MAE tek tek tahmin hatalarının mutlak büyüklüğünü ortalama olarak gösterirken RMSE büyük hataları karesel terim nedeniyle daha güçlü cezalandırır.
Kaynakta Denklem (2) aşağıdaki biçimde yayımlanmıştır:
\[ \mathrm{MAE}= \frac{\sum_{i=0}^{N}\left|\mathrm{prediction}(i)-\mathrm{computed}(i)\right|}{N} \]
Kaynakta Denklem (3) ise:
\[ \mathrm{RMSE}= \sqrt{ \frac{\sum_{i=1}^{N}\left(\mathrm{prediction}(i)-\mathrm{computed}(i)\right)^2}{N} } \]
Yayımlanmış denklemlerde MAE toplamının başlangıç indisi \(i=0\), RMSE toplamının başlangıç indisi \(i=1\) olarak görünmektedir. Verianla metni bu kaynak-içi gösterim farkını sessizce değiştirmemektedir. Her iki metriğin bilimsel işlevi, model tahminlerinin DFT ile hesaplanmış referans ΔG° değerlerinden ne kadar saptığını nicel olarak ölçmektir.
Regresyon algoritmalarının karşılaştırılması
| Model | Özellik kümesi | Test R² | MAE (kcal mol−1) | RMSE (kcal mol−1) |
|---|---|---|---|---|
| MLP | Tam özellik kümesi | 0.944 ± 0.002 | 3.57 ± 0.05 | 5.06 ± 0.08 |
| Gradient Boosting | Tam özellik kümesi | 0.923 ± 0.002 | 4.36 ± 0.05 | 5.93 ± 0.07 |
| Random Forest | Tam özellik kümesi | 0.944 ± 0.002 | 2.71 ± 0.05 | 5.1 ± 0.1 |
| Optimize edilmiş Random Forest | Yalnız one-hot kodlanmış sayısal olmayan özellikler | 0.933 ± 0.002 | 3.27 ± 0.05 | 5.50 ± 0.09 |
| Optimize edilmiş Random Forest | Tam özellik kümesi | 0.944 ± 0.002 | 2.74 ± 0.05 | 5.0 ± 0.1 |
Doğrusal regresyon, molekül sınıflarında negatif R² değerleri verdiği için sonraki karşılaştırmada elenmiştir. MLP, Gradient Boosting ve Random Forest benzer R² aralığında olmasına rağmen Random Forest mutlak hata bakımından daha iyi performans göstermiştir. Yazarlar bu nedenle Random Forest'ı hiperparametre optimizasyonunun odağı olarak seçmiştir.
Burada önemli bir ayrıntı vardır: optimize edilmiş tam özellikli modelin MAE değeri 2.74 kcal mol−1 iken optimizasyon öncesindeki tam özellikli Random Forest tablosunda 2.71 kcal mol−1 görülmektedir. Optimizasyon esas olarak RMSE'de küçük bir iyileşme sağlarken R² ve MAE benzer hata sınırları içinde kalmıştır. Dolayısıyla “optimizasyon her metriği belirgin biçimde iyileştirdi” şeklinde bir sonuç kaynak tarafından desteklenmez.
Random Forest Modelinin Yaklaşık 0.94 R² Değeri Nasıl Yorumlanmalıdır?
Yaklaşık 0.94 test R² değeri, modelin incelenen kimyasal alan içindeki leave-one-molecule-out değerlendirmelerinde DFT tarafından hesaplanan ΔG° değişiminin büyük bölümünü yakalayabildiğini gösterir; ancak bu değer modelin her yeni organik molekül ailesinde aynı doğrulukla çalışacağını kanıtlamaz. Kaynak özellikle LOMO katlarının aynı tanımlanmış kimyasal alan içinden geldiğini ve bu skorların alan dışındaki moleküller için iyimser bir üst sınır olarak görülmesi gerektiğini belirtmektedir.
Bu ayrım çalışmanın en önemli yorum sınırlarından biridir. Model yeni bir molekülü eğitim kümesinde birebir görmemiş olabilir; buna rağmen test molekülü veri tabanındaki fenolik ve antosiyanidin kimyasal alanına aittir. Tamamen farklı işlevsel gruplara, mekanizmalara veya molekül ailelerine geçildiğinde aynı hata düzeyinin korunacağı gösterilmemiştir.
Kimyasal sınıflara göre performans eşit değildir
Sayfa 7'deki sınıf bazlı R² analizi bu heterojenliği açık biçimde göstermektedir. Genel R² yaklaşık 0.944 iken flavonoidler yaklaşık 0.977, naftalenler yaklaşık 0.965 ve stilbenler yaklaşık 0.959 düzeyindedir. Fenoller ise yaklaşık 0.669 ile belirgin biçimde daha düşük performans göstermektedir. Naphthacene sınıfı da yaklaşık 0.800 ile görece düşük sonuç vermiştir.
Bu sonuç, yalnız örnek sayısının model başarısını açıklamadığını göstermektedir. Küçük fakat kimyasal açıdan daha homojen bazı sınıflar iyi tahmin edilirken, daha heterojen sınıflarda hata yüksek kalabilmektedir.
Fenolik anyonlar neden sorun oluşturdu?
Çalışmanın hata çözümlemesinde en önemli sorun alanlarından biri fenolik anyonlardır. Deprotonasyon sonrasında ortaya çıkan negatif yüklü oksijenler, reaktan ve radikal ürün yapılarında farklı intramoleküler hidrojen bağı düzenleri oluşturabilmektedir. Mevcut veri tabanı bu enerji çeşitliliğini yeterince temsil etmediğinde makine öğrenmesi modeli aynı kimyasal desenleri güvenilir biçimde öğrenememektedir.
Kaynakta fenoller sınıfı için hata özellikle yüksektir. Sayfa 8'deki sınıf hata grafiğinde fenoller yaklaşık 7.34 kcal mol−1 MAE ve 9.70 kcal mol−1 RMSE ile en problemli gruplardan biridir. Buna karşılık flavonoidler yaklaşık 1.37 kcal mol−1 MAE ve 2.87 kcal mol−1 RMSE göstermektedir.
Araştırmacılar anyonların rolünü sınamak için benzer veri tabanından bütün anyonik örnekleri çıkararak aynı makine öğrenmesi yaklaşımını yeniden uygulamıştır. Anyonların çıkarıldığı bu ek analizde optimize edilmemiş modelin MAE değeri 1.63 kcal mol−1'e düşmüştür. Bu bulgu, yüksek hatanın önemli bir bölümünün model mimarisinden çok mevcut veri temsilinin zor kimyasal durumları yeterince kapsamamasından kaynaklandığı yorumunu desteklemektedir.
Nadir reaksiyon bölgesi problemi
Kaynak ayrıca ARN olarak belirtilen belirli bir antosiyanidindeki O19 reaksiyon bölgesini özel bir hata örneği olarak inceler. Bu OH bölgesi diğer on bir antosiyanidinde benzer biçimde bulunmadığı için eğitim verisinde yeterince temsil edilmez. Modelin özellikle su ortamında bu bölgenin ΔG° değerini tahmin ederken daha yüksek hata göstermesi, nadir yerel kimyasal motiflerin veri güdümlü model için neden sorun oluşturabildiğine somut bir örnektir.
Model Tahminlerini En Fazla Hangi Kimyasal Özellikler Belirliyor?
Özellik önemi analizi, modelin yalnız genel moleküler şekilden öğrenmediğini; elektronik özellikler, reaksiyon bölgesi, molekül ailesi ve radikal partneri gibi kimyasal olarak yorumlanabilir bilgileri birlikte kullandığını göstermektedir. En güçlü tek özellik radikalin maksimum mutlak kısmi yüküdür; elektronik ve deneysel/site-grup özellikleri toplam önem içinde baskın rol oynamaktadır.
Özellikler türlerine göre gruplandığında elektronik ve deneysel özelliklerin toplam özellik öneminin yüzde 60'tan fazlasını oluşturduğu, yapısal ve VSA türü özelliklerin ise birlikte yaklaşık yüzde 30 düzeyinde katkı verdiği raporlanmaktadır. Reaksiyon bölgesiyle ilişkili deneysel tanımlayıcıların tek başına toplam önemin yaklaşık yüzde 20'sine katkı yaptığı belirtilmektedir.
| Özellik | Normalize küresel önem | Kimyasal anlamı |
|---|---|---|
| SMILES_RADICAL_MaxAbsPartialCharge | %19.46 | Radikal partnerinin maksimum mutlak kısmi yükü |
| GROUP_Phenols | %10.18 | Molekülün fenolik bileşik grubuna ait olduğunu belirten kategorik bilgi |
| SMILES_HallKierAlpha | %6.88 | Moleküler yapısal/topolojik özellikleri yansıtan Hall–Kier alfa tanımlayıcısı |
Radikalin maksimum mutlak kısmi yükünün yüksek önemi kimyasal olarak anlaşılabilirdir; radikal reaksiyonun iki doğrudan reaktanından biridir ve farklı radikaller ΔG° değerini sistematik biçimde değiştirebilir. Bununla birlikte yazarlar, radikal kimliğinin önemli olmasının tek başına belirli antioksidan molekülünün kendi süpürme kabiliyeti hakkında tam bir mekanistik açıklama sağlamadığını vurgulamaktadır.
Fenol grubu göstergesi ve Hall–Kier alfa gibi sonraki özellikler, modelin benzer moleküler ailelerdeki örüntülerden ve genel molekül topolojisinden yararlandığını düşündürmektedir. Bu durum aynı zamanda mevcut modelin neden mevcut veri tabanındaki fenolik kimyasal uzaydan çok uzak molekül ailelerinde garanti edilmiş bir performansa sahip olmadığını da açıklamaktadır.
Çalışmanın desteklediği sonuç
Çalışma, DFT ile oluşturulmuş tanımlı bir fenolik/antosiyanidin veri alanında RDKit tanımlayıcıları ve kategorik kimyasal bilgileri kullanan Random Forest modelinin f-HAT standart Gibbs serbest reaksiyon enerjilerini molekül dışarıda bırakmalı doğrulamada yaklaşık 0.94 R² ve yaklaşık 2.7 kcal mol−1 MAE düzeyinde tahmin edebildiğini desteklemektedir. Ayrıca kimyasal olarak yorumlanabilir elektronik, reaksiyon bölgesi, molekül grubu ve yapısal özelliklerin tahminlerde önemli rol oynadığı gösterilmektedir.
Çalışmanın desteklemediği sonuç
Bu sonuçlar herhangi bir organik molekülün antioksidan etkinliğinin aynı doğrulukla tahmin edilebildiğini göstermez. Çalışma, gerçek organizmada antioksidan etkinliği, klinik yarar, farmakokinetik özellik, toksisite veya tedavi başarısı ölçmemektedir. Model f-HAT mekanizmasının termodinamik enerjisini tahmin etmektedir; kinetik hız sabitlerini doğrudan öğrenmemekte ve diğer radikal süpürme mekanizmalarını bu hedef içinde modellememektedir.
Aynı şekilde 2.74 kcal mol−1 MAE'nin yazarların yaklaşık 2 kcal mol−1 olarak verdiği DFT kimyasal doğruluk referansına yakın olması, makine öğrenmesi modelinin DFT'nin bütün fiziksel içeriğini yeniden ürettiği anlamına gelmez. Model, belirli veri tabanındaki hesaplanmış DFT sonuçlarını yaklaşık olarak tahmin eden veri güdümlü bir vekil modeldir.
Bilimsel anlamı
Bu hibrit yaklaşımın esas değeri, pahalı kuantum kimyasal hesaplamaların yerine koşulsuz bir kestirme koymak değil, geniş aday havuzlarında hangi moleküllerin ve hangi reaksiyon bölgelerinin daha ayrıntılı DFT incelemesine öncelik verilebileceğini hızla değerlendirebilecek yorumlanabilir bir ön eleme katmanı oluşturmaktır.
Veri tabanı yeni kimyasal aileler, daha fazla nadir reaksiyon bölgesi ve özellikle mevcut modelin zorlandığı anyonik sistemlerle genişletildiğinde genellenebilirliğin yeniden sınanması gerekir. Çalışmanın kendi sonuçları, daha çeşitli veri eklemenin yalnız örnek sayısını artırmaktan daha önemli olabileceğini göstermektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: A Hybrid Machine Learning and Quantum Mechanical Strategy for Predicting Radical Scavenging Potential
Yazarlar: Davide Zeppilli, José Ferraz-Caetano, M. Natália D. S. Cordeiro ve Laura Orian. Davide Zeppilli ile José Ferraz-Caetano eş katkılı yazarlardır. M. Natália D. S. Cordeiro ve Laura Orian sorumlu yazarlardır.
Kurumlar: Dipartimento di Scienze Chimiche, Università di Padova, Padova, İtalya; LAQV-REQUIMTE, Department of Chemistry and Biochemistry, Faculty of Sciences, University of Porto, Porto, Portekiz.
Dergi: AI Chem.
Yayınevi: MDPI.
Bibliyografik kayıt: AI Chem. 2026, 1(2), 8.
DOI: 10.3390/aichem1020008
Tarih: Alınma 2 Şubat 2026; revizyon 19 Mart 2026; kabul 7 Mayıs 2026; yayımlanma 15 Mayıs 2026.
Kaynak türü ve hakemlik: Hakemli özgün araştırma makalesi; resmî yayıncı sürümü.
Lisans: Kaynak PDF makaleyi Creative Commons Attribution (CC BY) lisansı altında açık erişimli olarak tanımlamaktadır. Bu Verianla metni kaynak makalenin tam çevirisi veya yakın metinsel yeniden üretimi değildir; bilimsel olgular, yöntemler, sayılar ve sınırlılıklar bağımsız öğretici bir yapıda yeniden düzenlenmiştir.
Temel hesaplama protokolü: Geometri optimizasyonu M06-2X/6-31G(d); analitik frekans hesabı ve 298 K, 1 atm termokimyasal değerlendirme; tek-nokta hesapları M06-2X/6-311+G(d,p); su ve benzen için SMD çözünme modeli; gaz fazı referans ortamı.
Makine öğrenmesi altyapısı: RDKit 2025.03.4, Python 3.12.7 ve scikit-learn 1.7.2. Veri tabanı 71 molekül, 207 reaksiyon bölgesi, 10 radikal, üç ortam ve 6210 ΔG° kaydından oluşmaktadır. 106 RDKit sayısal tanımlayıcısı ve kategorik one-hot özellikler kullanılmıştır.
Değerlendirme: Ana model değerlendirmesi leave-one-molecule-out protokolüyle yapılmıştır. Rastgele satır bölmesi yalnız karşılaştırmalı kontrol olarak kullanılmış ve aynı molekülün eğitim ile test tarafına dağılmasının performansı belirgin biçimde yükselttiği gösterilmiştir.
Veri erişilebilirliği: Yazarlar çalışma bulgularını destekleyen veri kümelerinin, kodun ve eğitilmiş modellerin çevrimiçi GitHub deposunda ücretsiz erişilebilir olduğunu bildirmektedir. Repository içeriğinin lisans durumu ana makalenin CC BY lisansından bağımsız olarak değerlendirilmelidir.
Finansman: Çalışma Università di Padova ile Portekiz ulusal fonları üzerinden FCT/MECI tarafından, LAQV-REQUIMTE için UID/50006/2025 projesi kapsamında desteklenmiştir. Ayrıca hesaplama kaynakları için CINECA desteği ve José Ferraz-Caetano'nun doktora bursu kaynakta ayrıca belirtilmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiş ve finansman sağlayıcıların araştırmanın tasarımı, veri analizi, yorumlanması, yazımı veya yayımlama kararında rolü olmadığını belirtmiştir.
Temel yöntemsel sınırlılık: Modelin değerlendirme molekülleri eğitimde görülmemiş olsa bile aynı genel kimyasal alanın içindedir. Fenolik anyonlar, nadir reaksiyon bölgeleri ve heterojen molekül sınıfları belirgin hata kaynaklarıdır. Bu nedenle bildirilen LOMO performansı, mevcut fenolik/antosiyanidin kimyasal alanı dışındaki moleküller için doğrulanmış genel bir başarı değeri değildir.
Bilimsel yorum sınırı: Araştırma hesaplamalı termodinamik ve makine öğrenmesi çalışmasıdır. Sonuçlar gerçek biyolojik antioksidan etkinliğinin, klinik etkinliğin veya terapötik güvenliğin doğrudan kanıtı olarak yorumlanmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir