

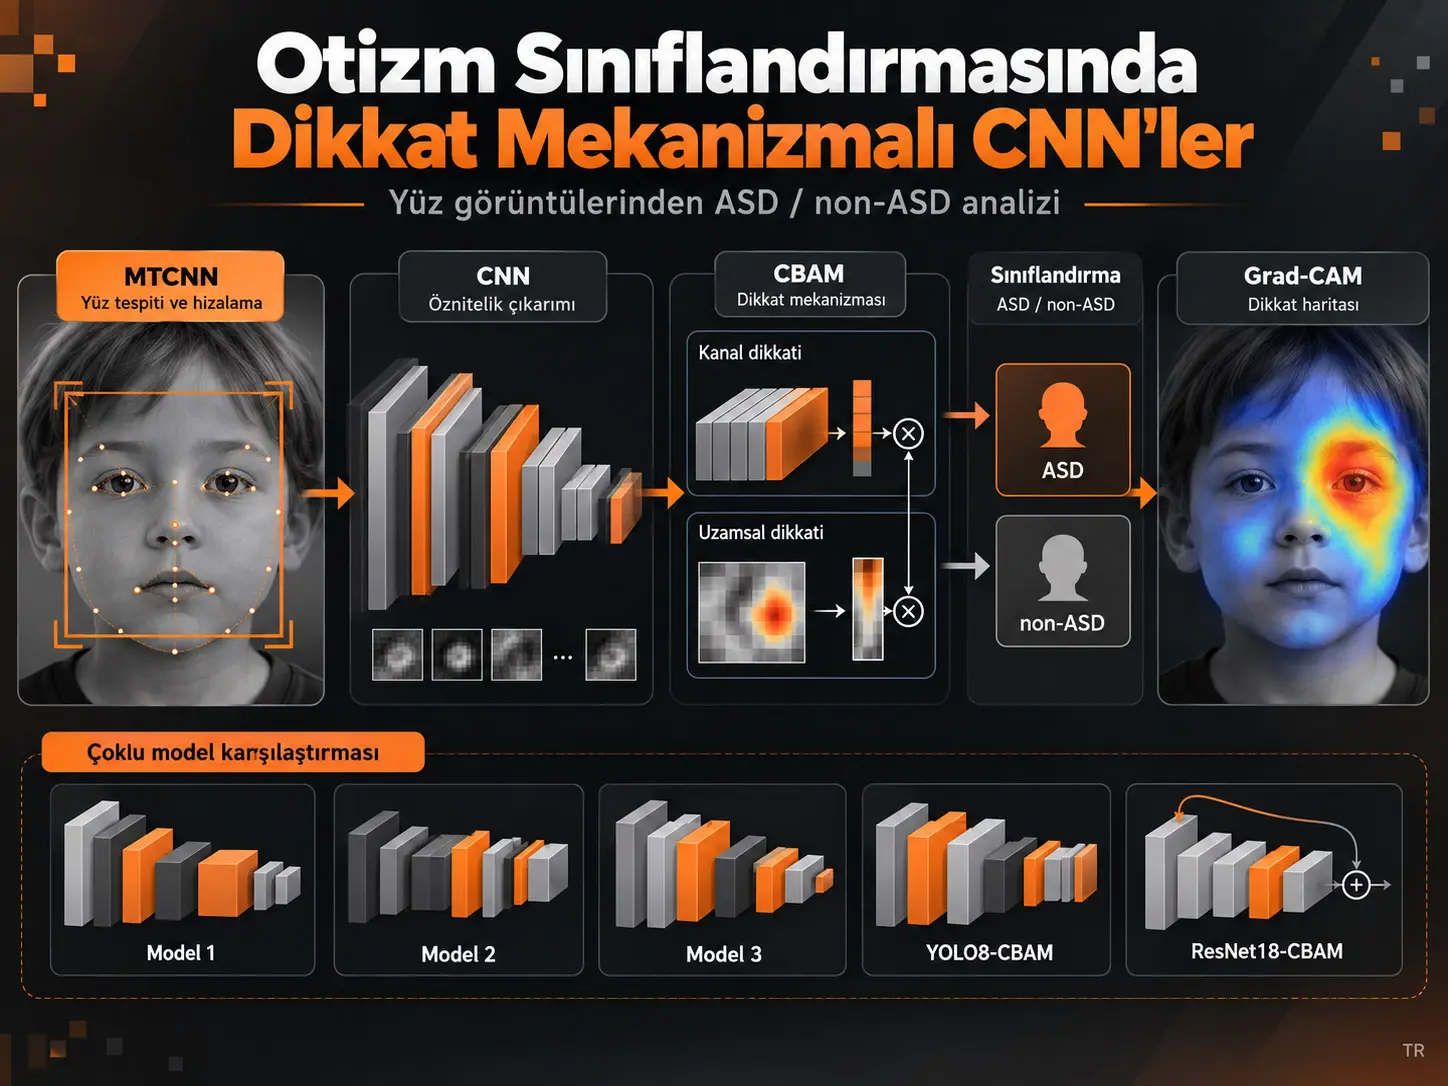
CNN-CBAM tabanlı ASD yüz görüntüsü sınıflandırması, çocukların yüz görüntülerinden çıkarılan görsel özellikleri evrişimsel sinir ağlarıyla işleyen ve Convolutional Block Attention Module (CBAM) aracılığıyla bilgilendirici kanal ve uzamsal özellikleri daha yüksek ağırlıkla temsil eden bir derin öğrenme yaklaşımıdır. Bu çalışma, üç özgün CNN mimarisini ve iki önceden eğitilmiş mimariyi —YOLO8 ve ResNet18— CBAM ile birleştirerek ASD ve non-ASD görüntülerinin ikili sınıflandırmasını karşılaştırmıştır. Kaynak veri setinde 2536 eğitim, 300 test ve 100 doğrulama görüntüsü bulunmaktadır; model değerlendirmesinde beş katlı çapraz doğrulama, accuracy, F1-score, Matthews Correlation Coefficient (MCC), False Negative Rate (FNR), False Positive Rate (FPR) ve AUC ölçütleri kullanılmıştır.
Kaynak Tablo 1'e göre en yüksek doğruluk ve AUC değerleri YOLO8-CBAM modelinde elde edilmiştir: accuracy 0,776, F1-score 0,726, MCC 0,600, FNR 0,297, FPR 0,063 ve AUC 0,912. Bununla birlikte F1-score bakımından en yüksek değer ResNet18-CBAM modeline aittir: 0,792. Bu nedenle çalışma YOLO8-CBAM'ı genel olarak en güçlü model olarak yorumlasa da farklı performans ölçütleri aynı modeli mutlak olarak üstün göstermemektedir.
Model kararlarının görsel olarak yorumlanabilmesi için Gradient-weighted Class Activation Mapping (Grad-CAM) kullanılmıştır. Kaynağa göre özgün CNN modellerinin dikkat haritaları yanak, burun, çene ve alın gibi daha geniş alanlara yayılırken, önceden eğitilmiş YOLO8-CBAM modeli göz ve ağız bölgelerine, ResNet18-CBAM ise ağırlıklı olarak ağız bölgesine odaklanmıştır. Bu ısı haritaları modelin hangi görüntü alanlarının sınıflandırma skoruna daha fazla katkıda bulunduğunu gösterir; bu bölgelerin klinik olarak doğrulanmış ASD biyobelirteçleri olduğunu kanıtlamaz.
Çalışmanın en önemli sınırlılığı tek bir görüntü veri setine dayanmasıdır. Yazarlar modelin veri setine özgü örüntüler öğrenmiş olabileceğini ve bilinmeyen veri dağılımlarında ya da gerçek yaşam koşullarında aynı performansın garanti edilemeyeceğini açıkça belirtmektedir. Dolayısıyla bildirilen sonuçlar bir görüntü sınıflandırma deneyinin performans ölçütleridir; klinik tanı doğruluğu, tarama programı etkinliği veya gerçek dünyadaki tanısal geçerlik olarak yorumlanmamalıdır.
Araştırmanın temel problemi
Otizm spektrum bozukluğu (Autism Spectrum Disorder, ASD), sosyal iletişim ve etkileşimde kalıcı güçlükler ile sınırlı ve tekrarlayıcı davranış örüntüleriyle karakterize edilen nörogelişimsel bir durumdur. Kaynak, erken tanımlamanın zamanında destek ve eğitim müdahaleleri açısından önemli olduğunu belirtmektedir. Araştırmanın teknik sorusu ise yüz görüntülerinden elde edilen görsel örüntülerin farklı CNN mimarileri ve dikkat mekanizmaları kullanılarak ASD / non-ASD sınıflandırmasında ne ölçüde ayrıştırılabileceğidir.
Çalışma geleneksel klinik değerlendirme yerine geçecek bir tanı sistemi doğrulamamaktadır. Araştırılan görev, etiketlenmiş bir görüntü veri setinde iki sınıfın makine öğrenmesiyle ayrılmasıdır. Bu ayrım özellikle önemlidir; çünkü bir modelin veri setindeki sınıfları ayırabilmesi, klinik tanı kriterlerinin veya gerçek hasta değerlendirmesinin yerine geçtiği anlamına gelmez.
Literatür ve çalışmanın hedefi
Kaynak, ASD sınıflandırması için daha önce makine öğrenmesi, fMRI, EEG, grafik tabanlı yöntemler, multimodal modeller, CNN'ler ve çeşitli optimizasyon yaklaşımlarının kullanıldığını tartışmaktadır. Bu çalışmanın ana yaklaşımı, yüz görüntülerini işleyen CNN'lerdeki özellik temsiline CBAM dikkat mekanizması eklemek ve üç özgün mimariyi iki önceden eğitilmiş mimariyle aynı çalışma içinde karşılaştırmaktır.
Araştırmacılar ayrıca Grad-CAM kullanarak yalnız “hangi model daha yüksek puan aldı?” sorusunu değil, ağın sınıflandırma sırasında görüntünün hangi bölgelerine ağırlık verdiğini de görselleştirmeyi amaçlamıştır.
CBAM, ASD Görüntü Sınıflandırmasında Ne Yapar?
Convolutional Block Attention Module (CBAM), bir CNN'nin özellik haritasını önce kanal boyutunda, ardından uzamsal boyutta yeniden ağırlıklandırarak ağın daha bilgilendirici özelliklere ve görüntü bölgelerine daha fazla önem vermesini sağlayan bir dikkat modülüdür. Bu çalışmada CBAM, hem üç özgün CNN mimarisine hem de YOLO8 ve ResNet18 tabanlı modellere eklenmiş ve ASD/non-ASD sınıflandırmasında özelliklerin rafine edilmesi için kullanılmıştır.
Özellik haritası
Kaynak, bir evrişim katmanının çıktısını \(F\) ile gösterir:
\[ F \in \mathbb{R}^{C \times H \times W} \]
Burada \(C\) kanal sayısını, \(H\) özellik haritasının yüksekliğini ve \(W\) genişliğini temsil eder. Bu gösterim, CNN'nin tek bir görüntüyü yalnız iki boyutlu piksel tablosu olarak değil, çok sayıda özellik kanalından oluşan üç boyutlu bir temsil olarak işlediğini ifade eder.
Kanal dikkati
CBAM'ın ilk aşamasında kanal dikkat haritası \(M_c\), özellik kanallarını yeniden ağırlıklandırır:
\[ F' = M_c(F) \otimes F \]
\(\otimes\) eleman bazlı çarpımı temsil eder. Matematiksel rol, bazı kanal bileşenlerinin etkisini yükseltmek ve sınıflandırma açısından daha az yararlı kanalları görece bastırmaktır. Bu işlem yeni görüntü üretmez; CNN'nin mevcut özellik temsilini yeniden ağırlıklandırır.
Uzamsal dikkat
Kanal dikkati sonrasında uzamsal dikkat haritası \(M_s\), özelliklerin görüntü üzerinde hangi konumlarda daha önemli olduğunu belirler:
\[ F'' = M_s(F') \otimes F' \]
Kaynağa göre uzamsal dikkat oluşturulurken kanal boyutunda average pooling ve max pooling uygulanmakta, ardından 7 × 7 evrişim kullanılmaktadır. Kanal dikkatinin “hangi özellik türleri önemli?” sorusuna, uzamsal dikkatin ise “görüntünün neresindeki özellikler önemli?” sorusuna karşılık geldiği düşünülebilir.
Neden hem kanal hem uzamsal dikkat kullanılıyor?
Bir yüz görüntüsünde bütün özellik kanalları ve bütün piksel bölgeleri sınıflandırma açısından aynı bilgi değerine sahip değildir. CBAM'ın ardışık iki aşaması ağın hem özellik türleri hem de konum bakımından seçici olmasını amaçlar. Kaynak bu mekanizmanın temsil gücünü ve ayırt edici özelliklerin vurgulanmasını artırmak amacıyla kullanıldığını belirtmektedir.
Grad-CAM Bu Çalışmada Neyi Gösteriyor?
Gradient-weighted Class Activation Mapping (Grad-CAM), belirli bir sınıf tahminine CNN'nin hangi görüntü bölgelerinin daha fazla katkı verdiğini ısı haritası biçiminde gösteren post hoc açıklanabilirlik yöntemidir. Bu çalışmada Grad-CAM, ASD ve non-ASD sınıflandırmasında modellerin yüz üzerindeki dikkat dağılımlarını karşılaştırmak için kullanılmıştır; ortaya çıkan sıcak bölgeler klinik biyobelirteç değil, model kararına katkı veren görsel alanlardır.
Grad-CAM ağırlıkları
Kaynak, sınıf \(c\) için özellik haritası \(A^k\)'nın önem ağırlığını şu biçimde tanımlar:
\[ \alpha_k^c = \frac{1}{Z} \sum_i \sum_j \frac{\partial y^c}{\partial A_{ij}^k} \]
Burada \(y^c\), incelenen sınıfın skorunu; \(A_{ij}^k\), \(k\). özellik haritasının \(i,j\) konumundaki değerini; \(Z\) ise özellik haritasındaki piksel sayısıyla ilişkili normalizasyon terimini temsil eder. Türev, sınıf skorunun belirli özellik haritasındaki değişime ne kadar duyarlı olduğunu ölçer.
Son Grad-CAM haritası kaynakta:
\[ L_{\mathrm{Grad-CAM}}^c = \mathrm{ReLU} \left( \sum_k \alpha_k^c A^k \right) \]
olarak verilir. ReLU, sınıf skoruna pozitif katkı sağlayan bölgelerin görselleştirilmesini öne çıkarır.
Kaynağın Grad-CAM gözlemleri
Sayfa 12–13'teki Şekil 6, özgün görüntüyü, Grad-CAM maskesini ve görüntü üzerine bindirilmiş dikkat haritasını yan yana göstermektedir. Kaynak, Model 1, Model 2 ve Model 3'ün yanak, burun, çene ve alın gibi daha yaygın yüz bölgelerine odaklandığını; YOLO8-CBAM'ın özellikle gözler ve ağız üzerinde, ResNet18-CBAM'ın ise ağırlıklı olarak ağız bölgesi üzerinde yoğunlaştığını bildirmektedir.
Bu görselleştirme “modelin karar verirken nereye baktığını” yaklaşık olarak açıklamaya yardımcı olur. Buna karşılık bir bölgenin Grad-CAM'de yüksek etkinlik göstermesi, o bölgenin ASD için neden-sonuç ilişkili klinik belirteç olduğunu göstermez.
Veri seti
| Özellik | Kaynakta bildirilen bilgi |
|---|---|
| Veri tipi | 2D RGB çocuk yüz görüntüleri |
| Yaş aralığı | 2–14 yaş; görüntülerin çoğu 2–8 yaş |
| Sınıflar | ASD ve non-ASD |
| Sınıf oranı | Yaklaşık 1:1 |
| Erkek / kız oranı | Yaklaşık 3:1 |
| Eğitim seti | 2536 görüntü |
| Test seti | 300 görüntü |
| Doğrulama seti | 100 görüntü |
| Veri artırımı | Rastgele yatay çevirme ve 15° döndürme |
MTCNN ile yüz tespiti ve hizalama
Ham yüz görüntüleri doğrudan sınıflandırıcıya verilmemiştir. Multi-task Cascaded Convolutional Neural Network (MTCNN), önce yüzün tespit edilmesi ve geometrik olarak hizalanması için kullanılmıştır.
MTCNN üç aşamalı bir yapı içerir:
- P-Net: görüntü piramidi üzerinde çok sayıda yüz adayı üretir ve kaba yüz landmark tahmini yapar.
- R-Net: P-Net adaylarının önemli bölümünü eler ve bounding box koordinatlarını iyileştirir.
- O-Net: nihai bounding box, güven skoru ve göz köşeleri ile burun ucunu içeren beş yüz landmark'ını hesaplar.
Bu ön işleme aşamasının amacı, ağın sınıflandırmasını baş pozisyonu veya görüntü kırpma farklılıklarından mümkün olduğunca bağımsız hâle getirmek ve yüz bölgesini daha tutarlı biçimde CNN girişine sunmaktır.
Üç özgün CNN mimarisi
| Model | Conv2D katmanı | MaxPool2D | CBAM | AdaptiveAvgPool2D |
|---|---|---|---|---|
| Model 1 | 3 | 3 | 3 | 1 |
| Model 2 | 2 | 2 | 2 | 1 |
| Model 3 | 1 | 1 | 1 | 1 |
Model 1 en derin özgün mimari, Model 3 ise en sığ özgün mimaridir. Kaynağın bulgularına göre özgün modellerde katman sayısının artırılması bu veri setinde performansı sürekli yükseltmemiştir; tersine Model 3, Model 1 ve Model 2'den daha yüksek accuracy ve AUC elde etmiştir.
Önceden eğitilmiş mimariler
YOLO8, çalışmada önceden eğitilmiş ağlardan biri olarak kullanılmış ve seçilen evrişimsel bloklardan sonra CBAM entegrasyonuyla özelliklerin yeniden ağırlıklandırılması amaçlanmıştır.
ResNet18, residual/skip connection kullanan ikinci önceden eğitilmiş ağdır. Residual bağlantıların daha derin temsil öğreniminde gradyan akışını koruma avantajından yararlanılır. Çalışmada bu mimari de CBAM ile birleştirilmiştir.
Çalışmanın Yöntemi ve Bulguları
Donanım ve yazılım
| Bileşen | Değer |
|---|---|
| Bilgisayar | Apple Mac Studio (2023) |
| CPU | Apple M2 Ultra |
| RAM | 64 GB |
| SSD | 1 TB |
| GPU | 32 çekirdekli GPU |
| Python | 3.10.19 |
| Batch size | 16 |
| Learning rate | 0,0001 |
| Epoch | 30 |
| Görüntü boyutu | 324 × 324 |
| Değerlendirme | Beş katlı çapraz doğrulama |
Kaynak ayrıca Pandas 2.3.3, Torch 2.2.2, Scikit-learn 1.7.2, Pillow 10.2.0, Matplotlib 3.10.8, Seaborn 0.13.2, TensorFlow 2.19.1 ve Tqdm 4.67.1 kütüphanelerini bildirmektedir.
Yeniden üretilebilirlik sınırı: Kaynak öğrenme oranı, batch size, epoch sayısı ve görüntü boyutunu raporlamaktadır; ancak kullanılan optimizer ve loss function açıkça belirtilmemektedir. Ayrıca önceden ayrılmış eğitim/test/doğrulama kümeleri ile beş katlı çapraz doğrulamanın tam uygulama ilişkisi ayrıntılandırılmamıştır.
Performans metriklerinin matematiksel yapısı
Karmaşıklık matrisinde:
- \(TP\): doğru pozitif,
- \(TN\): doğru negatif,
- \(FP\): yanlış pozitif,
- \(FN\): yanlış negatif
olarak tanımlanır.
Accuracy:
\[ Accuracy = \frac{TP+TN} {TP+TN+FP+FN} \]
Toplam örneklerin ne kadarının doğru sınıflandırıldığını ölçer. Sınıflar veya hata maliyetleri asimetrik olduğunda accuracy tek başına yeterli değildir.
Precision:
\[ Precision = \frac{TP}{TP+FP} \]
Pozitif olarak sınıflandırılan örneklerin ne kadarının gerçekten pozitif sınıfa ait olduğunu ölçer.
Recall:
\[ Recall = \frac{TP}{TP+FN} \]
Gerçek pozitiflerin ne kadarının model tarafından yakalandığını gösterir.
F1-score:
\[ F1 = 2 \frac{Precision \times Recall} {Precision+Recall} \]
Precision ile recall'un harmonik ortalamasıdır ve iki hata yönünü tek bir performans ölçüsünde birleştirir.
False Positive Rate:
\[ FPR = \frac{FP}{FP+TN} \]
Gerçek negatif örnekler içinde yanlışlıkla pozitif sınıfa atananların oranını ifade eder.
False Negative Rate:
\[ FNR = \frac{FN}{TP+FN} \]
Gerçek pozitif örnekler içinde modelin kaçırdığı bölümün oranıdır.
Matthews Correlation Coefficient:
\[ MCC = \frac {TP \times TN-FP \times FN} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \]
MCC, karmaşıklık matrisinin dört bileşenini birlikte kullanır ve ikili sınıflandırma performansını tek değerde özetler.
Kaynağın AUC denklemindeki tutarsızlık
Kaynak Denklem 13'te şu ifadeyi verir:
\[ AUC = \frac{TP\ Rate}{FP\ Rate} \]
Ancak aynı makale AUC'yi başka yerlerde ROC eğrisinin altında kalan alan olarak adlandırmakta ve Şekil 5'te ROC eğrileri üzerinden AUC değerleri göstermektedir. Dolayısıyla Denklem 13'ün yazımı ile metinsel/görsel AUC kullanımı kendi içinde tam uyumlu değildir. Verianla bu denklemi sessizce başka bir formüle dönüştürmemekte, kaynak-içi tutarsızlığı görünür bırakmaktadır.
Hangi CNN-CBAM Modeli En Yüksek Performansı Gösterdi?
Kaynak Tablo 1 ve sonuç bölümüne göre YOLO8-CBAM, accuracy 0,776, MCC 0,600 ve AUC 0,912 ile çalışmanın genel olarak en güçlü modeli olarak seçilmiştir; ancak ResNet18-CBAM 0,792 ile en yüksek F1-score değerine ve 0,163 ile en düşük FNR değerine sahiptir. Bu nedenle “en iyi” değerlendirmesi kullanılan performans metriğine bağlıdır ve bütün ölçütlerde tek model üstün değildir.
| Model | Accuracy | F1-score | MCC | FNR | FPR | AUC |
|---|---|---|---|---|---|---|
| Model 1 | 0,683 | 0,692 | 0,367 | 0,304 | 0,327 | 0,753 |
| Model 2 | 0,706 | 0,639 | 0,445 | 0,349 | 0,170 | 0,793 |
| Model 3 | 0,746 | 0,714 | 0,506 | 0,298 | 0,181 | 0,841 |
| YOLO8-CBAM | 0,776 | 0,726 | 0,600 | 0,297 | 0,063 | 0,912 |
| ResNet18-CBAM | 0,773 | 0,792 | 0,556 | 0,163 | 0,269 | 0,878 |
Yazım notu: Kaynak Tablo 1 ve bazı şekil açıklamalarında YOLO8-CBAM için “Yolo8-CABM” biçimi de kullanılmaktadır. CBAM makalenin tanımladığı canonical modül adı olduğundan Verianla anlatımında bilimsel kavram YOLO8-CBAM olarak tutulmakta, ancak kaynakta bulunan CABM yazımı bir kaynak-içi yazım farklılığı olarak kaydedilmektedir.
Özgün CNN modelleri ne gösterdi?
Üç özgün model arasında Model 3 en yüksek sonucu vermiştir: accuracy 0,746 ve AUC 0,841. Model 1'in accuracy değeri 0,683, Model 2'nin 0,706'dır.
Kaynak, özgün CNN'lerde katman sayısının artmasıyla sınıflandırma kalitesinin düşme eğilimi gösterdiğini ve daha derin özgün ağların mevcut veri setine uyum sağlamakta zorlanmış olabileceğini yorumlamaktadır. Bu sonuç yalnız incelenen mimariler ve veri seti için geçerlidir; “derin ağlar ASD sınıflandırmasında genel olarak daha kötüdür” sonucunu desteklemez.
YOLO8-CBAM ve ResNet18-CBAM
Önceden eğitilmiş iki mimari birbirine yakın accuracy değerleri üretmiştir: YOLO8-CBAM 0,776, ResNet18-CBAM 0,773. Bununla birlikte hata profilleri farklıdır. Kaynak Tablo 1'e göre YOLO8-CBAM'ın FPR değeri 0,063 iken ResNet18-CBAM'ın FPR değeri 0,269'dur. Buna karşılık ResNet18-CBAM'ın FNR değeri 0,163 ile YOLO8-CBAM'ın 0,297 değerinden daha düşüktür.
Bu asimetri, model seçiminin yalnız accuracy üzerinden yapılmaması gerektiğini gösterir. Bir uygulamada yanlış pozitif ve yanlış negatif hatalarının göreli önemi farklıysa aynı iki model farklı biçimde değerlendirilebilir.
Kaynakta YOLO8 ve ResNet18 sonuçlarının eşleşme problemi
Kaynağın Tablo 1'i YOLO8-CBAM için AUC=0,912 ve FPR=0,063; ResNet18-CBAM için AUC=0,878 ve FPR=0,269 bildirmektedir. Buna karşılık sonuç metninin bir cümlesi ResNet18-CBAM'a AUC=0,912 ve FPR=0,063 atamaktadır; aynı cümlede verilen %73,1 özgüllük ise FPR=0,269 ile uyumludur.
Şekil 5'in panel sıralamasında da benzer bir uyuşmazlık vardır: caption d2 panelini ResNet18-CBAM, e2 panelini YOLO8-CBAM olarak adlandırırken, görselde d2 AUC=0,9120 ve e2 AUC=0,8784 göstermektedir. Bunlar Tablo 1'deki model sırasıyla ters düşmektedir.
Bu nedenle Verianla'da sayısal karşılaştırmanın kaynak-of-truth'u olarak Tablo 1 ve abstract/conclusion'da tekrarlanan ana YOLO8-CBAM değerleri esas alınmış; Şekil 5'teki panel-model eşlemesi bağımsız doğrulanmış veri gibi kullanılmamıştır.
Literatür karşılaştırması
| Çalışma | Yöntem | Kaynakta verilen metrik |
|---|---|---|
| M. Das ve ark. (2025) | EfficientNet | Accuracy %84; AUC-ROC 0,89 |
| Negin ve ark. (2021) | LSTM, ConvLSTM ve 3DCNN | Accuracy %72 |
| Khalaji ve ark. (2022) | ML classifier | Accuracy %75 |
| Liu ve ark. (2025) | 3D-CNN + recurrent neural network + random forest | Accuracy %77 |
| Bu çalışma | YOLO8-CBAM | Accuracy %77,6; AUC 0,912 |
Bu tablo literatürdeki sonuçları bağlamsal karşılaştırma amacıyla yan yana getirmektedir. Kaynak bütün çalışmaların aynı veri seti, veri bölümü ve deney protokolünü kullandığını göstermediğinden bu sayılar kontrollü bir başa baş benchmark sıralaması gibi yorumlanmamalıdır.
Bu Sonuçlar Klinik Otizm Tanısı Anlamına Gelir mi?
Hayır. Çalışmanın sonuçları, tek bir etiketli yüz görüntüsü veri setinde CNN-CBAM modellerinin ASD/non-ASD sınıflarını ayırma performansını göstermektedir; bağımsız klinik popülasyonlarda tanısal geçerlik, prospektif tarama performansı veya gerçek sağlık hizmeti kullanımına uygunluk doğrulanmamıştır. Yazarlar da tek veri setinin genellenebilirliği sınırladığını ve yeni, uzman desteğiyle oluşturulmuş veri setlerinde ek doğrulama gerektiğini belirtmektedir.
Tek veri seti problemi
Bir model tek bir veri setinde eğitildiğinde yalnız ASD ile ilişkili olabilecek görsel yapıların değil, veri toplama koşullarına özgü arka plan, aydınlatma, kamera, kırpma, yaş dağılımı veya başka veri seti özelliklerinin de örüntülerini öğrenebilir. Kaynağın sınırlılık bölümünde bu sorun doğrudan belirtilmektedir: model veri setine özgü örüntüler öğrenebilir ve bilinmeyen veri dağılımlarında aynı performansı göstermeyebilir.
Dış doğrulama
Çalışma ayrı bir dış merkez veya bağımsız gerçek yaşam popülasyonu üzerinde model doğrulaması raporlamamaktadır. Yazarlar gelecekte farklı veri setlerinin, daha verimli mimarilerin ve erken ASD değerlendirmesinde uzman klinik psikologların katkısıyla oluşturulacak yeni test verilerinin kullanılmasını önermektedir.
Hesaplama maliyeti
Kaynak ayrıca CNN sınıflandırmasının hesaplama açısından maliyetli ve zaman alıcı olduğunu belirtmektedir. Çok sayıda evrişimsel katman, parametre ve tekrarlı eğitim yüksek çözünürlüklü görüntüler veya büyük veri setlerinde eğitim ve çıkarım süresini artırabilir. Bu durum gerçek zamanlı veya kaynak-kısıtlı ortamlardaki kullanım açısından ek bir sınırlılıktır.
Çalışmanın desteklediği ve desteklemediği sonuçlar
| Çalışmanın desteklediği | Çalışmanın desteklemediği |
|---|---|
| İncelenen veri setinde YOLO8-CBAM %77,6 accuracy ve 0,912 AUC elde etmiştir. | YOLO8-CBAM'ın genel nüfusta %77,6 klinik tanı doğruluğuna sahip olduğu. |
| CBAM, incelenen CNN mimarilerinde kanal ve uzamsal dikkat mekanizması olarak kullanılmıştır. | CBAM'ın bütün ASD veri setlerinde performansı kesin olarak artıracağı. |
| Grad-CAM, modelin belirli yüz bölgelerine verdiği göreli önemi görselleştirmiştir. | Göz, ağız veya başka yüz bölgelerinin klinik ASD biyobelirteci olduğunun kanıtlandığı. |
| Özgün modeller arasında Model 3 en yüksek accuracy ve AUC değerini vermiştir. | Daha az katmanlı CNN'lerin genel olarak daha üstün olduğu. |
| Önceden eğitilmiş YOLO8-CBAM ve ResNet18-CBAM, üç özgün modelden accuracy açısından daha yüksek sonuç vermiştir. | Önceden eğitilmiş modellerin bütün yüz görüntüsü problemlerinde üstün olacağı. |
| Tek veri seti genel uygulanabilirliği sınırlar. | Modelin gerçek klinik kullanım için dışarıdan doğrulandığı. |
Kaynak ve Yöntem Notu
| Özgün başlık | Multi-Architecture Convolutional Neural Networks with Attention Mechanisms for Autism Spectrum Disorder Classification |
|---|---|
| Yazarlar | Ioana Diana Moldovanu; Ecaterina Popa; Simona Moldovanu |
| Sorumlu yazar | Simona Moldovanu |
| Kurum 1 | Department of Psychology, Danubius International University, Galati, Romania |
| Kurum 2 | Department of Computer Science and Information Technology, Faculty of Automation, Computers, Electrical Engineering and Electronics, “Dunarea de Jos” University of Galati, Romania |
| Kurum 3 | The Modelling & Simulation Laboratory, “Dunarea de Jos” University of Galati, Romania |
| DOI | 10.3390/aieduc2020021 |
| Dergi | AI in Education |
| Kısaltılmış dergi adı | AI Educ. |
| Yayınevi | MDPI, Basel, Switzerland |
| Cilt / sayı | 2 / 2 |
| Makale numarası | 21 |
| Kaynak türü | Article |
| Alınma tarihi | 14 Ocak 2026 |
| Revizyon | 12 Mart 2026 |
| Kabul | 24 Nisan 2026 |
| Yayın | 5 Haziran 2026 |
| Hakemlik | Hakem değerlendirmeli dergi makalesi |
| Lisans | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Finansman | Harici finansman yok |
| Institutional Review Board | Not applicable |
| Bilgilendirilmiş onam | Not applicable |
| Veri erişilebilirliği | Sınıflandırmada kullanılan veri seti Zenodo üzerinden erişilebilir; makale 18 Aralık 2025 erişim tarihini bildirir. |
| Çıkar çatışması | Yazarlar çıkar çatışması bildirmemiştir. |
Veri/etik notu: Makalenin Institutional Review Board ve informed consent alanları “Not applicable” olarak verilmiştir. Bununla birlikte Data Availability Statement, görüntü işlemenin Helsinki Bildirgesi'ne uygun gerçekleştirildiğini ve kaynak protokolün Duke University Medical Center Center for Developmental Epidemiology tarafından R01 MH081025 numarasıyla onaylandığını belirtmektedir. Bu ifadeler muhtemelen mevcut/ikincil veri setinin yeniden kullanım bağlamıyla ilişkilidir; makale iki beyan arasındaki ilişkiyi ayrıca ayrıntılandırmamaktadır.
Şekil 6 veri kaynağı notu: Makalenin veri seti bölümü sınıflandırma verisini Zenodo kaydına bağlarken, Grad-CAM için kullanılan Şekil 6'daki örnek görüntünün National Institute of Mental Health Child Emotional Faces Picture Set (NIMH-ChEFS) kaynaklı olduğu belirtilmektedir. Makale bu şekil görüntüsünün ana sınıflandırma veri setiyle ilişkisini ayrıca ayrıntılandırmamaktadır.
Yazar katkıları: Ioana Diana Moldovanu kavramsallaştırma, doğrulama, araştırma ve veri kürasyonu; Ecaterina Popa metodoloji, biçimsel analiz, ilk taslak yazımı ve görselleştirme; Simona Moldovanu yazılım, kaynaklar, gözden geçirme/düzenleme, denetim ve proje yönetimi görevlerini üstlenmiştir. Tüm yazarların yayımlanan sürümü okuyup onayladığı belirtilmektedir.
Kaynak-içi tutarlılık notu: Tablo 1, sonuç metni ve Şekil 5 arasında özellikle YOLO8-CBAM ve ResNet18-CBAM'ın AUC/FPR değerlerinin eşleştirilmesinde tutarsızlık vardır. Ayrıca CBAM kısaltması bazı yerlerde CABM olarak yazılmıştır. Verianla sayısal karşılaştırmada Tablo 1'i temel kaynak olarak kullanmış ve çelişkileri görünür biçimde korumuştur.
Denklem notu: Kaynak Denklem 13 AUC'yi TP Rate / FP Rate biçiminde yazmaktadır; aynı makalede AUC ROC eğrisi altındaki alan olarak kullanılmaktadır. Kaynak içindeki bu farklılık düzeltilmiş gibi gösterilmemiştir.
Yeniden üretilebilirlik notu: Kaynak batch size, learning rate, epoch, görüntü boyutu, ana yazılım kütüphaneleri ve beş katlı çapraz doğrulamayı bildirirken optimizer ve loss function açıkça raporlamamaktadır. Sabit eğitim/test/doğrulama bölümü ile beş katlı çapraz doğrulamanın uygulama ilişkisi de ayrıntılı olarak açıklanmamıştır.
Temel yöntemsel sınır: Tek veri setine dayanılması, bağımsız dış doğrulama bulunmaması ve gerçek klinik uygulamada prospektif performansın test edilmemesi nedeniyle bildirilen model metrikleri veri seti kapsamındaki sınıflandırma performansı olarak yorumlanmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir