

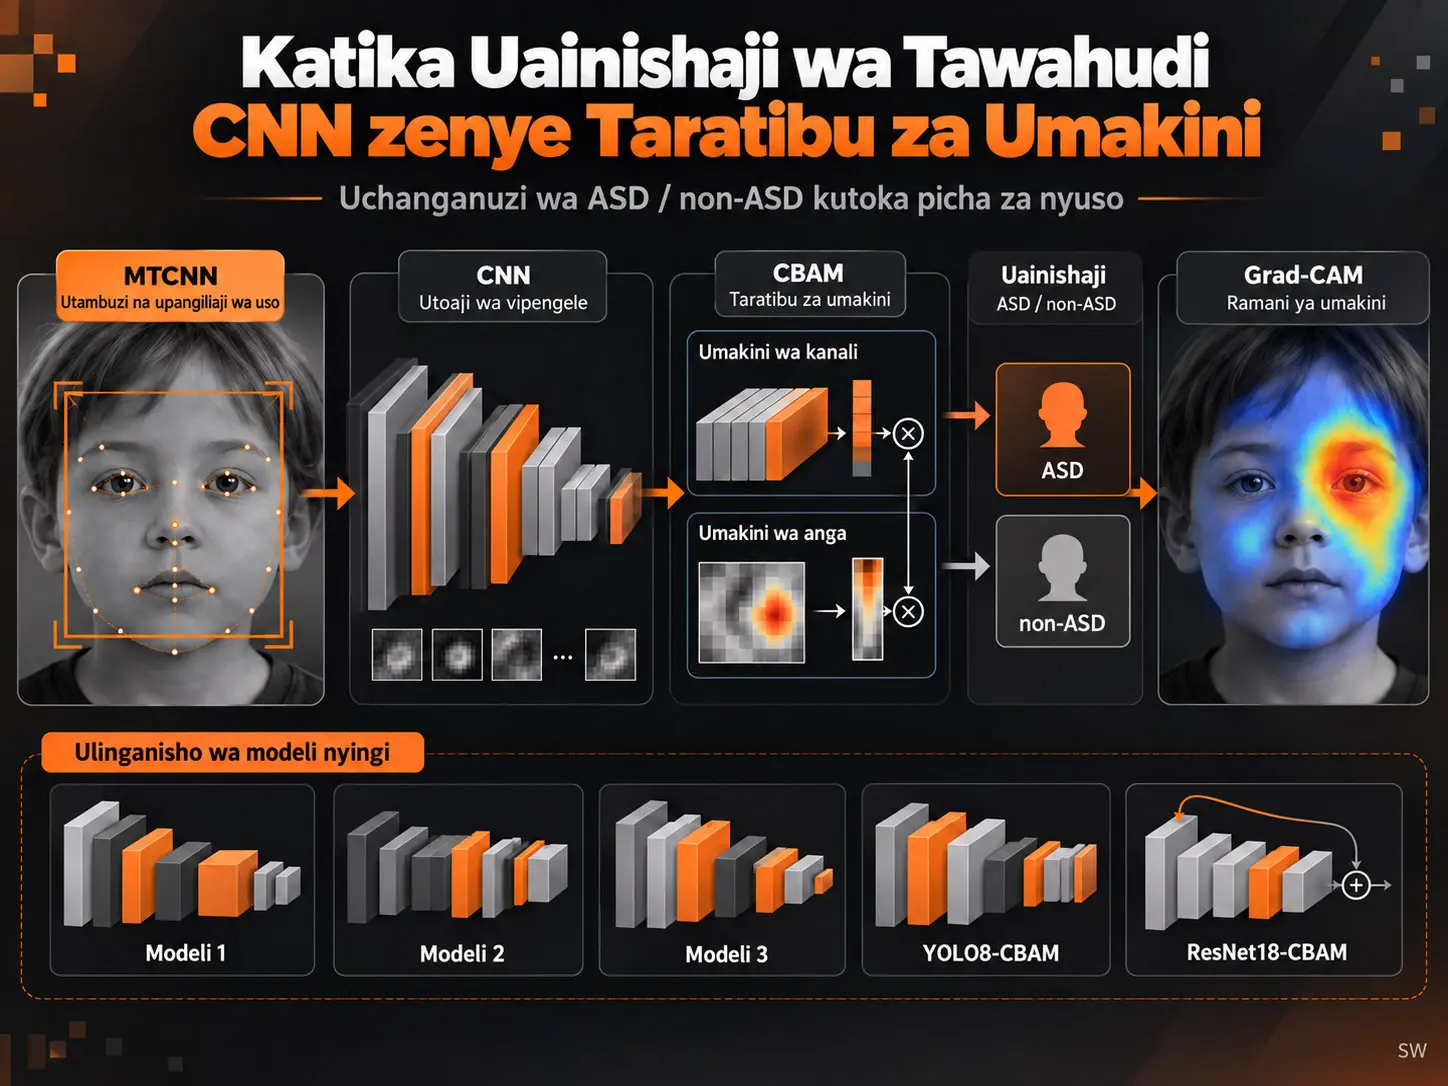
Uainishaji wa picha za nyuso za ASD unaotegemea CNN-CBAM, ni mbinu ya ujifunzaji wa kina inayochakata vipengele vya kuona vilivyotolewa kutoka picha za nyuso za watoto kwa mitandao ya neva ya konvolusheni na, kupitia Convolutional Block Attention Module (CBAM), kuzipa uzito mkubwa zaidi sifa za njia na za anga zenye taarifa. Utafiti huu ulilinganisha uainishaji wa jozi wa picha za ASD na non-ASD kwa kuunganisha miundo mitatu asilia ya CNN na miundo miwili iliyofunzwa awali —YOLO8 na ResNet18— na CBAM. Seti ya data ya chanzo ina picha 2536 za mafunzo, 300 za majaribio na 100 za uthibitishaji; tathmini ya modeli ilitumia uthibitishaji mtambuka wa mikunjo mitano, accuracy, F1-score, Matthews Correlation Coefficient (MCC), False Negative Rate (FNR), False Positive Rate (FPR) na AUC.
Kulingana na Jedwali la 1 la chanzo, thamani za juu zaidi za accuracy na AUC zilipatikana katika modeli ya YOLO8-CBAM: accuracy 0,776, F1-score 0,726, MCC 0,600, FNR 0,297, FPR 0,063 na AUC 0,912. Hata hivyo, thamani ya juu zaidi ya F1-score ni ya modeli ya ResNet18-CBAM: 0,792. Kwa hiyo, ingawa utafiti unaitafsiri YOLO8-CBAM kwa ujumla kama modeli yenye nguvu zaidi, vipimo tofauti vya utendaji haviionyeshi modeli hiyo hiyo kuwa bora kabisa katika kila kipimo.
Gradient-weighted Class Activation Mapping (Grad-CAM) ilitumika ili maamuzi ya modeli yaweze kufasiriwa kwa kuona. Kulingana na chanzo, ramani za umakini za modeli asilia za CNN huenea katika maeneo mapana zaidi kama mashavu, pua, kidevu na paji la uso, ilhali modeli iliyofunzwa awali ya YOLO8-CBAM ililenga maeneo ya macho na mdomo, na ResNet18-CBAM ililenga zaidi eneo la mdomo. Ramani hizi za joto zinaonyesha ni maeneo gani ya picha yalichangia zaidi alama ya uainishaji; hazithibitishi kwamba maeneo hayo ni biomarka za ASD zilizothibitishwa kliniki.
Kizuizi muhimu zaidi cha utafiti ni kutegemea seti moja tu ya data ya picha. Waandishi wanaeleza wazi kwamba modeli inaweza kuwa imejifunza ruwaza mahususi za seti ya data na kwamba utendaji uleule hauwezi kuhakikishwa katika usambazaji wa data usiojulikana au katika hali halisi za maisha. Kwa hiyo, matokeo yaliyoripotiwa ni vipimo vya utendaji wa jaribio la uainishaji wa picha; hayapaswi kufasiriwa kama usahihi wa utambuzi wa kliniki, ufanisi wa programu ya uchunguzi au uhalali wa uchunguzi katika ulimwengu halisi.
Tatizo kuu la utafiti
Ugonjwa wa wigo wa tawahudi (Autism Spectrum Disorder, ASD) ni hali ya ukuaji wa neva inayojulikana kwa matatizo ya kudumu katika mawasiliano na mwingiliano wa kijamii pamoja na mifumo ya tabia iliyozuiliwa na inayojirudia. Chanzo kinaeleza kuwa utambuzi wa mapema ni muhimu kwa msaada na afua za kielimu kwa wakati. Swali la kiufundi la utafiti ni ni kwa kiwango gani ruwaza za kuona zinazotolewa kutoka picha za nyuso zinaweza kutenganishwa katika uainishaji wa ASD / non-ASD kwa kutumia miundo tofauti ya CNN na taratibu za umakini.
Utafiti hauthibitishi mfumo wa utambuzi unaokusudiwa kuchukua nafasi ya tathmini ya kawaida ya kliniki. Kazi iliyochunguzwa ni kutenganisha madarasa mawili katika seti ya data ya picha zilizowekewa lebo kwa kutumia ujifunzaji wa mashine. Tofauti hii ni muhimu hasa kwa sababu uwezo wa modeli kutenganisha madarasa katika seti ya data haumaanishi kuwa inaweza kuchukua nafasi ya vigezo vya utambuzi wa kliniki au tathmini ya mgonjwa halisi.
Fasihi na lengo la utafiti
Chanzo kinajadili kwamba ujifunzaji wa mashine, fMRI, EEG, mbinu zinazotegemea grafu, modeli za multimodal, CNN na mbinu mbalimbali za uboreshaji zimetumika hapo awali kwa uainishaji wa ASD. Mbinu kuu ya utafiti huu ni kuongeza utaratibu wa umakini wa CBAM kwenye uwakilishi wa vipengele katika CNN zinazochakata picha za nyuso na kulinganisha miundo mitatu asilia na miundo miwili iliyofunzwa awali ndani ya utafiti mmoja.
Watafiti pia walilenga kutumia Grad-CAM sio tu kujibu swali “ni modeli gani ilipata alama ya juu zaidi?”, bali pia kuonesha ni maeneo gani ya picha ambayo mtandao ulipewa uzito zaidi wakati wa uainishaji.
CBAM Hufanya Nini katika Uainishaji wa Picha za ASD?
Convolutional Block Attention Module (CBAM) ni moduli ya umakini inayopima upya ramani ya vipengele ya CNN kwanza katika mwelekeo wa njia na kisha katika mwelekeo wa anga, hivyo kuwezesha mtandao kutoa umuhimu zaidi kwa vipengele na maeneo ya picha yenye taarifa zaidi. Katika utafiti huu, CBAM iliongezwa kwenye miundo yote mitatu asilia ya CNN na pia kwenye modeli zinazotegemea YOLO8 na ResNet18, na ilitumika kusafisha vipengele katika uainishaji wa ASD/non-ASD.
Ramani ya vipengele
Chanzo kinaonyesha pato la tabaka la konvolusheni kwa \(F\):
\[ F \in \mathbb{R}^{C \times H \times W} \]
Hapa \(C\) inawakilisha idadi ya njia, \(H\) urefu wa ramani ya vipengele, na \(W\) upana wake. Uwakilishi huu unaonyesha kuwa CNN haichakati picha moja kama jedwali la pikseli la pande mbili tu, bali kama uwakilishi wa pande tatu unaoundwa na njia nyingi za vipengele.
Umakini wa njia
Katika hatua ya kwanza ya CBAM, ramani ya umakini wa njia \(M_c\) hupima upya njia za vipengele:
\[ F' = M_c(F) \otimes F \]
\(\otimes\) inawakilisha kuzidisha kipengele kwa kipengele. Jukumu lake la kihisabati ni kuongeza athari ya baadhi ya vipengele vya njia na kupunguza kwa kiasi njia ambazo hazina manufaa mengi kwa uainishaji. Operesheni hii haitengenezi picha mpya; inapima upya uwakilishi wa vipengele uliopo wa CNN.
Umakini wa anga
Baada ya umakini wa njia, ramani ya umakini wa anga \(M_s\) huamua ni katika maeneo gani ya picha vipengele ni muhimu zaidi:
\[ F'' = M_s(F') \otimes F' \]
Kulingana na chanzo, wakati wa kuunda umakini wa anga, average pooling na max pooling hutumika katika mwelekeo wa njia, kisha hutumika konvolusheni ya 7 × 7. Umakini wa njia unaweza kufikiriwa kujibu swali “ni aina gani za vipengele ni muhimu?”, huku umakini wa anga ukijibu “vipengele vilivyo wapi katika picha ni muhimu?”.
Kwa nini umakini wa njia na wa anga hutumika pamoja?
Katika picha ya uso, si njia zote za vipengele wala maeneo yote ya pikseli yana thamani sawa ya taarifa kwa uainishaji. Hatua mbili zinazofuatana za CBAM zinalenga kuufanya mtandao kuwa chaguzi kwa aina ya kipengele na pia kwa eneo. Chanzo kinaeleza kuwa utaratibu huu ulitumika kuongeza nguvu ya uwakilishi na kusisitiza vipengele vinavyotofautisha madarasa.
Grad-CAM Inaonyesha Nini katika Utafiti Huu?
Gradient-weighted Class Activation Mapping (Grad-CAM) ni mbinu ya post hoc ya kuelezeka inayoonyesha kwa ramani ya joto ni maeneo gani ya picha ya CNN yalichangia zaidi katika utabiri wa darasa fulani. Katika utafiti huu, Grad-CAM ilitumika kulinganisha usambazaji wa umakini wa modeli kwenye uso wakati wa uainishaji wa ASD na non-ASD; maeneo yenye joto si biomarka za kliniki, bali ni maeneo ya kuona yaliyotoa mchango katika uamuzi wa modeli.
Uzito wa Grad-CAM
Chanzo kinafafanua kwa darasa \(c\) uzito wa umuhimu wa ramani ya kipengele \(A^k\) kama ifuatavyo:
\[ \alpha_k^c = \frac{1}{Z} \sum_i \sum_j \frac{\partial y^c}{\partial A_{ij}^k} \]
Hapa \(y^c\) ni alama ya darasa linalochunguzwa; \(A_{ij}^k\) ni thamani ya ramani ya kipengele ya \(k\) katika nafasi \(i,j\); na \(Z\) ni istilahi ya urekebishaji inayohusiana na idadi ya pikseli katika ramani ya kipengele. Derivative hupima jinsi alama ya darasa ilivyo nyeti kwa mabadiliko katika ramani mahususi ya kipengele.
Ramani ya mwisho ya Grad-CAM katika chanzo imetolewa kama:
\[ L_{\mathrm{Grad-CAM}}^c = \mathrm{ReLU} \left( \sum_k \alpha_k^c A^k \right) \]
ReLU husisitiza uoneshaji wa maeneo yanayotoa mchango chanya kwa alama ya darasa.
Uchunguzi wa Grad-CAM katika chanzo
Kielelezo cha 6 kwenye kurasa 12–13 kinaonyesha picha asilia, maski ya Grad-CAM na ramani ya umakini iliyowekwa juu ya picha kando kwa kando. Chanzo kinaripoti kuwa Model 1, Model 2 na Model 3 zililenga maeneo mapana zaidi ya uso kama mashavu, pua, kidevu na paji la uso; YOLO8-CBAM ililenga hasa macho na mdomo, na ResNet18-CBAM ililenga zaidi eneo la mdomo.
Uoneshaji huu husaidia kueleza kwa kukadiria “modeli inaangalia wapi inapofanya uamuzi?”. Hata hivyo, eneo kuonyesha shughuli kubwa kwenye Grad-CAM hakumaanishi kwamba eneo hilo ni kiashiria cha kliniki chenye uhusiano wa sababu na ASD.
Seti ya data
| Kipengele | Taarifa iliyoripotiwa katika chanzo |
|---|---|
| Aina ya data | Picha za nyuso za watoto za 2D RGB |
| Umri | Miaka 2–14; picha nyingi ni za miaka 2–8 |
| Madarasa | ASD na non-ASD |
| Uwiano wa madarasa | Takriban 1:1 |
| Uwiano wa wavulana / wasichana | Takriban 3:1 |
| Seti ya mafunzo | Picha 2536 |
| Seti ya majaribio | Picha 300 |
| Seti ya uthibitishaji | Picha 100 |
| Uongezaji data | Kugeuza kwa mlalo bila mpangilio na kuzungusha 15° |
Ugunduzi na upangaji wa uso kwa MTCNN
Picha ghafi za nyuso hazikupelekwa moja kwa moja kwenye kiainishaji. Multi-task Cascaded Convolutional Neural Network (MTCNN) ilitumika kwanza kugundua uso na kuupanga kijiometria.
MTCNN ina muundo wa hatua tatu:
- P-Net: hutengeneza wagombea wengi wa uso kwenye piramidi ya picha na kufanya makadirio ya awali ya landmark za uso.
- R-Net: huondoa sehemu kubwa ya wagombea wa P-Net na kuboresha koordinati za bounding box.
- O-Net: huhesabu bounding box ya mwisho, alama ya kujiamini na landmark tano za uso zinazojumuisha pembe za macho na ncha ya pua.
Lengo la hatua hii ya uchakataji wa awali ni kufanya uainishaji wa mtandao utegemee kwa kiwango kidogo iwezekanavyo nafasi ya kichwa au tofauti za kukata picha, na kuwasilisha eneo la uso kwa ingizo la CNN kwa namna iliyo thabiti zaidi.
Miundo mitatu asilia ya CNN
| Modeli | Tabaka la Conv2D | MaxPool2D | CBAM | AdaptiveAvgPool2D |
|---|---|---|---|---|
| Model 1 | 3 | 3 | 3 | 1 |
| Model 2 | 2 | 2 | 2 | 1 |
| Model 3 | 1 | 1 | 1 | 1 |
Model 1 ndiyo muundo asilia wenye kina kikubwa zaidi, na Model 3 ndiyo muundo asilia wenye kina kidogo zaidi. Kulingana na matokeo ya chanzo, kuongeza idadi ya tabaka katika modeli asilia hakukuongeza utendaji kila mara katika seti hii ya data; kinyume chake Model 3 ilipata accuracy na AUC za juu kuliko Model 1 na Model 2.
Miundo iliyofunzwa awali
YOLO8, ilitumika kama mojawapo ya mitandao iliyofunzwa awali katika utafiti, na baada ya bloksi zilizochaguliwa za konvolusheni, ujumuishaji wa CBAM ulilenga kupima upya vipengele.
ResNet18, ni mtandao wa pili uliofunzwa awali unaotumia residual/skip connection. Faida ya miunganisho ya residual katika kuhifadhi mtiririko wa gradient wakati wa kujifunza uwakilishi wenye kina zaidi hutumiwa. Katika utafiti, muundo huu pia uliunganishwa na CBAM.
Mbinu na Matokeo ya Utafiti
Vifaa na programu
| Kipengele | Thamani |
|---|---|
| Kompyuta | Apple Mac Studio (2023) |
| CPU | Apple M2 Ultra |
| RAM | 64 GB |
| SSD | 1 TB |
| GPU | GPU yenye cores 32 |
| Python | 3.10.19 |
| Batch size | 16 |
| Learning rate | 0,0001 |
| Epoch | 30 |
| Ukubwa wa picha | 324 × 324 |
| Tathmini | Uthibitishaji mtambuka wa mikunjo mitano |
Chanzo pia kinaripoti maktaba za Pandas 2.3.3, Torch 2.2.2, Scikit-learn 1.7.2, Pillow 10.2.0, Matplotlib 3.10.8, Seaborn 0.13.2, TensorFlow 2.19.1 na Tqdm 4.67.1.
Kikomo cha urudufu: Chanzo kinaripoti learning rate, batch size, idadi ya epoch na ukubwa wa picha; hata hivyo optimizer na loss function zilizotumika hazijaelezwa wazi. Zaidi ya hayo, uhusiano kamili wa utekelezaji kati ya seti zilizogawanywa mapema za mafunzo/test/uthibitishaji na uthibitishaji mtambuka wa mikunjo mitano haujaelezwa kwa kina.
Muundo wa kihisabati wa vipimo vya utendaji
Katika confusion matrix:
- \(TP\): chanya sahihi,
- \(TN\): hasi sahihi,
- \(FP\): chanya isiyo sahihi,
- \(FN\): hasi isiyo sahihi
hufafanuliwa hivyo.
Accuracy:
\[ Accuracy = \frac{TP+TN} {TP+TN+FP+FN} \]
Hupima sehemu ya sampuli zote zilizoainishwa kwa usahihi. Wakati madarasa au gharama za makosa zina usawaziko usio sawa, accuracy pekee haitoshi.
Precision:
\[ Precision = \frac{TP}{TP+FP} \]
Hupima sehemu ya sampuli zilizoainishwa kuwa chanya ambazo kwa kweli ni za darasa chanya.
Recall:
\[ Recall = \frac{TP}{TP+FN} \]
Huonyesha sehemu ya chanya halisi zilizogunduliwa na modeli.
F1-score:
\[ F1 = 2 \frac{Precision \times Recall} {Precision+Recall} \]
Ni wastani wa harmoniki wa Precision na recall, na huunganisha mielekeo miwili ya makosa katika kipimo kimoja cha utendaji.
False Positive Rate:
\[ FPR = \frac{FP}{FP+TN} \]
Huwakilisha uwiano wa sampuli hasi halisi ambazo ziliainishwa kimakosa kuwa chanya.
False Negative Rate:
\[ FNR = \frac{FN}{TP+FN} \]
Ni uwiano wa sampuli chanya halisi ambazo modeli ilizikosa.
Matthews Correlation Coefficient:
\[ MCC = \frac {TP \times TN-FP \times FN} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \]
MCC hutumia vipengele vinne vya confusion matrix kwa pamoja na kufupisha utendaji wa uainishaji wa jozi katika thamani moja.
Utofauti katika mlinganyo wa AUC wa chanzo
Chanzo kinatoa usemi ufuatao katika Mlinganyo wa 13:
\[ AUC = \frac{TP\ Rate}{FP\ Rate} \]
Hata hivyo, sehemu nyingine za makala hiyo hiyo zinaita AUC eneo chini ya ROC curve na Kielelezo cha 5 kinaonyesha thamani za AUC kupitia mikunjo ya ROC. Kwa hiyo, uandishi wa Mlinganyo wa 13 na matumizi ya AUC katika maandishi/vielelezo hayalingani kikamilifu. Verianla haibadilishi kimya kimya mlinganyo huo kuwa fomula nyingine, bali inaacha utofauti wa ndani ya chanzo uonekane.
Ni Modeli Ipi ya CNN-CBAM Iliyoonyesha Utendaji wa Juu Zaidi?
Kulingana na Jedwali la 1 na sehemu ya matokeo ya chanzo, YOLO8-CBAM ilichaguliwa kwa ujumla kuwa modeli yenye nguvu zaidi ya utafiti kwa accuracy 0,776, MCC 0,600 na AUC 0,912; hata hivyo ResNet18-CBAM ina F1-score ya juu zaidi, 0,792, na FNR ya chini zaidi, 0,163. Kwa hiyo tathmini ya “bora zaidi” inategemea kipimo cha utendaji kinachotumika na hakuna modeli moja iliyo bora katika vipimo vyote.
| Modeli | Accuracy | F1-score | MCC | FNR | FPR | AUC |
|---|---|---|---|---|---|---|
| Model 1 | 0,683 | 0,692 | 0,367 | 0,304 | 0,327 | 0,753 |
| Model 2 | 0,706 | 0,639 | 0,445 | 0,349 | 0,170 | 0,793 |
| Model 3 | 0,746 | 0,714 | 0,506 | 0,298 | 0,181 | 0,841 |
| YOLO8-CBAM | 0,776 | 0,726 | 0,600 | 0,297 | 0,063 | 0,912 |
| ResNet18-CBAM | 0,773 | 0,792 | 0,556 | 0,163 | 0,269 | 0,878 |
Dokezo la uandishi: Katika Jedwali la 1 na baadhi ya maelezo ya vielelezo ya chanzo, “Yolo8-CABM” pia limetumika kwa YOLO8-CBAM. Kwa kuwa CBAM ndiyo jina la canonical la moduli iliyoelezwa na makala, katika maelezo ya Verianla dhana ya kisayansi inadumishwa kama YOLO8-CBAM, lakini uandishi wa CABM katika chanzo unasajiliwa kama tofauti ya uandishi ndani ya chanzo.
Modeli asilia za CNN zilionyesha nini?
Kati ya modeli tatu asilia, Model 3 ilitoa matokeo ya juu zaidi: accuracy 0,746 na AUC 0,841. Accuracy ya Model 1 ni 0,683 na ya Model 2 ni 0,706.
Chanzo kinatafsiri kwamba katika CNN asilia, ubora wa uainishaji ulionyesha mwelekeo wa kupungua kadiri idadi ya tabaka ilivyoongezeka na kwamba mitandao asilia yenye kina zaidi huenda ilipata ugumu kuzoea seti ya data iliyopo. Matokeo haya yanatumika tu kwa miundo na seti ya data iliyochunguzwa; hayaungi mkono hitimisho kwamba “mitandao yenye kina ni mibaya zaidi kwa uainishaji wa ASD kwa ujumla”.
YOLO8-CBAM na ResNet18-CBAM
Miundo miwili iliyofunzwa awali ilitoa accuracy zinazokaribiana: YOLO8-CBAM 0,776, ResNet18-CBAM 0,773. Hata hivyo, wasifu wa makosa unatofautiana. Kulingana na Jedwali la 1, FPR ya YOLO8-CBAM ni 0,063 huku FPR ya ResNet18-CBAM ikiwa 0,269. Kwa upande mwingine, FNR ya ResNet18-CBAM ni 0,163, chini kuliko 0,297 ya YOLO8-CBAM.
Uasymetria huu unaonyesha kwamba uteuzi wa modeli haupaswi kufanywa kwa accuracy pekee. Ikiwa umuhimu wa jamaa wa makosa ya false positive na false negative unatofautiana katika matumizi fulani, modeli hizi mbili zinaweza kutathminiwa tofauti.
Tatizo la kulinganisha matokeo ya YOLO8 na ResNet18 katika chanzo
Jedwali la 1 la chanzo linaripoti AUC=0,912 na FPR=0,063 kwa YOLO8-CBAM; na AUC=0,878 na FPR=0,269 kwa ResNet18-CBAM. Hata hivyo, sentensi moja katika maandishi ya matokeo inahusisha AUC=0,912 na FPR=0,063 na ResNet18-CBAM; specificity ya %73,1 iliyotolewa katika sentensi hiyo hiyo inaendana na FPR=0,269.
Kuna utofauti sawa katika mpangilio wa paneli za Kielelezo cha 5: caption inaita paneli d2 ResNet18-CBAM na paneli e2 YOLO8-CBAM, lakini picha inaonyesha d2 AUC=0,9120 na e2 AUC=0,8784. Haya yanapingana na mpangilio wa modeli katika Jedwali la 1.
Kwa hiyo, katika Verianla Jedwali la 1 na thamani kuu za YOLO8-CBAM zinazojirudia katika abstract/conclusion zimechukuliwa kama source-of-truth ya ulinganisho wa nambari; ulinganishaji wa paneli na modeli katika Kielelezo cha 5 haukutumika kama data iliyothibitishwa kwa kujitegemea.
Ulinganisho wa fasihi
| Utafiti | Mbinu | Kipimo kilichotolewa katika chanzo |
|---|---|---|
| M. Das na wenz. (2025) | EfficientNet | Accuracy %84; AUC-ROC 0,89 |
| Negin na wenz. (2021) | LSTM, ConvLSTM na 3DCNN | Accuracy %72 |
| Khalaji na wenz. (2022) | ML classifier | Accuracy %75 |
| Liu na wenz. (2025) | 3D-CNN + recurrent neural network + random forest | Accuracy %77 |
| Utafiti huu | YOLO8-CBAM | Accuracy %77,6; AUC 0,912 |
Jedwali hili linaweka matokeo ya fasihi kando kwa kando kwa madhumuni ya ulinganisho wa kimuktadha. Kwa kuwa chanzo hakionyeshi kwamba tafiti zote zilitumia seti sawa ya data, mgawanyo sawa wa data na itifaki sawa ya majaribio, nambari hizi hazipaswi kufasiriwa kama mpangilio wa benchmark wa moja kwa moja uliodhibitiwa.
Je, Matokeo Haya Yanamaanisha Utambuzi wa Kliniki wa Tawahudi?
Hapana. Matokeo ya utafiti yanaonyesha utendaji wa modeli za CNN-CBAM katika kutenganisha madarasa ya ASD/non-ASD katika seti moja ya data ya picha za nyuso zilizowekewa lebo; uhalali wa uchunguzi katika makundi huru ya kliniki, utendaji wa uchunguzi wa mbele au kufaa kwa matumizi katika huduma halisi za afya haujathibitishwa. Waandishi pia wanasema kwamba seti moja ya data inapunguza uwezo wa kujumlisha na kwamba uthibitishaji zaidi unahitajika katika seti mpya za data zilizotengenezwa kwa msaada wa wataalamu.
Tatizo la seti moja ya data
Modeli inapofunzwa katika seti moja ya data, inaweza kujifunza si tu miundo ya kuona ambayo huenda inahusiana na ASD bali pia ruwaza za mandharinyuma, mwanga, kamera, kukata picha, usambazaji wa umri au sifa nyingine mahususi za mazingira ya ukusanyaji data. Tatizo hili limetajwa moja kwa moja katika sehemu ya mapungufu ya chanzo: modeli inaweza kujifunza ruwaza mahususi za seti ya data na huenda isionyeshe utendaji uleule katika usambazaji wa data usiojulikana.
Uthibitishaji wa nje
Utafiti hauripoti uthibitishaji wa modeli katika kituo tofauti cha nje au katika idadi huru ya watu wa maisha halisi. Waandishi wanapendekeza matumizi ya seti tofauti za data, miundo yenye ufanisi zaidi na data mpya za majaribio zitakazoundwa kwa mchango wa wanasaikolojia wa kliniki wenye utaalamu katika tathmini ya mapema ya ASD.
Gharama ya ukokotoaji
Chanzo pia kinaeleza kwamba uainishaji wa CNN ni wa gharama kubwa kwa ukokotoaji na unahitaji muda. Idadi kubwa ya tabaka za konvolusheni, vigezo na mafunzo yanayorudiwa yanaweza kuongeza muda wa mafunzo na inference kwa picha zenye azimio kubwa au seti kubwa za data. Hii ni kizuizi cha ziada kwa matumizi ya muda halisi au katika mazingira yenye rasilimali chache.
Hitimisho zinazoungwa mkono na zisizoungwa mkono na utafiti
| Utafiti unaunga mkono | Utafiti hauungi mkono |
|---|---|
| Katika seti ya data iliyochunguzwa YOLO8-CBAM ilipata accuracy %77,6 na AUC 0,912. | Kwamba YOLO8-CBAM ina usahihi wa utambuzi wa kliniki wa %77,6 katika idadi ya watu kwa ujumla. |
| CBAM ilitumika kama utaratibu wa umakini wa njia na anga katika miundo ya CNN iliyochunguzwa. | Kwamba CBAM itaongeza utendaji kwa uhakika katika seti zote za data za ASD. |
| Grad-CAM ilionyesha umuhimu wa jamaa ambao modeli iliupa maeneo fulani ya uso. | Kwamba imethibitishwa macho, mdomo au maeneo mengine ya uso ni biomarka za kliniki za ASD. |
| Kati ya modeli asilia, Model 3 ilitoa accuracy na AUC za juu zaidi. | Kwamba CNN zenye tabaka chache ni bora kwa ujumla. |
| YOLO8-CBAM na ResNet18-CBAM zilizofunzwa awali zilitoa matokeo ya juu zaidi ya accuracy kuliko modeli tatu asilia. | Kwamba modeli zilizofunzwa awali zitakuwa bora katika matatizo yote ya picha za nyuso. |
| Seti moja ya data inapunguza matumizi ya jumla. | Kwamba modeli imethibitishwa nje kwa matumizi halisi ya kliniki. |
Maelezo ya Chanzo na Mbinu
| Kichwa asilia | Multi-Architecture Convolutional Neural Networks with Attention Mechanisms for Autism Spectrum Disorder Classification |
|---|---|
| Waandishi | Ioana Diana Moldovanu; Ecaterina Popa; Simona Moldovanu |
| Mwandishi wa mawasiliano | Simona Moldovanu |
| Taasisi 1 | Department of Psychology, Danubius International University, Galati, Romania |
| Taasisi 2 | Department of Computer Science and Information Technology, Faculty of Automation, Computers, Electrical Engineering and Electronics, “Dunarea de Jos” University of Galati, Romania |
| Taasisi 3 | The Modelling & Simulation Laboratory, “Dunarea de Jos” University of Galati, Romania |
| DOI | 10.3390/aieduc2020021 |
| Jarida | AI in Education |
| Jina fupi la jarida | AI Educ. |
| Mchapishaji | MDPI, Basel, Switzerland |
| Juzuu / toleo | 2 / 2 |
| Nambari ya makala | 21 |
| Aina ya chanzo | Article |
| Tarehe ya kupokelewa | 14 Januari 2026 |
| Marekebisho | 12 Machi 2026 |
| Kukubaliwa | 24 Aprili 2026 |
| Kuchapishwa | 5 Juni 2026 |
| Mapitio ya rika | Makala ya jarida iliyopitiwa na rika |
| Leseni | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Ufadhili | Hakuna ufadhili wa nje |
| Institutional Review Board | Not applicable |
| Ridhaa iliyoarifiwa | Not applicable |
| Upatikanaji wa data | Seti ya data iliyotumika katika uainishaji inapatikana kupitia Zenodo; makala inataja tarehe ya kufikiwa 18 Desemba 2025. |
| Mgongano wa maslahi | Waandishi hawakuripoti mgongano wa maslahi. |
Dokezo la data/maadili: Sehemu za Institutional Review Board na informed consent katika makala zimeandikwa “Not applicable”. Hata hivyo, Data Availability Statement inaeleza kuwa uchakataji wa picha ulifanywa kwa kufuata Azimio la Helsinki na kwamba itifaki ya chanzo iliidhinishwa na Duke University Medical Center Center for Developmental Epidemiology kwa nambari R01 MH081025. Kauli hizi huenda zinahusiana na muktadha wa matumizi upya ya seti ya data iliyopo/ya pili; makala haielezi kwa kina uhusiano kati ya kauli hizo mbili.
Dokezo la chanzo cha data cha Kielelezo cha 6: Ingawa sehemu ya seti ya data ya makala inaunganisha data ya uainishaji na rekodi ya Zenodo, picha ya mfano katika Kielelezo cha 6 iliyotumika kwa Grad-CAM imetajwa kuwa kutoka National Institute of Mental Health Child Emotional Faces Picture Set (NIMH-ChEFS). Makala haifafanui kwa kina uhusiano wa picha hii na seti kuu ya data ya uainishaji.
Michango ya waandishi: Ioana Diana Moldovanu — uundaji wa dhana, uthibitishaji, utafiti na usimamizi wa data; Ecaterina Popa — metodolojia, uchanganuzi rasmi, uandishi wa rasimu ya kwanza na uoneshaji; Simona Moldovanu — programu, rasilimali, mapitio/uhariri, usimamizi na usimamizi wa mradi. Inaelezwa kuwa waandishi wote walisoma na kuidhinisha toleo lililochapishwa.
Dokezo la ulinganifu wa ndani ya chanzo: Kuna kutolingana kati ya Jedwali la 1, maandishi ya matokeo na Kielelezo cha 5, hasa katika kuoanisha thamani za AUC/FPR za YOLO8-CBAM na ResNet18-CBAM. Zaidi ya hayo, kifupi CBAM kimeandikwa CABM katika baadhi ya maeneo. Verianla imetumia Jedwali la 1 kama chanzo kikuu katika ulinganisho wa nambari na imeacha migongano ionekane.
Dokezo la mlinganyo: Chanzo kinaandika AUC kama TP Rate / FP Rate katika Mlinganyo wa 13; katika makala hiyo hiyo AUC inatumika kama eneo chini ya ROC curve. Tofauti hii ya ndani ya chanzo haijaonyeshwa kana kwamba imesahihishwa.
Dokezo la urudufu: Ingawa chanzo kinaripoti batch size, learning rate, epoch, ukubwa wa picha, maktaba kuu za programu na uthibitishaji mtambuka wa mikunjo mitano, hakielezi wazi optimizer na loss function. Uhusiano wa utekelezaji kati ya mgawanyo thabiti wa mafunzo/test/uthibitishaji na uthibitishaji mtambuka wa mikunjo mitano pia haujaelezwa kwa kina.
Kikomo kikuu cha kimetodolojia: Kwa sababu utafiti unategemea seti moja ya data, hauna uthibitishaji huru wa nje na utendaji wa mbele katika matumizi halisi ya kliniki haujajaribiwa, metrika za modeli zilizoripotiwa zinapaswa kufasiriwa kama utendaji wa uainishaji ndani ya mipaka ya seti ya data.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *