


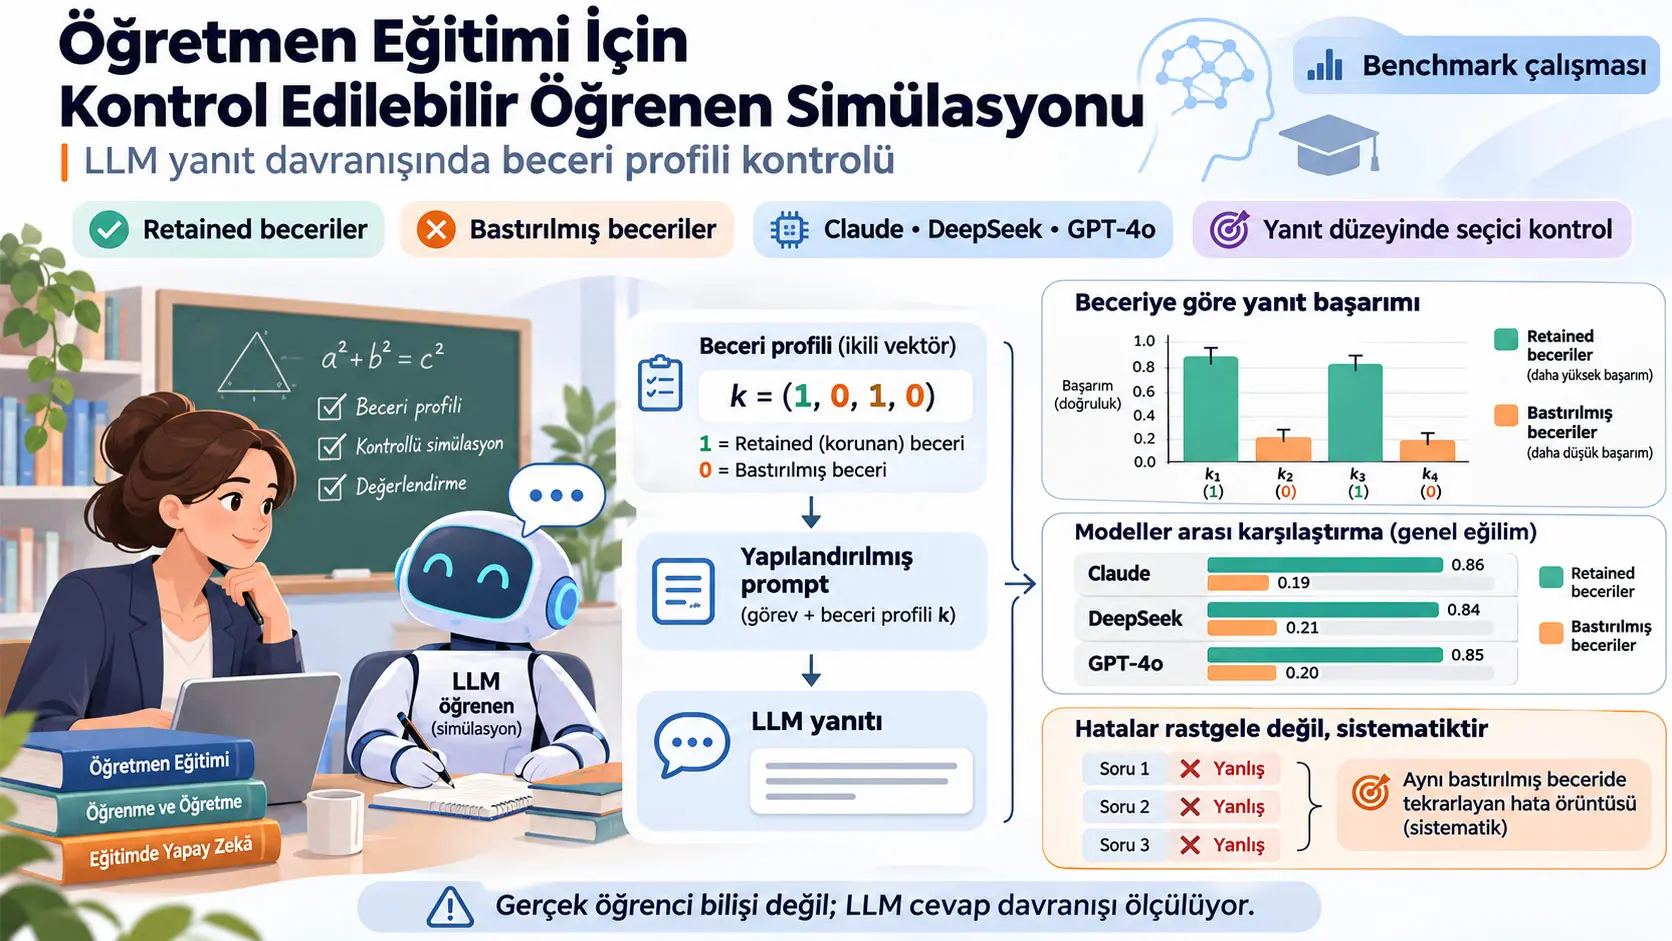
Kontrol edilebilir öğrenen simülasyonu (controllable learner simulation), bir büyük dil modelinin yalnız genel olarak “daha zayıf öğrenci” gibi davranmasını değil, önceden tanımlanmış bir beceri profilinde bazı müfredat becerilerini korurken belirli becerilerde seçici biçimde daha düşük yanıt performansı göstermesini hedefleyen bir eğitimsel simülasyon problemidir. Bu çalışma, okul matematiği bağlamında böyle bir davranışın ölçülüp ölçülemeyeceğini araştıran tamamen hesaplamalı bir benchmark çalışmasıdır. Araştırmacılar Claude, DeepSeek ve GPT-4o endpoint'lerini; Grade 4 ve Grade 5 matematik becerileri üzerinde, retained ve suppressed becerileri gösteren ikili beceri vektörleri kullanarak değerlendirmiştir.
Çalışmanın temel sonucu, üç modelin de belirli becerileri bastırırken başka becerileri görece koruyan seçici yanıt profilleri üretebildiği; ancak bu kontrolün modelden modele ciddi biçimde değiştiğidir. Daha yüksek temel matematik başarısı daha güçlü kontrol edilebilirlik anlamına gelmemiştir. Claude, raporlanan genel ölçütlerde retained ve suppressed beceriler arasındaki en temiz ayrımı üretirken; DeepSeek bastırılması istenen becerilerde daha fazla artık performans göstermiş, GPT-4o ise bazı becerileri güçlü bastırmasına rağmen retained becerilerde daha fazla hata üretmiştir.
Prompt tasarımı da belirleyicidir. Yalnız örnek gösteren few-shot yaklaşımı, hedef beceri profiline en yüksek uyumsuzluğu üretmiştir: RMSE aralığı 0.40–0.61'dir. Retained ve suppressed becerileri açıkça söyleyen rule-based ve combined prompt'lar ise 0.19–0.39 aralığında daha düşük RMSE üretmiştir. Kaynak, explicit instruction bileşenini kontrol edilebilirliğin ana sürücüsü olarak yorumlamaktadır; kurallara örnek eklemenin kuralların tek başına kullanılmasına göre sınırlı ek katkı sağladığı görülmüştür.
İndüklenen yanlış cevaplar da tamamen rastgele değildir. Üç bağımsız model, baseline'da doğru çözdükleri fakat suppression altında yanlış cevapladıkları ortak maddelerde aynı yanlış seçeneğe Grade 4'te %39, Grade 5'te kaynak metne göre %35 oranında yönelmiştir; Grade 5 Figure 10 çubuk etiketi 0.34 gösterdiğinden bu sonuç yaklaşık %34–35 olarak okunmalıdır. Üçlü yakınsama için shuffle-null oranları sırasıyla yaklaşık %21 ve %11'dir. Bununla birlikte bu yakınsama gerçek öğrencilerle aynı bilişsel mekanizmayı veya gerçek bir misconception'ı kanıtlamaz; dört seçenekli soruların kasıtlı olarak makul distractor'lar içermesi de aynı yanlış yanıta yönelmeyi etkileyebilir.
En önemli yorum sınırı budur: çalışma gerçek öğrencilerin bilgisini, düşünme sürecini veya öğretmen eğitiminin etkililiğini ölçmemektedir. Deneyler tek turlu, dört seçenekli LLM yanıtları üzerindedir. Binary target profile, insan öğrencinin gerçek zihinsel mastery state'i değildir; yalnız modele verilen bir atanmış yanıt-performans koşuludur. Bu nedenle çalışma, “bu LLM'ler gerçek öğrencileri doğru simüle ediyor” sonucunu değil, “belirli cevap düzeyi beceri profillerinin ne kadar seçici biçimde oluşturulabildiği ölçülebilir” sonucunu desteklemektedir.
Kontrol Edilebilir Öğrenen Simülasyonu Nedir?
Kontrol edilebilir öğrenen simülasyonu, bir LLM'nin önceden tanımlanmış retained ve suppressed müfredat becerilerine göre cevap davranışı göstermesini ve bu davranışın hedef profile ne kadar uyduğunun nicel olarak ölçülmesini amaçlayan benchmark problemidir; bu çalışma öğrenci bilişinin tamamını değil, yalnız answer-level skill-profile control özelliğini test etmektedir.
Neden “yanlış yapan öğrenci” üretmek yeterli değildir?
Bir öğretmen adayı için rastgele yanlış yapan bir simülatörün eğitsel değeri sınırlıdır. Gerçek öğretim ortamında önemli olan yalnız öğrencinin yanlış cevap vermesi değil, belirli alanlarda güçlü, belirli alanlarda zayıf ve nispeten tutarlı bir performans örüntüsü göstermesidir.
Kaynağın öğretmen eğitimi açısından kurduğu kavramsal zincir şöyledir:
öğretmen hazırlığı → simüle edilmiş öğrenciler → kontrollü beceri profilleri → tekrarlanabilir amaçlı pratik → daha iyi tanı → daha duyarlı öğretim
Ancak çalışma bu zincirin yalnız “simüle edilmiş öğrenci → kontrollü beceri profili” bağlantısını ölçmektedir. Tekrarlı pratiğin gerçekten öğretmenin tanı becerisini geliştirdiği veya bunun daha iyi öğretime dönüştüğü bu deneyde test edilmemiştir.
Kontrol edilebilirlik ile yüksek performans neden aynı şey değildir?
Standart LLM benchmark'larında modelin daha fazla soruyu doğru cevaplaması çoğunlukla daha iyi performans anlamına gelir. Bu çalışmada amaç farklıdır. Eğer hedef profil bir becerinin retained, diğerinin suppressed olmasını istiyorsa modelin her soruyu doğru çözmesi başarısızlık sayılabilir; çünkü model istenen kısmi performans profilini gerçekleştirmemiş olur.
Bu nedenle:
- Capability: Model matematiği ne kadar iyi çözebiliyor?
- Controllability: Model, kendisine verilen retained/suppressed profile ne kadar seçici biçimde uyabiliyor?
iki ayrı değerlendirme eksenidir.
Çalışmanın üç model üzerindeki sonucu da bu ayrımı desteklemektedir: yüksek baseline matematik performansı, en güçlü selective suppression ile otomatik olarak birlikte gitmemiştir.
Beceri Profili Vektörü Ne Anlama Geliyor?
Beceri profili vektörü, her müfredat becerisi için 1 değerini “retained”, 0 değerini “suppressed” olarak atayan ikili hedef vektördür; bu vektör ölçülmüş insan bilişi değil, LLM'nin cevap davranışında gerçekleştirmesi istenen deneysel performans koşuludur.
Formal tanım
Bir sınıf düzeyi için müfredat beceri aileleri:
\[ \mathcal{S}=\{s_1,\ldots,s_K\} \]
olarak tanımlanır.
Hedef profil:
\[ \mathbf{k}=(k_1,\ldots,k_K)\in\{0,1\}^{K} \]
şeklindedir.
- \(k_i=1\): \(s_i\) becerisi retained olarak atanmıştır.
- \(k_i=0\): \(s_i\) becerisi suppressed olarak atanmıştır.
\(K\), değerlendirmeye dahil edilen beceri ailesi sayısıdır ve fiziksel birim taşımaz.
Örneğin:
\[ \mathbf{k}=(1,0,0,1) \]
profili dört becerili bir durumda birinci ve dördüncü becerilerin korunması, ikinci ve üçüncü becerilerin bastırılması gerektiğini söyler.
Kaynak özellikle şu ayrımı yapmaktadır: bu vektör “öğrencinin gerçekten bildiği ve bilmediği şeyler” değildir. Bu, modele verilen bir assigned curricular performance condition'dır.
Retained ve suppressed kümeleri
Retained becerilerin indeks kümesi:
\[ R=\{i:k_i=1\} \]
suppressed becerilerin indeks kümesi:
\[ F=\{i:k_i=0\} \]
olarak tanımlanır.
Bir beceri için baseline accuracy:
\[ a_i^{0}=A_{\mathrm{base}}(s_i) \]
ve hedef profil altında gözlenen accuracy:
\[ a_i^{*}=A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) \]
olarak gösterilir.
\(a_i^{0}\), modelin perfect-student yani bütün becerilerin retained olduğu koşuldaki başarı oranıdır. \(a_i^{*}\), belirli bir target profile altında aynı beceride gözlenen başarıdır.
Retained ve suppressed ortalama performans
Kaynak iki temel ortalamayı kullanır:
\[ a_R(\mathbf{k}) = \frac{1}{|R|} \sum_{i\in R}a_i^{*} \]
\[ a_F(\mathbf{k}) = \frac{1}{|F|} \sum_{i\in F}a_i^{*} \]
\(a_R\), retained olarak atanmış becerilerdeki ortalama doğruluğu; \(a_F\), suppressed olarak atanmış becerilerde kalan ortalama doğruluğu gösterir.
İdeal seçici kontrol mantığında \(a_R\)'nin yüksek, \(a_F\)'nin düşük olması beklenir. Fakat kaynak “suppressed = sıfır performans” varsayımını yapmamaktadır; gerçek sonuçlar bastırmanın dereceli olduğunu göstermiştir.
MathCAMPS veri setinin rolü
Çalışma, U.S. Common Core standartlarına göre etiketlenmiş matematik sorularından oluşan MathCAMPS veri setini kullanmaktadır. Benchmark Grade 1–8 için oluşturulmuş ve her grade-specific dataset 99 çoktan seçmeli soru içermektedir.
Sorular dört seçeneklidir. Distractor'lar doğru değere sayısal olarak yakın veya hedef beceri açısından kavramsal olarak makul yanlış cevaplar olacak şekilde düzenlenmiştir.
Ana ayrıntılı controllability deneyleri bütün sekiz sınıf üzerinde değil, yalnız Grade 4 ve Grade 5 üzerinde yapılmıştır.
Grade 4'te kullanılan beceriler
- S4.1: Measurement and Data
- S4.2: Number and Operations — Base
- S4.3: Number and Operations — Fractions
- S4.4: Operations and Algebraic
Dört beceri bulunduğundan bütün ikili profillerin sayısı:
\[ 2^4=16 \]
olur.
Grade 5'te kullanılan beceriler
- S5.1: Number and Operations — Base
- S5.2: Number and Operations — Fractions
- S5.3: Operations and Algebraic
Üç beceri için:
\[ 2^3=8 \]
farklı hedef profil vardır.
Böylece ayrıntılı analiz toplam:
\[ 16+8=24 \]
farklı retained/suppressed profil içerir.
Veri ön işlemede değiştirilen sorular
Perfect-student koşulunda modellerin tümünün veya çoğunun yanlış yaptığı maddeler, hedeflenen “unutma” davranışından bağımsız biçimde sorunlu soru olabileceği gerekçesiyle önceden tanımlanmış kalite kontrolü kapsamında işaretlenmiştir.
Bu süreç sonunda:
- Grade 4'te 7 madde,
- Grade 5'te 12 madde
aynı Common Core standardından alternatif maddelerle değiştirilmiştir.
Bu nokta metodolojik olarak önemlidir çünkü model çıktılarının item curation'da kullanılması outcome-aware curation eleştirisine açık olabilir. Yazarlar bunun sonuçları yönlendirip yönlendirmediğini ayrıca test etmiş ve değiştirilen bütün maddeler çıkarıldığında model sıralamasının korunduğunu, herhangi bir selectivity değerindeki en büyük değişimin 0.04 olduğunu bildirmiştir.
Beceri düzeyinde doğruluk
Temel gözlenen büyüklük:
\[ Acc(s_i)=\frac{c_i}{n_i} \]
şeklindedir.
- \(c_i\): \(s_i\) becerisine etiketlenmiş sorularda doğru yanıt sayısıdır.
- \(n_i\): aynı beceri için değerlendirilen toplam madde sayısıdır.
- \(Acc(s_i)\): 0 ile 1 arasında boyutsuz bir doğruluk oranıdır.
Bu değer, profil düzeyindeki diğer metriklerin temel girdisidir.
Relative Loss neyi ölçüyor?
Kaynak relative loss'u:
\[ L_i= \max\left( 0, \frac{a_i^{0}-a_i^{*}} {\max(a_i^{0},\varepsilon)} \right) \]
şeklinde tanımlar.
\(\varepsilon>0\), paydanın sıfır olmasını önleyen küçük bir sabittir.
Bu metrik baseline'a göre oransal performans kaybını ölçer.
- Suppressed beceriler için yüksek \(L_i\), daha güçlü bastırma anlamına gelir.
- Retained beceriler için \(L_i\)'nin sıfıra yakın olması istenir; çünkü korunması gereken performansın kaybolmadığını gösterir.
RMSE hedef profile uyumu nasıl ölçüyor?
Kaynakta:
\[ RMSE(\mathbf{k}) = \sqrt{ \frac{1}{K} \sum_{i=1}^{K} (k_i-a_i^{*})^2 } \]
olarak tanımlanır.
RMSE, binary target vector ile gözlenen continuous skill-accuracy profile arasındaki ortalama karesel sapmanın kareköküdür.
Örneğin retained bir beceride \(k_i=1\) iken gözlenen doğruluk 1'e yakınsa hata küçüktür. Suppressed beceride \(k_i=0\) iken doğruluk 0'a yaklaştıkça yine hata küçülür.
Dolayısıyla daha düşük RMSE daha iyi hedef-profil uyumu demektir.
Ancak RMSE retained performansının korunmasıyla suppressed performansının azaltılmasını tek sayıya sıkıştırdığı için çalışma onu özellikle prompt-strategy ablation'da kullanmakta; ana kontrollülük yorumunu yalnız RMSE'ye dayandırmamaktadır.
Controllability Score C(k) Ne Ölçüyor?
Controllability score \(C(\mathbf{k})\), retained olarak işaretlenen becerilerde yüksek doğruluğu ve suppressed olarak işaretlenen becerilerde düşük doğruluğu aynı formülde ödüllendirerek gözlenen cevap profilinin hedef ikili profile ne kadar uyduğunu 0–1 aralığında ölçer; \(C=1\) tam hedef uyumunu ifade eder.
Kaynak formülü:
\[ C(\mathbf{k}) = \frac{1}{K} \sum_{i=1}^{K} \left[ k_i a_i^{*} + (1-k_i)(1-a_i^{*}) \right] \]
şeklindedir.
Formülü adım adım okumak
Eğer \(k_i=1\), yani beceri retained ise:
\[ k_i a_i^{*}=a_i^{*} \]
ve ikinci terim sıfır olur. Dolayısıyla yüksek doğruluk skoru yükseltir.
Eğer \(k_i=0\), yani beceri suppressed ise:
\[ (1-k_i)(1-a_i^{*})=1-a_i^{*} \]
olur. Bu kez düşük doğruluk skoru yükseltir.
Bu nedenle formül “model ne kadar doğru?” sorusunu değil, “model istenen retained/suppressed davranışına ne kadar uydu?” sorusunu cevaplar.
Cross-skill influence neden gerekli?
Bir beceriyi bastırmak kolay görünebilir; ancak bu sırada korunması gereken diğer beceriler de zarar görüyorsa kontrol gerçekten seçici değildir.
Kaynak bu durumu cross-skill influence matrisi \(\Delta_{ij}\) ile inceler.
Doğrudan suppression etkisi:
\[ \Delta_{ii} = \frac{1}{|\mathcal{K}_i|} \sum_{\mathbf{k}\in\mathcal{K}_i} A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) - A_{\mathrm{base}}(s_i) \]
ile değerlendirilir.
Burada:
\[ \mathcal{K}_i=\{\mathbf{k}:k_i=0\} \]
yani \(s_i\)'nin suppressed olduğu profiller kümesidir.
Başka bir retained beceri \(s_j\) üzerindeki collateral influence:
\[ \Delta_{ij} = \frac{1}{|\mathcal{K}_{ij}|} \sum_{\mathbf{k}\in\mathcal{K}_{ij}} A_{\mathrm{ctrl}}(s_j\mid\mathbf{k}) - A_{\mathrm{base}}(s_j), \qquad i\neq j \]
ve:
\[ \mathcal{K}_{ij} = \{\mathbf{k}:k_i=0,\;k_j=1\} \]
şeklindedir.
Önemli ayrıntı, off-diagonal etkinin yalnız \(s_i\) suppressed iken \(s_j\)'nin retained olduğu profiller üzerinde hesaplanmasıdır. Böylece \(s_j\)'nin de kasıtlı olarak bastırıldığı profiller collateral-damage hesabına karışmaz.
Kaynakta doğrudan suppression'ın model/koşul düzeyindeki etkisi büyük ve negatifken retained beceriler üzerindeki off-diagonal değişiklikler küçüktür. Robustness analizinde mean diagonal değer yaklaşık −0.47, mean off-diagonal magnitude ise 0.03 olarak bildirilmiş ve fark Mann–Whitney \(U\) testiyle \(p<10^{-10}\) düzeyinde bulunmuştur.
Prediction Score nedir?
İkincil kalibrasyon metriği:
\[ PS(\mathbf{k}) = a_R^{actual}(\mathbf{k}) - a_R^{expected}(\mathbf{k}) \]
şeklindedir.
Değer:
- 0'a yakınsa observed retention ile calibration expectation uyumludur;
- pozitifse retained performans beklenenden daha iyidir;
- negatifse retained performans beklenenin altındadır.
Çalışma Prediction Score'u ana sonuç metriği olarak değil, correlation structure'a duyarlı yardımcı bir diagnostic olarak kullanmaktadır.
Gaussian calibration formülü
Appendix A'da beceri performans vektörü için:
\[ \mathbf{a}\sim\mathcal{N}(\boldsymbol{\mu},\boldsymbol{\Sigma}) \]
Gaussian approximation kullanılır.
Suppressed küme \(F\), retained küme \(R\) ise hedeflenen forgetting altında retained performansın conditional expectation'ı:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] = \boldsymbol{\mu}_R - \boldsymbol{\Sigma}_{RF} \boldsymbol{\Sigma}_{FF}^{-1} \boldsymbol{\mu}_F \]
olarak yazılır.
Burada:
- \(\boldsymbol{\mu}_R\): retained skill performance ortalamaları,
- \(\boldsymbol{\mu}_F\): suppressed skill performance ortalamaları,
- \(\boldsymbol{\Sigma}_{RF}\): retained ile suppressed beceriler arasındaki cross-covariance block,
- \(\boldsymbol{\Sigma}_{FF}\): suppressed beceriler arasındaki covariance block'tur.
Eğer cross-skill coupling çok zayıfsa:
\[ \boldsymbol{\Sigma}_{RF}\approx0 \]
ve dolayısıyla:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] \approx \boldsymbol{\mu}_R \]
olur.
Kaynak özellikle bunun gerçek öğrenci bilişinin üretici modeli olmadığını vurgular. Bu Gaussian yaklaşım yalnız expected-versus-observed retention kalibrasyonu için kullanılan analitik bir yaklaşımdır.
Çalışmanın Yöntemi ve Bulguları
Deney tamamen hesaplamalıdır
Çalışmaya öğrenci, öğretmen veya başka insan katılımcı dahil edilmemiştir. Bütün gözlemler dil modellerinin ürettiği tek seçenekli yanıtların değerlendirilmesidir.
Değerlendirilen model endpoint'leri
| Model | Kaynakta verilen identifier | Çalışmadaki rol |
|---|---|---|
| Claude | claude-sonnet-4-5-20250929 | Güçlü instruction-following özelliğiyle yüksek-compliance karşılaştırma noktası |
| DeepSeek | DeepSeek-chat | Güçlü matematik performansının kontrollülükle aynı şey olup olmadığını inceleyen karşılaştırma |
| GPT-4o | gpt-4o | Yaygın kullanılan genel amaçlı LLM karşılaştırması |
Bütün inference işlemlerinde:
\[ temperature=0 \]
kullanılmıştır.
Bu nedenle aynı deneyde stochastic sampling variability özellikle azaltılmıştır. Appendix A'daki profil varyasyonu da tekrarlar arası sampling noise değil, farklı student-profile koşulları arasındaki değişimi temsil etmektedir.
Kaynak ayrıca DeepSeek-chat ve gpt-4o alias'larının date-pinned olmadığını ve zaman içinde provider tarafında değişebileceğini belirtmektedir. Dolayısıyla sonuçların model ailesinin bütün sürümlerine genellenmesi uygun değildir.
Üç prompt stratejisi
| Strateji | İçerik | Kaynak sonucu |
|---|---|---|
| Rule-based | Retained becerilerde doğru, suppressed becerilerde tutarlı hata davranışını açıkça belirten kurallar | Düşük alignment error; combined ile benzer |
| Example-only / few-shot | Doğru ve yanlış davranışı gösteren örnekler; değerlendirme verisinden ayrı tutulmuştur | En yüksek RMSE, 0.40–0.61 |
| Combined | Açık kurallar + örnekler | RMSE 0.19–0.39 aralığındaki rule-bearing stratejilerden biri |
Claude için rule-based RMSE, combined'dan biraz daha düşük raporlanmıştır:
- Grade 4: rule-based 0.19, combined 0.24;
- Grade 5: rule-based 0.20, combined 0.22.
Dolayısıyla “combined her zaman en iyi prompt'tur” sonucu desteklenmez. Kaynağın daha doğru yorumu, açık beceri-durumu talimatının few-shot örneklerinden daha önemli olduğudur.
Ana deney akışı
- Her model perfect-student yani tüm becerilerin retained olduğu koşulda test edildi.
- Binary skill vector prompt içine yerleştirilerek retained ve suppressed hedef profilleri tanımlandı.
- Aynı profiller rule-based, example-only ve combined prompting altında değerlendirildi.
- Yanıtlar profile-level ve skill-level metriklere dönüştürüldü.
Grade 4 için 16 profil ve Grade 5 için 8 profil exhaustive biçimde değerlendirilmiştir.
Combined prompt ana karşılaştırmasında üç model ve her grade'deki 99 soru birlikte:
\[ (16\times99+8\times99)\times3=7128 \]
model–question response event üretmiştir.
Bu 7128 değeri yalnız core combined-prompt comparison içindir; perfect-student baseline ve prompt ablation deneyleri dahil edildiğinde tüm çalışma daha büyüktür.
İstatistiksel çıkarım birimi nedir?
Kaynak deterministic decoding altında her grade için sabit 99 maddeyi inference birimi olarak kullanmaktadır.
Aynı maddede perfect ve all-forgotten durumları eşleştirilmiş olduğundan retained-versus-forgotten değişimi için exact McNemar test kullanılmıştır.
McNemar testi, aynı birimin iki koşuldaki binary sonucunu karşılaştırır. Buradaki temel mantık “kaç soru her iki koşulda da aynı?” yerine, özellikle:
- baseline'da doğru olup suppression altında yanlış olan,
- baseline'da yanlış olup suppression altında doğru olan
discordant pair sayılarının dengesini test etmektir.
Kaynak bütün model ve grade kombinasyonlarında perfect vs all-forgotten farkları için:
\[ p<10^{-5} \]
ve Cohen's \(h\) için:
\[ 0.76\leq h\leq1.62 \]
aralığını raporlamaktadır.
GEE lojistik model
Population-averaged analiz:
\[ correct \sim target\_state \times model + grade \]
formundaki logistic generalized estimating equations (GEE) modeliyle yapılmıştır.
Modelde:
- 198 madde iki grade boyunca cluster olarak kullanılmıştır,
- binomial family kullanılmıştır,
- working correlation exchangeable olarak seçilmiştir,
- robust sandwich standard errors kullanılmıştır.
Reference model Claude için retained bir beceride doğru cevap odds'unun forgotten beceriye göre yaklaşık 40 kat olduğu tahmin edilmiş; confidence interval'ın tamamı 1'in çok üzerinde ve \(p<10^{-30}\) olarak raporlanmıştır.
Bu “Claude retained skill'de 40 kat daha yüksek doğruluk oranına sahiptir” demek değildir. Odds ratio, doğrudan probability ratio değildir. Kaynak burada doğru cevap odds'undaki değişimi raporlamaktadır.
Target-state × model interaction'larının anlamlı olması, retained–forgotten ayrımının modelden modele değiştiğini desteklemektedir.
Model farkları
Forgotten-skill accuracy için yedi grade-by-skill block üzerinde Friedman testi:
\[ \chi^2=11.1,\qquad p=0.004 \]
sonucunu vermiştir.
Holm-düzeltilmiş pairwise Wilcoxon testleri:
- Claude–DeepSeek,
- DeepSeek–GPT-4o
karşılaştırmalarını adjusted \(p<0.05\) ile ayırmıştır.
Kaynak burada raporlanmayan üçüncü ikili karşılaştırmanın da otomatik olarak anlamlı olduğu sonucunu vermemektedir.
Prompt stratejileri arasında istatistiksel fark
Altı model-by-grade block üzerindeki Friedman RMSE testi:
\[ \chi^2=9.3,\qquad p=0.009 \]
sonucunu üretmiştir.
Ancak yalnız altı block olduğu için exact pairwise signed-rank testlerin çözünürlüğü düşüktür. Yazarlar prompt-strategy yorumunu bu nedenle pairwise p değerlerinden çok omnibus test ve açık RMSE aralıklarına dayandırmaktadır.
Selectivity index
Kaynak selectivity index'i retained accuracy ile forgotten accuracy arasındaki fark olarak kullanmaktadır.
4000 item-level bootstrap resampling ile hesaplanan %95 percentile interval'ları bütün model–grade kombinasyonlarında sıfırın üzerinde kalmış ve index yaklaşık:
\[ 0.35\text{–}0.70 \]
aralığında raporlanmıştır.
Suppressed becerilerde talimat gereği yanlış cevap verme oranı yani compliance rate ise:
\[ 0.56\text{–}0.82 \]
aralığındadır.
Retained ve suppressed performans baseline'a göre ne kadar ayrıldı?
| Model | Grade | Retained / baseline | Suppressed / baseline |
|---|---|---|---|
| Claude | 4 | %101.2 | %34.1 |
| Claude | 5 | %97.4 | %33.4 |
| DeepSeek | 4 | %98.8 | %59.9 |
| DeepSeek | 5 | %98.3 | %51.9 |
| GPT-4o | 4 | %94.1 | %29.7 |
| GPT-4o | 5 | %100.0 | %50.5 |
Bu tablo önemli bir ayrımı gösterir. Yalnız suppressed accuracy'nin en düşük olmasına bakmak yeterli değildir. Örneğin GPT-4o bazı koşullarda güçlü suppression üretirken retained becerilerde de daha fazla kayıp gösterebilir. İyi controllability, suppression + retention birlikte değerlendirilerek anlaşılır.
Suppression beceri ailesine göre değişiyor
| Grade | Model | S1 | S2 | S3 | S4 |
|---|---|---|---|---|---|
| 4 | Claude | 0.43 | 0.39 | 0.10 | 0.34 |
| 4 | DeepSeek | 0.50 | 0.48 | 0.54 | 0.63 |
| 4 | GPT-4o | 0.19 | 0.21 | 0.28 | 0.14 |
| 5 | Claude | 0.23 | 0.24 | 0.52 | — |
| 5 | DeepSeek | 0.56 | 0.30 | 0.56 | — |
| 5 | GPT-4o | 0.30 | 0.18 | 0.33 | — |
Bu sonuçlar controllability'nin tek bir global “itaat” özelliği olmadığını; model ve curricular skill family etkileşimine bağlı olduğunu göstermektedir.
Tek bir profil örneği seçici kontrolü nasıl gösteriyor?
Claude Grade 4 için kaynakta verilen:
\[ [1,0,0,1] \]
profilinde hedef, S4.1 ve S4.4'ü retained; S4.2 ve S4.3'ü suppressed tutmaktır.
| Beceri | Hedef durum | Gözlenen accuracy |
|---|---|---|
| S4.1 | Retained | 0.92 |
| S4.2 | Suppressed | 0.32 |
| S4.3 | Suppressed | 0.12 |
| S4.4 | Retained | 0.96 |
Bu örneğin bilimsel anlamı modelin genel olarak kötüleşmesi değildir. Aynı profil içinde retained iki beceri yüksek kalırken targeted iki beceride performans keskin biçimde düşmektedir.
Suppression derecelidir, mutlak değildir
Bütün model, grade ve profiller birlikte ele alındığında forgotten-skill accuracy ortalaması:
\[ 0.35 \]
olarak raporlanmıştır.
Forgotten-skill örneklerinin %95'i:
\[ 0.1\text{–}0.9 \]
aralığındadır.
Bu nedenle “unutulan beceri tamamen yok oldu” ifadesi yanlış olur. Çalışmada suppression, partial and graded performance üretmektedir.
Signal-detection bakış açısı
Kaynak instruction-following'i signal-detection benzetmesiyle de inceler:
- Hit rate: suppressed beceride talimat gereği yanlış cevap verilen maddelerin oranı.
- False-alarm rate: retained beceride yanlış cevap verilen maddelerin oranı.
İdeal kontrollü öğrenci simülatörü yüksek hit rate fakat düşük false-alarm rate üretmelidir.
Claude için sensitivity index \(d'\) yaklaşık 2.1 olarak raporlanmış ve değerlendirilen üç model arasında en temiz ayrımın Claude'da görüldüğü belirtilmiştir.
Seçici Beceri Bastırma Gerçek Öğrenci Yanılgısını Kanıtlıyor mu?
Hayır. Modellerin aynı yanlış seçeneğe beklenenden sık yönelmesi hataların rastgele olmadığını destekler, ancak gerçek öğrencilerle aynı bilişsel mekanizmanın veya gerçek bir misconception'ın üretildiğini kanıtlamaz; çalışma bunun için öğretmen değerlendirmesi ve gerçek öğrenci yanıt dağılımlarıyla doğrulama gerektiğini açıkça belirtmektedir.
Yanlış cevap yakınsaması
Analiz yalnız bütün modellerin perfect-student durumunda doğru cevaplayabildiği maddelere sınırlandırılmıştır. Böylece suppression sonrasında ortaya çıkan yanlışın baseline'da zaten çözülemeyen bir sorudan gelmesi engellenmeye çalışılmıştır.
| Karşılaştırma | Grade 4 observed | Grade 5 observed | Shuffle-null |
|---|---|---|---|
| Üç model aynı yanlış cevap | %39 | Metin: %35; Figure 10 etiketi: %34 | Yaklaşık %21 / %11 |
| Pairwise agreement | %56–%59 | Yaklaşık %31–%40 | |
Bütün bu karşılaştırmalar için:
\[ p<0.001 \]
raporlanmıştır.
Permutation null, her modelin kendi yanlış cevap harfi sıklığını korur. Böylece belirli bir modelin örneğin “A” seçeneğini genel olarak fazla seçmesi, sahte bir model-arası yakınsama olarak yorumlanmamaya çalışılır.
Permutation p değeri kaynakta:
\[ p= \frac{ 1+\#\{\mathrm{null}\geq\mathrm{observed}\} }{ 1+5000 } \]
şeklinde hesaplanmıştır.
5000 permütasyon kullanılmıştır.
28 ortak yanlış cevap hangi kategorilere ayrıldı?
| Hata kategorisi | Sayı | Kaynak örneğinin anlamı |
|---|---|---|
| Magnitude / fraction-comparison misconception | 7 | Kesirlerin büyüklük ilişkisini ters yorumlayan cevap örüntüsü |
| Fraction whole-unit / conversion error | 3 | 78/65 + 78/65 için doğru 2.4 yerine 1.4 seçimi |
| Computation slip / carrying error | 11 | 47 × 9 için 423 yerine 422 seçimi |
| Wrong operation | 1 | 48 − 12 işleminde çıkarma yerine toplama yönünde cevap |
| Degenerate option selection | 4 | Yazarlar bunu misconception olarak sınıflandırmamıştır |
| Notation artifact | 2 | Aynı değerin eşdeğer gösterimlerinden kaynaklanan durum |
22/28 madde yani:
\[ \frac{22}{28}\approx79\% \]
yazarın exploratory sınıflandırmasında matematik eğitimi literatüründe belgelenmiş hata türleriyle uyumlu bulunmuştur.
Ancak bu %79:
- bütün induced error'ların %79'u değildir;
- yalnız üç modelin aynı yanlışta birleştiği 28 maddelik alt kümeye aittir;
- tek bir yazar/coder tarafından sınıflandırılmıştır;
- inter-rater reliability hesaplanmamıştır.
Dolayısıyla bu bulgunun gerçek öğrenci misconception fidelity kanıtı gibi sunulması uygun değildir.
Robustness: yalnız baseline'da çözülebilen maddeler
Daha katı analizde, modelin perfect-student koşulunda doğru çözebildiği maddeler alınmıştır.
| Model | Retained iken doğru kalma | Suppressed iken yanlışa çevrilme | Controllability score |
|---|---|---|---|
| Claude | 0.98 | 0.68 | 0.82 |
| DeepSeek | 0.97 | 0.47 | 0.69 |
| GPT-4o | 0.93 | 0.80 | 0.69 |
Bu sonuç çok öğreticidir: GPT-4o suppression açısından yüksek bir “yanlışa çevirme” oranına sahip olsa da retained maddelerde Claude ve DeepSeek'e göre daha fazla collateral hata ürettiği için bütüncül controllability score'da Claude'la aynı düzeye ulaşmamaktadır.
Değiştirilen sorular çıkarıldığında ne oldu?
| Model | Retained — Full | Retained — Excl. | Forgotten — Full | Forgotten — Excl. | Selectivity — Full | Selectivity — Excl. |
|---|---|---|---|---|---|---|
| Claude | 0.948 | 0.946 | 0.318 | 0.317 | 0.630 | 0.628 |
| DeepSeek | 0.888 | 0.877 | 0.521 | 0.528 | 0.367 | 0.349 |
| GPT-4o | 0.618 | 0.589 | 0.223 | 0.232 | 0.396 | 0.357 |
En büyük selectivity değişimi 0.04'tür. Bu nedenle kaynak, değiştirilen 19 maddenin ana model sıralamasını açıklamadığı sonucuna varmaktadır.
Answer-position imbalance
Dört seçenek içindeki doğru cevap konumları uniform dağılmamıştır ve A seçeneği fazla temsil edilmiştir:
\[ p<10^{-6} \]
her iki grade için raporlanmıştır.
Ancak error-convergence permutation null her modelin kendi answer-letter frequency dağılımını koruduğu için kaynak, bu positional imbalance'ın model-arası yanlış cevap yakınsamasını tek başına açıklamadığını belirtmektedir.
Çalışmanın desteklediği sonuçlar
- İkili retained/suppressed skill profile kullanılarak answer-level LLM davranışı ölçülebilir biçimde yönlendirilebilmiştir.
- Açık skill-state rule içeren prompt'lar example-only prompting'den daha düşük profile-alignment hatası üretmiştir.
- Rule-based ve combined prompting, değerlendirilmiş koşullarda birbirine yakın alignment sağlamıştır.
- Selective suppression üç modelde de ölçülebilmiştir fakat gücü model ve beceri ailesine bağlıdır.
- Retained beceriler genel olarak suppressed becerilerden belirgin biçimde daha iyi korunmuştur.
- Cross-skill collateral change, doğrudan suppression etkisine göre küçüktür.
- Daha yüksek baseline matematik becerisi, değerlendirilen üç model içinde otomatik olarak daha güçlü controllability anlamına gelmemiştir.
- Induced wrong answers basit bağımsız rastgele seçim modelinden daha yapılandırılmış görünmektedir.
- Üç modelin aynı yanlış seçeneğe yakınsaması marginal answer-letter bias'ın üzerinde gerçekleşmiştir.
- Değiştirilen benchmark maddelerinin çıkarılması ana model sıralamasını değiştirmemiştir.
Çalışmanın desteklemediği sonuçlar
- LLM'lerin gerçek öğrencilerin bilişsel durumunu doğru biçimde simüle ettiği kanıtlanmamıştır.
- Binary skill vector gerçek insan mastery state'i değildir.
- Induced wrong answer gerçek öğrenci misconception'ı olarak doğrulanmamıştır.
- Üç modelin aynı yanlışa yönelmesi ortak bilişsel mekanizma kanıtı değildir.
- Kontrol edilebilir profil üretiminin öğretmenlerin tanı becerisini geliştirdiği test edilmemiştir.
- Bu tür simülatörlerin öğretmen eğitimini veya öğrenci başarısını artırdığı gösterilmemiştir.
- Sonuçlar açık uçlu açıklama veya çok turlu tutor–student dialog için doğrulanmamıştır.
- Grade 1–8 benchmark hazırlanmış olsa da ayrıntılı controllability sonucu bütün Grade 1–8 için gösterilmemiştir.
- Matematik dışındaki bilim, dil, programlama gibi alanlara genellenebilirlik test edilmemiştir.
- Sonuçlar bütün Claude, DeepSeek veya GPT model ailelerine genellenemez; yalnız kullanılan endpoint'lere aittir.
- Prompt-based control dışında fine-tuning veya training-time yöntemlerin daha iyi ya da kötü olduğu bu çalışmadan çıkarılamaz.
Çalışmanın dört ana geçerlilik sınırı
1. Construct validity
Hedef profile alignment, gerçek insan mastery veya authentic misconception ile eşit değildir. Target profile binary iken gözlenen suppression derecelidir.
2. Ecological validity
Veri tek turlu çoktan seçmeli cevaptır. Öğrenci açıklaması, tutor dialog, motivation, confusion, engagement ve peer interaction yoktur.
3. External validity
Derin analiz yalnız Grade 4 ve Grade 5 matematik becerilerini ve üç model endpoint'ini kapsamaktadır. Başka sınıflar, dersler ve model aileleri için sonuçların yeniden doğrulanması gerekir.
4. Benchmark / internal validity
Her soru tek bir skill family'ye etiketlenmiştir; gerçek matematik problemleri birden fazla beceriyi birlikte gerektirebilir. Ayrıca tam \(2^K\) profil enumeration'ı beceri sayısıyla üstel büyür.
Yeniden üretilebilirlik
Kaynak, benchmark maddeleri, skill annotation'ları, rule-based/example-only/combined prompt template'leri, item-to-skill mapping, üç modelin per-item evaluation çıktıları, raw prompt/response/parsed-answer kayıtları ve analiz kodunun arşivlendiğini belirtmektedir.
Veri ve kod arşivi için kaynakta verilen Zenodo DOI:
10.5281/zenodo.21853933
olarak belirtilmiştir.
Analizler Python 3.14, statsmodels 0.14.6, SciPy 1.17.1 ve NumPy 1.26.4 kullanılarak çalıştırılmıştır.
Gelecek çalışmalar
Yazarların en önemli sonraki adım olarak gördüğü konu uzman insan değerlendirmesidir. Deneyimli öğretmenlerin simüle edilen öğrencilerin gerçekçiliğini ve pedagojik yararlılığını puanlaması, yalnız objective answer metrics ile elde edilemeyen external validity kanıtı sağlayabilir.
Kaynak ayrıca:
- gerçek öğrenci response distributions ile karşılaştırma,
- blinded multi-rater misconception coding,
- conceptual misconception, procedural slip, arithmetic error ve reasoning shortcut gibi daha ayrıntılı hata profilleri,
- binary yerine continuous target-performance scale,
- hierarchical skill representations,
- fine-tuning veya reinforcement-based control,
- diğer dersler ve grade bands,
- çok turlu interactive tutoring,
- öğretmen-döngülü gerçek eğitimsel doğrulama
gibi uzantılar önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Toward Controllable Learner Simulation for Teacher Education: Benchmarking Skill-Profile Control in LLM Answer Behavior
Yazarlar, kaynak sırasıyla: Omri Sasson; Alexander Apartsin; Yehudit Aperstein.
Yazar afiliyasyonları: Omri Sasson ve Yehudit Aperstein — Intelligent Systems, Afeka College of Engineering, Tel Aviv, Israel. Alexander Apartsin — School of Computer Science, Faculty of Sciences, Holon Institute of Technology, Holon, Israel.
Sorumlu yazar: Yehudit Aperstein.
Eş katkı: Kaynakta equal-contribution beyanı bulunmamaktadır.
Dergi: Education Sciences.
Yayınevi: MDPI, Basel, Switzerland.
Yayın türü: Article; tamamen hesaplamalı benchmark/experimental evaluation.
Cilt / sayı / makale numarası: 16(10), 1752.
DOI: 10.3390/educsci16101752.
Received: 11 August 2026.
Revised: 4 October 2026.
Accepted: 14 October 2026.
Published: 19 October 2026.
Academic Editor: Samson Nashon.
Hakemlik durumu: Yayımlanmış hakemli dergi makalesidir.
Preprint durumu: İncelenen kaynak ve resmî bibliyografik kayıtta bu makalenin ayrı preprint sürümüne ilişkin bilgi verilmemektedir.
Lisans: Creative Commons Attribution (CC BY).
Çalışmanın ana araştırma sorusu: Prompt ile kontrol edilen bir LLM, bazı müfredat becerilerini retained tutarken diğerlerini suppressed gösteren belirlenmiş bir student skill profile'ı seçici biçimde gerçekleştirebilir mi?
Alt araştırma soruları: Prompt stratejisinin etkisi; değerlendirilen model endpoint'leri arasındaki controllability farkı; suppression'ın retained skills üzerinde sınırlı collateral interference ile gerçekleştirilip gerçekleştirilememesi.
Veri seti: MathCAMPS; Grade 1–8 için 99'ar çoktan seçmeli soru hazırlanmıştır. Ayrıntılı controllability analizleri Grade 4 ve Grade 5 ile sınırlıdır.
Ana analiz footprint'i: Grade 4'te 4 beceri ve 16 profil; Grade 5'te 3 beceri ve 8 profil; toplam 24 target profile.
Core combined-prompt response count: 7128 model–question event.
Model endpoint'leri: claude-sonnet-4-5-20250929; DeepSeek-chat; gpt-4o.
Decoding: Deterministic, temperature = 0.
Prompt stratejileri: Rule-based; example-only/few-shot; combined.
Ana metrikler: Per-skill accuracy; retained/suppressed mean accuracy; relative loss; RMSE; controllability score \(C(\mathbf{k})\); cross-skill influence \(\Delta_{ij}\); selectivity index; signal-detection hit/false-alarm yapısı. Prediction score yardımcı calibration metric'idir.
İstatistiksel analiz: Exact McNemar; Cohen's \(h\); logistic GEE; Friedman omnibus; Holm-corrected Wilcoxon signed-rank; 4000-resample percentile bootstrap; 5000-permutation marginal-preserving error-convergence test; Mann–Whitney \(U\) robustness analizi.
İstatistiksel yazılım: Python 3.14; statsmodels 0.14.6; SciPy 1.17.1; NumPy 1.26.4.
Kaynak içi sayısal not: Section 7.7 metni Grade 5 üç-model wrong-answer convergence değerini %35 olarak verirken Figure 10 üzerindeki değer 0.34'tür. Verianla bu farklılığı sessizce düzeltmemiş ve ilgili sonuç yaklaşık %34–35 olarak sınırlandırılmıştır.
Item quality control: Grade 4'te 7, Grade 5'te 12 madde perfect-student baseline'daki çapraz model başarısızlıkları nedeniyle değiştirilmiştir. Bu maddelerin tamamının çıkarıldığı robustness analizinde model sıralaması korunmuş, selectivity değişimleri en fazla 0.04 olmuştur.
Finansman: Araştırma harici finansman almamıştır.
Institutional Review Board: Uygulanabilir değil; çalışmada insan veya hayvan katılımcı bulunmamaktadır ve analiz edilen yanıtların tamamı dil modelleri tarafından üretilmiştir.
Informed Consent: Uygulanabilir değil.
Data Availability: Benchmark maddeleri, prompt template'leri, per-item model çıktıları ve analiz kodu Zenodo'da DOI 10.5281/zenodo.21853933 ile açık olarak arşivlenmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını bildirmiştir.
Yazar katkıları
- Conceptualization: Yehudit Aperstein, Alexander Apartsin.
- Methodology: Yehudit Aperstein, Alexander Apartsin.
- Formal analysis: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Data curation: Omri Sasson, Alexander Apartsin.
- Software: Omri Sasson.
- Supervision: Yehudit Aperstein, Alexander Apartsin.
- Project administration: Yehudit Aperstein.
- Writing — original draft preparation: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Writing — review and editing: Yehudit Aperstein, Alexander Apartsin.
Temel yöntemsel sınırlılıklar: İnsan uzman doğrulaması bulunmaması; binary target profile'ın gerçek mastery state olmaması; tek turlu çoktan seçmeli answer-level değerlendirme; açık uçlu muhakeme ve tutor dialog'un incelenmemesi; yalnız Grade 4–5 ayrıntılı analizi; yalnız üç model endpoint'i; yalnız prompt-based control; single-skill item annotation; bazı maddelerin baseline model çıktısıyla kalite kontrolünden geçirilmiş olması; full \(2^K\) profile enumeration'ın beceri sayısıyla üstel büyümesi.
Temel bilimsel yorum sınırı: Bu çalışma, üretken yapay zekânın gerçek öğrencileri pedagojik açıdan güvenilir biçimde simüle ettiğini veya öğretmen adaylarının eğitimini geliştirdiğini göstermemektedir. Çalışma, belirlenmiş bir retained/suppressed skill profile'ın LLM answer behavior düzeyinde ne kadar seçici ve yerel biçimde gerçekleştirilebildiğini ölçmek için bir benchmark ve metrik ailesi sunmaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir