


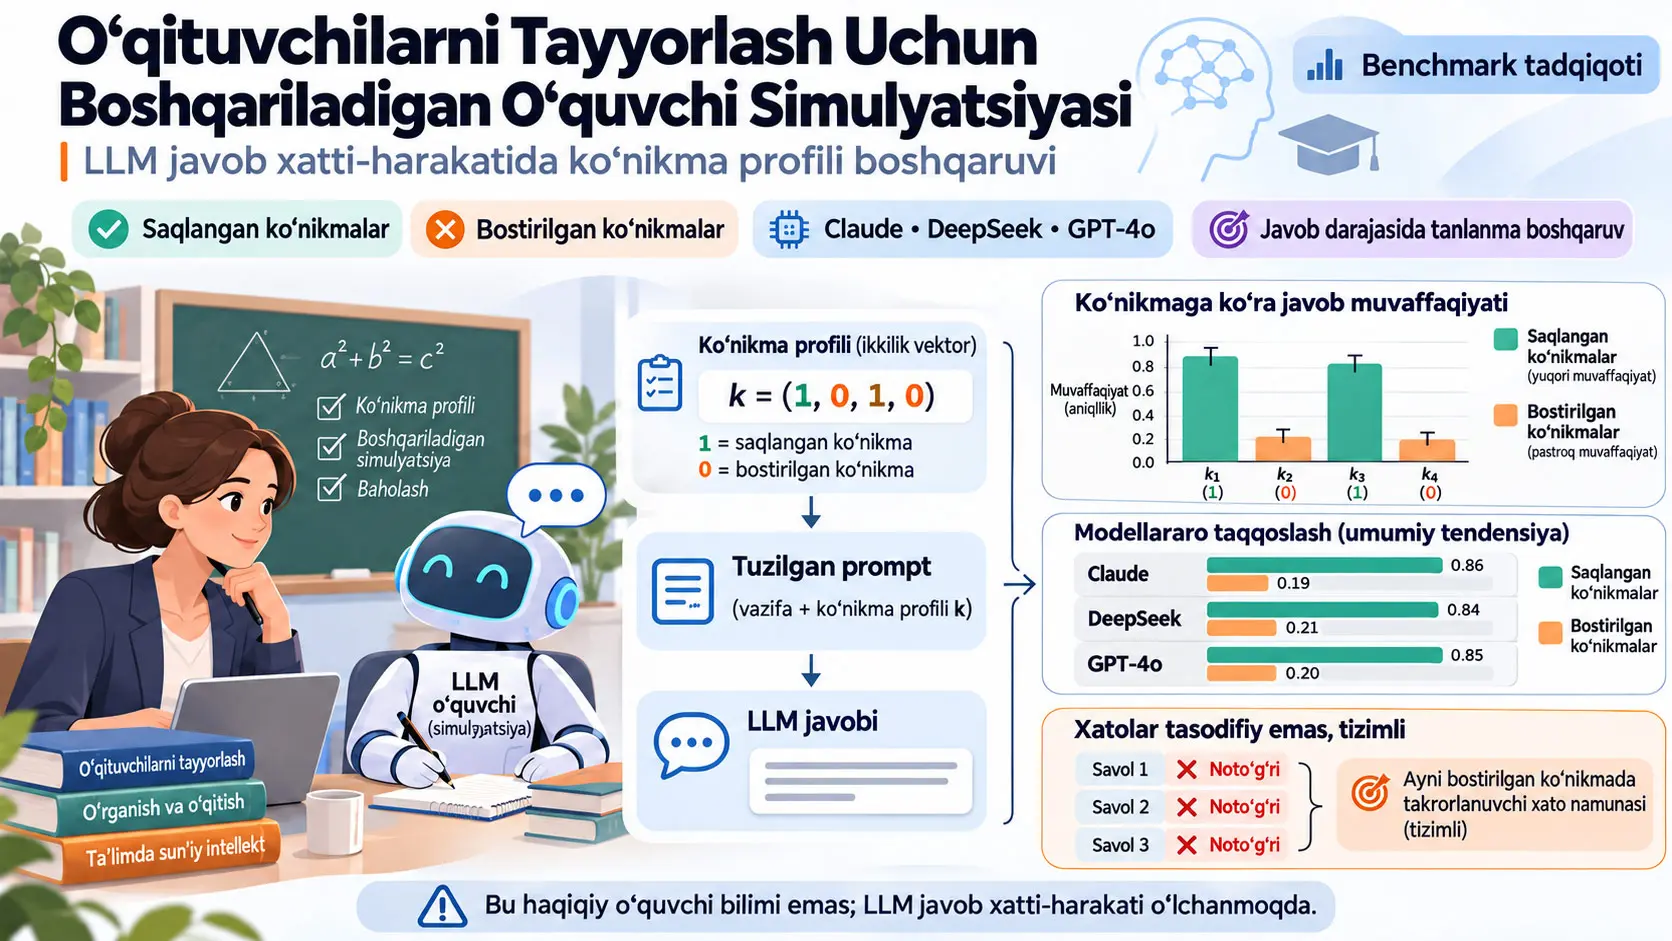
Boshqariladigan o‘quvchi simulyatsiyasi (controllable learner simulation) — katta til modelining faqat umumiy tarzda “kuchsizroq o‘quvchi” kabi tutishini emas, balki oldindan belgilangan ko‘nikma profilida ayrim o‘quv dasturi ko‘nikmalarini saqlab qolgan holda muayyan ko‘nikmalarda tanlab pastroq javob ko‘rsatkichini namoyon etishini ko‘zlaydigan ta’limiy simulyatsiya muammosidir. Ushbu tadqiqot maktab matematikasi kontekstida bunday xatti-harakatni o‘lchash mumkin yoki mumkin emasligini tekshiradigan to‘liq hisoblashga asoslangan benchmark tadqiqotidir. Tadqiqotchilar Claude, DeepSeek va GPT-4o endpoint-larini Grade 4 va Grade 5 matematika ko‘nikmalarida retained va suppressed ko‘nikmalarni ko‘rsatuvchi ikkilik ko‘nikma vektorlaridan foydalanib baholaganlar.
Tadqiqotning asosiy natijasi shuki, uchala model ham muayyan ko‘nikmalarni bostirar ekan, boshqa ko‘nikmalarni nisbatan saqlab qoladigan tanlanma javob profillarini hosil qila olgan; biroq bu boshqaruv modeldan modelga jiddiy farq qilgan. Yuqoriroq boshlang‘ich matematika natijasi kuchliroq boshqariluvchanlikni anglatmagan. Claude hisobot qilingan umumiy mezonlarda retained va suppressed ko‘nikmalar o‘rtasidagi eng aniq ajralishni yaratgan bo‘lsa; DeepSeek bostirilishi talab qilingan ko‘nikmalarda ko‘proq qoldiq ko‘rsatkich ko‘rsatgan, GPT-4o esa ayrim ko‘nikmalarni kuchli bostirganiga qaramay retained ko‘nikmalarda ko‘proq xato qilgan.
Prompt dizayni ham hal qiluvchi ahamiyatga ega. Faqat misol ko‘rsatadigan few-shot yondashuvi maqsadli ko‘nikma profiliga eng yuqori nomuvofiqlikni yuzaga keltirgan: RMSE oralig‘i 0.40–0.61. Retained va suppressed ko‘nikmalarni ochiq aytadigan rule-based va combined prompt-lar esa 0.19–0.39 oralig‘ida pastroq RMSE hosil qilgan. Manba explicit instruction komponentini boshqariluvchanlikning asosiy harakatlantiruvchi omili deb talqin qiladi; qoidalarga misollar qo‘shish qoidalarning o‘zini qo‘llashga nisbatan cheklangan qo‘shimcha hissa bergani kuzatilgan.
Induksiya qilingan noto‘g‘ri javoblar ham mutlaqo tasodifiy emas. Uch mustaqil model baseline-da to‘g‘ri yechgan, ammo suppression ostida noto‘g‘ri javob bergan umumiy topshiriqlarda bir xil noto‘g‘ri variantga Grade 4 da %39, Grade 5 da esa manba matniga ko‘ra %35 nisbatda yo‘nalgan; Grade 5 Figure 10 ustun yorlig‘i 0.34 ni ko‘rsatgani sababli bu natija taxminan %34–35 deb o‘qilishi kerak. Uch tomonlama yaqinlashuv uchun shuffle-null ko‘rsatkichlari mos ravishda taxminan %21 va %11. Biroq bu yaqinlashuv haqiqiy o‘quvchilar bilan bir xil kognitiv mexanizmni yoki haqiqiy misconception-ni isbotlamaydi; to‘rt variantli savollarda ataylab mantiqan ishonarli distractor-lar bo‘lishi ham bir xil noto‘g‘ri javobga yo‘nalishga ta’sir qilishi mumkin.
Eng muhim talqin chegarasi shudir: tadqiqot haqiqiy o‘quvchilarning bilimini, fikrlash jarayonini yoki o‘qituvchi tayyorlash samaradorligini o‘lchamaydi. Tajribalar bir martalik, to‘rt variantli LLM javoblari ustida olib borilgan. Binary target profile inson o‘quvchisining haqiqiy aqliy mastery state-i emas; u faqat modelga berilgan tayinlangan javob-ko‘rsatkich shartidir. Shuning uchun tadqiqot “bu LLM-lar haqiqiy o‘quvchilarni to‘g‘ri simulyatsiya qiladi” degan xulosani emas, balki “muayyan javob darajasidagi ko‘nikma profillarini qanchalik tanlab hosil qilish mumkinligini o‘lchash mumkin” degan xulosani qo‘llab-quvvatlaydi.
Boshqariladigan O‘quvchi Simulyatsiyasi Nima?
Boshqariladigan o‘quvchi simulyatsiyasi — LLM ning oldindan belgilangan retained va suppressed o‘quv dasturi ko‘nikmalariga muvofiq javob xatti-harakatini namoyon etishi va bu xatti-harakatning maqsadli profilga qanchalik mos kelishini miqdoriy o‘lchashni ko‘zlaydigan benchmark muammosidir; ushbu tadqiqot o‘quvchi idrokining hammasini emas, faqat answer-level skill-profile control xususiyatini sinaydi.
Nega “xato qiladigan o‘quvchi” yaratishning o‘zi yetarli emas?
Bo‘lajak o‘qituvchi uchun tasodifiy xato qiladigan simulyatorning ta’limiy qiymati cheklangan. Haqiqiy ta’lim muhitida muhim narsa o‘quvchining faqat noto‘g‘ri javob berishi emas, balki muayyan sohalarda kuchli, muayyan sohalarda zaif va nisbatan izchil ko‘rsatkich naqshini namoyon etishidir.
Manba o‘qituvchi tayyorlash nuqtai nazaridan quyidagi konseptual zanjirni quradi:
o‘qituvchini tayyorlash → simulyatsiya qilingan o‘quvchilar → boshqariladigan ko‘nikma profillari → takrorlanuvchi maqsadli amaliyot → yaxshiroq tashxis → ehtiyojga sezgirroq o‘qitish
Biroq tadqiqot bu zanjirdagi faqat “simulyatsiya qilingan o‘quvchi → boshqariladigan ko‘nikma profili” bog‘lanishini o‘lchaydi. Takroriy amaliyot haqiqatan o‘qituvchining tashxis qo‘yish ko‘nikmasini yaxshilaydimi yoki bu yaxshiroq o‘qitishga aylanadimi — ushbu tajribada sinovdan o‘tkazilmagan.
Nega boshqariluvchanlik bilan yuqori ko‘rsatkich bir xil narsa emas?
Standart LLM benchmark-larida modelning ko‘proq savolga to‘g‘ri javob berishi odatda yaxshiroq natijani anglatadi. Ushbu tadqiqotda maqsad boshqacha. Agar maqsadli profil bir ko‘nikmaning retained, boshqasining suppressed bo‘lishini talab qilsa, modelning har bir savolni to‘g‘ri yechishi muvaffaqiyatsizlik hisoblanishi mumkin; chunki model talab qilingan qisman ko‘rsatkich profilini amalga oshirmagan bo‘ladi.
Shuning uchun:
- Capability: Model matematikani qanchalik yaxshi yecha oladi?
- Controllability: Model o‘ziga berilgan retained/suppressed profilga qanchalik tanlab moslasha oladi?
ikki alohida baholash o‘qidir.
Tadqiqotning uch model bo‘yicha natijasi ham bu farqni qo‘llab-quvvatlaydi: yuqori baseline matematika ko‘rsatkichi eng kuchli selective suppression bilan avtomatik ravishda birga kelmagan.
Ko‘nikma Profili Vektori Nimani Anglatadi?
Ko‘nikma profili vektori har bir o‘quv dasturi ko‘nikmasi uchun 1 qiymatini “retained”, 0 qiymatini “suppressed” deb belgilaydigan ikkilik maqsad vektoridir; bu vektor o‘lchangan inson idroki emas, balki LLM javob xatti-harakatida amalga oshirishi talab qilinadigan eksperimental ko‘rsatkich shartidir.
Formal ta’rif
Bir sinf darajasi uchun o‘quv dasturi ko‘nikmalari oilalari:
\[ \mathcal{S}=\{s_1,\ldots,s_K\} \]
deb ta’riflanadi.
Maqsadli profil:
\[ \mathbf{k}=(k_1,\ldots,k_K)\in\{0,1\}^{K} \]
ko‘rinishidadir.
- \(k_i=1\): \(s_i\) ko‘nikmasi retained deb belgilangan.
- \(k_i=0\): \(s_i\) ko‘nikmasi suppressed deb belgilangan.
\(K\) baholashga kiritilgan ko‘nikma oilalari soni bo‘lib, fizik birlikka ega emas.
Masalan:
\[ \mathbf{k}=(1,0,0,1) \]
profili to‘rtta ko‘nikma mavjud holatda birinchi va to‘rtinchi ko‘nikmalar saqlanishi, ikkinchi va uchinchi ko‘nikmalar esa bostirilishi kerakligini bildiradi.
Manba ayniqsa quyidagi farqni ta’kidlaydi: bu vektor “o‘quvchi haqiqatda biladigan va bilmaydigan narsalar” emas. Bu modelga berilgan assigned curricular performance condition hisoblanadi.
Retained va suppressed to‘plamlari
Retained ko‘nikmalarning indekslar to‘plami:
\[ R=\{i:k_i=1\} \]
suppressed ko‘nikmalarning indekslar to‘plami:
\[ F=\{i:k_i=0\} \]
deb ta’riflanadi.
Bir ko‘nikma uchun baseline accuracy:
\[ a_i^{0}=A_{\mathrm{base}}(s_i) \]
va maqsadli profil ostida kuzatilgan accuracy:
\[ a_i^{*}=A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) \]
ko‘rinishida belgilanadi.
\(a_i^{0}\) — modelning perfect-student, ya’ni barcha ko‘nikmalar retained bo‘lgan shartdagi muvaffaqiyat darajasi. \(a_i^{*}\) — muayyan target profile ostida ayni ko‘nikmada kuzatilgan muvaffaqiyat.
Retained va suppressed o‘rtacha ko‘rsatkichlari
Manba ikkita asosiy o‘rtacha qiymatdan foydalanadi:
\[ a_R(\mathbf{k}) = \frac{1}{|R|} \sum_{i\in R}a_i^{*} \]
\[ a_F(\mathbf{k}) = \frac{1}{|F|} \sum_{i\in F}a_i^{*} \]
\(a_R\) retained deb belgilangan ko‘nikmalardagi o‘rtacha aniqlikni; \(a_F\) esa suppressed deb belgilangan ko‘nikmalarda qolgan o‘rtacha aniqlikni ko‘rsatadi.
Ideal tanlanma boshqaruv mantiqida \(a_R\) yuqori, \(a_F\) past bo‘lishi kutiladi. Biroq manba “suppressed = nol ko‘rsatkich” farazini qabul qilmaydi; haqiqiy natijalar bostirish darajali ekanini ko‘rsatgan.
MathCAMPS ma’lumotlar to‘plamining roli
Tadqiqot U.S. Common Core standartlariga muvofiq belgilangan matematika savollaridan iborat MathCAMPS ma’lumotlar to‘plamidan foydalanadi. Benchmark Grade 1–8 uchun yaratilgan va har bir grade-specific dataset 99 ta ko‘p variantli savolni o‘z ichiga oladi.
Savollar to‘rt variantli. Distractor-lar to‘g‘ri qiymatga son jihatdan yaqin yoki maqsadli ko‘nikma nuqtai nazaridan konseptual jihatdan ishonarli noto‘g‘ri javoblar bo‘ladigan qilib tuzilgan.
Asosiy batafsil controllability tajribalari barcha sakkiz sinfda emas, faqat Grade 4 va Grade 5 da o‘tkazilgan.
Grade 4 da qo‘llanilgan ko‘nikmalar
- S4.1: Measurement and Data
- S4.2: Number and Operations — Base
- S4.3: Number and Operations — Fractions
- S4.4: Operations and Algebraic
To‘rtta ko‘nikma bo‘lgani uchun barcha ikkilik profillar soni:
\[ 2^4=16 \]
bo‘ladi.
Grade 5 da qo‘llanilgan ko‘nikmalar
- S5.1: Number and Operations — Base
- S5.2: Number and Operations — Fractions
- S5.3: Operations and Algebraic
Uch ko‘nikma uchun:
\[ 2^3=8 \]
turli maqsadli profil mavjud.
Shunday qilib, batafsil tahlil jami:
\[ 16+8=24 \]
turli retained/suppressed profilni o‘z ichiga oladi.
Ma’lumotlarni dastlabki qayta ishlashda o‘zgartirilgan savollar
Perfect-student shartida modellarning barchasi yoki ko‘pchiligi noto‘g‘ri javob bergan topshiriqlar, maqsad qilingan “unutish” xatti-harakatidan mustaqil ravishda muammoli savol bo‘lishi mumkinligi sababli oldindan belgilangan sifat nazorati doirasida belgilangan.
Bu jarayon yakunida:
- Grade 4 da 7 ta topshiriq,
- Grade 5 da 12 ta topshiriq
ayni Common Core standartidagi muqobil topshiriqlar bilan almashtirilgan.
Bu nuqta metodologik jihatdan muhim, chunki model chiqishlaridan item curation-da foydalanish outcome-aware curation tanqidiga ochiq bo‘lishi mumkin. Mualliflar buning natijalarni yo‘naltirgan yoki yo‘naltirmaganini alohida sinagan va o‘zgartirilgan barcha topshiriqlar chiqarib tashlanganda model reytingi saqlanib qolganini, har qanday selectivity qiymatidagi eng katta o‘zgarish 0.04 bo‘lganini bildirgan.
Ko‘nikma darajasidagi aniqlik
Asosiy kuzatiladigan kattalik:
\[ Acc(s_i)=\frac{c_i}{n_i} \]
ko‘rinishidadir.
- \(c_i\): \(s_i\) ko‘nikmasi bilan belgilangan savollardagi to‘g‘ri javoblar soni.
- \(n_i\): ayni ko‘nikma uchun baholangan jami topshiriqlar soni.
- \(Acc(s_i)\): 0 dan 1 gacha bo‘lgan o‘lchovsiz aniqlik nisbati.
Bu qiymat profil darajasidagi boshqa metrikalarning asosiy kirishidir.
Relative Loss nimani o‘lchaydi?
Manba relative loss-ni:
\[ L_i= \max\left( 0, \frac{a_i^{0}-a_i^{*}} {\max(a_i^{0},\varepsilon)} \right) \]
ko‘rinishida ta’riflaydi.
\(\varepsilon>0\) maxrajning nol bo‘lishini oldini oluvchi kichik doimiydir.
Bu metrika baseline-ga nisbatan proporsional ko‘rsatkich yo‘qotilishini o‘lchaydi.
- Suppressed ko‘nikmalar uchun yuqori \(L_i\) kuchliroq bostirishni anglatadi.
- Retained ko‘nikmalar uchun \(L_i\) ning nolga yaqin bo‘lishi talab etiladi; chunki bu saqlanishi kerak bo‘lgan ko‘rsatkich yo‘qolmaganini bildiradi.
RMSE maqsadli profilga moslikni qanday o‘lchaydi?
Manbada:
\[ RMSE(\mathbf{k}) = \sqrt{ \frac{1}{K} \sum_{i=1}^{K} (k_i-a_i^{*})^2 } \]
deb ta’riflanadi.
RMSE binary target vector bilan kuzatilgan continuous skill-accuracy profile o‘rtasidagi o‘rtacha kvadratik og‘ishning kvadrat ildizidir.
Masalan, retained ko‘nikmada \(k_i=1\) bo‘lganda kuzatilgan aniqlik 1 ga yaqin bo‘lsa, xato kichik. Suppressed ko‘nikmada \(k_i=0\) bo‘lganda aniqlik 0 ga yaqinlashgani sari xato yana kichrayadi.
Demak, pastroq RMSE yaxshiroq maqsad-profil mosligini anglatadi.
Biroq RMSE retained ko‘rsatkichining saqlanishi bilan suppressed ko‘rsatkichining kamayishini bitta songa siqqani sababli tadqiqot undan ayniqsa prompt-strategy ablation-da foydalanadi; asosiy controllability talqinini faqat RMSE ga asoslamaydi.
Controllability Score C(k) Nimani O‘lchaydi?
Controllability score \(C(\mathbf{k})\) retained deb belgilangan ko‘nikmalarda yuqori aniqlikni va suppressed deb belgilangan ko‘nikmalarda past aniqlikni bir formulada mukofotlab, kuzatilgan javob profilining maqsadli ikkilik profilga qanchalik mos kelishini 0–1 oralig‘ida o‘lchaydi; \(C=1\) maqsadga to‘liq moslikni bildiradi.
Manbadagi formula:
\[ C(\mathbf{k}) = \frac{1}{K} \sum_{i=1}^{K} \left[ k_i a_i^{*} + (1-k_i)(1-a_i^{*}) \right] \]
ko‘rinishidadir.
Formulani bosqichma-bosqich o‘qish
Agar \(k_i=1\), ya’ni ko‘nikma retained bo‘lsa:
\[ k_i a_i^{*}=a_i^{*} \]
va ikkinchi had nol bo‘ladi. Shuning uchun yuqori aniqlik ballni oshiradi.
Agar \(k_i=0\), ya’ni ko‘nikma suppressed bo‘lsa:
\[ (1-k_i)(1-a_i^{*})=1-a_i^{*} \]
bo‘ladi. Bu safar past aniqlik ballni oshiradi.
Shu sababli formula “model qanchalik to‘g‘ri?” degan savolga emas, “model talab qilingan retained/suppressed xatti-harakatiga qanchalik moslashdi?” degan savolga javob beradi.
Cross-skill influence nima uchun zarur?
Bir ko‘nikmani bostirish oson ko‘rinishi mumkin; ammo shu paytda saqlanishi kerak bo‘lgan boshqa ko‘nikmalar ham zarar ko‘rsa, boshqaruv haqiqatan tanlanma emas.
Manba bu holatni cross-skill influence matritsasi \(\Delta_{ij}\) orqali tekshiradi.
To‘g‘ridan-to‘g‘ri suppression ta’siri:
\[ \Delta_{ii} = \frac{1}{|\mathcal{K}_i|} \sum_{\mathbf{k}\in\mathcal{K}_i} A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) - A_{\mathrm{base}}(s_i) \]
bilan baholanadi.
Bu yerda:
\[ \mathcal{K}_i=\{\mathbf{k}:k_i=0\} \]
ya’ni \(s_i\) suppressed bo‘lgan profillar to‘plami.
Boshqa retained ko‘nikma \(s_j\) ga bo‘lgan collateral influence:
\[ \Delta_{ij} = \frac{1}{|\mathcal{K}_{ij}|} \sum_{\mathbf{k}\in\mathcal{K}_{ij}} A_{\mathrm{ctrl}}(s_j\mid\mathbf{k}) - A_{\mathrm{base}}(s_j), \qquad i\neq j \]
va:
\[ \mathcal{K}_{ij} = \{\mathbf{k}:k_i=0,\;k_j=1\} \]
ko‘rinishidadir.
Muhim jihat shuki, off-diagonal ta’sir faqat \(s_i\) suppressed, \(s_j\) esa retained bo‘lgan profillarda hisoblanadi. Shunday qilib, \(s_j\) ham ataylab bostirilgan profillar collateral-damage hisobiga aralashmaydi.
Manbada to‘g‘ridan-to‘g‘ri suppression-ning model/shart darajasidagi ta’siri katta va manfiy bo‘lsa, retained ko‘nikmalardagi off-diagonal o‘zgarishlar kichik. Robustness tahlilida mean diagonal qiymat taxminan −0.47, mean off-diagonal magnitude esa 0.03 deb berilgan va farq Mann–Whitney \(U\) testi bilan \(p<10^{-10}\) darajasida aniqlangan.
Prediction Score nima?
Ikkilamchi kalibrlash metrikasi:
\[ PS(\mathbf{k}) = a_R^{actual}(\mathbf{k}) - a_R^{expected}(\mathbf{k}) \]
ko‘rinishidadir.
Qiymat:
- 0 ga yaqin bo‘lsa observed retention bilan calibration expectation mos keladi;
- musbat bo‘lsa retained ko‘rsatkich kutilganidan yaxshiroq;
- manfiy bo‘lsa retained ko‘rsatkich kutilganidan past.
Tadqiqot Prediction Score-ni asosiy natija metrikasi sifatida emas, correlation structure-ga sezgir yordamchi diagnostic sifatida ishlatadi.
Gaussian calibration formulasi
Appendix A da ko‘nikma ko‘rsatkichlari vektori uchun:
\[ \mathbf{a}\sim\mathcal{N}(\boldsymbol{\mu},\boldsymbol{\Sigma}) \]
Gaussian approximation qo‘llanadi.
Suppressed to‘plam \(F\), retained to‘plam \(R\) bo‘lsa, maqsadli forgetting ostida retained ko‘rsatkichning conditional expectation-i:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] = \boldsymbol{\mu}_R - \boldsymbol{\Sigma}_{RF} \boldsymbol{\Sigma}_{FF}^{-1} \boldsymbol{\mu}_F \]
ko‘rinishida yoziladi.
Bu yerda:
- \(\boldsymbol{\mu}_R\): retained skill performance o‘rtacha qiymatlari,
- \(\boldsymbol{\mu}_F\): suppressed skill performance o‘rtacha qiymatlari,
- \(\boldsymbol{\Sigma}_{RF}\): retained va suppressed ko‘nikmalar o‘rtasidagi cross-covariance block,
- \(\boldsymbol{\Sigma}_{FF}\): suppressed ko‘nikmalar o‘rtasidagi covariance block.
Agar cross-skill coupling juda zaif bo‘lsa:
\[ \boldsymbol{\Sigma}_{RF}\approx0 \]
va shuning uchun:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] \approx \boldsymbol{\mu}_R \]
bo‘ladi.
Manba ayniqsa bu haqiqiy o‘quvchi idrokining generativ modeli emasligini ta’kidlaydi. Ushbu Gaussian yondashuvi faqat expected-versus-observed retention kalibrlashi uchun ishlatiladigan analitik yondashuvdir.
Tadqiqotning Usuli va Natijalari
Tajriba to‘liq hisoblashga asoslangan
Tadqiqotga o‘quvchi, o‘qituvchi yoki boshqa inson ishtirokchisi kiritilmagan. Barcha kuzatuvlar til modellari yaratgan bitta variantli javoblarni baholashdan iborat.
Baholangan model endpoint-lari
| Model | Manbada berilgan identifier | Tadqiqotdagi roli |
|---|---|---|
| Claude | claude-sonnet-4-5-20250929 | Kuchli instruction-following xususiyati bilan yuqori-compliance taqqoslash nuqtasi |
| DeepSeek | DeepSeek-chat | Kuchli matematika ko‘rsatkichi controllability bilan bir xil narsa yoki yo‘qligini tekshiruvchi taqqoslash |
| GPT-4o | gpt-4o | Keng qo‘llanadigan umumiy maqsadli LLM taqqoslashi |
Barcha inference amallarida:
\[ temperature=0 \]
qo‘llangan.
Shu sababli ayni tajribada stochastic sampling variability maxsus ravishda kamaytirilgan. Appendix A dagi profil variatsiyasi ham takrorlar o‘rtasidagi sampling noise-ni emas, turli student-profile shartlari o‘rtasidagi o‘zgarishni ifodalaydi.
Manba, shuningdek, DeepSeek-chat va gpt-4o alias-lari date-pinned emasligini va vaqt o‘tishi bilan provider tomonida o‘zgarishi mumkinligini ta’kidlaydi. Shuning uchun natijalarni model oilasining barcha versiyalariga umumlashtirish to‘g‘ri emas.
Uchta prompt strategiyasi
| Strategiya | Mazmun | Manba natijasi |
|---|---|---|
| Rule-based | Retained ko‘nikmalarda to‘g‘ri, suppressed ko‘nikmalarda izchil xato xatti-harakatini ochiq belgilovchi qoidalar | Past alignment error; combined bilan o‘xshash |
| Example-only / few-shot | To‘g‘ri va noto‘g‘ri xatti-harakatni ko‘rsatuvchi misollar; baholash ma’lumotlaridan alohida saqlangan | Eng yuqori RMSE, 0.40–0.61 |
| Combined | Ochiq qoidalar + misollar | RMSE 0.19–0.39 oralig‘idagi rule-bearing strategiyalardan biri |
Claude uchun rule-based RMSE combined-dan biroz pastroq deb berilgan:
- Grade 4: rule-based 0.19, combined 0.24;
- Grade 5: rule-based 0.20, combined 0.22.
Demak, “combined har doim eng yaxshi prompt” degan xulosa qo‘llab-quvvatlanmaydi. Manbaning aniqroq talqini shuki, ko‘nikma-holati bo‘yicha ochiq ko‘rsatma few-shot misollaridan muhimroq.
Asosiy tajriba oqimi
- Har bir model perfect-student, ya’ni barcha ko‘nikmalar retained bo‘lgan shartda sinovdan o‘tkazildi.
- Binary skill vector prompt ichiga joylashtirilib, retained va suppressed maqsadli profillar belgilandi.
- Ayni profillar rule-based, example-only va combined prompting ostida baholandi.
- Javoblar profile-level va skill-level metrikalarga aylantirildi.
Grade 4 uchun 16 profil va Grade 5 uchun 8 profil exhaustive tarzda baholangan.
Combined prompt asosiy taqqoslashida uch model va har bir grade-dagi 99 savol birgalikda:
\[ (16\times99+8\times99)\times3=7128 \]
model–question response event yaratgan.
Bu 7128 qiymati faqat core combined-prompt comparison uchun; perfect-student baseline va prompt ablation tajribalari qo‘shilganda butun tadqiqot bundan kattaroq.
Statistik xulosa chiqarish birligi nima?
Manba deterministic decoding ostida har bir grade uchun qat’iy 99 ta topshiriqni inference birligi sifatida ishlatadi.
Ayni topshiriqda perfect va all-forgotten holatlari juftlanganligi sababli retained-versus-forgotten o‘zgarishi uchun exact McNemar test qo‘llangan.
McNemar testi ayni birlikning ikki shartdagi binary natijasini taqqoslaydi. Bu yerdagi asosiy mantiq “nechta savol ikkala shartda ham bir xil?” degan savoldan ko‘ra, ayniqsa:
- baseline-da to‘g‘ri bo‘lib, suppression ostida noto‘g‘ri bo‘lgan,
- baseline-da noto‘g‘ri bo‘lib, suppression ostida to‘g‘ri bo‘lgan
discordant pair sonlarining muvozanatini sinashdir.
Manba barcha model va grade kombinatsiyalarida perfect vs all-forgotten farqlari uchun:
\[ p<10^{-5} \]
va Cohen's \(h\) uchun:
\[ 0.76\leq h\leq1.62 \]
oralig‘ini xabar qiladi.
GEE logistik modeli
Population-averaged tahlil:
\[ correct \sim target\_state \times model + grade \]
ko‘rinishidagi logistic generalized estimating equations (GEE) modeli bilan bajarilgan.
Modelda:
- 198 ta topshiriq ikki grade bo‘ylab cluster sifatida ishlatilgan,
- binomial family ishlatilgan,
- working correlation exchangeable deb tanlangan,
- robust sandwich standard errors ishlatilgan.
Reference model Claude uchun retained ko‘nikmada to‘g‘ri javob odds-i forgotten ko‘nikmaga nisbatan taxminan 40 baravar ekani baholangan; confidence interval to‘liq 1 dan ancha yuqori bo‘lgan va \(p<10^{-30}\) deb xabar qilingan.
Bu “Claude retained skill-da 40 baravar yuqori aniqlik nisbatiga ega” degani emas. Odds ratio bevosita probability ratio emas. Manba bu yerda to‘g‘ri javob odds-idagi o‘zgarishni xabar qiladi.
Target-state × model interaction-larining ahamiyatli bo‘lishi retained–forgotten ajralishi modeldan modelga o‘zgarishini qo‘llab-quvvatlaydi.
Model farqlari
Forgotten-skill accuracy uchun yettita grade-by-skill block ustida Friedman testi:
\[ \chi^2=11.1,\qquad p=0.004 \]
natijasini bergan.
Holm-tuzatilgan pairwise Wilcoxon testlari:
- Claude–DeepSeek,
- DeepSeek–GPT-4o
taqqoslashlarini adjusted \(p<0.05\) bilan ajratgan.
Manba bu yerda xabar qilinmagan uchinchi juft taqqoslash ham avtomatik ravishda ahamiyatli degan xulosani bermaydi.
Prompt strategiyalari o‘rtasidagi statistik farq
Oltita model-by-grade block ustidagi Friedman RMSE testi:
\[ \chi^2=9.3,\qquad p=0.009 \]
natijasini hosil qilgan.
Biroq atigi oltita block bo‘lgani sababli exact pairwise signed-rank testlarning aniqlik darajasi past. Mualliflar shu sababli prompt-strategy talqinini pairwise p qiymatlaridan ko‘ra omnibus test va ochiq RMSE oraliqlariga ko‘proq tayantiradi.
Selectivity index
Manba selectivity index-ni retained accuracy bilan forgotten accuracy o‘rtasidagi farq sifatida ishlatadi.
4000 item-level bootstrap resampling bilan hisoblangan %95 percentile interval-lar barcha model–grade kombinatsiyalarida noldan yuqori qolgan va index taxminan:
\[ 0.35\text{–}0.70 \]
oralig‘ida xabar qilingan.
Suppressed ko‘nikmalarda ko‘rsatmaga muvofiq noto‘g‘ri javob berish ulushi, ya’ni compliance rate esa:
\[ 0.56\text{–}0.82 \]
oralig‘ida.
Retained va suppressed ko‘rsatkich baseline-ga nisbatan qanchalik ajraldi?
| Model | Grade | Retained / baseline | Suppressed / baseline |
|---|---|---|---|
| Claude | 4 | %101.2 | %34.1 |
| Claude | 5 | %97.4 | %33.4 |
| DeepSeek | 4 | %98.8 | %59.9 |
| DeepSeek | 5 | %98.3 | %51.9 |
| GPT-4o | 4 | %94.1 | %29.7 |
| GPT-4o | 5 | %100.0 | %50.5 |
Bu jadval muhim farqni ko‘rsatadi. Faqat suppressed accuracy eng past bo‘lishiga qarash yetarli emas. Masalan, GPT-4o ayrim shartlarda kuchli suppression hosil qilsa ham retained ko‘nikmalarda ko‘proq yo‘qotish ko‘rsatishi mumkin. Yaxshi controllability suppression + retention ni birgalikda baholash orqali tushuniladi.
Suppression ko‘nikma oilasiga qarab o‘zgaradi
| Grade | Model | S1 | S2 | S3 | S4 |
|---|---|---|---|---|---|
| 4 | Claude | 0.43 | 0.39 | 0.10 | 0.34 |
| 4 | DeepSeek | 0.50 | 0.48 | 0.54 | 0.63 |
| 4 | GPT-4o | 0.19 | 0.21 | 0.28 | 0.14 |
| 5 | Claude | 0.23 | 0.24 | 0.52 | — |
| 5 | DeepSeek | 0.56 | 0.30 | 0.56 | — |
| 5 | GPT-4o | 0.30 | 0.18 | 0.33 | — |
Bu natijalar controllability yagona global “itoat” xususiyati emasligini; u model va curricular skill family o‘zaro ta’siriga bog‘liqligini ko‘rsatadi.
Bitta profil misoli tanlanma boshqaruvni qanday ko‘rsatadi?
Claude Grade 4 uchun manbada berilgan:
\[ [1,0,0,1] \]
profilida maqsad S4.1 va S4.4 ni retained; S4.2 va S4.3 ni suppressed saqlashdir.
| Ko‘nikma | Maqsadli holat | Kuzatilgan accuracy |
|---|---|---|
| S4.1 | Retained | 0.92 |
| S4.2 | Suppressed | 0.32 |
| S4.3 | Suppressed | 0.12 |
| S4.4 | Retained | 0.96 |
Bu misolning ilmiy ma’nosi modelning umumiy ravishda yomonlashishi emas. Ayni profil ichida retained ikki ko‘nikma yuqori qolgan paytda targeted ikki ko‘nikmada ko‘rsatkich keskin pasayadi.
Suppression darajali, mutlaq emas
Barcha model, grade va profillar birgalikda ko‘rilganda forgotten-skill accuracy o‘rtachasi:
\[ 0.35 \]
deb xabar qilingan.
Forgotten-skill misollarining %95 i:
\[ 0.1\text{–}0.9 \]
oralig‘ida.
Shuning uchun “unutilgan ko‘nikma butunlay yo‘qoldi” degan ifoda noto‘g‘ri bo‘ladi. Tadqiqotda suppression partial and graded performance hosil qiladi.
Signal-detection nuqtai nazari
Manba instruction-following-ni signal-detection o‘xshatishi orqali ham tahlil qiladi:
- Hit rate: suppressed ko‘nikmada ko‘rsatmaga muvofiq noto‘g‘ri javob berilgan topshiriqlar ulushi.
- False-alarm rate: retained ko‘nikmada noto‘g‘ri javob berilgan topshiriqlar ulushi.
Ideal boshqariladigan o‘quvchi simulyatori yuqori hit rate, ammo past false-alarm rate hosil qilishi kerak.
Claude uchun sensitivity index \(d'\) taxminan 2.1 deb xabar qilingan va baholangan uch model orasida eng aniq ajralish Claude da kuzatilgani ko‘rsatilgan.
Tanlanma Ko‘nikma Bostirilishi Haqiqiy O‘quvchi Yanglishishini Isbotlaydimi?
Yo‘q. Modellarning bir xil noto‘g‘ri variantga kutilganidan ko‘proq yo‘nalishi xatolar tasodifiy emasligini qo‘llab-quvvatlaydi, ammo haqiqiy o‘quvchilar bilan bir xil kognitiv mexanizm yoki haqiqiy misconception hosil qilinganini isbotlamaydi; tadqiqot buning uchun o‘qituvchi baholashi va haqiqiy o‘quvchi javoblari taqsimotlari bilan tasdiqlash zarurligini aniq qayd etadi.
Noto‘g‘ri javoblar yaqinlashuvi
Tahlil faqat barcha modellar perfect-student holatida to‘g‘ri javob bera olgan topshiriqlar bilan cheklangan. Shu tariqa suppression dan keyin yuzaga kelgan xatoning baseline da allaqachon yechilmagan savoldan kelib chiqishiga yo‘l qo‘ymaslikka harakat qilingan.
| Taqqoslash | Grade 4 observed | Grade 5 observed | Shuffle-null |
|---|---|---|---|
| Uch model bir xil noto‘g‘ri javob | %39 | Matn: %35; Figure 10 yorlig‘i: %34 | Taxminan %21 / %11 |
| Pairwise agreement | %56–%59 | Taxminan %31–%40 | |
Ushbu barcha taqqoslashlar uchun:
\[ p<0.001 \]
xabar qilingan.
Permutation null har bir modelning o‘z noto‘g‘ri javob harfi chastotasini saqlaydi. Shunday qilib, masalan, muayyan modelning “A” variantini umumiy tarzda ko‘p tanlashi soxta modelaro yaqinlashuv deb talqin qilinmasligiga harakat qilinadi.
Permutation p qiymati manbada:
\[ p= \frac{ 1+\#\{\mathrm{null}\geq\mathrm{observed}\} }{ 1+5000 } \]
ko‘rinishida hisoblangan.
5000 ta permutatsiya qo‘llangan.
28 ta umumiy noto‘g‘ri javob qaysi toifalarga ajratildi?
| Xato toifasi | Soni | Manba misolining ma’nosi |
|---|---|---|
| Magnitude / fraction-comparison misconception | 7 | Kasrlarning kattalik munosabatini teskari talqin qiladigan javob naqshi |
| Fraction whole-unit / conversion error | 3 | 78/65 + 78/65 uchun to‘g‘ri 2.4 o‘rniga 1.4 ni tanlash |
| Computation slip / carrying error | 11 | 47 × 9 uchun 423 o‘rniga 422 ni tanlash |
| Wrong operation | 1 | 48 − 12 amalida ayirish o‘rniga qo‘shish yo‘nalishidagi javob |
| Degenerate option selection | 4 | Mualliflar buni misconception deb tasniflamagan |
| Notation artifact | 2 | Ayni qiymatning ekvivalent ifodalaridan kelib chiqqan holat |
22/28 ta topshiriq, ya’ni:
\[ \frac{22}{28}\approx79\% \]
muallifning exploratory tasnifida matematika ta’limi adabiyotida hujjatlashtirilgan xato turlariga mos deb topilgan.
Biroq bu %79:
- barcha induced error-larning %79 i emas;
- faqat uch model bir xil xatoda birlashgan 28 topshiriqli quyi to‘plamga tegishli;
- bitta muallif/coder tomonidan tasniflangan;
- inter-rater reliability hisoblanmagan.
Shu sababli bu topilmani haqiqiy o‘quvchi misconception fidelity dalili sifatida taqdim etish to‘g‘ri emas.
Robustness: faqat baseline da yechiladigan topshiriqlar
Qat’iyroq tahlilda model perfect-student shartida to‘g‘ri yecha olgan topshiriqlar olingan.
| Model | Retained bo‘lganda to‘g‘ri qolish | Suppressed bo‘lganda noto‘g‘riga aylanish | Controllability score |
|---|---|---|---|
| Claude | 0.98 | 0.68 | 0.82 |
| DeepSeek | 0.97 | 0.47 | 0.69 |
| GPT-4o | 0.93 | 0.80 | 0.69 |
Bu natija juda ko‘rsatmalidir: GPT-4o suppression nuqtai nazaridan yuqori “noto‘g‘riga aylantirish” ulushiga ega bo‘lsa ham, retained topshiriqlarda Claude va DeepSeek ga qaraganda ko‘proq collateral xato hosil qilgani sababli umumiy controllability score da Claude bilan bir darajaga yetmaydi.
O‘zgartirilgan savollar chiqarilganda nima bo‘ldi?
| Model | Retained — Full | Retained — Excl. | Forgotten — Full | Forgotten — Excl. | Selectivity — Full | Selectivity — Excl. |
|---|---|---|---|---|---|---|
| Claude | 0.948 | 0.946 | 0.318 | 0.317 | 0.630 | 0.628 |
| DeepSeek | 0.888 | 0.877 | 0.521 | 0.528 | 0.367 | 0.349 |
| GPT-4o | 0.618 | 0.589 | 0.223 | 0.232 | 0.396 | 0.357 |
Eng katta selectivity o‘zgarishi 0.04. Shu sababli manba o‘zgartirilgan 19 ta topshiriq asosiy model reytingini tushuntirmaydi degan xulosaga keladi.
Answer-position imbalance
To‘rtta variant ichidagi to‘g‘ri javob pozitsiyalari uniform taqsimlanmagan va A varianti ortiqcha namoyon bo‘lgan:
\[ p<10^{-6} \]
har ikki grade uchun xabar qilingan.
Biroq error-convergence permutation null har bir modelning o‘z answer-letter frequency taqsimotini saqlagani sababli manba bu positional imbalance modelaro noto‘g‘ri javob yaqinlashuvini yakka o‘zi tushuntirmasligini qayd etadi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Ikkilik retained/suppressed skill profile yordamida answer-level LLM xatti-harakati o‘lchanadigan tarzda yo‘naltirilgan.
- Ochiq skill-state rule o‘z ichiga olgan prompt-lar example-only prompting ga qaraganda pastroq profile-alignment xatosini hosil qilgan.
- Rule-based va combined prompting baholangan shartlarda bir-biriga yaqin alignment bergan.
- Selective suppression uchala modelda ham o‘lchangan, biroq uning kuchi model va ko‘nikma oilasiga bog‘liq.
- Retained ko‘nikmalar umumiy hisobda suppressed ko‘nikmalardan ancha yaxshiroq saqlangan.
- Cross-skill collateral change to‘g‘ridan-to‘g‘ri suppression ta’siriga nisbatan kichik.
- Yuqoriroq baseline matematika ko‘nikmasi baholangan uch model ichida avtomatik ravishda kuchliroq controllability ni anglatmagan.
- Induced wrong answers oddiy mustaqil tasodifiy tanlov modeliga qaraganda ko‘proq tuzilgan ko‘rinadi.
- Uch modelning bir xil noto‘g‘ri variantga yaqinlashuvi marginal answer-letter bias darajasidan yuqori bo‘lgan.
- O‘zgartirilgan benchmark topshiriqlarini chiqarish asosiy model reytingini o‘zgartirmagan.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- LLM lar haqiqiy o‘quvchilarning kognitiv holatini to‘g‘ri simulyatsiya qilishi isbotlanmagan.
- Binary skill vector haqiqiy inson mastery state-i emas.
- Induced wrong answer haqiqiy o‘quvchi misconception-i sifatida tasdiqlanmagan.
- Uch modelning bir xil xatoga yo‘nalishi umumiy kognitiv mexanizm dalili emas.
- Boshqariladigan profil hosil qilish o‘qituvchilarning tashxis ko‘nikmasini yaxshilashi sinovdan o‘tkazilmagan.
- Bunday simulyatorlar o‘qituvchi tayyorlash yoki o‘quvchi muvaffaqiyatini oshirishi ko‘rsatilmagan.
- Natijalar ochiq javobli izoh yoki ko‘p turlik tutor–student dialog uchun tasdiqlanmagan.
- Grade 1–8 benchmark tayyorlangan bo‘lsa-da, batafsil controllability natijasi barcha Grade 1–8 uchun ko‘rsatilmagan.
- Matematikadan tashqari fan, til, dasturlash kabi sohalarga umumlashtirish imkoniyati sinovdan o‘tkazilmagan.
- Natijalarni barcha Claude, DeepSeek yoki GPT model oilalariga umumlashtirib bo‘lmaydi; ular faqat qo‘llangan endpoint-larga tegishli.
- Prompt-based control dan tashqari fine-tuning yoki training-time usullari yaxshiroq yoki yomonroq ekanini ushbu tadqiqotdan chiqarib bo‘lmaydi.
Tadqiqotning to‘rtta asosiy validlik chegarasi
1. Construct validity
Maqsadli profile alignment haqiqiy inson mastery-si yoki authentic misconception bilan teng emas. Target profile binary bo‘lsa, kuzatilgan suppression darajali.
2. Ecological validity
Ma’lumot bir martalik ko‘p variantli javobdan iborat. O‘quvchi izohi, tutor dialog, motivation, confusion, engagement va peer interaction yo‘q.
3. External validity
Chuqur tahlil faqat Grade 4 va Grade 5 matematika ko‘nikmalari hamda uchta model endpoint-ini qamrab oladi. Boshqa sinflar, fanlar va model oilalari uchun natijalarni qayta tasdiqlash zarur.
4. Benchmark / internal validity
Har bir savol faqat bitta skill family bilan belgilangan; haqiqiy matematika masalalari bir nechta ko‘nikmani birgalikda talab qilishi mumkin. Bundan tashqari to‘liq \(2^K\) profile enumeration ko‘nikmalar soni bilan eksponensial o‘sadi.
Qayta ishlab chiqarish mumkinligi
Manba benchmark topshiriqlari, skill annotation-lar, rule-based/example-only/combined prompt template-lar, item-to-skill mapping, uch modelning per-item evaluation chiqishlari, raw prompt/response/parsed-answer yozuvlari va tahlil kodi arxivlanganini qayd etadi.
Ma’lumot va kod arxivi uchun manbada berilgan Zenodo DOI:
10.5281/zenodo.21853933
deb ko‘rsatilgan.
Tahlillar Python 3.14, statsmodels 0.14.6, SciPy 1.17.1 va NumPy 1.26.4 yordamida bajarilgan.
Kelajakdagi tadqiqotlar
Mualliflar eng muhim keyingi qadam sifatida inson ekspert baholashini ko‘rishadi. Tajribali o‘qituvchilarning simulyatsiya qilingan o‘quvchilarning realizmi va pedagogik foydaliligini baholashi faqat objective answer metrics orqali olinmaydigan external validity dalilini ta’minlashi mumkin.
Manba, shuningdek:
- haqiqiy o‘quvchi response distributions bilan taqqoslash,
- blinded multi-rater misconception coding,
- conceptual misconception, procedural slip, arithmetic error va reasoning shortcut kabi batafsilroq xato profillari,
- binary o‘rniga continuous target-performance scale,
- hierarchical skill representations,
- fine-tuning yoki reinforcement-based control,
- boshqa fanlar va grade bands,
- ko‘p turlik interactive tutoring,
- o‘qituvchi ishtirokidagi haqiqiy ta’limiy tasdiqlash
kabi kengaytmalarni taklif qiladi.
Manba va Usul Haqida Izoh
Asl sarlavha: Toward Controllable Learner Simulation for Teacher Education: Benchmarking Skill-Profile Control in LLM Answer Behavior
Mualliflar, manbadagi tartibda: Omri Sasson; Alexander Apartsin; Yehudit Aperstein.
Muallif affiliasiyalari: Omri Sasson va Yehudit Aperstein — Intelligent Systems, Afeka College of Engineering, Tel Aviv, Israel. Alexander Apartsin — School of Computer Science, Faculty of Sciences, Holon Institute of Technology, Holon, Israel.
Mas’ul muallif: Yehudit Aperstein.
Teng hissa: Manbada equal-contribution bayonoti mavjud emas.
Jurnal: Education Sciences.
Nashriyot: MDPI, Basel, Switzerland.
Nashr turi: Article; to‘liq hisoblashga asoslangan benchmark/experimental evaluation.
Jild / son / maqola raqami: 16(10), 1752.
DOI: 10.3390/educsci16101752.
Received: 11 August 2026.
Revised: 4 October 2026.
Accepted: 14 October 2026.
Published: 19 October 2026.
Academic Editor: Samson Nashon.
Taqriz holati: Nashr etilgan, taqrizdan o‘tgan jurnal maqolasidir.
Preprint holati: Ko‘rib chiqilgan manba va rasmiy bibliografik qaydda ushbu maqolaning alohida preprint versiyasi haqida ma’lumot berilmagan.
Litsenziya: Creative Commons Attribution (CC BY).
Tadqiqotning asosiy savoli: Prompt orqali boshqariladigan LLM ayrim o‘quv dasturi ko‘nikmalarini retained saqlab, boshqalarini suppressed ko‘rsatadigan belgilangan student skill profile-ni tanlab amalga oshira oladimi?
Quyi tadqiqot savollari: Prompt strategiyasining ta’siri; baholangan model endpoint-lari o‘rtasidagi controllability farqi; suppression retained skills ustida cheklangan collateral interference bilan amalga oshirilishi mumkin yoki mumkin emasligi.
Ma’lumotlar to‘plami: MathCAMPS; Grade 1–8 uchun har birida 99 tadan ko‘p variantli savol tayyorlangan. Batafsil controllability tahlillari Grade 4 va Grade 5 bilan cheklangan.
Asosiy tahlil footprint-i: Grade 4 da 4 ko‘nikma va 16 profil; Grade 5 da 3 ko‘nikma va 8 profil; jami 24 target profile.
Core combined-prompt response count: 7128 model–question event.
Model endpoint-lari: claude-sonnet-4-5-20250929; DeepSeek-chat; gpt-4o.
Decoding: Deterministic, temperature = 0.
Prompt strategiyalari: Rule-based; example-only/few-shot; combined.
Asosiy metrikalar: Per-skill accuracy; retained/suppressed mean accuracy; relative loss; RMSE; controllability score \(C(\mathbf{k})\); cross-skill influence \(\Delta_{ij}\); selectivity index; signal-detection hit/false-alarm tuzilishi. Prediction score yordamchi calibration metric hisoblanadi.
Statistik tahlil: Exact McNemar; Cohen's \(h\); logistic GEE; Friedman omnibus; Holm-corrected Wilcoxon signed-rank; 4000-resample percentile bootstrap; 5000-permutation marginal-preserving error-convergence test; Mann–Whitney \(U\) robustness tahlili.
Statistik dasturiy ta’minot: Python 3.14; statsmodels 0.14.6; SciPy 1.17.1; NumPy 1.26.4.
Manba ichidagi sonli izoh: Section 7.7 matni Grade 5 uch-model wrong-answer convergence qiymatini %35 deb bergan bo‘lsa, Figure 10 dagi qiymat 0.34. Verianla bu tafovutni jim tuzatmagan va tegishli natijani taxminan %34–35 doirasida chegaralagan.
Item quality control: Grade 4 da 7, Grade 5 da 12 ta topshiriq perfect-student baseline dagi modellararo muvaffaqiyatsizliklar sababli almashtirilgan. Bu topshiriqlarning barchasi chiqarilgan robustness tahlilida model reytingi saqlangan, selectivity o‘zgarishlari ko‘pi bilan 0.04 bo‘lgan.
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Institutional Review Board: Qo‘llanilmaydi; tadqiqotda inson yoki hayvon ishtirokchilari yo‘q va tahlil qilingan javoblarning barchasi til modellari tomonidan yaratilgan.
Informed Consent: Qo‘llanilmaydi.
Data Availability: Benchmark topshiriqlari, prompt template-lari, per-item model chiqishlari va tahlil kodi Zenodo da DOI 10.5281/zenodo.21853933 bilan ochiq arxivlangan.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildirgan.
Muallif hissalari
- Conceptualization: Yehudit Aperstein, Alexander Apartsin.
- Methodology: Yehudit Aperstein, Alexander Apartsin.
- Formal analysis: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Data curation: Omri Sasson, Alexander Apartsin.
- Software: Omri Sasson.
- Supervision: Yehudit Aperstein, Alexander Apartsin.
- Project administration: Yehudit Aperstein.
- Writing — original draft preparation: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Writing — review and editing: Yehudit Aperstein, Alexander Apartsin.
Asosiy metodologik cheklovlar: Inson ekspert tasdig‘ining yo‘qligi; binary target profile haqiqiy mastery state emasligi; bir martalik ko‘p variantli answer-level baholash; ochiq javobli mulohaza va tutor dialog tekshirilmaganligi; faqat Grade 4–5 batafsil tahlili; faqat uchta model endpoint-i; faqat prompt-based control; single-skill item annotation; ayrim topshiriqlarning baseline model chiqishi bilan sifat nazoratidan o‘tkazilgani; full \(2^K\) profile enumeration ko‘nikmalar soni bilan eksponensial o‘sishi.
Asosiy ilmiy talqin chegarasi: Ushbu tadqiqot generativ sun’iy intellekt haqiqiy o‘quvchilarni pedagogik jihatdan ishonchli simulyatsiya qilishini yoki bo‘lajak o‘qituvchilar ta’limini yaxshilashini ko‘rsatmaydi. Tadqiqot belgilangan retained/suppressed skill profile LLM answer behavior darajasida qanchalik tanlanma va mahalliy tarzda amalga oshirilishi mumkinligini o‘lchash uchun benchmark va metrikalar oilasini taqdim etadi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan