

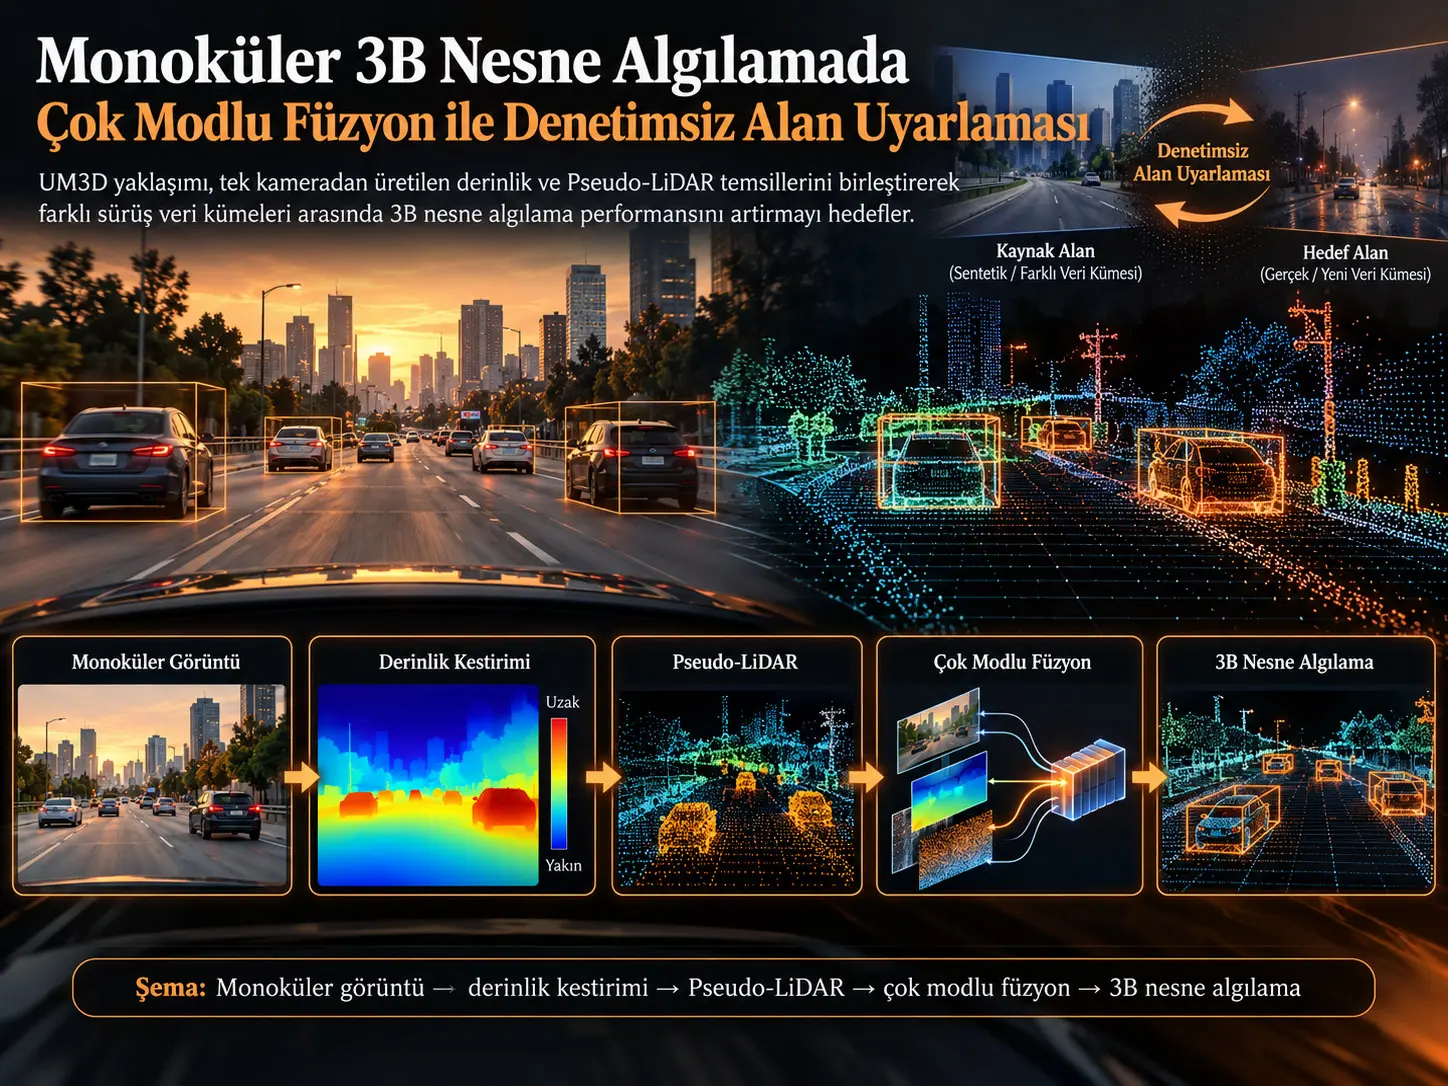
Denetimsiz Monoküler 3B Algılama modeli UM3D (Unsupervised Monocular 3D Detection), etiketli bir kaynak alanda öğrenilen üç boyutlu algılama bilgisini hedef alanda 3B kutu etiketlerine ihtiyaç duymadan aktarmak için kendinden denetimli derinlik kestirimi, Pseudo-LiDAR üretimi, kalite-duyarlı sahte etiketleme ve görüntü–nokta bulutu füzyonunu tek bir uçtan uca öğrenme hattında birleştiren bir denetimsiz alan uyarlama çerçevesidir. Çalışma KITTI, Waymo Open Dataset (WOD), nuScenes ve Lyft veri kümeleri üzerinde değerlendirilmiştir. UM3D, özellikle alan değişimi nedeniyle farklı ortamlar arasında bozulan monoküler 3B algılama performansını iyileştirmeyi amaçlar. Çıkarım aşamasında gerçek LiDAR gerektirmez; Pseudo-LiDAR temsili aynı monoküler görüntüden kestirilen derinlik üzerinden içeride oluşturulur. Bununla birlikte performans, özellikle uzak nesnelerde derinlik kestiriminin doğruluğuyla sınırlıdır ve deneylerin ana odağı otomobil sınıfıdır.
Yöntemin iki temel müdahalesi vardır. İlk olarak nesne düzeyinde rastgele ölçekleme, kaynak ve hedef alanlar arasındaki araç boyutu farklılıklarının ilk sahte etiketleri bozmasını azaltmaya çalışır. İkinci olarak IoU tabanlı kalite puanlaması kullanan üç aralıklı bir bellek bankası, sahte etiketleri yalnız tek bir güven puanına göre kabul etmek yerine tarihsel tahminlerle eşleştirip günceller. Bu yapı, LoGoNet tabanlı görüntü–nokta bulutu füzyonu ve diferansiyellenebilir Change of Representation (CoR) katmanı ile birleştirilerek algılama hatasının derinlik ağına kadar geri yayılmasını sağlar.
WOD → KITTI nokta bulutu alan uyarlamasında LoGoNet tabanlı UM3D, APBEV/AP3D değerlerinde 85,71/67,44'e ulaşmıştır. Kaynak makalenin özet ve sonuç bölümleri WOD → KITTI için APBEV alan farkının %76,81'inin kapatıldığını vurgular; ancak aynı çalışmanın Tablo 2'sinde SECOND tabanlı UM3D için %97,89 APBEV Closed Gap raporlanmaktadır. Bu nedenle %76,81 değeri makaledeki bütün konfigürasyonların mutlak maksimumu olarak değil, LoGoNet konfigürasyonunda raporlanan sonuç olarak değerlendirilmelidir.
UM3D Nedir ve Hangi Problemi Çözer?
UM3D, farklı veri kümeleri ve sürüş ortamları arasındaki dağılım değişiminin monoküler 3B nesne algılamada yarattığı performans kaybını, hedef alanda gerçek 3B kutu etiketlerine dayanmadan azaltmayı amaçlayan uçtan uca bir denetimsiz alan uyarlama çerçevesidir. Sistem tek görüntüden derinlik çıkarır, bu derinliği Pseudo-LiDAR nokta bulutuna dönüştürür, kalite kontrollü sahte etiketlerle hedef alana uyarlanır ve görüntü özellikleri ile üç boyutlu geometrik özellikleri birlikte işler.
Temel problem: tek kameradan derinlik çıkarmak neden zordur?
Monoküler kamerada aynı iki boyutlu görüntü izdüşümü farklı üç boyutlu sahne geometrileriyle uyumlu olabilir. Başka bir deyişle görüntü, derinliği doğrudan ölçmez. LiDAR fiziksel menzil ölçümü sağlarken monoküler sistem derinliği görüntü ipuçlarından kestirmek zorundadır. Bu nedenle derinlikteki hata, Pseudo-LiDAR noktasının uzaydaki konumunu ve ardından 3B kutunun yerini, boyutunu veya yönelimini bozabilir.
İkinci güçlük alan değişimidir. Bir algılayıcı bir veri kümesinde öğrenildiğinde başka bir veri kümesindeki kamera geometrisi, coğrafi çevre, sensör yoğunluğu, araç boyut dağılımları ve anotasyon protokolleri farklı olabilir. Kaynak alanda güçlü olan model bu nedenle hedef alanda aynı performansı göstermeyebilir.
UM3D'nin bilimsel mimarisi
- Kendinden denetimli mutlak derinlik kestirimi: RSANet kullanılarak monoküler görüntüden mutlak ölçekli derinlik haritası üretilir.
- Pseudo-LiDAR dönüşümü: Piksel koordinatları ve derinlik, iğne deliği kamera geometrisiyle üç boyutlu noktalara dönüştürülür.
- Yoğunluk tabanlı aralık örnekleme: Yoğun Pseudo-LiDAR bulutunun seyrek ve yoğun bölgeleri dengelenmeye çalışılır.
- Kalite-duyarlı sahte etiketleme: Nesne düzeyinde rastgele ölçekleme ve IoU tabanlı üç aralıklı bellek bankası kullanılır.
- Çok modlu füzyon: Görüntü özellikleri ile Pseudo-LiDAR geometrisi, LoGoNet tabanlı iki aşamalı füzyon ve öz-dikkat ağırlıklandırmasıyla birleştirilir.
- Uçtan uca ortak optimizasyon: Diferansiyellenebilir CoR katmanı sayesinde 3B algılama kaybının gradyanı derinlik kestirim ağına geri ulaşır.
Pseudo-LiDAR Bu Çalışmada Nasıl Üretilir?
Pseudo-LiDAR, monoküler görüntü için kestirilen mutlak derinlik haritasındaki her pikselin kamera iç parametreleri kullanılarak üç boyutlu koordinata geri izdüşürülmesiyle oluşturulur; UM3D daha sonra koordinat sistemini araç-LiDAR eksenlerine dönüştürür, 64 çizgili LiDAR edinimini taklit eden açısal örnekleme uygular ve yüksek yoğunluklu nokta bulutunu yoğunluk tabanlı aralık örneklemesiyle seyrekleştirir.
Görüntü düzleminden üç boyutlu noktaya dönüşüm
Kaynak çalışmanın Denklem (1)'inde görüntüdeki (i, j) konumu, mutlak derinlik değeri D(i,j) ve kamera iç parametreleri kullanılır:
\[ x=\frac{(i-c_i)D(i,j)}{f_x},\qquad y=\frac{(j-c_j)D(i,j)}{f_y},\qquad z=D(i,j) \tag{1} \]
Burada \(f_x\) ve \(f_y\) yatay ve dikey odak uzaklıklarını; \(c_i\) ve \(c_j\) ana nokta koordinatlarını gösterir. \(i\), \(j\), \(f_x\), \(f_y\), \(c_i\) ve \(c_j\) görüntü/piksel koordinat sistemi içindedir. \(D\) hangi uzunluk ölçeğinde ifade ediliyorsa üretilen \(x\), \(y\) ve \(z\) koordinatları aynı fiziksel ölçeği taşır.
Kamera koordinatlarının araç üzerindeki LiDAR koordinat sistemine dönüşümü kaynakta şu eksen eşlemesiyle verilir:
\[ x=-z,\qquad y=-x,\qquad z=y \tag{2} \]
64 çizgili LiDAR edinimini taklit etmek için her noktanın düşey açısı ve sensöre uzaklığı hesaplanır:
\[ \vartheta(n)= \arctan\left( \frac{z(n)} {\sqrt{x^2(n)+y^2(n)}} \right), \qquad l(n)=\sqrt{x^2(n)+y^2(n)+z^2(n)} \tag{3} \]
Noktalar düşey açıya göre tarama çizgilerine atanır, çizgi içinde menzile göre sıralanır ve azimut hücrelerine ayrılır. Her çizgi–azimut hücresinde sensöre en yakın noktanın tutulması, tek dönüşlü LiDAR ölçümünü şematik olarak taklit eder. Çalışmada sensör başlangıç noktasının 1 m üzerinde bulunan noktaların çıkarıldığı ve yansıma yoğunluklarının 1'e ayarlandığı belirtilmektedir.
Yoğunluk tabanlı aralık örnekleme
Yüksek çözünürlüklü derinlik haritasından üretilen Pseudo-LiDAR çok yoğun olabilir. UM3D, uzayı \(n\) kübik bölgeye ayırır:
\[ \Omega=\{\omega_1,\omega_2,\ldots,\omega_n\} \tag{4} \]
Her \(\omega_i\) bölgesindeki nokta sayısı \(m_i\) için ters yoğunluk ağırlığı:
\[ k_i=\frac{1}{m_i+\sigma} \tag{5} \]
olarak tanımlanır. \(\sigma\), sıfıra bölmeyi engelleyen küçük pozitif bir değerdir. Seyrek bölgelerin \(k_i\) değeri daha yüksek olduğundan örnekleme içinde göreli katkıları artar. Her bölgeden elde edilen örnek kümesi:
\[ P_i=\{p_{i1},p_{i2},\ldots,p_{ij}\} \tag{6} \]
ve nihai örneklenmiş bulut:
\[ \Gamma=\bigcup_{i=1}^{n}P_i \tag{7} \]
şeklinde oluşturulur. Kaynak \(\sigma\)'nın sayısal değerini, kübik aralıkların tam geometrik boyutlarını veya \(j\)'nin \(k_i\)'den hangi kesin örnek sayısı kuralıyla üretildiğini ayrıntılı olarak raporlamaz; bu değerler Verianla tarafından tamamlanmamıştır.
Nesne düzeyinde rastgele ölçekleme neden kullanılıyor?
Kaynak alandaki araçların fiziksel boyut dağılımı hedef alandaki araçlardan farklıysa, kaynakta eğitilen bir 3B algılayıcı hedef alandaki kutuları sistematik biçimde yanlış boyutlandırabilir. UM3D'nin Object-Level Random Scaling Strategy (ORSS) bileşeni bu önyargıyı azaltmak için etiketli kaynak-alan nesnelerini yerel kutu koordinat sisteminde ölçekler.
Boyutu \((l,w,h)\), merkezi \((u,v,d)\) ve yönelimi \(\omega\) olan bir kutudaki nokta önce yerel koordinata dönüştürülür:
\[ (p_{il},p_{iw},p_{ih})= (p_{ix}-u,p_{iy}-v,p_{iz}-d) \begin{bmatrix} \cos\omega & -\sin\omega & 0\\ \sin\omega & \cos\omega & 0\\ 0 & 0 & 1 \end{bmatrix} \tag{8} \]
Ardından boyutsuz \(f_l\), \(f_w\), \(f_h\) ölçek katsayıları uygulanır ve nokta tekrar küresel koordinata taşınır:
\[ (p_{ix},p_{iy},p_{iz})= (p_{il}f_l,p_{iw}f_w,p_{ih}f_h) \begin{bmatrix} \cos\omega & \sin\omega & 0\\ -\sin\omega & \cos\omega & 0\\ 0 & 0 & 1 \end{bmatrix} +(u,v,d) \tag{9} \]
Kaynak makale \(f_l\), \(f_w\) ve \(f_h\) için kullanılan rastgele örnekleme aralıklarını sayısal olarak vermemektedir. Dolayısıyla bu parametrelerin dağılımı veya sınırları burada varsayılmamıştır.
Sahte etiket kalitesi nasıl kontrol ediliyor?
UM3D, algılayıcıya eklenen IoU regresyon başlığıyla tahmin edilen 3B kutunun kalite puanını öğrenir. Kaynakta kalite kaybı ikili çapraz entropi biçiminde verilir:
\[ L_{\mathrm{quality}} =-(1-\hat{s})\log(1-s)-\hat{s}\log(s) \tag{10} \]
\(s\), modelin kutu için öngördüğü IoU kalite değerini; \(\hat{s}\) ise tahmin kutusunun gerçek kutu veya sahte etiketle hesaplanan IoU değerini temsil eder.
Uygulamada pozitif eşik \(Thr_p=0.5\), negatif eşik \(Thr_n=0.2\) olarak verilmiştir. \(s_i>Thr_p\) olan kutular pozitif örnek olarak belleğe alınır; \(Thr_n<s_i<Thr_p\) aralığındaki kutular eğitim sırasında yok sayılacak bölgeleri belirtmek üzere bellekte tutulur; \(s_i<Thr_n\) olanlar atılır.
Tarihsel sahte etiket kümesi \(H\) ve mevcut küme \(C\) için 3B IoU:
\[ \mathrm{IoU}(H,C)= \frac{\cap_{H,C}}{\cup_{H,C}} \tag{11} \]
üzerinden hesaplanır ve her tarihsel kutu için en güçlü mevcut eşleşme seçilir:
\[ \mathrm{optimum}(H,C) = \underset{C}{\arg\max}\, |\mathrm{IoU}(H,C)| \tag{12} \]
Eşleşmeyen tarihsel kutular için sayaç mekanizması kullanılır:
\[ \mathrm{state}= \begin{cases} 1, & \mathrm{counter}(H)\lt Thr_i\\ 0, & Thr_i\leq \mathrm{counter}(H)\lt Thr_r\\ -1, & \mathrm{counter}(H)\geq Thr_r \end{cases} \tag{13} \]
\(\mathrm{state}=1\) bellekte tutma, \(\mathrm{state}=0\) yok sayma, \(\mathrm{state}=-1\) ise silme anlamına gelir. Kaynak \(Thr_i\) ve \(Thr_r\) eşiklerini kavramsal olarak tanımlar ancak uygulama ayrıntılarında bunların sayısal değerlerini raporlamaz. Buna karşılık mevcut–tarihsel sahte etiket eşleştirmesinde kullanılan IoU eşiği 0,1 olarak belirtilmiştir.
Görüntü ve Pseudo-LiDAR özellikleri nasıl birleştiriliyor?
UM3D'nin çok modlu algılayıcısı LoGoNet mimarisini temel alır. Nokta bulutu voxel yapısına dönüştürülerek 3B backbone ve Region Proposal Network (RPN) tarafından işlenir. Aynı anda önceden eğitilmiş bir 2B algılayıcı monoküler görüntüden görüntü özellikleri çıkarır.
LoGoNet'in iki füzyon aşaması korunur. Aday bölge dışı füzyon, voxel merkezlerini görüntü düzlemine izdüşürerek küresel geometrik düzeni ilişkilendirir. Aday bölge içi füzyon ise her öneri içindeki yerel ayrıntıyı çapraz-dikkat ile işler. Çalışmanın değiştirdiği bölüm, bu iki çıkışın yalnız birleştirilmesi yerine öz-dikkat tabanlı ağırlıklı özellik toplamasıdır.
\[ F=[F_{\mathrm{out}};F_{\mathrm{in}}], \qquad Q=W_QF,\quad K=W_KF,\quad V=W_VF \tag{14} \]
Burada \(F_{\mathrm{out}}\) bölge dışı, \(F_{\mathrm{in}}\) bölge içi füzyon özelliğidir. \(W_Q\), \(W_K\) ve \(W_V\) öğrenilebilir izdüşüm matrisleridir. Ölçekli noktasal çarpım dikkati:
\[ \mathrm{Attention}(Q,K,V) = \mathrm{softmax} \left( \frac{QK^\top}{\sqrt{d_k}} \right)V \tag{15} \]
şeklindedir. \(d_k\), anahtar vektörlerinin boyutudur. Matematiksel olarak mekanizma, her özellik konumunun diğer özellik konumlarıyla ilişkisini ağırlıklandırarak sınıflandırma ve kutu regresyonu için daha seçici bir birleşik gösterim oluşturur.
Diferansiyellenebilir CoR neden kritik?
Klasik voxelizasyon bir noktanın hücre içinde olup olmamasını 0 veya 1 ile ifade eder. Bu keskin karar, koordinat değişiminin küçük değişiklikleri karşısında süreksiz olduğundan derinlik ağına geri yayılacak gradyanı kesebilir. UM3D, E2E-PL'den alınan Change of Representation (CoR) yaklaşımını yoğunluk tabanlı örneklemeyle birlikte kullanır ve voxel doluluğunu yumuşak RBF ağırlıklarıyla ifade eder.
Bir hücre \(u\) içindeki \(P_u\) noktaları için:
\[ W(u) = \frac{1}{|P_u|} \sum_{p\in P_u} e^{-\|p-p_c\|_2^2/\delta^2} \tag{16} \]
ve komşu hücreler \(\Upsilon_u\) hesaba katıldığında:
\[ T_{\mathrm{softquantization}}(u) = W(u)+ \frac{1}{|\Upsilon_u|} \sum_{\bar{u}\in\Upsilon_u} W(\bar{u}) \tag{17} \]
elde edilir. \(p_c\) voxel merkezidir; \(\delta\) RBF bant genişliğiyle ilişkilidir. Deney ayarlarında \(\delta^2=0.01\) ve 26 komşulu 3×3×3 yumuşatma çekirdeği kullanılmıştır. Bu yumuşak gösterimin temel algoritmik işlevi, algılama hatasının nokta temsili üzerinden derinlik ağına geri yayılabilmesini sağlamaktır.
Toplam öğrenme amacı
Uçtan uca toplam kayıp:
\[ L=\alpha L_{\mathrm{depth}}+\beta L_{\mathrm{detection}} \tag{18} \]
şeklindedir. Deneylerde \(\alpha=1\) ve \(\beta=0.01\) kullanılmıştır.
Kaynakta derinlik kaybı Denklem (19) ile şu biçimde raporlanır:
\[ L_{\mathrm{depth}} = \min_{t'} p_e(I_t,I_{t'\rightarrow t})L_p +\mu L_{\mathrm{smooth}} \tag{19} \]
Fotometrik bileşen ve düzgünlük bileşeni:
\[ L_p=\sum_{t'}\ell(I_t,I_{t'\rightarrow t}) \tag{20} \]
\[ L_{\mathrm{smooth}} = |\nabla_x d_t^*|e^{-|\nabla_x I_t|} + |\nabla_y d_t^*|e^{-|\nabla_y I_t|} \tag{21} \]
şeklindedir. \(d_t^*\) normalize ters derinliği, \(\nabla_x\) ve \(\nabla_y\) yatay ve düşey gradyanları gösterir. Düzgünlük ağırlığı deneylerde \(\mu=0.001\)'dir.
Algılama kaybı:
\[ L_{\mathrm{detection}} = L_{\mathrm{RPN}} + L_{\mathrm{conf}} + \lambda L_{\mathrm{reg}} \tag{22} \]
olarak verilir. \(L_{\mathrm{RPN}}\) bölge öneri ağı kaybı, \(L_{\mathrm{conf}}\) güven/tahmin kaybı ve \(L_{\mathrm{reg}}\) kutu regresyon kaybıdır. Deneylerde \(\lambda=2.0\) kullanılmıştır.
Üç aşamalı eğitim mantığı
- Kaynak alan ön eğitimi: Gerçek etiketli kaynak-alan nokta bulutu verileriyle IoU başlıklı algılayıcı ORSS kullanılarak önceden eğitilir.
- Hedef alan kendi kendine eğitim: Hedef alanda tahmin kutuları ve IoU kalite puanları oluşturulur; üç aralıklı bellek bankası güncellenir ve sahte etiketlerle eğitim sürdürülür.
- Uçtan uca monoküler ortak optimizasyon: Görüntüden derinlik oluşturulur, diferansiyellenebilir CoR ile Pseudo-LiDAR üretilir, sahte etiketler güncellenir ve derinlik → CoR → çok modlu algılama zinciri tek toplam kayıp altında birlikte optimize edilir.
Çalışmanın Yöntemi ve Bulguları
Uygulama ayrıntıları
| Öğe | Kaynakta raporlanan değer |
|---|---|
| Hedef-alan self-training optimizer | Adam |
| Self-training öğrenme oranı | 0.0015 |
| Self-training süresi | 40 epoch |
| Sahte etiket güncelleme | Her epoch |
| Uçtan uca giriş/çıkış çözünürlüğü | 1024 × 320 |
| Framework | PyTorch 1.10.0 |
| Uçtan uca optimizer | Adam |
| Başlangıç öğrenme oranı | 0.001 |
| Öğrenme oranı azaltımı | Her 10 epoch'ta ×0.1 |
| Uçtan uca eğitim | 30 epoch |
| \(\alpha\) | 1 |
| \(\beta\) | 0.01 |
| \(\mu\) | 0.001 |
| \(\lambda\) | 2.0 |
| RBF | \(\delta^2=0.01\) |
| Yumuşatma komşuluğu | 26 komşu, 3×3×3 |
| \(Thr_p\) | 0.5 |
| \(Thr_n\) | 0.2 |
| Bellek bankası IoU eşleştirme eşiği | 0.1 |
Veri kümeleri ve değerlendirme alanı
| Veri kümesi | Kaynakta verilen kapsam | Çalışmadaki rol |
|---|---|---|
| KITTI | 7481 eğitim, 7518 test örneği; Easy/Moderate/Hard değerlendirme | Önemli hedef alanlardan biri |
| Waymo Open Dataset (WOD) | 798 eğitim, 202 doğrulama, 150 test sekansı | Kaynak alan / çapraz veri kümesi aktarımı |
| nuScenes | 1000 sahne; Boston ve Singapur | Kaynak veya hedef alan |
| Lyft | 55.000'den fazla anotasyonlu kare | Kaynak veya hedef alan |
Tüm veri kümeleri için algılama alanı \(X/Y\in[-75.2,75.2]\) m ve \(Z\in[-2,4]\) m olarak belirlenmiştir. SECOND ve LoGoNet için voxel boyutu \((0.1,0.1,0.15)\) m'dir. Veri artırma; küresel rastgele ölçekleme, döndürme, çevirme ve nesne başına ölçekleme/döndürmeyi içerir.
Closed Gap Metriği Ne Anlama Gelir?
Closed Gap, kaynak alanda eğitilip hedef alana doğrudan uygulanan model ile hedef alanda tam denetimli eğitilen Oracle arasındaki performans farkının, alan uyarlama yöntemi tarafından ne kadarının kapatıldığını yüzde olarak ifade eder; değer yükseldikçe uyarlanmış model Oracle performansına yaklaşır, ancak oran kullanılan Source Only ve Oracle referanslarına bağlıdır ve farklı deney düzenleri arasında bağlamdan koparılarak karşılaştırılmamalıdır.
Kaynakta kullanılan denklem:
\[ \mathrm{Closed\ Gap} = \frac{AP_{\mathrm{model}}-AP_{\mathrm{sourceonly}}} {AP_{\mathrm{oracle}}-AP_{\mathrm{sourceonly}}} \times100\% \tag{23} \]
Nokta bulutu UDA sonuçları
Aşağıdaki tablo, kaynak Tables 2–4'teki olgusal değerlerin Verianla için yeni bir tablo düzeninde bir araya getirilmiş halidir. AP sütunlarında sıra APBEV/AP3D'dir.
| Aktarım | Algılayıcı | Source Only | SN | ST3D | UM3D | Oracle | UM3D Closed Gap BEV/3D |
|---|---|---|---|---|---|---|---|
| nuScenes → KITTI | LoGoNet | 54.56/23.15 | 47.69/32.38 | 78.26/57.41 | 80.17/58.20 | 90.72/84.87 | 70.84%/56.79% |
| nuScenes → KITTI | SECOND | 51.84/17.92 | 40.03/21.23 | 75.94/54.13 | 76.25/54.38 | 83.29/73.45 | 77.62%/65.66% |
| WOD → KITTI | LoGoNet | 69.12/31.59 | 79.95/62.25 | 84.67/65.39 | 85.71/67.44 | 90.72/84.87 | 76.81%/67.27% |
| WOD → KITTI | SECOND | 67.64/27.48 | 78.96/59.20 | 82.19/61.83 | 82.96/62.75 | 83.29/73.45 | 97.89%/76.73% |
| WOD → nuScenes | LoGoNet | 39.28/24.65 | 40.15/26.36 | 42.58/28.14 | 44.10/29.57 | 55.62/39.18 | 29.49%/33.86% |
| WOD → nuScenes | SECOND | 32.91/17.24 | 33.23/18.57 | 35.92/20.19 | 36.84/23.62 | 51.88/34.87 | 20.72%/36.18% |
| WOD → Lyft | LoGoNet | 74.87/57.61 | 74.93/57.89 | 78.14/59.93 | 79.06/61.28 | 85.33/71.52 | 40.05%/26.38% |
| WOD → Lyft | SECOND | 72.92/54.34 | 72.33/54.34 | 76.32/59.24 | 76.14/59.19 | 84.47/68.78 | 27.88%/33.59% |
Sonuçlar tek bir model/aktarım çiftinde mutlak üstünlük iddiasına indirgenmemelidir. Örneğin WOD → Lyft SECOND konfigürasyonunda ST3D'nin APBEV değeri 76,32 iken UM3D 76,14'tür; buna karşılık UM3D'nin AP3D değeri 59,19, ST3D'nin değeri 59,24'tür. Yani bu konfigürasyonda farklar çok küçüktür ve UM3D her hücrede en yüksek sonucu üretmez.
Monoküler WOD/nuScenes/Lyft → KITTI sonuçları
KITTI hedef alanında Source Only değerleri çalışmada bütün Easy/Moderate/Hard APBEV ve AP3D hücreleri için 0 olarak raporlanmıştır. Aşağıdaki tablo STMono3D, UM3D ve Oracle sonuçlarını gösterir.
| Aktarım | Yöntem | APBEV Easy | APBEV Mod. | APBEV Hard | AP3D Easy | AP3D Mod. | AP3D Hard |
|---|---|---|---|---|---|---|---|
| nuScenes → KITTI | STMono3D | 35.63 | 27.37 | 23.95 | 28.65 | 21.89 | 19.55 |
| nuScenes → KITTI | UM3D | 36.81 | 27.60 | 22.94 | 29.37 | 22.16 | 18.93 |
| nuScenes → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
| Lyft → KITTI | STMono3D | 26.46 | 20.71 | 17.66 | 18.14 | 13.32 | 11.83 |
| Lyft → KITTI | UM3D | 28.23 | 21.59 | 17.98 | 19.32 | 13.35 | 11.16 |
| Lyft → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
| WOD → KITTI | STMono3D | 35.69 | 26.94 | 23.19 | 28.34 | 20.21 | 18.03 |
| WOD → KITTI | UM3D | 36.10 | 27.67 | 23.48 | 29.08 | 20.92 | 18.84 |
| WOD → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
Bazı monoküler hücrelerde UM3D'nin Oracle değerini aşması dikkatli yorumlanmalıdır. Makaledeki Oracle, hedef alanda tam denetimli eğitilen görüntü-tabanlı FCOS3D'dir. UM3D ise tek kamerayla çıkarım yapmasına rağmen aynı görüntüden türettiği Pseudo-LiDAR geometrisini görüntü özellikleriyle birleştirir ve daha geniş kaynak-alan ön eğitiminden yararlanır. Dolayısıyla burada karşılaştırılan iki sistemin temsil yapıları aynı değildir. Bu sonuç “denetimsiz öğrenme genel olarak tam denetimli öğrenmeden üstündür” anlamına gelmez.
nuScenes hedef alanındaki monoküler sonuçlar
| Aktarım | Yöntem | mAP | mATE | mASE | mAOE |
|---|---|---|---|---|---|
| WOD → nuScenes | Source Only | 2.4 | 1.302 | 0.190 | 0.802 |
| WOD → nuScenes | STMono3D | 23.5 | 0.843 | 0.171 | 0.349 |
| WOD → nuScenes | UM3D | 25.7 | 0.820 | 0.168 | 0.311 |
| WOD → nuScenes | Oracle | 28.2 | 0.798 | 0.160 | 0.209 |
| Lyft → nuScenes | Source Only | 2.4 | 1.302 | 0.190 | 0.802 |
| Lyft → nuScenes | STMono3D | 21.3 | 0.911 | 0.170 | 0.355 |
| Lyft → nuScenes | UM3D | 22.1 | 0.898 | 0.173 | 0.304 |
| Lyft → nuScenes | Oracle | 28.2 | 0.798 | 0.160 | 0.209 |
mAP için daha yüksek değer daha iyi algılama hassasiyetini ifade ederken mATE, mASE ve mAOE hata metrikleridir; bu nedenle bunlarda daha düşük değer tercih edilir. WOD → nuScenes aktarımında UM3D, STMono3D'ye göre mAP'yi 23,5'ten 25,7'ye yükseltirken mATE'yi 0,843'ten 0,820'ye, mASE'yi 0,171'den 0,168'e ve mAOE'yi 0,349'dan 0,311'e düşürmüştür.
ORSS ve PLGM ablasyonu
| Modül | Algılayıcı | APBEV | AP3D |
|---|---|---|---|
| Source Only | SECOND | 67.64 | 27.48 |
| Source Only | LoGoNet | 69.12 | 31.59 |
| Baseline + ORSS | SECOND | 78.29 | 55.13 |
| Baseline + ORSS | LoGoNet | 79.46 | 56.08 |
| Baseline + PLGM | SECOND | 81.30 | 59.42 |
| Baseline + PLGM | LoGoNet | 83.25 | 61.91 |
| Baseline + PLGM + ORSS | SECOND | 82.96 | 62.75 |
| Baseline + PLGM + ORSS | LoGoNet | 85.71 | 67.44 |
LoGoNet tabanında yalnız ORSS eklenmesi Source Only'ye göre APBEV/AP3D'yi 69,12/31,59'dan 79,46/56,08'e çıkarır. Yalnız PLGM 83,25/61,91'e ulaşır. İki bileşenin birlikte kullanılması 85,71/67,44 ile en yüksek sonucu verir. Bu tablo, çalışmanın sahte etiket belleği ile nesne ölçekleme müdahalelerinin aynı işlevi tekrar etmediğini, birbirini tamamlayan etkiler sunduğunu gösteren temel ablasyon kanıtıdır.
Uçtan uca ortak eğitimin ablasyonu
| Ortak optimize edilen ağ | APBEV Easy | APBEV Mod. | APBEV Hard | AP3D Easy | AP3D Mod. | AP3D Hard |
|---|---|---|---|---|---|---|
| Depth | 30.26 | 20.71 | 17.35 | 25.51 | 16.06 | 14.48 |
| RCNN | 32.01 | 22.56 | 18.55 | 26.75 | 17.69 | 15.41 |
| RPN | 32.64 | 22.87 | 18.94 | 26.14 | 17.52 | 14.34 |
| RCNN + RPN | 33.89 | 23.42 | 19.80 | 26.99 | 17.10 | 15.85 |
| Depth + RPN | 35.62 | 26.36 | 21.16 | 28.74 | 19.23 | 16.19 |
| Depth + RCNN | 35.98 | 26.73 | 23.20 | 29.32 | 19.15 | 17.41 |
| Depth + RCNN + RPN | 36.10 | 27.67 | 23.48 | 29.08 | 20.92 | 18.84 |
Moderate APBEV, RCNN + RPN ortak eğitiminde 23,42 iken derinlik ağı da ortak optimizasyona katıldığında 27,67'ye yükselir. Kaynak yazarları bu 4,25 puanlık farkı algılama gradyanının derinlik kestirimine geri akmasının önemine bağlamaktadır. Tam üç ağlı yapı altı AP hücresinin beşinde en yüksek değere ulaşır; tek istisna Easy AP3D'dir. Burada Depth + RCNN 29,32, tam yapı ise 29,08 üretmiştir.
Çalışmanın özetinde belirtilen %19,30 göreli APBEV artışı da Easy koşulunda yalnız Depth satırındaki 30,26 ile tam Depth + RCNN + RPN satırındaki 36,10 karşılaştırmasına karşılık gelir.
Nitel sonuçlar ne gösteriyor?
Kaynak Şekil 5'te WOD → KITTI nokta bulutu uyarlaması görselleştirilir. Source Only modelinin alanlar arası geometrik uyumsuzluk nedeniyle bazı araç kutularını belirgin biçimde küçük ürettiği; ST3D'nin bunu iyileştirdiği; UM3D'nin kutu konum ve boyutlarını Oracle'a daha fazla yaklaştırdığı görülmektedir.
Kaynak Şekil 6'da aynı aktarım monoküler 3B görünüm ve BEV üzerinden karşılaştırılır. Source Only modelinin 2B nesneleri bulmasına rağmen derinlik kestirimindeki büyük hata nedeniyle 3B AP'nin neredeyse sıfıra indiği; STMono3D'nin derinlik hatasını azalttığı; UM3D tahminlerinin ise birçok örnekte Oracle'a daha fazla yaklaştığı raporlanmaktadır. Bu şekiller nicel tabloların yerine geçmez; yalnız kutu geometrisindeki alan uyarlama etkisini görsel olarak destekler.
Hesaplama maliyeti
Tek NVIDIA RTX 3080 üzerinde tek karelik çıkarım yaklaşık 127 ms, yani 7,9 FPS olarak ölçülmüştür. Bunun yaklaşık 15,5 ms'si 14,5 milyon parametreli RSANet derinlik ağına, 8,1 ms'si CoR ve yoğunluk tabanlı Pseudo-LiDAR üretimine, 103,7 ms'si ise çok modlu algılayıcıya aittir. Toplam model yaklaşık 60,5 milyon parametre içerir. Dolayısıyla mevcut uygulamada darboğaz derinlik kestirimi değil, 3B voxel backbone, RPN, 2B özellik çıkarıcı ve iki aşamalı çapraz-modlu füzyonu içeren algılama katmanıdır.
Çalışmanın desteklediği sonuçlar
- UM3D, incelenen birçok kaynak→hedef aktarımında Source Only ve karşılaştırılan UDA yöntemlerine göre performans kazanımı sağlamaktadır.
- ORSS ve PLGM birlikte kullanıldığında WOD → KITTI ablasyonunda her iki algılayıcı için de en yüksek birleşik sonuç elde edilmektedir.
- Derinlik kestiriminin algılama hedefiyle birlikte optimize edilmesi, yalnız algılama alt ağlarını ortak eğitmeye göre belirgin APBEV kazanımı sağlamaktadır.
- Görüntü ve Pseudo-LiDAR füzyonu, yalnız tek bir modaliteye dayalı alan uyarlamasına karşı kaynak çalışmanın merkezî tasarım avantajıdır.
- Çıkarım aşamasında Pseudo-LiDAR aynı monoküler görüntüden üretildiğinden ek LiDAR sensörü gerekmemektedir.
Çalışmanın desteklemediği genellemeler ve sınırlılıklar
- Sonuçlar bütün nesne sınıfları için eşit başarı kanıtlamaz; çalışma ağırlıklı olarak otomobil sınıfına odaklanmıştır.
- Uzun menzilde algılama, kendinden denetimli derinlik kestiriminin doğruluğuyla sınırlıdır.
- 7,9 FPS'lik raporlanan RTX 3080 uygulaması tam gerçek-zamanlı araç içi üretim sisteminin doğrulandığı anlamına gelmez; yazarlar model sıkıştırma ve çıkarım hızlandırmayı gelecekteki çalışma olarak belirtmektedir.
- KITTI veya nuScenes benchmark başarısı, başka kamera geometrileri, hava koşulları, ülkeler veya üretim araçları için aynı performansı garanti etmez.
- Bazı monoküler deneylerde Oracle'ın aşılması, genel olarak denetimsiz öğrenmenin tam denetimli öğrenmeden üstün olduğunu göstermez; karşılaştırılan Oracle'ın görüntü-tabanlı FCOS3D olması ve UM3D'nin Pseudo-LiDAR geometrisiyle farklı bir özellik temsili kullanması dikkate alınmalıdır.
- Kaynak \(f_l,f_w,f_h\) ölçek aralıklarını, \(\sigma\)'nın sayısal değerini ve bellek bankasındaki \(Thr_i\), \(Thr_r\) eşiklerinin sayısal değerlerini raporlamadığından yalnız makale metni üzerinden her ayrıntısıyla yeniden üretim yapılamaz.
Kaynak ve Yöntem Notu
Özgün çalışma: Unsupervised Domain Adaptation with Multimodal Fusion for Monocular 3D Object Detection
Yazarlar: Jin Jiang; Jidong Dai; Wei Li; Yuquan Zhou; Maozhang Ye; Jianhuan Zhang; Chentao Zhang.
Sorumlu yazar: Chentao Zhang.
Kurumlar: Xiamen King Long United Automotive Industry Co., Ltd., Xiamen, Çin; Pen-Tung Sah Institute of Micro-Nano Science and Technology, Xiamen University, Xiamen, Çin; School of Artificial Intelligence, Quanzhou Vocational College of Economics and Business, Quanzhou, Çin.
Dergi: Vehicles.
Yayıncı: MDPI, Basel, Switzerland.
Bibliyografik kayıt: Vehicles 2026, 8(5), 98.
DOI: 10.3390/vehicles8050098
Resmî DOI bağlantısı: https://doi.org/10.3390/vehicles8050098
Tarihçe: Gönderim 7 Mart 2026; revizyon 22 Nisan 2026; kabul 25 Nisan 2026; yayın 1 Mayıs 2026.
Kaynak türü: Yayımlanmış akademik araştırma makalesi.
Lisans: Creative Commons Attribution (CC BY). Bu Verianla metni, lisansın varlığına rağmen özgün makalenin cümle, paragraf veya şekil düzenini yeniden yayımlamak yerine bilimsel olgular, yöntemler, matematiksel ilişkiler ve raporlanan veriler üzerinden bağımsız bir öğretici yapı olarak hazırlanmıştır.
Finansman: Major Science and Technology Special Project of Fujian Province, Grant No. 2024HZ022013; Applied Technology Engineering Center of Fujian Provincial Higher Education for Visual Perception and Intelligent Analysis, Grant No. SJGZ202501.
Veri erişilebilirliği: Yazarlar özgün katkıların makale içinde bulunduğunu, ek soruların sorumlu yazara yöneltilebileceğini belirtmektedir.
Etik beyanlar: Institutional Review Board ve informed consent alanları çalışma için uygulanabilir değildir.
Çıkar çatışması: Jin Jiang ve Wei Li, Xiamen King Long United Automotive Industry Co., Ltd. çalışanıdır. Diğer yazarlar araştırmanın potansiyel çıkar çatışması olarak yorumlanabilecek ticari veya finansal ilişkiler bulunmadan yürütüldüğünü beyan etmiştir.
Yazar katkıları: Kavramsallaştırma Jin Jiang ve Chentao Zhang; yöntem Jin Jiang ve Wei Li; yazılım Jidong Dai; doğrulama Jidong Dai ve Yuquan Zhou; biçimsel analiz Jidong Dai ve Jianhuan Zhang; araştırma Jin Jiang, Wei Li ve Maozhang Ye; kaynaklar Wei Li ve Maozhang Ye; veri kürasyonu Jidong Dai ve Yuquan Zhou; ilk taslak Jin Jiang; gözden geçirme/düzenleme Jianhuan Zhang ve Chentao Zhang; görselleştirme Jidong Dai ve Yuquan Zhou; denetim Jin Jiang, Jianhuan Zhang ve Chentao Zhang; proje yönetimi Chentao Zhang; finansman edinimi Jin Jiang ve Chentao Zhang tarafından yürütülmüştür.
Kaynak içi raporlama notu: Özet ve sonuç bölümü WOD → KITTI için APBEV alan farkının %76,81'e kadar kapatıldığını belirtirken, Tablo 2'nin SECOND satırı %97,89 APBEV Closed Gap raporlamaktadır. Kaynak bu farkı ayrıca açıklamadığından iki değer de kendi deney bağlamlarıyla korunmalıdır.
Yöntemsel sınır: Çalışma farklı benchmark veri kümeleri üzerinde algoritmik çapraz-alan doğrulaması sunar. Bu kanıt, gerçek üretim aracında uzun dönem saha güvenliği, tüm nesne sınıflarında genellenebilirlik veya her yeni sensör/coğrafya kombinasyonunda aynı başarı düzeyi anlamına gelmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir