

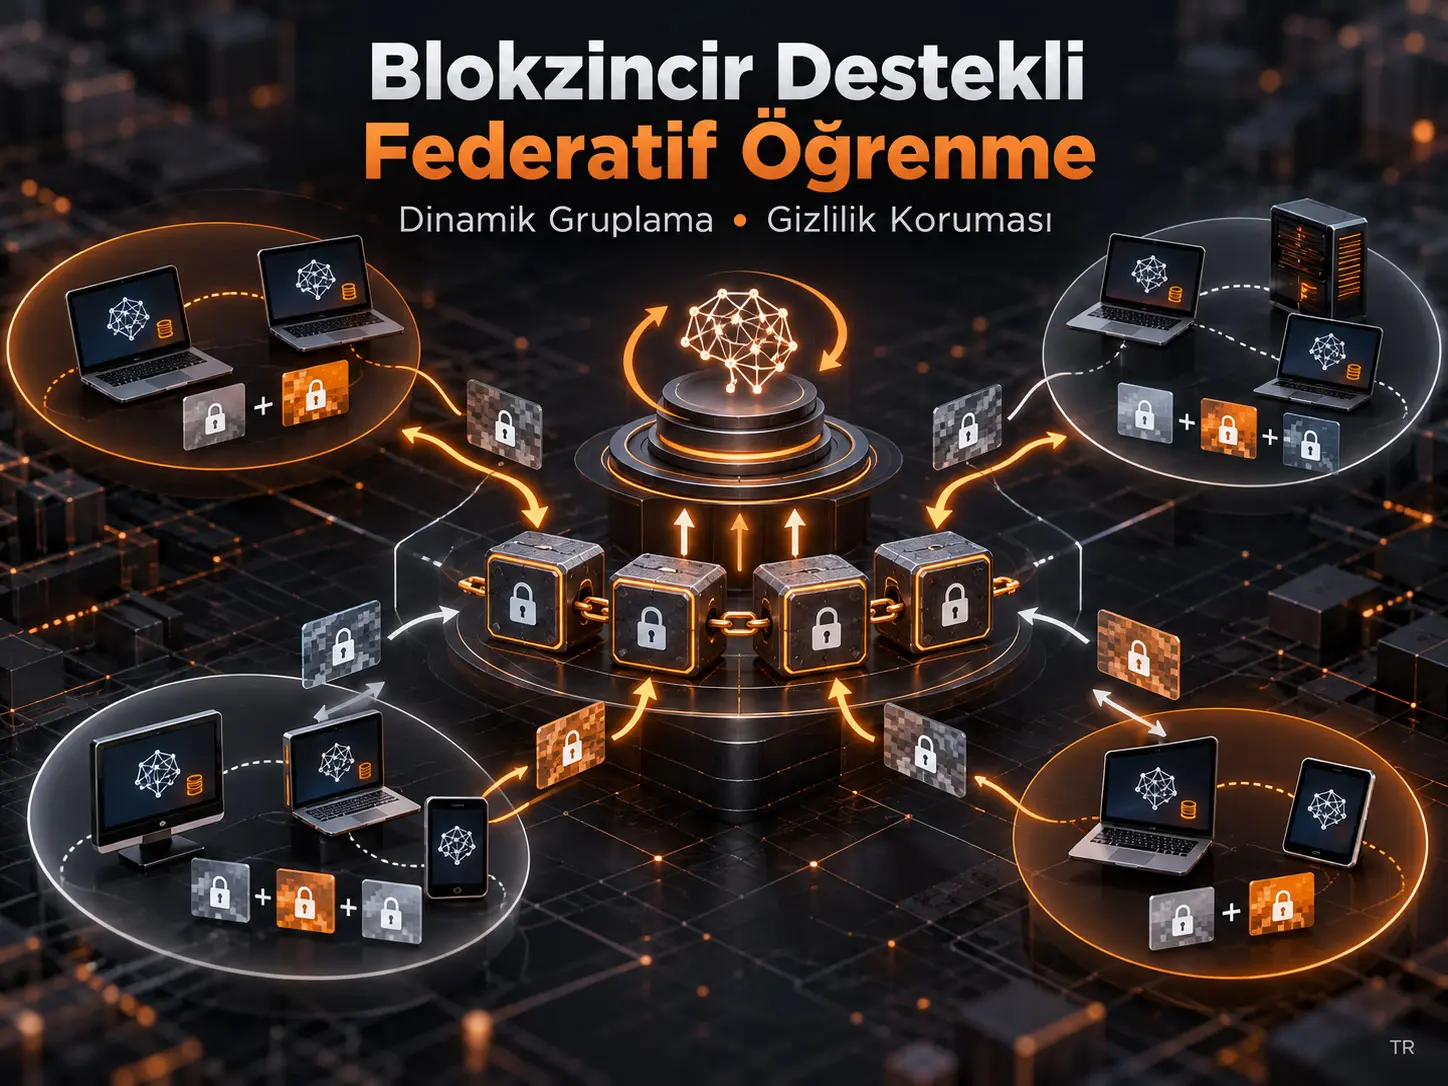
Bu çalışmada önerilen sistem, yerel eğitim verilerini merkezi bir noktaya taşımadan ortak bir makine öğrenmesi modeli geliştirmeyi amaçlayan federatif öğrenmeyi; izinli Hyperledger Fabric blokzinciri, dinamik kullanıcı gruplaması, grup tabanlı toplamsal paylaşım, geçici körleme ve itibar destekli koordinasyonla birleştiren bir gizlilik-korumalı işbirlikçi öğrenme çerçevesidir. Kullanıcıların ham eğitim verileri blokzincire yüklenmez. Yerel gradyanlar da doğrudan zincire yazılmak yerine önce iki veya üç kullanıcılı gruplarda paylara ayrılır, pay düzeyi değerler geçici rastgele vektörlerle körlenir ve yalnız bu körlenmiş değerler ile toplulaştırmaya ilişkin kayıtlar izinli deftere aktarılır.
Çerçeve, her iletişim turunda kullanıcıları itibar ve işbirliği istekliliğine göre iki veya üç kişilik gruplara ayırır. Yerel gradyanlar sonlu bir alan üzerinde toplamsal paylara dönüştürülür; her yüklenen pay düzeyi değer ayrı bir rastgele vektörle maskelenir. Rastgele vektörlerin gerekli toplamı, kullanıcı ayrılması veya gerekli kurtarma bilgisinin verilmemesi durumuna karşı yetkili bir kurtarma komitesi tarafından eşik tabanlı biçimde desteklenir. Hyperledger Fabric katmanı ise kimlik doğrulama, chaincode yürütme, endorsement, sıralama, doğrulama ve denetlenebilir kayıt görevlerini üstlenir.
Kavram kanıtlama deneyleri MNIST veri seti üzerinde gerçekleştirilmiştir. İki taraflı toplamsal paylaşım işlemi yaklaşık 12,6 ms, üç taraflı paylaşım yaklaşık 16,9 ms sürmüştür. Makale metninde önerilen yöntemin karşılaştırmalı MNIST deneyinde %99,6 doğruluğa ulaştığı bildirilirken Şekil 8 üzerindeki etiket %99,56'dır. Yazarların bildirdiği fark, karşılaştırılan yöntemlere göre 1,06 ile 3,96 yüzde puanı arasındadır. Bununla birlikte sonuçlar yalnız değerlendirilen prototip ortamına aittir: çalışma tam bir simulation-based kriptografik güvenlik kanıtı sunmaz, Byzantine model zehirleme veya sınırsız işbirliğine karşı güvenlik göstermez ve gerçek sağlık verisi üzerinde klinik doğrulama yapmaz.
Federatif öğrenmede gizlilik sorunu nerede ortaya çıkıyor?
Federatif öğrenmede temel fikir ham veriyi kullanıcının cihazında tutmak ve merkezi eğitim için verinin kendisi yerine model parametreleri veya gradyanlar gibi güncelleme bilgilerini paylaşmaktır. Bu yaklaşım ham verinin doğrudan merkezileştirilmesini önlese de model güncellemelerinin kendisi de bilgi taşıyabilir. Kaynak çalışma bu nedenle “ham veri zincire gitmiyor” koşulunu tek başına yeterli bir gizlilik garantisi olarak değerlendirmiyor; özellikle bireysel yerel güncellemelerin doğrudan görünürlüğünü azaltmaya odaklanıyor.
Bir kullanıcı \(u_i\)'nin yerel veri kümesi kaynakta
\[ D_i=\{(x_{i,k},y_{i,k})\}_{k=1}^{N_i} \]
olarak tanımlanır. Burada \(N_i\) kullanıcının sahip olduğu yerel örnek sayısıdır. \(x_{i,k}\) giriş örneğini, \(y_{i,k}\) ise etiketi gösterir.
İletişim turu \(t\)'de global model parametre vektörü \(W^{(t)}\) ise kullanıcının ampirik kaybı
\[ L_i(W^{(t)})= \frac{1}{N_i} \sum_{k=1}^{N_i} \ell\left( f(x_{i,k};W^{(t)}),y_{i,k} \right) \]
ile ifade edilir. Yerel gradyan
\[ g_i^{(t)}=\nabla L_i(W^{(t)}) \]
olarak hesaplanır ve kaynakta yerel model güncellemesi
\[ W_i^{(t+1)} = W^{(t)}-\alpha g_i^{(t)} \]
şeklinde verilir. Bu formüldeki \(\alpha>0\), kaynak tarafından öğrenme oranı olarak tanımlanmıştır.
Önerilen protokolün gizlilik müdahalesi, \(g_i^{(t)}\) gradyanının bu haliyle blokzincire yüklenmesinden önce gerçekleşir. Gradyan önce sonlu bir alan üzerinde kodlanır, küçük bir grup içinde toplamsal paylara ayrılır ve zincire gidecek pay düzeyi değer ayrıca geçici bir rastgele vektörle körlenir.
Hyperledger Fabric neden kullanılıyor?
Çalışma genel bir permissionless blockchain veya Proof-of-Work sistemi kurmuyor. Hyperledger Fabric, kimlerin ağa katılabildiğinin kontrol edildiği izinli bir blokzincir platformu olarak kullanılıyor. Fabric peers işlemleri endorsement, ordering, validation ve ledger commitment aşamalarından geçirirken chaincode, pay düzeyi kayıtları ile toplulaştırma sürecine ilişkin mantığı yürütüyor.
Sistem beş temel varlık içeriyor: yerel veriyle eğitim yapan istemciler; yetkili Fabric peers; akıllı sözleşme işlevini yerine getiren chaincode; sertifika tabanlı üyelik hizmeti ve geçici körleme vektörlerinin gerektiğinde eşik mekanizmasıyla kurtarılmasını sağlayan yetkili kurtarma komitesi.
Kurtarma komitesi
\[ C_{\mathrm{rec}}=\{c_1,c_2,\ldots,c_h\} \]
kümesiyle, gerekli eşik ise
\[ \tau_{\mathrm{rec}}\in\{1,2,\ldots,h\} \]
ile tanımlanır. En az \(\tau_{\mathrm{rec}}\) geçerli kurtarma payı bulunmadıkça eksik bir rastgele vektör katkısı yeniden oluşturulamaz. Komitenin rolü yerel model eğitimine katılmak değil, yalnız güvenilen kurtarma kapsamı içinde global toplulaştırma için gereken toplam rastgele vektörü oluşturabilmektir.
Dinamik gruplama nasıl çalışıyor?
Dinamik gruplama, her iletişim turunda kullanıcıları önce itibar sırasına koyan, ikili uyumluluk puanlarıyla iki kullanıcılı çekirdek gruplar kuran ve yeterli genişletme puanı varsa grubu üç kullanıcıya çıkaran; eşleşmeden kalan kullanıcıları ise itibar skorlarıyla sistematik biçimde atayan iki aşamalı bir gruplama mekanizmasıdır.
İletişim turu \(t\)'de kullanıcıların ikili çalışma isteğini gösteren matris
\[ \Omega^{(t)} = \left(w_{ij}^{(t)}\right)_{m\times m} \]
olarak tanımlanır. Kaynakta
\[ w_{ij}^{(t)}\in\{0,1,2\} \]
olup 2 yüksek, 1 orta, 0 düşük istekliliği temsil eder. İki kullanıcı arasındaki çift yönlü uyumluluk
\[ s_{ij}^{(t)} = w_{ij}^{(t)}+w_{ji}^{(t)} \]
ile hesaplanır.
Her turun başında henüz gruba atanmamış kullanıcılar itibar puanlarına göre büyükten küçüğe sıralanır. En yüksek itibarlı kullanıcı başlatıcı olur ve kendisiyle en yüksek \(s_{ij}^{(t)}\) puanını veren eşleşmemiş kullanıcıyı seçer. Eşitlik durumunda önce daha yüksek itibar, ardından sabit kullanıcı kimliği sırası belirleyicidir.
İki üyeli \(\{u_i,u_j\}\) çekirdek grup oluşturulduğunda üçüncü aday \(u_k\) için genişletme skoru
\[ c_{ij,k}^{(t)} = s_{ik}^{(t)}+s_{jk}^{(t)} \]
hesaplanır. Eğer
\[ \max_{u_k} c_{ij,k}^{(t)}\geq\tau_3 \]
olursa en yüksek skorlu aday gruba eklenir ve üç kullanıcılı grup oluşur. Aksi halde grup iki kişi olarak kalır.
Eşleşmeden kalan kullanıcılar nasıl ele alınıyor?
Gönüllü gruplama aşamasından sonra kalan kullanıcı kümesi \(R\) ile gösterilir. En az üç kullanıcı kaldığında itibar sırasındaki ilk üç kullanıcı tekrarlı olarak bir araya getirilir. Tam iki kullanıcı kaldığında doğrudan ikili grup oluşturulur. Tek kullanıcı kaldığında sistem, daha önce atanmış kullanıcılar arasında en düşük itibara sahip kullanıcının grubunu bulur. Bu grup iki kişiyse kalan kullanıcı üçüncü üye olur. Grup zaten üç kişiyse dört kullanıcı geçici olarak bir araya getirilir, itibar sırasına dizilir ve iki ikili gruba yeniden bölünür.
Bu nedenle isteklilik matrisi yalnız gönüllü eşleşmede kullanılır. Artık kullanıcıların sistem düzeyindeki atanmasını ise itibar skorları belirler. Yazarlar iki ve üç kullanıcılı grup sınırlamasının teorik olarak optimum olduğunu iddia etmez; bu tercih uygulama basitliği ve iletişim verimliliği gerekçesiyle yapılmış bir protokol tasarımıdır.
İtibar puanı neyi ölçüyor?
İtibar mekanizması, bir kullanıcının sunduğu güncellemenin ortak sabit doğrulama kümesindeki performansını diğer katılımcılarla karşılaştırarak sonraki gruplama turlarında kullanılacak bir sıralama sinyali üretir. Kaynak, bunu evrensel veya biçimsel olarak optimum bir kullanıcı değeri ölçüsü değil, izinli sistem içinde kullanılan sezgisel bir koordinasyon mekanizması olarak tanımlar.
Bir \(u_i\) istemcisinin tur \(t\)'deki itibarı \(B_i^{(t)}\in(0,1)\) için kaynakta verilen güncelleme yapısı şöyledir:
\[ B_i^{(t+1)} = \frac{1}{ 1+ \exp\left[ -\alpha B_i^{(t)} \left( 1+ \frac{1}{|M^{(t)}|-1} \sum_{n\in M^{(t)}\setminus\{i\}} \left( Acc_i^{(t)}-Acc_n^{(t)} \right) \right) \right] }. \]
Burada \(M^{(t)}\), o tura katılan istemci kümesidir. \(Acc_i^{(t)}\), yetkili altyapının bütün kullanıcılar için ortak tuttuğu sabit \(D_{\mathrm{val}}\) doğrulama kümesindeki doğruluk değeridir. Toplam terimi, \(u_i\)'nin diğer katılımcılara karşı ortalama doğruluk üstünlüğünü temsil eder. Sigmoid yapı çıktıyı \((0,1)\) aralığında tutar.
Notasyon sınırı: Kaynak, burada \(\alpha\)'yı itibar güncellemesinin duyarlılığını kontrol eden parametre olarak tanımlar. Aynı sembol daha önce yerel model güncellemesinde öğrenme oranı için de kullanılmıştır. Kaynak bunların mutlaka aynı hiperparametre olduğunu belirtmediğinden iki rol ayrı bağlamlarda değerlendirilmelidir.
Toplamsal paylaşım ve geçici körleme birlikte nasıl çalışıyor?
Yerel gradyan önce sonlu alan üzerinde birkaç toplamsal paya ayrılır; her grup üyesi yalnız payların birleşiminden oluşan bir pay düzeyi değer taşır ve zincire gönderilecek bu değer ayrıca bağımsız bir rastgele vektör eklenerek körlenir, böylece bireysel gradyanın veya körlenmemiş pay düzeyi toplamın doğrudan deftere yazılması önlenir.
Gerçek sayıdan sonlu alana kodlama
Yerel gradyanlar doğal olarak
\[ g_i^{(t)}\in\mathbb{R}^{p} \]
uzayındadır. Toplamsal paylaşım için kaynak bunları sabit noktalı bir kodlama haritasıyla
\[ Q_q:\mathbb{R}^{p}\rightarrow\mathbb{F}_q^{p} \]
üzerinden
\[ \bar g_i^{(t)}\in\mathbb{F}_q^{p} \]
vektörlerine dönüştürür. Ters yönde
\[ D_q:\mathbb{F}_q^{p}\rightarrow\mathbb{R}^{p} \]
çözümleme haritası kullanılır.
Kaynağın kritik varsayımı, seçilen modül \(q\) ile fixed-point hassasiyetinin bir turdaki gradyanları, payları, körleme vektörlerini ve ara toplamları temsil edecek kadar geniş olmasıdır. Başka bir ifadeyle hesaplama sırasında modüler taşma, yani wrap-around oluşmamalıdır. Bu koşul altında sonlu-alan toplamı tamdır; gerçek sayı alanına geri dönüşte ise sabit noktalı kodlama nedeniyle kuantizasyon hatası bulunabilir.
Bir gradyan nasıl paylara ayrılıyor?
Bir grup
\[ G=\{u_{a_1},u_{a_2},\ldots,u_{a_s}\}, \qquad s\in\{2,3\} \]
olsun. \(u_{a_r}\) istemcisi kodlanmış gradyanını \(s\) adet paya ayırır:
\[ \bar g_{a_r}^{(t)} = \sum_{\ell=1}^{s} [\bar g_{a_r}^{(t)}]_{\ell} \qquad \text{in }\mathbb{F}_q^{p}. \]
İlk \(s-1\) pay, \(\mathbb{F}_q^p\) içinden bağımsız ve düzgün biçimde rastgele seçilir. Son pay ise toplamın özgün gradyanı vermesini sağlayacak biçimde
\[ [\bar g_{a_r}^{(t)}]_s = \bar g_{a_r}^{(t)} - \sum_{\ell=1}^{s-1} [\bar g_{a_r}^{(t)}]_{\ell} \]
olarak belirlenir.
Her grup üyesi her katılımcıdan bir pay aldıktan sonra \(j\)'nci üyenin taşıdığı pay düzeyi değer
\[ s_j^{(t)} = \sum_{r=1}^{s} [\bar g_{a_r}^{(t)}]_j \]
olur. Bu yapı
\[ \sum_{j=1}^{s}s_j^{(t)} = \sum_{r=1}^{s}\bar g_{a_r}^{(t)} \]
eşitliğini korur. Böylece tüm paylar doğru biçimde yeniden toplandığında grup gradyanlarının kodlanmış toplamı elde edilir; ancak bireysel kodlanmış gradyanlar blokzincire plaintext olarak gönderilmez.
Geçici körleme neden ikinci bir katman ekliyor?
Pay düzeyi toplamın bütün yüklemeler tamamlanmadan erken elde edilmesini önlemek için her istemci
\[ r_i^{(t)}\in\mathbb{F}_q^p \]
rastgele vektörünü oluşturur. Önce bu vektör için
\[ C_i^{(t)} = H\left(t\parallel i\parallel r_i^{(t)}\right) \]
hash commitment'ı kaydedilir. Ardından blokzincire giden değer
\[ z_i^{(t)} = s_i^{(t)}+r_i^{(t)} \]
olur.
\(H(\cdot)\) kriptografik hash fonksiyonunu, \(\parallel\) ise birleştirme işlemini ifade eder. Rastgele vektörün kendisi geniş biçimde yayımlanmaz. Gerekli kurtarma bilgisi yalnız güvenilen kurtarma kapsamına gönderilir.
Kullanıcı ayrılırsa körleme nasıl kaldırılıyor?
Her \(r_i^{(t)}\) vektörü eşik paylaşımıyla kurtarma komitesine emanet edilir. Bir kullanıcı gerekli kurtarma bilgisini vermediğinde, en az \(\tau_{\mathrm{rec}}\) geçerli kurtarma payı mevcutsa komite eksik katkıyı yeniden oluşturabilir. Amaç bireysel rastgele vektörleri genel olarak açığa çıkarmak değil, yalnız toplulaştırma için gereken
\[ R^{(t)} = \sum_{i=1}^{m}r_i^{(t)} \]
toplam rastgele vektörünü oluşturmaktır.
Kurtarılan veya kullanıcı tarafından sağlanan her katkı önce önceden kaydedilmiş commitment ile
\[ H\left(t\parallel i\parallel r_i^{(t)}\right) = C_i^{(t)} \]
eşitliği üzerinden doğrulanır. Gerekli bir katkı doğrulamayı geçemezse mevcut iletişim turu iptal edilir; geçersiz katkı çıkarılır ve sonraki yürütme gruplama aşamasından yeniden başlar.
Blockchain katmanı bu protokolde neyi yapıyor, neyi yapmıyor?
Hyperledger Fabric bu sistemde gradyanı kriptografik olarak tek başına gizleyen mekanizma değil; kimliği doğrulanmış işlemleri chaincode üzerinden işlemek, sıralamak, doğrulamak ve denetlenebilir bir deftere kaydetmek için koordinasyon ve bütünlük katmanı sağlıyor, asıl güncelleme gizleme işlemi ise toplamsal paylaşım ve geçici körleme tarafından gerçekleştiriliyor.
İstemciler işlem önerilerini Fabric ağına gönderir. Endorsing peers chaincode'u çalıştırıp endorsement üretir; ordering service onaylı işlemlere toplam sıra verir; committing peers ise işlemleri doğrulayıp deftere ekler. Bu sistemde madencilik veya Proof-of-Work rekabeti bulunmaz.
Tur sonundaki toplulaştırma matematiği
Blokzincir tarafında bütün körlenmiş değerlerin toplamı
\[ Z^{(t)} = \sum_{i=1}^{m}z_i^{(t)} \]
olarak hesaplanır. Doğrulanmış rastgele katkıların toplamı \(R^{(t)}\) çıkarıldığında
\[ S^{(t)} = Z^{(t)}-R^{(t)} = \sum_{i=1}^{m}s_i^{(t)} \]
elde edilir.
Toplamsal paylaşımın yapısı gereği bu değer aynı zamanda kodlanmış yerel gradyanların toplamıdır:
\[ \bar G^{(t)} = S^{(t)} = \sum_{i=1}^{m}\bar g_i^{(t)} \qquad \text{in }\mathbb{F}_q^p . \]
Ardından
\[ G^{(t)} = D_q(\bar G^{(t)}) \in\mathbb{R}^{p} \]
ile gerçek sayı alanına dönülür ve ortalama gradyan
\[ g_{\mathrm{avg}}^{(t)} = \frac{1}{m}G^{(t)} \]
olarak hesaplanır. Global model güncellemesi ise
\[ W^{(t+1)} = W^{(t)}-\alpha g_{\mathrm{avg}}^{(t)} \]
şeklindedir.
Kaynağın doğruluk sonucu iki seviyede yorumlanmalıdır. \(\mathbb{F}_q^p\) kodlanmış alanında toplulaştırma cebirsel olarak tamdır. \(\mathbb{R}^p\)'ye geri dönüldüğünde ise sonuç, fixed-point kodlama/çözme işleminden gelen kuantizasyon hatasına kadar hedeflenen gerçek-alan toplamıyla eşleşir. Bu yorum ayrıca modüler wrap-around oluşmaması varsayımına bağlıdır.
Güvenlik modeli hangi saldırıları kapsamıyor?
Çalışma ham verinin cihazda kalmasını ve defterdeki körlenmiş pay düzeyi yüklemelerin bireysel gradyanı plaintext olarak doğrudan göstermemesini semi-honest ve sınırlı işbirliği varsayımları altında savunuyor; Byzantine model poisoning, eşik ötesi keyfî collusion, side-channel leakage ve gelişmiş adaptive inference saldırılarına karşı tam güvenlik kanıtı sunmuyor.
İstemcilerin protokolü doğru uyguladığı ancak gördükleri paylardan veya defter kayıtlarından ek bilgi çıkarmaya çalışabileceği kabul ediliyor. Fabric peers ise honest-but-curious olarak modelleniyor: Fabric protokolünü doğru yürütüyorlar fakat kendilerine görünür bilgilerden ek bilgi öğrenmeye çalışabilirler.
Kaynak üç temel güvenlik sonucunu tartışıyor. Birincisi, ham veri kümeleri \(D_i\) kullanıcı tarafında kalır ve blokzincire yüklenmez. İkincisi, belirtilen varsayımlar altında zincirdeki körlenmiş pay düzeyi değerler herhangi bir istemcinin ham yerel gradyanıyla doğrudan aynı plaintext değer değildir. Üçüncüsü, Fabric'in endorsement, ordering ve validation süreci kabul edilen işlem kayıtlarının kimliği doğrulanmış, değişiklikleri fark edilebilir ve denetlenebilir bir kayıt olarak tutulmasını sağlar.
Ancak yazarlar bunu simulation-based tam bir kriptografik kanıt olarak sunmuyor. Özellikle kurtarma sürecinin yalnız gerekli toplam rastgele vektörü oluşturduğu ve bireysel körleme vektörlerini güvenilen alan dışına yaymadığı varsayılıyor. Ayrıca son global toplulaştırma değeri, küçük grup veya çok sayıda tekrarlı iletişim turu altında çıkarım saldırıları için bilgi taşımaya devam edebilir.
Çalışmanın Yöntemi ve Bulguları
Deneysel değerlendirme nasıl yapıldı ve ne bulundu?
Prototip Windows 11, Ryzen 7 5800H, RTX 3060 ve 32 GB RAM üzerinde; MNIST'in 60.000 eğitim ve 10.000 test görüntüsü, tam bağlı bir sinir ağı ve Hyperledger Fabric v2.0.0 kullanılarak değerlendirildi; sonuçlar gruplama maliyeti, grup içi toplamsal paylaşım süresi, Fabric işlem maliyeti/throughput ve MNIST sınıflandırma doğruluğu açısından raporlandı.
Deney ortamı ve veri seti
| Öğe | Kaynakta bildirilen koşul |
|---|---|
| İşletim sistemi | 64-bit Windows 11 |
| İşlemci | AMD Ryzen 7 5800H |
| GPU | NVIDIA GeForce RTX 3060 |
| Bellek | 32 GB RAM |
| Veri seti | MNIST |
| Eğitim görüntüsü | 60.000 |
| Test görüntüsü | 10.000 |
| Model | Tam bağlı sinir ağı |
| Blockchain platformu | Hyperledger Fabric v2.0.0 |
| Fabric işlem hacmi | 500 işleme kadar |
Model önce plaintext ortamında 60.000 eğitim görüntüsüyle eğitilmiş ve 10.000 test görüntüsünde değerlendirilmiştir. Kaynak bu ilk plaintext model için yaklaşık %98 doğruluk bildirir. Daha sonra model parametreleri değiştirilerek beş farklı başlangıç doğruluğu oluşturulmuş ve bu başlangıç modelleri üzerinden birkaç toplulaştırma turu çalıştırılmıştır. Amaç, önerilen şemanın MNIST üzerinde toplulaştırma sonrasında doğruluk davranışını gözlemlemektir.
Bu prototipte eğitim ve test için kullanılan veri seti MNIST'tir. Dolayısıyla çalışmanın girişinde sağlık verileri ve tıbbi gizlilik önemli bir uygulama motivasyonu olarak tartışılsa da deneyler hasta verileri, klinik kayıtlar veya gerçek bir sağlık kurumları arası federatif öğrenme ağı üzerinde yapılmamıştır.
Dinamik gruplama maliyeti
Gönüllü gruplama iletişiminin gerçek maliyeti kullanıcılar arasındaki müzakereye bağlı olduğu için kaynak bu kısmın kesin communication overhead değerini vermiyor. Bunun yerine sistem tarafında rastgele iki ve üç kişilik gruplar oluşturmanın ölçülen süreleri Şekil 6'da karşılaştırılıyor.
PDF'nin 19. sayfasındaki Şekil 6, kullanıcı sayısı arttıkça her iki gruplama türünün çalışma süresinin arttığını gösterir. Kaynak metne göre tamamen rastgele iki kişilik gruplama, mevcut uygulamada üç kişilik gruplamadan biraz daha yüksek zaman maliyetine sahiptir. Yazarlar iki kişilik tamamen rastgele gruplamayı, incelenen gruplama durumları arasında bir tür üst-sınır referansı olarak değerlendiriyor.
Toplamsal paylaşım maliyeti
| Grup yapısı | Yaklaşık çalışma süresi | Yorum |
|---|---|---|
| 2 kullanıcılı toplamsal paylaşım | 12,6 ms | Prototip uygulama düzeyindeki ölçüm |
| 3 kullanıcılı toplamsal paylaşım | 16,9 ms | Prototip uygulama düzeyindeki ölçüm |
Üç kişilik paylaşım iki kişilik yapıya göre daha uzun sürmektedir. Kaynak bu değerleri grup tabanlı paylaşım protokolünün hesaplama maliyetine ilişkin uygulama düzeyinde bir gösterge olarak sunar; genel donanım veya ağ koşullarına taşınabilen evrensel latency değerleri olarak sunmaz.
Hyperledger Fabric performansı
Kaynak Fabric v2.0.0 üzerinde 500 işleme kadar yürütme maliyeti ve saniye başına başarılı işlem sayısı olarak throughput'u inceliyor. PDF'nin 20. sayfasındaki Şekil 7'de 100, 200, 300, 400 ve 500 işlem yükleri için invoke ve query işlemlerinin hem yürütme süresi hem throughput eğrileri gösteriliyor.
Kaynak grafiğin ham sayısal noktalarını ayrı bir tabloda vermemektedir. Bu nedenle grafiğin eğrilerinden yeni kesin değerler türetilmemiştir. Şekil 7'nin bilimsel rolü, prototip Fabric katmanının farklı işlem yüklerindeki execution cost ve throughput davranışını uygulama düzeyinde göstermektir.
İşlev kapsamı karşılaştırması
| Yöntem | Gizlilik koruması | Blockchain | Robustness | İtibar/teşvik mekanizması | Dinamik gruplama |
|---|---|---|---|---|---|
| PDLM | Evet | Hayır | Hayır | Hayır | Hayır |
| SPDDL | Evet | Hayır | Evet | Hayır | Hayır |
| SPPFL | Evet | Hayır | Evet | Evet | Hayır |
| chain-PPFL | Evet | Evet | Hayır | Hayır | Hayır |
| FL-CGAN-LSTM | Evet | Evet | Hayır | Hayır | Hayır |
| DPPFL | Evet | Evet | Evet | Evet | Evet |
Bu tablo doğrudan model accuracy üstünlüğü kanıtlayan bir performans karşılaştırması değildir. Yazarlar tabloyu yöntemlerin hangi fonksiyonel bileşenleri kapsadığını göstermek için kullanmaktadır. DPPFL'nin bütün kutuları karşılaması, her güvenlik özelliğinin diğer yöntemlerden matematiksel olarak daha güçlü olduğunu tek başına göstermez.
MNIST doğruluk karşılaştırması
PDF'nin 21. sayfasındaki Şekil 8'de grafik üzerine yazılmış değerler şöyledir:
| Yöntem | Doğruluk |
|---|---|
| FL-Blockchain Dynamic Grouping | %99,56 |
| SVM | %95,60 |
| CNN | %98,50 |
| RNN | %98,25 |
Makale metni önerilen yöntemin sonucunu yuvarlayarak %99,6 olarak verir. Bu ayarda bildirilen fark, karşılaştırılan yöntemlere göre 1,06 ile 3,96 yüzde puanı arasındadır. Bu karşılaştırma yalnız mevcut MNIST tabanlı proof-of-concept koşulları için yorumlanmalıdır.
Yirmi düğümlü robustness gösterimi
Şekil 9, toplam 20 düğüm kullanılan simülasyon ortamında dinamik gruplamalı FL'nin blockchain kullanılan ve kullanılmayan sürümlerini karşılaştırıyor. Simülasyonda “malicious” olarak işaretlenen düğüm sayısı arttıkça blockchain bulunmayan sürümün doğruluğu belirgin biçimde düşerken blockchain destekli seri daha kararlı görünüyor.
Yazarların kendi yorum sınırı burada kritiktir: Şekil 9 bir ampirik prototip robustness gösterimidir; Byzantine saldırılara veya malicious katılımcılara karşı biçimsel kriptografik güvenlik garantisi değildir. Bu grafik, kaynakta tanımlanan semi-honest tehdit modelini malicious-security modeline dönüştürmez.
Blockchain, dinamik gruplama ve merkezi yaklaşım karşılaştırması
PDF'nin 21. sayfasındaki Şekil 10 üzerinde gösterilen değerler:
| Yaklaşım | Doğruluk |
|---|---|
| FL Blockchain Dynamic Grouping | %99,56 |
| Blockchain Algorithms | %98,60 |
| Centralized Algorithms | %97,62 |
Bu özel deneyde dinamik gruplama ve blockchain koordinasyonunu birlikte kullanan sürüm üç yaklaşım arasında en yüksek doğruluk etiketine sahiptir. Ancak bu, bütün veri setlerinde, bütün modellerde veya gerçek dağıtık ağlarda merkezi öğrenmenin üzerinde genel bir performans garantisi anlamına gelmez.
Kaynak mimarisinin uçtan uca işlem akışı
- Her istemci kendi \(D_i\) veri kümesinde yerel eğitim yapar ve \(g_i^{(t)}\) gradyanını hesaplar.
- İstemciler itibar ve isteklilik bilgileri kullanılarak iki veya üç üyeli gruplara ayrılır.
- Gerçek-alan gradyanı \(\mathbb{F}_q^p\)'ye kodlanır ve grup içinde toplamsal paylara ayrılır.
- Her istemci elindeki pay düzeyi değere \(r_i^{(t)}\) rastgele vektörünü ekler ve körlenmiş \(z_i^{(t)}\) değerini oluşturur.
- Körleme vektörü için hash commitment zincire kaydedilir ve eşik tabanlı kurtarma bilgisi güvenilen kurtarma kapsamına emanet edilir.
- Gerekli rastgele katkılar commitment değerleriyle doğrulanır.
- Fabric chaincode ve ledger işlemleri körlenmiş pay düzeyi yüklemelerini işler ve toplar.
- \(R^{(t)}\) toplam rastgele vektörü çıkarılarak kodlanmış global gradyan toplamı geri kazanılır.
- Sonlu-alan toplamı gerçek sayı alanına çözülür, ortalama gradyan hesaplanır ve global model senkronize edilir.
- İtibar değerleri güncellenir ve sonraki iletişim turuna geçilir.
PDF'nin 10. sayfasındaki Şekil 4 tam olarak bu yapının mimari görünümünü verir: istemcilerden dinamik gruplamaya, toplamsal paylaşım ve geçici körlemeye; oradan Hyperledger Fabric endorsement/ordering/commitment akışına, ledger kayıtlarına, aggregate recovery sürecine ve tekrar model senkronizasyonuna dönen kapalı bir işlem zinciri gösterilir.
Çalışmanın desteklediği sonuçlar
Kaynak, önerilen protokolün belirtilen semi-honest ve bounded-collusion varsayımları altında ham veri kümelerini istemci tarafında tuttuğunu; zincirde doğrudan plaintext bireysel gradyan yerine körlenmiş pay düzeyi değerler kullandığını; kodlanmış sonlu-alan toplulaştırmasının doğru olduğunu; gerçek alana dönüşte yalnız encoding–decoding kuantizasyon hatasının kaldığını ve Hyperledger Fabric'in accepted transaction kayıtlarına integrity/auditability katmanı sağladığını ortaya koymaktadır.
MNIST proof-of-concept deneyleri ise sistemin değerlendirilen prototip ortamında çalıştırılabilir olduğunu, grup tabanlı toplamsal paylaşımın milisaniye düzeyinde uygulanabildiğini, Fabric tarafında 500 işleme kadar yürütme/throughput davranışının ölçülebildiğini ve mevcut karşılaştırmada model doğruluğunun korunabildiğini göstermektedir.
Çalışmanın desteklemediği sonuçlar
Çalışma, bütün federatif öğrenme saldırılarını çözen genel bir güvenlik protokolü ortaya koymaz. Tam malicious-security veya simulation-based privacy kanıtı yoktur. Byzantine model poisoning, sınırlandırılmamış collusion, side-channel saldırıları ve gelişmiş adaptive inference saldırıları kapsam dışındadır. Final aggregate'in kendisi belirli koşullarda bilgi sızıntısı için kullanılabilir. İki ve üç kişilik grupların optimum olduğu kanıtlanmamıştır. İtibar mekanizması trust-free veya optimal contribution oracle değildir. MNIST deneyleri gerçek sağlık verisi üzerinde yapılmamıştır ve çalışma klinik veya büyük ölçekli gerçek dünya deployment kanıtı sunmaz.
Kaynak ve Yöntem Notu
Özgün çalışma: Blockchain-Enabled Federated Learning: A Dynamic-Grouping Privacy-Preserving Framework
Yazarlar: Senmao Wei; Xiaochao Wei; Tingting Pang; Dian Li.
Corresponding authors: Xiaochao Wei ve Tingting Pang.
Kurumlar: School of Computer Science and Artificial Intelligence, Shandong Normal University, Jinan, China; Department of Informatics, University of Bergen, Bergen, Norway.
Dergi: Mathematics.
Yayınevi: MDPI.
Bibliyografik kayıt: Mathematics 2026, 14(9), 1534.
DOI: 10.3390/math14091534.
Makale süreci: Alınış 31 Mart 2026; revizyon 24 Nisan 2026; kabul 25 Nisan 2026; yayın 1 Mayıs 2026.
Kaynak türü: Hakemli akademik araştırma makalesi; protokol tasarımı, matematiksel doğruluk tartışması, sınırlı güvenlik analizi ve MNIST tabanlı proof-of-concept deneysel değerlendirme içerir.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Çalışma National Natural Science Foundation of China 12201356 numaralı hibe ile ve Shandong Provincial Key Research and Development Program 2025TSGCCZZB0016 numaralı program tarafından kısmen desteklenmiştir.
Veri erişilebilirliği: Yazarlar özgün katkıların makale içinde yer aldığını ve ek soruların corresponding author'lara yöneltilebileceğini belirtmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma Xiaochao Wei ve Tingting Pang; metodoloji Senmao Wei ve Xiaochao Wei; yazılım ve doğrulama Senmao Wei ve Dian Li; ilk taslak Senmao Wei; inceleme ve düzenleme Xiaochao Wei ve Tingting Pang; finansman temini Tingting Pang ve Xiaochao Wei tarafından yürütülmüştür.
Temel yöntemsel sınırlılık: Güvenlik analizi semi-honest ve bounded-collusion varsayımlarıyla sınırlıdır; tam simulation-based kriptografik proof değildir. Deney MNIST üzerinde yapılmış kavram kanıtlama değerlendirmesidir. Tıbbi veri ve klinik deployment doğrulaması yoktur. Sonlu-alan kodlamasından gerçek alana dönüş quantization error içerir. Modül ve fixed-point hassasiyeti wrap-around oluşmayacak şekilde seçilmelidir.
Görsel yeniden çizim: Kaynak Şekil 4'teki mimari, Şekil 6'daki gruplama overhead'i, Şekil 7'deki Fabric execution/throughput davranışı ve Şekil 8–10'daki karşılaştırmalar Verianla için özgün grafik ve şemalar halinde yeniden çizilebilir. Şekil 7'nin ham noktaları tablolaştırılmadığı için grafikten hassas yeni sayılar türetilmemelidir.
Verianla Live / Live Figure: Uygun. En güvenli kullanım; istemci eğitimi → gruplama → toplamsal paylaşım → körleme → Fabric doğrulama → aggregate recovery → model senkronizasyonu işlem akışının sabit-parametreli source-derived animasyonudur. Kullanıcının grup eşiğini, saldırgan sayısını, öğrenme oranını veya başka bilimsel parametreyi değiştirerek yeni sonuç üretmesine izin verilmemelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir