

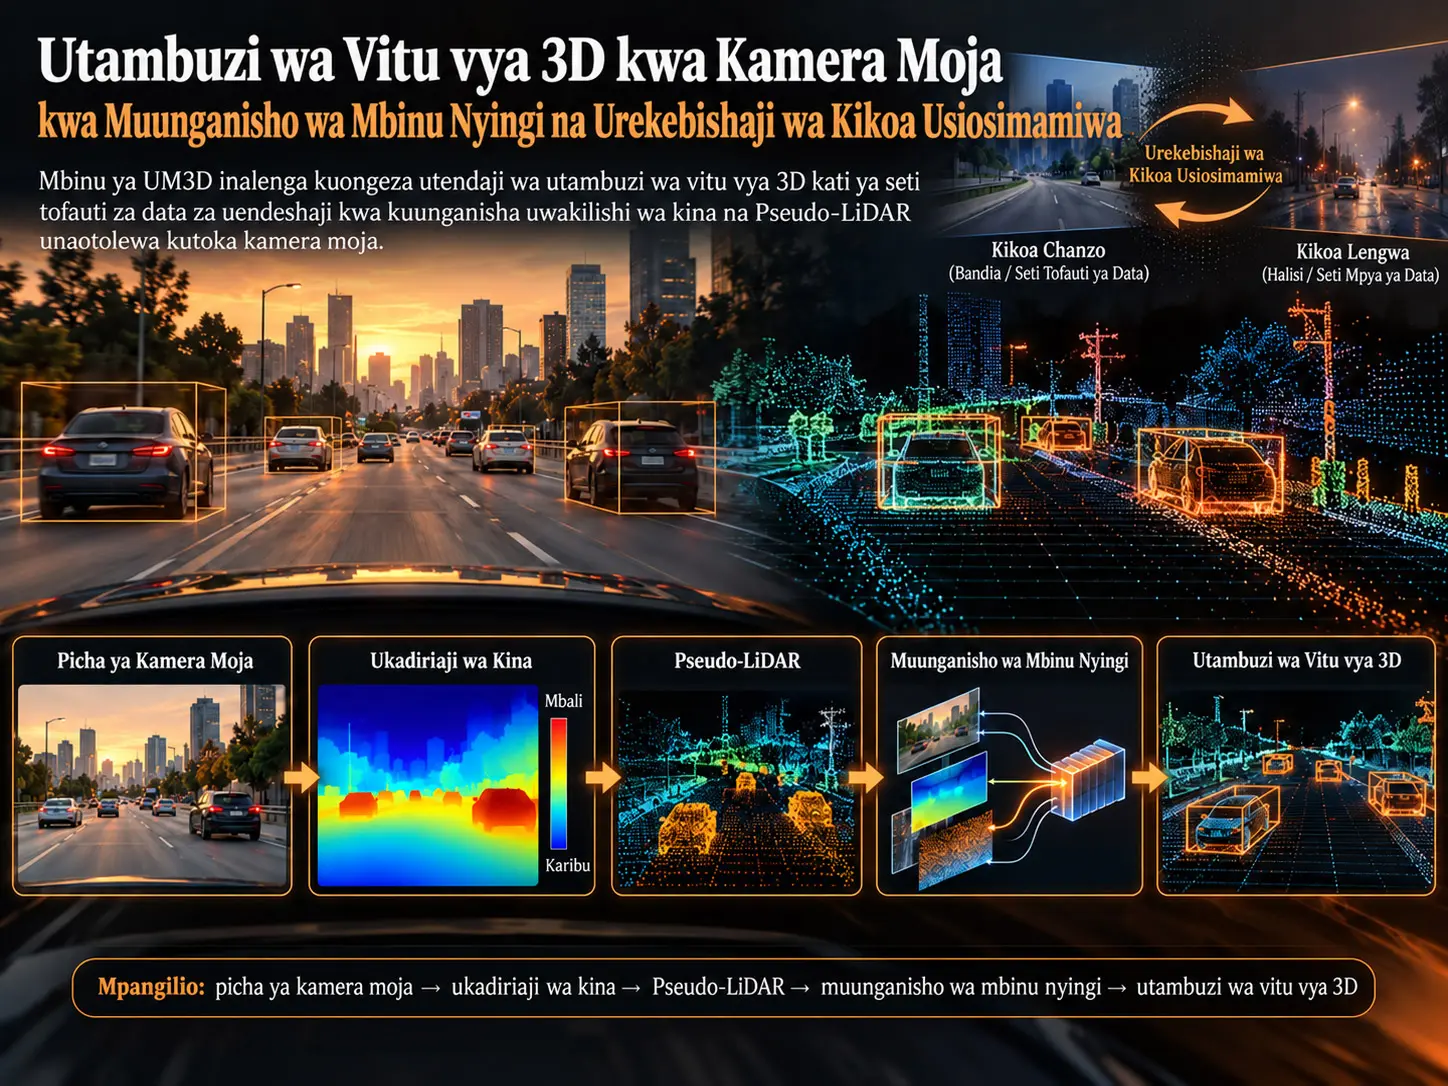
Mfumo wa Utambuzi wa 3D kwa Kamera Moja UM3D (Unsupervised Monocular 3D Detection) ni mfumo wa urekebishaji wa kikoa usiosimamiwa unaounganisha ukadiriaji wa kina unaojisimamia, uundaji wa Pseudo-LiDAR, uwekaji wa lebo bandia unaozingatia ubora na muunganisho wa picha–wingu la nukta katika mkondo mmoja wa ujifunzaji wa mwanzo hadi mwisho ili kuhamisha maarifa ya utambuzi wa pande tatu yaliyojifunzwa katika kikoa chanzo chenye lebo kwenda kikoa lengwa bila kuhitaji lebo za visanduku vya 3D. Utafiti ulitathminiwa kwenye seti za data za KITTI, Waymo Open Dataset (WOD), nuScenes na Lyft. UM3D inalenga hasa kuboresha utendaji wa utambuzi wa 3D kwa kamera moja unaoharibika kati ya mazingira tofauti kutokana na mabadiliko ya kikoa. Katika hatua ya inferensi haihitaji LiDAR halisi; uwakilishi wa Pseudo-LiDAR huundwa ndani ya mfumo kutokana na kina kinachokadiriwa kutoka picha hiyo hiyo ya kamera moja. Hata hivyo, utendaji wake, hasa kwa vitu vya mbali, unazuiliwa na usahihi wa ukadiriaji wa kina, na lengo kuu la majaribio ni darasa la magari.
Mbinu ina hatua mbili kuu za kuingilia. Kwanza, upanuzi wa nasibu katika kiwango cha kitu unajaribu kupunguza athari ya tofauti za ukubwa wa magari kati ya kikoa chanzo na kikoa lengwa katika kuharibu lebo bandia za awali. Pili, benki ya kumbukumbu yenye vipindi vitatu inayotumia upangaji wa ubora unaotegemea IoU hailinganishi lebo bandia kwa alama moja tu ya kujiamini, bali huzioanisha na utabiri wa kihistoria na kuzisasisha. Muundo huu unaunganishwa na muunganisho wa picha–wingu la nukta unaotegemea LoGoNet na tabaka linaloweza kutofautishwa la Change of Representation (CoR), hivyo kuruhusu hitilafu ya utambuzi kusambazwa nyuma hadi kwenye mtandao wa kina.
Katika urekebishaji wa kikoa wa wingu la nukta wa WOD → KITTI, UM3D inayotegemea LoGoNet ilifikia 85,71/67,44 katika thamani za APBEV/AP3D. Sehemu za muhtasari na hitimisho za makala chanzo zinasisitiza kuwa %76,81 ya pengo la kikoa la APBEV lilifungwa kwa WOD → KITTI; hata hivyo, Jedwali 2 la utafiti huohuo linaripoti %97,89 APBEV Closed Gap kwa UM3D inayotegemea SECOND. Kwa hiyo, thamani ya %76,81 haipaswi kutafsiriwa kama kiwango cha juu kabisa kati ya usanidi wote wa makala, bali kama matokeo yaliyoripotiwa katika usanidi wa LoGoNet.
UM3D ni nini na inatatua tatizo gani?
UM3D ni mfumo wa urekebishaji wa kikoa usiosimamiwa wa mwanzo hadi mwisho unaolenga kupunguza upotevu wa utendaji katika utambuzi wa vitu vya 3D kwa kamera moja unaosababishwa na mabadiliko ya mgawanyo kati ya seti tofauti za data na mazingira ya uendeshaji, bila kutegemea lebo halisi za visanduku vya 3D katika kikoa lengwa. Mfumo hutoa kina kutoka picha moja, hubadilisha kina hicho kuwa wingu la nukta la Pseudo-LiDAR, hujirekebisha kwa kikoa lengwa kwa kutumia lebo bandia zilizodhibitiwa ubora, na huchakata kwa pamoja vipengele vya picha na vipengele vya kijiometri vya pande tatu.
Tatizo la msingi: kwa nini kutoa kina kutoka kamera moja ni vigumu?
Katika kamera moja, makadirio yale yale ya picha ya pande mbili yanaweza kuendana na jiometri tofauti za mandhari ya pande tatu. Kwa maneno mengine, picha haipimi kina moja kwa moja. LiDAR hutoa kipimo halisi cha umbali, ilhali mfumo wa kamera moja lazima ukadirie kina kutokana na viashiria vya picha. Kwa hiyo, hitilafu katika kina inaweza kuathiri nafasi ya nukta ya Pseudo-LiDAR angani na baadaye kuvuruga eneo, ukubwa au mwelekeo wa kisanduku cha 3D.
Ugumu wa pili ni mabadiliko ya kikoa. Detekta inapofunzwa kwenye seti moja ya data, jiometri ya kamera, mazingira ya kijiografia, msongamano wa sensa, mgawanyo wa ukubwa wa magari na itifaki za anoteshini katika seti nyingine ya data zinaweza kuwa tofauti. Kwa sababu hiyo, modeli iliyo imara katika kikoa chanzo huenda isionyeshe utendaji uleule katika kikoa lengwa.
Muundo wa kisayansi wa UM3D
- Ukadiriaji wa kina kamili unaojisimamia: RSANet hutumiwa kuzalisha ramani ya kina katika kipimo kamili kutoka picha ya kamera moja.
- Ubadilishaji wa Pseudo-LiDAR: Viwianishi vya pikseli na kina hubadilishwa kuwa nukta za pande tatu kwa jiometri ya kamera ya pinhole.
- Usampulishaji wa masafa unaotegemea msongamano: Mfumo hujaribu kusawazisha maeneo yenye msongamano mdogo na mkubwa katika wingu zito la Pseudo-LiDAR.
- Uwekaji wa lebo bandia unaozingatia ubora: Hutumia upanuzi wa nasibu katika kiwango cha kitu na benki ya kumbukumbu yenye vipindi vitatu inayotegemea IoU.
- Muunganisho wa mbinu nyingi: Vipengele vya picha na jiometri ya Pseudo-LiDAR huunganishwa kwa muunganisho wa hatua mbili unaotegemea LoGoNet na uzani wa self-attention.
- Uboreshaji wa pamoja wa mwanzo hadi mwisho: Kwa tabaka la CoR linaloweza kutofautishwa, gradient ya hasara ya utambuzi wa 3D inaweza kurudi hadi mtandao wa ukadiriaji wa kina.
Pseudo-LiDAR inazalishwaje katika utafiti huu?
Pseudo-LiDAR huundwa kwa kurudisha kila pikseli katika ramani ya kina kamili iliyokadiriwa kwa picha ya kamera moja kwenda kwenye kiwianishi cha pande tatu kwa kutumia vigezo vya ndani vya kamera; baadaye UM3D hubadilisha mfumo wa viwianishi kwenda kwenye mihimili ya gari–LiDAR, hutumia usampulishaji wa pembe unaoiga upataji wa LiDAR yenye mistari 64, na hupunguza msongamano wa wingu lenye nukta nyingi kwa usampulishaji wa masafa unaotegemea msongamano.
Ubadilishaji kutoka tambarare ya picha kwenda nukta ya pande tatu
Katika Mlinganyo (1) wa utafiti chanzo, nafasi ya (i, j) kwenye picha, thamani ya kina kamili D(i,j) na vigezo vya ndani vya kamera hutumiwa:
\[ x=\frac{(i-c_i)D(i,j)}{f_x},\qquad y=\frac{(j-c_j)D(i,j)}{f_y},\qquad z=D(i,j) \tag{1} \]
Hapa \(f_x\) na \(f_y\) zinaonyesha urefu wa fokasi wa mlalo na wima; \(c_i\) na \(c_j\) zinaonyesha viwianishi vya nukta kuu. \(i\), \(j\), \(f_x\), \(f_y\), \(c_i\) na \(c_j\) ziko katika mfumo wa viwianishi vya picha/pikseli. Ikiwa \(D\) imeelezwa katika kipimo fulani cha urefu, viwianishi vinavyotokana vya \(x\), \(y\) na \(z\) hubeba kipimo kilekile cha kimwili.
Ubadilishaji wa viwianishi vya kamera kwenda katika mfumo wa viwianishi vya LiDAR kwenye gari umetolewa katika chanzo kwa ulinganisho huu wa mihimili:
\[ x=-z,\qquad y=-x,\qquad z=y \tag{2} \]
Ili kuiga upataji wa LiDAR yenye mistari 64, pembe ya wima ya kila nukta na umbali wake kutoka kwa sensa huhesabiwa:
\[ \vartheta(n)= \arctan\left( \frac{z(n)} {\sqrt{x^2(n)+y^2(n)}} \right), \qquad l(n)=\sqrt{x^2(n)+y^2(n)+z^2(n)} \tag{3} \]
Nukta hupangiwa mistari ya skani kulingana na pembe ya wima, hupangwa kwa umbali ndani ya kila mstari na kugawanywa katika seli za azimuth. Kuhifadhi nukta iliyo karibu zaidi na sensa katika kila seli ya mstari–azimuth huiga kwa muhtasari kipimo cha LiDAR cha mrejesho mmoja. Utafiti unaeleza kuwa nukta zilizokuwa 1 m juu ya sehemu ya kuanzia ya sensa ziliondolewa na kiwango cha nguvu ya mng’ao uliorejea kiliwekwa kuwa 1.
Usampulishaji wa masafa unaotegemea msongamano
Pseudo-LiDAR inayozalishwa kutoka ramani ya kina yenye azimio la juu inaweza kuwa na msongamano mkubwa sana. UM3D hugawanya nafasi katika maeneo \(n\) ya umbo la mchemraba:
\[ \Omega=\{\omega_1,\omega_2,\ldots,\omega_n\} \tag{4} \]
Kwa idadi ya nukta \(\omega_i\) katika kila eneo \(m_i\), uzani wa kinyume cha msongamano hufafanuliwa kama:
\[ k_i=\frac{1}{m_i+\sigma} \tag{5} \]
\(\sigma\) ni thamani ndogo chanya inayozuia kugawanya kwa sifuri. Kwa kuwa maeneo yenye msongamano mdogo yana thamani kubwa zaidi ya \(k_i\), mchango wao wa jamaa katika usampulishaji huongezeka. Seti ya sampuli kutoka kila eneo ni:
\[ P_i=\{p_{i1},p_{i2},\ldots,p_{ij}\} \tag{6} \]
na wingu la mwisho lililosampuliwa ni:
\[ \Gamma=\bigcup_{i=1}^{n}P_i \tag{7} \]
Chanzo hakiripoti kwa undani thamani ya nambari ya \(\sigma\), vipimo kamili vya kijiometri vya masafa ya mchemraba, wala kanuni mahsusi ya idadi ya sampuli inayotumia \(j\) kupata \(k_i\); thamani hizi hazijakamilishwa na Verianla.
Kwa nini upanuzi wa nasibu katika kiwango cha kitu hutumiwa?
Ikiwa mgawanyo wa ukubwa wa kimwili wa magari katika kikoa chanzo unatofautiana na ule wa kikoa lengwa, detekta ya 3D iliyofunzwa katika chanzo inaweza kukadiria vibaya ukubwa wa visanduku katika kikoa lengwa kwa njia ya kimfumo. Kipengele cha Object-Level Random Scaling Strategy (ORSS) cha UM3D hupunguza upendeleo huu kwa kubadilisha ukubwa wa vitu vya kikoa chanzo vilivyo na lebo ndani ya mfumo wa viwianishi wa kisanduku husika.
Nukta katika kisanduku chenye ukubwa \((l,w,h)\), kituo \((u,v,d)\) na mwelekeo \(\omega\) hubadilishwa kwanza kwenda kwenye viwianishi vya ndani:
\[ (p_{il},p_{iw},p_{ih})= (p_{ix}-u,p_{iy}-v,p_{iz}-d) \begin{bmatrix} \cos\omega & -\sin\omega & 0\\ \sin\omega & \cos\omega & 0\\ 0 & 0 & 1 \end{bmatrix} \tag{8} \]
Kisha vigawo visivyo na kipimo \(f_l\), \(f_w\), \(f_h\) hutumika na nukta hurudishwa kwenye viwianishi vya jumla:
\[ (p_{ix},p_{iy},p_{iz})= (p_{il}f_l,p_{iw}f_w,p_{ih}f_h) \begin{bmatrix} \cos\omega & \sin\omega & 0\\ -\sin\omega & \cos\omega & 0\\ 0 & 0 & 1 \end{bmatrix} +(u,v,d) \tag{9} \]
Makala chanzo haitoi kwa nambari masafa ya usampulishaji wa nasibu yaliyotumiwa kwa \(f_l\), \(f_w\) na \(f_h\). Kwa hiyo, mgawanyo au mipaka ya vigezo hivi haijadhaniwa hapa.
Ubora wa lebo bandia unadhibitiwaje?
UM3D hujifunza alama ya ubora ya kisanduku cha 3D kilichotabiriwa kwa kichwa cha regresha ya IoU kinachoongezwa kwenye detekta. Katika chanzo, hasara ya ubora imetolewa katika mfumo wa binary cross-entropy:
\[ L_{\mathrm{quality}} =-(1-\hat{s})\log(1-s)-\hat{s}\log(s) \tag{10} \]
\(s\) inawakilisha thamani ya ubora ya IoU inayotabiriwa na modeli kwa kisanduku; \(\hat{s}\) ni thamani ya IoU ya kisanduku kilichotabiriwa iliyohesabiwa dhidi ya kisanduku halisi au lebo bandia.
Katika utekelezaji, kizingiti chanya kimetolewa kama \(Thr_p=0.5\), na kizingiti hasi kama \(Thr_n=0.2\). Visanduku vyenye \(s_i>Thr_p\) huingizwa kwenye kumbukumbu kama sampuli chanya; visanduku katika masafa \(Thr_n<s_i<Thr_p\) huhifadhiwa ili kuonyesha maeneo yatakayopuuzwa wakati wa mafunzo; vile vyenye \(s_i<Thr_n\) hutupwa.
Kwa seti ya kihistoria ya lebo bandia \(H\) na seti ya sasa \(C\), 3D IoU huhesabiwa kama:
\[ \mathrm{IoU}(H,C)= \frac{\cap_{H,C}}{\cup_{H,C}} \tag{11} \]
na ulinganisho wa sasa wenye nguvu zaidi huchaguliwa kwa kila kisanduku cha kihistoria:
\[ \mathrm{optimum}(H,C) = \underset{C}{\arg\max}\, |\mathrm{IoU}(H,C)| \tag{12} \]
Kwa visanduku vya kihistoria visivyolingana, utaratibu wa kihesabu hutumiwa:
\[ \mathrm{state}= \begin{cases} 1, & \mathrm{counter}(H)\lt Thr_i\\ 0, & Thr_i\leq \mathrm{counter}(H)\lt Thr_r\\ -1, & \mathrm{counter}(H)\geq Thr_r \end{cases} \tag{13} \]
\(\mathrm{state}=1\) humaanisha kuhifadhi kwenye kumbukumbu, \(\mathrm{state}=0\) kupuuza, na \(\mathrm{state}=-1\) kufuta. Chanzo hufafanua vizingiti \(Thr_i\) na \(Thr_r\) kimawazo lakini hakiripoti thamani zake za nambari katika maelezo ya utekelezaji. Kwa upande mwingine, kizingiti cha IoU kinachotumiwa katika ulinganisho wa lebo bandia za sasa–kihistoria kimetajwa kuwa 0,1.
Vipengele vya picha na Pseudo-LiDAR vinaunganishwaje?
Detekta ya mbinu nyingi ya UM3D inategemea usanifu wa LoGoNet. Wingu la nukta hubadilishwa kuwa muundo wa voxel na kuchakatwa na 3D backbone pamoja na Region Proposal Network (RPN). Wakati huo huo, detekta ya 2D iliyofunzwa awali hutoa vipengele vya picha kutoka picha ya kamera moja.
Hatua mbili za muunganisho za LoGoNet huhifadhiwa. Muunganisho wa nje ya eneo pendekezo huprojekti vituo vya voxel kwenye tambarare ya picha ili kuhusianisha mpangilio wa kijiometri wa jumla. Muunganisho wa ndani ya eneo pendekezo huchakata maelezo ya ndani katika kila pendekezo kwa cross-attention. Sehemu iliyobadilishwa na utafiti ni kutumia mkusanyo wa vipengele wenye uzani unaotegemea self-attention badala ya kuunganisha tu matokeo haya mawili.
\[ F=[F_{\mathrm{out}};F_{\mathrm{in}}], \qquad Q=W_QF,\quad K=W_KF,\quad V=W_VF \tag{14} \]
Hapa \(F_{\mathrm{out}}\) ni kipengele cha muunganisho wa nje ya eneo na \(F_{\mathrm{in}}\) ni kipengele cha muunganisho wa ndani ya eneo. \(W_Q\), \(W_K\) na \(W_V\) ni matriki za projeksheni zinazoweza kujifunzwa. Scaled dot-product attention ni:
\[ \mathrm{Attention}(Q,K,V) = \mathrm{softmax} \left( \frac{QK^\top}{\sqrt{d_k}} \right)V \tag{15} \]
\(d_k\) ni ukubwa wa vekta za ufunguo. Kihisabati, utaratibu huu huweka uzani kwenye uhusiano wa kila nafasi ya kipengele na nafasi nyingine za vipengele, na hivyo kuunda uwakilishi uliojumuishwa wenye uchaguzi zaidi kwa uainishaji na regresha ya kisanduku.
Kwa nini CoR inayoweza kutofautishwa ni muhimu?
Voxelizering ya kawaida huonyesha kwa 0 au 1 kama nukta iko ndani ya seli. Kwa sababu uamuzi huu mkali hauendelei vizuri kwa mabadiliko madogo ya viwianishi, unaweza kukata gradient inayopaswa kusambazwa nyuma hadi mtandao wa kina. UM3D hutumia mbinu ya Change of Representation (CoR) kutoka E2E-PL pamoja na usampulishaji unaotegemea msongamano na kueleza ujazo wa voxel kwa uzani laini wa RBF.
Kwa nukta \(u\) ndani ya seli \(P_u\):
\[ W(u) = \frac{1}{|P_u|} \sum_{p\in P_u} e^{-\|p-p_c\|_2^2/\delta^2} \tag{16} \]
na seli jirani \(\Upsilon_u\) zinapozingatiwa:
\[ T_{\mathrm{softquantization}}(u) = W(u)+ \frac{1}{|\Upsilon_u|} \sum_{\bar{u}\in\Upsilon_u} W(\bar{u}) \tag{17} \]
hupatikana. \(p_c\) ni kituo cha voxel; \(\delta\) inahusiana na upana wa bendi wa RBF. Katika mipangilio ya majaribio, \(\delta^2=0.01\) na kernel ya kulainisha ya 3×3×3 yenye majirani 26 zilitumiwa. Kazi kuu ya kialgorithimu ya uwakilishi huu laini ni kuruhusu hitilafu ya utambuzi kusambazwa nyuma kupitia uwakilishi wa nukta hadi mtandao wa kina.
Lengo la jumla la ujifunzaji
Hasara ya jumla ya mwanzo hadi mwisho ni:
\[ L=\alpha L_{\mathrm{depth}}+\beta L_{\mathrm{detection}} \tag{18} \]
Katika majaribio, \(\alpha=1\) na \(\beta=0.01\) zilitumiwa.
Katika chanzo, hasara ya kina imeripotiwa kwa Mlinganyo (19) katika umbo lifuatalo:
\[ L_{\mathrm{depth}} = \min_{t'} p_e(I_t,I_{t'\rightarrow t})L_p +\mu L_{\mathrm{smooth}} \tag{19} \]
Kipengele cha fotometriki na kipengele cha ulaini ni:
\[ L_p=\sum_{t'}\ell(I_t,I_{t'\rightarrow t}) \tag{20} \]
\[ L_{\mathrm{smooth}} = |\nabla_x d_t^*|e^{-|\nabla_x I_t|} + |\nabla_y d_t^*|e^{-|\nabla_y I_t|} \tag{21} \]
\(d_t^*\) ni kina kinyume kilichonormalishwa, huku \(\nabla_x\) na \(\nabla_y\) zikionyesha gradient za mlalo na wima. Uzani wa ulaini katika majaribio ni \(\mu=0.001\).
Hasara ya utambuzi ni:
\[ L_{\mathrm{detection}} = L_{\mathrm{RPN}} + L_{\mathrm{conf}} + \lambda L_{\mathrm{reg}} \tag{22} \]
\(L_{\mathrm{RPN}}\) ni hasara ya mtandao wa mapendekezo ya eneo, \(L_{\mathrm{conf}}\) ni hasara ya kujiamini/utabiri, na \(L_{\mathrm{reg}}\) ni hasara ya regresha ya kisanduku. Katika majaribio, \(\lambda=2.0\) ilitumika.
Mantiki ya mafunzo ya hatua tatu
- Mafunzo ya awali ya kikoa chanzo: Detekta yenye kichwa cha IoU hufunzwa awali kwa kutumia ORSS na data halisi yenye lebo ya wingu la nukta kutoka kikoa chanzo.
- Self-training katika kikoa lengwa: Visanduku vya utabiri na alama za ubora wa IoU huundwa katika kikoa lengwa; benki ya kumbukumbu yenye vipindi vitatu husasishwa na mafunzo huendelea kwa lebo bandia.
- Uboreshaji wa pamoja wa monokula wa mwanzo hadi mwisho: Kina huundwa kutoka picha, Pseudo-LiDAR huzalishwa kwa CoR inayoweza kutofautishwa, lebo bandia husasishwa, na mnyororo kina → CoR → utambuzi wa mbinu nyingi huboreshwa kwa pamoja chini ya hasara moja ya jumla.
Mbinu na Matokeo ya Utafiti
Maelezo ya utekelezaji
| Kipengele | Thamani iliyoripotiwa katika chanzo |
|---|---|
| Optimizer ya self-training ya kikoa lengwa | Adam |
| Kiwango cha ujifunzaji cha self-training | 0.0015 |
| Muda wa self-training | 40 epoch |
| Usasishaji wa lebo bandia | Kila epoch |
| Azimio la ingizo/tokeo la mwanzo hadi mwisho | 1024 × 320 |
| Framework | PyTorch 1.10.0 |
| Optimizer ya mwanzo hadi mwisho | Adam |
| Kiwango cha awali cha ujifunzaji | 0.001 |
| Upunguzaji wa kiwango cha ujifunzaji | Kila 10 epoch ×0.1 |
| Mafunzo ya mwanzo hadi mwisho | 30 epoch |
| \(\alpha\) | 1 |
| \(\beta\) | 0.01 |
| \(\mu\) | 0.001 |
| \(\lambda\) | 2.0 |
| RBF | \(\delta^2=0.01\) |
| Ujirani wa kulainisha | Majirani 26, 3×3×3 |
| \(Thr_p\) | 0.5 |
| \(Thr_n\) | 0.2 |
| Kizingiti cha ulinganisho wa IoU katika benki ya kumbukumbu | 0.1 |
Seti za data na eneo la tathmini
| Seti ya data | Wigo uliotolewa katika chanzo | Jukumu katika utafiti |
|---|---|---|
| KITTI | Sampuli 7481 za mafunzo, 7518 za majaribio; tathmini Easy/Moderate/Hard | Moja ya vikoa lengwa muhimu |
| Waymo Open Dataset (WOD) | Mifuatano 798 ya mafunzo, 202 ya uthibitishaji, 150 ya majaribio | Kikoa chanzo / uhamishaji kati ya seti za data |
| nuScenes | Matukio 1000; Boston na Singapore | Kikoa chanzo au lengwa |
| Lyft | Zaidi ya fremu 55.000 zilizoannotetiwa | Kikoa chanzo au lengwa |
Kwa seti zote za data, eneo la utambuzi liliwekwa kuwa \(X/Y\in[-75.2,75.2]\) m na \(Z\in[-2,4]\) m. Ukubwa wa voxel kwa SECOND na LoGoNet ni \((0.1,0.1,0.15)\) m. Uongezaji wa data unajumuisha upanuzi wa nasibu wa jumla, mzunguko, uhamishaji, na upanuzi/mzunguko kwa kila kitu.
Kipimo cha Closed Gap kinamaanisha nini?
Closed Gap huonyesha kwa asilimia ni kiasi gani cha pengo la utendaji kati ya modeli iliyofunzwa katika kikoa chanzo na kutumika moja kwa moja katika kikoa lengwa na Oracle iliyofunzwa kwa usimamizi kamili katika kikoa lengwa kimefungwa na mbinu ya urekebishaji wa kikoa; kadiri thamani inavyoongezeka, modeli iliyorekebishwa inakaribia utendaji wa Oracle, lakini uwiano huo unategemea marejeo ya Source Only na Oracle yaliyotumiwa na haupaswi kulinganishwa nje ya muktadha kati ya mipangilio tofauti ya majaribio.
Mlinganyo uliotumiwa katika chanzo:
\[ \mathrm{Closed\ Gap} = \frac{AP_{\mathrm{model}}-AP_{\mathrm{sourceonly}}} {AP_{\mathrm{oracle}}-AP_{\mathrm{sourceonly}}} \times100\% \tag{23} \]
Matokeo ya UDA ya wingu la nukta
Jedwali lifuatalo linaunganisha thamani halisi kutoka Tables 2–4 za chanzo katika mpangilio mpya wa jedwali kwa Verianla. Katika safu za AP, mpangilio ni APBEV/AP3D.
| Uhamishaji | Detekta | Source Only | SN | ST3D | UM3D | Oracle | UM3D Closed Gap BEV/3D |
|---|---|---|---|---|---|---|---|
| nuScenes → KITTI | LoGoNet | 54.56/23.15 | 47.69/32.38 | 78.26/57.41 | 80.17/58.20 | 90.72/84.87 | 70.84%/56.79% |
| nuScenes → KITTI | SECOND | 51.84/17.92 | 40.03/21.23 | 75.94/54.13 | 76.25/54.38 | 83.29/73.45 | 77.62%/65.66% |
| WOD → KITTI | LoGoNet | 69.12/31.59 | 79.95/62.25 | 84.67/65.39 | 85.71/67.44 | 90.72/84.87 | 76.81%/67.27% |
| WOD → KITTI | SECOND | 67.64/27.48 | 78.96/59.20 | 82.19/61.83 | 82.96/62.75 | 83.29/73.45 | 97.89%/76.73% |
| WOD → nuScenes | LoGoNet | 39.28/24.65 | 40.15/26.36 | 42.58/28.14 | 44.10/29.57 | 55.62/39.18 | 29.49%/33.86% |
| WOD → nuScenes | SECOND | 32.91/17.24 | 33.23/18.57 | 35.92/20.19 | 36.84/23.62 | 51.88/34.87 | 20.72%/36.18% |
| WOD → Lyft | LoGoNet | 74.87/57.61 | 74.93/57.89 | 78.14/59.93 | 79.06/61.28 | 85.33/71.52 | 40.05%/26.38% |
| WOD → Lyft | SECOND | 72.92/54.34 | 72.33/54.34 | 76.32/59.24 | 76.14/59.19 | 84.47/68.78 | 27.88%/33.59% |
Matokeo hayapaswi kupunguzwa kuwa dai la ubora wa jumla katika jozi moja ya modeli/uhamishaji. Kwa mfano, katika usanidi wa WOD → Lyft SECOND, APBEV ya ST3D ni 76,32 huku UM3D ikiwa 76,14; kwa upande mwingine AP3D ya UM3D ni 59,19 na ya ST3D ni 59,24. Hivyo, katika usanidi huu tofauti ni ndogo sana na UM3D haitoi matokeo ya juu zaidi katika kila seli.
Matokeo ya monokula ya WOD/nuScenes/Lyft → KITTI
Katika kikoa lengwa cha KITTI, thamani za Source Only ziliripotiwa kuwa 0 kwa seli zote za Easy/Moderate/Hard APBEV na AP3D. Jedwali lifuatalo linaonyesha matokeo ya STMono3D, UM3D na Oracle.
| Uhamishaji | Mbinu | APBEV Easy | APBEV Mod. | APBEV Hard | AP3D Easy | AP3D Mod. | AP3D Hard |
|---|---|---|---|---|---|---|---|
| nuScenes → KITTI | STMono3D | 35.63 | 27.37 | 23.95 | 28.65 | 21.89 | 19.55 |
| nuScenes → KITTI | UM3D | 36.81 | 27.60 | 22.94 | 29.37 | 22.16 | 18.93 |
| nuScenes → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
| Lyft → KITTI | STMono3D | 26.46 | 20.71 | 17.66 | 18.14 | 13.32 | 11.83 |
| Lyft → KITTI | UM3D | 28.23 | 21.59 | 17.98 | 19.32 | 13.35 | 11.16 |
| Lyft → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
| WOD → KITTI | STMono3D | 35.69 | 26.94 | 23.19 | 28.34 | 20.21 | 18.03 |
| WOD → KITTI | UM3D | 36.10 | 27.67 | 23.48 | 29.08 | 20.92 | 18.84 |
| WOD → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
Katika baadhi ya seli za monokula, UM3D kuzidi thamani ya Oracle kunapaswa kufasiriwa kwa tahadhari. Oracle katika makala ni FCOS3D inayotegemea picha na kufunzwa kwa usimamizi kamili katika kikoa lengwa. UM3D, ingawa hufanya inferensi kwa kamera moja, huunganisha jiometri ya Pseudo-LiDAR inayotokana na picha hiyo hiyo na vipengele vya picha na kunufaika na mafunzo mapana zaidi ya awali katika kikoa chanzo. Kwa hiyo, miundo ya uwakilishi ya mifumo hii miwili si sawa. Matokeo haya hayamaanishi kwamba “ujifunzaji usiosimamiwa kwa ujumla ni bora kuliko ujifunzaji unaosimamiwa kikamilifu.”
Matokeo ya monokula katika kikoa lengwa cha nuScenes
| Uhamishaji | Mbinu | mAP | mATE | mASE | mAOE |
|---|---|---|---|---|---|
| WOD → nuScenes | Source Only | 2.4 | 1.302 | 0.190 | 0.802 |
| WOD → nuScenes | STMono3D | 23.5 | 0.843 | 0.171 | 0.349 |
| WOD → nuScenes | UM3D | 25.7 | 0.820 | 0.168 | 0.311 |
| WOD → nuScenes | Oracle | 28.2 | 0.798 | 0.160 | 0.209 |
| Lyft → nuScenes | Source Only | 2.4 | 1.302 | 0.190 | 0.802 |
| Lyft → nuScenes | STMono3D | 21.3 | 0.911 | 0.170 | 0.355 |
| Lyft → nuScenes | UM3D | 22.1 | 0.898 | 0.173 | 0.304 |
| Lyft → nuScenes | Oracle | 28.2 | 0.798 | 0.160 | 0.209 |
Kwa mAP, thamani ya juu humaanisha usahihi bora wa utambuzi, wakati mATE, mASE na mAOE ni vipimo vya hitilafu; kwa hiyo thamani ya chini inapendelewa kwa vipimo hivyo. Katika uhamishaji wa WOD → nuScenes, UM3D iliongeza mAP kutoka 23,5 hadi 25,7 ikilinganishwa na STMono3D, huku ikipunguza mATE kutoka 0,843 hadi 0,820, mASE kutoka 0,171 hadi 0,168 na mAOE kutoka 0,349 hadi 0,311.
Ablesheni ya ORSS na PLGM
| Moduli | Detekta | APBEV | AP3D |
|---|---|---|---|
| Source Only | SECOND | 67.64 | 27.48 |
| Source Only | LoGoNet | 69.12 | 31.59 |
| Baseline + ORSS | SECOND | 78.29 | 55.13 |
| Baseline + ORSS | LoGoNet | 79.46 | 56.08 |
| Baseline + PLGM | SECOND | 81.30 | 59.42 |
| Baseline + PLGM | LoGoNet | 83.25 | 61.91 |
| Baseline + PLGM + ORSS | SECOND | 82.96 | 62.75 |
| Baseline + PLGM + ORSS | LoGoNet | 85.71 | 67.44 |
Katika msingi wa LoGoNet, kuongeza ORSS pekee huongeza APBEV/AP3D kutoka 69,12/31,59 hadi 79,46/56,08 ikilinganishwa na Source Only. PLGM pekee hufikia 83,25/61,91. Kutumia vipengele vyote viwili kwa pamoja hutoa matokeo ya juu zaidi, 85,71/67,44. Jedwali hili ni ushahidi mkuu wa ablesheni unaoonyesha kuwa kumbukumbu ya lebo bandia na hatua ya kubadilisha ukubwa wa vitu hazirudii kazi ileile, bali zina athari zinazokamilishana.
Ablesheni ya mafunzo ya pamoja ya mwanzo hadi mwisho
| Mtandao unaoboreshwa kwa pamoja | APBEV Easy | APBEV Mod. | APBEV Hard | AP3D Easy | AP3D Mod. | AP3D Hard |
|---|---|---|---|---|---|---|
| Depth | 30.26 | 20.71 | 17.35 | 25.51 | 16.06 | 14.48 |
| RCNN | 32.01 | 22.56 | 18.55 | 26.75 | 17.69 | 15.41 |
| RPN | 32.64 | 22.87 | 18.94 | 26.14 | 17.52 | 14.34 |
| RCNN + RPN | 33.89 | 23.42 | 19.80 | 26.99 | 17.10 | 15.85 |
| Depth + RPN | 35.62 | 26.36 | 21.16 | 28.74 | 19.23 | 16.19 |
| Depth + RCNN | 35.98 | 26.73 | 23.20 | 29.32 | 19.15 | 17.41 |
| Depth + RCNN + RPN | 36.10 | 27.67 | 23.48 | 29.08 | 20.92 | 18.84 |
Moderate APBEV ni 23,42 katika mafunzo ya pamoja ya RCNN + RPN, lakini huongezeka hadi 27,67 mtandao wa kina unapojumuishwa pia katika uboreshaji wa pamoja. Waandishi wa chanzo wanahusisha tofauti hii ya pointi 4,25 na umuhimu wa gradient ya utambuzi kurudi kwenye ukadiriaji wa kina. Muundo kamili wa mitandao mitatu unafikia thamani ya juu zaidi katika seli tano kati ya sita za AP; isipokuwa moja ni Easy AP3D. Hapa Depth + RCNN hutoa 29,32, wakati muundo kamili hutoa 29,08.
Ongezeko la jamaa la %19,30 la APBEV lililotajwa katika muhtasari wa utafiti pia linalingana na kulinganisha 30,26 katika safu ya Depth pekee na 36,10 katika safu kamili ya Depth + RCNN + RPN chini ya hali ya Easy.
Matokeo ya ubora yanaonyesha nini?
Kielelezo 5 cha chanzo kinaonyesha kwa picha urekebishaji wa wingu la nukta wa WOD → KITTI. Inaonekana kuwa modeli ya Source Only huzalisha baadhi ya visanduku vya magari vikiwa vidogo sana kutokana na kutolingana kwa jiometri kati ya vikoa; ST3D huboresha hali hiyo; na UM3D husogeza zaidi eneo na ukubwa wa visanduku kuelekea Oracle.
Katika Kielelezo 6 cha chanzo, uhamishaji huohuo unalinganishwa kupitia mwonekano wa monokula wa 3D na BEV. Inaripotiwa kuwa ingawa Source Only hupata vitu vya 2D, 3D AP hushuka karibu na sifuri kutokana na hitilafu kubwa katika ukadiriaji wa kina; STMono3D hupunguza hitilafu ya kina; na utabiri wa UM3D husogea karibu zaidi na Oracle katika mifano mingi. Vielelezo hivi havichukui nafasi ya majedwali ya kiasi; vinaunga mkono tu kwa mwonekano athari ya urekebishaji wa kikoa katika jiometri ya visanduku.
Gharama ya ukokotoaji
Kwa NVIDIA RTX 3080 moja, inferensi ya fremu moja ilipimwa kuwa takribani 127 ms, yaani 7,9 FPS. Takribani 15,5 ms kati ya hizo ni za mtandao wa kina wa RSANet wenye vigezo milioni 14,5, 8,1 ms ni za CoR na uundaji wa Pseudo-LiDAR unaotegemea msongamano, na 103,7 ms ni za detekta ya mbinu nyingi. Modeli nzima ina takribani vigezo milioni 60,5. Kwa hiyo, katika utekelezaji wa sasa kikwazo kikuu si ukadiriaji wa kina, bali ni tabaka la utambuzi linalojumuisha 3D voxel backbone, RPN, kichimbaji cha vipengele vya 2D na muunganisho wa cross-modal wa hatua mbili.
Hitimisho zinazoungwa mkono na utafiti
- UM3D hutoa ongezeko la utendaji katika uhamishaji mwingi wa chanzo→lengwa uliotathminiwa ikilinganishwa na Source Only na mbinu za UDA zilizolinganishwa.
- ORSS na PLGM zinapotumiwa pamoja, matokeo ya juu zaidi yaliyounganishwa hupatikana kwa detekta zote mbili katika ablesheni ya WOD → KITTI.
- Kuboresha ukadiriaji wa kina pamoja na lengo la utambuzi hutoa ongezeko dhahiri la APBEV ikilinganishwa na kufunza kwa pamoja mitandao midogo ya utambuzi pekee.
- Muunganisho wa picha na Pseudo-LiDAR ni faida kuu ya usanifu wa utafiti chanzo dhidi ya urekebishaji wa kikoa unaotegemea modaliti moja pekee.
- Kwa kuwa Pseudo-LiDAR huzalishwa kutoka picha hiyo hiyo ya kamera moja wakati wa inferensi, hakuna haja ya sensa ya ziada ya LiDAR.
Ujumlishaji na mipaka isiyoungwa mkono na utafiti
- Matokeo hayathibitishi mafanikio sawa kwa madarasa yote ya vitu; utafiti unalenga zaidi darasa la magari.
- Utambuzi wa masafa marefu unazuiliwa na usahihi wa ukadiriaji wa kina unaojisimamia.
- Utekelezaji ulioripotiwa wa 7,9 FPS kwenye RTX 3080 haumaanishi kuwa mfumo kamili wa uzalishaji wa ndani ya gari unaofanya kazi wakati halisi umethibitishwa; waandishi wanataja ufinyaji wa modeli na kuongeza kasi ya inferensi kama kazi ya baadaye.
- Mafanikio kwenye benchmark ya KITTI au nuScenes hayahakikishi utendaji uleule kwa jiometri nyingine za kamera, hali nyingine za hewa, nchi nyingine au magari ya uzalishaji.
- Kuzidi Oracle katika baadhi ya majaribio ya monokula hakuonyeshi kuwa ujifunzaji usiosimamiwa kwa ujumla ni bora kuliko ujifunzaji unaosimamiwa kikamilifu; inapaswa kuzingatiwa kuwa Oracle inayolinganishwa ni FCOS3D inayotegemea picha na UM3D hutumia uwakilishi tofauti wa vipengele kupitia jiometri ya Pseudo-LiDAR.
- Kwa kuwa chanzo hakiripoti masafa ya upanuzi ya \(f_l,f_w,f_h\), thamani ya nambari ya \(\sigma\), wala thamani za nambari za vizingiti \(Thr_i\), \(Thr_r\) katika benki ya kumbukumbu, haiwezekani kuzalisha upya kila undani kwa kutumia maandishi ya makala pekee.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Unsupervised Domain Adaptation with Multimodal Fusion for Monocular 3D Object Detection
Waandishi: Jin Jiang; Jidong Dai; Wei Li; Yuquan Zhou; Maozhang Ye; Jianhuan Zhang; Chentao Zhang.
Mwandishi anayewajibika: Chentao Zhang.
Taasisi: Xiamen King Long United Automotive Industry Co., Ltd., Xiamen, China; Pen-Tung Sah Institute of Micro-Nano Science and Technology, Xiamen University, Xiamen, China; School of Artificial Intelligence, Quanzhou Vocational College of Economics and Business, Quanzhou, China.
Jarida: Vehicles.
Mchapishaji: MDPI, Basel, Switzerland.
Rekodi ya bibliografia: Vehicles 2026, 8(5), 98.
DOI: 10.3390/vehicles8050098
Kiungo rasmi cha DOI: https://doi.org/10.3390/vehicles8050098
Historia: Iliwasilishwa 7 Machi 2026; marekebisho 22 Aprili 2026; ilikubaliwa 25 Aprili 2026; ilichapishwa 1 Mei 2026.
Aina ya chanzo: Makala ya utafiti wa kitaaluma iliyochapishwa.
Leseni: Creative Commons Attribution (CC BY). Licha ya kuwepo kwa leseni, maandishi haya ya Verianla yameandaliwa kama muundo huru wa kufundishia unaotegemea ukweli wa kisayansi, mbinu, mahusiano ya kihisabati na data zilizoripotiwa, badala ya kuchapisha upya muundo wa sentensi, aya au vielelezo vya makala asilia.
Ufadhili: Major Science and Technology Special Project of Fujian Province, Grant No. 2024HZ022013; Applied Technology Engineering Center of Fujian Provincial Higher Education for Visual Perception and Intelligent Analysis, Grant No. SJGZ202501.
Upatikanaji wa data: Waandishi wanaeleza kuwa michango asilia imo ndani ya makala na maswali ya ziada yanaweza kuelekezwa kwa mwandishi anayewajibika.
Taarifa za kimaadili: Vipengele vya Institutional Review Board na informed consent havitumiki kwa utafiti huu.
Mgongano wa maslahi: Jin Jiang na Wei Li ni wafanyakazi wa Xiamen King Long United Automotive Industry Co., Ltd. Waandishi wengine walitangaza kuwa utafiti ulifanywa bila mahusiano ya kibiashara au kifedha ambayo yangeweza kutafsiriwa kama mgongano wa maslahi unaowezekana.
Michango ya waandishi: Uundaji wa dhana Jin Jiang na Chentao Zhang; mbinu Jin Jiang na Wei Li; programu Jidong Dai; uthibitishaji Jidong Dai na Yuquan Zhou; uchanganuzi rasmi Jidong Dai na Jianhuan Zhang; utafiti Jin Jiang, Wei Li na Maozhang Ye; rasilimali Wei Li na Maozhang Ye; uratibu wa data Jidong Dai na Yuquan Zhou; rasimu ya kwanza Jin Jiang; mapitio/uhariri Jianhuan Zhang na Chentao Zhang; uoneshaji Jidong Dai na Yuquan Zhou; usimamizi Jin Jiang, Jianhuan Zhang na Chentao Zhang; usimamizi wa mradi Chentao Zhang; upatikanaji wa ufadhili ulifanywa na Jin Jiang na Chentao Zhang.
Dokezo la uripoti ndani ya chanzo: Sehemu za muhtasari na hitimisho zinasema kuwa pengo la kikoa la APBEV kwa WOD → KITTI lilifungwa hadi %76,81, huku safu ya SECOND katika Jedwali 2 ikiripoti %97,89 APBEV Closed Gap. Kwa kuwa chanzo hakielezi tofauti hii kando, thamani zote mbili zinapaswa kuhifadhiwa katika muktadha wa majaribio yake.
Kikomo cha kimetodolojia: Utafiti unatoa uthibitishaji wa kialgorithimu wa kuvuka vikoa katika seti tofauti za data za benchmark. Ushahidi huu haumaanishi usalama wa muda mrefu wa uwanjani katika gari halisi la uzalishaji, uwezo wa kujumlisha katika madarasa yote ya vitu, au kiwango kilekile cha mafanikio katika kila mchanganyiko mpya wa sensa/jiografia.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *