

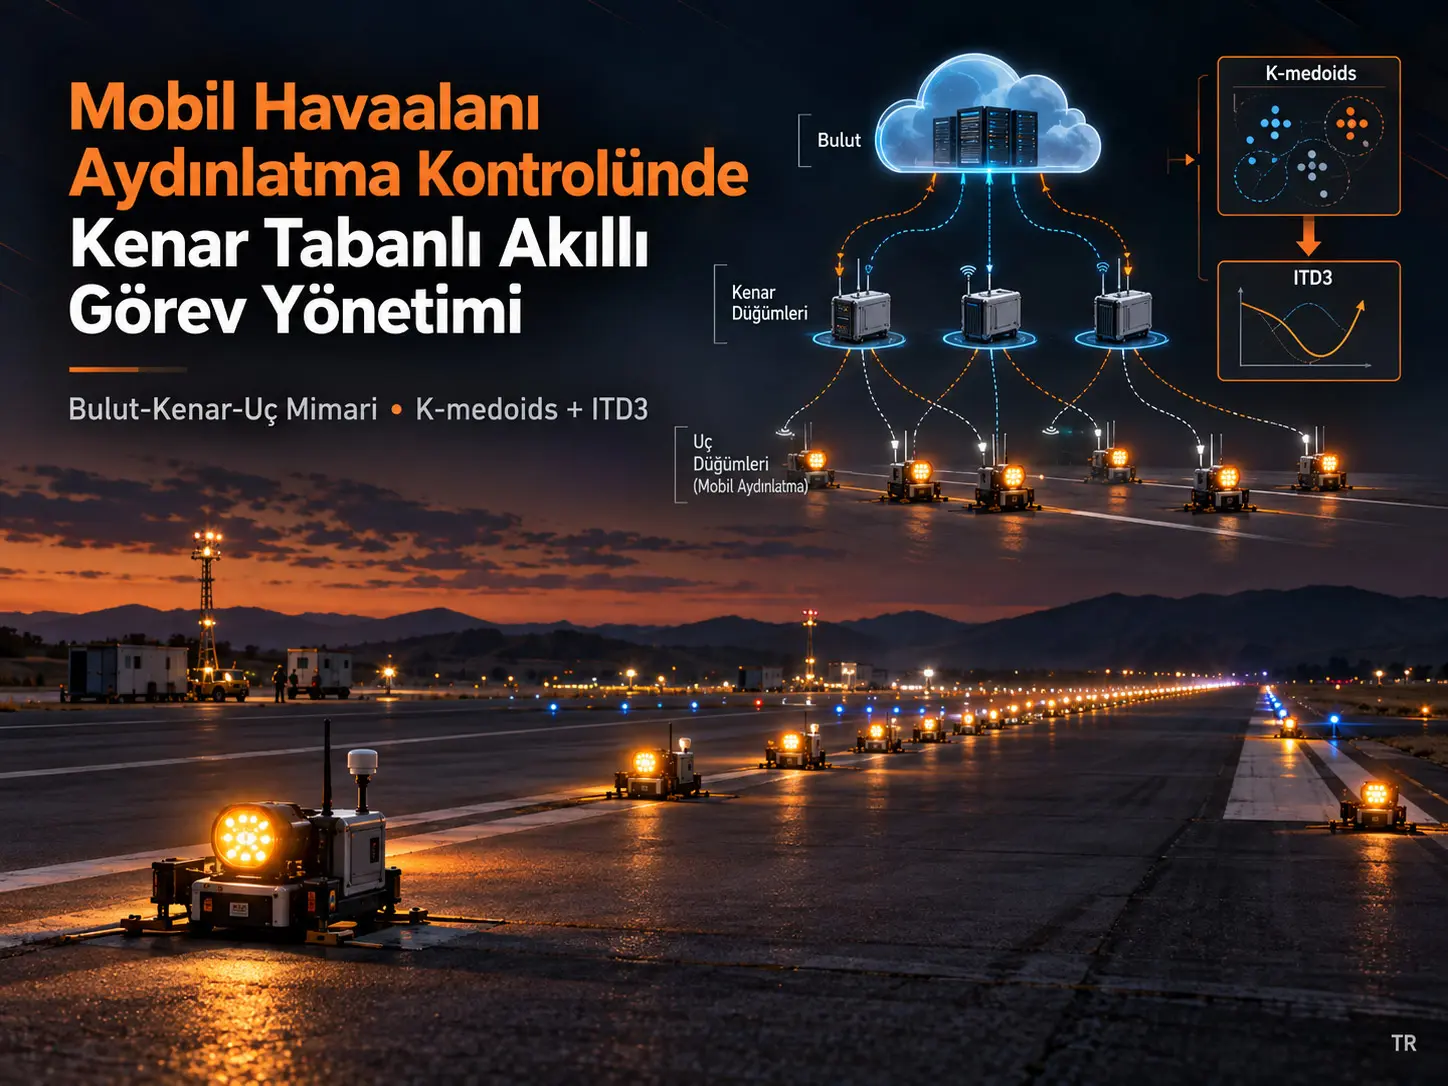
Bu çalışma, mobil havaalanı aydınlatma (Mobile Airfield Lighting, MAL) sistemlerinde çok sayıdaki havaalanı aydınlatma düğümünün hesaplama, haberleşme ve enerji kaynaklarının gerçek zamana yakın biçimde yönetilmesi için bulut–kenar–uç (cloud–edge–end) işbirlikli bir mimari ve derin pekiştirmeli öğrenme tabanlı optimizasyon yöntemi geliştirir. MAL sistemi, geçici veya mobil iniş alanlarında yaklaşma, pist ve taksi yolu aydınlatmalarını çevresel ve operasyonel koşullara göre yönetmeye yönelik dağıtık bir havaalanı aydınlatma sistemidir. Araştırmacılar toplam sistem gecikmesi ile enerji tüketimini birlikte küçülten kısıtlı bir optimizasyon problemi tanımlamış; çözüm için K-medoids ile kaba kaynak tahsisini Improved Twin Delayed Deep Deterministic Policy Gradient (ITD3) ile hassas optimizasyonu birleştirmiştir. Python 3.12 tabanlı ayrık-olay simülasyonlarında 50–2000 havaalanı aydınlatma düğümü incelenmiş ve ITD3, karşılaştırılan TAI, DDPG, PPO ve standart TD3 yöntemlerine göre toplam gecikme ve enerji tüketimi açısından daha elverişli sonuçlar vermiştir. Ancak bu sonuçlar gerçek bir işletme havaalanında gerçekleştirilen saha doğrulaması değildir; gerçek MAL saha denemeleri çalışma tarafından gelecek araştırma yönü olarak bırakılmıştır.
Önerilen sistemin temel düşüncesi bütün sensör verisini tek bir merkeze taşıyıp kararın yalnız merkezde verilmesi yerine hesaplamayı üç düzeye dağıtmaktır. Aydınlatma düğümleri yüksek frekanslı durum bilgisini toplar ve sınırlı yerel işlemler yapar; edge düğümleri bölgesel veri işleme, görev planlama ve düşük gecikmeli kararları üstlenir; bulut ise uzun süreli veri işleme, model eğitimi, küresel optimizasyon ve koordinasyon görevlerini yürütür. Böylece araştırma, mobil havaalanı aydınlatmasında gecikme, enerji tüketimi, kanal tahsisi ve işlem kapasitesini tek bir optimizasyon çerçevesi içinde ele almaktadır.
Mobil havaalanı aydınlatma sisteminde temel problem
Havaalanı saha aydınlatması; kalkış, yaklaşma, iniş ve taksi sırasında pilotların pist ve taksi yolu geometrisini, yaklaşma eksenini ve operasyonel yönlendirmeyi görsel olarak algılamasına yardım eder. Özellikle düşük görüş koşullarında aydınlatmanın kullanılabilirliği, kontrol gecikmesi ve doğru ışık düzeninin oluşturulması operasyon açısından kritik hale gelir.
Geleneksel havaalanı aydınlatma sistemleri çoğunlukla merkezi ve devre-temelli bir kontrol yaklaşımına dayanır. Fakat daha gelişmiş A-SMGCS Level IV benzeri senaryolarda binlerce ışığın uçak hareketiyle bağlantılı olarak dinamik yönetilmesi gerekebilir. Kaynak, bu durumda saniyede on binlerce veri noktasına varabilen veri toplama yüklerinin ve milisaniye ölçeğinde kontrol gereksinimlerinin merkezi “bütün veriyi merkeze yükle, merkezde karar ver” yaklaşımını zorladığını belirtmektedir.
Mobil havaalanı aydınlatması bu ölçeklenebilirlik sorununa ek bir boyut getirir. MAL sistemleri kalıcı pist altyapısına bağlı olmayan geçici veya mobil kullanım alanlarında, çevre koşullarına ve hizmet verilen hava aracına göre aydınlatma düzeninin uyarlanmasını amaçlar. Bu nedenle yalnız ışıkları açıp kapatmak yeterli değildir; çok sayıda düğümün haberleşmesi, hesaplama yükleri, enerji bütçesi ve gecikme gereksinimi birlikte yönetilmelidir.
Bulut–Kenar–Uç Mimarisi Mobil Havaalanı Aydınlatmasında Neden Kullanılıyor?
Bulut–kenar–uç mimarisi, gecikmeye duyarlı kararları havaalanı aydınlatma düğümlerine yakın edge kaynaklarında işlerken yüksek maliyetli model eğitimi ve küresel optimizasyonu buluta bırakmak için kullanılır; böylece bütün verinin merkezi sisteme taşınmasına bağlı gecikme, bant genişliği ve tek hata noktası baskısının azaltılması amaçlanır.
Üç hesaplama katmanı
| Katman | Ana bileşenler | Temel görev | Kaynak sınırı |
|---|---|---|---|
| End / Uç | Havaalanı ışıkları, hafif hesaplama birimleri, sensörler, haberleşme radyoları | Yüksek frekanslı durum toplama, temel ön işleme ve sınırlı yardımcı kararlar | Hesaplama ve enerji kaynakları sınırlıdır. |
| Edge / Kenar | Birden fazla ALN ile bağlantılı bölgesel edge düğümleri | Veri toplama, bölgesel işlem, hesaplama, kontrol, yerel tahmin ve görev yönetimi | Çok geniş saha için birden fazla edge düğümü gerekir. |
| Cloud / Bulut | Merkezi bulut veri merkezi ve hizmet bileşenleri | Uzun çevrimli işlem, veri yönetimi, karmaşık model eğitimi, küresel optimizasyon ve koordinasyon | Gecikmeye duyarlı her işlem doğrudan bulutta yürütülmez. |
Çalışmanın önerdiği dağılımda edge düğümleri yalnız birer iletişim aktarıcısı değildir. Hesaplama ve depolama kaynaklarına sahiptirler ve kapsama alanlarındaki havaalanı aydınlatma düğümlerinin verilerini işleyebilirler. Bulut ise tüm ağın daha uzun zaman ölçeğindeki ortak optimizasyonunu ve model eğitimini üstlenir.
İletişim modelinin ilk adımı: yol kaybı
Kaynak, referans mesafedeki serbest uzay yol kaybını Denklem (1) ile tanımlar:
\[ L(d_0)=\left(\frac{4\pi d_0 f}{c_v}\right)^2 \]
Burada \(d_0\) referans mesafesidir ve kaynak bunu genellikle 1 m olarak belirtir. \(f\) taşıyıcı frekansı, \(c_v\) ışık hızıdır. Bu denklem, haberleşme bağlantısında frekans ve mesafenin temel serbest uzay kaybına nasıl girdiğini belirler. Frekans yükseldiğinde diğer koşullar aynı kalırsa bu terim karesel biçimde büyür.
ALN ile edge düğümü arasındaki uzaklık
n’inci havaalanı aydınlatma düğümü ile m’inci edge düğümünün uzaklığı Denklem (2) ile verilir:
\[ d_{n,m}=\sqrt{H^2+(x_m-x_n)^2+(y_m-y_n)^2} \]
\(x_n,y_n\) ve \(x_m,y_m\) yatay koordinatları, \(H\) ise geometrik uzaklığa giren yükseklik bileşenini temsil eder. Denklem, düğümler arasındaki üç boyutlu geometrik ayrımı kanal modeline taşır.
Rayleigh fading altında kanal kazancı
Kaynak kanal kazancını Denklem (3) ile tanımlar:
\[ g_{n,m}=\frac{1}{L(d_0)} \left(\frac{d_0}{d_{n,m}}\right)^\beta h \]
\(\beta\) yol kaybı üssüdür ve kaynak serbest uzay için tipik olarak 2 değerini belirtir. \(h\), çok yollu yayılımın sinyal genliği üzerindeki rastlantısal etkisini temsil eden Rayleigh dağılımlı terimdir. Bu nedenle düğümler arasındaki haberleşme kalitesi yalnız geometrik mesafeye değil, fading etkisine de bağlıdır.
Sinyal-gürültü-girişim oranı
n’inci ALN’nin c alt kanalında m’inci edge düğümüne bağlantısı için SNR Denklem (4)’te şöyledir:
\[ \mathrm{SNR}_{n,m,c} = \frac{P_{n,c}g_{n,m}} {\sigma^2+\sum_{n'\neq n}P_{n',c}g_{n',m}} \]
\(P_{n,c}\), n’inci ALN’nin c alt kanalındaki iletim gücüdür. \(\sigma^2\) gürültü gücünü, toplam terimi ise aynı alt kanalda diğer ALN’lerin oluşturduğu girişimi temsil eder. Paydaki faydalı alınan güç arttıkça SNR yükselirken gürültü veya ortak kanal girişimi arttıkça SNR düşer.
İletişim hızı
Kaynak, Shannon bağıntısından hareketle ALN–EN haberleşme hızını Denklem (5) ile verir:
\[ R_{n,m} = B\sum_{c=1}^{C}\log_2 \left(1+\mathrm{SNR}_{n,m,c}\right) \]
\(B\) kablosuz kanal bant genişliği, \(C\) alt kanal sayısıdır. Bu değer daha sonraki yükleme gecikmesi hesaplarının doğrudan girdisidir. Aynı veri boyutunda \(R_{n,m}\) büyüdükçe veri aktarım süresi azalır.
Yerel hesaplama gecikmesi
n’inci ALN’nin yerel ön işleme gecikmesi:
\[ T_n^{local} = \frac{D_n C_n}{cf_n} \]
şeklindedir. \(D_n\) işlenecek veri miktarını, \(C_n\) veri örneği başına hesaplama yükünü, \(cf_n\) ise ALN’nin yerel hesaplama kapasitesini temsil eder. Veri ve işlem yükü büyüdükçe gecikme artarken işlem kapasitesi büyüdükçe gecikme azalır.
ALN’den edge düğümüne veri yükleme süresi
\[ T_{n,m}^{up} = \frac{|w_n|}{R_{n,m}} \]
Burada \(|w_n|\) yüklenen parametre verisinin büyüklüğüdür. Haberleşme hızı aynı veri miktarı için iki katına çıkarsa bu yükleme gecikmesinin matematiksel olarak yarıya düşmesi beklenir.
Tek ALN için toplam gecikme ve enerji
\[ T_n=T_n^{local}+T_{n,m}^{up} \]
\[ E_n= \kappa cf_n^3T_n^{local} + P_{n,c}T_{n,m}^{up} \]
Enerji modelinin ilk terimi yerel hesaplama, ikinci terimi kablosuz iletim maliyetini temsil eder. İşlem frekansının küpüyle gelen \(cf_n^3\) terimi, hesaplama hızını yükseltmenin enerji açısından doğrusal olmayan bir maliyet oluşturduğunu gösterir. Bu ilişki çalışmanın neden yalnız gecikmeyi küçültmek yerine gecikme ve enerjiyi birlikte optimize ettiğini açıklayan matematiksel çekirdektir.
Edge hesaplama maliyeti
m’inci edge düğümünün yerel parametre görevini işlemesi için kaynak:
\[ T_{m,k}^{com} = \sum_{n=1}^{N} \alpha_{n,m} \frac{|w_n|c_m}{cf_m} \]
\[ E_{m,k}^{com} = \kappa cf_m^3T_{m,k}^{com} \]
denklemlerini kullanır. \(\alpha_{n,m}\), n’inci ALN’nin m’inci edge düğümünü seçip seçmediğini belirleyen ikili değişkendir. \(c_m\) edge düğümünün bit başına işlem yükü, \(cf_m\) edge hesaplama kapasitesidir.
Edge’den buluta yükleme
\[ T_{m,k}^{up} = \frac{|w_m|}{R_{m,L}} \]
\[ E_{m,k}^{up} = P_m T_{m,k}^{up} \]
\(|w_m|\), m’inci edge düğümünün buluta aktardığı veri büyüklüğüdür; \(R_{m,L}\) edge–cloud iletişim hızı ve \(P_m\) bu bağlantı için kullanılan iletim gücüdür.
Bulut hesaplama gecikmesi
Kaynak bulut işlem süresini Denklem (11) ile verir:
\[ T_{L,k_L}^{com} = \sum_{m=1}^{M} \frac{|w_m|c_L}{cf_L} \]
\(c_L\) bulutun bit başına hesaplama yükünü, \(cf_L\) ise bulut işlem kapasitesini ifade eder. Kaynağa göre edge kapasitesi görevi karşılayabiliyorsa bulut desteği kullanılmayabilir ve ilgili bulut hesaplama gecikmesi sıfır kabul edilir.
Buluttan sonuçların geri dağıtılması
Kaynakta bulut → edge → ALN geri dağıtımı için Denklem (12) ve (13) kullanılır:
\[ T_{L,k_L}^{down} = \max_{m=1,2,\ldots,M} \left( \frac{|w_L|}{R_{L,m}} + \sum_{n=1}^{N} \alpha_{m,n} \frac{|w_L|}{R_{m,n}} \right) \]
\[ T_{m,k}^{down} = \sum_{n=1}^{N} \alpha_{m,n} \frac{|w_L|}{R_{m,n}} \]
Kaynak bu bölümde \(L\) simgesini bulut için kullanırken \(|w_L|\) ifadesini “L-th EN” veri boyutu şeklinde açıklamaktadır. Bu ifade önceki sembol tanımlarıyla tam uyumlu görünmediği için Verianla metni notasyonu sessizce değiştirmemiştir.
Toplam sistem gecikmesi
ALN, edge ve bulut işleme/aktarım bileşenleri bir araya getirilerek toplam gecikme Denklem (14a)’da oluşturulur:
\[ T^{all} = \max_{m\in\{1,2,\ldots,M\}} \left[ \sum_{n\in N_m} \left( T_n^{local}+T_{n,m}^{up} \right) + \left( T_{m,k}^{com} + T_{m,k}^{up} + T_{m,k}^{down} \right) \right] + \left( T_{L,k_L}^{com} + T_{L,k_L}^{down} \right) \]
Buradaki maksimum operatörü, paralel edge bölgeleri içinde toplam sistem yanıtının en yavaş kritik yol tarafından sınırlandırılması fikrini taşır.
Kaynak toplam enerji için Denklem (14b)’yi şu notasyonla verir:
\[ E^{all} = \sum_{n=1}^{N}E_n + \sum_{i=1}^{M}E_{i,n}^{all} \]
İkinci toplamın \(E_{i,n}^{all}\) sembolü kaynak metinde ayrıca ayrıntılı biçimde yeniden tanımlanmadığından burada farklı bir sembolle değiştirilmemiştir.
Gecikme ile enerji neden birlikte optimize ediliyor?
Yalnız gecikmenin küçültülmesi hesaplama frekansını veya iletim gücünü yükselterek enerji maliyetini artırabilir. Yalnız enerjinin küçültülmesi ise işlem ve veri iletimini yavaşlatarak gerçek zamanlı kontrol gereksiniminin aşılmasına neden olabilir. Çalışma bu nedenle iki hedefi ağırlıklı tek amaç fonksiyonunda birleştirir.
\[ P1: \min_{\alpha_{m,n},cf_i} \lambda_1T^{all}(\alpha_{m,n},f_i) + \lambda_2E^{all}(\alpha_{m,n},cf_i) \]
Kaynakta gecikme teriminde \(f_i\), enerji teriminde \(cf_i\) notasyonu kullanılmıştır; Verianla çekirdeği bu notasyon farkını sessizce eşitlemez.
Kısıtlar Denklem (16)’da şu şekilde tanımlanmıştır:
\[ C1: T_n(\alpha_{m,n},cf_i)\le T_{max} \]
\[ C2: E^{all}\le E_{max} \]
\[ C3: \sum_{n=1}^{N}\phi_{n,c}\le1 \]
\[ C4: 0<cf_i\le f_{max} \]
C1 her düğümün izin verilen maksimum gecikmayı aşmasını engeller. C2 toplam enerji bütçesini sınırlar. C3 bir alt kanalın aynı anda birden fazla ALN tarafından işgal edilmemesini zorunlu kılar. C4 ise edge/bulut işlem kaynağının fiziksel kapasiteyi aşmasına izin vermez.
K-Medoids ve ITD3 Birlikte Nasıl Çalışıyor?
K-medoids önce çok sayıdaki havaalanı aydınlatma düğümünü gecikme maliyetine göre edge düğümlerine kaba biçimde gruplandırarak arama uzayını küçültür; ITD3 daha sonra bu başlangıç dağılımı üzerinde düğüm seçimi, kanal tahsisi ve sürekli kaynak değişkenlerini kısıtlar altında daha hassas biçimde optimize eder.
K-medoids ile kaba ALN–EN dağıtımı
Kaynak, ALN–EN uçtan uca gecikme/maliyet bilgisini kümelendirme özelliği olarak kullanır. Süreç beş temel adımdan oluşur: başlangıçta M adet ALN medoid adayı seçilir; bütün ALN’ler en düşük gecikme maliyetine sahip kümeye atanır; her kümedeki merkez yeniden hesaplanır ve gecikme kısıtını karşılamayan adaylar elenir; merkezler değişmeyene veya küme içi uzaklık değişimi eşik değerinin altına düşünceye kadar işlem tekrarlanır; sonunda ITD3 için başlangıç kanal/düğüm tahsis matrisi elde edilir.
K-medoids aşamasının görevi nihai optimumu tek başına bulmak değildir. Temel işlevi, binlerce düğüm bulunan durumda ITD3’ün ince optimizasyona başlayacağı problem uzayını daha yönetilebilir hale getirmektir.
ITD3 durum uzayı
Kaynağın durum vektörü Denklem (17)’de şöyledir:
\[ S= \{ cf_m, cf_n, P_{n,c}, R_{n,m}, T_n, E_n, E_m^{rem} \} \]
Durum; edge ve ALN işlem kapasitesi, iletim gücü, haberleşme hızı, tek düğüm gecikmesi, ALN enerji tüketimi ve edge düğümünde kalan enerji gibi dinamik değişkenleri içerir. Bütün durum değişkenleri sinir ağı eğitiminde ölçek farklılığının etkisini azaltmak için [0,1] aralığına normalize edilir.
ITD3 eylem uzayı
Kaynak Denklem (18)’de eylem uzayını şu şekilde verir:
\[ A= \{ \alpha_{m,n}, \phi_{m,c}, P_m \} \]
\(\alpha_{m,n}\) parametrelerin hangi edge düğümüne yükleneceğine ilişkin ikili seçimi, \(\phi_{m,c}\) kanal tahsisini temsil eder. Kaynak metni \(P_m\)’yi bu noktada görevlere göre hesaplama kaynaklarının oransal dağıtımı şeklinde açıklamaktadır. Ancak önceki iletişim/enerji modelinde \(P_m\) edge düğümünün iletim gücü olarak kullanılmıştır. Bu kaynak içi sembol belirsizliği korunmalı ve farklı bir tanımla sessizce giderilmemelidir.
Ödül fonksiyonu
ITD3 ajanı doğrudan gecikme ve enerji değerini küçültmek yerine bunların negatif ağırlıklı değerini ve kısıt ihlallerini içeren ödülü maksimize eder:
\[ r(S,A) = -\lambda_1\frac{T^{all}(S,A)}{T_{max}} -\lambda_2\frac{E^{all}(S,A)}{E_{max}} -\gamma\sum_{k=1}^{4}Pen_k(S,A) \]
Ceza terimleri kaynakta:
\[ Pen_1=1 \text{ eğer } T_n>T_{max}, \text{ aksi halde } 0 \]
\[ Pen_2=1 \text{ eğer } E^{all}>E_{max}, \text{ aksi halde } 0 \]
\[ Pen_3=1 \text{ eğer } \sum_n\phi_{n,c}>1, \text{ aksi halde } 0 \]
\[ Pen_4=1 \text{ eğer } f_i>f_{max}, \text{ aksi halde } 0 \]
şeklindedir. Kullanılan ceza katsayısının önerilen değeri \(\gamma=10\)’dur. Böylece kısıt ihlal eden eylemlerin ödülü düşürülerek ajanın yalnız düşük gecikmeli değil, aynı zamanda uygulanabilir çözümleri tercih etmesi amaçlanır.
Standart TD3 üzerinde yapılan üç temel değişiklik
| Geliştirme | Teknik mekanizma | Amaç |
|---|---|---|
| Çift dallı actor | Sürekli ve ayrık eylemlerin ayrı dallardan üretilmesi; ayrık dalda Gumbel-Softmax ve 0,5 sert eşik | Karma ayrık–sürekli eylem uzayını eğitebilmek |
| Kısıt-farkındalıklı critic | Kısıt ihlal eden eylemlerin Q-değerlerinin aşağı çekilmesi | Ödül cezasına ek ikinci bir uygulanabilirlik mekanizması oluşturmak |
| Prioritized Experience Replay | Örneklerin TD-hatasına göre önceliklendirilmesi ve ISW ile örnekleme yanlılığının düzeltilmesi | Bilgi değeri yüksek deneyimlerden daha verimli öğrenmek ve yakınsamayı hızlandırmak |
Actor ve critic ağları
| Ağ | Kaynakta verilen yapı | Aktivasyon | Optimizer |
|---|---|---|---|
| Actor | State S → “2-layer FC(256,128,64)” → çift dal, sürekli + ayrık | ReLU + Tanh / Softmax | Adam |
| Critic Q1 | [S,A] → “2-layer FC(256,128,64)” → 1D Q-value | ReLU + Linear | Adam |
| Critic Q2 | [S,A] → “2-layer FC(256,128)” → 1D Q-value | ReLU + Linear | Adam |
Kaynak tablo actor ve Q1 için üç boyut değeri \(256,128,64\) vermesine rağmen yapıyı “2-layer FC” olarak adlandırmaktadır. Burada mimariyi kaynakta yazılmayan bir katman yorumuyla değiştirmek yerine özgün gösterim korunmuştur.
Aktivasyon fonksiyonları
ReLU:
\[ \operatorname{ReLU}(x)=\max(0,x) \]
Tanh:
\[ \tanh(x) = \frac{e^x-e^{-x}} {e^x+e^{-x}} \]
Softmax:
\[ \operatorname{Softmax}(x_i) = \frac{e^{x_i}} {\sum_{j=1}^{n}e^{x_j}} \]
Tanh sürekli actor çıktısında, Softmax ise ayrık kanal tahsis dalında kullanılmaktadır. Adam optimizer ağ ağırlıklarının güncellenmesinde kullanılır.
ITD3 eğitim döngüsü
Eğitim actor, target actor, iki critic ve bunların target ağlarının başlatılmasıyla başlar. Prioritized Experience Replay tamponunun kapasitesi \(10^6\) olarak belirlenmiştir. Actor mevcut durumda eylem üretir ve keşif için Gaussian gürültü eklenir; keşif gürültüsü eğitim ilerledikçe 0,1’den 0,01’e düşürülür.
Her etkileşimden \((S,A',r,S')\) deneyimi replay buffer’a yazılır. Eğitim sırasında 64 veya 128 örneklik batch’ler önceliğe göre seçilir ve Importance Sampling Weights ile priority sampling kaynaklı yanlılık düzeltilir. Target critic için iki Q tahmininin minimumu kullanılarak TD3’ün aşırı değerleme eğilimi azaltılır.
Critic ağları hedef Q-değerine göre ortalama karesel hata benzeri kayıplarla güncellenir; actor ise:
\[ L_\pi=-E[Q_1(S,\pi(S))] \]
politika kaybını küçülterek güncellenir.
Target ağların yumuşak güncellemesinde \(\tau=0.005\) kullanılır:
\[ \theta_{\pi_{target}} \leftarrow \tau\theta_\pi + (1-\tau)\theta_{\pi_{target}} \]
\[ \theta_{Q_{target}} \leftarrow \tau\theta_Q + (1-\tau)\theta_{Q_{target}} \]
Ödül fonksiyonunun hareketli ortalaması 500 ardışık adım boyunca iyileşmezse veya maksimum eğitim adımı sayısına ulaşılırsa eğitim sonlandırılır.
Çalışmanın Yöntemi ve Bulguları
Simülasyon Hangi Koşullarda Yapıldı?
Performans değerlendirmesi Python 3.12 ile geliştirilmiş ayrık-olay simülatöründe, 50’den 2000’e kadar havaalanı aydınlatma düğümü ve N/25 oranında edge düğümü kullanılarak gerçekleştirilmiştir; her koşul 100 ms’lik 3600 zaman dilimini kapsayan 6 dakikalık bir simülasyon ve 10 bağımsız rastgele tohum üzerinden değerlendirilmiştir.
| Parametre | Değer |
|---|---|
| ALN sayısı \(N\) | 50 / 100 / 500 / 1000 / 2000 |
| EN sayısı \(M\) | \(N/25\) |
| EN hesaplama kapasitesi \(cf_m\) | [3, 4] GHz |
| ALN hesaplama kapasitesi \(cf_n\) | [0,5, 2,5] GHz |
| ALN iletim gücü \(P_{n,c}\) | [0,5, 5] W |
| Kablosuz kanal bant genişliği \(B\) | 2 MHz |
| Gürültü gücü \(\sigma^2\) | −50 dBm |
| Eğitim veri boyutu \(D_n\) | [0,1, 2] MB |
| Yükleme veri boyutu \(|w|\) | [0,1, 2] MB |
\(M=N/25\) kuralına göre incelenen beş ALN ölçeği sırasıyla 2, 4, 20, 40 ve 80 edge düğümüne karşılık gelir. Bu değer kaynak parametrizasyonunun doğrudan matematiksel sonucudur; ayrı bir deney sonucu değildir.
ITD3 eğitim parametreleri
| Modül | Parametre | Önerilen değer |
|---|---|---|
| K-medoids | Küme sayısı K | EN sayısı M |
| K-medoids | Yakınsama eşiği | \(10^{-3}\) |
| ITD3 | Batch size | 64 / 128 |
| ITD3 | Gizli katman boyutu | 256 / 128 |
| ITD3 | Actor öğrenme oranı \(\mu\) | \(10^{-3}\) – \(10^{-5}\) |
| ITD3 | Critic öğrenme oranı \(\rho\) | \(10^{-2}\) – \(10^{-4}\) |
| ITD3 | Discount factor | 0,95 – 0,99 |
| ITD3 | Soft update rate | 0,005 |
| ITD3 | Exploration noise std | 0,1 → 0,01 |
| ITD3 | Replay buffer kapasitesi | \(10^6\) |
| Ödül | Ceza katsayısı \(\gamma\) | 10 |
| Ödül | \(\lambda_1/\lambda_2\) | 0,7 / 0,3 |
Kaynak düşük gecikmenin MAL gerçek zamanlı kontrolü açısından öncelikli olması nedeniyle \(\lambda_1=0.7\), \(\lambda_2=0.3\) seçmiştir. Bu kombinasyon 0,5/0,5; 0,6/0,4; 0,7/0,3 ve 0,8/0,2 seçenekleri arasında çalışma kapsamında en uygun gecikme–enerji dengesini vermiştir.
Simülasyon süresi ve tekrarlar
Her zaman dilimi \(\Delta t=100\) ms’dir. Bir koşu \(T=3600\) zaman dilimi sürer; bu da 360 saniye veya 6 dakikalık simüle edilmiş sistem süresine karşılık gelir. Sonuçlar farklı random seed’lerle gerçekleştirilen 10 bağımsız çalışmanın ortalamasıdır.
Simülasyon ve eğitim Intel Core i9-10700K CPU, NVIDIA RTX 4060 GPU ve Python 3.12 kullanılan bir platformda çalıştırılmıştır.
Karşılaştırılan algoritmalar
| Yöntem | Rol |
|---|---|
| TAI | Geleneksel alternating iteration yaklaşımı |
| DDPG | Deep Deterministic Policy Gradient |
| PPO | Proximal Policy Optimization |
| TD3 | Standart Twin Delayed Deep Deterministic Policy Gradient |
| ITD3 | K-medoids ile birlikte kullanılan çalışmanın geliştirilmiş TD3 yöntemi |
Eğitim ilerledikçe gecikme ve enerji
Kaynak Şekil 5’te eğitim epoch’u arttıkça toplam gecikme ve toplam enerji tüketimini karşılaştırmaktadır. ITD3 eğrisi karşılaştırılan algoritmalar arasında daha düşük kararlı gecikme ve enerji bölgesine ulaşmaktadır. Kaynak ayrıca yaklaşık 2000 eğitim epoch’undan sonra bütün yöntemlerde ek iyileşmenin küçük hale geldiğini belirtmektedir.
Grafik ham sayısal noktaları tablo olarak vermediği için Verianla metni Şekil 5’ten gözle okunmuş kesin yüzdeler veya hassas performans farkları üretmemektedir. Kaynağın doğrudan desteklediği sonuç, algoritmaların göreli eğilimi ve ITD3’ün bu simülasyon koşullarındaki üstün performansıdır.
Düğüm sayısı büyüdüğünde ne oluyor?
Şekil 6’da \(N=50,100,500,1000,2000\) için ITD3 davranışı karşılaştırılmaktadır. ALN sayısı yükseldikçe hem toplam gecikme hem toplam enerji tüketimi artmaktadır. Kaynak bunu daha fazla düğümün eğitim ve işleme sürecine katılmasının yerel hesaplama süresini ve enerji tüketimini büyütmesiyle açıklamaktadır.
Bu bulgu, yöntemin ölçeklenebilir olduğu iddiasının “düğüm sayısı büyüdükçe maliyet değişmiyor” anlamına gelmediğini gösterir. ITD3 büyük problem boyutlarında karşılaştırmalı avantaj sunarken fiziksel ve hesaplamalı yük yine büyümektedir.
Öğrenme oranının etkisi
Kaynak Şekil 7’de actor öğrenme oranı \(\mu\) ile critic öğrenme oranı \(\rho\)’yu birlikte değiştirmiştir. Başlangıçtaki \(\mu=0.001\) ve \(\rho=0.01\) düzeylerinden daha küçük değerlere geçildiğinde gecikme ve enerji açısından iyileşme görülmektedir.
\(\mu=0.000025\) ve \(\rho=0.00025\) kombinasyonu erken dönemde daha yavaş yakınsamakta, fakat 2000 epoch sonrasında kaynak tarafından en iyi kararlı toplam gecikme ve enerji değerlerini veren ayar olarak tanımlanmaktadır.
Öğrenme oranları daha da azaltılarak \(\mu=0.00001\), \(\rho=0.0001\) yapıldığında performans yeniden kötüleşmiştir. Kaynak bunu çok yüksek öğrenme oranının eğitim salınımı, çok düşük öğrenme oranının ise yavaş yakınsama yaratması bağlamında yorumlamaktadır. 2000 epoch’tan önce \(\mu=0.0001\), \(\rho=0.001\) ayarı yakınsama hızı ile performans arasında elverişli bir denge göstermiştir.
ITD3 Sonuçları Gerçek Havaalanı Saha Başarısını Kanıtlıyor mu?
Hayır. Çalışmanın ayrıntılı performans değerlendirmesi Python tabanlı ayrık-olay simülasyonlarından oluşur ve yazarlar gerçek havaalanı MAL sistemlerinde saha denemelerini gelecek çalışma olarak belirtir; bu nedenle raporlanan gecikme ve enerji avantajları gerçek operasyonel havaalanında doğrulanmış performans olarak genellenemez.
Çalışmanın desteklediği sonuçlar
Kaynak, tanımlanan simülasyon parametreleri ve karşılaştırma yöntemleri altında K-medoids + ITD3 yaklaşımının toplam gecikme ve toplam enerji tüketimi bakımından TAI, DDPG, PPO ve standart TD3’e göre daha elverişli performans verdiğini desteklemektedir.
Kaynak ayrıca ITD3 performansının yalnız tek bir öğrenme oranı değerine bağlı olmadığını; makul hiperparametre aralıklarında avantajların sürdüğünü bildirmektedir. Bununla birlikte “makul aralık” ve performans üstünlüğü bu çalışmanın tanımladığı simülasyon ortamı ile sınırlıdır.
Çalışmanın desteklemediği sonuçlar
Çalışma, gerçek havaalanında uçuş emniyetinin ölçülebilir biçimde arttığını, gerçek uçakların iniş süresinin azaldığını veya sistemin A-SMGCS Level IV ortamında operasyonel sertifikasyon kazandığını göstermemektedir.
Çalışma ayrıca gerçek havaalanı saha ağında ölçülmüş uçtan uca gecikme dağılımlarını, saha enerji tüketimini veya uzun dönemli donanım arızası davranışını raporlamamaktadır. Bu tür çıkarımlar simülasyon performansının ötesine geçer.
Kaynak içindeki “prototype” ifadesinin sınırı
Sonuç bölümünde yazarlar “MAL system prototype” üzerinde deneysel değerlendirme ve kapsamlı simülasyonlardan söz etmektedir. Bununla birlikte yöntem bölümünde ayrıntılı olarak belgelenen performans değerlendirmesi Python 3.12 tabanlı ayrık-olay simülasyonudur ve gerçek havaalanı MAL saha testleri gelecek araştırma olarak belirtilmektedir. Bu nedenle “prototype” ifadesi gerçek operasyonel havaalanında tamamlanmış saha doğrulamasıyla eşdeğer kabul edilmemelidir.
Yeniden üretilebilirlik sınırı
Kaynak simülasyon topolojisi, ana fiziksel parametreler, algoritma karşılaştırmaları, öğrenme oranları, replay buffer kapasitesi, batch size, soft-update oranı, ceza katsayısı, zaman dilimi ve tekrarlı koşu sayısı gibi çok sayıda yeniden üretilebilirlik parametresi sağlamaktadır.
Buna karşılık makalenin Data Availability Statement bölümünde altta yatan verilerin havaalanı operasyon verilerinin proprietary niteliği nedeniyle kamuya açılamayacağı belirtilmektedir. Bu durum bağımsız araştırmacının bütün veri girdilerini birebir yeniden kullanarak tam tekrar yapmasını sınırlar.
İstatistiksel yorum sınırı
Simülasyon sonuçları 10 bağımsız random seed koşusunun ortalaması üzerinden raporlanmıştır. Ancak karşılaştırma grafiklerinde güven aralığı, hata çubuğu, p değeri veya istatistiksel anlamlılık testi raporlanmamaktadır. Bu nedenle “ITD3 kesin olarak her koşulda üstündür” biçiminde evrensel bir istatistiksel sonuç çıkarılamaz.
Gelecek çalışma
Yazarlar gerçek havaalanı MAL sistemlerinde saha deneylerini, daha ileri uyarlanabilir makine öğrenmesi tekniklerini, yöntemin başka akıllı havaalanı uygulamalarına genişletilmesini, daha gelişmiş teşvik mekanizmalarını ve kaynak kısıtlı edge cihazları için hafif güvenlik çözümleriyle 5G URLLC entegrasyonunu gelecek çalışma konuları arasında göstermektedir.
Ayrıca DDPG ve PPO gibi diğer derin pekiştirmeli öğrenme yöntemlerinin de aynı K-medoids kümelendirme aşamasıyla birleştirildiğinde nasıl değişeceğinin araştırılması önerilmektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Edge-Based Intelligent Task Management for Mobile Airfield Lighting Control
Yazarlar: Li Jiang; Hong Wen; Wenjing Hou; Fan Sun
Yazışma yazarları: Hong Wen; Wenjing Hou
Kurumlar: School of Aeronautics and Astronautics, University of Electronic Science and Technology of China; Research and Development Centre, The Second Research Institute of CAAC; Sichuan Intelligent IoT Communication Technology Engineering Research Center, University of Electronic Science and Technology of China; Aircraft Swarm Intelligent Sensing and Cooperative Control Key Laboratory of Sichuan Province.
Dergi: Aerospace
Yayınevi: MDPI
Cilt / Sayı / Makale: 13 / 5 / 424
DOI: 10.3390/aerospace13050424
Tarihler: Alındı: 10 Mart 2026; revize edildi: 29 Nisan 2026; kabul edildi: 29 Nisan 2026; yayımlandı: 1 Mayıs 2026.
Kaynak türü: Hakemli araştırma makalesi; matematiksel sistem modelleme, derin pekiştirmeli öğrenme tabanlı optimizasyon ve ayrık-olay simülasyonu.
Lisans: Creative Commons Attribution (CC BY).
Ana sistem: Mobile Airfield Lighting (MAL) için cloud–edge–end görev yönetimi.
Ana optimizasyon yöntemi: K-medoids kaba tahsis + Improved Twin Delayed Deep Deterministic Policy Gradient (ITD3) hassas optimizasyon.
Karşılaştırılan yöntemler: TAI, DDPG, PPO, TD3 ve ITD3.
Simülasyon yazılımı: Python 3.12 tabanlı discrete-event simulator.
Hesaplama donanımı: Intel Core i9-10700K CPU ve NVIDIA RTX 4060 GPU.
Simülasyon ölçeği: 50–2000 ALN; EN sayısı N/25; 100 ms zaman dilimi; 3600 zaman dilimi / koşu; 10 bağımsız random seed.
Finansman: Sichuan Science and Technology Program, Grant 2024ZDZX0007; NSFC, Grants U23B2021 ve 62302082.
Veri erişilebilirliği: Makalenin altında yatan veriler, havaalanı operasyon verilerinin proprietary niteliği nedeniyle kamuya açık paylaşılmamaktadır.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını bildirmektedir.
Yazar katkıları: Kavramsallaştırma: Li Jiang, Hong Wen, Wenjing Hou. Yöntem: Li Jiang, Hong Wen, Wenjing Hou. Yazılım: Li Jiang, Wenjing Hou. Doğrulama: Hong Wen. Formal analiz ve araştırma: Fan Sun. Özgün taslak: Li Jiang, Fan Sun, Wenjing Hou. Gözden geçirme ve düzenleme: Hong Wen, Wenjing Hou.
Önemli kaynak içi notasyon sınırı: Denklem (18)’de kullanılan \(P_m\) sembolünün açıklaması, önceki enerji/haberleşme bölümündeki kullanımla tam olarak uyuşmamaktadır. Aynı şekilde kaynak Table 1, actor ve Q1 yapılarındaki 256/128/64 boyutlarını “2-layer FC” adı altında vermektedir. Verianla metni bu noktaları sessizce düzeltmemiş, özgün kaynak notasyonunu korumuştur.
Temel yöntemsel sınırlılık: Performans kanıtı esas olarak model ve simülasyon düzeyindedir. Gerçek havaalanı MAL saha denemeleri henüz bu çalışmanın ayrıntılı doğrulama seti içinde değildir ve yazarlar tarafından gelecek çalışma olarak belirtilmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir