

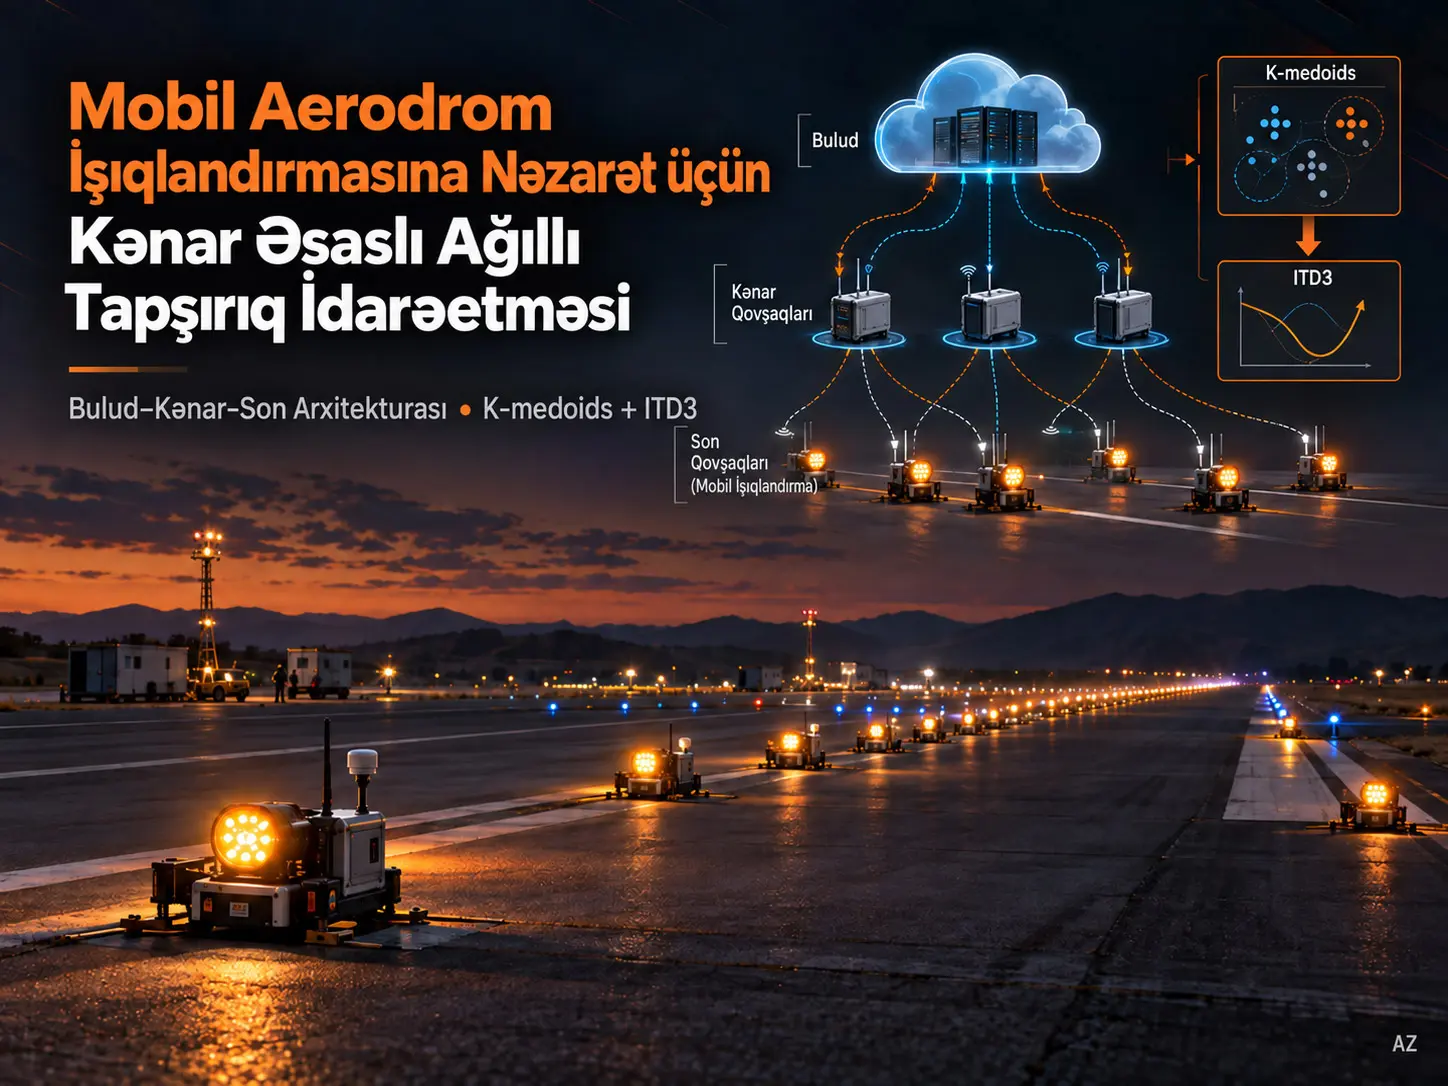
Bu tədqiqat mobil aerodrom işıqlandırma (Mobile Airfield Lighting, MAL) sistemlərində çoxsaylı aerodrom işıqlandırma qovşaqlarının hesablama, rabitə və enerji resurslarını real vaxta yaxın rejimdə idarə etmək üçün bulud–kənar–son (cloud–edge–end) əməkdaşlıqlı arxitektura və dərin möhkəmləndirici öyrənməyə əsaslanan optimallaşdırma üsulu hazırlayır. MAL sistemi müvəqqəti və ya mobil eniş sahələrində yanaşma, uçuş-enmə zolağı və taksi yolu işıqlarını ətraf mühit və əməliyyat şəraitinə uyğun idarə etməyə yönəlmiş paylanmış aerodrom işıqlandırma sistemidir. Tədqiqatçılar ümumi sistem gecikməsini və enerji sərfini birlikdə minimumlaşdıran məhdudiyyətli optimallaşdırma problemi müəyyən etmiş; həll üçün K-medoids ilə kobud resurs bölgüsünü Improved Twin Delayed Deep Deterministic Policy Gradient (ITD3) ilə dəqiq optimallaşdırma ilə birləşdirmişlər. Python 3.12 əsasında qurulmuş diskret-hadisə simulyasiyalarında 50–2000 aerodrom işıqlandırma qovşağı araşdırılmış və ITD3 müqayisə edilən TAI, DDPG, PPO və standart TD3 üsullarına nisbətən ümumi gecikmə və enerji sərfi baxımından daha əlverişli nəticələr vermişdir. Lakin bu nəticələr real fəaliyyətdə olan aerodromda aparılmış sahə doğrulaması deyil; real MAL sahə sınaqları tədqiqatda gələcək araşdırma istiqaməti kimi saxlanılmışdır.
Təklif olunan sistemin əsas ideyası bütün sensor məlumatlarını tək mərkəzə daşıyıb qərarı yalnız mərkəzdə vermək əvəzinə hesablamanı üç səviyyəyə paylamaqdır. İşıqlandırma qovşaqları yüksək tezlikli vəziyyət məlumatını toplayır və məhdud yerli əməliyyatlar yerinə yetirir; kənar qovşaqlar regional məlumat emalını, tapşırıqların planlaşdırılmasını və aşağı gecikməli qərarları üzərinə götürür; bulud isə uzunmüddətli məlumat emalı, model təlimi, qlobal optimallaşdırma və koordinasiya vəzifələrini həyata keçirir. Beləliklə, tədqiqat mobil aerodrom işıqlandırmasında gecikməni, enerji sərfini, kanal bölgüsünü və hesablama gücünü vahid optimallaşdırma çərçivəsində nəzərdən keçirir.
Mobil aerodrom işıqlandırma sistemində əsas problem
Aerodrom sahə işıqlandırması qalxma, yanaşma, enmə və taksi zamanı pilotların uçuş-enmə zolağının və taksi yolunun həndəsəsini, yanaşma oxunu və əməliyyat istiqamətləndirməsini vizual qavramasına kömək edir. Xüsusilə zəif görünüş şəraitində işıqlandırmanın əlçatanlığı, idarəetmə gecikməsi və düzgün işıq konfiqurasiyasının yaradılması əməliyyat baxımından kritik olur.
Ənənəvi aerodrom işıqlandırma sistemləri əsasən mərkəzləşdirilmiş və dövrə-əsaslı idarəetmə yanaşmasına söykənir. Lakin daha inkişaf etmiş A-SMGCS Level IV kimi ssenarilərdə minlərlə işığın hava gəmisinin hərəkəti ilə əlaqəli şəkildə dinamik idarə edilməsi tələb oluna bilər. Mənbə bildirir ki, belə halda saniyədə on minlərlə məlumat nöqtəsinə çata bilən məlumat toplama yükü və millisaniyə miqyasında idarəetmə tələbləri mərkəzləşdirilmiş “bütün məlumatı mərkəzə yüklə, qərarı mərkəzdə ver” yanaşmasını çətinləşdirir.
Mobil aerodrom işıqlandırması bu miqyaslana bilmə probleminə əlavə ölçü gətirir. MAL sistemləri daimi uçuş-enmə zolağı infrastrukturuna bağlı olmayan müvəqqəti və ya mobil istifadə sahələrində, ətraf mühit şəraitinə və xidmət göstərilən hava gəmisinə uyğun işıqlandırma konfiqurasiyasını uyğunlaşdırmağı hədəfləyir. Buna görə yalnız işıqları açıb-söndürmək kifayət deyil; çoxsaylı qovşaqların rabitəsi, hesablama yükləri, enerji büdcəsi və gecikmə tələbi birlikdə idarə edilməlidir.
Bulud–Kənar–Son Arxitekturası Mobil Aerodrom İşıqlandırmasında Niyə İstifadə Olunur?
Bulud–kənar–son arxitekturası gecikməyə həssas qərarları aerodrom işıqlandırma qovşaqlarına yaxın kənar resurslarda emal edərkən yüksək xərcli model təlimini və qlobal optimallaşdırmanı buluda həvalə etmək üçün istifadə olunur; bununla bütün məlumatların mərkəzi sistemə daşınmasından yaranan gecikmə, buraxılış zolağı və tək nasazlıq nöqtəsi təzyiqinin azaldılması məqsəd qoyulur.
Üç hesablama qatı
| Qat | Əsas komponentlər | Əsas vəzifə | Mənbədəki məhdudiyyət |
|---|---|---|---|
| End / Son | Aerodrom işıqları, yüngül hesablama vahidləri, sensorlar, rabitə radioları | Yüksək tezlikli vəziyyət məlumatının toplanması, əsas ilkin emal və məhdud köməkçi qərarlar | Hesablama və enerji resursları məhduddur. |
| Edge / Kənar | Birdən çox ALN ilə əlaqəli regional kənar qovşaqlar | Məlumat toplama, regional emal, hesablama, idarəetmə, yerli proqnoz və tapşırıq idarəetməsi | Çox geniş sahə üçün bir neçə kənar qovşaq tələb olunur. |
| Cloud / Bulud | Mərkəzləşdirilmiş bulud məlumat mərkəzi və xidmət komponentləri | Uzun dövrlü emal, məlumat idarəetməsi, mürəkkəb model təlimi, qlobal optimallaşdırma və koordinasiya | Gecikməyə həssas hər əməliyyat birbaşa buludda icra edilmir. |
Tədqiqatın təklif etdiyi bölgüdə kənar qovşaqlar yalnız rabitə ötürücüsü deyil. Onların hesablama və saxlama resursları var və əhatə dairələrindəki aerodrom işıqlandırma qovşaqlarının məlumatlarını emal edə bilirlər. Bulud isə bütün şəbəkənin daha uzun zaman miqyasındakı birgə optimallaşdırılmasını və model təlimini öz üzərinə götürür.
Rabitə modelinin ilk addımı: yol itkisi
Mənbə istinad məsafəsində sərbəst fəza yol itkisini Tənlik (1) ilə müəyyən edir:
\[ L(d_0)=\left(\frac{4\pi d_0 f}{c_v}\right)^2 \]
Burada \(d_0\) istinad məsafəsidir və mənbə bunun adətən 1 m olduğunu bildirir. \(f\) daşıyıcı tezlik, \(c_v\) isə işıq sürətidir. Bu tənlik rabitə bağlantısında tezlik və məsafənin əsas sərbəst fəza itkisinə necə daxil olduğunu müəyyən edir. Tezlik yüksəldikdə, digər şərtlər eyni qalarsa, bu termin kvadratik şəkildə böyüyür.
ALN ilə kənar qovşaq arasındakı məsafə
n-ci aerodrom işıqlandırma qovşağı ilə m-ci kənar qovşağın məsafəsi Tənlik (2) ilə verilir:
\[ d_{n,m}=\sqrt{H^2+(x_m-x_n)^2+(y_m-y_n)^2} \]
\(x_n,y_n\) və \(x_m,y_m\) üfüqi koordinatları, \(H\) isə həndəsi məsafəyə daxil olan hündürlük komponentini təmsil edir. Tənlik qovşaqlar arasındakı üçölçülü həndəsi ayrılığı kanal modelinə daxil edir.
Rayleigh fading şəraitində kanal qazancı
Mənbə kanal qazancını Tənlik (3) ilə müəyyən edir:
\[ g_{n,m}=\frac{1}{L(d_0)} \left(\frac{d_0}{d_{n,m}}\right)^\beta h \]
\(\beta\) yol itkisi üstüdür və mənbə sərbəst fəza üçün tipik olaraq 2 dəyərini göstərir. \(h\) çoxyollu yayılmanın siqnal amplitudasına təsadüfi təsirini təmsil edən Rayleigh paylanmalı termindir. Buna görə qovşaqlar arasındakı rabitə keyfiyyəti yalnız həndəsi məsafədən deyil, fading təsirindən də asılıdır.
Siqnal-küy-maneə nisbəti
n-ci ALN-nin c alt kanalında m-ci kənar qovşağa bağlantısı üçün SNR Tənlik (4)-də belədir:
\[ \mathrm{SNR}_{n,m,c} = \frac{P_{n,c}g_{n,m}} {\sigma^2+\sum_{n'\neq n}P_{n',c}g_{n',m}} \]
\(P_{n,c}\), n-ci ALN-nin c alt kanalındakı ötürmə gücüdür. \(\sigma^2\) küy gücünü, cəm termini isə eyni alt kanalda digər ALN-lərin yaratdığı maneəni təmsil edir. Surətdəki faydalı qəbul edilmiş güc artdıqca SNR yüksəlir, küy və ya ortaq kanal maneəsi artdıqca isə SNR azalır.
Rabitə sürəti
Mənbə Shannon münasibətindən çıxış edərək ALN–EN rabitə sürətini Tənlik (5) ilə verir:
\[ R_{n,m} = B\sum_{c=1}^{C}\log_2 \left(1+\mathrm{SNR}_{n,m,c}\right) \]
\(B\) simsiz kanalın buraxılış zolağı, \(C\) alt kanal sayıdır. Bu dəyər sonrakı yükləmə gecikməsi hesablamalarının birbaşa girişidir. Eyni məlumat ölçüsündə \(R_{n,m}\) böyüdükcə məlumat ötürmə müddəti azalır.
Yerli hesablama gecikməsi
n-ci ALN-nin yerli ilkin emal gecikməsi:
\[ T_n^{local} = \frac{D_n C_n}{cf_n} \]
şəklindədir. \(D_n\) emal ediləcək məlumat miqdarını, \(C_n\) hər məlumat nümunəsinə düşən hesablama yükünü, \(cf_n\) isə ALN-nin yerli hesablama gücünü təmsil edir. Məlumat və emal yükü artdıqca gecikmə artır, hesablama gücü artdıqca isə gecikmə azalır.
ALN-dən kənar qovşağa məlumat yükləmə müddəti
\[ T_{n,m}^{up} = \frac{|w_n|}{R_{n,m}} \]
Burada \(|w_n|\) yüklənən parametr məlumatının ölçüsüdür. Rabitə sürəti eyni məlumat miqdarı üçün iki dəfə artsa, bu yükləmə gecikməsinin riyazi olaraq yarıya enməsi gözlənilir.
Bir ALN üçün ümumi gecikmə və enerji
\[ T_n=T_n^{local}+T_{n,m}^{up} \]
\[ E_n= \kappa cf_n^3T_n^{local} + P_{n,c}T_{n,m}^{up} \]
Enerji modelinin birinci termini yerli hesablama, ikinci termini simsiz ötürmə xərcini təmsil edir. Emal tezliyinin kubu ilə gələn \(cf_n^3\) termini hesablama sürətini artırmağın enerji baxımından qeyri-xətti xərc yaratdığını göstərir. Bu əlaqə tədqiqatın niyə yalnız gecikməni azaltmaq əvəzinə gecikmə ilə enerjini birlikdə optimallaşdırdığını izah edən riyazi nüvədir.
Kənar hesablama xərci
m-ci kənar qovşağın yerli parametr tapşırığını emal etməsi üçün mənbə:
\[ T_{m,k}^{com} = \sum_{n=1}^{N} \alpha_{n,m} \frac{|w_n|c_m}{cf_m} \]
\[ E_{m,k}^{com} = \kappa cf_m^3T_{m,k}^{com} \]
tənliklərindən istifadə edir. \(\alpha_{n,m}\), n-ci ALN-nin m-ci kənar qovşağı seçib-seçmədiyini müəyyən edən ikili dəyişəndir. \(c_m\) kənar qovşağın hər bitə düşən emal yükü, \(cf_m\) isə kənar hesablama gücüdür.
Kənardan buluda yükləmə
\[ T_{m,k}^{up} = \frac{|w_m|}{R_{m,L}} \]
\[ E_{m,k}^{up} = P_m T_{m,k}^{up} \]
\(|w_m|\), m-ci kənar qovşağın buluda ötürdüyü məlumatın ölçüsüdür; \(R_{m,L}\) kənar–bulud rabitə sürəti, \(P_m\) isə bu bağlantı üçün istifadə olunan ötürmə gücüdür.
Bulud hesablama gecikməsi
Mənbə bulud emal müddətini Tənlik (11) ilə verir:
\[ T_{L,k_L}^{com} = \sum_{m=1}^{M} \frac{|w_m|c_L}{cf_L} \]
\(c_L\) buludun hər bitə düşən hesablama yükünü, \(cf_L\) isə bulud emal gücünü ifadə edir. Mənbəyə görə kənar gücü tapşırığı qarşılaya bilirsə, bulud dəstəyi istifadə olunmaya bilər və uyğun bulud hesablama gecikməsi sıfır qəbul edilir.
Nəticələrin buluddan geri paylanması
Mənbədə bulud → kənar → ALN geri paylanması üçün Tənlik (12) və (13) istifadə olunur:
\[ T_{L,k_L}^{down} = \max_{m=1,2,\ldots,M} \left( \frac{|w_L|}{R_{L,m}} + \sum_{n=1}^{N} \alpha_{m,n} \frac{|w_L|}{R_{m,n}} \right) \]
\[ T_{m,k}^{down} = \sum_{n=1}^{N} \alpha_{m,n} \frac{|w_L|}{R_{m,n}} \]
Mənbə bu bölmədə \(L\) simvolunu bulud üçün istifadə edərkən \(|w_L|\) ifadəsini “L-th EN” məlumat ölçüsü kimi izah edir. Bu ifadə əvvəlki simvol tərifləri ilə tam uyğun görünmədiyi üçün Verianla mətni notasiyanı səssizcə dəyişdirməmişdir.
Ümumi sistem gecikməsi
ALN, kənar və bulud emal/ötürmə komponentləri birləşdirilərək ümumi gecikmə Tənlik (14a)-da formalaşdırılır:
\[ T^{all} = \max_{m\in\{1,2,\ldots,M\}} \left[ \sum_{n\in N_m} \left( T_n^{local}+T_{n,m}^{up} \right) + \left( T_{m,k}^{com} + T_{m,k}^{up} + T_{m,k}^{down} \right) \right] + \left( T_{L,k_L}^{com} + T_{L,k_L}^{down} \right) \]
Buradakı maksimum operatoru paralel kənar bölgələri daxilində ümumi sistem cavabının ən yavaş kritik yol ilə məhdudlaşdırılması ideyasını ifadə edir.
Mənbə ümumi enerji üçün Tənlik (14b)-ni aşağıdakı notasiya ilə verir:
\[ E^{all} = \sum_{n=1}^{N}E_n + \sum_{i=1}^{M}E_{i,n}^{all} \]
İkinci cəmdəki \(E_{i,n}^{all}\) simvolu mənbə mətnində ayrıca ətraflı şəkildə yenidən müəyyən edilmədiyi üçün burada başqa simvolla əvəz edilməmişdir.
Gecikmə və enerji niyə birlikdə optimallaşdırılır?
Yalnız gecikmənin azaldılması hesablama tezliyini və ya ötürmə gücünü artıraraq enerji xərcini yüksəldə bilər. Yalnız enerjinin azaldılması isə emal və məlumat ötürməsini ləngidərək real vaxt idarəetmə tələbinin aşılmasına səbəb ola bilər. Tədqiqat buna görə iki hədəfi çəkili vahid məqsəd funksiyasında birləşdirir.
\[ P1: \min_{\alpha_{m,n},cf_i} \lambda_1T^{all}(\alpha_{m,n},f_i) + \lambda_2E^{all}(\alpha_{m,n},cf_i) \]
Mənbədə gecikmə terminində \(f_i\), enerji terminində isə \(cf_i\) notasiyası istifadə olunmuşdur; Verianla nüvəsi bu notasiya fərqini səssizcə bərabərləşdirmir.
Məhdudiyyətlər Tənlik (16)-da belə müəyyən edilmişdir:
\[ C1: T_n(\alpha_{m,n},cf_i)\le T_{max} \]
\[ C2: E^{all}\le E_{max} \]
\[ C3: \sum_{n=1}^{N}\phi_{n,c}\le1 \]
\[ C4: 0<cf_i\le f_{max} \]
C1 hər qovşağın icazə verilən maksimum gecikməni aşmasının qarşısını alır. C2 ümumi enerji büdcəsini məhdudlaşdırır. C3 bir alt kanalın eyni vaxtda birdən çox ALN tərəfindən tutulmamasını məcburi edir. C4 isə kənar/bulud emal resursunun fiziki gücü aşmasına imkan vermir.
K-Medoids və ITD3 Birlikdə Necə İşləyir?
K-medoids əvvəlcə çoxsaylı aerodrom işıqlandırma qovşaqlarını gecikmə xərcinə görə kənar qovşaqlara kobud şəkildə qruplaşdıraraq axtarış fəzasını kiçildir; ITD3 daha sonra bu ilkin bölgü üzərində qovşaq seçimini, kanal bölgüsünü və davamlı resurs dəyişənlərini məhdudiyyətlər daxilində daha dəqiq optimallaşdırır.
K-medoids ilə kobud ALN–EN bölgüsü
Mənbə ALN–EN ucdan-uca gecikmə/xərc məlumatını klasterləşdirmə xüsusiyyəti kimi istifadə edir. Proses beş əsas addımdan ibarətdir: əvvəlcə M ədəd ALN medoid namizədi seçilir; bütün ALN-lər ən aşağı gecikmə xərci olan klasterə təyin edilir; hər klasterdə mərkəz yenidən hesablanır və gecikmə məhdudiyyətini ödəməyən namizədlər çıxarılır; mərkəzlər dəyişməyənədək və ya klasterdaxili məsafə dəyişməsi hədd dəyərindən aşağı düşənədək proses təkrarlanır; sonda ITD3 üçün ilkin kanal/qovşaq bölgü matrisi əldə edilir.
K-medoids mərhələsinin vəzifəsi yekun optimumu təkbaşına tapmaq deyil. Əsas funksiyası minlərlə qovşağın olduğu halda ITD3-ün incə optimallaşdırmaya başlayacağı problem fəzasını daha idarəolunan etməkdir.
ITD3 vəziyyət fəzası
Mənbənin vəziyyət vektoru Tənlik (17)-də belədir:
\[ S= \{ cf_m, cf_n, P_{n,c}, R_{n,m}, T_n, E_n, E_m^{rem} \} \]
Vəziyyət; kənar və ALN emal gücü, ötürmə gücü, rabitə sürəti, tək qovşaq gecikməsi, ALN enerji sərfi və kənar qovşaqda qalan enerji kimi dinamik dəyişənləri ehtiva edir. Bütün vəziyyət dəyişənləri sinir şəbəkəsi təlimində miqyas fərqinin təsirini azaltmaq üçün [0,1] intervalına normallaşdırılır.
ITD3 hərəkət fəzası
Mənbə Tənlik (18)-də hərəkət fəzasını belə verir:
\[ A= \{ \alpha_{m,n}, \phi_{m,c}, P_m \} \]
\(\alpha_{m,n}\) parametrlərin hansı kənar qovşağa yüklənəcəyinə dair ikili seçimi, \(\phi_{m,c}\) isə kanal bölgüsünü təmsil edir. Mənbə mətni \(P_m\)-ni bu nöqtədə tapşırıqlara görə hesablama resurslarının proporsional bölgüsü kimi izah edir. Lakin əvvəlki rabitə/enerji modelində \(P_m\) kənar qovşağın ötürmə gücü kimi istifadə edilmişdir. Mənbədaxili bu simvol qeyri-müəyyənliyi qorunmalı və başqa təriflə səssizcə aradan qaldırılmamalıdır.
Mükafat funksiyası
ITD3 agenti gecikmə və enerji dəyərlərini birbaşa azaltmaq əvəzinə onların mənfi çəkili dəyərini və məhdudiyyət pozuntularını ehtiva edən mükafatı maksimumlaşdırır:
\[ r(S,A) = -\lambda_1\frac{T^{all}(S,A)}{T_{max}} -\lambda_2\frac{E^{all}(S,A)}{E_{max}} -\gamma\sum_{k=1}^{4}Pen_k(S,A) \]
Cəza terminləri mənbədə:
\[ Pen_1=1 \text{ eğer } T_n>T_{max}, \text{ aksi halde } 0 \]
\[ Pen_2=1 \text{ eğer } E^{all}>E_{max}, \text{ aksi halde } 0 \]
\[ Pen_3=1 \text{ eğer } \sum_n\phi_{n,c}>1, \text{ aksi halde } 0 \]
\[ Pen_4=1 \text{ eğer } f_i>f_{max}, \text{ aksi halde } 0 \]
şəklindədir. İstifadə edilən cəza əmsalının təklif olunan dəyəri \(\gamma=10\)-dur. Beləliklə, məhdudiyyəti pozan hərəkətlərin mükafatı azaldılaraq agentin yalnız aşağı gecikməli deyil, həm də tətbiq oluna bilən həllərə üstünlük verməsi məqsəd qoyulur.
Standart TD3 üzərində edilən üç əsas dəyişiklik
| Təkmilləşdirmə | Texniki mexanizm | Məqsəd |
|---|---|---|
| İki qollu actor | Davamlı və diskret hərəkətlərin ayrı qollardan yaradılması; diskret qolda Gumbel-Softmax və 0,5 sərt hədd | Qarışıq diskret–davamlı hərəkət fəzasını öyrədə bilmək |
| Məhdudiyyət-fərqində olan critic | Məhdudiyyəti pozan hərəkətlərin Q-dəyərlərinin aşağı salınması | Mükafat cəzasına əlavə ikinci tətbiqolunma mexanizmi yaratmaq |
| Prioritized Experience Replay | Nümunələrin TD-səhvinə görə prioritetləşdirilməsi və ISW ilə nümunə götürmə qərəzinin düzəldilməsi | Məlumat dəyəri yüksək təcrübələrdən daha səmərəli öyrənmək və yaxınlaşmanı sürətləndirmək |
Actor və critic şəbəkələri
| Şəbəkə | Mənbədə verilən quruluş | Aktivləşdirmə | Optimizer |
|---|---|---|---|
| Actor | State S → “2-layer FC(256,128,64)” → iki qol, davamlı + diskret | ReLU + Tanh / Softmax | Adam |
| Critic Q1 | [S,A] → “2-layer FC(256,128,64)” → 1D Q-value | ReLU + Linear | Adam |
| Critic Q2 | [S,A] → “2-layer FC(256,128)” → 1D Q-value | ReLU + Linear | Adam |
Mənbə cədvəli actor və Q1 üçün üç ölçü dəyəri \(256,128,64\) versə də, quruluşu “2-layer FC” adlandırır. Burada arxitekturanı mənbədə yazılmayan qat şərhi ilə dəyişmək əvəzinə özgün göstəriliş qorunmuşdur.
Aktivləşdirmə funksiyaları
ReLU:
\[ \operatorname{ReLU}(x)=\max(0,x) \]
Tanh:
\[ \tanh(x) = \frac{e^x-e^{-x}} {e^x+e^{-x}} \]
Softmax:
\[ \operatorname{Softmax}(x_i) = \frac{e^{x_i}} {\sum_{j=1}^{n}e^{x_j}} \]
Tanh davamlı actor çıxışında, Softmax isə diskret kanal bölgüsü qolunda istifadə olunur. Adam optimizer şəbəkə çəkilərinin yenilənməsində istifadə edilir.
ITD3 təlim dövrü
Təlim actor, target actor, iki critic və onların target şəbəkələrinin başladılması ilə başlayır. Prioritized Experience Replay buferinin tutumu \(10^6\) olaraq müəyyən edilmişdir. Actor mövcud vəziyyətdə hərəkət yaradır və kəşfiyyat üçün Gaussian küy əlavə olunur; kəşfiyyat küyü təlim irəlilədikcə 0,1-dən 0,01-ə endirilir.
Hər qarşılıqlı təsirdən \((S,A',r,S')\) təcrübəsi replay buffer-a yazılır. Təlim zamanı 64 və ya 128 nümunəlik batch-lər prioritetə görə seçilir və Importance Sampling Weights ilə priority sampling-dən yaranan qərəz düzəldilir. Target critic üçün iki Q proqnozunun minimumu istifadə edilərək TD3-ün həddindən artıq qiymətləndirmə meyli azaldılır.
Critic şəbəkələri hədəf Q-dəyərinə görə orta kvadratik xətaya bənzər itkilərlə yenilənir; actor isə:
\[ L_\pi=-E[Q_1(S,\pi(S))] \]
siyasət itkisini azaltmaqla yenilənir.
Target şəbəkələrin yumşaq yenilənməsində \(\tau=0.005\) istifadə olunur:
\[ \theta_{\pi_{target}} \leftarrow \tau\theta_\pi + (1-\tau)\theta_{\pi_{target}} \]
\[ \theta_{Q_{target}} \leftarrow \tau\theta_Q + (1-\tau)\theta_{Q_{target}} \]
Mükafat funksiyasının hərəkətli ortalaması 500 ardıcıl addım ərzində yaxşılaşmırsa və ya maksimum təlim addımı sayına çatılırsa, təlim dayandırılır.
Tədqiqatın Metodu və Nəticələri
Simulyasiya Hansı Şəraitdə Aparılıb?
Performans qiymətləndirilməsi Python 3.12 ilə hazırlanmış diskret-hadisə simulyatorunda, 50-dən 2000-ə qədər aerodrom işıqlandırma qovşağı və N/25 nisbətində kənar qovşaq istifadə edilməklə aparılmışdır; hər şərait 100 ms-lik 3600 zaman dilimini əhatə edən 6 dəqiqəlik simulyasiya və 10 müstəqil təsadüfi toxum üzrə qiymətləndirilmişdir.
| Parametr | Dəyər |
|---|---|
| ALN sayı \(N\) | 50 / 100 / 500 / 1000 / 2000 |
| EN sayı \(M\) | \(N/25\) |
| EN hesablama gücü \(cf_m\) | [3, 4] GHz |
| ALN hesablama gücü \(cf_n\) | [0,5, 2,5] GHz |
| ALN ötürmə gücü \(P_{n,c}\) | [0,5, 5] W |
| Simsiz kanal buraxılış zolağı \(B\) | 2 MHz |
| Küy gücü \(\sigma^2\) | −50 dBm |
| Təlim məlumatının ölçüsü \(D_n\) | [0,1, 2] MB |
| Yükləmə məlumatının ölçüsü \(|w|\) | [0,1, 2] MB |
\(M=N/25\) qaydasına görə araşdırılan beş ALN miqyası müvafiq olaraq 2, 4, 20, 40 və 80 kənar qovşağa uyğun gəlir. Bu dəyər mənbə parametrizasiyasının birbaşa riyazi nəticəsidir; ayrıca eksperiment nəticəsi deyil.
ITD3 təlim parametrləri
| Modul | Parametr | Təklif olunan dəyər |
|---|---|---|
| K-medoids | Klaster sayı K | EN sayı M |
| K-medoids | Yaxınlaşma həddi | \(10^{-3}\) |
| ITD3 | Batch size | 64 / 128 |
| ITD3 | Gizli qat ölçüsü | 256 / 128 |
| ITD3 | Actor öyrənmə sürəti \(\mu\) | \(10^{-3}\) – \(10^{-5}\) |
| ITD3 | Critic öyrənmə sürəti \(\rho\) | \(10^{-2}\) – \(10^{-4}\) |
| ITD3 | Discount factor | 0,95 – 0,99 |
| ITD3 | Soft update rate | 0,005 |
| ITD3 | Exploration noise std | 0,1 → 0,01 |
| ITD3 | Replay buffer tutumu | \(10^6\) |
| Mükafat | Cəza əmsalı \(\gamma\) | 10 |
| Mükafat | \(\lambda_1/\lambda_2\) | 0,7 / 0,3 |
Mənbə MAL real vaxt idarəetməsi baxımından aşağı gecikmənin prioritet olması səbəbindən \(\lambda_1=0.7\), \(\lambda_2=0.3\) seçmişdir. Bu kombinasiya 0,5/0,5; 0,6/0,4; 0,7/0,3 və 0,8/0,2 variantları arasında tədqiqat çərçivəsində ən uyğun gecikmə–enerji balansını vermişdir.
Simulyasiya müddəti və təkrarlar
Hər zaman dilimi \(\Delta t=100\) ms-dir. Bir gediş \(T=3600\) zaman dilimi davam edir; bu, 360 saniyə və ya 6 dəqiqə simulyasiya edilmiş sistem vaxtına uyğun gəlir. Nəticələr müxtəlif random seed-lərlə aparılmış 10 müstəqil işin ortalamasıdır.
Simulyasiya və təlim Intel Core i9-10700K CPU, NVIDIA RTX 4060 GPU və Python 3.12 istifadə olunan platformada icra edilmişdir.
Müqayisə edilən alqoritmlər
| Üsul | Rol |
|---|---|
| TAI | Ənənəvi alternating iteration yanaşması |
| DDPG | Deep Deterministic Policy Gradient |
| PPO | Proximal Policy Optimization |
| TD3 | Standart Twin Delayed Deep Deterministic Policy Gradient |
| ITD3 | K-medoids ilə birlikdə istifadə olunan tədqiqatın təkmilləşdirilmiş TD3 üsulu |
Təlim irəlilədikcə gecikmə və enerji
Mənbə Şəkil 5-də təlim epoch-u artdıqca ümumi gecikmə və ümumi enerji sərfini müqayisə edir. ITD3 əyrisi müqayisə edilən alqoritmlər arasında daha aşağı sabit gecikmə və enerji bölgəsinə çatır. Mənbə həmçinin təxminən 2000 təlim epoch-undan sonra bütün üsullarda əlavə yaxşılaşmanın kiçik olduğunu bildirir.
Qrafik xam ədədi nöqtələri cədvəl şəklində vermədiyi üçün Verianla mətni Şəkil 5-dən gözlə oxunmuş dəqiq faizlər və ya həssas performans fərqləri yaratmır. Mənbənin birbaşa dəstəklədiyi nəticə alqoritmlərin nisbi meyli və ITD3-ün bu simulyasiya şəraitində üstün performansıdır.
Qovşaq sayı artdıqda nə baş verir?
Şəkil 6-da \(N=50,100,500,1000,2000\) üçün ITD3 davranışı müqayisə edilir. ALN sayı artdıqca həm ümumi gecikmə, həm də ümumi enerji sərfi artır. Mənbə bunu daha çox qovşağın təlim və emal prosesinə qoşulmasının yerli hesablama müddətini və enerji sərfini artırması ilə izah edir.
Bu nəticə üsulun miqyaslana bilən olması iddiasının “qovşaq sayı artdıqca xərc dəyişmir” mənasına gəlmədiyini göstərir. ITD3 böyük problem ölçülərində müqayisəli üstünlük təqdim etsə də, fiziki və hesablama yükü yenə artır.
Öyrənmə sürətinin təsiri
Mənbə Şəkil 7-də actor öyrənmə sürəti \(\mu\) ilə critic öyrənmə sürəti \(\rho\)-nu birlikdə dəyişmişdir. Başlanğıcdakı \(\mu=0.001\) və \(\rho=0.01\) səviyyələrindən daha kiçik dəyərlərə keçdikdə gecikmə və enerji baxımından yaxşılaşma görülür.
\(\mu=0.000025\) və \(\rho=0.00025\) kombinasiyası erkən mərhələdə daha yavaş yaxınlaşır, lakin 2000 epoch-dan sonra mənbə tərəfindən ən yaxşı sabit ümumi gecikmə və enerji dəyərlərini verən parametr kimi təsvir edilir.
Öyrənmə sürətləri daha da azaldılaraq \(\mu=0.00001\), \(\rho=0.0001\) edildikdə performans yenidən pisləşmişdir. Mənbə bunu çox yüksək öyrənmə sürətinin təlim salınımı, çox aşağı öyrənmə sürətinin isə yavaş yaxınlaşma yaratması kontekstində şərh edir. 2000 epoch-dan əvvəl \(\mu=0.0001\), \(\rho=0.001\) parametri yaxınlaşma sürəti ilə performans arasında əlverişli balans göstərmişdir.
ITD3 Nəticələri Real Aerodrom Sahə Uğurunu Sübut Edirmi?
Xeyr. Tədqiqatın ətraflı performans qiymətləndirilməsi Python əsaslı diskret-hadisə simulyasiyalarından ibarətdir və müəlliflər real aerodrom MAL sistemlərində sahə sınaqlarını gələcək iş kimi göstərirlər; buna görə bildirilən gecikmə və enerji üstünlükləri real əməliyyat aerodromunda doğrulanmış performans kimi ümumiləşdirilə bilməz.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə müəyyən edilmiş simulyasiya parametrləri və müqayisə üsulları altında K-medoids + ITD3 yanaşmasının ümumi gecikmə və ümumi enerji sərfi baxımından TAI, DDPG, PPO və standart TD3-ə nisbətən daha əlverişli performans verdiyini dəstəkləyir.
Mənbə həmçinin ITD3 performansının yalnız bir öyrənmə sürəti dəyərindən asılı olmadığını; məqbul hiperparametr aralıqlarında üstünlüklərin davam etdiyini bildirir. Bununla belə, “məqbul aralıq” və performans üstünlüyü bu tədqiqatın müəyyən etdiyi simulyasiya mühiti ilə məhdudlaşır.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat real aerodromda uçuş təhlükəsizliyinin ölçülə bilən şəkildə artdığını, real hava gəmilərinin enmə vaxtının azaldığını və ya sistemin A-SMGCS Level IV mühitində əməliyyat sertifikatı qazandığını göstərmir.
Tədqiqat həmçinin real aerodrom sahə şəbəkəsində ölçülmüş ucdan-uca gecikmə paylanmalarını, sahə enerji sərfini və ya uzunmüddətli avadanlıq nasazlığı davranışını bildirmir. Belə nəticələr simulyasiya performansından kənara çıxır.
Mənbədəki “prototype” ifadəsinin həddi
Nəticə bölməsində müəlliflər “MAL system prototype” üzərində eksperimental qiymətləndirmə və geniş simulyasiyalardan bəhs edirlər. Bununla belə, metod bölməsində ətraflı sənədləşdirilən performans qiymətləndirilməsi Python 3.12 əsaslı diskret-hadisə simulyasiyasıdır və real aerodrom MAL sahə sınaqları gələcək tədqiqat kimi göstərilir. Buna görə “prototype” ifadəsi real əməliyyat aerodromunda tamamlanmış sahə doğrulaması ilə eyni qəbul edilməməlidir.
Təkrar istehsal oluna bilmə həddi
Mənbə simulyasiya topologiyası, əsas fiziki parametrlər, alqoritm müqayisələri, öyrənmə sürətləri, replay buffer tutumu, batch size, soft-update sürəti, cəza əmsalı, zaman dilimi və təkrarlanan gedişlərin sayı kimi çoxsaylı təkrar istehsal oluna bilmə parametrləri təqdim edir.
Bunun əksinə, məqalənin Data Availability Statement bölməsində əsas məlumatların aerodrom əməliyyat məlumatlarının proprietary xarakterinə görə ictimaiyyətə açıqlana bilmədiyi bildirilir. Bu vəziyyət müstəqil tədqiqatçının bütün məlumat girişlərini eynilə yenidən istifadə edərək tam təkrar aparmasını məhdudlaşdırır.
Statistik şərh həddi
Simulyasiya nəticələri 10 müstəqil random seed gedişinin ortalaması əsasında bildirilmişdir. Lakin müqayisə qrafiklərində etibar intervalı, xəta çubuğu, p dəyəri və ya statistik əhəmiyyətlilik testi göstərilmir. Buna görə “ITD3 hər şəraitdə qəti şəkildə üstündür” şəklində universal statistik nəticə çıxarıla bilməz.
Gələcək iş
Müəlliflər real aerodrom MAL sistemlərində sahə sınaqlarını, daha inkişaf etmiş uyğunlaşan maşın öyrənməsi üsullarını, metodun digər ağıllı aerodrom tətbiqlərinə genişləndirilməsini, daha inkişaf etmiş təşviq mexanizmlərini və resursları məhdud kənar cihazlar üçün yüngül təhlükəsizlik həlləri ilə 5G URLLC inteqrasiyasını gələcək tədqiqat mövzuları kimi göstərirlər.
Bundan əlavə, DDPG və PPO kimi digər dərin möhkəmləndirici öyrənmə üsullarının eyni K-medoids klasterləşdirmə mərhələsi ilə birləşdirildikdə necə dəyişəcəyinin araşdırılması təklif olunur.
Mənbə və Metod Qeydi
Özgün başlıq: Edge-Based Intelligent Task Management for Mobile Airfield Lighting Control
Müəlliflər: Li Jiang; Hong Wen; Wenjing Hou; Fan Sun
Yazışma müəllifləri: Hong Wen; Wenjing Hou
Qurumlar: School of Aeronautics and Astronautics, University of Electronic Science and Technology of China; Research and Development Centre, The Second Research Institute of CAAC; Sichuan Intelligent IoT Communication Technology Engineering Research Center, University of Electronic Science and Technology of China; Aircraft Swarm Intelligent Sensing and Cooperative Control Key Laboratory of Sichuan Province.
Jurnal: Aerospace
Nəşriyyat: MDPI
Cild / Say / Məqalə: 13 / 5 / 424
DOI: 10.3390/aerospace13050424
Tarixlər: Alınıb: 10 Mart 2026; yenidən işlənib: 29 Aprel 2026; qəbul edilib: 29 Aprel 2026; dərc edilib: 1 May 2026.
Mənbə növü: Hakemli tədqiqat məqaləsi; riyazi sistem modelləşdirməsi, dərin möhkəmləndirici öyrənmə əsaslı optimallaşdırma və diskret-hadisə simulyasiyası.
Lisenziya: Creative Commons Attribution (CC BY).
Əsas sistem: Mobile Airfield Lighting (MAL) üçün cloud–edge–end tapşırıq idarəetməsi.
Əsas optimallaşdırma üsulu: K-medoids kobud bölgü + Improved Twin Delayed Deep Deterministic Policy Gradient (ITD3) dəqiq optimallaşdırma.
Müqayisə edilən üsullar: TAI, DDPG, PPO, TD3 və ITD3.
Simulyasiya proqramı: Python 3.12 əsaslı discrete-event simulator.
Hesablama avadanlığı: Intel Core i9-10700K CPU və NVIDIA RTX 4060 GPU.
Simulyasiya miqyası: 50–2000 ALN; EN sayı N/25; 100 ms zaman dilimi; 3600 zaman dilimi / gediş; 10 müstəqil random seed.
Maliyyələşdirmə: Sichuan Science and Technology Program, Grant 2024ZDZX0007; NSFC, Grants U23B2021 və 62302082.
Məlumatların əlçatanlığı: Məqalənin əsaslandığı məlumatlar aerodrom əməliyyat məlumatlarının proprietary xarakterinə görə ictimai şəkildə paylaşılmır.
Maraqların toqquşması: Müəlliflər maraqların toqquşmasının olmadığını bildirirlər.
Müəllif töhfələri: Konseptuallaşdırma: Li Jiang, Hong Wen, Wenjing Hou. Metod: Li Jiang, Hong Wen, Wenjing Hou. Proqram təminatı: Li Jiang, Wenjing Hou. Doğrulama: Hong Wen. Formal analiz və tədqiqat: Fan Sun. İlkin mətn: Li Jiang, Fan Sun, Wenjing Hou. Nəzərdən keçirmə və redaktə: Hong Wen, Wenjing Hou.
Mənbədaxili mühüm notasiya məhdudiyyəti: Tənlik (18)-də istifadə olunan \(P_m\) simvolunun izahı əvvəlki enerji/rabitə bölməsindəki istifadə ilə tam uyğun gəlmir. Eyni şəkildə, mənbə Table 1 actor və Q1 strukturlarındakı 256/128/64 ölçülərini “2-layer FC” adı altında verir. Verianla mətni bu məqamları səssizcə düzəltməmiş, özgün mənbə notasiyasını qorumuşdur.
Əsas metodoloji məhdudiyyət: Performans sübutu əsasən model və simulyasiya səviyyəsindədir. Real aerodrom MAL sahə sınaqları hələ bu tədqiqatın ətraflı doğrulama dəstinə daxil deyil və müəlliflər tərəfindən gələcək iş kimi göstərilmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib