

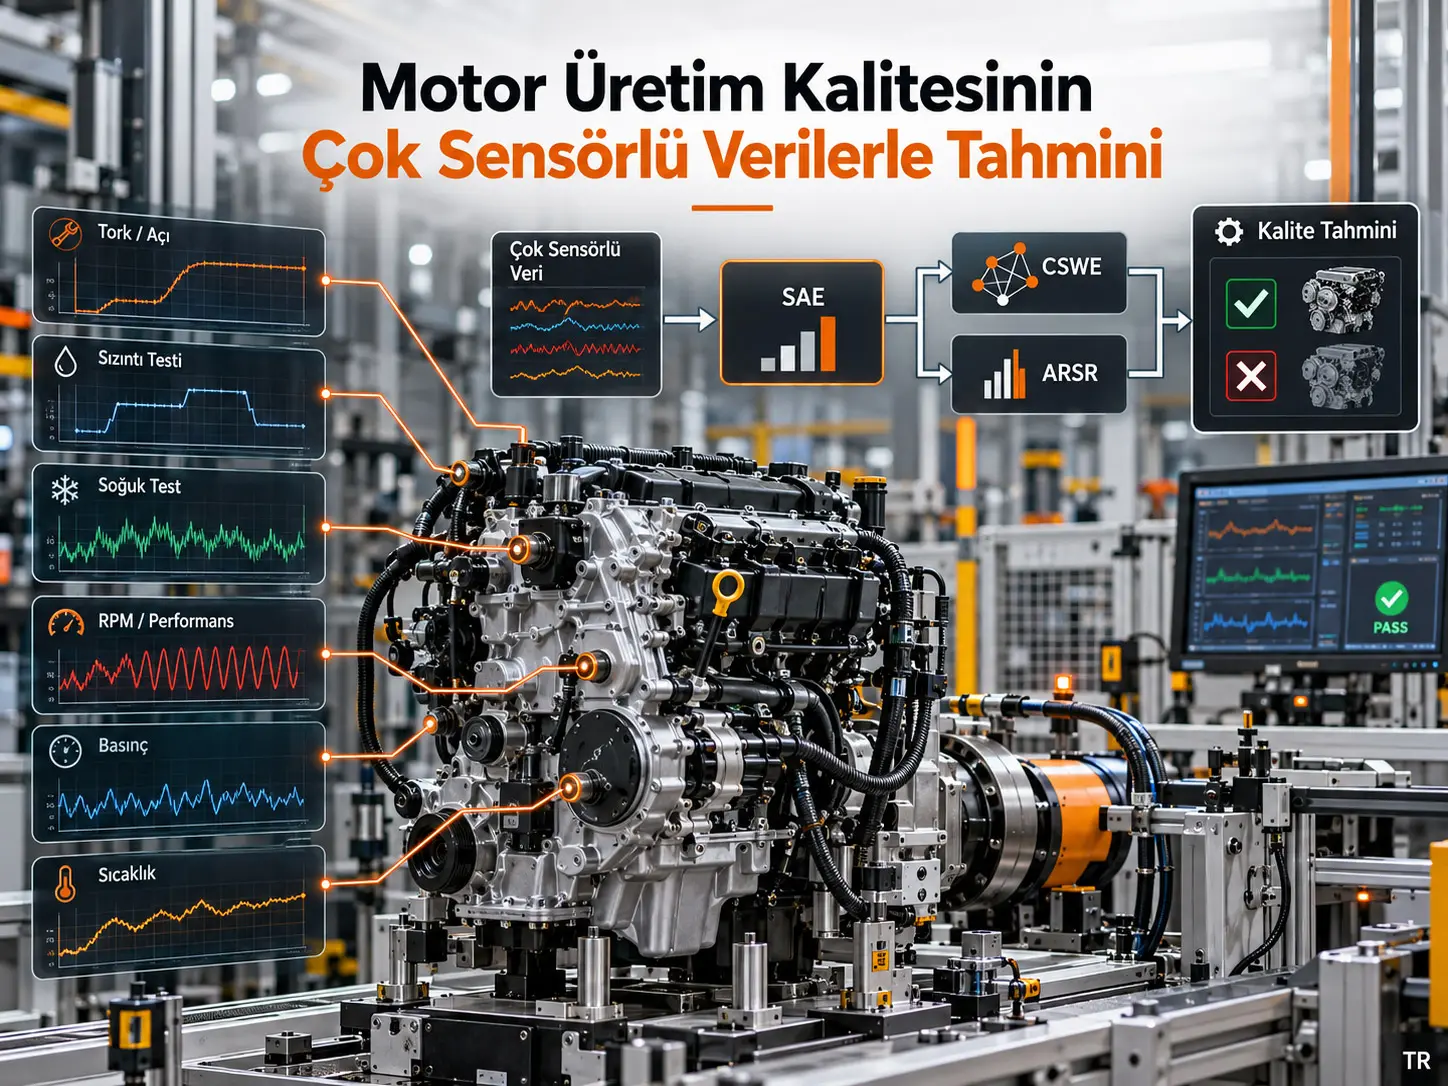
Çalışmada önerilen motor üretim kalite tahmin çerçevesi, heterojen üretim sensörlerinden gelen 12.000'den fazla parametreyi işleyerek kusurlu motorların sınıflandırılması ve motor performansının sürekli tahmini için tasarlanmış, edge cihazlarda çalışabilen birleşik bir makine öğrenmesi sistemidir. Mimari üç merkezi bileşen kullanır: yüksek boyutlu ve gürültülü sensör verisini sıkıştıran Sparse Autoencoder (SAE), az sayıdaki kusurlu örneği daha etkili yakalamayı amaçlayan Class-Specific Weighted Ensemble (CSWE) ve farklı motor çalışma rejimleri için farklı regresyon uzmanları kullanan Adaptive Regime-Switching Regression (ARSR). Sistem üç kamu veri kümesinde ve gerçek bir H4 motor montaj hattında değerlendirilmiştir. Endüstriyel uygulamada kusur yakalama Recall değeri %69,20'den %76,92'ye yükselmiş, ortalama çıkarım gecikmesi 80 ± 3 ms olmuş ve üç aylık pilot döneminde motor onarım/yeniden işleme oranında %7,2 düşüş raporlanmıştır. Bununla birlikte %76,92 Recall, yazarların kalite güvence için ideal olarak belirttiği >%95 hedefin altında kalmaktadır; ayrıca tek modlu tablo sensör verileri mikroskobik yapısal anomalileri tamamen yakalayamamaktadır.
Çalışmanın temel mühendislik problemi, otomobil motoru montaj hatlarında sensör verisinin yalnız büyük hacimli değil, aynı zamanda fiziksel olarak heterojen olmasıdır. Tork, dönme açısı, motor devri, sıcaklık, basınç ve sızıntı gibi büyüklükler farklı ölçeklerde ölçülür; sensörler elektromanyetik girişim, eksik veri, yüksek korelasyon ve çalışma fazlarına bağlı istatistiksel değişimler içerir. Üstelik kusurlu motor sayısı normal motor sayısına göre çok düşüktür. Bu koşullar, yüksek genel doğruluğa sahip fakat gerçek kusurların önemli bölümünü kaçıran modeller üretebilir.
Çalışma bu problemleri tek bir ağır derin öğrenme modeliyle çözmek yerine görevleri ayırmaktadır. İlk aşamada SAE, ortak bir gizil özellik uzayı üretir. Ardından sınıflandırma görevinde CSWE, her temel sınıflandırıcının belirli kusur sınıflarındaki yeterliliğine göre ağırlıklı oy kullanır. Regresyon görevinde ARSR, tek bir küresel regresyon fonksiyonu yerine farklı çalışma rejimlerine uygun yerel uzmanları kullanır. Kamu benchmark'larında rejimler SAE gizil özellikleri üzerinde K-Means ile keşfedilirken gerçek üretim hattındaki edge sürümünde hesaplama maliyetini azaltmak için Start-up, High-speed ve Idle rejimleri doğrudan RPM sınırlarıyla yönlendirilmiştir.
Motor üretim kalitesini tahmin etmek neden zor?
Modern motor montaj hattında kalite bilgisi tek bir sensörden gelmez. Üretimin farklı istasyonlarında cıvata sıkma torku, dönme açısı, geometrik açıklıklar, sızdırmazlık, basınç, akış, motor devri, sıcaklık ve ECU parametreleri gibi binlerce değişken oluşur. Kaynak çalışmadaki endüstriyel veri tabanı OP10'dan OP130'a uzanan üretim istasyonlarını kapsayan üç ana fiziksel veri alanında örgütlenmiştir: proses verisi, kalite verisi ve performans verisi.
| Veri alanı | Kategori | Parametre sayısı | Örnek fiziksel içerik |
|---|---|---|---|
| Proses verisi | Temel veri | 54 | Biyel yatağı açıklıkları, düzlemsellik, derinlik, eksantrik mili açıklıkları |
| Proses verisi | Sıkma torku verisi | 11.381 | Son tork, dönme açısı, tork/açı oranı |
| Proses verisi | Ölçekleme uygulama verisi | 261 | Alt blok, buji, ön kapak ve yağ karteri için genişlik/ofset |
| Kalite verisi | Soğuk test | 1027 | Kısa ve uzun soğuk test sinyalleri |
| Kalite verisi | Sızıntı testi | 150 | Sızıntı testi sonuçları |
| Performans verisi | Performans parametreleri | 29 | Devir, sıcaklıklar, basınçlar ve ECU parametreleri |
Sıkma istasyonlarındaki mekanik sinyaller 5 Hz örnekleme frekansıyla kaydedilmiştir. EOL performans tezgâhındaki veriler ise motorun fonksiyonel durumunu temsil eden devir ve tork gibi değişkenleri içerir. Engine ID, farklı istasyonlardan gelen bütün kayıtları aynı fiziksel motorla ilişkilendiren temel anahtardır.
Veri zaman çizelgesi nasıl yeniden kuruldu?
Ham kayıtlar Engine ID → Category/Workstation → Inspection Time hiyerarşisiyle sıralanmıştır. Böylece aynı motora ait farklı üretim istasyonlarındaki sensör ölçümleri kronolojik bir montaj yörüngesine dönüştürülmüştür.
Kusur sınıflandırmasındaki Pass/Fail etiketleri ile regresyon için kullanılan RPM/Torque hedefleri sertifikalı EOL test tezgâhından alınmıştır. Karar sınırına yakın bazı örnekler ayrıca kıdemli kalite mühendisleri tarafından manuel yeniden incelemeye tabi tutulmuştur.
Eksik ve gürültülü veriler nasıl işlendi?
Ön işleme dört eşzamanlı işlemden oluşmuştur:
- Aykırı değerlerin giderilmesi,
- Eksik değerlerin sayısal interpolasyonla doldurulması,
- Yumuşatma filtreleriyle gürültü azaltma,
- Fiziksel ölçeklerin standardizasyonu.
Bir sensör kanalı veya örnekte eksik veri oranı %30'u aştığında ilgili veri çıkarılmıştır. Bu eşik yalnız ampirik bir filtre olarak bırakılmamış, çalışma içinde fiziksel olarak tartışılmıştır. 5 Hz örneklemede ardışık noktalar yaklaşık 0,2 s aralıklıdır. %30'dan daha büyük kayıp, belirli çalışma pencerelerinde yaklaşık 0,8-1,0 s süreli kör bölgeler oluşturabilmektedir. Kritik mekanik geçişlerin yaklaşık 1,5-2,0 s gibi dar pencerelerde gerçekleştiği düşünüldüğünde böyle bir kayıp gerçek dinamik imzayı ortadan kaldırabilir.
Yazarlar eşik çok daha katı, örneğin <%10 yapılırsa, zorlu endüstriyel ortamda toplanan örneklerin %40'tan fazlasının atılabileceğini belirtmektedir. Böyle bir filtreleme, eğitim hacmini küçültmekle kalmayıp modelin yalnız ideal sensör koşullarını görmesine ve gerçek üretimdeki gürültülü kusur örneklerini öğrenememesine yol açabilir.
Sparse Autoencoder Bu Çalışmada Ne İşe Yarıyor?
Sparse Autoencoder (SAE), farklı ölçeklerdeki ve 12.000'den fazla parametre içeren sensör verisini düşük boyutlu bir gizil temsile sıkıştırırken seyreklik cezası aracılığıyla sürekli olmayan veya bilgi taşımayan sensör gürültüsünü bastırmak için kullanılan doğrusal olmayan özellik çıkarma bileşenidir.
PCA Whitening ve standardizasyon
Endüstriyel sensör verisinde tork ile basınç gibi değişkenler arasında kuvvetli çoklu doğrusal bağlantılar bulunabildiğinden çalışma, endüstriyel veri için PCA Whitening kullanmıştır:
\[ X_{\mathrm{white}}=(X-\mu)U(\Lambda+\epsilon I)^{-1/2} \]
Burada \(X\) giriş matrisi, \(\mu\) eğitim verisinden hesaplanan ortalama, \(U\) özvektör matrisi, \(\Lambda\) özdeğer matrisi, \(I\) birim matris ve \(\epsilon\) sayısal kararlılık terimidir. Dönüşüm değişken varyanslarını ölçeklendirirken korelasyon yapısını da ayrıştırmayı amaçlar.
AI4I, SECOM ve C-MAPSS gibi daha düşük boyutlu benchmark verilerinde veri yapısına göre Z-Score veya Min-Max ölçekleme kullanılmıştır. En kritik veri sızıntısı önlemi, standardizasyon istatistikleri ve SAE ağırlıklarının yalnız etiketlenmemiş eğitim verisinden öğrenilmesi; doğrulama ve test örneklerine aynı dondurulmuş dönüşümün uygulanmasıdır.
SAE'nin kayıp fonksiyonu
Kaynakta verilen birleşik SAE amaç fonksiyonu:
\[ J_{\mathrm{sparse}}(W,b) = \frac{1}{m}\sum_{i=1}^{m} \frac{1}{2} \left\| h_{W,b}(x^{(i)})-x^{(i)} \right\|^2 + \frac{\lambda}{2} \sum_{l=1}^{2} \left\| W^{(l)} \right\|_F^2 + \beta \sum_{j=1}^{s} KL(\rho\|\hat{\rho}_j) \]
Birinci terim giriş sinyalini yeniden oluşturma hatasıdır ve temel bilgiyi korumayı amaçlar. İkinci terim, \(\lambda\) ile ağırlıklandırılmış L2 ağırlık cezasıdır ve model karmaşıklığını sınırlar. Üçüncü terim, \(\beta\) ile ağırlıklandırılmış seyreklik cezasıdır. \(KL(\rho\|\hat{\rho}_j)\), gizli birimin ortalama etkinliği \(\hat{\rho}_j\)'yi düşük hedef etkinlik \(\rho\)'ya yaklaştırır.
Bu yapı SAE'nin yalnız boyut azaltmasını değil, sürekli aktif olmayan ve bilgi taşımayan gizli özellikleri bastırmasını sağlar. Çalışma, ağ parametrelerini L-BFGS (Limited-memory Broyden-Fletcher-Goldfarb-Shanno) algoritmasıyla optimize etmiştir.
Noise-Aware Residual Fusion
Derin sıkıştırma yüksek frekanslı gerçek fiziksel ayrıntının bir bölümünü de kaybedebileceği için kaynak, koşullu bir ham-sinyal artık bağlantısı kullanmıştır:
\[ X_{\mathrm{hybrid}}= \operatorname{Concat} (\gamma X_{\mathrm{std}},X_{\mathrm{sae}}) \]
\(\gamma\in\{0,1\}\) iki çalışma modunu seçer.
- Mode I, \(\gamma=0\): Çok yüksek boyutlu ve gürültülü endüstriyel veride yalnız SAE gizil özellikleri kullanılır. Amaç boyut ve gürültüyü mümkün olduğunca azaltmaktır.
- Mode II, \(\gamma=1\): Daha düşük boyutlu ve temiz benchmark verilerinde standartlaştırılmış ham özellikler ile SAE özellikleri birlikte kullanılır.
Kaynak bu kararı sinyal-gürültü oranı ve giriş boyutunun birleşik etkisine bağlamaktadır. Endüstriyel sistemde \(N_{in}\) yaklaşık 10.000 veya daha yüksek düzeyde olduğu için gerçek edge deployment \(\gamma=0\) modunda çalıştırılmıştır.
Motor çalışma rejimlerinin ayrılması
Motorun EOL test döngüsü üç fiziksel rejime ayrılmıştır:
- Start-up Phase (SUP): hızlı ve yaklaşık doğrusal hızlanma,
- High-Speed Phase (HSP): yüksek frekanslı ve daha doğrusal olmayan dinamikler,
- Idle Phase (IP): düşük genlikli, kararlı çalışma.
Bu fazlar arasındaki geçiş bölgeleri, test tezgâhı ve motorun birlikte ürettiği yüksek geçici gürültünün kalite imzasını bozmasını önlemek amacıyla değerlendirme dışı bırakılmıştır. Kaynağın 11. sayfasındaki Şekil 5, sürekli devir profilini ve SUP-HSP-IP sınırlarını açık biçimde göstermektedir.
ARSR Neden Tek Bir Regresyon Modeli Kullanmak Yerine Birden Fazla Uzman Kullanıyor?
Adaptive Regime-Switching Regression (ARSR), Start-up, High-speed ve Idle gibi istatistiksel yapıları farklı motor rejimlerini tek bir küresel fonksiyona zorlamak yerine her rejim için doğrulama hatası en düşük yerel regresyon uzmanını seçmek için tasarlanmıştır.
Genel ARSR mimarisi
Kamu benchmark'larında ARSR, SAE gizil uzayında K-Means kullanarak rejimleri etiketsiz biçimde keşfeder:
\[ \mathcal{R}=\{C_1,C_2,\ldots,C_K\} \]
Her küme için LR, SVR, XGBoost ve GBR gibi farklı endüktif önyargılara sahip modellerden bir uzman havuzu oluşturulur. Rejim \(C_k\) için seçilen model:
\[ f_k^* = \operatorname*{arg\,min}_{f\in\mathcal{H}_{pool}} L_{val}(f,D_{C_k}) \]
olarak belirlenir. Yani algoritma adı önceden sabit değildir; hangi aday model ilgili rejimde doğrulama hatasını en aza indiriyorsa o uzman kullanılır.
Gerçek fabrikada K-Means neden kullanılmadı?
Üretim hattındaki edge sürümünde ARSR'nin K-Means tabanlı rejim keşfi bilinçli biçimde değiştirilmiştir. Start-up, High-speed ve Idle fazları fiziksel RPM eşikleriyle zaten deterministik olarak tanımlanabildiğinden, gerçek sistemde K-Means yerine bu sabit fizik tabanlı yönlendirme kullanılmıştır. Amaç çevrim içi kümeleme maliyetini kaldırmak, rejim atamasını tamamen tekrarlanabilir yapmak ve 100 ms'lik Takt zamanı sınırı altında kalmaktır.
Dolayısıyla çalışmanın iki ARSR konfigürasyonu birbirinden ayrılmalıdır: benchmark/genel mimari etiketsiz K-Means routing kullanırken gerçek montaj hattı deployment'ı RPM eşiklerine dayalı hard-switching kullanmaktadır.
CSWE Nadir Motor Kusurlarını Nasıl Yakalamaya Çalışıyor?
Class-Specific Weighted Ensemble (CSWE), bütün kusur sınıfları için her sınıflandırıcıya tek bir küresel ağırlık vermek yerine SVM, KNN, Gaussian Naive Bayes ve Bagging gibi modellerin her kusur sınıfındaki doğrulama F1 performansını ayrı bir yeterlilik ağırlığı olarak kullanır; böylece az görülen kusurları çoğunluk sınıfının baskısından korumayı amaçlar.
Sınıfa özgü yeterlilik matrisi
\(m\) sınıflandırıcı ve \(n\) hedef kusur sınıfı için yeterlilik matrisi:
\[ W= \begin{bmatrix} w_{1,1} & w_{1,2} & \cdots & w_{1,n}\\ w_{2,1} & w_{2,2} & \cdots & w_{2,n}\\ \vdots & \vdots & \ddots & \vdots\\ w_{m,1} & w_{m,2} & \cdots & w_{m,n} \end{bmatrix} \]
biçiminde tanımlanır.
Kaynakta her ağırlık sınıfa özgü doğrulama F1 skoru üzerinden şu biçimde verilmiştir:
\[ w_{j,k} = F1_{j,k} = \frac{2P_{j,k}R_{j,k}} {P_{j,k}+R_{j,k}} +\epsilon \]
Burada \(P_{j,k}\), \(j\). sınıflandırıcının \(k\). sınıf için Precision değeri; \(R_{j,k}\) ise Recall değeridir. Kaynak formülde \(\epsilon\) toplamsal bir sayısal kararlılık terimi olarak gösterilmektedir.
Çevrim içi karar aşamasında temel modellerin ikili çıktıları \(V\in\{0,1\}^{m\times n}\) matrisini oluşturur. Her sınıfın toplam skoru:
\[ S_k= \sum_{j=1}^{m} w_{j,k}v_{j,k} \]
olarak hesaplanır.
Nihai sınıf:
\[ c^*= \operatorname*{arg\,max}_{k} S_k \]
ile belirlenir. Böylece aynı temel sınıflandırıcı bir kusur türünde yüksek, başka bir kusur türünde düşük karar ağırlığına sahip olabilir.
Değerlendirme metriklerinin neden Recall merkezli olduğu
Motor kalite kontrolünde False Negative, yani gerçekten kusurlu bir motorun sağlam kabul edilmesi, False Positive nedeniyle yeniden kontrol yapılmasından daha yüksek maliyet taşıyabilir. Bu nedenle çalışma genel Accuracy yerine özellikle Recall ve F1 değerlerini öne çıkarmaktadır.
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1= 2\frac{Precision\cdot Recall} {Precision+Recall} \]
Accuracy dengesiz veri kümesinde yanıltıcı olabilir. Kusur oranı çok düşük olduğunda neredeyse bütün motorları “normal” olarak sınıflandıran bir model yüksek Accuracy elde edebilir fakat kritik kusurları kaçırabilir. Recall bu nedenle kalite kapısında daha doğrudan bir kusur yakalama göstergesidir.
Çalışmanın Yöntemi ve Bulguları
Endüstriyel veri kümesi
Gerçek üretim verisi, önde gelen bir otomotiv üreticisinin H4 montaj hattındaki JL478QEA-AJ motor modelinden elde edilmiştir. Veri, Engine Test Data Management Database üzerinden Engine ID temel anahtarıyla birleştirilmiştir.
| Görev | Etiketlenmemiş örnek | Etiketli örnek | Faz |
|---|---|---|---|
| ARSR | 2090 | 520 | SUP |
| ARSR | 2090 | 520 | HSP |
| ARSR | 2090 | 520 | IP |
| CSWE | 620 | 135 | SUP |
| CSWE | 620 | 135 | HSP |
| CSWE | 620 | 135 | IP |
Eğitim ve test ayrımında aynı fiziksel motordan gelen örneklerin iki kümeye birden girmesini engellemek için motor seri numarasına göre katı gruplama uygulanmıştır. Bu ayrıntı önemlidir; çünkü aynı motora ait yüksek derecede ilişkili sensör parçalarının hem eğitim hem test kümesinde bulunması performansı yapay biçimde artırabilirdi.
Kamu benchmark veri kümeleri
| Veri kümesi | Görev | Örnek / özellik | Ana zorluk |
|---|---|---|---|
| AI4I 2020 | Sınıflandırma ve regresyon | 10.000 örnek, 14 özellik | Yaklaşık %3,4 arıza oranıyla ciddi sınıf dengesizliği; takım aşınması tahmini |
| UCI SECOM | Sınıflandırma | 3140 örnek, 591 özellik | Yüksek boyut, gürültü ve seyrek veri |
| NASA C-MAPSS FD002 | Regresyon | 21 özellik | Etiketsiz altı farklı çalışma koşulu ve Remaining Useful Life tahmini |
Bu benchmark'ların amacı üç veri kümesinde aynı uygulamayı taklit etmek değildir. Her biri sistemin farklı bir bileşenini stres testine sokmaktadır: sınıf dengesizliği, yüksek boyutlu gürültü veya gizli çalışma rejimleri.
Donanım ve yazılım
| Aşama | Donanım / yazılım |
|---|---|
| Model eğitimi ve benchmark deneyleri | Intel Xeon Gold 6430 CPU; NVIDIA RTX 4090, 24 GB VRAM |
| Gerçek üretim hattı edge deployment | Intel Xeon E5-2680 v4 tabanlı line-side edge cluster |
| Yazılım | Python 3.8; PyTorch 2.0.0; Scikit-learn 1.0 |
| Global random seed | 42 |
Sınıflandırma görevleri ve AI4I Tool Wear sonuçları 10 bağımsız çalıştırmanın ortalaması ve standart sapmasıyla raporlanmıştır. Daha maliyetli NASA C-MAPSS zaman serisi deneyleri 5 bağımsız çalıştırma üzerinden değerlendirilmiştir.
Sınıflandırma sonuçları: AI4I
| Model | Accuracy (%) | F1 (%) | Recall (%) | Precision (%) |
|---|---|---|---|---|
| SAE + CSWE | 98,80 ± 0,24 | 81,55 ± 3,51 | 77,94 ± 3,83 | 85,70 ± 4,89 |
| LightGBM | 98,81 ± 0,24 | 81,05 ± 4,63 | 75,29 ± 7,05 | 88,42 ± 4,20 |
| Bagging | 98,45 ± 0,28 | 75,51 ± 4,56 | 70,44 ± 5,71 | 81,77 ± 5,76 |
| Random Forest | 98,35 ± 0,30 | 75,13 ± 3,53 | 73,09 ± 5,92 | 78,25 ± 7,43 |
| CNN | 97,66 ± 0,40 | 65,47 ± 3,84 | 65,44 ± 10,15 | 67,78 ± 8,39 |
| Transformer | 97,62 ± 0,38 | 62,22 ± 4,34 | 57,50 ± 6,85 | 69,90 ± 10,65 |
| XGBoost | 98,28 ± 0,26 | 77,22 ± 3,46 | 85,74 ± 4,16 | 70,29 ± 3,38 |
| SVM | 97,19 ± 0,54 | 61,13 ± 2,63 | 64,71 ± 9,53 | 60,25 ± 8,83 |
| MLP | 98,49 ± 0,34 | 77,03 ± 4,26 | 74,12 ± 3,10 | 80,58 ± 7,74 |
SAE + CSWE en yüksek F1 değerini vermiştir. XGBoost daha yüksek Recall üretmiş fakat Precision değerinin daha düşük olması daha fazla yanlış alarm anlamına gelmiştir. Bu nedenle çalışmanın iddiası “her metrikte en iyi” olmak değil, kusur yakalama ile yanlış alarm arasında daha dengeli bir sonuç sağlamaktır.
Sınıflandırma sonuçları: UCI SECOM
| Model | Accuracy (%) | F1 (%) | Recall (%) | Precision (%) |
|---|---|---|---|---|
| SAE + CSWE | 85,54 ± 7,36 | 33,17 ± 6,29 | 49,05 ± 17,82 | 30,87 ± 16,01 |
| XGBoost | 87,55 ± 5,11 | 32,94 ± 3,36 | 45,24 ± 16,25 | 28,88 ± 6,66 |
| LightGBM | 86,53 ± 7,36 | 30,86 ± 5,85 | 40,95 ± 11,11 | 28,05 ± 10,87 |
| Random Forest | 87,45 ± 4,58 | 18,90 ± 11,83 | 27,62 ± 19,73 | 17,69 ± 10,94 |
| SVM | 91,66 ± 1,01 | 9,67 ± 6,31 | 6,67 ± 4,36 | 18,82 ± 12,52 |
| Transformer | 89,39 ± 1,47 | 14,78 ± 5,25 | 13,81 ± 5,41 | 16,67 ± 6,34 |
SECOM sonuçları Accuracy'nin dengesiz sınıflarda neden tek başına yeterli olmadığını özellikle iyi göstermektedir. Örneğin SVM'nin Accuracy değeri %91,66 iken Recall yalnız %6,67'dir. SAE + CSWE daha düşük Accuracy'ye rağmen kusurların çok daha büyük bölümünü yakalayarak %49,05 Recall elde etmiştir.
Regresyon metrikleri
Regresyon görevlerinde üç ana metrik kullanılmıştır:
\[ MSE= \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat{y}_i)^2 \]
\[ R^2= 1- \frac{\sum_i(y_i-\hat{y}_i)^2} {\sum_i(y_i-\bar{y})^2} \]
\[ MAPE= \frac{1}{n} \sum_{i=1}^{n} \left| \frac{y_i-\hat{y}_i}{y_i} \right| \]
MSE büyük hataları karesel olarak daha fazla cezalandırır. \(R^2\), hedef değişkendeki varyansın model tarafından açıklanma düzeyini gösterir. MAPE ölçekten bağımsız yüzde hata verir; fakat hedef değer sıfıra yaklaştığında matematiksel olarak kararsız hâle gelebilir. Bu son sorun, çalışmanın Idle fazındaki devir standart sapması analizinde doğrudan gözlenmiştir.
AI4I Tool Wear regresyonu
| Model | MSE | \(R^2\) | MAPE (%) |
|---|---|---|---|
| SAE + ARSR | 2584,88 ± 62,40 | 0,9196 ± 0,0047 | 2,67 ± 0,02 |
| 1D-CNN | 2589,83 ± 65,09 | 0,9194 ± 0,0048 | 2,66 ± 0,03 |
| Transformer | 2648,32 ± 80,67 | 0,9176 ± 0,0045 | 2,66 ± 0,02 |
| XGBoost | 2735,70 ± 68,53 | 0,9149 ± 0,0043 | 2,72 ± 0,03 |
| SVR | 3651,86 ± 234,76 | 0,8866 ± 0,0070 | 2,81 ± 0,03 |
SAE + ARSR en düşük MSE ve en yüksek \(R^2\) değerini elde etmiş, ancak MAPE açısından CNN ve Transformer yaklaşık aynı veya çok az daha düşük değerler üretmiştir. Dolayısıyla sonuç, kullanılan bütün metriklerde mutlak üstünlük biçiminde yorumlanmamalıdır.
NASA C-MAPSS FD002 regresyonu
| Model | MSE | \(R^2\) | MAPE (%) |
|---|---|---|---|
| SAE + ARSR | 424,49 ± 36,03 | 0,7561 ± 0,0207 | 32,14 ± 1,03 |
| Bagging | 433,81 ± 34,72 | 0,7508 ± 0,0199 | 31,82 ± 1,16 |
| XGBoost | 434,01 ± 32,28 | 0,7507 ± 0,0185 | 31,70 ± 1,01 |
| LightGBM | 435,13 ± 32,30 | 0,7500 ± 0,0185 | 32,01 ± 1,02 |
| 1D-CNN | 484,69 ± 41,63 | 0,7216 ± 0,0239 | 41,31 ± 3,48 |
| Transformer | 970,55 ± 131,33 | 0,4425 ± 0,0754 | 114,26 ± 23,29 |
ARSR, FD002'de en düşük MSE ve en yüksek \(R^2\) değerini üretmiştir. Buna karşılık MAPE'de XGBoost ve Bagging daha düşük değerler vermiştir. Bu sonuç yine model performansının kullanılan hata metriğine bağlı olarak değerlendirilmesi gerektiğini göstermektedir.
Ablasyon deneyleri SAE ve rejim bölmenin rolü hakkında ne gösterdi?
| Varyant | SECOM F1 (%) | SECOM Recall (%) | NASA FD002 MSE |
|---|---|---|---|
| Tam model | 33,17 ± 6,29 | 49,05 ± 17,82 | 424,49 ± 36,03 |
| Seyreklik yok - standart AE | 23,94 ± 2,75 | 40,00 ± 21,63 | 485,99 ± 39,20 |
| SAE yok - ham özellik | 32,38 ± 4,48 | 40,48 ± 9,82 | 452,24 ± 35,74 |
| Rejim bölme yok - global model | 29,23 ± 6,13 | 43,33 ± 14,67 | 474,45 ± 38,80 |
Seyreklik cezasının kaldırılması SECOM F1 skorunu %33,17'den %23,94'e düşürmüştür. Ham standartlaştırılmış sensörlerin doğrudan kullanılması Accuracy'yi yükseltmesine rağmen Recall değerini %49,05'ten %40,48'e düşürmüştür. Kaynak bunu ham yüksek boyutlu gürültünün çoğunluk sınıfına yönelim yaratmasıyla açıklamaktadır.
NASA FD002'de rejim bölmenin kaldırılması MSE'yi 424,49'dan 474,45'e yükseltmiştir. Bu sonuç, altı farklı çalışma koşulunu tek bir küresel regresyon fonksiyonuna zorlamanın hata ürettiğini ve yerel uzman stratejisinin çok rejimli süreçlerde yararlı olduğunu desteklemektedir.
Gerçek H4 hattında kusur sınıflandırması
| Metrik | Bagging | CSWE |
|---|---|---|
| Precision | 80,00% | 81,63% |
| Recall | 69,20% | 76,92% |
| F1 | 74,21% | 79,21% |
Recall'daki mutlak artış 7,72 yüzde puandır. Bu bulgu kaynakta “kusur yakalama Recall'unda %7,72 iyileşme” şeklinde özetlenmektedir. Ancak %76,92 değeri, çalışmanın kendi tartışmasında kalite güvence için ideal kabul edilen >%95 seviyesinden belirgin biçimde düşüktür.
Gerçek hatta sürekli motor performansı tahmini
Regresyon hedefi sürücünün talep ettiği motor devri değildir. Test tezgâhındaki sabit yük protokolü altında motorun beklenen fonksiyonel tepkisi tahmin edilmektedir. Model ortalama devir ve devir standart sapması için bir “normal davranış” tabanı oluşturur. Bu tabandan sapmalar sürtünme anomalisi veya ECU kalibrasyon sorunu gibi daha ince problemlere işaret edebilecek yardımcı göstergeler olarak kullanılır.
Ortalama motor devri için ARSR:
- Start-up fazında Linear Regression,
- High-speed fazında SVR,
- Idle fazında SVR
seçmiş ve L-S-S uzman dizisi toplam %2,276 MAPE vermiştir. Tek başına LR için MAPE %2,646, tek başına SVR için %2,350 olarak raporlanmıştır.
Motor devri standart sapmasının tahmininde ise SVR-GPR-Bagging uzman bileşimi kullanılmış ve toplam MAPE %39,00 olmuştur. Bu değer yüksek görünmektedir; ancak özellikle Idle fazında gerçek standart sapma sıfıra çok yaklaştığı için MAPE'nin paydası çok küçülmektedir. Kaynak, küçük mutlak hataların bu nedenle dev yüzde hatalarına dönüştüğünü belirtmektedir.
Idle fazındaki mutlak tahmin hatasının ±10 RPM endüstriyel tolerans içinde kaldığı bildirilmiştir. Bu nedenle MAPE'nin bu rejimde tek başına fiziksel performans göstergesi olarak kullanılmasının sınırlı olduğu kabul edilmiştir.
Edge Deployment Bu Çalışmada Gerçekten Ne Kadar Hızlı ve Ne Kadar Başarılı?
Gerçek H4 motor montaj hattında kullanılan edge sürümü ortalama 80 ± 3 ms çıkarım gecikmesiyle 100 ms Takt zamanı sınırı içinde çalışmış ve üç aylık pilot dönemde motor onarım/yeniden işleme oranında %7,2 azalma raporlanmıştır; ancak kaynak bu operasyonel iyileşmeyi eşzamanlı kontrollü bir nedensellik deneyiyle ayrıştırmadığından %7,2 değeri gözlenen saha sonucu olarak yorumlanmalıdır.
Edge optimizasyonunun iki temel kararı
Birinci optimizasyon: Çevrim içi K-Means routing yerine motor rejimi doğrudan RPM eşikleriyle belirlenmiştir. Böylece küme atama hesaplaması kaldırılmıştır.
İkinci optimizasyon: \(\gamma=0\) kullanılarak yalnız SAE'nin sıkıştırılmış gizil özellikleri downstream modele verilmiştir. 10.000'den fazla ham özelliğin edge işlemcide taşınması ve hesaplanması önlenmiştir.
Bu konfigürasyon Intel Xeon E5-2680 v4 tabanlı line-side edge cihazlarda ortalama 80 ± 3 ms çıkarım süresi sağlamıştır. Çalışma bunu 100 ms'lik Takt zamanı sınırıyla karşılaştırmaktadır.
Üç aylık pilot üretim sonucu
Yazarlar üç aylık pilot çalışmanın ardından motor onarım/yeniden işleme oranında %7,2 azalma raporlamıştır. Bu, yöntemin yalnız benchmark veri kümelerinde değil gerçek üretim iş akışında da çalıştırıldığını göstermesi bakımından önemlidir.
Bununla birlikte kaynakta ayrı bir kontrol hattı, randomize karşılaştırma veya diğer üretim süreci değişikliklerini istatistiksel olarak ayıran nedensel etki tasarımı raporlanmamaktadır. Bu nedenle %7,2'lik değer doğrudan gözlenen pilot dönem performans göstergesidir; algoritmanın tek başına oluşturduğu kesin nedensel etki olarak genişletilmemelidir.
Karışıklık matrisleri ne gösteriyor?
Kaynağın 21. sayfasındaki Şekil 12, UCI SECOM üzerindeki 10 bağımsız çalıştırmanın toplu karışıklık matrislerini gösterir. LightGBM 86, Bagging 76 ve XGBoost 95 gerçek kusuru yakalamıştır. XGBoost aynı zamanda 234 yanlış alarm üretmiştir. Önerilen CSWE ise 103 gerçek kusuru yakalarken 231 False Positive üretmiştir.
Bu karşılaştırmanın temel mesajı, CSWE'nin yalnız Recall'u artırması değil, Recall artışı sırasında yanlış alarm sayısını kontrol altında tutmaya çalışmasıdır.
Çalışmanın desteklediği sonuçlar
- SAE'nin seyreklik yapısı yüksek boyutlu ve gürültülü sensör verisinde kusur sınıflandırmasına ölçülebilir katkı sağlamıştır.
- Sınıfa özgü ağırlıklandırma, dengesiz kusur sınıflarında Recall ve F1 performansını iyileştirebilmiştir.
- Çalışma rejimlerine göre uzman seçimi çok rejimli regresyon görevlerinde tek global modele göre hata azaltabilmiştir.
- Önerilen mimari gerçek H4 motor üretim hattındaki CPU tabanlı edge donanımında 100 ms sınırı içinde çalışmıştır.
- Üç aylık gerçek üretim pilotunda onarım/yeniden işleme oranında %7,2 düşüş raporlanmıştır.
Çalışmanın desteklemediği sonuçlar
- Sistem bütün motor kusurlarını yakalamaz; endüstriyel Recall %76,92'dir.
- Sonuçlar bütün otomotiv üreticilerine, bütün motor ailelerine ve bütün montaj hatlarına otomatik olarak genellenemez.
- %7,2 üretim iyileşmesi kontrollü nedensel etki büyüklüğü değildir.
- Mevcut tek modlu tablo sensör sistemi, mikroskobik yapısal anomalilerin tamamını gözlemleyemez.
- Model mevcut hâliyle sürekli çevrim içi öğrenme veya otomatik concept-drift uyarlaması yapmaz.
- Idle fazındaki yüksek MAPE değerleri tek başına kötü fiziksel performans anlamına gelmez; sıfıra yaklaşan hedef değer MAPE'yi matematiksel olarak şişirir.
Sınırlılıklar ve gelecek çalışma yönleri
Tek modlu veri sınırı: Çalışma temel olarak tablo biçimindeki tork, basınç ve benzeri proses/sensör ölçümlerine dayanır. Yazarlar daha yüksek kusur yakalama için Acoustic Emission sensörleri ile gerçek zamanlı görsel izleme gibi ek modalitelerin gerekli olabileceğini belirtmektedir.
Belirsizlik tahmini: Özellikle sıfıra yakın hedeflerde nokta tahmini ve MAPE'nin sınırlı olması nedeniyle gelecekte Bayesian Neural Networks gibi olasılıksal yöntemler ve güven aralıklarının değerlendirilmesi önerilmektedir.
Concept drift: Model, belirli bir üretim stabilizasyon döneminde toplanan statik eğitim verisiyle çalışmaktadır. Takım aşınması, ortam sıcaklığı veya tedarikçi malzeme partisi değiştiğinde veri dağılımı zamanla kayabilir. Mevcut sürümde sürekli çevrim içi öğrenme mekanizması bulunmamaktadır.
Genellenebilirlik: Farklı motor modelleri ve farklı montaj hatlarında ayrıca doğrulama gereklidir. Kaynak çalışma, tek bir fiziksel hatta elde edilen endüstriyel başarının evrensel üretim performansı anlamına gelmediğini kabul etmektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Predicting Car-Engine Manufacturing Quality with Multi-Sensor Data of Manufacturing Assembly Process
Yazarlar: Xinyu Yang; Qianxi Zhang; Junjie Bao; Xue Wang; Nengchao Wu; Qing Tao; Haijia Wu; Li Liu.
Sorumlu yazar: Li Liu.
Kurumlar: School of Mechanical Engineering, Xinjiang University, Urumqi, China; Chongqing Municipal Economy and Information Technology Commission, Chongqing, China; School of Big Data & Software Engineering, Chongqing University, Chongqing, China.
Dergi: Sensors.
Yayınevi: MDPI.
Bibliyografik kayıt: Sensors 2026, 26(5), 1651.
DOI: 10.3390/s26051651
Kaynak türü: Hakemli araştırma makalesi.
Makale bölümü: Industrial Sensors.
Alınma: 29 Ocak 2026.
Revizyon: 21 Şubat 2026.
Kabul: 27 Şubat 2026.
Yayın: 5 Mart 2026.
Lisans: Creative Commons Attribution (CC BY).
Endüstriyel sistem: H4 motor montaj hattı; JL478QEA-AJ motor modeli.
Kamu doğrulama veri kümeleri: AI4I 2020 Predictive Maintenance Dataset; UCI SECOM; NASA C-MAPSS FD002.
Finansman: Chongqing Municipal Economy and Information Technology Commission, Grant No. YJX-2025001001008.
İnsan/hayvan araştırması: Çalışmanın insan katılımcılar veya hayvanlar üzerinde gerçekleştirilen araştırma içermediği belirtilmiştir.
Veri erişilebilirliği: Bulguları destekleyen verilerin makul talep üzerine sorumlu yazar Li Liu'dan edinilebileceği belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını beyan etmiştir.
Yazar katkıları: Xinyu Yang, Li Liu ve Qing Tao kavramsallaştırma; Xinyu Yang ve Li Liu yöntem; Xinyu Yang, Qianxi Zhang, Junjie Bao ve Nengchao Wu yazılım; Qianxi Zhang, Xue Wang ve Nengchao Wu doğrulama; Xinyu Yang ve Qianxi Zhang biçimsel analiz; Xinyu Yang, Junjie Bao ve Xue Wang araştırma; Li Liu ve Haijia Wu kaynaklar; Xinyu Yang, Qianxi Zhang ve Nengchao Wu veri kürasyonu; Xinyu Yang ilk taslak; Li Liu, Qing Tao ve Haijia Wu gözden geçirme/düzenleme; Xinyu Yang ve Qianxi Zhang görselleştirme; Li Liu ve Qing Tao gözetim; Li Liu ve Haijia Wu proje yönetimi ve finansman rollerini üstlenmiştir.
Temel yorum sınırı: Endüstriyel doğrulama gerçek üretim hattında gerçekleştirilmiş olsa da tek bir motor modeli ve belirli bir montaj hattı bağlamındadır. Recall değeri %76,92 ile yazarların belirttiği >%95 ideal QA hedefinin altındadır. Mevcut sistem yalnız tablo tabanlı tek sensör modalitesine dayanır, çevrim içi concept-drift uyarlaması içermez ve üç aylık %7,2 saha iyileşmesinin algoritmaya özgü nedensel payı ayrı bir kontrollü çalışma ile ayrıştırılmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir