


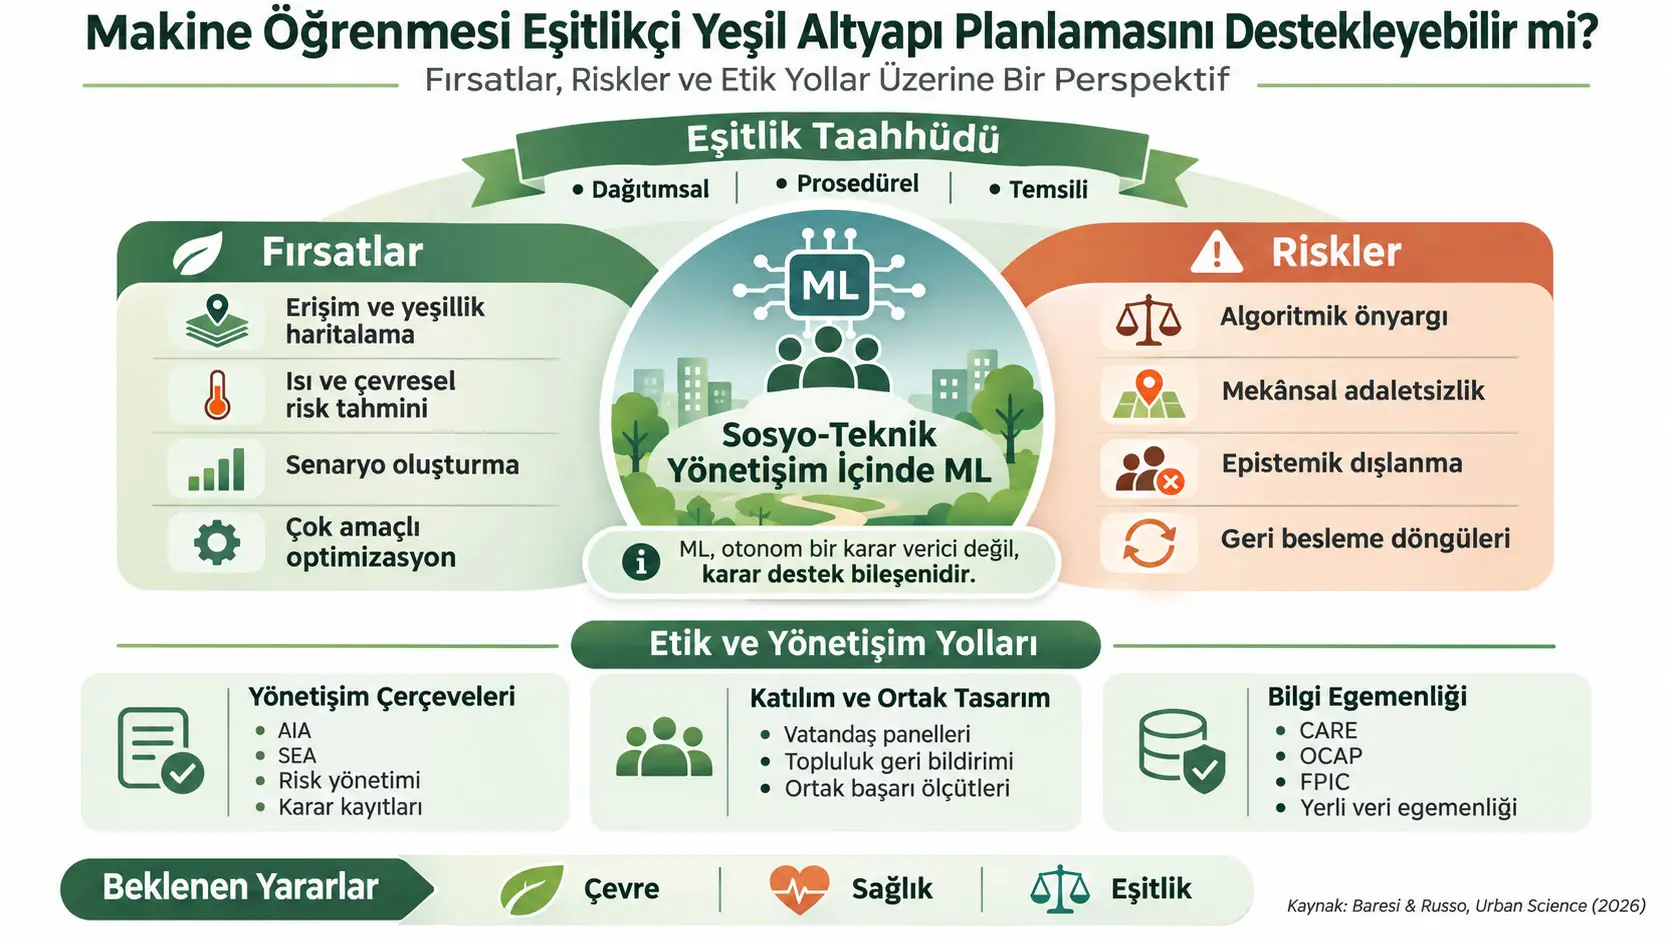
Yeşil altyapı (Green Infrastructure, GI), doğal ve yarı doğal alanların ekolojik, iklimsel, toplumsal ve sağlıkla ilişkili yararlar sağlayacak biçimde stratejik olarak planlandığı bir kentsel altyapı yaklaşımıdır. Umberto Baresi ve Alessio Russo'nun Perspective çalışması, makine öğrenmesinin (Machine Learning, ML) yeşil altyapı planlamasında toplumsal ve mekânsal eşitliği desteklemek için nasıl kullanılabileceğini; aynı teknolojinin yanlış veri, yanlış optimizasyon hedefleri veya yetersiz yönetişim altında mevcut eşitsizlikleri nasıl yeniden üretebileceğini incelemektedir.
Çalışma yeni bir makine öğrenmesi modeli geliştirmemekte, yeni veri toplamamakta ve deneysel bir performans karşılaştırması yapmamaktadır. Bunun yerine yeşil altyapı planlaması, kentsel mekânsal analiz, yapay zekâ etiği, çevresel adalet ve katılımcı yönetişim alanlarındaki literatürü planlama odaklı bir çerçevede bir araya getirmektedir.
Yazarlar makine öğrenmesinin yeşil altyapı planlamasında üç temel işleve sahip olabileceğini belirtmektedir: betimleyici kullanım mevcut eşitsizlikleri ve mekânsal örüntüleri haritalayabilir; öngörücü kullanım ısı, taşkın, bitki stresi veya başka çevresel kırılganlıkları tahmin edebilir; kural koyucu/önerici kullanım ise yer seçimi, yatırım önceliği ve farklı senaryolar arasındaki tercihleri destekleyebilir.
Makine öğrenmesinin güçlü yanı, uydu görüntüleri, sokak görüntüleri, hareketlilik verileri, sosyoekonomik bilgiler ve çevresel göstergeler gibi büyük ve farklı veri kaynaklarını aynı analiz içerisinde işleyebilmesidir. Bu kapasite, görünür yeşillik, yeşil alan erişimi, ısı maruziyeti, ekosistem hizmetleri ve hassas nüfus gruplarının ihtiyaçları gibi çok sayıda faktörün birlikte değerlendirilmesini sağlayabilir.
Ancak çalışma, makine öğrenmesinin kullanılmasının kendi başına eşitlik üretmediğini özellikle vurgulamaktadır. Tarihsel yatırım eşitsizliklerini içeren eğitim verileri, sosyoekonomik durumu dolaylı biçimde kodlayan vekil değişkenler, eksik dijital temsil, yanlış kalibrasyon, veri dağılımındaki değişiklikler ve geri besleme döngüleri; modelin geçmiş eşitsizlikleri yeni planlama kararlarına taşımasına neden olabilir.
Yazarların temel önerisi, makine öğrenmesinin bağımsız bir karar verici olarak değil, sosyo-teknik yönetişim sisteminin bir bileşeni olarak kullanılmasıdır. Nihai amaç fonksiyonlarının, “adil” kabul edilen sonuçların ve hangi grupların önceliklendirileceğinin yalnız algoritmalar tarafından belirlenmemesi; toplum, kamu kurumları, uzmanlar ve etkilenen gruplar tarafından açıkça tartışılması gerekir.
Çalışma özellikle üç eşitlik boyutunu birlikte ele almaktadır: dağıtımsal eşitlik, yararların ve zararların kimlere ve hangi mekânlara dağıldığını; prosedürel eşitlik, kararların kimler tarafından ve hangi süreçlerle alındığını; temsili eşitlik ise hangi bilgi, değer ve dünya görüşlerinin “yarar” ve “zarar” tanımlarında temsil edildiğini sorgular.
Sonuç olarak çalışma, ML destekli yeşil altyapı planlamasının dört temel ilkeye dayanmasını önermektedir: betimleyici, öngörücü ve önerici ML uygulamalarının birbirinden ayrılması; veri kaynakları, varsayımlar ve belirsizliklerin açıkça belgelenmesi; eşitlikle ilgili ödünleşimlerin etkilenen topluluklarla birlikte tartışılması; uygulanan yeşil altyapının zaman içinde gerçekten eşitsizlikleri azaltıp azaltmadığının izlenmesi.
Yeşil altyapı nedir?
Yeşil altyapı kavramı, koruma planlaması ve peyzaj ekolojisiyle ilişkili uzun bir geçmişe sahip olmakla birlikte 2000'li yılların başından itibaren planlama literatüründe daha görünür hale gelmiştir.
Erken dönem yaklaşımlarda yeşil altyapı büyük ölçüde habitat bağlantısı, biyolojik çeşitliliğin korunması, ekosistem işlevleri ve daha sonra ekosistem hizmetleri çerçevesinde ele alınmıştır.
Daha yeni yaklaşım ise yeşil altyapıyı yalnız ağaç, park veya yeşil koridorların toplamı olarak görmemektedir. Yeşil altyapı; insan davranışları, yönetişim, toplumsal eşitlik, altyapı sistemleri ve ekolojik süreçlerin karşılıklı etkileşimi içerisinde değerlendirilir.
Çalışmanın kullandığı sosyo-ekolojik-teknik sistemler (Socio-Ecological–Technical Systems, SETS) yaklaşımı da bu genişlemeyi temsil etmektedir. SETS düşüncesinde kentteki doğal sistemler, insanlar ve teknik altyapı birbirinden bağımsız değil, karşılıklı etkiler üreten bileşenlerdir.
Biyo-kapsayıcılık ve biyo-bütünleştirme ne demektir?
Çalışma çağdaş yeşil altyapı tanımlarının iki genel yönelim etrafında kümelendiğini aktarmaktadır.
- Biyo-kapsayıcılık (bio-inclusivity): Birbirine bağlı doğal alanları, açık alanları ve ekolojik bağlantıları öne çıkaran yaklaşımdır.
- Biyo-bütünleştirme (bio-integration): Birden fazla ekosistem hizmeti üretmesi amacıyla doğal ve yarı doğal sistemlerin stratejik planlamaya bilinçli biçimde dahil edilmesini öne çıkarır.
Bu iki yaklaşım tamamen birbirini dışlamak zorunda değildir. Ayrım, yeşil altyapının hangi planlama mantığıyla tanımlandığını anlamaya yardımcı olur.
Yeşil altyapı her ülkede aynı şeyi mi ifade eder?
Hayır. Kaynak çalışma yeşil altyapı kavramının politika bağlamına göre farklı biçimlerde kullanılabildiğini vurgulamaktadır.
Amerika Birleşik Devletleri'nde kavram sıklıkla yağmur suyu yönetimiyle ilişkilendirilirken, Kanada'da iklim azaltımı ve uyum ile suya ilişkin çevresel kalite boyutları daha görünürdür. Avustralya'da iklim azaltımı, uyum ve ekolojik bağlantıyla ilişkili temel kentsel altyapı olarak ele alınabilir. Avrupa Birliği bağlamında ise biyolojik çeşitlilik ve kentsel ekosistemlerin geliştirilmesiyle bağlantılıdır.
Bu farklılık önemlidir; çünkü bir makine öğrenmesi modelinin “yeşil altyapı başarısı” olarak optimize ettiği değişkenler, kullanılan politika tanımına göre değişebilir.
Yeşil Altyapıda Eşitlik Ne Anlama Gelir?
Yeşil altyapıda eşitlik, yalnız parkların veya ağaçların kent yüzeyinde eşit miktarda dağıtılması değildir; hangi toplulukların ekolojik, iklimsel ve sağlık yararlarına erişebildiğini, karar sürecine kimlerin katılabildiğini ve hangi bilgi ve değerlerin planlama kararlarında temsil edildiğini birlikte değerlendirmeyi gerektirir.
Yeşil alanın varlığı ile yararına erişmek aynı şey değildir
Bir mahallede park bulunması, mahallede yaşayan bütün insanların o parkın yararlarından eşit biçimde yararlandığını göstermez.
Çalışma erişimin yalnız fiziksel mesafeyle açıklanamayacağını vurgulamaktadır. Kurumsal kurallar, hareketlilik olanakları, ekonomik koşullar, güvenlik algısı, alanın fiziksel kalitesi ve kullanım biçimleri gerçek erişimi etkileyebilir.
Dolayısıyla bir harita üzerinde “yeşil alana yakın” görünen bir nüfusun, günlük yaşamında o alanı kolay, güvenli ve anlamlı biçimde kullanabildiği otomatik olarak varsayılamaz.
Dağıtımsal eşitlik
Dağıtımsal eşitlik, yeşil altyapının yararlarının ve olası zararlarının farklı mahalleler ve toplumsal gruplar arasında nasıl dağıldığını inceler.
Örneğin kentsel ağaçlandırmanın serinletme yararı yalnız yüksek gelirli mahallelerde yoğunlaşıyorsa, kent genelindeki toplam ağaç sayısı artmış olsa bile dağılım açısından bir eşitlik problemi devam edebilir.
Prosedürel eşitlik
Prosedürel eşitlik, kararın yalnız sonucuna değil kararın nasıl oluşturulduğuna bakar.
Hangi hedeflerin optimize edileceğine kim karar vermiştir? Hangi topluluklar görüş bildirebilmiştir? Modelin kabul ettiği risk düzeyi kim tarafından belirlenmiştir? Planlama sürecindeki kişiler model varsayımlarına itiraz edebilir mi?
Bu sorular makinenin teknik doğruluğundan farklıdır. Son derece doğru çalışan bir tahmin modeli, karar süreci demokratik veya kapsayıcı değilse prosedürel eşitliği sağlayamayabilir.
Temsili eşitlik
Temsili eşitlik, hangi insanların, bilgi sistemlerinin, kültürel değerlerin ve yaşam deneyimlerinin model tarafından görünür kabul edildiğini sorgular.
Bir topluluğun kültürel öneme sahip bir alanı, modelin standart veri tabanlarında herhangi bir sayısal değişkenle temsil edilmeyebilir. Bu durum söz konusu değerin önemsiz olduğunu değil, kullanılan hesaplama kategorisine kolayca çevrilemediğini gösterebilir.
Yeşil altyapının yararları nelerdir?
Kaynakta tartışılan literatüre göre yeşil altyapı farklı bağlamlarda:
- kentsel sıcaklığın azaltılmasına,
- yağmur suyunun düzenlenmesine,
- biyolojik çeşitliliğin desteklenmesine,
- hava kalitesine ilişkin yararlara,
- gölgeleme ve termal konfora,
- ruh sağlığı ve genel iyi oluşa,
- habitat sağlanmasına
katkı sağlayabilir.
Ancak çalışma yeşil altyapıyı yalnız olumlu etkiler üreten bir müdahale olarak sunmamaktadır. Bağlama bağlı olarak alerjen maruziyeti, vektör kaynaklı hastalık riski veya istenmeyen mikroiklim etkileri gibi ekosistem zararları ya da olumsuz yan etkiler de değerlendirilmelidir.
“Daha fazla yeşil” her zaman “daha adil” anlamına gelir mi?
Hayır. Bir kentte toplam yeşil alan miktarının artması, bu alanların yararlarının kırılgan veya tarihsel olarak dezavantajlı gruplara ulaştığını tek başına göstermez.
Bu nedenle çalışma, planlamada yalnız “ne kadar yeşil altyapı üretildi?” sorusunun değil, “kim yararlanıyor, kim erişebiliyor, hangi zararlar oluşuyor ve karar sürecine kim katıldı?” sorularının da sorulması gerektiğini savunmaktadır.
Makine Öğrenmesi Yeşil Altyapı Planlamasında Ne Yapabilir?
Makine öğrenmesi, yeşil altyapı planlamasında büyük ve farklı veri kaynaklarını işleyerek mevcut mekânsal eşitsizlikleri haritalayabilir, çevresel riskleri ve kırılganlıkları tahmin edebilir, farklı planlama senaryolarını değerlendirebilir ve birden fazla amaç arasında önceliklendirme yapılmasına destek olabilir; ancak hangi amacın optimize edilmesi gerektiğini kendi başına belirleyemez.
Yapay zekâ, makine öğrenmesi ve derin öğrenme arasındaki fark
Kaynak çalışma kavramları açık biçimde birbirinden ayırmaktadır.
Yapay zekâ (Artificial Intelligence, AI), algılama, tahmin, akıl yürütme veya karar desteği gibi işlemleri gerçekleştiren hesaplamalı sistemler için kullanılan daha geniş kavramdır.
Makine öğrenmesi (Machine Learning, ML), sınıflandırma, tahmin, kümeleme ve optimizasyon gibi görevler için verilerden örüntüler öğrenen yöntemleri ifade eder.
Derin öğrenme (Deep Learning, DL) ise makine öğrenmesinin bir alt alanıdır ve çalışmanın tartıştığı bağlamda özellikle uzaktan algılama, sokak görüntülerinin analizi ve bitki örtüsü sınıflandırması gibi görüntü tabanlı görevlerde kullanılabilir.
Kaynak makalenin ana odağı ML'dir. AI terimi daha geniş etik ve yönetişim tartışmaları sırasında kullanılmaktadır.
Makine öğrenmesi ile GIS aynı şey midir?
Hayır. Coğrafi Bilgi Sistemleri (Geographic Information Systems, GIS), mekânsal ve öznitelik verilerinin depolanması, işlenmesi, birleştirilmesi ve haritalanmasına yönelik araçlar bütünüdür.
Makine öğrenmesi GIS süreçlerine sınıflandırma, tahmin, yüksek boyutlu veri işleme ve optimizasyon kapasitesi ekleyebilir.
Kaynak çalışma, ML ve AI'nin mekânsal planlamada GIS'in analitik kapasitesini genişletebildiğini tartışmaktadır; fakat basit bir GIS analizinin yeterli olduğu her durumda ML kullanılması gerektiğini savunmamaktadır.
ML hangi durumlarda gerçekten yararlı olabilir?
Kaynak çalışmaya göre makine öğrenmesi özellikle aşağıdaki gereksinimlerin bulunduğu planlama problemlerinde değerli olabilir:
- görüntü sınıflandırması,
- yüksek boyutlu verilerin birlikte işlenmesi,
- doğrusal olmayan ilişkilerin tahmini,
- sürekli veya tekrarlanan izleme,
- çok amaçlı optimizasyon.
Buna karşılık statik, küçük ölçekli veya daha basit problemlerde klasik GIS katman bindirme işlemleri, erişim tamponları veya mesafe göstergeleri yeterli olabilir.
Betimleyici ML nedir?
Betimleyici kullanım, “şu anda kentte ne oluyor?” sorusuna yönelik analizdir.
Örneğin ML:
- ağaç örtüsünün nerede yoğun veya yetersiz olduğunu,
- sokak seviyesinde insanların ne kadar yeşillik görebildiğini,
- hangi mahallelerin yeşil alanlara daha düşük erişime sahip olduğunu,
- ekosistem hizmetlerinin hangi nüfus gruplarına ulaştığını
haritalamaya yardımcı olabilir.
Öngörücü ML nedir?
Öngörücü kullanım gelecekte veya gözlenmeyen koşullarda oluşabilecek durumları tahmin etmeye yöneliktir.
Çalışmada tartışılan örnekler arasında ısı maruziyeti, taşkın riski, bitki örtüsü stresi ve iklimle ilişkili çevresel etkilerin öngörülmesi bulunmaktadır.
Önerici veya kural koyucu ML nedir?
Önerici kullanım yalnız mevcut durumu tanımlamaz veya geleceği tahmin etmez; hangi müdahalenin nerede önceliklendirilmesi gerektiğine ilişkin senaryoları karşılaştırır.
Örneğin bir ağaçlandırma programının:
- ısı azaltma,
- yağmur suyu yönetimi,
- maliyet,
- ekolojik yarar,
- toplumsal eşitlik
gibi birden fazla hedef arasında nasıl dağıtılacağını değerlendirebilir.
Kaynağın özellikle dikkat çektiği nokta burada ortaya çıkar: önerici bir model artık yalnız bilgi üretmemekte, yatırım ve kaynak dağılımını etkileyebilecek seçenekler üretmektedir. Bu nedenle yönetişim denetiminin daha güçlü olması gerekir.
Sokak görüntüleri ve uzaktan algılama
Çalışmada değerlendirilen literatür, sokak görüntülerinin ve uydu veya hava görüntülerinin birlikte kullanılmasının, kent sakinlerinin gerçekten gördüğü yeşilliği yalnız yukarıdan ölçülen bitki örtüsünden ayırmaya yardımcı olabileceğini göstermektedir.
Los Angeles County örneğinde sokak seviyesindeki yeşil alan türleri makine öğrenmesiyle değerlendirilmiş ve sonuçlar mahalle ölçeğindeki sosyoekonomik dezavantaj göstergeleriyle ilişkilendirilmiştir.
Bu sonuçlar Baresi ve Russo'nun gerçekleştirdiği yeni bir deney değildir; kaynak Perspective makalesinin literatürden aktardığı bir uygulama örneğidir.
Green View Index neyi ölçmeye çalışır?
Green View Index yaklaşımı, yeşil alanı yalnız haritadaki alan miktarı olarak değerlendirmek yerine yaya seviyesindeki görünürlük ve deneyim perspektifine yaklaşmayı amaçlar.
Bu yaklaşım yeşilliğin bulunabilirliğinin yanı sıra insanların kentte yürürken ne kadar yeşil çevre gördüğü gibi boyutların incelenmesine yardımcı olabilir.
10 metre çözünürlüklü yeşil alan haritası örneği
Kaynak çalışma, Latin Amerika'daki çeşitli büyük kentler için Sentinel-2 uzaktan algılama görüntüleri ve OpenStreetMap verileri kullanılarak oluşturulan 10 metre çözünürlüklü kentsel yeşil alan haritasını literatürdeki uygulamalara örnek göstermektedir.
Buradaki 10 metre değeri Baresi ve Russo'nun yeni ürettiği veri çözünürlüğü değildir; atıf verilen önceki çalışmaya aittir.
Sosyoekonomik ve çevresel veriler neden birlikte kullanılmalıdır?
Bir bölgede yüksek çevresel risk bulunduğunu bilmek, hangi insanların bu riskten daha fazla etkilendiğini tek başına açıklamayabilir.
Aynı şekilde yalnız gelir, nüfus veya demografik veri de ekolojik hizmetlerin nerede eksik olduğunu göstermez.
Çalışma bu nedenle sosyo-demografik ve çevresel verilerin birlikte değerlendirilmesini önemli görmektedir. Bu yaklaşım yüksek çevresel ve toplumsal kırılganlığın aynı yerde oluştuğu bölgelerin belirlenmesine yardımcı olabilir.
Eşit mesafe neden her zaman eşitlik değildir?
Kaynakta aktarılan araştırmalar, yalnız herkesin yeşil alana aynı fiziksel uzaklıkta olmasını hedeflemenin yanlış öncelikler üretebileceğini göstermektedir.
Örneğin iki mahalle bir parka aynı uzaklıkta olabilir; ancak bir mahallede yoğun ısı maruziyeti, düşük ağaç örtüsü, yetersiz ulaşım, sağlık kırılganlığı veya daha düşük ekonomik olanaklar bulunabilir.
Bu durumda salt mesafe eşitliği, ihtiyaç eşitliği anlamına gelmez.
Gerçekleşmiş erişim nedir?
Gerçekleşmiş erişim (realised access), insanların bir yeşil alana teorik olarak ulaşabilmesinden ziyade o alanı fiilen nasıl kullandığını anlamaya çalışır.
Mobil telefon hareketlilik verileri veya benzeri kaynaklar, basit yarıçap veya yürüme mesafesi modellerinin ötesinde gerçek hareket örüntülerini incelemek için kullanılabilir.
Ancak bu veri türleri yeni bir eşitlik problemi yaratır: cep telefonu veya dijital platform verilerinde toplumun bütün grupları eşit biçimde temsil edilmeyebilir.
Çok amaçlı optimizasyon neyi değiştirebilir?
Yeşil altyapı planlaması çoğu zaman tek bir hedef içermez. Aynı proje:
- ısıyı azaltmaya,
- yağmur suyunu yönetmeye,
- biyolojik çeşitliliği korumaya,
- hava kalitesini iyileştirmeye,
- maliyeti sınırlamaya,
- dezavantajlı topluluklara yarar sağlamaya
çalışabilir.
Çok amaçlı optimizasyon bu hedefler arasındaki ödünleşimleri sayısal olarak karşılaştırmaya yardımcı olabilir. Fakat hangi hedefin daha önemli olduğuna verilen ağırlıklar teknik olarak nötr değildir. Bu ağırlıklar toplumsal ve politik değer tercihleri içerir.
Dünya Sağlık Örgütü'nün yaklaşık 300 metre örneği
Kaynak çalışma senaryo planlamasını açıklarken Dünya Sağlık Örgütü'nün, insanların konutlarından yaklaşık 300 metre mesafe içerisinde kamusal yeşil alana erişebilmesine ilişkin rehberini örnek olarak kullanmaktadır.
ML destekli modeller bu tür eşikleri kullanarak erişim boşluklarını haritalayabilir ve alternatif yerleşim senaryolarını test edebilir.
Ancak yazarlar fiziksel yakınlığın tek başına eşitliği garanti etmediğini vurgulamaktadır. Alanın kalitesi, güvenliği, kullanılabilirliği, farklı yaş grupları ve engellilik durumları açısından erişilebilirliği de değerlendirilmelidir.
Makine Öğrenmesi Neden Tek Başına Adil Bir Planlama Aracı Değildir?
Makine öğrenmesi verilerdeki mevcut örüntüleri öğrenir ve tanımlanan hedefleri optimize eder; tarihsel veriler geçmiş yatırım eşitsizliklerini taşıyorsa veya optimizasyon hedefleri belirli grupların değerlerini dışlıyorsa model bu eşitsizlikleri yeniden üretebilir, büyütebilir veya teknik bir sonuç görüntüsü altında görünmez hale getirebilir.
Algoritmik önyargı nedir?
Algoritmik önyargı, bir modelin belirli kişi veya gruplar için sistematik biçimde farklı veya adaletsiz sonuçlar üretmesine yol açabilen veri, tasarım veya uygulama kaynaklı örüntüleri ifade eder.
Yeşil altyapı bağlamında tarihsel yatırımlar ağırlıklı olarak varlıklı mahallelerde gerçekleştirilmişse, geçmiş veriler bu mahalleleri “başarılı yatırım bölgeleri” olarak gösterebilir.
Bir ML sistemi yalnız bu geçmiş örüntülerden öğrenirse benzer mahalleleri gelecekte de yüksek öncelikli veya “optimal” alanlar olarak seçebilir.
Tarihsel eşitsizlik nasıl geri besleme döngüsüne dönüşebilir?
Kaynak çalışma şu riski tarif etmektedir:
- Tarihsel eşitsizlik eğitim veya planlama verisine girer.
- Model bu verilerden öncelik örüntüleri öğrenir.
- Model belirli bölgelere daha fazla kaynak yönlendirilmesini destekler.
- Kaynak dağılımı mevcut mekânsal örüntüyü güçlendirir.
- Gelecekte toplanan yeni veriler güçlenmiş örüntüyü yeniden kaydeder.
- Bu yeni veri, önceki model kararlarının doğru olduğu izlenimini oluşturabilir.
Bu durum geri besleme döngüsü (feedback loop) olarak adlandırılır. Sorun algoritmanın yalnız bir kez yanlış karar vermesi değil, kararın gelecekteki veriyi değiştirerek kendi varsayımını güçlendirmesidir.
Dağılım kayması nedir?
Dağılım kayması (distribution shift), modelin geliştirildiği veri koşulları ile daha sonra kullanılacağı koşulların birbirinden farklı hale gelmesidir.
Bir model belirli bir şehirde, mevsimde, sensör türünde veya politika ortamında başarılı olabilir. Aynı model başka bir şehirde, mevsimde veya veri toplama sisteminde aynı performansı göstermeyebilir.
Bu nedenle belirli bir test ortamında elde edilen yüksek doğruluk, gerçek planlama ortamında aynı doğruluğun korunacağı anlamına gelmez.
Vekil değişken nedir?
Vekil değişken (proxy variable), doğrudan kullanılmayan bir özelliği dolaylı biçimde temsil edebilen değişkendir.
Örneğin modelde doğrudan gelir veya etnik köken kullanılmasa bile konut değeri, mahalle, kira biçimi, geçmiş yatırım seviyesi veya başka mekânsal değişkenler bu özelliklerle güçlü biçimde ilişkili olabilir.
Bu nedenle “hassas değişkeni modelden çıkarmak” tek başına eşitlik sağlamayabilir.
Etiket önyargısı nedir?
Etiket önyargısı (label bias), modelin doğru kabul ettiği hedef veya kayıtların toplumsal süreçlerde eşitsiz biçimde üretilmesinden kaynaklanabilir.
Örneğin şikâyet kayıtlarının az olması bir mahallede sorun bulunmadığı anlamına gelmeyebilir. Düşük gelirli veya dışlanmış toplulukların bildirim sistemlerine erişimi ya da güveni daha düşük olabilir.
Bu tür veriler bağlam dikkate alınmadan kullanılırsa “daha az şikâyet = daha az ihtiyaç” şeklinde hatalı bir model mantığı oluşabilir.
Kalibrasyon problemi nedir?
Kalibrasyon, bir modelin belirttiği güven düzeyinin gerçek başarı olasılığıyla ne kadar uyumlu olduğunu ifade eder.
Bir model bir tahmin için çok yüksek güven bildiriyor fakat benzer yüksek güvenli tahminlerin önemli bölümü yanlış çıkıyorsa model yanlış kalibre edilmiş olabilir.
Kaynak çalışma, yüksek güvenli ML çıktılarının her zaman gerçek planlama koşullarında aynı güvenilirliği taşımayabileceğine dikkat çekmektedir.
Teknik çözümler yeterli midir?
Belirsizlik nicelleştirmesi, açıklanabilir yapay zekâ, duyarlılık analizi ve adalet-farkındalıklı modelleme gibi teknik yöntemler riski azaltabilir.
Ancak kaynak çalışmanın kritik ayrımı şudur: Bu araçlar eşitliğin ne olması gerektiğine kendileri karar veremez.
Örneğin aşağıdaki hedeflerin her biri “adil” olarak savunulabilir:
- herkesin yeşil alana mesafesini eşitlemek,
- en kırılgan gruplara öncelik vermek,
- toplam ekosistem hizmetini en yüksek yapmak,
- maliyeti en düşük tutmak,
- kültürel öneme sahip alanları korumak.
Bu hedefler aynı mekânsal sonucu üretmek zorunda değildir. Dolayısıyla eşitlik kriteri toplumsal ve kurumsal karar gerektirir.
Dijital veriler toplumun tamamını temsil eder mi?
Hayır. Kaynak çalışma mobil telefon kayıtları, sokak görüntüleri, sosyal medya ve platform tabanlı hareketlilik verilerinin bütün kentsel nüfusun eksiksiz temsili olarak kabul edilmemesi gerektiğini belirtmektedir.
Yaşlılar, düşük gelirli gruplar, çocuklar, belgesiz göçmenler ve dijital erişimi sınırlı insanlar bu veri kaynaklarında eksik veya farklı biçimde temsil edilebilir.
Yüksek çözünürlüklü konum ve hareketlilik verileri ayrıca gizlilik, rıza, veri sahipliği ve konum gözetimi sorunları doğurabilir.
Mevsimsel görüntü önyargısı nasıl oluşur?
Sokak görüntülerinden yeşillik ölçülürken görüntünün hangi mevsimde çekildiği sonucu etkileyebilir. Yaprakların yoğun olduğu dönem ile yapraksız dönem aynı fiziksel alan için farklı yeşillik ölçümleri oluşturabilir.
Bu nedenle modelin teknik başarısı yalnız algoritmaya değil veri toplama zamanına ve kapsama özelliklerine de bağlıdır.
Neo-colonial intelligence kavramı
Kaynak çalışma “neo-colonial intelligence” kavramını, kentsel yönetişimde yapay zekâ ve makine öğrenmesinin bazı başarısızlıklarını yalnız teknik hatalar olarak değil, tarihsel güç ilişkileri bağlamında değerlendirmek için kullanmaktadır.
Yazarların tartışmasına göre veri altyapılarını, platformları ve analitik kapasiteyi kontrol eden kurumların hangi bilginin görünür olacağını belirlemesi; veri açısından zengin ve veri açısından yoksul bölgeler arasındaki mevcut güç dengesizliklerini güçlendirebilir.
Bu kavram, her ML uygulamasının sömürgeci olduğu anlamına gelmez. Çalışmanın vurguladığı risk, veri toplama ve karar verme yapılarındaki tarihsel eşitsizliklerin teknoloji aracılığıyla sürdürülmesidir.
Veri sömürgeciliği tartışması
Çalışma ayrıca davranışsal ve mekânsal verilerin dış aktörler tarafından toplanması ve kontrol edilmesini data colonialism tartışmasıyla ilişkilendirmektedir.
Toplulukların yalnız veri üreten nesneler haline gelmesi, ancak veri üzerinde kontrol veya karar gücüne sahip olmaması temel sorundur.
Kaynak çalışmanın önerdiği yönlerden biri, topluluk tarafından oluşturulan ve yerel kurumlar tarafından yönetilen veri sistemlerinin geliştirilmesidir.
Epistemik dışlanma ne demektir?
Epistemik dışlanma, belirli bilgi biçimlerinin karar süreçlerinde yeterince tanınmaması, temsil edilmemesi veya meşru bilgi olarak görülmemesidir.
Yerel ve Yerli toplulukların araziyle ilişkileri, kültürel anlamlar, geleneksel bakım sorumlulukları, manevi değerler, deneyimsel bilgiler ve yer temelli tarihleri her zaman standart bir tablo sütununa veya model değişkenine çevrilemez.
Bu bilgilerin kolay ölçülememesi onların bilimsel veya planlama açısından değersiz olduğunu göstermez.
Tumbes Havzası örneği neden dikkatle yorumlanmalıdır?
Kaynak çalışma Peru'daki Tumbes Havzası örneğini Yerli ve yerel bilginin yeterince tanınmadığı bir yeşil altyapı yönetişimi vakası olarak tartışmaktadır.
Ancak yazarlar önemli bir ayrım yapmaktadır: Tumbes örneği doğrudan bir ML başarısızlığı değildir. Daha geniş bir yeşil altyapı yönetişim sorununun örneğidir.
Bu ayrım korunmalıdır; çünkü makine öğrenmesine ait olmayan bir planlama başarısızlığını “AI yaptı” şeklinde sunmak kaynak çalışmayı bozacaktır.
Sundarbans örneği
Sundarban Adalarıyla ilişkili ML destekli haritalama çalışmalarında, kırılganlık ve müdahale önceliklerinin belirlenmesinde topluluk temelli bilginin yeterince temsil edilmemesi kaynakta tartışılan örneklerden biridir.
Buradaki temel ders, yalnız biyofiziksel ve sosyoekonomik değişkenlerin hesaplanmasının yerel bilgi gereksinimini ortadan kaldırmamasıdır.
Mumbai mangrov restorasyonu örneği
Kaynak makale, Mumbai'deki yaklaşık on yıllık mangrov restorasyonu değerlendirmesini de tartışmaktadır.
Atıf verilen çalışmada Google Earth verileri ve Sentinel/Landsat görüntülerine uygulanan Random Forest sınıflandırması kullanılmış ve değerlendirilen 25 restorasyon alanının 13'ünün restorasyon hedeflerine ulaşmadığı bildirilmiştir.
Kaynak Perspective, yetersiz topluluk önceliklendirmesinin ve özellikle Koli topluluğunun bilgisinin yeterince dikkate alınmamasının bu başarısızlıklarla ilişkili faktörlerden biri olarak değerlendirildiğini aktarmaktadır.
Bu 13/25 sonucu Baresi ve Russo'nun yeni saha bulgusu değildir; tartıştıkları önceki araştırmaya aittir.
Yerel bilgiyi yalnız “veriye dönüştürmek” yeterli midir?
Hayır. Kaynak çalışmanın önemli noktalarından biri, yerel ve Yerli bilginin yalnız yeni bir veri sütununa çevrilmesinin katılımcı planlama anlamına gelmediğidir.
Kültürel anlam, yerle kurulan ilişki veya topluluk sorumluluğu gibi kavramlar standartlaştırıldığında anlamlarının bir bölümü kaybolabilir.
Bu nedenle yazarlar bilgi ortak üretimi, topluluk tabanlı doğrulama ve Yerli veri yönetişimini gerekli görmektedir.
Şeffaflık neden yalnız model kodunu açıklamak değildir?
Teknik şeffaflık modelin nasıl çalıştığının açıklanması açısından değerlidir; ancak planlama kararlarında tek başına yeterli değildir.
Aşağıdaki sorular da şeffaflığın parçasıdır:
- Veriler nereden geldi?
- Kimler veride eksik temsil ediliyor?
- Hangi değişkenler seçildi?
- Modelin amacı kim tarafından belirlendi?
- Hangi ödünleşimler kabul edildi?
- Belirsizlik nasıl raporlandı?
- Bir topluluk model sonucuna nasıl itiraz edebilir?
- Nihai karardan kim sorumludur?
Pratik şeffaflık mekanizmaları
Kaynak çalışma aşağıdaki uygulamaların önemini belirtmektedir:
- veri kümesi dokümantasyonu,
- model dokümantasyonu,
- karar kayıtları,
- belirsizlik raporlaması,
- etkilenen toplulukların model varsayımlarını ve sonuçlarını sorgulayabilmesi.
Çalışmanın Yöntemi ve Bulguları
Bu çalışma deneysel bir “yöntem ve sonuç” makalesi olmadığı için bu bölüm klasik laboratuvar araştırmalarındaki örneklem, kontrol grubu, cihaz, hiperparametre veya p değeri biçiminde okunmamalıdır. Yöntem, yakın dönem yeşil altyapı, ML, mekânsal planlama, çevresel adalet ve yapay zekâ yönetişimi literatürünün Perspective formatında kavramsal sentezidir.
Çalışmanın üç temel amacı
Yazarlar Perspective çalışmasının üç temel amacını tanımlamaktadır:
- Makine öğrenmesinin eşitlik odaklı yeşil altyapı planlamasını hangi yollarla destekleyebileceğini açıklamak.
- Teknik ve sosyoekonomik riskleri belirlemek.
- Meşru, hesap verebilir ve eşitlik odaklı planlamayı destekleyebilecek etik ve yönetişim yollarını ortaya koymak.
Literatürde belirlenen temel boşluk
Yazarların belirlediği temel boşluk, ML destekli yeşil altyapı çözümlerini gerçek dünya uygulamasındaki teknik belirsizliklerle ve planlama kararlarının meşruiyeti, hesap verebilirliği ve toplumsal güveni için gereken yönetişim koşullarıyla birlikte ele alan bütünleşik bir yaklaşımın eksikliğidir.
Başka bir ifadeyle sorun yalnız “ML yeşil alanı nerede önerir?” değildir. Asıl mesele, modelin hangi bilgiyle bunu önerdiği, hangi grupları temsil ettiği, hangi değerleri optimize ettiği ve kararın kim tarafından denetlenebildiğidir.
ML kullanımının üç planlama işlevi
| İşlev | Temel soru | Örnek rol | Yönetişim açısından anlamı |
|---|---|---|---|
| Betimleyici | Mevcut durum nedir? | Erişim, bitki örtüsü, görünür yeşillik veya ekosistem hizmeti dağılımını haritalamak. | Mevcut eşitsizlikleri görünür kılabilir. |
| Öngörücü | Ne olabilir? | Isı, taşkın, bitki stresi veya başka çevresel kırılganlıkları tahmin etmek. | Tahmin hataları, veri değişimi ve kalibrasyon dikkatle izlenmelidir. |
| Önerici | Ne yapılmalı? | Yer seçimi, senaryo karşılaştırması ve yatırım önceliklendirmesi. | Kaynak dağılımını doğrudan etkileyebildiği için daha güçlü kamusal ve kurumsal denetim gerektirir. |
Kaynak Tablo 1: ML uygulamaları, eşitlik değeri, risk ve yönetişim koruması
| ML kullanımı / uygulaması | Planlama işlevi | Eşitlik açısından değeri | Başlıca risk | Yönetişim koruması |
|---|---|---|---|---|
| Sokak görüntüsü veya uzaktan algılama sınıflandırması | Betimleyici haritalama | Ağaç örtüsü, görünürlük veya maruziyetteki eşitsiz dağılımı ortaya çıkarabilir. | Mevsim, sensör veya kapsama kaynaklı önyargı. | Veri kümesi kontrolleri, saha doğrulaması (ground-truthing), belirsizlik raporlaması. |
| Regresyon, Random Forest veya mekânsal tahmin | Öngörücü kırılganlık analizi | Isı, taşkın veya çevresel risk alanlarının belirlenmesine yardımcı olur. | Vekil değişkenler gelir, ırk/etnik yapı, mülkiyet/kullanım durumu veya geçmiş yatırımları dolaylı biçimde kodlayabilir. | Duyarlılık testleri, eşitlik kontrolleri ve değişken seçiminde şeffaflık. |
| Hareketlilik veya sosyal medya verisi analizi | Gerçekleşmiş erişim ve kullanım | Basit mesafe tamponlarının ötesine geçerek insanların gerçek mekânsal davranışlarına yaklaşabilir. | Gizlilik riskleri ve dijital olarak marjinalleştirilmiş grupların yetersiz temsili. | Toplulaştırma, rıza korumaları ve veri minimizasyonu. |
| Çok amaçlı optimizasyon | Önerici yer seçimi ve önceliklendirme | Eşitlik, maliyet ve ekosistem hizmetleri arasındaki ödünleşimleri test edebilir. | Optimizasyon kullanılan değer tercihlerini görünmez hale getirebilir. | Kamusal müzakere, karar kayıtları, AIA ve SEA incelemesi. |
| Katılımcı veya topluluk verisinin bütünleştirilmesi | Doğrulama ve yorumlama | Yerel ve bağlama özgü bilgiyi planlama sürecine taşır. | Sembolik katılım (tokenism) veya bilgiyi dar veri kategorilerine indirgeme riski. | Ortak tasarım, FPIC, CARE/OCAP ve topluluk doğrulaması. |
Ground-truthing ne demektir?
Ground-truthing, uzaktan algılama, görüntü sınıflandırması veya başka model çıktılarının gerçek sahadaki gözlemler veya güvenilir referans verilerle karşılaştırılmasıdır.
Örneğin uydu görüntüsünün bir alanı ağaç örtüsü olarak sınıflandırması, gerekirse yerinde gözlem veya daha güvenilir referans veriyle kontrol edilebilir.
Veri minimizasyonu nedir?
Veri minimizasyonu, bir analiz veya hizmet için gerçekten gerekli olmayan kişisel veya hassas verilerin toplanmaması ve kullanılmaması ilkesidir.
Özellikle hareketlilik verisi gibi yüksek çözünürlüklü konumsal bilgilerin kullanıldığı planlamada gizlilik riskini azaltmak açısından önemlidir.
Planlama senaryolarında istenmeyen sonuçların hesaba katılması
Kaynak çalışma, ML destekli senaryoların yalnız beklenen olumlu sonuçları değil potansiyel olumsuz etkileri de değerlendirmesini önermektedir.
Yeşil altyapının olası yararları ile bağlama göre oluşabilecek zararlar aynı karar yapısında ele alınabilir.
Örneğin belirli ağaç türleri gölge ve soğutma sağlayabilirken bazı koşullarda alerjen maruziyeti gibi istenmeyen sonuçlar da doğurabilir.
Bu nedenle “ekosistem hizmetini maksimum yap” biçimindeki tek amaçlı optimizasyonun her durumda yeterli olduğu kabul edilmemelidir.
Algoritmik Etki Değerlendirmesi nedir?
Algoritmik Etki Değerlendirmesi (Algorithmic Impact Assessment, AIA), bir algoritmik sistem kullanılmadan veya kullanım sırasında sistemin insanlar ve topluluklar üzerindeki potansiyel etkilerini, verilerini, karar mantığını, eşitlik risklerini ve hesap verebilirlik mekanizmalarını sistematik biçimde değerlendirmeye yönelik yönetişim yaklaşımıdır.
Kaynak çalışmaya göre AIA süreçleri:
- ML kullanımının gerçekten uygun olup olmadığını inceleyebilir,
- dağıtımsal ve prosedürel eşitliği değerlendirebilir,
- model ve eğitim verisi hakkında açıklama talep edebilir,
- kamusal geri bildirim toplayabilir,
- modelin daha sonra izlenmesi ve iyileştirilmesi için süreç oluşturabilir.
NIST AI Risk Management Framework nasıl kullanılıyor?
Kaynak çalışma NIST AI Risk Management Framework'ü yaşam döngüsü boyunca sosyo-teknik risklerin ele alınmasına ilişkin mevcut bir yönetişim örneği olarak kullanmaktadır.
Çerçevenin öne çıkan işlevleri:
- Govern: yönetişim yapısını kurmak,
- Map: bağlamı ve riskleri haritalamak,
- Measure: riskleri değerlendirmek ve ölçmek,
- Manage: belirlenen riskleri yönetmek.
Perspective makalesi NIST çerçevesini kendisinin geliştirdiği yeni bir yöntem olarak sunmamaktadır; eşitlikçi GI planlamasında kullanılabilecek mevcut yönetişim araçlarından biri olarak tartışmaktadır.
AIA ve Stratejik Çevresel Değerlendirme Birlikte Nasıl Kullanılabilir?
Kaynak çalışmaya göre Stratejik Çevresel Değerlendirme (SEA), plan ve program düzeyinde alternatifleri, toplumsal katılımı, kümülatif etkileri ve uzun dönem izlemesini organize eden geniş planlama çerçevesini sağlayabilir; AIA ise bu çerçeve içinde kullanılan makine öğrenmesi veya algoritmik bileşenin veri, eşitlik, şeffaflık ve hesap verebilirlik risklerine daha ayrıntılı odaklanabilir.
SEA nedir?
Stratejik Çevresel Değerlendirme (Strategic Environmental Assessment, SEA), tek bir projenin ayrıntılarından daha üst düzeyde politika, plan ve programların çevresel ve toplumsal etkilerini değerlendirmek için kullanılan stratejik bir süreçtir.
SEA'nın önemli yönlerinden biri alternatif senaryoları, kümülatif etkileri, farklı politika sektörlerini, uzun dönem sonuçlarını ve kamusal katılımı birlikte ele alabilmesidir.
SEA ile EIA arasındaki fark
Çevresel Etki Değerlendirmesi (Environmental Impact Assessment, EIA) çoğunlukla belirli bir proje ölçeğindeki etkilerin değerlendirilmesine odaklanırken, SEA politika, plan ve program düzeyinde daha geniş stratejik alternatifleri inceleyebilir.
Kaynak çalışma bu nedenle ML destekli yeşil altyapı planlamasının yalnız tek bir proje değerlendirmesine sıkıştırılmaması gerektiğini tartışmaktadır.
AIA neden SEA'nın yerine geçmez?
AIA algoritmanın risklerini değerlendirebilir; ancak arazi sahipliği, planlama mevzuatı, kurumlar arası yetki paylaşımı, satın alma kuralları, bütçe veya geniş çevresel etkiler gibi konular yalnız algoritma düzeyinde çözülemez.
Kaynak çalışmanın önerdiği ilişki tamamlayıcılıktır: SEA geniş stratejik planlama kabını oluşturabilir, AIA ise o yapı içinde kullanılan algoritmik karar desteğine odaklanabilir.
Katılım ve ortak tasarım
Kaynak çalışmaya göre toplum ve paydaş katılımı projenin sonunda yalnız hazır bir sonucun halka anlatılması biçiminde uygulanmamalıdır.
Topluluklar mümkün olduğunca erken aşamada:
- hedeflerin,
- kısıtların,
- başarı ölçütlerinin,
- kabul edilebilir ödünleşimlerin,
- kabul edilemez sonuçların
belirlenmesine katılmalıdır.
Örneğin yerinden edilme baskısı veya kültürel değer kaybı gibi sonuçlar, teknik optimizasyonun dışında bırakılmış “sonradan düşünülecek” konular olmamalıdır.
Vatandaş panelleri ve müzakereci süreçler
Yazarlar vatandaş panelleri veya paydaş danışma kurulları gibi müzakereci mekanizmaların stratejik planlama süreçlerine dahil edilebileceğini tartışmaktadır.
Bu yapıların amacı topluluğun yalnız veri sağlaması değil, modelin varsayımlarını, ürettiği sonuçları ve yararların nasıl dağıtılacağını etkileyebilmesidir.
CARE ilkeleri nedir?
CARE Principles for Indigenous Data Governance, Yerli veri yönetişiminin yalnız “verinin açık olması” üzerinden değil, topluluk hakları ve kolektif yarar üzerinden değerlendirilmesini amaçlayan ilkeler bütünüdür.
- C — Collective Benefit: Kolektif yarar.
- A — Authority to Control: Kontrol yetkisi.
- R — Responsibility: Sorumluluk.
- E — Ethics: Etik.
Kaynak çalışma CARE ilkelerini Yerli bilgi ve verilerinin ML destekli planlamada yönetilmesi için yararlanılabilecek mevcut çerçevelerden biri olarak göstermektedir.
OCAP nedir?
OCAP, Yerli veri yönetişiminde kullanılan dört temel ilkenin baş harflerinden oluşur:
- Ownership: Sahiplik.
- Control: Kontrol.
- Access: Erişim.
- Possession: Bulundurma/zilyetlik.
Bu ilkeler veriyi kimin topladığı kadar, veri üzerinde kimin yetkiye ve erişim hakkına sahip olduğu sorusunu da gündeme getirir.
FPIC nedir?
Free, Prior and Informed Consent (FPIC), Türkçede genel olarak Özgür, Önceden ve Bilgilendirilmiş Onam olarak ifade edilebilir.
FPIC, Yerli halkların haklarını etkileyebilecek uygulamalarda kararın baskı olmadan, uygulama başlamadan önce ve yeterli bilgi sağlanarak alınmasına ilişkin bir ilkedir.
Kaynak çalışma FPIC'yi UNDRIP gibi uluslararası insan hakları çerçeveleriyle ilişkili olarak ele almaktadır.
UNDRIP nedir?
United Nations Declaration on the Rights of Indigenous Peoples (UNDRIP), Birleşmiş Milletler Yerli Halkların Hakları Bildirgesi'dir.
Kaynak çalışma UNDRIP'i, Yerli toplulukları etkileyen yeşil altyapı ve veri yönetişimi kararlarında hak temelli katılımın önemini açıklayan uluslararası çerçevelerden biri olarak anmaktadır.
Kaynak Şekil 1'in bilimsel yapısı
Kaynak çalışmanın Şekil 1'i, eşitlikçi yeşil altyapı planlamasında ML'nin bağımsız karar verici olarak değil, sosyo-teknik yönetişim içinde çalışan bir bileşen olarak konumlandırılması gerektiğini göstermektedir.
Şekildeki geri besleme döngüsü neyi anlatır?
Kaynak Şekil 1'de uygulanan yeşil altyapının sonuçlarının gelecekteki veri, model varsayımları ve planlama önceliklerine geri dönmesi gerektiği belirtilmektedir.
Bu, planlamanın “model bir kez çalıştı ve karar tamamlandı” yaklaşımıyla bitmemesi gerektiği anlamına gelir.
Bir proje uygulandıktan sonra gerçekten:
- hangi toplulukların yararlandığı,
- hangi grupların dışarıda kaldığı,
- beklenmeyen zararların oluşup oluşmadığı,
- erişim ve kullanım örüntülerinin nasıl değiştiği
izlenmeli ve sonraki modelleme döngüsüne geri aktarılmalıdır.
Çalışmanın önerdiği dört uygulama ilkesi
| İlke | Anlamı |
|---|---|
| 1. ML kullanım türünü açıkça ayır | Betimleyici, öngörücü ve önerici uygulamalar aynı karar yetkisine ve aynı yönetişim riskine sahip değildir. |
| 2. Veri, varsayım ve belirsizliği belgele | Verinin kaynağı, kapsama sınırları, model varsayımları ve belirsizlikler görünür olmalıdır. |
| 3. Eşitlik ödünleşimlerini toplumla tartış | Hangi grupların, yararların ve risklerin önceliklendirileceği yalnız algoritmanın amaç fonksiyonuna bırakılmamalıdır. |
| 4. Gerçek sonuçları zaman içinde izle | Uygulanan yeşil altyapının eşitsizliği gerçekten azaltıp azaltmadığı izlenmeli ve sonuçlar gelecekteki planlamaya geri beslenmelidir. |
Çalışmanın güçlü yönü nedir?
Çalışmanın temel güçlü yönü makine öğrenmesini yalnız teknik performans perspektifinden değerlendirmemesidir.
Veri kalitesi, model doğruluğu ve optimizasyon kapasitesinin yanında:
- planlama meşruiyeti,
- kamusal katılım,
- kültürel bilgi,
- gizlilik,
- veri egemenliği,
- hesap verebilirlik,
- kararlara itiraz edebilme
gibi yönetişim unsurlarını aynı çerçeve içinde ele almaktadır.
Çalışmanın temel sınırlılıkları
Perspective türü nedeniyle çalışma yeni bir saha müdahalesi, kontrollü deney, deneysel örneklem veya özgün ML modeli sunmamaktadır.
Bu nedenle kaynak:
- bir ML mimarisinin diğerinden daha yüksek doğruluğa sahip olduğunu deneysel olarak göstermemektedir,
- belirli bir algoritma için yeni doğruluk, F1, AUC veya hata değeri raporlamamaktadır,
- yeni bir veri kümesi analiz etmemektedir,
- önerilen yönetişim çerçevesinin kontrollü bir saha uygulamasında eşitsizliği belirli bir yüzde azalttığını göstermemektedir,
- bütün kentler için tek bir evrensel eşitlik metriği tanımlamamaktadır.
Çalışmanın katkısı bunların yerine mevcut teknik ve yönetişim literatürünü birbiriyle ilişkilendiren kavramsal ve planlama odaklı bir sentez sunmasıdır.
Çalışmanın desteklediği sonuçlar
- ML büyük ve karmaşık kentsel veri kümelerini işlemek için yararlı bir karar destek kapasitesi sağlayabilir.
- ML mevcut yeşil alan ve ekosistem hizmeti eşitsizliklerinin haritalanmasına yardımcı olabilir.
- ML çevresel kırılganlıkların tahmininde ve planlama senaryolarının karşılaştırılmasında kullanılabilir.
- Çok amaçlı optimizasyon eşitlik, maliyet ve ekosistem hizmetleri arasındaki ödünleşimleri görünür hale getirebilir.
- Geçmiş eşitsizlikleri taşıyan veri, yeni ML destekli planlama kararlarında aynı eşitsizliklerin yeniden üretilmesine neden olabilir.
- Dijital veri kümeleri kentsel nüfusun tamamını eşit biçimde temsil etmeyebilir.
- Teknik eşitlik araçları, toplumsal eşitlik hedeflerini kendiliğinden belirleyemez.
- Yerli ve yerel bilginin planlamaya katılması yalnız veri çıkarımı olarak değil, bilgi ortak üretimi ve veri yönetişimi olarak ele alınmalıdır.
- ML destekli planlamada şeffaflık, katılım, izleme ve hesap verebilirlik mekanizmaları gereklidir.
- Makine öğrenmesinin yeşil altyapı planlamasındaki rolü karar desteği olarak kalmalı; sorumluluk planlama kurumları, toplum ve yönetişim süreçlerinde bulunmalıdır.
Çalışmanın desteklemediği sonuçlar
Kaynak çalışma makine öğrenmesinin yeşil altyapı planlamasını otomatik olarak adil hale getirdiğini söylememektedir.
Makine öğrenmesinin insan katılımının yerini alması gerektiğini savunmamaktadır.
ML kullanıldığında yeşil altyapı yatırımlarının kesin olarak daha başarılı olacağını kanıtlamamaktadır.
Her planlama probleminde ML kullanımının klasik GIS veya daha basit yöntemlerden üstün olduğunu göstermemektedir.
Yerli veya yerel bilginin her zaman sayısal modele eksiksiz biçimde çevrilebileceğini öne sürmemektedir.
AIA, SEA, CARE, OCAP veya FPIC gibi çerçevelerin tek başlarına bütün eşitlik problemlerini çözeceğini iddia etmemektedir.
Makine öğrenmesi çıktısının nihai planlama kararı olarak kabul edilmesi gerektiğini savunmamaktadır.
Genel sonuç
Çalışmanın ana mesajı teknoloji karşıtlığı değildir. Makine öğrenmesinin kapsamlı veri işleme, haritalama, tahmin, senaryo analizi ve çok amaçlı optimizasyon gibi güçlü yeteneklerinin yeşil altyapı planlamasına önemli katkılar sağlayabileceği kabul edilmektedir.
Ancak algoritmanın hesaplama gücü ile planlama kararının toplumsal meşruiyeti aynı şey değildir.
Bir model teknik açıdan mükemmel çalışsa bile yanlış hedefi optimize edebilir. Veri bilimsel olarak temiz görünse bile toplumun bazı kesimlerini temsil etmeyebilir. Bir harita mekânsal açıdan doğru olsa bile kültürel değeri görünmez bırakabilir. Bir optimizasyon en yüksek toplam faydayı sağlayabilirken en kırılgan topluluğun ihtiyacını geri plana atabilir.
Bu nedenle eşitlikçi yeşil altyapı planlamasında asıl soru yalnız “Makine öğrenmesi ne kadar iyi tahmin yapıyor?” değildir. Aynı zamanda “Neyi optimize ediyor, hangi veriye güveniyor, kim temsil ediliyor, kim karar veriyor, kim hesap sorabiliyor ve uygulamanın gerçek sonuçları daha sonra nasıl izleniyor?” sorularının da yanıtlanması gerekir.
Yazarların yaklaşımında makine öğrenmesi nihai karar verici değil, şeffaf, katılımcı, sorgulanabilir ve periyodik olarak yeniden değerlendirilen sosyo-teknik planlama sisteminin bir bileşenidir.
Kaynak ve Yöntem Notu
Özgün başlık: Can Machine Learning Support Planning for Equitable Green Infrastructure? A Perspective on Opportunities, Risks, and Ethical Pathways
Yazarlar: Umberto Baresi; Alessio Russo.
Yazar sırası: Kaynakta verildiği biçimiyle Umberto Baresi birinci, Alessio Russo ikinci yazardır.
Birinci kurum: School of Architecture and Built Environment, Faculty of Engineering, Queensland University of Technology, Brisbane 4000, Australia.
İkinci kurum: Centre for Environment and Society, Queensland University of Technology, Brisbane 4000, Australia.
Üçüncü kurum: IUCN Commission on Environmental, Economic and Social Policy, 1196 Gland, Switzerland. Bu bağlantı Umberto Baresi'ye aittir.
Sorumlu yazar: Umberto Baresi.
Eşit katkı / eş birinci yazarlık: Kaynakta böyle bir bildirim bulunmamaktadır.
Yayın türü: Perspective.
Dergi: Urban Science.
Yayıncı: MDPI.
Cilt / sayı / makale numarası: 10 / 7 / 377.
DOI: 10.3390/urbansci10070377.
Gönderim tarihi: 15 Nisan 2026.
Revizyon tarihi: 19 Haziran 2026.
Kabul tarihi: 26 Haziran 2026.
Yayın tarihi: 2 Temmuz 2026.
Akademik editör: Jianming Cai.
Lisans: Creative Commons Attribution (CC BY).
Resmî yayın bağlantısı: https://www.mdpi.com/2413-8851/10/7/377
DOI bağlantısı: https://doi.org/10.3390/urbansci10070377
Finansman: Yazarlar araştırmanın dış finansman almadığını bildirmiştir.
Kurumsal etik kurul: Uygulanabilir değil olarak bildirilmiştir.
Bilgilendirilmiş onam: Uygulanabilir değil olarak bildirilmiştir.
Veri erişilebilirliği: Kaynak makalede yeni veri oluşturulmadığı veya analiz edilmediği açıkça belirtilmiştir. Bu nedenle çalışma özgün bir veri kümesi veya deneysel veri deposu sunmamaktadır.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını beyan etmiştir.
Yazar katkıları: Kavramsallaştırma Umberto Baresi ve Alessio Russo tarafından; ilk taslak hazırlama ve gözden geçirme/düzenleme iki yazar tarafından gerçekleştirilmiştir. Görselleştirme Umberto Baresi tarafından yapılmıştır. İki yazar yayımlanan sürümü okuyup onaylamıştır.
Yapay zekâ kullanım bildirimi: Yazarlar makale hazırlanırken Microsoft Copilot (GPT-5 chat model) ve ChatGPT'nin (OpenAI, GPT-5 chat model) yalnız prova okuma ve dilbilgisi iyileştirmesi amacıyla kullanıldığını bildirmiştir. Çıktıların yazarlar tarafından gözden geçirilip düzenlendiği ve yayın içeriğinin sorumluluğunun yazarlarda olduğu belirtilmiştir.
Bilimsel yöntem niteliği: Çalışma yeni deneysel veri toplama, saha deneyi veya özgün ML modeli geliştirme çalışması değildir. Yakın dönem literatüründen yararlanan, planlama odaklı bir Perspective sentezidir.
Merkezi kavramsal çerçeve: ML'nin yeşil altyapı planlamasında betimleyici, öngörücü ve önerici işlevleri; bunların eşitlik değeri ve teknik/toplumsal riskleri; algoritmik önyargı ve mekânsal adaletsizlik; Yerli ve yerel bilgi; şeffaflık ve hesap verebilirlik; AIA, SEA, CARE, OCAP, FPIC ve katılımcı ortak tasarım süreçleri.
Formül ve istatistik notu: Kaynak makale kendi araştırması için merkezi matematiksel denklem, istatistiksel hipotez testi, p değeri, güven aralığı, deneysel performans metriği veya model doğruluk değeri sunmamaktadır. Bu nedenle Verianla metnine kaynak dışı formül veya istatistik eklenmemiştir.
Tablo aktarımı: Kaynak Tablo 1'deki beş ML uygulama kategorisi, planlama işlevi, eşitlik değeri, ana risk ve yönetişim korumasıyla birlikte Türkçeye aktarılmıştır.
Şekil aktarımı: Kaynak Şekil 1, özgün görselin kopyası yapılmadan bilimsel ilişkileri koruyan bağımsız bir inline SVG olarak yeniden oluşturulmuştur. Şema nicel veri veya deney sonucu değildir.
Temel yorum sınırı: Makalede verilen Los Angeles, Barcelona, Bronx, Latin Amerika kentleri, Çin, Tumbes, Sundarbans, Mumbai ve diğer örnekler Baresi ve Russo'nun gerçekleştirdiği yeni deneyler değildir. Bunlar Perspective çalışmasının tartıştığı önceki literatür örnekleridir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir