


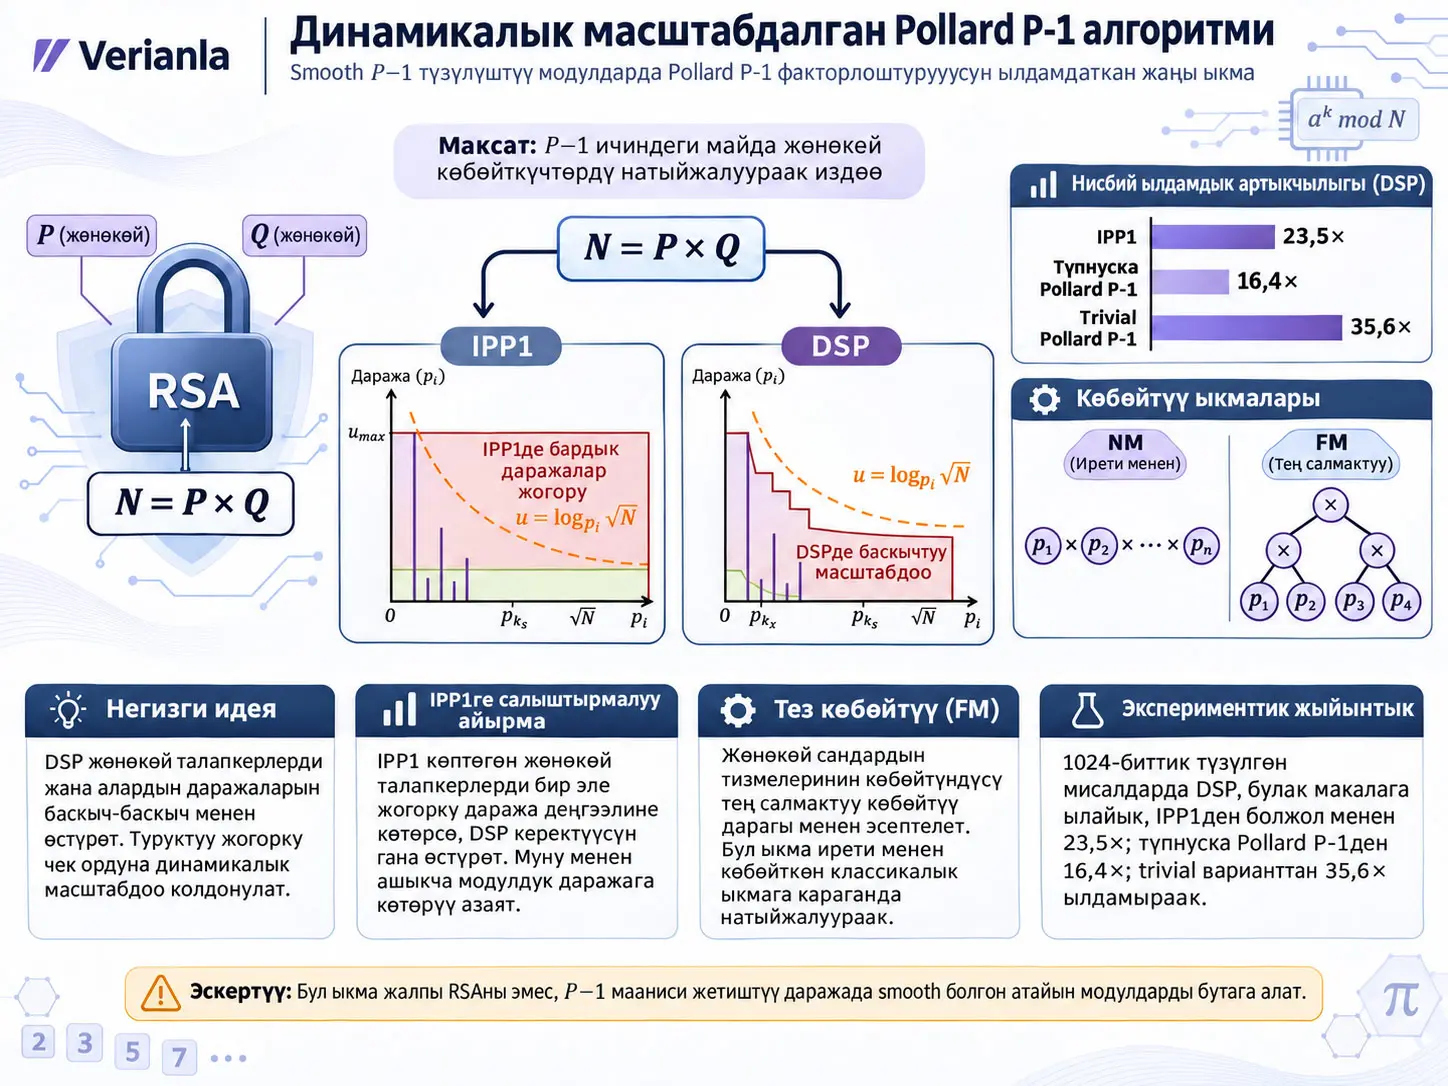
Dynamic Scaling Pollard’s P-1 Algorithm (DSP), Pollard P-1 атайын максаттагы бүтүн сандарды факторлорго ажыратуу ыкмасын жөнөкөй сан талапкерлерин жана алардын зарыл даражаларын баскыч-баскыч чоңойто тургандай кылып кайра уюштурган алгоритмдин варианты. Изилдөө өзгөчө RSA модулу \(N=PQ\) ичиндеги жөнөкөй көбөйткүч \(P\) үчүн \(P-1\) кичине жөнөкөй көбөйткүчтөрдөн турган учурларды бутага алат. DSPнин негизги максаты салттуу Pollard P-1 жана IPP1 ыкмаларында пайда болгон туруктуу smoothness-bound тандоосун жана керексиз жогорку даража эсептөөлөрүн азайтуу. Изилдөө ошондой эле чоң жөнөкөй сандар тизмелеринин көбөйтүндүсүн төмөн чыгым менен эсептөө үчүн Fast Multiplication (FM) ыкмасын иштеп чыгат.
DSPнин айырмалоочу өзгөчөлүгү — жөнөкөй сан талапкерлерин бир туруктуу аралыкка топтоонун ордуна өлчөмүнө жараша баскычтуу кичи топтомдорго бөлүп, кичине жөнөкөй сандардын көбөйтүндүлөрүнөн мурда алынган аралык натыйжаларды кийинки даражаларда кайра колдонушу. Ошентип, IPP1дегидей бардык жөнөкөй сан талапкерлерин бирдей \(u_{\max}\) деңгээлге чейин көтөрүүнүн ордуна, кичине жөнөкөй сандар жогорку даражаларга, чоң жөнөкөй сандар математикалык жактан талап кылынган төмөнкү даражаларга чейин көтөрүлөт. Бул ыкма өзгөчө \(P-1\)дин жөнөкөй көбөйткүчтөрүнүн бири жогорку даражага ээ болуп, башкалары ошол эле жогорку даражаны талап кылбаган учурда керексиз модулдук даражага көтөрүү чыгымын азайтууну көздөйт.
Авторлордун теориялык салыштыруусунда белгилүү шарттарда эң чоң тиешелүү жөнөкөй сан \(p_{\sigma_s}\ge64\) болгондо DSPнин IPP1ге караганда арзаныраак болушун колдогон ыктымалдык кеминде 0,95 деп чыгарылган. Бул маани жалпы RSA ачкычтарынын %95и DSP менен бузулат дегенди билдирбейт; ал макаладагы белгилүү сан-теориялык чыгым теңсиздигинин ыктымалдыгы.
Эксперименттик бөлүмдө \(P-1\) Pollard P-1 менен чечиле тургандай кылуу үчүн бир нече кокус 30-bit сандын көбөйтүндүсү колдонулуп 512-bit \(P\) жөнөкөй сандары түзүлгөн, ошол эле bit узундуктагы кокус \(Q\) тандалып 1024-bit \(N=PQ\) модулдары алынган. Бир агымдуу Intel Core i5-9500 системасындагы салыштырууда булак DSP болжол менен IPP1ден 23,5 эсе, түпнуска Pollard P-1ден 16,4 эсе жана trivial варианттан 35,6 эсе тез иштегенин билдирет.
Эң маанилүү түшүндүрмө чеги: DSP жалпы максаттагы RSA бузуу алгоритми эмес. Pollard P-1 үй-бүлөсү жөнөкөй көбөйткүчтөрдүн биринин \(P-1\) же \(Q-1\) маанисинде ылайыктуу smoothness алсыздыгы бар өзгөчө учурларда гана натыйжалуу. Изилдөөнүн 1024-bit эксперименттери да атайын ушул алсыздыкты камтыган тест модулдары болуп түзүлгөн.
Бүтүн сандарды факторлорго ажыратуу маселеси деген эмне?
RSA тибиндеги модуль:
түрүндө эки чоң жана ар башка жөнөкөй сандын көбөйтүндүсү. \(N\) белгилүү болгондо \(P\) жана \(Q\)ну кайра табуу маселеси Integer Factorization Problem (IFP), башкача айтканда бүтүн сандарды факторлорго ажыратуу маселеси деп аталат.
Модулдун bit узундугу:
менен көрсөтүлөт. \(n_N\) — \(N\)ди экилик көрсөтүүдө жазууга керек болгон bit саны. Булактагы анализде \(P\) жана \(Q\) болжол менен бирдей bit узундукта деп кабыл алынат; демек ар бири болжол менен \(n_N/2\) bit узундукта.
Эйлердин totient функциясы:
түрүндө.
B-smooth сан деген эмне?
Булактагы изилдөөнүн аныктамасы боюнча B-smooth сан — бардык жөнөкөй көбөйткүчтөрү \(B\)ден кичине же \(B\)ге барабар болгон оң бүтүн сан.
Мисалы:
2 жана 3 жөнөкөй көбөйткүчтөрүн гана камтыгандыктан 3-smooth сан. Бул мисал аныктаманы түшүндүрүү үчүн гана берилген; изилдөөнүн эксперименттик жыйынтыгы эмес.
Pollard P-1 алгоритми бутага алган алсыздык — \(P-1\)дин ушундай кичине жөнөкөй көбөйткүчтөрдөн турушу.
Pollard P-1 эмне үчүн иштеши мүмкүн?
Ферманын Кичине Теоремасы боюнча, \(P\) жөнөкөй сан болуп, \(a\) саны \(P\) менен өз ара жөнөкөй болсо:
теңдик аткарылат.
Эгер тандалган даража \(z\), \(P-1\)дин эселүүсү болсо:
жана демек:
болот.
Бул учурда:
эсеби ылайыктуу шарттарда:
\[ 1
болгон жөнөкөй көбөйткүч \(P\)ни бере алат.
Демек Pollard P-1дин негизги маселеси \(P-1\)дин жөнөкөй көбөйткүчтөрүн камтыгандай жетиштүү бай, бирок керексиз өтө чоң эмес \(z\) даражасын түзүү.
Булактын негизги белгилөөсү
\(P-1\) ар дайым жуп болгондуктан, булак адегенде так бөлүгүн:
деп ажыратат.
\(\gamma\) — жөнөкөй сан талапкерлеринин тизмесинин глобалдык жогорку чеги. Талапкерлер топтому:
түрүндө аныкталат.
\(P_{\mathrm{div}}\) ичиндеги чыныгы жөнөкөй көбөйткүчтөр:
түрүндө жазылат.
- \(p_{\sigma_i}\): чындап \(P_{\mathrm{div}}\)ди бөлгөн жөнөкөй сан.
- \(u_{\sigma_i}\): ошол жөнөкөй сандын чыныгы даражасы.
- \(\sigma_1<\sigma_2<\cdots<\sigma_s\): бул жөнөкөй сандардын глобалдык жөнөкөй сандар тизмесиндеги катарлары.
- \(u_{\max}\): чыныгы жөнөкөй сан даражаларынын арасындагы максималдуу маани.
Булак эң чоң жөнөкөй-даража компонентин дагы:
деп аныктайт.
Бир \(p_i\) жөнөкөй санынын мүмкүн болгон максималдуу даражасы үчүн булак:
жогорку чегин колдонот. Мунун себеби:
болгондуктан кандай гана жөнөкөй сан даражасы болбосун бул чоңдуктан ашпашы керек.
DSP жөнөкөй сан талапкерлерин кантип бөлөт?
Булак жөнөкөй сан талапкерлеринин топтомун өлчөмүнө жараша \(k_0\) кичи топтомго бөлөт:
жана:
түрүндөгү интервалдарды колдонот.
Бул double-exponential чектер алгач караганда адаттан тыш көрүнүшү мүмкүн. Максат жөнөкөй сан чоңойгон сайын ал \(P-1\) ичинде ээ боло ала турган максималдуу даражалардын саны тез азаярын алгоритмдик түзүлүшкө чагылдыруу.
DSP чындап эле Smoothness Bound таптакыр колдонбойбу?
Жок; Algorithm 4түн кириштеринин бири \(\gamma\) деп аталган глобалдык жөнөкөй-сандар-тизмесинин жогорку чеги. DSPнин артыкчылыгы классикалык Pollard P-1 же IPP1дегидей иштин ийгилиги үчүн тар \(B\) чегин алдын ала туура божомолдоого көз каранды болбогонунда: \(\gamma\) теориялык максимумга коюлушу мүмкүн жана алгоритм жөнөкөй сан/даража мейкиндигин динамикалык скандайт; алдын ала маалымат болсо кичирээк \(\gamma\) тездетүү үчүн гана колдонулушу мүмкүн.
Жөнөкөй сандар көбөйтүндүсүнүн bit узундугунун күтүлгөн мааниси
Булак FM жана NM чыгымын талдоо үчүн \(L(p,n_1,n_2)\) аттуу тизме моделин түзөт. Тизмедеги ар бир:
элемент көз карандысыз түрдө \(p\) ыктымалдыгы менен тандалат.
Тизмедеги бардык сандардын көбөйтүндүсүнүн күтүлгөн структуралык bit узундугу:
деп берилет.
Бул формула убакытты өлчөбөйт. Ал кийинки чоң-бүтүн-сандарды көбөйтүү жана модулдук даражага көтөрүү чыгымдарындагы operand өлчөмүн баалоо үчүн колдонулган математикалык аралык жыйынтык.
Негизги операция чыгымынын моделдери
Булак DSP/IPP1 чыгым талдоосунун баарын төрт негизги операция түрүнө бөлөт.
1. Чоң бүтүн сандарды көбөйтүү:
Бул жерде \(n\) — operand bit узундугу; \(C_1\) implementation-dependent туруктуу. Булак асимптотикалык анализ үчүн чоң бүтүн сандарды көбөйтүүнү \(O(n\log n)\) катары моделдейт.
2. Модулдук даражага көтөрүү:
\(l\) — exponent bit узундугу; \(n\) — base/modulus bit өлчөмү; \(w\) — sliding-window туурасы болсун:
түрүндө моделденет.
Булак оптималдуу терезе тандоосун Lambert W функциясынын асимптотикалык жакындашуусу менен чечип:
жакындашуусун алат.
Каралган exponent-өлчөм диапазонунда бул чыгым exponent bit узундугу \(l\) менен болжол менен сызыктуу өзгөрөт. DSPнин аралык жөнөкөй сан көбөйтүндүлөрүн кайра колдонуу идеясынын маанилүү математикалык негиздеринин бири ушунда.
3. Кадимки даражага көтөрүү:
булакта жөнөкөй binary exponentiation үчүн колдонулган жогорку чыгым модели.
4. Эң чоң жалпы бөлүүчү:
түрүндө моделденет. \(C_2\) — GCD implementationына көз каранды туруктуу.
Түпнуска Pollard P-1 алгоритми
Булак Pollardдын түпнуска ыкмасын эки баскычтуу түзүлүш катары түшүндүрөт. \(1<B_1<B_2\) болгондо алгоритм ийгиликтүү боло турган эки негизги жагдай:
- \(P-1\), \(B_1\)-smooth.
- \(P-1=Ap\), мында \(A\) \(B_1\)-smooth жана \(B_1<p<B_2\) жөнөкөй сан.
Биринчи баскычта ар бир жөнөкөй сан үчүн:
сыяктуу жетиштүү даражалар тандалып:
түзүлөт.
Bishopтун trivial варианты
Bishopтун булак салыштырган жөнөкөй вариантында башында кокус:
тандалат жана:
операциялары ырааттуу аткарылат. Ар бир кадамда:
эсептелет. Бул ыкма smoothness boundду алдын ала тандоону талап кылбаса да, exponentти бирден чоңойткондуктан булакта практикалык эмес деңгээлде кымбат деп эсептелет.
IPP1 кантип иштейт?
IPP1 адегенде белгилүү жөнөкөй сандар тизмесинин бардык элементтерин бир көбөйтүндүгө бириктирет:
андан кийин:
операциясын кайталап, бардык жөнөкөй сандарды бирдей iteration саны ичинде чогуу даражага көтөрөт.
Бул ыкма жөнөкөй сандардын даражалары бири-бирине жакын болсо пайдалуу болушу мүмкүн. Бирок бир эле жөнөкөй сандын чыныгы даражасы жогору болгондо калган бардык жөнөкөй сан талапкерлери да ошол эле кайталоо санына туш болот. DSP бутага алган негизги керексиз чыгым ушул.
IPP1 теориялык чыгым модели
Булак Theorem 1де \(p_t\ge p_{\sigma_s}\) шарты астында:
жогорку чыгымды берет.
Эгер \(p_t=p_{\sigma_s}\) тандалса:
алынат.
Биринчи мүчө жөнөкөй-сандар-тизмесинин көбөйтүндүсүнүн чыгымын; экинчи мүчө кайталанган GCD чыгымын; үчүнчү мүчө кайталанган modular exponentiationдын үстөм чыгымын билдирет.
DSPнин негизги алгоритми
DSPнин кириштери:
- \(N\): факторлорго ажыратылуучу эки-жөнөкөй-сандуу модуль.
- \(\gamma\): жөнөкөй сан талапкерлеринин тизмесинин глобалдык жогорку чеги.
чыгышы болсо табылган жөнөкөй көбөйткүч же ийгиликсиздикти көрсөткөн \(\perp\).
Башында:
жана:
эсептелет.
Эгер биринчи GCD non-trivial көбөйткүч бербесе:
менен dynamic scaling башталат.
\(j<k_0\) үчүн тиешелүү жөнөкөй сан кичи топтому:
түзүлөт.
Бул аралыктагы жөнөкөй сандардын көбөйтүндүсү:
деп эсептелет.
Динамикалык exponent:
жана кийинки баскычтын accumulatorу:
болот.
Ар бир айлампада:
андан кийин:
эсептелет.
Non-trivial \(d\) табылса алгоритм көбөйткүчтү кайтарат. Табылбаса кийинки жөнөкөй сан/даража масштабына өтөт.
DSPнин экинчи фазасы эмне үчүн башкача?
Булакта акыркы жөнөкөй сан кичи топтому \(\mathcal{P}_{k_0}\) үчүн өзгөчө байкоо берилет. Бул аралыктагы жөнөкөй сандар ушунчалык чоң болгондуктан, \(P_{\mathrm{div}}\) ичинде алардын экөөсү бир учурда болушу өлчөм чегине каршы келет. Ошондуктан акыркы кичи топтомдо бардык жөнөкөй сандарды жогорку даражаларга чыгарган кымбат операциянын ордуна Pollardдын shift modular exponentiation ыкмасы колдонулат.
Кезектеш жөнөкөй сан талапкерлеринин ортосундагы жарым айырма үчүн:
эсептелет жана:
алдын ала эсептелет. Ошентип, кезектеш жөнөкөй сан талапкерлерине өтүүдө exponentiation башынан жүргүзүлбөстөн, жөнөкөй сандардын арасындагы айырмалар пайдаланылат.
DSPде аралык натыйжаларды кайра колдонуу эмне үчүн иштейт?
Булактагы Example 1 эки жөнөкөй сан \(p_1,p_2\) үчүн:
туюнтманы эки башка ыкма менен эсептөөнү салыштырат.
Биринчи ыкмада:
бир жолу эсептелет жана:
андан соң:
эсептелет.
Экинчи ыкмада exponent адегенде түздөн-түз:
түрүндө түзүлүп, бир модулдук даражага көтөрүү аткарылат.
Modular exponentiation чыгымы exponent bit узундугуна болжол менен сызыктуу болгондуктан эки ыкманын modular exponentiation чыгымдары бири-бирине жакын болушу мүмкүн; бирок экинчи ыкма кошумча чоң exponentтин квадратын түзүшү керек. Булактын жыйынтыгы аралык көбөйтүндүнү кайра колдонуу exponent түзүү чыгымын азайтышы мүмкүн дегенге келет.
DSP теориялык чыгым модели
Булак Theorem 2де тиешелүү жагдайдагы DSP чыгымын:
түрүндө берет.
Бул жерде:
- \(p_{\sigma_s}\): \(P_{\mathrm{div}}\) ичиндеги эң чоң чыныгы жөнөкөй көбөйткүч.
- \(p_{\sigma_x}^{u_{\sigma_x}}\): эң чоң жөнөкөй-даража компоненти.
- \(n_N\): модулдун bit узундугу.
- \(C_1\): чоң бүтүн сандарды көбөйтүү чыгымынын туруктуусу.
- \(C_2\): GCD чыгымынын туруктуусу.
- \(o(\cdot)\): үстөм мүчөлөргө караганда жайыраак өскөн төмөнкү тартиптеги мүчөлөрдү көрсөтөт.
Бул теорема булакта ийгиликтүү факторлоштурула турган жагдай үчүн түзүлгөн. Ийгиликсиздик сценарийинин толук чыгымы бул туюнтмага киргизилген эмес.
DSP эмне үчүн IPP1ге караганда азыраак керексиз даража эсептей алат?
IPP1 тандалган жөнөкөй сандар тизмесиндеги бардык жөнөкөй сан талапкерлерин бирдей \(u_{\max}\) кайталоо санына чейин чогуу көтөрсө, DSP жөнөкөй сан чоңойгон сайын мүмкүн болгон даража чеги төмөндөй турганын пайдаланып ар башка жөнөкөй сан интервалдарын ар башка ылдамдыкта масштабдайт; ошондуктан бир кичине жөнөкөй сандын жогорку даражага ээ болушу башка бардык талапкерлердин ошол эле жогорку даражаны керексиз алуусуна алып келбейт.
%95 жыйынтык кантип алынат?
Булак Theorem 1 жана Theorem 2 чыгымдарын салыштырганда DSP арзаныраак болушу мүмкүн болгон теңсиздикти алат. Андан кийин \(P-1\)дин largest-prime-factor бөлүштүрүүсү үчүн Rieselде аныкталган \(\rho_1\) функциясына кайрылат.
\(p_{\sigma_s}\ge64\) болгондо:
жана булак колдонгон жыйынтыктан:
экенин келтирет. \(\rho_1\) монотондуу азайгандыктан тиешелүү окуя үчүн:
жыйынтыкка келет.
Ошондуктан макаладагы “%95тен көп” деген туюнтма теориялык чыгым-салыштыруу ыктымалдыгы. Бул RSA ачкычын бузуу ийгилигинин деңгээли, коопсуздук деңгээли же эксперименттеги 100 үлгүнүн 95и бузулган дегенди билдирбейт.
DSP жалпысынан RSAны бузган алгоритмби?
Жок; DSP Pollard P-1 үй-бүлөсүнүн атайын максаттагы факторлоштуруу ыкмасы жана натыйжалуу болушу үчүн \(P-1\) же \(Q-1\) кичине жөнөкөй көбөйткүчтөрдөн турган ылайыктуу smooth түзүлүшкө ээ болушу керек; изилдөөнүн 1024-bit тест модулдары да ушул түзүлүш атайын бар болушу үчүн өндүрүлгөн.
Fast Multiplication маселеси деген эмне?
DSP жана IPP1 көп сандагы жөнөкөй сан талапкерлеринин көбөйтүндүсүн эсептөөгө тийиш. Жөнөкөй Normal Multiplication (NM) ыкмасында:
тизмеси үчүн биринчи элемент дайыма өсүп турган аккумулятор катары колдонулат:
Бул учурда ар бир жаңы көбөйтүү мурункусунан кыйла чоң бүтүн сан менен аткарылат.
FM кантип иштейт?
Fast Multiplication тизмеде эң кичине менен эң чоң, экинчи кичине менен экинчи чоң элементти жуптайт:
жана:
кылып, тизмени ар бир айлампада болжол менен жарымына азайтат.
Эгер тизмедеги элементтердин саны так болсо, башына көбөйтүүгө таасири жок 1 кошулат. Операция бир гана көбөйтүндү калганга чейин кайталанат.
Fast Multiplication эмне үчүн Normal Multiplicationдан арзаныраак болушу мүмкүн?
Normal Multiplication улам чоңойгон бир аккумуляторду жаңы элементтерге көбөйткөндүктөн өтө тең салмаксыз operand өлчөмдөрүн жаратат; FM болсо чоң жана кичине элементтерди симметриялуу жуптап, тең салмактуу көбөйтүү дарагын түзөт. Булактын чоң-бүтүн-сан чыгым моделинде бул түзүлүш жөнөкөй-сандар-тизмесинин көбөйтүндүсүндөгү болжол менен \(4^n\) масштабдуу NM чыгымын болжол менен \(2^n n^2\) масштабдуу FM чыгымына түшүрөт.
Normal Multiplication татаалдыгы
Theorem 3тө:
туюнтма берилет.
Эгер \(p=1\) болсо:
болот.
Жөнөкөй сандардын болжолдуу тыгыздыгы Prime Number Theorem аркылуу эсепке алынганда, бардык \(n\)-bit чектен төмөн жөнөкөй сандардын NM менен көбөйтүндү чыгымы булакта:
түрүндө берилет.
Fast Multiplication татаалдыгы
Theorem 4:
жыйынтыгын берет.
\(p=1\) үчүн:
болот.
Жөнөкөй сандар тизмеси үчүн Corollary 2де:
алынат.
\(n_1=0,n_2=n\) деп алганда негизги масштаб:
болуп, NM тарабы \(4^n\) менен өсөт. Булак 4-сүрөттө максималдуу жөнөкөй көбөйткүч өлчөмү 21-26 bit болгон учурлар үчүн теориялык ийри сызыктар чыныгы өлчөөлөргө жакшы дал келерин көрсөтөт. Чийки өлчөө таблицасы берилбегендиктен Verianla графиктен так убакыт чыгарбайт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эксперимент 1: Pollard P-1дин төрт вариантын салыштыруу
Булак төрт implementationды салыштырат:
- DSP + Fast Multiplication.
- IPP1 + Fast Multiplication.
- Түпнуска Pollard P-1.
- Bishopтун trivial Pollard P-1 варианты.
Эксперимент кодунун репозиторийи булакта төмөнкүдөй берилген:
https://github.com/Summwer/expemeriment_of_pollardpm1
Булак шилтеме үчүн 1 Август 2026 кирүү датасын берет.
1024-bit тест модулдары кантип түзүлгөн?
Авторлор алгач \(P\)ни, \(P-1\) мааниси бир нече кокус түзүлгөн 30-bit сандын көбөйтүндүсү болгудай кылып түзүшкөн. Ошентип \(P-1\)дин эң чоң жөнөкөй көбөйткүчү:
болуп, тест үлгүлөрүнүн Pollard P-1 үй-бүлөсү тарабынан чечиле алышы максат кылынат.
Андан кийин \(P\) менен бирдей bit узундуктагы кокус жөнөкөй сан \(Q\) түзүлүп:
эсептелет.
Булак тексти бул ыкма менен **10 даана 1024-bit \(N\)** түзүлгөнүн айтат. Бирок булактагы 7-сүрөттүн көрүнгөн x огунда instance 1-8 гана бар. Булак бул айырманы түшүндүрбөйт.
Эксперименттик жабдуу
| Элемент | Булакта билдирилген маани |
|---|---|
| Операциялык система | Ubuntu 20.04.1 |
| Архитектура | x86-64 |
| CPU | Intel Core i5-9500 @ 3.00 GHz |
| Булакта жазылган CPU маалыматы | 6 × Intel Core i5-9500 |
| RAM | 16 GB |
| Иштетүү | Single thread |
| Модуль | 1024-bit \(N=PQ\) |
| \(P,Q\) bit узундугу | Болжол менен 512 bit |
1-эксперименттин негизги ылдамдык жыйынтыгы
| Салыштырылган ыкма | DSPнин булакта билдирилген болжолдуу ылдамдык артыкчылыгы | Контекст |
|---|---|---|
| IPP1 + FM | 23,5× | Атайын түзүлгөн 1024-bit тест модулдары |
| Түпнуска Pollard P-1 | 16,4× | Ошол эле тест түзүлүшү |
| Trivial Pollard P-1 | 35,6× | Ошол эле тест түзүлүшү |
Булак жогорку жөнөкөй-даражалар бар instance 2, 3, 4, 5 жана 8 бул жүрүм-турумду даана көрсөткөнүн белгилейт. Instance 2, 3, 4 жана 8де IPP1 түпнуска Pollard P-1ден да жайыраак болгону, ошого карабай DSP түпнуска алгоритмден тезирээк бойдон калганы билдирилген.
Авторлордун түшүндүрмөсүнө ылайык DSPнин чыгымы жөнөкөй көбөйткүчтөрдүн санына же жөнөкөй сандын катар индексине караганда көбүрөөк эң чоң жөнөкөй көбөйткүчтүн өлчөмүнө сезимтал. Бул булактын өз эксперименттик жана теориялык түшүндүрмөсү; аны башка бөлүштүрүүлөрдөгү бардык \(P-1\) түзүлүштөрүнө жаңы универсалдуу жыйынтык катары кеңейтүүгө болбойт.
Эксперимент 2: Бир жогорку даража көзөмөлдүү түрдө чоңойтулат
Экинчи экспериментте 512-bit \(P\) төмөнкү түзүлүштө түзүлөт:
жана:
колдонулат.
Бул дизайн башка шарттарды көзөмөлдө кармап туруп 3 жөнөкөй санынын даражасын чоңойтуу жана IPP1 менен DSP арасындагы айырманы системалуу байкоо максатын көздөйт.
Ар бир \(P\) үчүн кокус 512-bit \(Q\) тандалып:
түзүлөт.
DSP үчүн:
- Algorithm 4 чыныгы implementation,
- Algorithm 6 DSPEst estimator,
- Theorem 2 теориялык чыгым
салыштырылат.
IPP1 үчүн болсо:
- Algorithm 3 чыныгы implementation,
- Algorithm 5 IPP1Est estimator,
- Theorem 1 теориялык чыгым
салыштырылат.
8-сүрөттө теориялык чыгым сызыктары, estimator чекиттери жана чыныгы эксперимент чекиттери бирдей өсүү тенденциясын жакын ээрчийт. Бул жыйынтык изилдөөнүн чыгым моделдери сыналган ушул конфигурацияларда implementation жүрүм-турумун жакшы көрсөтөрүн колдойт. Булак чийки чекит маанилерин таблица түрүндө бербегендиктен жаңы аралык маанилер чыгарылбайт.
Теориялык %95 салыштыруунун туура түшүндүрмөсү
Булактын теориялык жыйынтыгы:
- \(p_{\sigma_s}\ge64\) шартын,
- Rieselдин \(\rho_1\) функциясын,
- Theorem 1 жана Theorem 2 чыгым моделдерин
бирге колдонот.
Ошондуктан “DSP %95 ийгилик деңгээлине ээ” деп айтуу туура эмес. Булак айткан нерсе — белгилүү шарттарда DSPнин IPP1ге караганда төмөн теориялык эсептөө чыгымына ээ болушун колдогон окуянын ыктымалдыгы кеминде 0,95 экендиги.
Изилдөө колдогон жыйынтыктар
- DSP — Pollard P-1дин жөнөкөй сан талапкерлерин жана зарыл даражаларды бир эле динамикалык скан тартибинде караган жаңы варианты.
- Мурда эсептелген жөнөкөй сан көбөйтүндүлөрүн кайра колдонуу жогорку exponent түзүү чыгымын азайтышы мүмкүн.
- DSP жөнөкөй сандын өлчөмүнө жараша exponent бөлүштүрүүнү өзгөртүп, IPP1 бардык талапкерлерди \(u_{\max}\)ка чейин көтөрүүдөн келип чыккан керексиз эсептерди азайтат.
- Fast Multiplication тең салмактуу көбөйтүү дарагын колдонуп, булак чыгым моделинде Normal Multiplicationга караганда жакшыраак асимптотикалык жүрүм-турум көрсөтөт.
- Булак 4-сүрөттө NM/FM теориялык чыгым моделдери менен эксперименттик чыгымдар жакшы дал келерин көрсөтөт.
- Булактын теориялык шарттарында \(p_{\sigma_s}\ge64\) болгондо DSP чыгымы IPP1 чыгымынан төмөн болушу үчүн колдонулган ыктымалдык кеминде 0,95.
- Булактын атайын түзүлгөн 1024-bit эксперименттеринде DSP салыштырылган үч эски варианттан тезирээк.
- Булак жогорку жөнөкөй-даражалар болгондо DSP артыкчылыгы даана көрүнөрүн билдирет.
- Көзөмөлдөнгөн \(u_x\) экспериментинде Theorem 1/2, estimatorлор жана implementation чыгымдарынын тенденциялары бири-бирине жакын.
Изилдөө колдобогон жыйынтыктар
- DSP жалпы 1024-bit RSA модулдарын натыйжалуу факторлоштурат деген жыйынтык чыгарууга болбойт.
- 23,5×, 16,4× жана 35,6× ылдамдык катыштарын бардык RSA ачкычтарына жалпылоого болбойт.
- %95 мааниси жалпы RSA факторлоштуруу ийгилигинин деңгээли эмес.
- DSP Number Field Sieve сыяктуу жалпы максаттагы факторлоштуруу ыкмаларынан жалпысынан тез экени сыналган эмес.
- Изилдөөнүн эксперименттери quantum factoring салыштыруусу эмес.
- Татаалдык теоремалары ийгиликсиз факторлоштуруу сценарийинин толук чыгым анализин камтыбайт.
- Көп өзөктүү же GPU ылдамдатылган performance сыналган эмес.
- Башка CPU, arbitrary-precision library же implementation чөйрөсүндө ошол эле ылдамдык катыштары сакталары далилденген эмес.
- 7-сүрөттө көрүнбөгөн instance 9 жана 10 үчүн убакыт маанилерин булактан чыгарууга болбойт.
Негизги ыкмалык жана кайра өндүрүмдүүлүк чектөөлөрү
- Эксперимент үлгүлөрү Pollard P-1 менен чечиле турган smooth түзүлүш атайын камсыздалып түзүлгөн.
- Салыштыруу бир жеке компьютерде жана single-thread режиминде жүргүзүлгөн.
- Булак тексти биринчи эксперимент үчүн 10 даана 1024-bit модуль десе, 7-сүрөт сегиз instance гана көрсөтөт.
- 7-сүрөттөгү бардык bar бийиктиктери таблица түрүндө берилген эмес.
- 8-сүрөттөгү чийки эксперимент, estimator жана теориялык маанилер таблица түрүндө жарыяланган эмес.
- DSP/IPP1 теориялык татаалдык бөлүмү так solvable situation менен чектелип, failure scenario чыгарылып салынган.
- Булакта эксперименттерде колдонулган arbitrary-precision arithmetic library версиясы толук билдирилген эмес.
- Макала классикалык сандар теориясы жана классикалык эсептөө контекстинде; quantum factoring жыйынтыгын бербейт.
Изилдөөнүн криптографиялык мааниси
Pollard P-1 алгоритмдери RSAнын негизги integer-factorization маселесиндеги жалпы кыйынчылыкты жок кылбайт. Анын ордуна prime generation учурунда пайда болушу мүмкүн болгон белгилүү algebraic weaknessтарды бутага алат. Макаланын салымы да ошол өзгөчө алсыздык болгондо факторлоштуруу процессин азыраак керексиз эсептөө менен жүргүзүүгө багытталган.
Ошондуктан изилдөөнүн туура жыйынтыгы “RSA эми бузулду” эмес. Туурараак айтканда, smooth \(P-1\) же \(Q-1\) түзүлүшүнө ээ өзгөчө композиттерде Pollard P-1 факторлоштуруусун тездетүүнү көздөгөн жаңы traversal/exponent-scaling стратегиясы теориялык жана эксперименттик жактан изилденген.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: Dynamic Scaling Pollard’s P-1 Algorithm
Авторлор: Wenwen Xia; Geng Wang; Dawu Gu.
Авторлордун тартиби: Wenwen Xia биринчи; Geng Wang экинчи; Dawu Gu үчүнчү автор.
Жооптуу авторлор: Geng Wang жана Dawu Gu.
Мекеме: School of Cyber Science and Engineering, Shanghai Jiao Tong University, Shanghai 200240, China.
Тең салым: Булакта тең биринчи авторлук же тең салым тууралуу билдирүү жок.
Журнал: Cryptography.
Басып чыгаруучу: MDPI.
Том / сан / макала: 10(4), Article 57.
Барак саны: 26.
DOI: 10.3390/cryptography10040057.
Academic Editor: Josef Pieprzyk.
Тапшырылган: 14 Июнь 2026.
Оңдолгон: 23 Июль 2026.
Кабыл алынган: 29 Июль 2026.
Жарыяланган: 13 Август 2026.
Version of Record эскертүүсү: Расмий MDPI Version Notes жазуусунда биринчи Version of Record PDF 13 Август 2026да, жаңыртылган PDF/HTML версиясы 17 Август 2026да жарыяланган.
Булак түрү: Рецензияланган изилдөө макаласы; сандар теориясын, классикалык криптоанализди, алгоритм дизайнын, асимптотикалык татаалдык анализин жана көзөмөлдөнгөн компьютердик экспериментти бириктирет.
Рецензиялоо: Cryptography — рецензияланган MDPI журналы. Журналдын submission материалдары single-anonymized peer review процессин билдирет.
Preprint абалы: Иштелген булак жарыяланган Version of Record; бул макалада өзүнчө preprint негиз катары алынган эмес.
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Расмий шилтеме: https://doi.org/10.3390/cryptography10040057
Ачкыч сөздөр: cryptanalysis; RSA; integer factorization; Pollard’s P-1.
Негизги илимий салым: Dynamic Scaling Pollard’s P-1 (DSP) жана Fast Multiplication (FM).
Салыштырылган алгоритмдер: DSP; IPP1; түпнуска Pollard P-1; Bishopтун trivial Pollard P-1 варианты.
Теориялык моделдер: Чоң бүтүн сан multiplication, sliding-window modular powering, binary normal powering жана GCD чыгымдарынын айкалышынан DSP/IPP1 cost estimatorлору түзүлгөн.
DSPнин негизги өзгөчөлүгү: Жөнөкөй сан талапкерлерин double-exponential өлчөм интервалдарына бөлүү, кичирээк жөнөкөй сандарды жогорку даража деңгээлдерине баскыч-баскыч көтөрүү жана мурда эсептелген жөнөкөй сан көбөйтүндүлөрүн кайра колдонуу.
FM өзгөчөлүгү: Өсүүчү тизмедеги симметриялуу четки элементтерди pairwise көбөйтүп, ар бир айлампада тизмени болжол менен жарымына кыскарткан тең салмактуу multiplication tree.
Биринчи эксперимент: \(P-1\) бир нече кокус 30-bit сандын көбөйтүндүсү болгудай түзүлгөн, 512-bit \(P\) жана болжол менен ошол эле өлчөмдөгү кокус \(Q\)дан алынган 1024-bit \(N=PQ\) тест модулдары.
Биринчи эксперимент чөйрөсү: Ubuntu 20.04.1; x86-64; Intel Core i5-9500 @ 3.00 GHz; 16 GB RAM; single thread.
Биринчи эксперименттин негизги жыйынтыгы: Булак DSP болжол менен IPP1ден 23,5×, түпнуска Pollard P-1ден 16,4× жана trivial варианттан 35,6× тез экенин билдирет.
Биринчи эксперименттеги булак ичиндеги дал келбестик: Текст 10 даана 1024-bit test instance билдирсе, булактагы 7-сүрөттүн көрүнгөн x огунда instance 1-8 гана бар. Булак бул айырманы түшүндүрбөйт.
Экинчи эксперимент: \(P=2\times3^{u_x}\times1073741789\times z+1\), \(u_x\in\{0,20,40,60,80,100\}\); кокус 512-bit \(Q\); DSP жана IPP1 үчүн теория-estimator-эксперимент салыштыруусу.
Теориялык %95 жыйынтыгы: \(p_{\sigma_s}\ge64\) шартында Rieselдин \(\rho_1\) функциясына негизделген чыгарууда DSP пайдасына колдонулган чыгым шарты үчүн кеминде 0,95 ыктымалдык алынат. Бул RSA бузуу ийгилигинин деңгээли эмес.
Код репозиторийи: https://github.com/Summwer/expemeriment_of_pollardpm1 — булакта кирүү датасы 1 Август 2026 деп берилген.
Каржылоо: National Cryptologic Science Fund of China, No. 2025NCSF02017.
Маалыматтардын жеткиликтүүлүгү: Авторлор жыйынтыктарды колдогон чийки маалыматтар суроо боюнча берилерин билдиришет.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришет.
Авторлордун салымдары: Conceptualization, methodology, software, validation, formal analysis, investigation, data curation жана original draft: Wenwen Xia; resources: Dawu Gu; visualization: Wenwen Xia жана Geng Wang; supervision жана project administration: Geng Wang жана Dawu Gu; funding acquisition: Geng Wang жана Dawu Gu.
Этика комитети / маалымдалган макулдук: Булакта өзүнчө этика комитети же informed-consent билдирүүсү жок; изилдөө математикалык алгоритм жана синтетикалык/эсептөөчү факторлоштуруу эксперименти.
Негизги ыкмалык чектөөлөр: Теориялык cost analysis ийгиликсиздик сценарийин чыгарбайт; эксперимент модулдары Pollard P-1ге ылайыктуу smooth түзүлүш камсыздалып өндүрүлгөн; салыштыруу бир машинада жана single-thread режиминде; биринчи экспериментте текст-график instance санынын дал келбестиги бар; 7-8-сүрөттөрдүн чийки сандык маалыматтары таблица түрүндө берилген эмес.
Жалпы түшүндүрмө чеги: Изилдөө ылайыктуу smooth \(P-1\) же \(Q-1\) түзүлүшүнө ээ модулдарда Pollard P-1 факторлоштуруусун DSP жана FM менен тездетүүгө болорун колдойт; arbitrary RSA modulus, жалпы NFS салыштыруусу же бардык заманбап RSA ачкычтарын практикалык түрдө бузууга болот деген жыйынтыкты колдобойт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген