

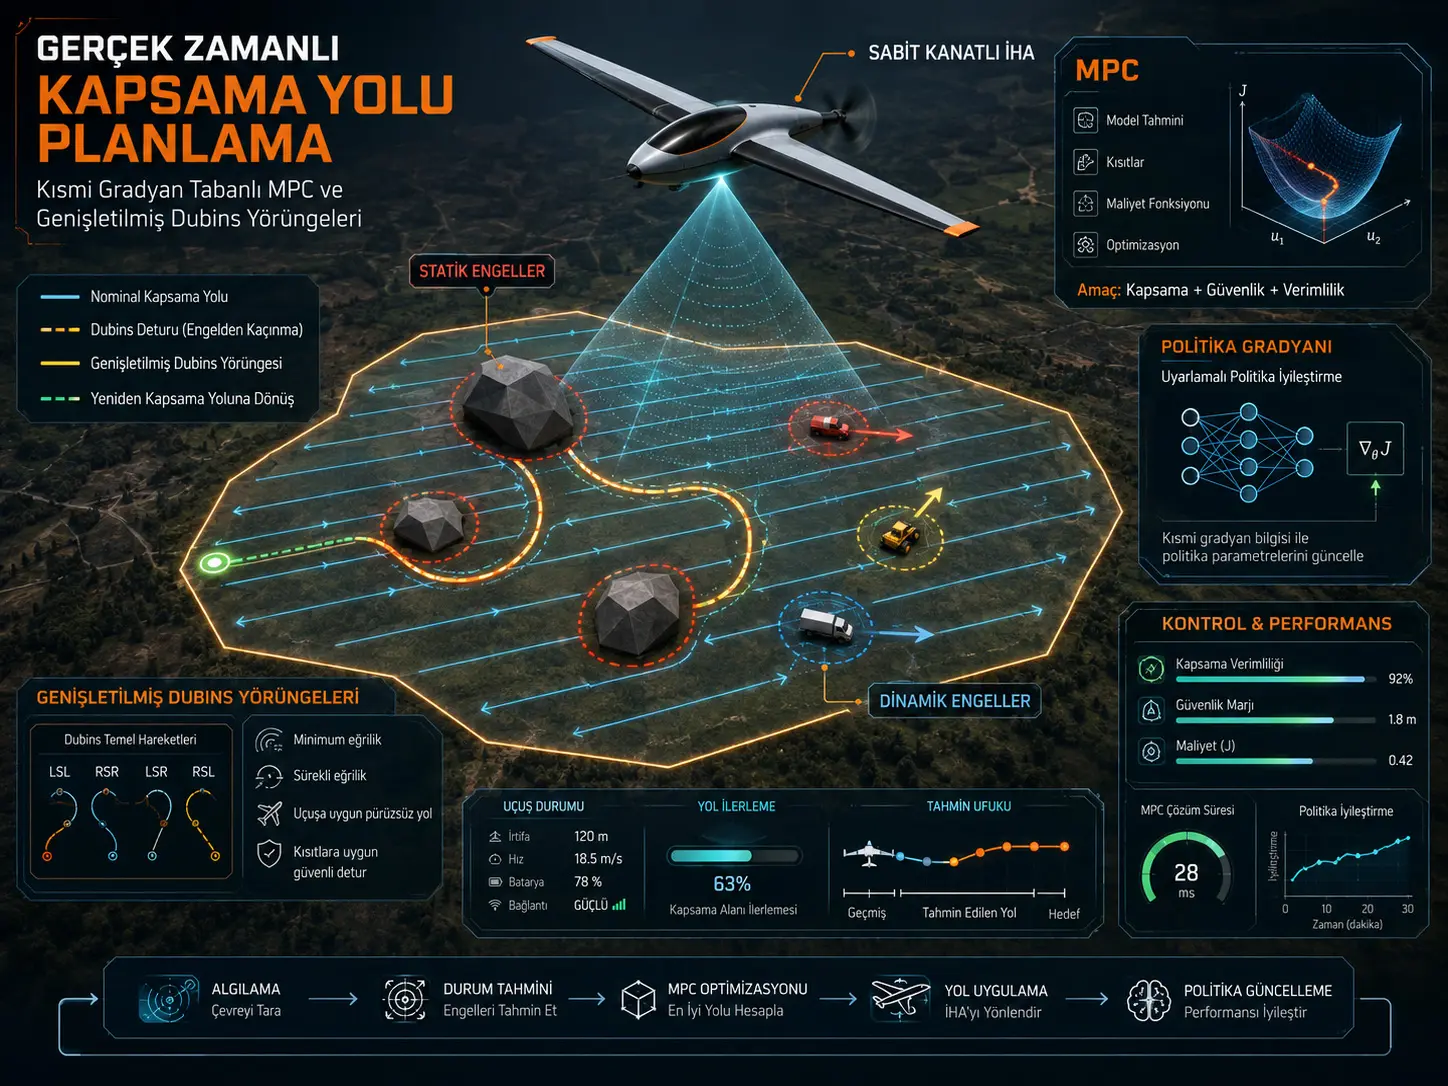
Бул изилдөө туруктуу канаттуу учкучсуз учуучу аппараттын алдын ала толук белгисиз статикалык жана кыймылдуу тоскоолдуктар болушу мүмкүн болгон аймакта бүтүндөй аянтты камтый тургандай учушун камсыз кылган гибрид жол пландоо жана башкаруу алкагын иштеп чыгат. Ыкма алгач офлайн режимде back-and-forth түрүндөгү номиналдык камтуу жолун түзөт; учуунун онлайн этабында болсо Model Predictive Control (MPC), Policy Gradient (PG) негизиндеги башкаруу жаңыртуусу жана виртуалдык waypoint-тер менен кеңейтилген Dubins Path (ADP) геометриясын бирге колдонот. Үч симуляциялык сценарийде сунушталган PG-MPC, айрыкча татаал чөйрөлөрдө классикалык gradient-based NLP-MPC ге салыштырмалуу максималдуу эсептөө жүгүн азайтып, оптималдаштыруунун жакындашуу коэффициентин жогорулаткан. Эң татаал үчүнчү сценарийде максималдуу эсептөө убактысы 0,9157 секунддан 0,5404 секундга түшкөн, бирок изилдөөнүн өзүнүн 0,5 секунддук реалдуу убакыттагы дискреттөө чегинен бир аз ашкан. Натыйжалар толугу менен симуляцияга негизделет; физикалык туруктуу канаттуу УУА учуусу жана бириктирилген PG-MPC түзүмүнүн теориялык жабык контур туруктуулугунун далили бул изилдөөдө жок.
Сунушталган архитектура эки катмардан турат. Офлайн этап камеранын көрүү аймагына жана аймактын геометриясына жараша бүт максаттуу аянтты камтыган параллелдүү sweep line-дардан турган номиналдык маршрутту түзөт. Онлайн этапта LiDAR тарабынан аныкталды деп болжолдонгон жаңы тоскоолдуктар чөйрө моделине кошулат; MPC башкаруу кириштерин жана божомолдонгон абалды оптималдаштырат; Policy Gradient бөлүгү башкаруу саясатын жаңы абалдарга ылайык жаңыртат; кеңейтилген Dubins ыкмасы болсо тоскоолдуктан качуу үчүн номиналдык сызыктан чыккан аппаратты туруктуу канаттуу учуунун бурулуу радиусунун чектөөлөрүнө ылайык, жылмакайыраак жол менен кайра камтуу сызыгына кайтарууну көздөйт.
PG-MPCнин артыкчылыгы бардык эсептөө көрсөткүчтөрүндө бирдей эмес. Scenario 1 жана Scenario 2де орточо иштетүү убактысы классикалык NLP-MPCден бир аз жогору. Бирок чөйрөнүн татаалдыгы өскөндө эң жогорку иштетүү убактысы олуттуу төмөндөйт. Scenario 2де максималдуу убакыт 0,718 sден 0,3621 sге, Scenario 3тө 0,9157 sден 0,5404 sге кыскарган. Жакындашуу коэффициенти Scenario 2де %92,30дан %96,87ге, Scenario 3тө %91,919дан %94,34кө жогорулаган.
Augmented Dubins Path ыкмасы классикалык Dubins Pathке караганда жылмакайыраак жана туруктуу канаттуу аппараттын кинематикалык бурулуу чектөөлөрүнө ылайыгыраак өтүүлөрдү камсыздоону максат кылат. Бирок бул геометриялык артыкчылык бекер эмес: 4-таблицада ADP үч сценарийдин бардыгында классикалык DPге караганда бир аз узагыраак жалпы жол жана бир аз жогору жалпы execution time түзгөн. Демек, изилдөө “ADP ар дайым жолду кыскартат” деген жыйынтыкты колдобойт.
Türkiye жагынан: Изилдөө тобунда Adana Alparslan Türkeş Science and Technology University жана Gebze Technical University изилдөөчүлөрүнүн болушу жана иштин TÜBİTAK тарабынан колдоого алынышы туруктуу канаттуу автономдуу системалардагы жергиликтүү академиялык башкаруу жана жол пландоо иштеринин масштабына конкреттүү мисал берет. Иштелип чыккан ыкма теориялык жактан чоң аймакты экологиялык мониторингдөө, кырсыктан кийинки сканерлөө же ушуга окшош камтуу миссиялары үчүн изилдениши мүмкүн. Бирок азыркы натыйжалардын баары симуляциялык; Türkiyeдеги чыныгы аба мейкиндигинде, реалдуу сенсорлор же реалдуу туруктуу канаттуу платформа менен миссиянын ийгилиги бул иште далилденген эмес.
Изилдөө кайсы көйгөйдү чечүүгө аракет кылат?
Coverage Path Planning (CPP) — аба роботу жеткиликтүү максаттуу аймактын баарын байкай турган же үстүнөн өтө турган жол түзүү көйгөйү. Туруктуу канаттуу УУАларда бул маселе multirotor системаларга караганда татаалыраак, анткени аппарат ордунда бурула албайт, минималдуу бурулуу радиусуна жана үзгүлтүксүз алдыга кыймылга байланышкан кинематикалык чектөөлөргө ээ.
Изилдөө багыттаган экинчи маселе — чөйрөнүн алдын ала толук белгисиз болушу. Классикалык back-and-forth камтуу жолдору геометриялык жактан бүт аймакты сканерлей алат; бирок учуу учурунда картада мурда болбогон имарат, тыюу салынган зона же кыймылдуу аба аппараты пайда болсо, жолду жергиликтүү түрдө кайра уюштуруу керек.
Ошондуктан изилдөө үч талапты бир математикалык алкакта бириктирүүгө аракет кылат:
- аймакты камтуунун бүтүндүгүн сактоо,
- туруктуу канаттуу аппараттын кинематикалык жана башкаруу чектөөлөрүнө ылайык келүү,
- жаңы статикалык жана динамикалык тоскоолдуктарга онлайн түрдө жооп берүү.
Эмне үчүн алкак эки этаптуу болуп иштелип чыккан?
Система офлайн жана онлайн деп аталган эки негизги фазадан турат. Офлайн этапта тоскоолдуктар эске алынбастан идеалдуу номиналдык камтуу маршруту даярдалат. Онлайн этапта болсо аппарат бул маршрутту ээрчип баратып сенсордук маалыматка жараша жаңы тоскоолдуктарды аныктайт, кыска мөөнөттүү башкаруу чечимдерин жаңыртат жана зарыл болсо номиналдык жолдон чыгып, кайра ошол эле камтуу түзүмүнө кайтып келет.
Изилдөөнүн системалык архитектурасын көрсөткөн 4-сүрөт бул бөлүнүүнү ачык көрсөтөт. Сол тарапта аймактын чек арасын аныктоо, sweep-line түзүү жана номиналдык back-and-forth маршрут; оң тарапта feature detection/localization, MPC, policy update жана Augmented Dubins Path компоненттери бар.
Номиналдык камтуу жолу кантип түзүлөт?
Максаттуу аймак эсептөө татаалдыгын азайтуу үчүн четтери туура эмес, бирок томпок полигон катары моделденген. Sweep багыты аныкталганда ар бир полигон кырынан эң алыскы чокуга чейинки аралык эсептелет; талапкер максималдуу тууралыктардын ичинен эң кичинеси камтуу сызыктарынын багытын аныктоо үчүн колдонулат.
Натыйжада параллелдүү сканерлөө сызыктарынан турган классикалык zigzag же back-and-forth түзүмүндөгү маршрут алынат. Ар бир sweep сегментинин акыркы чекити кийинки сегменттин баштапкы шилтемеси катары колдонулат.
Камера камтуу сызыктарынын аралыгына кантип таасир этет?
Изилдөө коңшу учуу сызыктарынын ортосундагы аралыкты камеранын көрүү бурчу, сүрөттөрдүн үстү-үстүнө түшүү даражасы жана учуу бийиктиги менен байланыштырат. Булакта сызык аралыгы мындай берилген:
\[ d= 2\frac{A(1-v)}{\tan(\mu)} \]
Бул жерде \(A\) — учуу бийиктиги, \(v\) — керектүү сүрөт overlap катышы жана \(\mu\) — камеранын тик көрүү талаасынын жарым бурчу. Verianla булак формуласын өзгөртпөстөн берет.
Симуляцияда кандай туруктуу канаттуу платформа кабыл алынган?
| Параметр | Булактагы маани |
|---|---|
| УУА массасы | 3,9 kg |
| Минималдуу cruise ылдамдыгы | 10 m/s |
| Cruise бийиктиги | 100 m |
| Endurance | 460 мүнөт |
| Минималдуу бурулуу радиусу | 28 m |
| Камеранын фокус аралыгы | 2,75 mm |
| Камера сенсору | 6,45 × 3,63 mm |
| Камеранын чечилиши | 11,9 MP |
| Горизонталдык / вертикалдык FoV | 102° / 67° |
| LiDAR максималдуу аралыгы | 60 m |
| LiDAR минималдуу аралыгы | 0,05 m |
| LiDAR FoV | 70° |
| LiDAR сканерлөө жыштыгы | 10 Hz |
Бул маанилер симуляциядагы агенттин жана кабыл алуу системасынын параметрлери болуп саналат; бул өзгөчөлүктөргө ээ физикалык аба аппараты менен учуу сыноосу жүргүзүлгөн эмес.
Туруктуу канаттуу УУАнын кыймыл модели кантип аныкталган?
Жалпы үч өлчөмдүү кинематика булакта:
\[ \dot{x}=V\cos\theta\cos\psi \]
\[ \dot{y}=V\cos\theta\sin\psi \]
\[ \dot{z}=V\sin\theta \]
\[ \dot{\theta}=q \]
\[ \dot{\psi}=r= \frac{g\tan\phi} {V\cos\theta} \]
түрүндө берилет.
Изилдөөдө учуу бийиктиги туруктуу деп кабыл алынгандыктан \(\dot{z}=0\), \(\theta=0\) жана \(q=0\) алынган; башкаруу маселеси тегиздиктеги кыймылга жөнөкөйлөштүрүлгөн. Бул жөнөкөйлөтүү реалдуу туруктуу канаттуу учуунун толук алты эркиндик даражасындагы аэродинамикалык моделин билдирбейт.
Чөйрө сценарийлери кантип түзүлгөн?
Изилдөөдө үч башка симуляциялык чөйрө колдонулган:
- Scenario 1: статикалык же кыймылдуу тоскоолдугу жок негизги чөйрө.
- Scenario 2: алдын ала белгисиз статикалык полигоналдык тоскоолдуктар жана кыймылдуу тоскоолдук.
- Scenario 3: чөйрөнүн татаалдыгын көбөйтүү үчүн бир аймакта бир нече динамикалык тоскоолдук.
Кыймылдуу тоскоолдуктар жабык траекторияларда туруктуу 20 m/s ылдамдыкта кыймылдайт. Статикалык тоскоолдуктар томпок жана non-convex полигондор түрүндө түзүлгөн.
3-сүрөттө экинчи сценарийде полигон тоскоолдуктар менен бир динамикалык тоскоолдук, үчүнчү сценарийде болсо ар башка жабык траекторияларда кыймылдаган бир нече динамикалык тоскоолдук көрсөтүлгөн.
Тоскоолдуктар учуу учурунда кантип аныкталат?
Симуляциялык түзүмдө LiDAR чөйрөгө байланыштуу аралык/depth маалыматын түзөт. 6-сүрөт мисал чөйрө сүрөтүнүн жанында pixel-wise relative-depth картасын көрсөтөт. Жаңы тоскоолдук аныкталганда анын геометриялык маалыматы чөйрө моделине кошулуп, MPC чектөөлөрү жаңыртылат.
Бирок бул LiDAR натыйжалары реалдуу учууда жазылган сенсордук маалымат эмес; алар симуляциялык чөйрөнүн perception моделинин чыгыштары.
MPCнин милдети эмне?
Model Predictive Control ар бир башкаруу кадамында чектелген prediction horizon боюнча келечектеги абалдарды божомолдоп, эң ылайыктуу башкаруу ырааттуулугун кайра эсептейт. Изилдөөдө үзгүлтүксүз система zero-order hold божомолу менен дискреттештирилип, абал мейкиндигинин модели:
\[ X_{k+1}=A_kX_k+B_ku_k \]
\[ Y_k=C_kX_k \]
түрүндө курулган.
Planar абалда абал вектору позиция жана ылдамдык компоненттерин, башкаруу вектору болсо x жана y багытындагы башкаруу кириштерин камтыйт.
Оптималдаштыруу бир учурда эмнелерди азайтууга аракет кылат?
CPP constrained Multi-Objective Optimization Problem катары формулировкаланган. Булактагы бириккен чыгым:
\[ J= \sum_{k=1}^{N} \left\{ \|p_k-p_{ref}\| + Q_u\|u_k\| + Q_d\|d(p_k,Z)\| \right\} \]
түрүндө.
Үч негизги компонент:
- учурдагы позиция менен максат/reference чекитинин ортосундагы аралык,
- башкаруу аракети,
- номиналдык zigzag камтуу сызыгынан cross-track четтөө.
Изилдөөдө path deviation салмагы \(Q_d=5\), control-effort салмагы \(Q_u=2\) болуп тандалган. Ошентип номиналдык камтуу жолуна берилгендик башкаруу буйругун кичине кармоого караганда жогорку салмак алат.
Тоскоолдук коопсуздугу математикалык чектөөгө кантип айландырылат?
Статикалык полигоналдык тоскоолдуктар физикалык аппараттын өлчөмүн жана коопсуздук аралыкты камтыгандай Minkowski sum ыкмасы менен кеңейтилет. Кеңейтилген коопсуздук аймагы:
\[ O_i^{aug} = \left\{ P_i^{aug}\in\mathbb{R}^2 \mid dist(P_i^{aug},O_i)\leq\delta \right\} \]
деп аныкталган.
Оптималдаштыруу параметрлеринде статикалык тоскоолдук safety margin мааниси 50 m, динамикалык тоскоолдук радиусу 30 m жана minimum separation distance 8 m.
Теңдеме шайкештиги боюнча эскертүү: Булактын Теңдеме (11)деги динамикалык тоскоолдук жаза туюнтмасы менен кийин бириктирилген оптималдаштырууну жыйынтыктаган Теңдеме (14)төгү динамикалык тоскоолдук туюнтмасы бирдей математикалык формада эмес. Verianla бул айырманы унчукпай бир теңдемеге бириктирбейт.
Policy Gradient бөлүгү кантип иштейт?
Изилдөөдө PG методдун тексти боюнча Policy Gradient ыкмасын билдирет. Системанын абалы беш өзүнчө кыймыл буйругунун ыктымалдык бөлүштүрүүсүнө айландырылат:
- солго бурул,
- түз жүр,
- оңго бурул,
- ылдамда,
- жайла.
Саясат сызыктуу функциялык жакындатуу менен:
\[ h_u(X)=\eta(X)^T\vartheta_u \]
деп аныкталып, SoftMax колдонулуп аракет ыктымалдыктары:
\[ Q(u|X)= \frac{e^{h_u(X)}} {\sum_{u'}e^{h_{u'}(X)}} \]
түрүндө эсептелет.
Critic эмне үчүн кошулган?
Таза Policy Gradient жаңыртууларында reward/cost сигналынын дисперсиясы жогору болушу мүмкүн болгондуктан, изилдөөдө сызыктуу value-function approximator колдонулган:
\[ V(X_k)=w^T\eta(X_k) \]
Temporal-Difference катасы:
\[ \delta_k= J_k+\lambda V(X_{k+1})-V(X_k) \]
түрүндө эсептелет.
Саясат параметри болсо:
\[ \vartheta_u \leftarrow \vartheta_u+ \alpha\delta_k \eta(X_k) \left( I(u_k)-Q(u_k|X_k) \right) \]
эрежеси менен жаңыртылат.
Изилдөөчүлөр бул үйрөнүү процесси алдын ала топтолгон маалымат топтомуна же experience replayге муктаж болбостон онлайн жүрөрүн белгилешет.
Augmented Dubins Path классикалык Dubinsтен эмнеси менен айырмаланат?
Классикалык Dubins маселеси туруктуу минималдуу бурулуу радиусу бар алдыга гана кыймылдаган аппараттын эки конфигурациянын ортосундагы ылайыктуу ийри комбинацияларын колдонот. Изилдөө виртуалдык waypoint кошуп, мүмкүн болгон траекториялар үй-бүлөсүн классикалык алты түрдөн он түргө чейин кеңейтет:
\[ D= \{ LSL,RSR,RSL,LSR,RLR,LRL, RLSLR,LRSRL,SLR,SRL \} \]
Жаңы жолдордун RLSLR жана LRSRL түрлөрү төрт ийри + бир түз сегментти; SLR жана SRL болсо эки ийри + бир түз сегментти камтыйт.
7-сүрөт бул виртуалдык waypoint-тердин бурулушту кечирээк баштоого жана багыт өзгөрүүлөрүн waypointке жакын чектелүү аймакта жүргүзүүгө шарт түзгөн геометриясын көрсөтөт.
Эмне үчүн ADP сөзсүз кыскараак болбойт?
Изилдөөнүн өз натыйжалары ADPнин негизги максаты абсолюттук минималдуу аралык эмес экенин көрсөтөт. Кошумча виртуалдык waypoint-тер жана кинематикалык жактан ылайыгыраак өтүүлөр аз өлчөмдө аралык жана execution-time өсүшүн жаратышы мүмкүн.
| Smoothing | Scenario 1 убакыт (s) | Scenario 2 убакыт (s) | Scenario 3 убакыт (s) | Scenario 1 аралык (m) | Scenario 2 аралык (m) | Scenario 3 аралык (m) |
|---|---|---|---|---|---|---|
| DP | 27.223 | 27.447 | 27.990,30 | 272.233,4 | 274.474,5 | 279.903,1 |
| ADP | 27.294 | 27.532 | 28.127,72 | 272.937,3 | 275.325,7 | 281.277,21 |
Таблицадагы жыйынтык ADP үч сценарийде тең классикалык DPден бир аз узагыраак аралык жана убакыт жаратса да, авторлордун баалоосу боюнча жылмакайыраак жана кинематикалык жактан аткарууга ылайыктуураак жергиликтүү өтүүлөрдү бергенин көрсөтөт.
Үйрөнүү параметрлери кантип тандалган?
Policy learning rate жана discount factor түздөн-түз бир гана маани катары кабыл алынган эмес; 100 симуляциялык иштетүүгө негизделген sensitivity analysis аркылуу бааланган.
Learning rate үчүн:
\[ 0.0001,\;0.0005,\;0.001,\;0.005,\;0.01 \]
маанилери; discount factor үчүн:
\[ 0.90,\;0.93,\;0.96,\;0.99 \]
маанилери сыналган.
9-сүрөттөгү корреляциялык карталар төмөн–орто үйрөнүү ылдамдыктары жана 0,93–0,96 discount factor аймагы cost менен computation time ортосунда ылайыгыраак тең салмак бергенин көрсөтөт. Акыркы моделде learning rate 0,001, discount factor 0,96 тандалган.
Симуляциядагы негизги оптималдаштыруу параметрлери кайсылар?
| Параметр | Маани | Түшүндүрмө |
|---|---|---|
| Sampling time | 0,5 s | MPC башкаруу жаңыртуу аралыгы |
| Prediction horizon | 100 | MPC божомолдоо горизонту |
| Policy learning rate | 0,001 | PG жаңыртуусу |
| Discount factor | 0,96 | Келечектеги TD таасиринин салмагы |
| Minimum separation | 8 m | Тоскоолдук / агент коопсуздук ажырымы |
| Control input төмөнкү чеги | −2 m/s² | Minimum acceleration command |
| Control input жогорку чеги | 2 m/s² | Maximum acceleration command |
| Статикалык тоскоолдуктардын саны | 4 | Полигоналдык тоскоолдуктар |
| Obstacle safety margin | 50 m | Статикалык тоскоолдуктун buffer аралыгы |
| Dynamic obstacle radius | 30 m | Динамикалык тоскоолдук модели |
| Waypoint acceptance threshold | 20 m | Кийинки сегментке өтүү чеги |
| Control effort weight | 2 | \(Q_u\) |
| Path deviation weight | 5 | \(Q_d\) |
PG-MPC реалдуу убакытта иштейби?
Scenario 2де өзүнүн реалдуу убакыт критерийин аткарат; Scenario 3төгү эң начар абал болсо 0,5 секунддук чектен ашат. Изилдөөчүлөр бир башкаруу цикли реалдуу убакыттагы деп эсептелиши үчүн perception, optimization жана control иштеринин суммасы sampling intervalдан ашпашы керек экенин белгилешет. Sampling interval 0,5 секунд.
10-сүрөттө Scenario 2 үчүн максималдуу computation time болжол менен 0,36 секунд. 4-таблица бул маанини 0,3621 секунд деп берет жана ал 0,5 секунддук чектен төмөн.
Бирок Scenario 3 үчүн PG-MPC максималдуу мааниси 0,5404 секунд. Ошондуктан изилдөөнүн “real-time feasibility” жыйынтыгы эң татаал сценарийде бардык башкаруу циклдери 0,5 секунддан төмөн калган дегенди билдирбеши керек.
Классикалык NLP-MPC менен PG-MPCнин толук натыйжалары кандай?
| Метрика | NLP-MPC S1 | NLP-MPC S2 | NLP-MPC S3 | PG-MPC S1 | PG-MPC S2 | PG-MPC S3 |
|---|---|---|---|---|---|---|
| Орточо computation time (s) | 0,095 | 0,1618 | 0,1898 | 0,128 | 0,2000 | 0,1891 |
| Максималдуу computation time (s) | 0,2295 | 0,7180 | 0,9157 | 0,2549 | 0,3621 | 0,5404 |
| Optimization convergence rate (%) | 99,993 | 92,30 | 91,919 | 99,993 | 96,87 | 94,34 |
| Constraint violation occurrence (%) | 0 | 5,67 | 3,2938 | 0 | 4,22 | 3,2864 |
Таблица сунушталган ыкманын артыкчылыгы айрыкча татаал сценарийлерде эң жогорку иштетүү жүгүн чектөө жана жакындашуу коэффициентин көтөрүү экенин көрсөтөт. Бирок PG-MPC Scenario 1 жана 2де орточо эсептөө убактысы боюнча классикалык NLP-MPCден тез эмес.
Constraint violation Scenario 2де %5,67ден %4,22ге азайса, Scenario 3тө %3,2938ден %3,2864кө гана өтө аз өзгөрөт. Булак бул натыйжаларды improved constraint satisfaction деп түшүндүрөт; бирок өзүнчө статистикалык маанилүүлүк тести берилген эмес.
Изилдөө колдогон жыйынтыктар
- Back-and-forth CPP, MPC, онлайн Policy Gradient жаңыртуусу жана augmented Dubins smoothing бир симуляциялык алкакта бирге колдонулган.
- Сунушталган түзүм статикалык жана динамикалык тоскоолдуктар бар симуляцияларда номиналдык камтуу жолунан жергиликтүү чыгып, кайра маршрутка кайта алат.
- PG-MPC Scenario 2 жана Scenario 3тө классикалык NLP-MPCге караганда максималдуу эсептөө убактысын азайткан.
- Scenario 2де convergence rate %92,30дан %96,87ге жогорулаган.
- Scenario 3тө convergence rate %91,919дан %94,34кө жогорулаган.
- Scenario 2де constraint violation occurrence %5,67ден %4,22ге азайган.
- Augmented Dubins ыкмасы симуляция сүрөттөрүндө классикалык Dubinsке караганда жылмакайыраак жана кинематикалык жактан ишке ашырууга ылайыктуураак жергиликтүү өтүүлөрдү түзөт.
- Scenario 2де PG-MPCнин максималдуу иштетүү убактысы 0,3621 s болуп, 0,5 s дискреттөө периодунан төмөн калган.
Изилдөө колдобогон же текшербеген жыйынтыктар
- Ыкма реалдуу туруктуу канаттуу УУАда учуу сыноосу менен тастыкталган эмес.
- Реалдуу LiDAR ызы-чуусу, сенсор кечигүүсү же пакет жоготуусу шартында көрсөткүч өлчөнгөн эмес.
- Реалдуу шамал жана атмосфералык disturbance шартында физикалык учуунун ийгилиги көрсөтүлгөн эмес.
- Реалдуу аткаргычтын каныгуусу жана аэродинамикалык модель белгисиздиги аппаратта текшерилген эмес.
- Бириктирилген PG-MPC системасынын жабык контур туруктуулугу үчүн rigorоз теориялык далил берилген эмес.
- Scenario 3тө бардык башкаруу циклдери 0,5 секунддук реалдуу убакыт чегинен төмөн калгандыгы көрсөтүлгөн эмес; максималдуу убакыт 0,5404 s.
- ADP классикалык Dubins жолунан кыскараак маршрут түзөрү көрсөтүлгөн эмес; үч сценарийде тең жыйынды аралык бир аз жогору.
- PG-MPC классикалык NLP-MPCге караганда ар дайым төмөн орточо computation time берери көрсөтүлгөн эмес.
- Симуляция натыйжаларын реалдуу кырсык, айыл чарба же экологиялык мониторинг миссияларына дал ушул көрсөткүчтөр менен жалпылоого болору далилденген эмес.
- Изилдөө толук алты эркиндик даражасындагы аэродинамикалык fixed-wing моделди колдонбойт; башкаруу маселеси туруктуу бийиктиктеги planar моделге кыскартылган.
Изилдөөнүн Ыкмасы жана Натыйжалары
Программалык камсыздоо жана эсептөө чөйрөсү
Алкак MATLAB R2024b чөйрөсүндө ишке ашырылган. Симуляциялар жүргүзүлгөн компьютерде:
- 4,7 GHz Intel Core i7 процессор,
- 16 GB RAM,
- NVIDIA RTX 3070 GPU
бар. Булак компьютерде GPU бар экенин көрсөтөт; бирок бардык оптималдаштыруу эсептөөлөрү GPU аркылуу тездетилгенин өзүнчө далилдебейт.
Офлайн пландоо алгоритми
Algorithm 1 томпок полигондун ар бир кыры менен бардык чокуларынын ортосундагы аралыкты эсептейт. Ар бир кыр үчүн эң алыскы vertex тандалат жана бул максималдуу аралыктардын ичинен эң кичинеси direction sweep orientation катары колдонулат.
Камера footprint туурасы жана сүрөт overlap талабы колдонулуп, параллелдүү sweep сызыктары аймакка жайгаштырылат. Номиналдык маршрут эч кандай белгисиз тоскоолдукту камтыбастан толук камтууну көздөйт.
Онлайн PG-MPC цикли
Онлайн система ар бир башкаруу кадамында негизинен төмөнкү иштерди аткарат:
- Учурдагы абал \(X_k\) алынат.
- Аныкталган статикалык жана кыймылдуу тоскоолдуктар чөйрө моделине кошулат.
- Саясат белгилери эсептелет.
- SoftMax аркылуу control action ыктымалдыктары түзүлөт.
- Башкаруу кириши аныкталат.
- Жаңы абал божомолдонот.
- Учурдагы чыгым эсептелет.
- TD error табылат.
- Critic параметри жаңыртылат.
- Policy параметрлери жаңыртылат.
- Жергиликтүү жол Augmented Dubins геометриясы менен жылмаланат.
Изилдөө бул циклди онлайн learning деп атап, алдын ала толук үйрөтүлгөн саясатты талап кылбай турганын билдирет.
Көп агымдуу түзүм
PG-MPC ишке ашырылышы optimization, perception жана navigation модулдарынын бир учурда иштөөсүн колдогон multi-threaded architecture катары моделденген. Максат — реалдуу учуу компьютериндеги асинхрондук тапшырмалар түзүмүн болжолдуу түрдө чагылдыруу.
Бирок бул архитектура физикалык avionics компьютеринде аткарылган Hardware-in-the-Loop же flight-test benchmark эмес.
Scenario 1 эмнени көрсөтөт?
Тоскоолдуксуз негизги сценарий frameworkтин номиналдык камтуу үлгүсүн ээрчишин текшерет. Классикалык жана сунушталган optimizer экөөндө тең convergence rate %99,993 жана constraint violation %0.
Бул эң жеңил шартта PG-MPCнин максималдуу эсептөө убактысы 0,2549 s болуп, NLP-MPCнин 0,2295 s маанисинен бир аз жогору. Демек, сунушталган PG жаңыртуусу жеңил чөйрөдө түз ылдамдык артыкчылыгын бербейт.
Scenario 2 эмнени көрсөтөт?
Статикалык жана кыймылдуу тоскоолдуктар кошулганда classical NLP-MPCнин максималдуу computation time мааниси 0,718 sге өсөт, ал эми PG-MPC 0,3621 sде калат.
Convergence rate ошол эле сценарийде %92,30дан %96,87ге, constraint violation мааниси %5,67ден %4,22ге өзгөрөт.
Бул сценарий изилдөөнүн “peak computation burden” боюнча эң ачык артыкчылыктарынын бирин көрсөтөт.
Scenario 3 эмнени көрсөтөт?
Көп сандагы динамикалык тоскоолдуктары бар үчүнчү сценарий эң татаал шарт. Классикалык NLP-MPCнин максималдуу эсептөө убактысы 0,9157 s, PG-MPCники 0,5404 s.
Булак бул өзгөрүүнү болжол менен %41,1 төмөндөө деп берет. PG-MPC чоң пик-убакыт артыкчылыгын бергени менен, 0,5404 s мааниси 0,5 s sampling intervalдан жогору. Ошондуктан изилдөөдө аныкталган катуу реалдуу убакыт критерийи боюнча бир worst-case ашуу бар.
Жакындашуу коэффициенти %91,919дан %94,34кө жогорулап, constraint violation occurrence %3,2938ден %3,2864кө өтө аз гана төмөндөгөн.
10-сүрөттүн негизги билдирүүсү эмне?
10-сүрөт чөйрөдөгү айрым тоскоолдук аймактарына жакын жерде эсептөө убактысы жана objective cost өсөрүн көрсөтөт. Бул чекиттер controller түз номиналдык жолду ээрчүүнүн ордуна collision avoidance жана feasibility шарттарына артыкчылык берген аймактар.
Эсептөө жүгү чөйрөнүн бардык жеринде туруктуу болбошу ыкманын worst-case убактысы эмне үчүн орточо убакыттан маанилүүрөөк экенин да көрсөтөт. Реалдуу убакыттагы flight-control колдонмосунда башкаруу циклинин deadlineын аныктоочу метрика көбүнчө орточо эмес, эң жогорку эсептөө убактысы болуп саналат.
11-сүрөт эмнени көрсөтөт?
11-сүрөт үч сценарийде MPC-ADP жана MPC-DP жолдорун жанаша салыштырат. Тоскоолдуксуз шартта эки түзүм тең номиналдык sweep patternге жакын жүрөт. Статикалык жана динамикалык тоскоолдуктар кошулганда жергиликтүү четтөөлөр пайда болот.
Жакындатылган аймактарда ADP бурулуштарынын классикалык DPге караганда акырындап өзгөрүшү авторлордун “smoother and dynamically feasible” деген баасынын визуалдык негизин түзөт.
Бирок ошол эле изилдөөнүн 4-таблицасы ADPнин жалпы аралыкты үч сценарийдин баарында бир аз көбөйткөнүн көрсөтөт. Сүрөттөгү жылмакайлык менен жалпы жол узундугу бирдей көрсөткүч эмес.
Ыкманын негизги trade-offу эмне?
Изилдөөнүн маалыматтары “ар бир жагынан жакшы” деген бир гана алгоритмдик жыйынтык бербейт. Сунушталган ыкма айрыкча татаал тоскоолдук чөйрөлөрүндө peak optimisation time жана convergence боюнча артыкчылык көрсөтөт; бирок онлайн policy update кээ бир сценарийлерде орточо эсептөө жүгүн көбөйтөт.
Ошондой эле Augmented Dubins маршрут геометриясы жылмакайыраак жана кинематикалык жактан ишке ашырууга ылайык өтүүлөрдү бергени менен, аз өлчөмдө кошумча аралык жана execution time жаратат.
Ошондуктан алкактын негизги инженердик компромисси таза минималдуу эсептөө убактысы же минималдуу аралык эмес, камтуу үзгүлтүксүздүгү + кинематикалык ишке ашыруучулук + динамикалык тоскоолдукка ыңгайлашуу айкалышына артыкчылык берүү болуп саналат.
Изилдөөнүн күчтүү жактары
- Камтуу пландоону жана онлайн башкарууну бир оптималдаштыруу түзүмүндө бириктирет.
- Туруктуу канаттуу аппараттын минималдуу бурулуу жүрүм-турумун Dubins геометриясы менен ачык эсепке алат.
- Белгисиз статикалык жана динамикалык тоскоолдуктарды бир алкакта карайт.
- Policy Gradientти MPC жаңыртуусуна түз интеграциялайт.
- Үйрөнүү ылдамдыгы жана discount factor үчүн sensitivity analysis жүргүзөт.
- Классикалык NLP-MPC менен бирдей шарттарда сандык салыштыруу берет.
- Average жана maximum computation time маанилерин өзүнчө билдирет.
- Convergence жана constraint violation метрикаларын бирге берет.
- DP жана ADP smoothing чыгымдарын өзүнчө салыштырат.
Изилдөөнүн негизги чектөөлөрү
- Бардык текшерүү симуляциялык.
- Физикалык fixed-wing UAV учуу сыноосу жок.
- Реалдуу sensor noise жана communication delay текшерилген эмес.
- Шамал жана реалдуу атмосфералык disturbance келечектеги ишке калтырылган.
- Аткаргычтын белгисиздиктери жана реалдуу flight-computer deadline жүрүм-туруму сыналган эмес.
- Модель туруктуу бийиктиктеги, төмөн тактыктагы planar dynamics ыкмасын колдонот.
- Жабык контур PG-MPC туруктуулугунун rigorоз теориялык анализи жүргүзүлгөн эмес.
- Scenario 3 worst-case убактысы 0,5 s башкаруу периодунан жогору.
- ADP аз болсо да кошумча жол узундугун жана execution time жаратат.
- Изилдөөнүн аталышындагы “Partial Gradient” менен ыкмадагы “Policy Gradient” терминологиясы дал келбейт.
Келечектеги изилдөөлөр кайсы маселелерди кароого тийиш?
Авторлор ыкманы реалдуу туруктуу канаттуу платформаларда колдонуу маанилүү кийинки кадам экенин белгилешет. Бул текшерүүгө шамалдын таасири, сенсордук ызы-чуу, communication delays жана actuator uncertainties кириши сунушталат.
Изилдөө ошондой эле бириктирилген PG-MPC түзүмүнүн rigorous closed-loop stability analysisи жүргүзүлбөгөнүн ачык мойнуна алып, муну келечектеги теориялык иш катары аныктайт.
Мындан тышкары Sliding Mode Control сыяктуу robust nonlinear control ыкмаларын disturbance rejection жана model uncertaintyге туруктуулукту жогорулатуу үчүн алкакка интеграциялоо сунушталат.
Булак жана Ыкма Эскертүүсү
Изилдөөнүн толук оригиналдуу аталышы: Real-Time Coverage Path Planning for Fixed-Wing Aerial Robots Using Partial Gradient-Based MPC and Augmented Dubins Trajectories
Авторлор: Mohammad Khaneghaei; Benyamin Ebrahimi; Davood Asadi; Onder Tutsoy; Seyed-Yaser Nabavi-Chashmi; Hassan Haghighi.
Авторлордун ирети: Булактагы оригиналдуу ирет толугу менен сакталган.
Тең салым/тең биринчи автор: Булакта көрсөтүлгөн эмес.
Жооптуу автор: Davood Asadi.
Мекемелер: Department of Electrical Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; Department of Aerospace Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; College of Arts, Technology and Environment, University of the West England, Bristol, UK; Department of Aeronautical Engineering, Gebze Technical University, Gebze, Türkiye; Laboratoire d’Informatique et Systèmes, Aix-Marseille University, Marseille, France.
Аффилиация боюнча эскертүү: Булактын үчүнчү аффилиациясы “University of the West England” түрүндө берилген. Verianla библиографиялык жазууну булакта кандай болсо ошол бойдон сактап, мекеменин атын унчукпай кайра жазган эмес.
Аталыш терминологиясы боюнча эскертүү: Оригиналдуу аталыш “Partial Gradient-Based MPC” деген сөз айкашын колдонот. Макаланын негизги бөлүгүндөгү PG ыкмасы болсо “Policy Gradient” деп аныкталып, теңдемелер ушул ыкмага ылайык түзүлгөн. Verianla оригиналдуу аталышты өзгөрткөн эмес.
Булак түрү: Рецензияланган изилдөө макаласы; алгоритм иштеп чыгуу жана симуляцияга негизделген салыштырмалуу текшерүү изилдөөсү.
Журнал: Aerospace
Басмакана: MDPI
Том / сан / макала номери: 13(8), 713
Жарыяланган дата: 9-август 2026
DOI: 10.3390/aerospace13080713
Расмий жарыя шилтемеси: https://www.mdpi.com/2226-4310/13/8/713
DOI шилтемеси: https://doi.org/10.3390/aerospace13080713
Рецензия абалы: Изилдөө рецензияланган Aerospace журналында жарыяланган илимий макала.
Лицензия: Creative Commons Attribution (CC BY) ачык жеткиликтүүлүк лицензиясы.
Каржылоо: Изилдөө Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK) тарабынан 125M675 жана 223M312 номерлүү колдоолор аркылуу каржыланган.
Маалыматтын жеткиликтүүлүгү: Маалыматтар суроо боюнча берилери көрсөтүлгөн.
Кызыкчылыктардын кагылышы: Авторлор белгилүү атаандаш финансылык кызыкчылыктар же изилдөөгө таасир этиши мүмкүн болгон жеке мамилелер жөнүндө билдиришкен эмес.
Авторлордун салымы: Mohammad Khaneghaei; карап чыгуу жана редакциялоо, биринчи долбоор, визуалдаштыруу, текшерүү, методология, ресурстар, изилдөө, формалдуу анализ, маалыматтарды курациялоо жана концептуалдаштыруу. Benyamin Ebrahimi; карап чыгуу жана редакциялоо, биринчи долбоор, визуалдаштыруу, текшерүү, методология, изилдөө, формалдуу анализ, маалыматтарды курациялоо жана концептуалдаштыруу. Davood Asadi; карап чыгуу жана редакциялоо, биринчи долбоор, көзөмөл, изилдөө, формалдуу анализ, маалыматтарды курациялоо жана концептуалдаштыруу. Onder Tutsoy; карап чыгуу жана редакциялоо, биринчи долбоор, текшерүү, методология, ресурстар жана көзөмөл. Seyed-Yaser Nabavi-Chashmi; карап чыгуу жана редакциялоо, текшерүү жана көзөмөл. Hassan Haghighi; карап чыгуу жана редакциялоо жана текшерүү.
Симуляция деңгээли: Бардык салыштыруулар MATLAB R2024bде жүргүзүлгөн симуляцияларга негизделген. Изилдөө реалдуу туруктуу канаттуу УУА учуу экспериментин, hardware-in-the-loop тестин же талаа демонстрациясын камтыбайт.
Реалдуу убакыт чеги: Булак реалдуу убакыт критерийин computation/control убактысы 0,5 s sampling intervalдан ашпашы керек деп аныктайт. PG-MPC Scenario 2де 0,3621 s максималдуу маани менен бул талапты аткарат; Scenario 3тө 0,5404 s максималдуу маани менен чектен жогору калат. Ошондуктан Verianla “бардык сценарийлерде ар бир башкаруу кадамы сөзсүз реалдуу убакытта” деген билдирүүнү колдонбойт.
Теңдеме шайкештиги боюнча эскертүү: Булактын динамикалык obstacle penalty термини Теңдеме (11) жана бириктирилген маселе туюнтмасы Теңдеме (14)тө бирдей математикалык формада берилген эмес. Verianla бул айырманы божомол менен оңдогон эмес.
ADP интерпретация чеги: Augmented Dubins Pathтын артыкчылыгы — жылмакайыраак жана кинематикалык жактан ишке ашырууга ылайык transition түзүшү. Булактын 4-таблицасындагы маанилер ADP үч сценарийде тең классикалык DPге караганда бир аз жогору жыйынды аралык жана execution time жаратканын көрсөтөт.
Туруктуулук чеги: Авторлор бириктирилген PG-MPC системасынын closed-loop stabilityси үчүн rigorоз теориялык анализ бербегенин жана муну келечектеги иш катары калтырганын ачык айтышат.
Илимий чеги: Модель натыйжалары синтетикалык статикалык/динамикалык тоскоолдуктар, идеалдаштырылган perception модели жана туруктуу бийиктиктеги planar fixed-wing динамика шартында алынган. Реалдуу шамал, sensor noise, communication delay, actuator uncertainty жана физикалык учуу системасынын таасирлери эксперименталдык бааланган эмес.
Мазмун өндүрүү ыкмасы: Бул Verianla түшүндүрмөсүндөгү илимий ыкма, теңдемелер, симуляция параметрлери, көрсөткүчтөр, сүрөт интерпретациялары жана чектөөлөр жүктөлгөн булак изилдөөгө негизделет. Тышкы текшерүү библиографиялык идентификацияны, расмий жарыя жазуусун жана рецензия статусун текшерүү үчүн гана колдонулган; тышкы булактардан жаңы илимий көрсөткүчтөр же булакта жок алгоритмдик жыйынтыктар негизги текстке кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген