

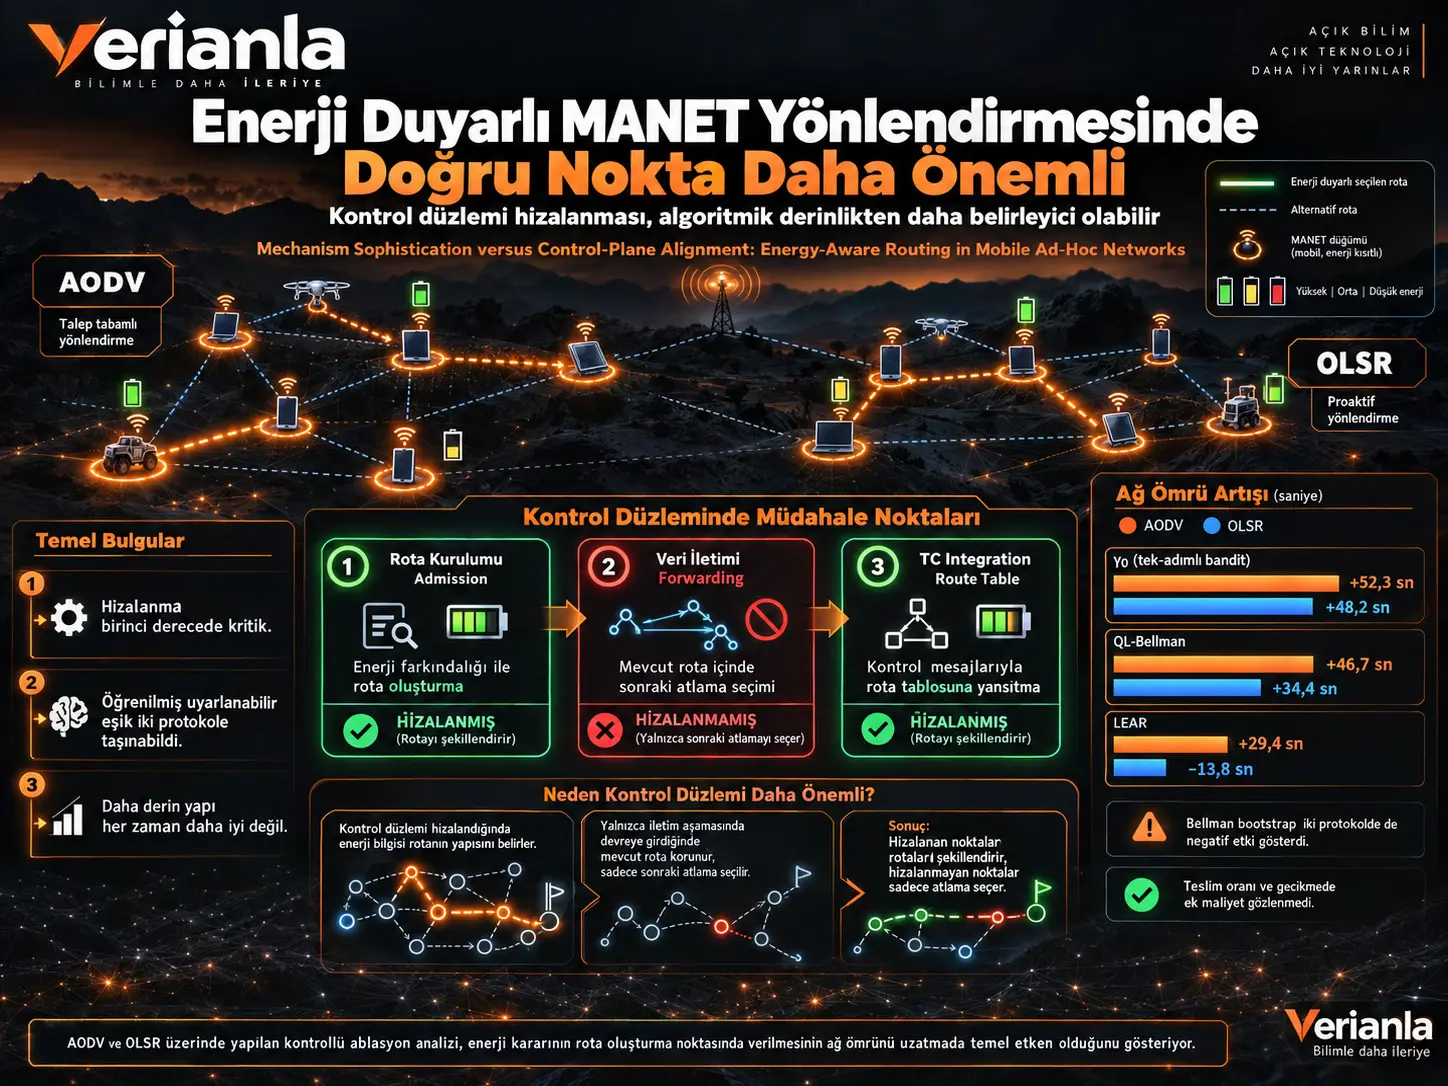
Mobil ad hoc ağlarda enerji tasarrufu için geliştirilen yönlendirme mekanizmaları giderek daha karmaşık öğrenme yöntemleri kullanabiliyor. Ancak bir mekanizmanın ağ ömrünü uzatması, gerçekten ne kadar gelişmiş olduğundan mı kaynaklanıyor, yoksa enerji kararının yönlendirme protokolünün doğru noktasında uygulanması mı daha önemli? Bu çalışma bu iki etkiyi birbirinden ayırmak için AODV ve OLSR protokolleri üzerinde kontrollü bir ablasyon analizi yürütüyor.
Çalışmanın temel kavramı kontrol-düzlemi hizalanmasıdır. Bir enerji kararı, protokolün rotaları oluşturduğu veya route table'ı biçimlendirdiği noktada uygulanıyorsa hizalanmış kabul edilir. AODV'de bu nokta RREQ mesajlarının kabulü ve yeniden yayımlanması sırasında ortaya çıkar. OLSR'de ise enerji kararının MPR seçimini etkileyen willingness mekanizmasına veya topology-control bilgisinin route table'a entegrasyonuna bağlanması gerekir. Buna karşılık veri paketinin iletilmesi sırasında yapılan bir next-hop değişikliği, rota zaten oluşturulduğu için yapısal olarak daha geç bir müdahaledir.
Yazarlar hizalanmış ve öğrenen bir enerji veto mekanizması olan QL-Bellman'ı başlangıç noktası alıyor. Daha sonra eylem, enerji bilgisi, hizalanma, öğrenme ve Bellman bootstrap gibi bileşenleri tek tek kaldırarak hangi özelliğin ağ ömrü kazancını taşıdığını ölçüyor. Deneyler ns-3 üzerinde 50 mobil düğüm, altı trafik yükü ve her koşul için 20 eşleştirilmiş rastgele tohumla yürütülüyor.
Sonuçlar, mekanizmanın doğru kontrol noktasında bulunmasının birinci derecede önemli olduğunu gösteriyor. Öğrenilmiş uyarlanabilir enerji eşiği hem AODV hem OLSR üzerinde yaşam süresi artışı sağlarken, sabit eşikli LEAR AODV'de faydalı olmasına karşın OLSR'de yaşam süresini azaltıyor. Daha önemlisi, komşu değerini geleceğe taşıyan Bellman bootstrap iki protokolde de performansı düşürüyor. Bu deneysel rejimde en yüksek ortalama yaşam süresi, bootstrap'ı kaldıran \(\gamma=0\) tek-adımlı bandit sürümüyle elde ediliyor.
Kontrol düzlemi ile veri düzlemi arasındaki fark
Bir yönlendirme protokolünde kontrol düzlemi, hangi rotaların var olacağını ve ağdaki yönlendirme bilgisinin nasıl oluşturulacağını belirleyen mekanizmalardan oluşur. Veri düzlemi ise oluşturulmuş bu yönlendirme kararlarını kullanarak gerçek paketlerin taşınmasını gerçekleştirir.
Enerji-duyarlı bir mekanizmanın hangi düzlemde ve hangi aşamada çalıştığı bu nedenle önemlidir. Bir düğüm düşük enerjili olduğu için rota oluşturulmadan önce aday yoldan çıkarılırsa, sonraki bütün veri trafiğinin kullanacağı rota kümesi değişir. Aynı enerji bilgisi paket iletimi sırasında kullanılırsa, mekanizma artık hangi rotaların mevcut olduğunu değiştiremez; yalnız daha önce oluşturulmuş seçenekler arasında karar verebilir.
Kontrol-Düzlemi Hizalanması Ne Anlama Geliyor?
Çalışmada bir mekanizma, eylem noktası protokolün rota oluşturma veya route-state oluşturma aşamasıyla çakışıyorsa hizalanmış kabul edilir. Bu yalnız iyi bir konum seçimi değildir; eylem noktasının mekanizmanın nedensel işlevini değiştirdiği savunulur.
AODV'de hizalanma
AODV reaktif bir protokoldür. Gerektiğinde rota keşfi yapılır ve RREQ mesajları ağda yayılarak olası yollar oluşturulur.
Enerji veto mekanizması bir düğümün RREQ mesajını kabul edip yeniden yayımlayıp yayımlamayacağını belirlerse, düşük enerjili düğüm aday yolun içine hiç girmeyebilir. Böylece enerji kararı doğrudan hangi rotaların var olacağını biçimlendirir.
Çalışmanın hizalanmış AODV mekanizmaları bu noktada çalışır.
OLSR'de hizalanma
OLSR ise proaktif bir protokoldür. Rotaları talep üzerine keşfetmek yerine topoloji bilgisini sürekli korur ve Multipoint Relay (MPR) yapısını kullanır.
Bu nedenle AODV'deki RREQ veto mekanizmasını OLSR'ye sözcüğü sözcüğüne taşımak mümkün değildir. İşlevsel olarak karşılık gelen kontrol noktaları, enerji seviyesinin MPR seçimini etkileyen willingness mekanizmasına ve topology-control bilgisinin yerel route table'a entegrasyonuna bağlanmasıdır.
Bu ayrım makalenin temel iddiasını oluşturur: bir algoritmanın protokoller arasında taşınabilirliğini yalnız karar kuralının aynı olmasına bakarak değerlendirmek yeterli değildir; kararın yeni protokolde hâlâ rota oluşturma noktasına temas edip etmediği kontrol edilmelidir.
Yanlış yerde çalışan mekanizma
Kaynakta override varyantı enerji kararını AODV'de data-forwarding aşamasına taşır. Burada enerji bilgisi hâlâ vardır ve öğrenme mekanizması hâlâ çalışabilir; fakat rota daha önce kurulmuştur.
Bu varyant yalnız mevcut rotalar arasında next-hop reselection yapabilir. Deneylerde yaşam süresi kazancının büyük ölçüde kaybolması, yazarların hizalanmayı yalnız bir hiperparametre değil, mekanizmanın ne yapabildiğini belirleyen yapısal bir özellik olarak yorumlamasının temel dayanaklarından biridir.
QL-Bellman Enerji Veto Mekanizması Nasıl Çalışıyor?
Referans mekanizma, enerji durumunu birkaç kaba sınıfa ayıran ve iki eylem arasında çevrimiçi öğrenme yapan dağıtık bir admission-control sistemidir. Eylemler basittir: gelen kontrol mesajını kabul etmek veya veto etmek.
Enerji durumunun ayrıklaştırılması
Normalize edilmiş enerji
\[ e\in[0,1] \]
dört kaba duruma ayrılır:
\[ s=\lfloor 4e\rfloor. \]
Dört durum kullanılması bilinçli bir tercihtir. Çok ince durum ayrımı yapılması halinde her durum daha az ziyaret edilir ve çevrimiçi öğrenme için yeterli örnek oluşmayabilir.
Ödül sinyali
Enerjiye bağlı ödül üç seviyelidir:
\[ r= \begin{cases} +1, & e\geq\theta_{\mathrm{hi}},\\ -1, & e<\theta_{\mathrm{lo}},\\ 0, & \text{diğer durumlarda}. \end{cases} \]
Kaynakta
\[ \theta_{\mathrm{hi}}=0.66, \qquad \theta_{\mathrm{lo}}=0.33 \]
kullanılır.
Bellman güncellemesi
Kabul eylemi için:
\[ q_{\mathrm{acc}} \leftarrow (1-\alpha)q_{\mathrm{acc}} + \alpha \left( r+\gamma V_{\mathrm{nbr}} \right), \]
veto eylemi için ise:
\[ q_{\mathrm{veto}} \leftarrow (1-\alpha)q_{\mathrm{veto}} + \alpha(-r). \]
Buradaki
\[ \gamma V_{\mathrm{nbr}} \]
terimi komşu düğümün değerini mevcut karara taşıyan Bellman bootstrap'tır.
Ana QL-Bellman yapılandırmasında
\[ \alpha=0.3,\qquad \gamma=0.9 \]
kullanılır.
\(\gamma=0\) yapıldığında gelecek/komşu değerinin bootstrap etkisi tamamen kaldırılır ve mekanizma bir tek-adımlı bandit haline gelir.
Çalışmanın Yöntemi ve Bulguları
Ablasyon tasarımı
| Varyant | Enerji sinyali | Doğru eylem noktası | Öğrenme | Bellman bootstrap | Test edilen fikir |
|---|---|---|---|---|---|
| Vanilla | Yok | Yok | Yok | Yok | Değiştirilmemiş protokol |
| QL-Bellman | Var | Var | Var | Var | Tam referans mekanizma |
| LEAR | Var | Var | Yok | Yok | Sabit eşik |
| \(\gamma_0\) | Var | Var | Var | Yok | Bootstrap gerekli mi? |
| veto-off | Var | Var | Var | Var | Öğrenmek ama eylem yapmamak |
| blind | Rastgele | Var | Hayır | Hayır | Enerji bilgisinin değeri |
| override | Var | Yanlış / forwarding | Var | Var | Eylem noktasının etkisi |
Neden klasik “algoritma yarışı” yapılmıyor?
Çalışmada farklı yazılım sistemlerinin sonuçlarını yan yana koymak yerine aynı kod tabanında compile-time flag'lerle özellikler açılıp kapatılıyor. Bütün flag'ler kapalıyken ikili dosyanın değiştirilmemiş ns-3 protokolüyle byte-identical olduğu kontrol edilmiş.
Ayrıca varyantlar aynı rastgele tohumlarla eşleştirilmiştir. Böylece aynı seed, aynı hareketlilik ve başlangıç enerji koşullarını bütün varyantlarda üretir. Fark ölçümü:
\[ \Delta HND = HND_{\mathrm{varyant}} - HND_{\mathrm{vanilla}} \]
şeklinde aynı deney koşulundaki eşleştirilmiş fark üzerinden yapılır.
ns-3 deney ortamı
| Parametre | Değer |
|---|---|
| Simülatör | ns-3.46.1 |
| Düğüm sayısı | 50 |
| Alan | 1000 × 1000 m |
| Hareket | Random Waypoint |
| Hız | 1–5 m/s |
| Bekleme | 0–2 s |
| Radyo | IEEE 802.11g, 54 Mbps |
| Menzil modeli | 250 m cap |
| Paket | 512 B UDP |
| Trafik | Akış başına 4 paket/s |
| Akış sayıları | 10, 15, 20, 25, 30, 35 |
| Başlangıç enerjisi | 3,3–3,7 J |
| Süre | 500 s |
| Rastgele tohum | Her hücre için 20 |
Half-Node-Death neden kullanılıyor?
Ana performans ölçütü Half-Node-Death (HND), yani 50 düğümlü ağda 25'inci düğümün öldüğü zamandır.
Tek bir düğümün alışılmadık biçimde erken veya geç ölmesine aşırı duyarlı olmaması nedeniyle ağın kullanım ömrünü temsil eden daha toplu bir end-of-life ölçüsüdür.
Kaynakta toplam 1560 deney hücresinin tamamında 25'inci düğüm 500 saniyelik deney bitmeden ölmüştür. Dolayısıyla HND sonucu sansürlenmemiş veya tahmin edilmemiştir.
Yaşam süresi sonuçları
| Mekanizma | AODV ΔHND | OLSR ΔHND |
|---|---|---|
| \(\gamma_0\) tek-adımlı bandit | +52,3 s | +48,2 s |
| QL-Bellman | +46,7 s | +34,4 s |
| LEAR | +29,4 s | −13,8 s |
| Blind veto | +12,2 s | +4,9 s |
| Veto-off | +0,4 s | −0,3 s |
| Override | −2,6 s | Kaynakta AODV-only |
En Büyük Kazanç Algoritmik Derinlikten mi Geliyor?
Bu deneylerde hayır. En yüksek yaşam süresi kazancını tam Bellman güncellemesi değil, komşu değerini bootstrap etmeyen \(\gamma=0\) tek-adımlı bandit sürümü sağlamıştır. Ancak bu sonuç “pekiştirmeli öğrenme gereksizdir” anlamına gelmez. Sabit eşik yerine uyarlanabilir öğrenilmiş karar kuralı özellikle OLSR'de kritik bir katkı sağlamıştır.
AODV için katkı ayrıştırması
Kaynağın additive scale analizi:
\[ \underbrace{+29.4}_{\text{hizalanmış sabit veto}} + \underbrace{22.9}_{\text{öğrenilmiş kural}} - \underbrace{5.6}_{\text{Bellman bootstrap}} = \underbrace{46.7}_{\text{QL-Bellman toplamı}} \quad\mathrm{s} \]
şeklindedir.
Yani AODV'de doğru noktaya enerji eşiği koymak büyük bir ilk kazanç üretir; öğrenme bunun üzerine ek kazanç getirir; çok-adımlı bootstrap ise bu kazancın bir bölümünü geri alır.
OLSR için katkı ayrıştırması
OLSR'de öğrenilmiş, hizalanmış TC veto:
\[ +48.2\ \mathrm{s} \]
kazanç sağlarken Bellman bootstrap:
\[ -13.8\ \mathrm{s} \]
katkı yapar ve toplam QL-Bellman kazancı:
\[ +34.4\ \mathrm{s} \]
olur.
OLSR'deki sabit LEAR willingness yaklaşımı ise ayrı bir mekanizma olarak
\[ -13.8\ \mathrm{s} \]
sonuç verir.
Bellman bootstrap neden zarar vermiş olabilir?
Kaynağın açıklamasında iki yapısal neden öne çıkar:
- Eylem yalnız admit veya veto şeklinde ikilidir; dolayısıyla uzun çok-adımlı değer zincirinin kullanabileceği zengin bir karar yapısı bulunmayabilir.
- Mobil ve sürekli enerji tüketen ağda komşunun öğrenilmiş değeri zamanla hızla bayatlayabilir. Bootstrap bu eski değeri hoplar boyunca yayarak ek gürültü oluşturabilir.
Bu nedenle çalışma koşullarında sığ, tek-adımlı öğrenme daha kararlı bir çalışma noktası oluşturmuştur.
Sabit Enerji Eşiği Neden AODV'de Çalışırken OLSR'de Çöküyor?
LEAR'ın AODV'de +29,4 saniye yaşam süresi kazancı sağlayıp OLSR'de −13,8 saniyeye düşmesi, aynı tür enerji eşiğinin farklı protokol ailelerine doğrudan taşınamayabileceğini gösteriyor. Kaynak bunu yalnız kötü eşik ayarıyla açıklamıyor; OLSR willingness eşiği 0,1 ile 0,5 arasında tarandığında bütün sabit değerlerin yaşam süresini düşürdüğü bildiriliyor.
Öğrenilmiş \(\gamma_0\) veto ise yeniden ayar yapılmadan:
\[ +52.3\ \mathrm{s} \]
AODV ve
\[ +48.2\ \mathrm{s} \]
OLSR kazancı sağlıyor.
Bu nedenle çalışmanın “rule quality” sonucu, öğrenilmiş uyarlanabilir eşiğin sabit eşiğe göre protokol değişimine daha dayanıklı olduğunu gösteriyor.
Hizalanmanın istatistiksel etkisi
| Protokol | Lever | Ortalama ΔHND | %95 güven aralığı | p | Cliff's δ |
|---|---|---|---|---|---|
| AODV | Alignment | +46,3 s | [+41,2, +51,3] | <10⁻⁴ | +1,00 |
| AODV | Point | +49,3 s | [+44,0, +54,4] | <10⁻⁴ | +1,00 |
| AODV | Intelligence | +34,5 s | [+29,9, +39,2] | <10⁻⁴ | +1,00 |
| AODV | Rule quality | +17,3 s | [+13,4, +21,9] | <10⁻⁴ | +1,00 |
| AODV | Bellman bootstrap | −5,5 s | [−9,0, −2,2] | 0,0037 | −0,60 |
| OLSR | Alignment | +34,8 s | [+28,7, +40,9] | <10⁻⁴ | +1,00 |
| OLSR | Rule quality | +48,2 s | [+42,0, +54,6] | <10⁻⁴ | +1,00 |
| OLSR | Bellman bootstrap | −13,7 s | [−16,8, −10,7] | <10⁻⁴ | −1,00 |
\(\delta=+1\), karşılaştırılan 20 eşleştirilmiş seed'in tamamının aynı yönde sonuç verdiğini gösterir. Bu nedenle hizalanma, enerji bilgisinin kullanılması ve öğrenilmiş kural gibi büyük etkiler yalnız ortalamadaki birkaç uç koşuldan kaynaklanmamıştır.
Daha Uzun Ağ Ömrü Paket Tesliminden Ödün Verilerek mi Elde Ediliyor?
Kaynakta incelenen olumlu yaşam süresi mekanizmaları için böyle bir ödünleşim gözlenmemiştir. PDR değişimi ya olumlu ya da istatistiksel olarak nötrdür; end-to-end delay da ana enerji-duyarlı çalışma noktalarında nötr veya daha düşüktür.
PDR üzerindeki hizalanma etkisi
AODV için hizalanma:
\[ \Delta PDR=+1.77 \]
yüzde puan; OLSR için:
\[ \Delta PDR=+1.07 \]
yüzde puan olarak raporlanmıştır.
AODV'de düşük değerli RREQ trafiğinin budanması kablosuz ortamda çarpışma ve congestion yükünü azaltabilir. OLSR'de ise TC veto flooding miktarını aynı şekilde azaltmadığından, kaynağın yorumu daha çok trafiğin enerjisi tükenen düğümlerden uzaklaştırılmasıdır.
Gecikme sonucu
\(\gamma_0\) varyantı AODV üzerinde vanilla'ya göre:
\[ -1.48\ \mathrm{ms} \]
fark üretmiş, ancak güven aralığı sıfırı içerdiği için anlamlı bir yavaşlama veya hızlanma gösterilmemiştir.
OLSR'de ise:
\[ -2.08\ \mathrm{ms} \]
ve %95 güven aralığı
\[ [-3.01,-1.19]\ \mathrm{ms} \]
olarak raporlanmış, yani bu çalışma koşullarında daha hızlıdır.
Buna karşılık AODV'deki yanlış hizalanmış override yaklaşık +5,45 ms ve signal-blind veto +4,69 ms gecikme eklemiştir.
Çalışmanın desteklediği sonuçlar
- İncelenen AODV ve OLSR mimarilerinde enerji kararının route-construction ile hizalanması ağ ömrü kazancının büyük ve gerekli bileşenidir.
- Yalnız öğrenmek, mekanizma eylemi gerçekten uygulamıyorsa yaşam süresi kazancı sağlamamaktadır.
- Enerjiye dayalı karar, rastgele veto uygulamasından belirgin biçimde daha etkilidir.
- Uyarlanabilir öğrenilmiş eşik iki protokole de taşınabilirken sabit LEAR kuralı OLSR'de başarısız olmuştur.
- Bu deneysel rejimde Bellman bootstrap eklemek iki protokolde de yaşam süresini azaltmıştır.
- \(\gamma=0\) tek-adımlı bandit incelenen varyantlar arasında en yüksek ortalama HND kazancını vermiştir.
- Olumlu yaşam süresi kazancı daha az paket teslim etme veya daha yüksek gecikme pahasına ortaya çıkmamıştır.
Çalışmanın desteklemediği yorumlar
- Çalışma “pekiştirmeli öğrenme gereksizdir” sonucunu desteklemez; öğrenilmiş uyarlanabilir eşik önemli bir pozitif katkıdır.
- Bellman bootstrap'ın bütün ağlarda veya bütün RL problemlerinde zararlı olduğu gösterilmemiştir.
- Kontrol-düzlemi hizalanmasının bütün protokol ailelerinde evrensel yasa olduğu kanıtlanmamıştır.
- Sonuçlar iki protokol, 50 düğümlü bir senaryo ailesi ve altı trafik yükü üzerinde elde edilmiştir.
- DSR, OLSRv2 veya diğer protokollerde aynı büyüklükte etki gösterildiği kanıtlanmamıştır.
- Sonuçlar gerçek fiziksel MANET saha dağıtımı değil ns-3 simülasyonudur.
- Düğüm yoğunluğu, farklı hareketlilik modelleri ve farklı başlangıç enerji dağılımları için sonuçların aynı kalacağı gösterilmemiştir.
Kaynak ve Yöntem Notu
Özgün başlık: Mechanism Sophistication versus Control-Plane Alignment: Energy-Aware Routing in Mobile Ad-Hoc Networks
Yazarlar: Redha Mili; Salim Chikhi.
Yazar kimliği notu: İncelenen PDF çift-kör değerlendirme sürümüdür ve yazar adlarını göstermemektedir. Yazar kimliği SSRN bibliyografik kaydından doğrulanmıştır.
Afiliasyon: SSRN, Salim Chikhi için University of Constantine 2 bilgisini vermektedir; Redha Mili için SSRN üzerinde afiliyasyon bilgisi belirtilmemiştir.
Kaynak türü: Mobil ad hoc ağlar ve pekiştirmeli öğrenme alanında kontrollü ablasyon ve ağ simülasyonu çalışması.
Platform: SSRN.
SSRN Abstract ID: 6963867.
DOI: 10.2139/ssrn.6963867.
SSRN yayın tarihi: 18 Haziran 2026.
Hakemlik durumu: İncelenen PDF açıkça “Preprint not peer reviewed” ibaresi taşımaktadır.
Telif/lisans yaklaşımı: PDF içinde açık bir Creative Commons veya benzeri açık yeniden kullanım lisansı belirtilmemektedir. Bu nedenle Verianla metni korumacı telif yaklaşımıyla hazırlanmış; kaynak cümleleri, özgün figürleri ve grafik tasarımları yeniden yayımlanmamıştır. Bilimsel olgular, sayısal sonuçlar ve yöntem yapısı bağımsız öğretici anlatım ve yeniden düzenlenmiş tablolarla açıklanmıştır.
Simülatör: ns-3.46.1.
Deney kapsamı: 50 mobil düğüm, altı trafik yükü, AODV ve OLSR protokolleri, 20 eşleştirilmiş seed, 500 saniyelik çalışma süresi.
Birincil ölçüt: Half-Node-Death (HND), yani 25'inci düğümün ölüm zamanı.
İkincil ölçütler: Packet Delivery Ratio (PDR) ve uygulama düzeyinde end-to-end delay.
İstatistik: Eşleştirilmiş seed farkları; 10.000 yeniden örneklemeli bootstrap %95 güven aralığı; exact paired Wilcoxon signed-rank testi; Cliff's delta.
Sansürleme: Kaynak toplam 1560 hücrenin hiçbirinin HND açısından sansürlenmediğini bildirmektedir.
Reprodüksiyon: Kaynak kampanya scriptlerinin, ns-3 enerji-modeli konfigürasyonunun ve bütün çalışmalara ait ham per-node death trace'lerinin makaleyle birlikte yayımlandığını belirtmektedir.
Temel sınırlılık: Yazarların kendi ifadesiyle çalışma iki protokolde ölçülmüş bir decomposition sonucudur; “alignment sophistication'dan daima önemlidir” biçiminde bütün ağ sistemlerine uygulanabilecek evrensel bir teorem değildir.
Görsel yeniden inşa: Uygundur. En güçlü özgün şema, aynı enerji sinyalinin AODV RREQ admission, data forwarding ve OLSR TC integration noktalarında üç farklı nedensel işleve dönüşmesini gösterebilir.
Verianla Live / Live Figure: Uygundur. AODV ve OLSR akışlarında enerji mekanizmasının eylem noktası değiştirildiğinde rotanın nasıl “oluşturulduğu”, “yalnız kullanıldığı” veya “route table'ın yeniden biçimlendirildiği” sabit verilerle animasyon halinde gösterilebilir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir