

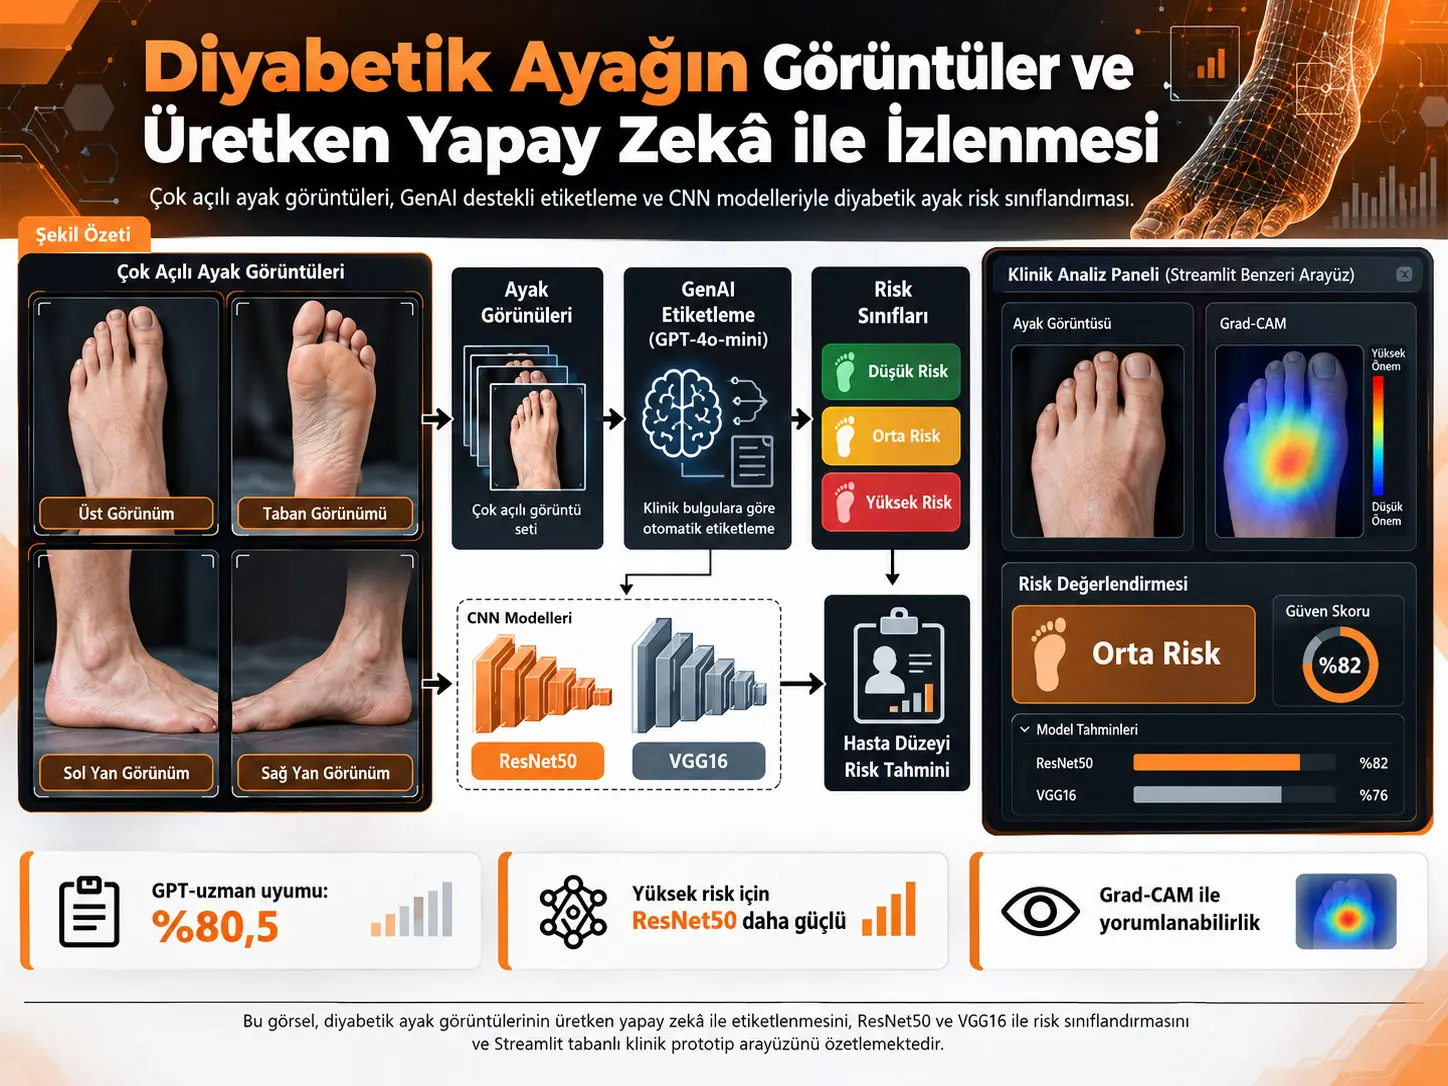
Bu çalışmadaki diyabetik ayak risk değerlendirme sistemi, çok açılı ayak görüntülerini üretken yapay zekâ ile etiketleyen, bu etiketlerle önceden eğitilmiş evrişimli sinir ağlarını (convolutional neural network, CNN) ince ayardan geçiren ve görüntü düzeyindeki tahminleri hasta düzeyinde birleştiren bir makine öğrenmesi yaklaşımıdır. GPT-4o-mini her görüntüye Low Risk, Medium Risk veya High Risk etiketi vermiş; bu etiketlerle ResNet50 ve VGG16 modelleri eğitilmiş ve test edilmiştir. Nihai veri setinde 3255 görüntü bulunmaktadır. İki modelin genel performansı birbirine yakın olmakla birlikte ResNet50, High Risk sınıfının saptanmasında daha yüksek recall ve F1 değerleri verdiği için prototip Streamlit uygulamasında kullanılmak üzere seçilmiştir. Bununla birlikte çalışma, gelecekte gerçekten ülser gelişip gelişmediğini uzunlamasına klinik sonlanımlarla doğrulamamış; model eğitimi ve test etiketleri esas olarak GPT tarafından oluşturulmuştur. Bu nedenle sonuçlar klinik gelecek tahmininin doğrudan doğrulanması olarak değil, GenAI destekli etiketleme ile CNN tabanlı bir risk sınıflandırma pipeline'ının teknik fizibilitesi olarak yorumlanmalıdır.
GPT tarafından oluşturulan etiketlerin tıbbi uzmanlarla karşılaştırıldığı 87 hastalık alt grupta %80,5 anlaşma sağlanmış; 70 hasta için etiketler uyuşmuş, 17 hastada uyuşmazlık görülmüştür. Araştırmacılar GPT'nin özellikle Low ve Medium Risk arasındaki daha ince görsel farklarda hata yapabildiğini ve üretken yapay zekâ etiketlerinin uzman etiketlemesinin yerine geçmemesi gerektiğini açıkça belirtmektedir.
Test setinde ResNet50 için görüntü düzeyi doğruluk %75,05, hasta düzeyi doğruluk %72,54; VGG16 için sırasıyla %75,48 ve %75,35 olarak raporlanmıştır. Buna karşılık High Risk sınıfında ResNet50'nin recall değeri görüntü düzeyinde %80,95 ve hasta düzeyinde %85,00; VGG16'nın değerleri ise %71,43 ve %75,00'dır. Her iki modelde High Risk precision %100 olarak bildirilmiştir. Bu sonuçlar ResNet50'nin özellikle yüksek riskli vakaları kaçırmama açısından daha avantajlı olabileceğini düşündürmüş ve uygulama seçimini belirlemiştir.
Diyabetik ayağın görüntüyle izlenmesinde hangi problem çözülmeye çalışılıyor?
Diyabetik ayak değerlendirmesi klasik klinik uygulamada yalnız görsel incelemeye dayanmaz; dokunma, sıcaklık, vibrasyon duyusu, dolaşım ve pedal nabız gibi başka klinik değerlendirmeler de kullanılır. Bununla birlikte ayağın görünümü, ülser, renk değişikliği, kuruluk, şişlik, nasır ve deformite gibi birçok klinik işaret hakkında bilgi taşıyabilir.
Kaynak çalışmanın hedefi bu görsel bilgiden yararlanarak diyabetik ayağın zaman içinde daha ciddi bir duruma ilerleme riskini Low Risk, Medium Risk ve High Risk olmak üzere üç sınıfta değerlendiren otomatik bir sistem geliştirmektir. Sisteme hasta tarafından bildirilen semptom veya anamnez verisi girilmemiş; model yalnız görüntülerden türetilen görsel özellikler üzerinde çalışmıştır.
Araştırmacıların gerekçelerinden biri, uzman değerlendirmesine erişimin özellikle uzak veya sağlık kaynağı kısıtlı bölgelerde sınırlı olabilmesidir. Diğer gerekçe ise görsel değerlendirmenin uzman deneyimine göre değişebilmesidir. Otomatik görüntü analizi, bu insan değerlendirmesinin yerine geçmekten çok tekrarlanabilir bir yardımcı katman sağlama potansiyeli açısından araştırılmıştır.
Üretken Yapay Zekâ Bu Çalışmada Ne Yaptı?
Üretken yapay zekâ bu çalışmada nihai CNN sınıflandırıcısı olarak değil, eğitim veri setinin etiketleyicisi olarak kullanıldı: GPT-4o-mini ayak görüntülerindeki görünür klinik işaretleri değerlendirerek her görüntüye Low Risk, Medium Risk veya High Risk etiketi verdi ve ResNet50 ile VGG16 bu GPT-üretilmiş etiketler kullanılarak eğitildi.
Etiketleme zinciri
Kaynağın 5. sayfasındaki Şekil 1 yöntemi şu zincirle göstermektedir:
- Diyabetik ayak klinik görüntülerinin toplanması.
- Görüntünün OpenAI API üzerinden üretken yapay zekâ etiketleme pipeline'ına aktarılması.
- Her görüntü için Low Risk, Medium Risk veya High Risk etiketi oluşturulması.
- Görüntülerin risk sınıflarına göre yeniden düzenlenmesi.
- ResNet50 ve VGG16 modellerinin eğitilmesi.
- Doğrulama ve test işlemleri.
- Her görüntü için risk tahmini oluşturulması.
- Aynı hastaya ait görüntülerin tek hasta etiketi altında birleştirilmesi.
- Sonucun Streamlit uygulamasında gösterilmesi.
Neden tek görüntü yerine dört farklı açı kullanıldı?
Klinik veri setinde aynı ayağın taban, üst, sağ yan ve sol yan görünümleri kullanılmıştır. Bunun nedeni ülser, renk değişikliği veya şişlik gibi bir risk işaretinin yalnız belirli bir açıdan görülebilmesi, başka bir açıdaki dokunun ise normal görünebilmesidir.
Kaynağın 5. sayfasındaki Şekil 2 bu dört görünümü gerçek klinik görüntülerle göstermektedir. Çok açılı yaklaşım, tek fotoğrafa bağımlı kararın görünmeyen bölgeler nedeniyle oluşturabileceği bilgi kaybını azaltmayı amaçlamaktadır.
GPT promptu hangi görsel bulgulara bakıyordu?
Kaynağın Ek A bölümündeki yapılandırılmış prompt, risk etiketleme işleminin serbest biçimli bir görüntü yorumu olarak bırakılmadığını göstermektedir. Prompt özellikle görüntü kalitesi ve kapsamı ile aşağıdaki görünür özelliklerin değerlendirilmesini istemektedir:
- nasır ve hiperkeratoz,
- kuruluk, çatlak ve pullanma,
- eritem ve lokal kızarıklık,
- macerasyon,
- preülseratif lezyonlar ve renk değişiklikleri,
- yapısal ayak deformiteleri,
- ödem,
- vasküler görünümü düşündürebilecek cilt değişiklikleri,
- ülser, enfeksiyon veya nekroz,
- önceden geçirilmiş amputasyona ait görünür bulgular.
Promptun risk kılavuzunda sağlıklı ve bütünlüğü korunmuş cilt Low Risk; hafif kuruluk, renk değişikliği veya yüzeysel lezyonlar Medium Risk; açık ülser, enfeksiyon, nekroz, belirgin şişlik, ciddi deformite veya amputasyon bulguları High Risk yönünde değerlendirilmiştir.
Bu etiketler çalışmanın hazırladığı operasyonel görüntü sınıflarıdır. Bir hastanın gerçek klinik prognozunu yalnız bu görüntü sınıflarının belirlediği varsayılmamalıdır.
Hasta Düzeyindeki Risk Etiketi Nasıl Oluşturuldu?
Hasta düzeyindeki risk etiketi aynı hastaya ait birden fazla görüntü tahmininin önceden belirlenmiş bir worst-case kuralıyla birleştirilmesiyle oluşturuldu: görüntülerden en az biri High Risk ise hasta High Risk, aksi halde Medium görüntüler Low görüntülerden daha fazla veya eşitse Medium Risk, diğer durumlarda Low Risk olarak sınıflandırıldı.
Agregasyon kuralı
- High Risk: Hastanın en az bir görüntüsü High Risk ise bütün hasta High Risk kabul edildi.
- Medium Risk: High Risk görüntü yoksa ve Medium Risk görüntü sayısı Low Risk sayısından fazla veya ona eşitse hasta Medium Risk olarak etiketlendi.
- Low Risk: High Risk görüntü yoksa ve Low Risk görüntüler Medium Risk görüntülerden fazlaysa hasta Low Risk olarak etiketlendi.
Bu yapı High Risk bulgusunun tek bir açıdan görülmesi durumunda diğer normal görünümler tarafından seyreltilmesini önlemeyi amaçlar. Buna karşılık kural aynı zamanda tek bir hatalı High Risk sınıflandırmasının bütün hasta etiketini High Risk'e yükseltebilmesi anlamına gelir. Bu nedenle görüntü düzeyi hata profili hasta düzeyi karar mekanizması açısından önemlidir.
GPT Etiketleri Uzman Etiketlerinin Yerini Tuttu mu?
Hayır. GPT etiketleri 87 hastalık uzman-etkiketli alt grupta %80,5 oranında uyuşmuş olsa da 17 hastada farklılık görülmüş ve araştırmacılar üretken yapay zekâ etiketlerinin insan uzman etiketlemesinin yerine geçmemesi gerektiğini açıkça belirtmiştir.
Uzman karşılaştırmasının sonucu
Uzmanlarla karşılaştırılabilen 87 hastanın 70'inde GPT etiketi uzman etiketiyle eşleşmiştir. Toplam 17 uyuşmazlığın:
- 9'u Low→Medium veya Medium→High gibi komşu sınıflar arasındaki orta düzey uyuşmazlıklar,
- 8'i Low ve High sınıfları arasında dahi ortaya çıkabilen ciddi uyuşmazlıklar
olarak sınıflandırılmıştır.
PDF'nin 9. sayfasındaki Şekil 4 ayrıca GPT'nin uzman etiketlerine kıyasla daha fazla Medium ve High Risk sınıflandırması verdiğini gösterir. Uzmanların dağılımı daha çok Low Risk yönündedir. Bu fark GPT etiketlerinin yalnız sayısal olarak değil, sınıf dağılımı açısından da uzman referansından sistematik olarak farklılaşabileceğini göstermektedir.
Low Risk ve Medium Risk neden daha fazla karışıyor?
Kaynak, Low Risk ve Medium Risk görüntülerindeki işaretlerin birbirine benzeyebildiğini vurgulamaktadır. Hafif kuruluk gibi bir görünüm bir durumda Low, başka bir durumda Medium olarak değerlendirilebilir. Sınıfların sınırları keskin olmadığı için hem GPT etiketlemesinde hem CNN sınıflandırmasında bu iki sınıfın ayrımı High Risk'e göre daha zordur.
High Risk sınıfında açık ülser, nekroz, belirgin enfeksiyon veya büyük deformite gibi daha belirgin görsel işaretlerin bulunabilmesi, modellerin bu sınıfta daha güçlü performans göstermesine katkıda bulunabilecek bir faktördür.
Grad-CAM ne amaçla kullanıldı?
Gradient-weighted Class Activation Mapping (Grad-CAM), CNN'nin bir görüntüyü sınıflandırırken hangi görüntü bölgelerinin tahmine daha fazla katkı verdiğini görsel bir ısı haritasıyla gösteren yorumlanabilirlik yöntemidir.
Streamlit prototipinde orijinal ayak görüntüsünün yanında Grad-CAM ısı haritası gösterilmektedir. Böylece kullanıcı modelin örneğin ülser veya kuru cilt bölgesi gibi klinik açıdan anlamlı bir alana mı, yoksa ilgisiz bir görüntü bölgesine mi odaklandığını kontrol edebilir.
Grad-CAM'in bir bölgeyi vurgulaması, bu bölgenin hastalığın nedensel nedeni olduğunu kanıtlamaz. Grad-CAM yalnız model kararına katkı veren görüntü bölgelerinin yorumlanmasına yardımcı olur.
Çalışmanın Yöntemi ve Bulguları
Veri Seti Nasıl Hazırlandı?
Çalışmanın veri seti Portekiz sağlık sistemindeki bir yerel sağlık biriminde DFAA projesi için toplanan çok açılı diyabetik ayak görüntülerinden oluşturuldu; sınıf dengesizliğini azaltmak için kamuya açık Kaggle görüntüleri de eklendi ve nihai veri seti 1807 Low Risk, 1294 Medium Risk ve 154 High Risk olmak üzere toplam 3255 görüntü içerdi.
Klinik görüntülerin kaynağı
Klinik görüntüler DFAA — Diabetic Foot Automated Assessment projesi için oluşturulmuş kamera sistemiyle Portekiz sağlık sistemindeki bir ULS hastanesinde elde edilmiştir. Orijinal veriler hasta bazında klasörlenmiş ve aynı ayağın farklı açılardan çekilmiş görüntülerini içermiştir.
Kaggle görüntülerinin eklenmesi
Orijinal veri setinde High Risk sınıfı belirgin biçimde az temsil edilmiştir. Kaynak, ciddi yüksek riskli örnekleri artırmak amacıyla kamuya açık Kaggle görüntülerini veri setine eklemiştir.
| Risk sınıfı | Kaggle olmadan | Kaggle eklendikten sonra |
|---|---|---|
| Low Risk | 1807 | 1807 |
| Medium Risk | 1294 | 1294 |
| High Risk | 77 | 154 |
| Toplam | 3178 | 3255 |
Kaynak, harici görüntülerin klinik görüntülerden çözünürlük, aydınlatma, kullanılan kamera ve hasta demografisi açısından farklı olabileceğini açıkça belirtmektedir. Bu durum modelin öğrendiği görüntü dağılımına bir domain farkı ekleyebilir.
Hasta bazlı eğitim/doğrulama/test ayrımı
Aynı hastaya ait görüntülerin eğitim ve test kümelerine dağılması veri sızıntısına neden olabileceği için veri bölme işlemi hasta kimliği düzeyinde yapılmıştır. Hastalar:
- %70 eğitim,
- %15 doğrulama,
- %15 test
olarak ayrılmış; bir hastaya ait bütün görüntüler aynı bölmede tutulmuştur.
Bu karar görüntü tabanlı çalışmalarda önemli bir yöntemsel güçlü yöndür. Aynı ayağın farklı açılardan çekilmiş çok benzer görüntülerinin hem eğitim hem test kümesine girmesi durumunda model performansı yapay biçimde yükselebilirdi.
Kaynak içindeki hasta sayısı raporlama sorunu
Kaynak toplam 946 hasta bulunduğunu belirtirken dağılımı “428 Low Risk, 383 Medium Risk ve 135 Low Risk” şeklinde yazmaktadır. Üçüncü kategori bağlam ve toplam sayı açısından High Risk'i temsil ediyor olabilir; ancak kaynak metninde “Low Risk” yazdığı için bu Verianla makalesinde 135 değerini düzeltilmiş bir High Risk hasta sayısı olarak bilimsel veri şeklinde sunmuyoruz.
ResNet50 ve VGG16 nasıl uyarlandı?
ResNet50 ve VGG16, ImageNet ağırlıklarıyla önceden eğitilmiş iki CNN mimarisidir. Çalışmada her model include_top=false biçiminde yüklenmiş; yani ImageNet'e ait özgün sınıflandırıcı katmanlar kaldırılmış ve yalnız önceden öğrenilmiş evrişimsel özellik çıkarıcı omurga korunmuştur.
Omurganın üzerine çalışmaya özgü yeni bir sınıflandırıcı başlık eklenmiştir:
Global Average Pooling → Dense 512 → Dense 256 → Dense 128 → 3 sınıflı Softmax.
Dense katmanlarla birlikte batch normalization ve dropout kullanılmıştır.
İki aşamalı eğitim
Eğitim iki aşamada yapılmıştır:
- Head Training: Omurga dondurulmuş, yalnız yeni sınıflandırıcı başlık 8 epoch boyunca eğitilmiştir.
- Fine-Tuning: Omurganın üst %50'si çözülmüş ve daha düşük öğrenme oranıyla 15 epoch boyunca ince ayar yapılmıştır.
Bu yapı ImageNet'ten öğrenilmiş genel görüntü özelliklerini tamamen yok etmeden modelin diyabetik ayak görüntülerine uyarlanmasını amaçlamıştır.
Ağırlıklı Kayıp ve Aşırı Örnekleme Neden Kullanıldı?
Ağırlıklı kayıp ve High Risk aşırı örneklemesi, veri setindeki ciddi sınıf dengesizliğinin modelin çoğunluk sınıflarına yönelmesini azaltmak ve az sayıdaki High Risk örneklerinin eğitim sırasında daha fazla etkili olmasını sağlamak için kullanıldı.
Kayıp fonksiyonu
Çalışmada sparse categorical cross-entropy kullanılmış ve sınıf ağırlığıyla değiştirilmiştir:
\(\mathrm{Loss}_i = w_{y_i}(-\log p_{i,y_i})\)
Burada \(y_i\), i'nci örneğin gerçek eğitim etiketini; \(p_{i,y_i}\), modelin bu sınıfa atadığı olasılığı; \(w_{y_i}\) ise ilgili sınıfın ağırlığını temsil eder. Sınıf ağırlığı büyüdükçe o sınıftaki hatanın kayıp fonksiyonuna katkısı artar.
Kaynakta ampirik başlangıç ağırlıkları:
- Low Risk × 1,1,
- Medium Risk × 1,2,
- High Risk × 4,0
olarak belirlenmiş ve ardından normalize edilmiştir.
High Risk oversampling
High Risk örnekleri yalnız eğitim setinde 10 kat oversampling ile artırılmıştır. Oversampling'in doğrulama ve test setlerine uygulanmaması, aynı yapay çoğaltmanın test performansını şişirmesini önlemek açısından önemlidir.
Veri artırma
Kaynakta görüntü artırma işlemleri arasında yatay çevirme, rotasyon, zoom, kontrast, parlaklık ve küçük translasyonlar bulunmaktadır. Tablo 2'de konservatif augmentasyon için rotasyon yaklaşık ±4,6°, zoom aralığı [0,85–1,15]; High Risk için daha agresif augmentasyonda rotasyon yaklaşık ±8,6° ve güçlendirilmiş kontrast/parlaklık değişimleri raporlanmıştır.
Eğitim hiperparametreleri
| Parametre | Değer |
|---|---|
| Görüntü boyutu | 224 × 224 piksel |
| Sınıf sayısı | 3 |
| Veri bölümü | %70 eğitim / %15 doğrulama / %15 test |
| Batch size | 32 |
| Head training | 8 epoch |
| Fine-tuning | 15 epoch |
| Head öğrenme oranı | 5 × 10⁻⁴ |
| Fine-tuning öğrenme oranı | 5 × 10⁻⁵ |
| Omurganın çözülen kısmı | Üst %50 |
| Dropout | 0,6 / 0,4 / 0,3 |
| L2 regularization | λ = 0,001 |
| Early stopping | 5 epoch patience |
| Optimizer | Adam |
| High Risk oversampling | ×10 |
Test sonuçları
| Metrik | ResNet50 görüntü | ResNet50 hasta | VGG16 görüntü | VGG16 hasta |
|---|---|---|---|---|
| Accuracy | %75,05 | %72,54 | %75,48 | %75,35 |
| Macro F1 | %79,35 | %76,95 | %77,60 | %77,83 |
| Weighted F1 | %75,32 | %72,57 | %75,68 | %75,55 |
| Low Risk precision | %83,64 | %79,17 | %80,82 | %77,59 |
| Low Risk recall | %70,50 | %59,38 | %75,86 | %70,31 |
| Low Risk F1 | %76,51 | %67,86 | %78,26 | %73,77 |
| Medium Risk precision | %65,09 | %62,34 | %67,46 | %68,12 |
| Medium Risk recall | %80,75 | %82,76 | %75,40 | %81,03 |
| Medium Risk F1 | %72,08 | %71,11 | %71,21 | %74,02 |
| High Risk precision | %100 | %100 | %100 | %100 |
| High Risk recall | %80,95 | %85,00 | %71,43 | %75,00 |
| High Risk F1 | %89,47 | %91,89 | %83,33 | %85,71 |
ResNet50 Neden Streamlit Uygulamasına Seçildi?
ResNet50 genel doğrulukta her ölçümde VGG16'yı geçmemesine rağmen High Risk sınıfında daha yüksek recall ve F1 sağladığı için Streamlit uygulamasında kullanıldı; araştırmacılar klinik açıdan daha kritik yüksek riskli görüntülerin saptanmasını model seçiminde önceliklendirdi.
Bu ayrım önemlidir. Hasta düzeyi genel doğruluk VGG16 için %75,35 iken ResNet50 için %72,54'tür. Buna karşılık hasta düzeyi High Risk recall ResNet50'de %85,00, VGG16'da %75,00; High Risk F1 ise sırasıyla %91,89 ve %85,71'dir.
Dolayısıyla “ResNet50 en iyi modeldir” ifadesi bütün metriklerde üstünlük anlamına gelmemelidir. Kaynakta model seçim gerekçesi özellikle High Risk saptama performansıdır.
Precision, recall ve F1 sonuçları nasıl okunmalı?
Precision, modelin bir sınıf için yaptığı pozitif tahminlerin ne kadarının ilgili etikete gerçekten karşılık geldiğini; recall, ilgili sınıftaki örneklerin ne kadarının yakalandığını; F1 ise precision ve recall arasındaki dengeyi özetler.
High Risk sınıfında tüm modeller için %100 precision bildirilmesi test setinde High Risk olarak sınıflandırılan örneklerin GPT tarafından tanımlanmış referans High Risk sınıfıyla güçlü biçimde örtüştüğünü gösterir. Ancak referans etiketlerin kendisi GPT tarafından oluşturulduğundan bu değer doğrudan tıbbi uzman doğruluğu veya gerçek klinik prognoz doğruluğu değildir.
Streamlit prototipi ne yapıyor?
Prototip uygulama Python 3.13 ve Streamlit kullanılarak geliştirilmiştir. Kullanıcı diyabetik ayağa ait görüntüleri yüklediğinde sistem:
- her görüntü için risk etiketi,
- üç risk sınıfının güven skorları,
- hasta düzeyinde birleştirilmiş risk sınıfı,
- Grad-CAM ısı haritası
üretmektedir.
Kaynağın 12. sayfasındaki Şekil 5 uygulamanın ana ekranını, Şekil 6 ise bir hasta için risk çıktısını ve modelin dikkate aldığı görüntü bölgelerini gösteren Grad-CAM görselini sunmaktadır.
Bu Sistem Klinik Olarak Doğrulanmış Bir Tanı Aracı mı?
Hayır. Streamlit uygulaması kaynakta açıkça araştırma-geliştirme aşamasındaki bir prototip olarak tanımlanmış ve herhangi bir düzenleyici veya sertifikasyon kurumuna sunulmadığı belirtilmiştir; ayrıca CNN performansı uzunlamasına klinik sonlanımlara veya bağımsız uzman etiketli büyük bir dış doğrulama setine karşı gösterilmemiştir.
En önemli doğrulama sınırı
Çalışmanın CNN eğitiminde ve temel test değerlendirmesinde kullandığı etiketler GPT tarafından oluşturulmuştur. Tıbbi uzmanlar 87 hastalık ayrı bir alt grupta GPT etiketlerini değerlendirmek için kullanılmıştır; CNN modellerinin ana performans tablosu doğrudan bu uzman etiketleri üzerinde raporlanmamıştır.
Bu nedenle modelin test doğruluğu iki katmanlı yorumlanmalıdır:
- Model, GPT tarafından oluşturulan sınıfları ne kadar iyi yeniden öğreniyor?
- GPT'nin oluşturduğu sınıflar klinik uzman görüşü ve gerçek gelecekteki hasta sonuçlarıyla ne kadar uyumludur?
Çalışma ilk soruya ayrıntılı CNN metrikleriyle, ikinci sorunun yalnız bir bölümüne 87 hastalık GPT-uzman karşılaştırmasıyla cevap vermektedir. Gelecekte gerçek ülser gelişimi, enfeksiyon, iyileşme veya amputasyon gibi sonlanımlar üzerinden prospektif doğrulama kaynakta raporlanmamaktadır.
Grad-CAM klinik doğrulama yerine geçmez
Grad-CAM'in modelin ayağın klinik açıdan anlamlı bir bölgesine odaklandığını göstermesi, tahminin klinik olarak doğru olduğu anlamına gelmez. Yorumlanabilirlik, model kararının incelenmesini kolaylaştırır; ancak bağımsız klinik geçerlilik kanıtının yerine geçmez.
Çalışmanın güçlü yönleri
- Aynı ayağın birden fazla açıdan görüntüsü kullanılmıştır.
- Veri bölümü hasta düzeyinde yapılarak aynı hastanın görüntülerinin farklı splitlere sızması önlenmiştir.
- ResNet50 ve VGG16 aynı genel eğitim koşullarında karşılaştırılmıştır.
- Sınıf dengesizliği açık biçimde tanınmış ve yalnız eğitim setinde oversampling uygulanmıştır.
- Eğitim hiperparametreleri ayrıntılı biçimde raporlanmıştır.
- GPT etiketleri tamamen uzman etiketi gibi kabul edilmemiş; 87 hastada uzman karşılaştırması yapılmıştır.
- Model seçimi yalnız genel accuracy değil, klinik açıdan kritik görülen High Risk recall/F1 performansı dikkate alınarak yapılmıştır.
- Grad-CAM model kararının hangi görüntü bölgelerine dayandığını denetlemek için kullanılmıştır.
- Çalışma yöntemini gerçek bir prototip Streamlit arayüzüyle uçtan uca göstermiştir.
Çalışmanın temel sınırlılıkları
Referans etiket sorunu: CNN'lerin eğitim ve temel test etiketleri uzmanlardan değil GPT'den gelmektedir. Dolayısıyla model performansı klinik gold-standard performansı olarak okunamaz.
GPT-uzman uyuşmazlığı: 87 hastada etiketlerin %19,5'i uyuşmamıştır ve bunların sekizi ciddi sınıf çatışmasıdır.
Low/Medium sınıf belirsizliği: İnce görsel farklar hem etiketleme hem sınıflandırma için daha zordur.
Sınıf dengesizliği: Orijinal High Risk görüntü sayısı yalnız 77'dir; dış görüntülerle 154'e çıkarılmış ve eğitimde ×10 oversampling uygulanmıştır.
Harici görüntü domain farkı: Kaggle görüntüleri çözünürlük, aydınlatma, kamera ve demografik yapı bakımından klinik veri setinden farklı olabilir.
Uzunlamasına sonuç yoktur: Model tahmini ileride gerçekten ülser gelişip gelişmediğine karşı prospektif biçimde doğrulanmamıştır.
Prototip düzenleyici statüsü: Streamlit uygulaması R&D düzeyindedir ve herhangi bir düzenleyici/sertifikasyon kurumuna sunulmamıştır.
Görsel-veri sınırlılığı: Kaynak yöntemi yalnız ayak görüntülerini kullanmaktadır; nöropati testi, dolaşım ölçümü, sıcaklık, laboratuvar verisi veya hasta öyküsü model girdisi değildir.
Çalışmanın desteklediği sonuçlar
- GPT-4o-mini ile otomatik ayak görüntüsü etiketleme pipeline'ı kurulabilmiştir.
- GPT ve uzman etiketleri 87 hastalık alt grupta %80,5 oranında eşleşmiştir.
- ResNet50 ve VGG16, GPT-etiketli test kümesinde yaklaşık %72-75 aralığında genel hasta/görüntü doğrulukları göstermiştir.
- High Risk sınıfı Low ve Medium sınıflara göre daha güçlü F1 performansına sahiptir.
- ResNet50 High Risk recall ve F1 açısından VGG16'dan daha yüksek değerler vermiştir.
- Hasta bazlı veri bölme ve yalnız eğitim setinde oversampling uygulanmıştır.
- Grad-CAM ve Streamlit ile uçtan uca araştırma prototipi geliştirilmiştir.
Çalışmanın desteklemediği sonuçlar
- Sistemin gelecekte oluşacak diyabetik ayak ülserlerini %75 doğrulukla öngördüğü söylenemez.
- GPT'nin uzman hekimlerin yerini alabileceği sonucu çıkarılamaz.
- ResNet50'nin bütün performans metriklerinde VGG16'dan üstün olduğu söylenemez.
- %100 High Risk precision gerçek klinik ortamda sıfır yanlış pozitif anlamına gelmez.
- Modelin farklı hastanelerde, ülkelerde, kamera sistemlerinde veya hasta popülasyonlarında aynı performansı sağlayacağı gösterilmemiştir.
- Grad-CAM ısı haritası klinik tanı doğruluğunu veya nedenselliği kanıtlamaz.
- Streamlit prototipi regüle edilmiş bir tıbbi cihaz veya onaylanmış klinik tanı sistemi değildir.
- Görüntü analizinin fizik muayene, dolaşım veya nöropati değerlendirmesinin yerini alabileceği kanıtlanmamıştır.
Kaynak içi raporlama ve yorum notları
Kaynak toplam 946 hastayı “428 Low Risk, 383 Medium Risk ve 135 Low Risk” olarak raporlamaktadır. Üçüncü “Low Risk” ifadesi bağlam açısından olası bir yazım hatası görünümündedir; ancak kaynak düzeltilmediği için Verianla metni bunu doğrulanmış “135 High Risk” verisi olarak kullanmamaktadır.
Makalenin özeti ResNet50'nin genel olarak daha üstün sonuç verdiğini belirtmektedir. Buna karşılık Tablo 3'te VGG16'nın görüntü ve hasta düzeyi genel accuracy değerleri ResNet50'den daha yüksektir. ResNet50'nin belirgin üstünlüğü özellikle High Risk recall ve F1 değerlerindedir. Bu nedenle “ResNet50 üstün” sonucu metrikten bağımsız genel bir üstünlük olarak değil, yazarların High Risk tespitini önceliklendiren model seçimi bağlamında yorumlanmalıdır.
Kaynak ve Yöntem Notu
Özgün başlık: Monitoring Diabetic Foot Using Images and Generative AI
Yazarlar: Afonso Nobre; João Silva Sequeira.
Corresponding author: João Silva Sequeira.
Kurum: Institute for Systems and Robotics, Instituto Superior Técnico, 1049-001 Lisbon, Portugal.
Dergi: Diabetology.
Yayınevi: MDPI.
Yayın bilgisi: Diabetology 2026, 7(5), 95.
DOI: 10.3390/diabetology7050095
Gönderim: 2 Mart 2026.
Revizyon: 8 Mayıs 2026.
Kabul: 8 Mayıs 2026.
Yayın: 12 Mayıs 2026.
Kaynak türü: Klinik görüntü veri seti üzerinde üretken yapay zekâ destekli veri etiketleme, transfer öğrenme ve makine öğrenmesi model geliştirme/değerlendirme çalışması.
Modeller: GPT-4o-mini; ResNet50; VGG16; Grad-CAM.
Uygulama: Python 3.13 ile geliştirilmiş Streamlit prototipi.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Çalışma Portekiz Fundação para a Ciência e Tecnologia tarafından DFAA-2023.12465.PEX projesi kapsamında finanse edilmiştir.
Etik/kurumsal açıklama: Yazarlar diyabetik ayak görüntülerinin Portekiz Ulusal Diyabet Programı kapsamında, Unidade Local de Saúde de Loures-Odivelas'ta sağlık profesyonelleri tarafından rutin görevler çerçevesinde elde edildiğini; bu nedenle ayrı etik kurul onayı ve bireysel bilgilendirilmiş onam gerekmediğini bildirmektedir.
Anonimleştirme: Kaynak, görüntü verilerinin edinim sırasında anonimleştirildiğini belirtmektedir.
Veri erişilebilirliği: Veri setinin makul talep üzerine corresponding author aracılığıyla elde edilebileceği bildirilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını bildirmiştir; fon sağlayıcının çalışma tasarımı, veri toplama/analiz/yorumlama, metin yazımı veya yayın kararında rolü olmadığı belirtilmiştir.
Yazar katkıları: Kavramsallaştırma A.N. ve J.S.S.; yazılım, araştırma ve ilk metin hazırlığı A.N.; veri kürasyonu, gözden geçirme/düzenleme, süpervizyon, proje yönetimi ve finansman edinimi J.S.S. tarafından gerçekleştirilmiştir.
Temel yöntemsel sınır: Test performansı büyük ölçüde GPT-üretilmiş etiketlerin yeniden sınıflandırılması üzerinden ölçülmüştür. 87 hastalık uzman karşılaştırması GPT etiketlerinin tam bir klinik gold standard olmadığını göstermektedir. Uzunlamasına gerçek klinik sonuç doğrulaması ve geniş bağımsız dış doğrulama kaynakta raporlanmamıştır.
Uygulama statüsü: Streamlit uygulaması araştırma-geliştirme prototipidir ve kaynakta herhangi bir düzenleyici veya sertifikasyon kurumuna sunulmadığı açıkça belirtilmiştir.
Görsel kaynak notu: PDF'nin 5. sayfasındaki Şekil 1 yöntem pipeline'ını; Şekil 2 aynı ayağın dört görüntüleme açısını; 8. sayfadaki Şekil 3 Low/Medium/High Risk örneklerini; 9. sayfadaki Şekil 4 GPT ve uzman etiketlerini; 12. sayfadaki Şekil 5-6 Streamlit arayüzünü ve Grad-CAM çıktısını göstermektedir. Verianla için hasta görüntülerini birebir yeniden yayımlamak yerine süreç, model mimarisi ve performans ilişkilerinin özgün şemalarla yeniden çizilmesi uygundur.
Sağlık bilgisi sınırı: Bu içerik yayımlanmış araştırmanın bilimsel açıklamasıdır. Ayak fotoğrafına bakarak bireysel diyabetik ayak tanısı veya risk kararı vermek amacıyla kullanılmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir