

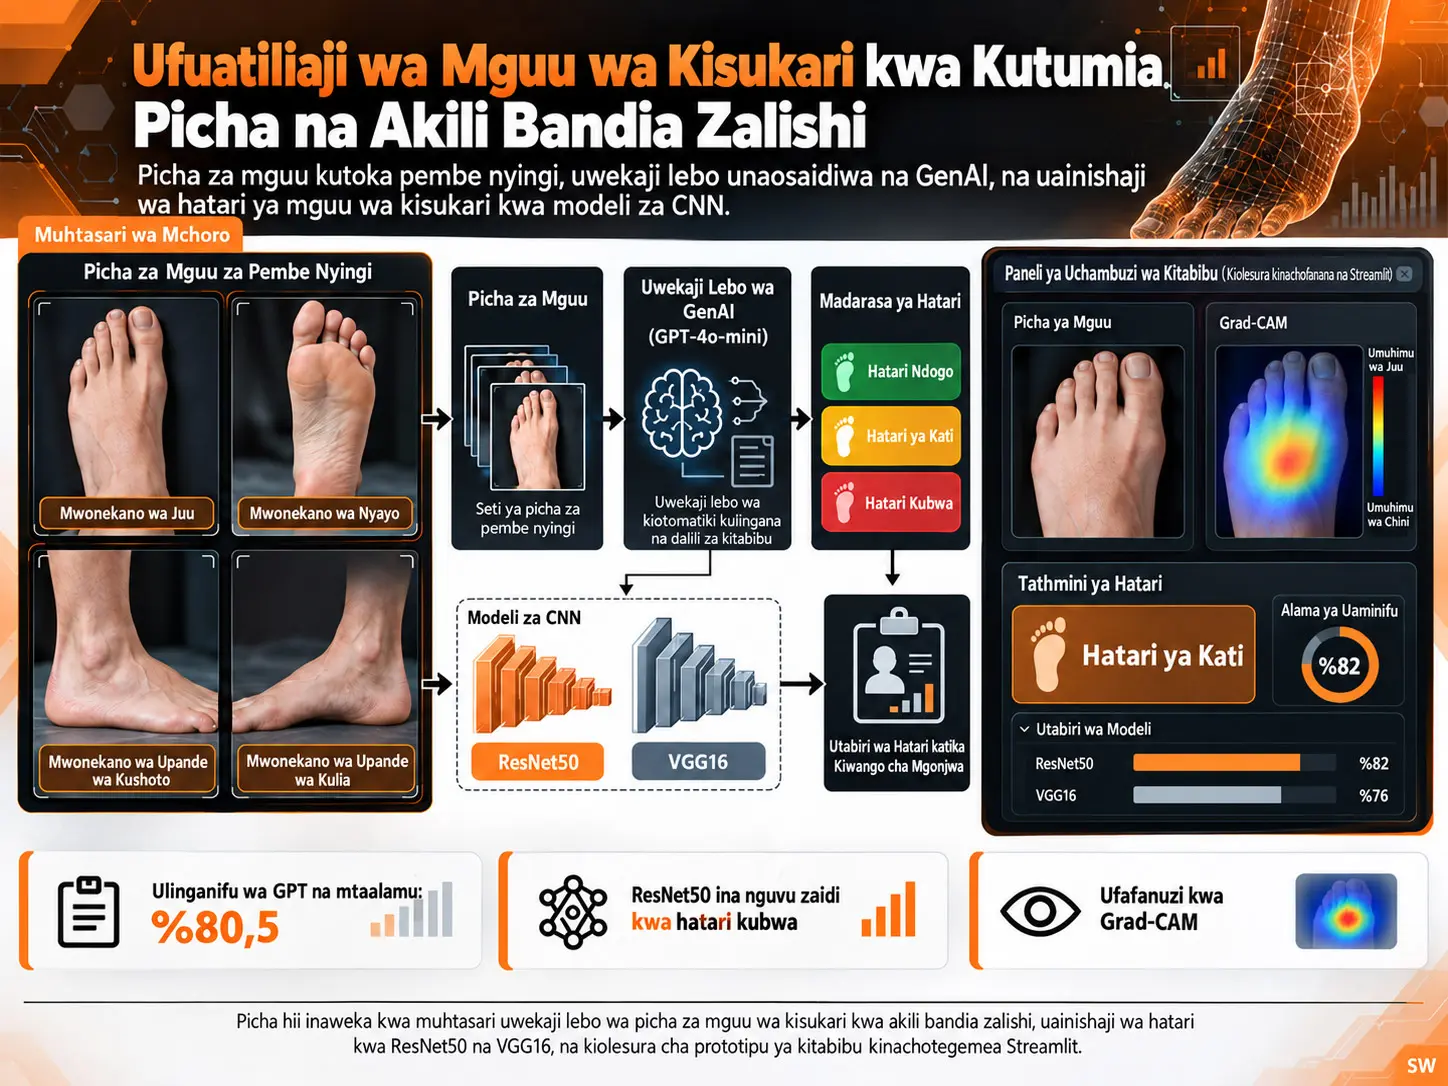
Mfumo wa tathmini ya hatari ya mguu wa kisukari katika utafiti huu ni mbinu ya ujifunzaji wa mashine inayoweka lebo kwenye picha za mguu kutoka pembe nyingi kwa kutumia akili bandia zalishi, kufanya fine-tuning ya mitandao ya neva ya konvolusheni iliyofunzwa awali (convolutional neural network, CNN) kwa lebo hizo, na kuunganisha utabiri wa kiwango cha picha katika kiwango cha mgonjwa. GPT-4o-mini iliipa kila picha lebo ya Low Risk, Medium Risk au High Risk; modeli za ResNet50 na VGG16 zilifunzwa na kujaribiwa kwa lebo hizi. Seti ya mwisho ya data ina picha 3255. Ingawa utendaji wa jumla wa modeli hizo mbili ulikuwa karibu, ResNet50 ilichaguliwa kwa matumizi katika prototipu ya Streamlit kwa sababu ilitoa recall na F1 za juu zaidi katika kutambua darasa la High Risk. Hata hivyo, utafiti haukuthibitisha kwa matokeo ya kliniki ya muda mrefu kama vidonda vingetokea kweli baadaye; lebo za mafunzo na majaribio zilitolewa hasa na GPT. Kwa hiyo, matokeo yanapaswa kutafsiriwa si kama uthibitisho wa moja kwa moja wa utabiri wa baadaye wa kliniki, bali kama uwezekano wa kiufundi wa pipeline ya uainishaji wa hatari inayotegemea CNN kwa kutumia uwekaji lebo unaosaidiwa na GenAI.
Katika kikundi kidogo cha wagonjwa 87 ambapo lebo zilizotolewa na GPT zililinganishwa na wataalamu wa tiba, kulikuwa na makubaliano ya %80,5; lebo zililingana kwa wagonjwa 70, huku kutolingana kukionekana kwa wagonjwa 17. Watafiti wanasema wazi kwamba GPT inaweza kukosea hasa katika tofauti ndogo za kuona kati ya Low na Medium Risk na kwamba lebo za akili bandia zalishi hazipaswi kuchukua nafasi ya uwekaji lebo wa mtaalamu.
Katika seti ya majaribio, usahihi wa kiwango cha picha kwa ResNet50 ulikuwa %75,05 na wa kiwango cha mgonjwa %72,54; kwa VGG16 ulikuwa %75,48 na %75,35 mtawalia. Kwa darasa la High Risk, recall ya ResNet50 ilikuwa %80,95 katika kiwango cha picha na %85,00 katika kiwango cha mgonjwa; kwa VGG16 ilikuwa %71,43 na %75,00. High Risk precision iliripotiwa kuwa %100 kwa modeli zote mbili. Matokeo haya yalipendekeza kuwa ResNet50 inaweza kuwa na faida hasa katika kutokosa visa vya hatari kubwa na ndiyo sababu ilichaguliwa kwa programu.
Ni tatizo gani linalojaribiwa kutatuliwa katika ufuatiliaji wa mguu wa kisukari kwa kutumia picha?
Tathmini ya mguu wa kisukari katika utendaji wa kawaida wa kliniki haitumii ukaguzi wa kuona pekee; tathmini nyingine za kliniki kama mguso, joto, hisia ya mtetemo, mzunguko wa damu na mapigo ya mishipa ya mguu pia hutumiwa. Hata hivyo, mwonekano wa mguu unaweza kutoa taarifa kuhusu alama nyingi za kliniki kama kidonda, mabadiliko ya rangi, ukavu, uvimbe, sugu na ulemavu.
Lengo la utafiti wa chanzo lilikuwa kutumia taarifa hizi za kuona kutengeneza mfumo wa kiotomatiki unaotathmini hatari ya mguu wa kisukari kuendelea kuwa hali mbaya zaidi kwa madarasa matatu: Low Risk, Medium Risk na High Risk. Dalili zilizoripotiwa na mgonjwa au data ya historia ya matibabu hazikuingizwa; modeli ilifanya kazi tu na vipengele vya kuona vilivyotolewa kwenye picha.
Sababu mojawapo ya watafiti ni kwamba upatikanaji wa tathmini ya mtaalamu unaweza kuwa mdogo hasa katika maeneo ya mbali au yenye rasilimali chache za afya. Sababu nyingine ni kwamba tathmini ya kuona inaweza kutofautiana kulingana na uzoefu wa mtaalamu. Uchambuzi wa picha wa kiotomatiki ulitafitiwa kama tabaka la usaidizi linaloweza kurudiwa, si kama mbadala wa tathmini ya binadamu.
Akili Bandia Zalishi Ilifanya Nini Katika Utafiti Huu?
Akili bandia zalishi haikutumiwa kama CNN classifier ya mwisho, bali kama mwekaji lebo wa seti ya mafunzo: GPT-4o-mini ilitathmini alama za kliniki zinazoonekana kwenye picha za miguu, ikaipa kila picha lebo ya Low Risk, Medium Risk au High Risk, na ResNet50 pamoja na VGG16 zikafunzwa kwa kutumia lebo hizi zilizotolewa na GPT.
Mlolongo wa uwekaji lebo
Kielelezo 1 katika ukurasa wa 5 wa chanzo kinaonyesha mbinu kwa mlolongo ufuatao:
- Kukusanya picha za kliniki za mguu wa kisukari.
- Kuhamisha picha kupitia OpenAI API kwenda kwenye pipeline ya uwekaji lebo wa akili bandia zalishi.
- Kutengeneza lebo ya Low Risk, Medium Risk au High Risk kwa kila picha.
- Kupanga upya picha kulingana na madarasa ya hatari.
- Kufunza modeli za ResNet50 na VGG16.
- Uthibitishaji na majaribio.
- Kutengeneza utabiri wa hatari kwa kila picha.
- Kuunganisha picha za mgonjwa mmoja chini ya lebo moja ya mgonjwa.
- Kuonyesha matokeo katika programu ya Streamlit.
Kwa nini pembe nne tofauti zilitumiwa badala ya picha moja?
Katika seti ya data ya kliniki, picha za mguu uleule kutoka nyayo, juu, upande wa kulia na upande wa kushoto zilitumiwa. Sababu ni kwamba alama ya hatari kama kidonda, mabadiliko ya rangi au uvimbe inaweza kuonekana kutoka pembe fulani pekee, ilhali tishu kutoka pembe nyingine zinaweza kuonekana kawaida.
Kielelezo 2 katika ukurasa wa 5 wa chanzo kinaonyesha mitazamo hii minne kwa picha halisi za kliniki. Mbinu ya pembe nyingi inalenga kupunguza upotevu wa taarifa unaoweza kutokea katika uamuzi unaotegemea picha moja kwa sababu ya maeneo yasiyoonekana.
Prompt ya GPT iliangalia alama gani za kuona?
Prompt iliyopangwa katika Kiambatisho A inaonyesha kuwa uwekaji lebo wa hatari haukuachwa kama tafsiri huru ya picha. Prompt iliomba tathmini ya ubora na upeo wa picha pamoja na sifa zifuatazo zinazoonekana:
- sugu na hyperkeratosis,
- ukavu, nyufa na ngozi kupukutika,
- erithema na wekundu wa eneo,
- maceration,
- vidonda vya kabla ya kidonda na mabadiliko ya rangi,
- ulemavu wa kimuundo wa mguu,
- uvimbe,
- mabadiliko ya ngozi yanayoweza kuashiria mwonekano wa mishipa,
- kidonda, maambukizi au nekrosisi,
- alama zinazoonekana za kukatwa kiungo hapo awali.
Katika mwongozo wa hatari wa prompt, ngozi yenye afya na uadilifu mzuri ilitathminiwa kama Low Risk; ukavu mdogo, mabadiliko ya rangi au vidonda vya juu juu kama Medium Risk; na kidonda wazi, maambukizi, nekrosisi, uvimbe mkubwa, ulemavu mkali au dalili za kukatwa kiungo kama High Risk.
Lebo hizi ni madarasa ya kiutendaji ya picha yaliyotayarishwa kwa ajili ya utafiti. Haipaswi kudhaniwa kwamba mwelekeo halisi wa kliniki wa mgonjwa unaamuliwa na madarasa haya ya picha pekee.
Lebo ya Hatari ya Kiwango cha Mgonjwa Iliundwaje?
Lebo ya hatari ya kiwango cha mgonjwa iliundwa kwa kuunganisha utabiri wa picha nyingi za mgonjwa yuleyule kwa kanuni ya worst-case iliyowekwa mapema: ikiwa angalau picha moja ilikuwa High Risk, mgonjwa aliwekwa High Risk; vinginevyo ikiwa picha za Medium zilikuwa nyingi kuliko au sawa na Low, aliwekwa Medium Risk; katika hali nyingine aliwekwa Low Risk.
Kanuni ya uunganishaji
- High Risk: Ikiwa angalau picha moja ya mgonjwa ilikuwa High Risk, mgonjwa mzima alichukuliwa kuwa High Risk.
- Medium Risk: Ikiwa hakuna picha ya High Risk na idadi ya picha za Medium Risk ilikuwa kubwa kuliko au sawa na Low Risk, mgonjwa aliwekewa lebo ya Medium Risk.
- Low Risk: Ikiwa hakuna picha ya High Risk na picha za Low Risk zilikuwa nyingi kuliko za Medium Risk, mgonjwa aliwekewa lebo ya Low Risk.
Muundo huu unalenga kuzuia alama ya High Risk inayoonekana kutoka pembe moja kupunguzwa na mitazamo mingine ya kawaida. Hata hivyo, kanuni hiyo pia inamaanisha kwamba uainishaji mmoja wa High Risk ulio makosa unaweza kuinua lebo ya mgonjwa mzima hadi High Risk. Kwa hiyo, wasifu wa makosa katika kiwango cha picha ni muhimu kwa utaratibu wa uamuzi wa kiwango cha mgonjwa.
Je, Lebo za GPT Zilichukua Nafasi ya Lebo za Wataalamu?
Hapana. Ingawa lebo za GPT zilikubaliana kwa %80,5 katika kikundi cha wagonjwa 87 chenye lebo za wataalamu, kulikuwa na tofauti kwa wagonjwa 17 na watafiti walisisitiza wazi kwamba lebo za akili bandia zalishi hazipaswi kuchukua nafasi ya uwekaji lebo wa wataalamu wa binadamu.
Matokeo ya ulinganisho wa wataalamu
Kati ya wagonjwa 87 walioweza kulinganishwa na wataalamu, lebo ya GPT ililingana na lebo ya mtaalamu kwa wagonjwa 70. Kati ya tofauti 17:
- 9 zilikuwa tofauti za kiwango cha kati kati ya madarasa jirani kama Low→Medium au Medium→High,
- 8 zilikuwa tofauti kubwa zilizoweza kutokea hata kati ya Low na High
na ziliainishwa hivyo.
Kielelezo 4 katika ukurasa wa 9 wa PDF pia kinaonyesha kwamba GPT ilitoa uainishaji zaidi wa Medium na High Risk ikilinganishwa na wataalamu. Mgawanyo wa wataalamu ulikuwa zaidi upande wa Low Risk. Hii inaonyesha kuwa lebo za GPT zinaweza kutofautiana na rejea ya wataalamu kwa mfumo, si kwa idadi tu bali pia kwa mgawanyo wa madarasa.
Kwa nini Low Risk na Medium Risk huchanganywa zaidi?
Chanzo kinasisitiza kuwa alama kwenye picha za Low Risk na Medium Risk zinaweza kufanana. Mwonekano kama ukavu mdogo unaweza kutathminiwa kama Low katika hali moja na Medium katika hali nyingine. Kwa sababu mipaka ya madarasa si mikali, kutenganisha madarasa haya mawili ni vigumu zaidi kuliko High Risk katika uwekaji lebo wa GPT na uainishaji wa CNN.
Katika High Risk, uwepo wa alama zilizo wazi zaidi kama kidonda wazi, nekrosisi, maambukizi yaliyo wazi au ulemavu mkubwa unaweza kuchangia utendaji bora wa modeli katika darasa hili.
Grad-CAM ilitumika kwa madhumuni gani?
Gradient-weighted Class Activation Mapping (Grad-CAM) ni mbinu ya ufasiri inayoonyesha kwa ramani ya joto ni maeneo gani ya picha yalichangia zaidi katika utabiri wa CNN wakati wa kuainisha picha.
Katika prototipu ya Streamlit, ramani ya joto ya Grad-CAM inaonyeshwa karibu na picha ya awali ya mguu. Hivyo mtumiaji anaweza kukagua kama modeli imelenga eneo lenye maana ya kliniki kama kidonda au ngozi kavu, au sehemu isiyohusika ya picha.
Grad-CAM kuangazia eneo hakuthibitishi kuwa eneo hilo ndilo sababu ya ugonjwa. Grad-CAM husaidia tu kutafsiri maeneo ya picha yaliyochangia katika uamuzi wa modeli.
Mbinu na Matokeo ya Utafiti
Seti ya Data Iliandaliwaje?
Seti ya data ya utafiti iliundwa kutoka picha za miguu ya kisukari za pembe nyingi zilizokusanywa kwa mradi wa DFAA katika kitengo cha afya cha eneo katika mfumo wa afya wa Ureno; picha za umma kutoka Kaggle ziliongezwa ili kupunguza kutokuwiana kwa madarasa, na seti ya mwisho ilikuwa na picha 1807 za Low Risk, 1294 za Medium Risk na 154 za High Risk, jumla ya 3255.
Chanzo cha picha za kliniki
Picha za kliniki zilipatikana katika hospitali ya ULS katika mfumo wa afya wa Ureno kwa kutumia mfumo wa kamera uliotengenezwa kwa mradi wa DFAA — Diabetic Foot Automated Assessment. Data ya awali ilipangwa kwa folda za wagonjwa na ilikuwa na picha za mguu uleule kutoka pembe tofauti.
Kuongezwa kwa picha za Kaggle
Katika seti ya awali, darasa la High Risk liliwakilishwa kwa kiwango kidogo sana. Chanzo kiliongeza picha za umma kutoka Kaggle ili kuongeza mifano mikali ya hatari kubwa.
| Darasa la hatari | Bila Kaggle | Baada ya kuongeza Kaggle |
|---|---|---|
| Low Risk | 1807 | 1807 |
| Medium Risk | 1294 | 1294 |
| High Risk | 77 | 154 |
| Jumla | 3178 | 3255 |
Chanzo kinasema wazi kwamba picha za nje zinaweza kutofautiana na picha za kliniki kwa azimio, mwanga, kamera iliyotumiwa na demografia ya wagonjwa. Hali hii inaweza kuongeza tofauti ya domain kwenye mgawanyo wa picha ambao modeli inajifunza.
Mgawanyo wa mafunzo/uthibitishaji/majaribio kwa msingi wa mgonjwa
Kwa sababu kusambaza picha za mgonjwa mmoja katika seti za mafunzo na majaribio kunaweza kusababisha data leakage, mgawanyo ulifanywa katika kiwango cha kitambulisho cha mgonjwa. Wagonjwa waligawanywa kama:
- %70 mafunzo,
- %15 uthibitishaji,
- %15 majaribio
na picha zote za mgonjwa mmoja ziliwekwa katika sehemu moja.
Uamuzi huu ni nguvu muhimu ya kimetodolojia katika tafiti za picha. Picha zinazofanana sana za mguu uleule kutoka pembe tofauti zingeweza kuingia katika mafunzo na majaribio na kuonyesha utendaji wa modeli kuwa juu kwa njia bandia.
Tatizo la kuripoti idadi ya wagonjwa katika chanzo
Chanzo kinasema kulikuwa na jumla ya wagonjwa 946, lakini kinaandika mgawanyo kama “428 Low Risk, 383 Medium Risk na 135 Low Risk”. Kategoria ya tatu inaweza kuwakilisha High Risk kwa kuzingatia muktadha na jumla, lakini kwa sababu chanzo kimeandika “Low Risk”, makala hii ya Verianla haitoi 135 kama idadi iliyosahihishwa ya wagonjwa wa High Risk.
ResNet50 na VGG16 zilibadilishwaje?
ResNet50 na VGG16 ni usanifu mbili za CNN zilizofunzwa awali kwa uzani wa ImageNet. Katika utafiti, kila modeli ilipakiwa kwa include_top=false; yaani tabaka za awali za uainishaji za ImageNet ziliondolewa na backbone ya konvolusheni iliyofunzwa awali pekee ikahifadhiwa.
Juu ya backbone iliongezwa kichwa kipya cha uainishaji maalumu kwa utafiti:
Global Average Pooling → Dense 512 → Dense 256 → Dense 128 → Softmax ya madarasa 3.
Batch normalization na dropout zilitumiwa pamoja na tabaka za Dense.
Mafunzo ya hatua mbili
Mafunzo yalifanywa katika hatua mbili:
- Head Training: Backbone iligandishwa na kichwa kipya cha uainishaji pekee kikafunzwa kwa 8 epoch.
- Fine-Tuning: %50 ya sehemu ya juu ya backbone ilifunguliwa na fine-tuning kufanywa kwa learning rate ya chini kwa 15 epoch.
Muundo huu ulilenga kuzoesha modeli kwa picha za mguu wa kisukari bila kupoteza kabisa vipengele vya jumla vilivyojifunzwa kutoka ImageNet.
Kwa Nini Weighted Loss na Oversampling Zilitumiwa?
Weighted loss na oversampling ya High Risk zilitumiwa kupunguza mwelekeo wa modeli kuelekea madarasa mengi kutokana na kutokuwiana kwa madarasa na kufanya mifano michache ya High Risk iwe na athari kubwa zaidi wakati wa mafunzo.
Loss function
Utafiti ulitumia sparse categorical cross-entropy na kuibadilisha kwa uzani wa darasa:
\(\mathrm{Loss}_i = w_{y_i}(-\log p_{i,y_i})\)
Hapa \(y_i\) ni lebo halisi ya mafunzo ya mfano wa i; \(p_{i,y_i}\) ni uwezekano ambao modeli imeipa darasa hilo; na \(w_{y_i}\) ni uzani wa darasa husika. Kadiri uzani wa darasa unavyoongezeka, mchango wa kosa la darasa hilo kwenye loss huongezeka.
Uzani wa awali wa kiempiria ulikuwa:
- Low Risk × 1,1,
- Medium Risk × 1,2,
- High Risk × 4,0
na kisha ukarekebishwa kwa normalization.
High Risk oversampling
Mifano ya High Risk iliongezwa kwa oversampling mara 10 katika seti ya mafunzo pekee. Kutotumia oversampling katika uthibitishaji na majaribio ni muhimu ili kuzuia kuongeza utendaji wa test kwa njia bandia.
Data augmentation
Chanzo kinataja kugeuza kwa mlalo, rotation, zoom, contrast, brightness na translations ndogo. Katika Jedwali 2, kwa augmentasiya ya kihafidhina rotation ilikuwa takriban ±4,6°, zoom [0,85–1,15]; kwa High Risk augmentasiya kali zaidi ilitumia rotation takriban ±8,6° na mabadiliko makubwa zaidi ya contrast/brightness.
Hyperparameters za mafunzo
| Kigezo | Thamani |
|---|---|
| Ukubwa wa picha | 224 × 224 pikseli |
| Idadi ya madarasa | 3 |
| Mgawanyo wa data | %70 mafunzo / %15 uthibitishaji / %15 majaribio |
| Batch size | 32 |
| Head training | 8 epoch |
| Fine-tuning | 15 epoch |
| Head learning rate | 5 × 10⁻⁴ |
| Fine-tuning learning rate | 5 × 10⁻⁵ |
| Sehemu ya backbone iliyofunguliwa | %50 ya juu |
| Dropout | 0,6 / 0,4 / 0,3 |
| L2 regularization | λ = 0,001 |
| Early stopping | 5 epoch patience |
| Optimizer | Adam |
| High Risk oversampling | ×10 |
Matokeo ya test
| Kipimo | ResNet50 picha | ResNet50 mgonjwa | VGG16 picha | VGG16 mgonjwa |
|---|---|---|---|---|
| Accuracy | %75,05 | %72,54 | %75,48 | %75,35 |
| Macro F1 | %79,35 | %76,95 | %77,60 | %77,83 |
| Weighted F1 | %75,32 | %72,57 | %75,68 | %75,55 |
| Low Risk precision | %83,64 | %79,17 | %80,82 | %77,59 |
| Low Risk recall | %70,50 | %59,38 | %75,86 | %70,31 |
| Low Risk F1 | %76,51 | %67,86 | %78,26 | %73,77 |
| Medium Risk precision | %65,09 | %62,34 | %67,46 | %68,12 |
| Medium Risk recall | %80,75 | %82,76 | %75,40 | %81,03 |
| Medium Risk F1 | %72,08 | %71,11 | %71,21 | %74,02 |
| High Risk precision | %100 | %100 | %100 | %100 |
| High Risk recall | %80,95 | %85,00 | %71,43 | %75,00 |
| High Risk F1 | %89,47 | %91,89 | %83,33 | %85,71 |
Kwa Nini ResNet50 Ilichaguliwa kwa Programu ya Streamlit?
Ingawa ResNet50 haikuzidi VGG16 katika kila kipimo cha usahihi wa jumla, ilitumiwa katika Streamlit kwa sababu ilikuwa na recall na F1 za juu zaidi katika High Risk; watafiti walipa kipaumbele kutambua picha za hatari kubwa zenye umuhimu zaidi wa kliniki.
Tofauti hii ni muhimu. Usahihi wa jumla wa kiwango cha mgonjwa ulikuwa %75,35 kwa VGG16 na %72,54 kwa ResNet50. Lakini High Risk recall ya kiwango cha mgonjwa ilikuwa %85,00 kwa ResNet50 na %75,00 kwa VGG16; High Risk F1 ilikuwa %91,89 na %85,71 mtawalia.
Kwa hiyo, kusema “ResNet50 ndiyo modeli bora” hakupaswi kumaanisha kuwa ilikuwa bora katika vipimo vyote. Sababu ya uchaguzi wa modeli katika chanzo ni hasa utendaji wa kutambua High Risk.
Matokeo ya precision, recall na F1 yasomweje?
Precision inaonyesha ni sehemu gani ya utabiri chanya wa modeli kwa darasa fulani inayolingana kweli na lebo hiyo; recall inaonyesha ni sehemu gani ya mifano ya darasa hilo iliyopatikana; na F1 inafupisha uwiano kati ya precision na recall.
%100 precision kwa High Risk katika modeli zote inaonyesha kwamba mifano iliyotabiriwa kuwa High Risk katika seti ya majaribio ililingana sana na darasa rejea la High Risk lililowekwa na GPT. Lakini kwa kuwa lebo rejea zenyewe zilitolewa na GPT, thamani hii si usahihi wa moja kwa moja wa mtaalamu wa tiba wala usahihi wa mwelekeo halisi wa kliniki.
Prototipu ya Streamlit hufanya nini?
Programu ya prototipu ilitengenezwa kwa Python 3.13 na Streamlit. Mtumiaji anapopakia picha za mguu wa kisukari, mfumo:
- lebo ya hatari kwa kila picha,
- alama za kujiamini za madarasa matatu ya hatari,
- darasa la hatari lililounganishwa katika kiwango cha mgonjwa,
- ramani ya joto ya Grad-CAM
hutoa matokeo haya.
Kielelezo 5 katika ukurasa wa 12 wa chanzo kinaonyesha skrini kuu ya programu, na Kielelezo 6 kinaonyesha matokeo ya hatari kwa mgonjwa na Grad-CAM inayoonyesha maeneo ya picha ambayo modeli ilizingatia.
Je, Mfumo Huu ni Zana ya Utambuzi Iliyothibitishwa Kliniki?
Hapana. Programu ya Streamlit imeelezwa wazi katika chanzo kama prototipu ya hatua ya utafiti na maendeleo na haijawasilishwa kwa mamlaka yoyote ya udhibiti au uthibitishaji; pia utendaji wa CNN haujaonyeshwa dhidi ya matokeo ya kliniki ya muda mrefu au seti kubwa huru ya nje yenye lebo za wataalamu.
Kikomo muhimu zaidi cha uthibitishaji
Lebo zilizotumiwa katika mafunzo ya CNN na tathmini kuu ya test zilitolewa na GPT. Wataalamu wa tiba walitumiwa katika kikundi tofauti cha wagonjwa 87 kutathmini lebo za GPT; jedwali kuu la utendaji wa CNN halikuripotiwa moja kwa moja juu ya lebo hizo za wataalamu.
Kwa hiyo, usahihi wa test wa modeli unapaswa kutafsiriwa kwa tabaka mbili:
- Modeli inajifunza tena kwa kiwango gani madarasa yaliyotolewa na GPT?
- Madarasa yaliyotolewa na GPT yanaendana kwa kiwango gani na maoni ya wataalamu wa kliniki na matokeo halisi ya baadaye ya wagonjwa?
Utafiti unajibu swali la kwanza kwa vipimo vya kina vya CNN, na sehemu tu ya swali la pili kwa ulinganisho wa GPT na wataalamu katika wagonjwa 87. Uthibitishaji wa mbele kwa matokeo halisi kama kuibuka kwa kidonda, maambukizi, kupona au kukatwa kiungo haujaripotiwa katika chanzo.
Grad-CAM si mbadala wa uthibitishaji wa kliniki
Grad-CAM kuonyesha kuwa modeli imelenga eneo lenye maana ya kliniki la mguu hakumaanishi utabiri ni sahihi kliniki. Ufasiri hurahisisha ukaguzi wa uamuzi wa modeli, lakini hauchukui nafasi ya ushahidi huru wa uhalali wa kliniki.
Nguvu za utafiti
- Picha za mguu uleule kutoka pembe nyingi zilitumiwa.
- Mgawanyo wa data ulifanywa katika kiwango cha mgonjwa ili kuzuia picha za mgonjwa mmoja kuingia katika split tofauti.
- ResNet50 na VGG16 zililinganishwa katika hali sawa za jumla za mafunzo.
- Kutokuwiana kwa madarasa kulitambuliwa wazi na oversampling ilitumika katika seti ya mafunzo pekee.
- Hyperparameters za mafunzo ziliripotiwa kwa kina.
- Lebo za GPT hazikuchukuliwa kama lebo kamili za wataalamu; ulinganisho wa wataalamu ulifanywa kwa wagonjwa 87.
- Uchaguzi wa modeli haukutegemea accuracy ya jumla pekee, bali pia High Risk recall/F1 yenye umuhimu wa kliniki.
- Grad-CAM ilitumika kukagua maeneo ya picha yaliyotegemewa na modeli.
- Mbinu ilionyeshwa mwanzo hadi mwisho kwa kiolesura halisi cha prototipu ya Streamlit.
Vikwazo vikuu vya utafiti
Tatizo la lebo rejea: Lebo za mafunzo na test kuu za CNN zilitoka kwa GPT, si wataalamu. Hivyo utendaji hauwezi kusomwa kama clinical gold-standard.
Kutolingana kwa GPT na wataalamu: Kwa wagonjwa 87, %19,5 ya lebo hazikulingana na nane zilikuwa migongano mikubwa ya darasa.
Kutokuwa wazi kwa Low/Medium: Tofauti ndogo za kuona ni ngumu zaidi katika uwekaji lebo na uainishaji.
Kutokuwiana kwa madarasa: Idadi ya awali ya picha za High Risk ilikuwa 77 tu; iliongezwa hadi 154 kwa picha za nje na ×10 oversampling ikatumika katika mafunzo.
Tofauti ya domain ya picha za nje: Picha za Kaggle zinaweza kutofautiana na seti ya kliniki katika azimio, mwanga, kamera na demografia.
Hakuna matokeo ya muda mrefu: Utabiri wa modeli haujathibitishwa kwa matarajio dhidi ya kama kidonda kinatokea kweli baadaye.
Hali ya udhibiti ya prototipu: Streamlit iko katika kiwango cha R&D na haijawasilishwa kwa mamlaka yoyote ya udhibiti/uthibitishaji.
Kikomo cha data ya kuona: Mbinu ya chanzo hutumia picha za miguu pekee; vipimo vya neuropathy, mzunguko wa damu, joto, data za maabara au historia ya mgonjwa si pembejeo za modeli.
Hitimisho zinazoungwa mkono na utafiti
- Pipeline ya kiotomatiki ya uwekaji lebo wa picha za miguu kwa GPT-4o-mini iliweza kujengwa.
- Lebo za GPT na wataalamu zililingana kwa %80,5 katika kikundi cha wagonjwa 87.
- ResNet50 na VGG16 zilionyesha usahihi wa jumla wa mgonjwa/picha wa takriban %72-75 katika test yenye lebo za GPT.
- High Risk ilikuwa na F1 yenye nguvu zaidi kuliko Low na Medium.
- ResNet50 ilitoa High Risk recall na F1 za juu kuliko VGG16.
- Mgawanyo wa data kwa mgonjwa na oversampling katika mafunzo pekee ulitumika.
- Prototipu ya utafiti ya mwanzo hadi mwisho ilitengenezwa kwa Grad-CAM na Streamlit.
Hitimisho ambazo utafiti hauungi mkono
- Haiwezi kusemwa kuwa mfumo unatabiri vidonda vya mguu wa kisukari vya baadaye kwa usahihi wa %75.
- Haiwezi kuhitimishwa kuwa GPT inaweza kuchukua nafasi ya madaktari wataalamu.
- Haiwezi kusemwa kuwa ResNet50 ni bora kuliko VGG16 katika vipimo vyote.
- %100 High Risk precision haimaanishi hakuna false positive katika mazingira halisi ya kliniki.
- Haijaonyeshwa kuwa modeli itatoa utendaji uleule katika hospitali, nchi, kamera au idadi tofauti za wagonjwa.
- Ramani ya joto ya Grad-CAM haithibitishi usahihi wa utambuzi wala causality.
- Prototipu ya Streamlit si kifaa cha tiba kilichodhibitiwa wala mfumo wa utambuzi uliothibitishwa.
- Haijathibitishwa kuwa uchambuzi wa picha unaweza kuchukua nafasi ya uchunguzi wa mwili, mzunguko wa damu au tathmini ya neuropathy.
Maelezo ya kuripoti na kutafsiri ndani ya chanzo
Chanzo kinaripoti wagonjwa 946 kama “428 Low Risk, 383 Medium Risk na 135 Low Risk”. “Low Risk” ya tatu inaonekana kama kosa linalowezekana la uandishi kwa muktadha, lakini kwa kuwa chanzo hakijasahihishwa, maandishi ya Verianla hayatumii hili kama data iliyothibitishwa ya “135 High Risk”.
Muhtasari wa makala unasema ResNet50 ilitoa matokeo bora kwa ujumla. Hata hivyo, katika Jedwali 3, accuracy ya jumla ya kiwango cha picha na mgonjwa ya VGG16 ni juu kuliko ResNet50. Ubora wa wazi wa ResNet50 uko hasa katika High Risk recall na F1. Kwa hiyo, hitimisho kwamba “ResNet50 ni bora” linapaswa kutafsiriwa katika muktadha wa uchaguzi wa modeli unaotanguliza utambuzi wa High Risk, si kama ubora wa jumla usiotegemea kipimo.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Monitoring Diabetic Foot Using Images and Generative AI
Waandishi: Afonso Nobre; João Silva Sequeira.
Corresponding author: João Silva Sequeira.
Taasisi: Institute for Systems and Robotics, Instituto Superior Técnico, 1049-001 Lisbon, Portugal.
Jarida: Diabetology.
Mchapishaji: MDPI.
Taarifa ya uchapishaji: Diabetology 2026, 7(5), 95.
DOI: 10.3390/diabetology7050095
Iliwasilishwa: 2 Machi 2026.
Marekebisho: 8 Mei 2026.
Imekubaliwa: 8 Mei 2026.
Imechapishwa: 12 Mei 2026.
Aina ya chanzo: Utafiti wa uwekaji lebo wa data unaosaidiwa na akili bandia zalishi, transfer learning na ukuzaji/tathmini ya modeli ya ujifunzaji wa mashine katika seti ya picha za kliniki.
Modeli: GPT-4o-mini; ResNet50; VGG16; Grad-CAM.
Programu: Prototipu ya Streamlit iliyotengenezwa kwa Python 3.13.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti ulifadhiliwa na Fundação para a Ciência e Tecnologia ya Ureno chini ya mradi DFAA-2023.12465.PEX.
Maelezo ya kimaadili/kitaasisi: Waandishi wanasema picha za mguu wa kisukari zilipatikana chini ya Mpango wa Kitaifa wa Kisukari wa Ureno katika Unidade Local de Saúde de Loures-Odivelas na wataalamu wa afya ndani ya majukumu yao ya kawaida; kwa hiyo idhini tofauti ya kamati ya maadili na ridhaa binafsi iliyoarifiwa haikuhitajika.
Kuficha utambulisho: Chanzo kinasema data za picha zilifanywa zisijulikane wakati wa ukusanyaji.
Upatikanaji wa data: Seti ya data inaweza kupatikana kupitia corresponding author kwa ombi la msingi.
Mgongano wa maslahi: Waandishi waliripoti kutokuwa na mgongano wa maslahi; mfadhili hakuwa na jukumu katika muundo, ukusanyaji/uchambuzi/tafsiri ya data, uandishi au uamuzi wa kuchapisha.
Michango ya waandishi: Uundaji wa dhana A.N. na J.S.S.; programu, utafiti na rasimu ya kwanza A.N.; usimamizi wa data, mapitio/uhariri, usimamizi, uendeshaji wa mradi na upatikanaji wa ufadhili J.S.S.
Kikomo kikuu cha kimetodolojia: Utendaji wa test ulipimwa kwa kiasi kikubwa kwa kuainisha upya lebo zilizotolewa na GPT. Ulinganisho wa wagonjwa 87 unaonyesha kuwa lebo za GPT si clinical gold standard kamili. Uthibitishaji wa matokeo halisi ya kliniki ya muda mrefu na uthibitishaji mkubwa huru wa nje haujaripotiwa.
Hali ya programu: Programu ya Streamlit ni prototipu ya R&D na chanzo kinasema wazi kuwa haijawasilishwa kwa mamlaka yoyote ya udhibiti au uthibitishaji.
Maelezo ya chanzo cha kuona: Kielelezo 1 katika ukurasa wa 5 kinaonyesha pipeline ya mbinu; Kielelezo 2 pembe nne za mguu uleule; Kielelezo 3 katika ukurasa wa 8 mifano ya Low/Medium/High Risk; Kielelezo 4 katika ukurasa wa 9 lebo za GPT na wataalamu; na Vielelezo 5-6 katika ukurasa wa 12 kiolesura cha Streamlit na matokeo ya Grad-CAM. Kwa Verianla, badala ya kuchapisha tena picha za wagonjwa moja kwa moja, mchakato, usanifu wa modeli na mahusiano ya utendaji yanafaa kuchorwa upya kwa michoro asilia.
Kikomo cha taarifa za afya: Maudhui haya ni maelezo ya kisayansi ya utafiti uliochapishwa. Hayapaswi kutumiwa kutoa utambuzi binafsi wa mguu wa kisukari au uamuzi wa hatari kwa kuangalia picha ya mguu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *