

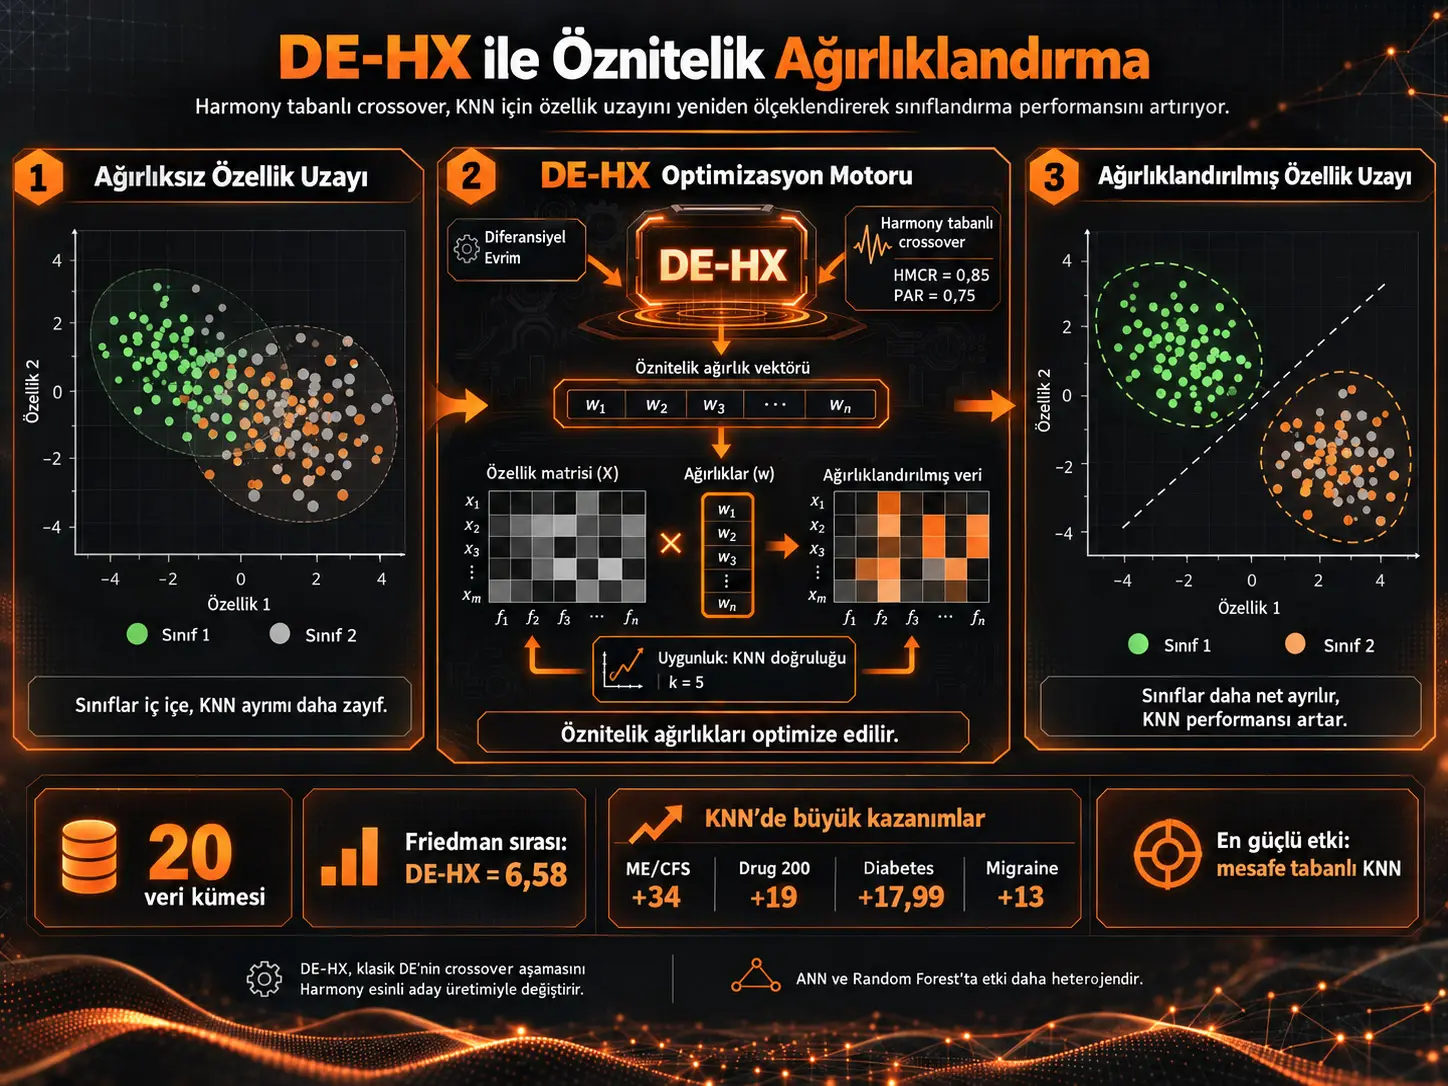
Öznitelik ağırlıklandırma, bir makine öğrenmesi modelinde bütün özelliklerin aynı derecede önemli olduğu varsayımını bırakıp her özelliğe farklı önem katsayısı vermeyi amaçlayan bir veri dönüştürme yaklaşımıdır. Bu çalışma, özellikle mesafe hesaplarına dayanan k-en yakın komşu (KNN) algoritması için öznitelik ağırlıklarının Diferansiyel Evrim (Differential Evolution, DE) ile optimize edilmesini ve klasik crossover operatörünün Harmony Search ilkelerinden esinlenen yeni bir mekanizmayla değiştirilmesini incelemektedir.
Önerilen DE-HX yönteminde her aday çözüm bir öznitelik ağırlık vektörüdür. Bu ağırlıklarla veri kümesi yeniden ölçeklendirilir ve KNN’nin 5-fold cross-validation doğruluğu uygunluk fonksiyonu olarak kullanılır. Klasik DE’de mutant ve hedef vektörün binomial crossover ile birleştirilmesi yerine DE-HX, mevcut popülasyonu bellek olarak kullanarak her boyut için Harmony Memory Considering Rate (HMCR) ve Pitch Adjusting Rate (PAR) tabanlı yeni aday değerler üretir.
Yöntem Kaggle ve UCI kaynaklı 20 heterojen veri kümesinde değerlendirilmiştir. Sonuçlar, DE-HX’in birçok veri kümesinde klasik DE, standart KNN, distance-weighted KNN ve ReliefF+KNN’den daha yüksek Accuracy ve Macro-F1 sağladığını göstermektedir. Özellikle ME/CFS vs. Depression, Diabetes Multiclass, Drug 200, Cryotherapy ve Migraine Classification gibi veri kümelerinde belirgin kazanımlar raporlanmıştır.
Bununla birlikte yöntem evrensel bir iyileştirme mekanizması değildir. DE-HX ağırlıkları ANN ve Random Forest’a aktarıldığında sonuçlar veri kümesine bağlı olarak artabilmekte, değişmeden kalabilmekte veya azalabilmektedir. Çalışmanın genel bulgusu, optimize edilmiş öznitelik ağırlıklarının en doğal ve tutarlı yararı doğrudan mesafe geometrisine bağlı KNN gibi modellerde sağladığıdır.
KNN neden öznitelik ağırlıklandırmadan etkilenir?
KNN, yeni bir örneği sınıflandırırken veri kümesindeki diğer örneklerle olan uzaklığını hesaplar ve en yakın \(k\) komşunun çoğunluk sınıfını yeni örneğe atar.
Standart Öklid uzaklığında bütün özniteliklerin katkısı aynı matematiksel ölçekte değerlendirilir. Ancak gerçek veri kümelerinde bazı öznitelikler sınıfları güçlü biçimde ayırırken bazıları sınıflandırma açısından daha az bilgi taşıyabilir.
Bu nedenle çalışma, her özniteliğin değerini ayrı bir ağırlıkla çarpmayı önermektedir:
\[ a_i^{(w)} = w_i a_i \]
Burada \(a_i\) özgün öznitelik değeri, \(w_i\) ilgili özniteliğin ağırlığı ve \(a_i^{(w)}\) ise ağırlıklandırılmış değerdir.
Ağırlık büyüdüğünde ilgili özellik KNN uzaklık hesabında daha belirleyici hale gelir. Küçük ağırlık ise o boyutun mesafeye katkısını azaltır.
DE-HX Klasik Diferansiyel Evrimden Nasıl Ayrılıyor?
DE-HX, klasik Diferansiyel Evrim algoritmasının popülasyon, değerlendirme ve seçim yapısını korur; ancak standart binomial crossover aşamasını kaldırarak onun yerine Harmony Search ilkelerinden esinlenen boyut-bazlı aday üretim mekanizması kullanır.
Klasik Diferansiyel Evrim
DE, sürekli optimizasyon problemleri için kullanılan popülasyon tabanlı bir meta-sezgisel yöntemdir. Çalışmada her birey:
\[ W=[w_1,w_2,\ldots,w_n] \]
biçiminde bir öznitelik ağırlık vektörünü temsil eder.
Mutant vektör klasik olarak:
\[ v_i^{g}=x_{r1}^{g}+F(x_{r2}^{g}-x_{r3}^{g}) \]
eşitliğiyle üretilir.
Burada \(F\), mutasyon ölçekleme faktörüdür; \(r_1\), \(r_2\) ve \(r_3\) popülasyondan seçilen farklı bireylerdir.
Daha sonra mutant ve hedef vektör binomial crossover ile birleştirilir:
\[ u_{i,j}^{g}= \begin{cases} v_{i,j}^{g}, & rand_j \leq CR \text{ veya } j=j_{rand}\\ x_{i,j}^{g}, & \text{aksi halde} \end{cases} \]
Yeni deneme vektörü daha yüksek uygunluk sağlarsa mevcut bireyin yerine geçer.
Harmony tabanlı aday üretimi
DE-HX’in temel farkı crossover aşamasındadır. Sistem ayrı bir Harmony Memory oluşturmaz. Mevcut DE popülasyonu aynı zamanda aday bileşenlerinin seçildiği bellek görevini görür.
Her \(j\) boyutu için:
- olasılık \(HMCR\) ise değer mevcut popülasyondaki başka bir çözümden alınır,
- aksi halde arama sınırları \([L_b,U_b]\) içinden rastgele üretilir,
- olasılık \(PAR\) ise seçilen değere yerel ayarlama uygulanır,
- değer geçerli sınırlar içinde tutulur.
Çalışmada:
HMCR = 0,85
ve
PAR = 0,75
olarak kullanılmıştır.
Bu yapı, mevcut iyi çözümlerden yararlanma ile yeni bölgeleri araştırma arasındaki exploration–exploitation dengesini klasik crossover’dan farklı biçimde düzenlemektedir.
Uygunluk fonksiyonu
Her aday ağırlık vektörü önce veri kümesine uygulanır. Ardından ağırlıklandırılmış veri KNN ile sınıflandırılır.
Çalışmada uygunluk fonksiyonu:
\[ fitness(W)=Accuracy(KNN(D\odot W)) \]
mantığına dayanır.
Burada \(D\) veri kümesini, \(W\) ağırlık vektörünü ve \(\odot\) öznitelik-bazlı ağırlıklandırmayı temsil eder.
KNN için \(k=5\) ve Öklid uzaklığı kullanılmıştır.
Veriler Nasıl Hazırlandı?
Çalışmada Kaggle ve UCI Machine Learning Repository kaynaklarından alınan 20 farklı veri kümesi kullanılmıştır.
Veri kümeleri sağlık, davranış, sürücü belgesi, içecek içeriği, oyun davranışı, kişilik, su kalitesi ve şarap sınıflandırması gibi farklı problem alanlarını kapsamaktadır.
Kategorik değişkenler iki şekilde dönüştürülmüştür:
- doğal sıralama bulunan kategoriler için ordinal encoding,
- sıralı ilişki bulunmayan kategoriler için one-hot encoding.
Sayısal değerler 1–10 aralığına normalize edilmiştir:
\[ Norm(x_i) = \frac{x_i-x_{min}} {x_{max}-x_{min}} \times 9 + 1 \]
Yazarlar bu ölçeği özellikle çok küçük floating-point değerlerle uğraşmamak ve hata ayıklamayı kolaylaştırmak amacıyla kullandıklarını belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
Deney protokolü
Bütün deneyler 5-fold cross-validation ile gerçekleştirilmiştir.
Temel parametreler:
| Parametre | Değer |
|---|---|
| KNN komşu sayısı | 5 |
| Mesafe | Öklid |
| DE popülasyonu | 12 |
| DE ölçek faktörü \(F\) | 1 |
| DE-HX HMCR | 0,85 |
| DE-HX PAR | 0,75 |
| Ağırlık aralığı | [0,1) |
| Random seed | 42 |
DE ve DE-HX aynı başlangıç düzenini, aynı uygunluk fonksiyonunu ve stagnation tabanlı durdurma kriterini kullanmıştır.
DE-HX ve standart DE karşılaştırması
| Veri kümesi | DE-HX Accuracy | DE Accuracy |
|---|---|---|
| Cirrhosis Patient Survival | 61,28 | 55,76 |
| Cryotherapy | 97,78 | 92,22 |
| Diabetes Multiclass | 98,87 | 96,23 |
| Drug 200 | 99,00 | 97,50 |
| ME/CFS vs. Depression | 99,60 | 90,80 |
| Migraine Classification | 91,50 | 86,25 |
| Spotify Recommendations | 96,41 | 93,85 |
DE-HX her veri kümesinde üstün değildir. Örneğin Body Performance ve Customer Behavior gibi bazı veri kümelerinde standart DE daha yüksek Accuracy üretmiştir. Bu nedenle yöntem bütün veri kümelerinde garantili üstünlük sağlayan bir optimizasyon yöntemi olarak yorumlanmamalıdır.
WeightedKNN ve ReliefF+KNN karşılaştırması
DE-HX ayrıca distance-weighted KNN ve ReliefF tabanlı KNN ile karşılaştırılmıştır.
Örneğin:
- Diabetes Multiclass: DE-HX %98,87, WeightedKNN %85,98, ReliefF+KNN %92,42
- Heart Failure Clinical: DE-HX %90,30, WeightedKNN %84,75, ReliefF+KNN %83,44
- Migraine Classification: DE-HX %91,50, WeightedKNN %79,50, ReliefF+KNN %81,00
- Spotify Recommendations: DE-HX %96,41, WeightedKNN %90,26, ReliefF+KNN %91,79
Bu sonuçlar, incelenen deney düzeninde DE-HX’in birçok veri kümesinde güçlü bir öznitelik ağırlıklandırma yaklaşımı olduğunu göstermektedir.
Standart KNN’ye göre kazanımlar
DE-HX ile ağırlıklandırılmış KNN’nin standart KNN’ye göre Accuracy artışı bazı veri kümelerinde dikkat çekicidir:
| Veri kümesi | KNN | DE-HX | Artış |
|---|---|---|---|
| ME/CFS vs. Depression | 65,60 | 99,60 | 34,00 puan |
| Drug 200 | 80,00 | 99,00 | 19,00 puan |
| Diabetes Multiclass | 80,88 | 98,87 | 17,99 puan |
| Migraine Classification | 78,50 | 91,50 | 13,00 puan |
| Body Performance | 55,69 | 68,44 | 12,75 puan |
Macro-F1 kazanımları
Macro-F1 açısından da bazı veri kümelerinde önemli farklar raporlanmıştır:
- ME/CFS vs. Depression: +39,16 puan
- Migraine Classification: +37,21 puan
- Drug 200: +27,13 puan
- Diabetes Multiclass: +18,21 puan
- Body Performance: +12,70 puan
Macro-F1 özellikle sınıf dağılımının dengesiz olabileceği veri kümelerinde yalnız Accuracy’ye göre daha dengeli performans değerlendirmesi sunar.
İstatistiksel Testler Ne Gösteriyor?
Friedman testi yedi yöntemin genel sıralamalarında anlamlı fark bulunduğunu göstermiştir:
\[ \chi^2(6)=61{,}870,\quad p<0{,}001 \]
Ortalama sıralamalar:
| Yöntem | Ortalama sıra |
|---|---|
| DE-HX | 6,58 |
| DE | 5,25 |
| Random Forest | 4,58 |
| ANN | 3,50 |
| ReliefF+KNN | 3,20 |
| WeightedKNN | 2,53 |
| KNN | 2,38 |
Holm post hoc düzeltmesinden sonra DE-HX; RF, ANN, ReliefF+KNN, WeightedKNN ve KNN’den anlamlı biçimde farklı bulunmuştur. Ancak DE-HX ile standart DE arasındaki düzeltilmiş değer:
p = 0,0515
olmuştur. Bu değer geleneksel 0,05 sınırının hemen üzerindedir.
Buna karşılık doğrudan Wilcoxon signed-rank testinde:
DE-HX vs. DE: p = 0,006, r = 0,652
sonucu raporlanmıştır.
Dolayısıyla iki istatistiksel analiz farklı düzeltme bağlamlarında okunmalıdır; kaynak sonuçları “DE-HX bütün testlerde tartışmasız anlamlı üstünlük göstermiştir” şeklinde genelleştirmek doğru değildir.
DE-HX Ağırlıkları ANN ve Random Forest’ı da İyileştiriyor mu?
Her zaman değil. Öğrenilen DE-HX ağırlıkları ANN ve Random Forest’a ek model-özel yeniden optimizasyon yapılmadan uygulanmıştır. ANN bazı veri kümelerinde belirgin iyileşme gösterirken bazılarında gerilemiştir; Random Forest’ta ise değişimler çoğunlukla küçük ve veri kümesine bağımlıdır.
ANN üzerindeki etki
Örneğin ANN Accuracy:
- Cryotherapy’de %85,56’dan %93,26’ya,
- Diabetes Multiclass’ta %80,30’dan %86,31’e,
- ME/CFS vs. Depression’da %92,50’den %98,70’e
yükselmiştir.
Buna karşılık Migraine Classification’da %89,50’den %82,46’ya düşmüştür.
Bu davranış, harici öznitelik ağırlıklarının sinir ağının kendi iç temsil öğrenme dinamikleriyle her zaman uyumlu olmayabileceğini göstermektedir.
Random Forest üzerindeki etki
Random Forest sonuçları daha sınırlı değişmektedir. Bunun nedeni kaynakta RF’nin zaten random feature selection ve bagging gibi kendi iç öznitelik seçim mekanizmalarına sahip olmasıyla ilişkilendirilmiştir.
Bu nedenle önceden uygulanmış harici ağırlıklandırma RF’ye KNN’deki kadar belirgin ek yarar sağlamamaktadır.
Yöntemin en doğal kullanım alanı
Kaynağın genel değerlendirmesine göre DE-HX en güçlü etkisini özellik uzayının geometrisine doğrudan bağımlı olan mesafe tabanlı modellerde göstermektedir.
KNN bu açıdan doğal bir hedeftir çünkü her öznitelik ağırlığı mesafe hesabını doğrudan değiştirir.
Çalışmanın Sınırlılıkları Nelerdir?
- Birden fazla bağımsız optimizasyon koşusu yapılmamıştır.
- Nested cross-validation kullanılmamıştır.
- Karşılaştırmalar sabit runtime veya eşit hesaplama bütçesi üzerinden yapılmamıştır.
- Convergence plot sunulmamıştır.
- HMCR, PAR ve diğer hiperparametreler için ayrıntılı sensitivity analysis yapılmamıştır.
- Öğrenilen ağırlıkların koşular arası stabilitesi analiz edilmemiştir.
- ANN ve RF aktarım deneyleri model-özel yeniden tuning olmadan gerçekleştirilmiştir.
- Sonuçlar veri kümesine bağlıdır ve DE-HX her durumda en yüksek performansı üretmemektedir.
Yazarlar gelecek çalışmalarda runtime ve convergence analizi, yerel arama entegrasyonu, hibrit ve ensemble yapılar ve sıfıra yakın ağırlıkların feature selection amacıyla kullanılması gibi yönleri araştırmayı önermektedir.
Kaynak ve Yöntem Notu
Bu Verianla içeriği, Andrea Ortega-Guzmán, Salvador Ibarra-Martínez, José Antonio Castan-Rocha, J. David Teran-Villanueva, Mayra Guadalupe Treviño-Berrones ve Aurelio Alejandro Santigo-Pineda tarafından hazırlanan Assessing Performance and Crossover Operators on Differential Evolution for Attribute Weighting başlıklı akademik çalışmaya dayanarak bağımsız biçimde hazırlanmıştır.
Makale AI dergisinde 2026 yılında, Cilt 7, Makale 163 olarak yayımlanmıştır. DOI: 10.3390/ai7050163. Yayın tarihi 7 Mayıs 2026’dır. Çalışma MDPI tarafından Creative Commons Attribution (CC BY) lisansıyla açık erişim olarak yayımlanmıştır.
Çalışmanın temel yöntemi, her veri kümesi özniteliğine sürekli bir ağırlık atayan Diferansiyel Evrim tabanlı bir optimizasyon sürecidir. Önerilen DE-HX, klasik DE’deki binomial crossover aşamasını Harmony Search esinli aday üretim mekanizmasıyla değiştirmektedir. Mevcut DE popülasyonu ayrı bir Harmony Memory olmadan kaynak bellek olarak kullanılmaktadır.
KNN’nin 5-fold cross-validation doğruluğu optimizasyonun uygunluk fonksiyonudur. Deneylerde KNN için k=5 ve Öklid uzaklığı; DE-HX için HMCR=0,85 ve PAR=0,75; klasik DE için F=1 kullanılmıştır.
Yöntem 20 veri kümesinde değerlendirilmiş; Accuracy ve Macro-F1 üzerinden standart DE, KNN, WeightedKNN, ReliefF+KNN, ANN ve Random Forest ile karşılaştırılmıştır. Friedman, Holm ve Wilcoxon testleri genel ve ikili istatistiksel karşılaştırmalar için kullanılmıştır.
DE-HX’in standart DE’ye karşı doğrudan Wilcoxon testinde anlamlı üstünlük gösterdiği raporlanmış olsa da Holm çoklu karşılaştırma düzeltmesinden sonra DE-HX–DE farkının p=0,0515 olduğu belirtilmiştir. Bu nedenle istatistiksel sonuçlar test bağlamı korunarak yorumlanmalıdır.
Yazarlar dış finansman alınmadığını bildirmiştir. Deney kodu ile özgün ve ön işlenmiş veri kümelerinin erişilebilir olduğu belirtilmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir