

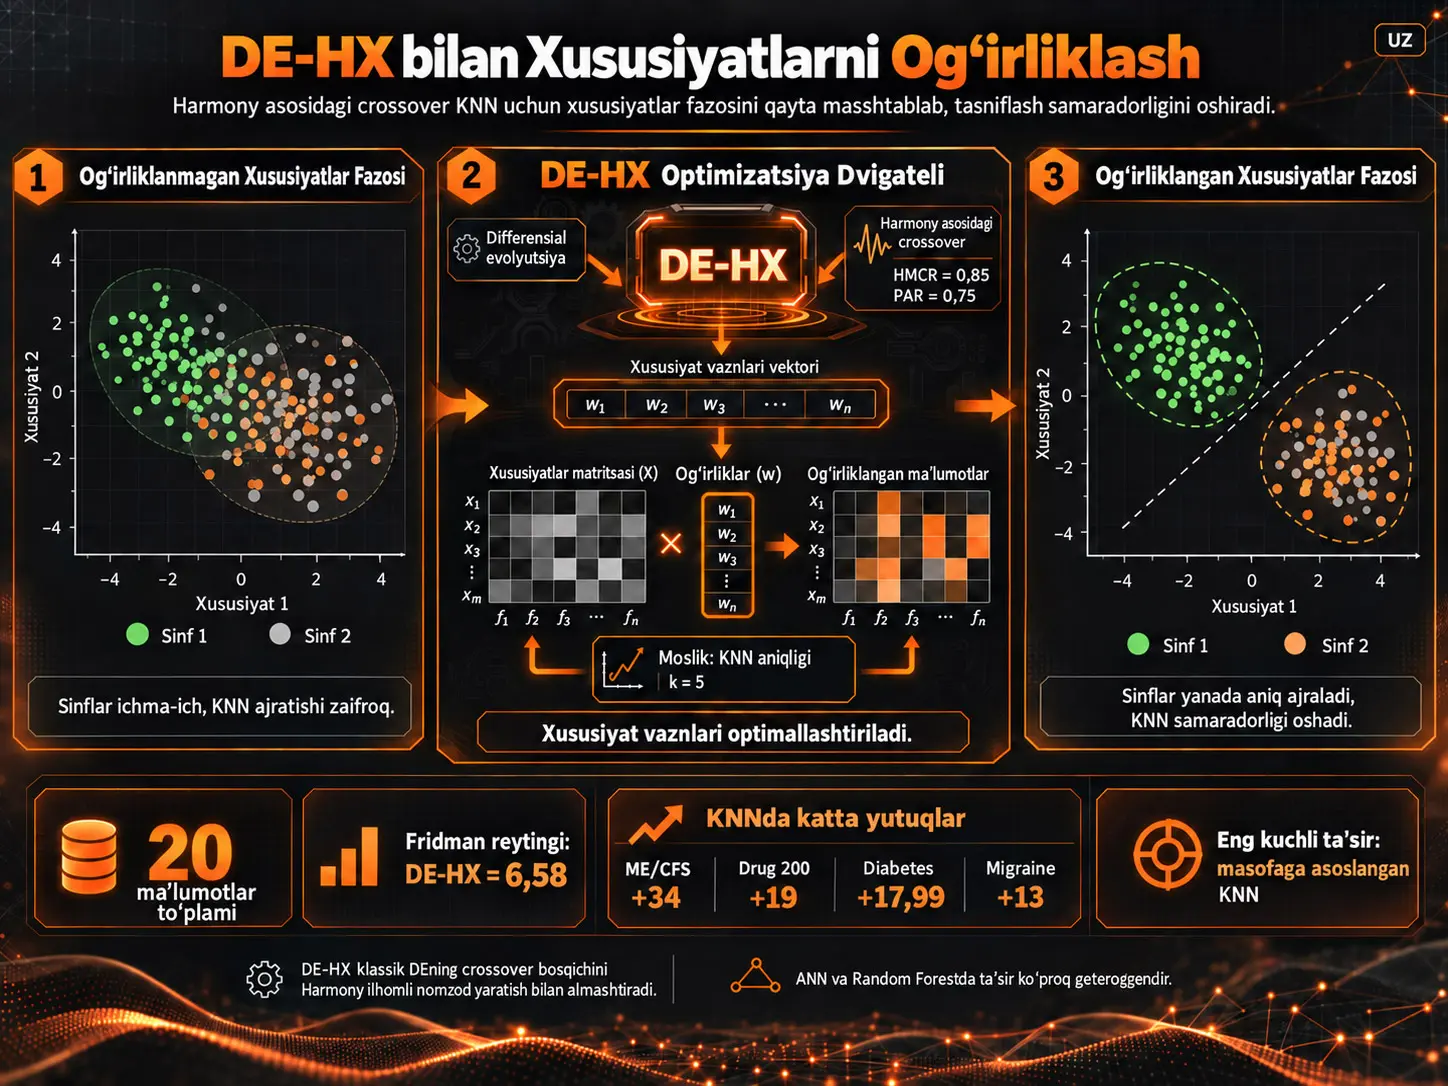
Xususiyatlarni vaznlash, mashinaviy o‘rganish modelida barcha xususiyatlar bir xil darajada muhim degan farazdan voz kechib, har bir xususiyatga turli ahamiyat koeffitsiyenti berishni maqsad qiladigan ma’lumotlarni o‘zgartirish yondashuvidir. Ushbu tadqiqot, ayniqsa, masofa hisoblariga asoslangan k-eng yaqin qo‘shni (KNN) algoritmi uchun xususiyat vaznlarini Differensial Evolyutsiya (Differential Evolution, DE) orqali optimallashtirishni va klassik crossover operatorini Harmony Search tamoyillaridan ilhomlangan yangi mexanizm bilan almashtirishni o‘rganadi.
Taklif etilgan DE-HX usulida har bir nomzod yechim xususiyatlar vazni vektoridir. Ushbu vaznlar bilan ma’lumotlar to‘plami qayta masshtablanadi va KNNning 5-fold cross-validation aniqligi moslik funksiyasi sifatida ishlatiladi. Klassik DEda mutant va maqsad vektorining binomial crossover orqali birlashtirilishi o‘rniga DE-HX mavjud populyatsiyani xotira sifatida ishlatib, har bir o‘lcham uchun Harmony Memory Considering Rate (HMCR) va Pitch Adjusting Rate (PAR) asosida yangi nomzod qiymatlar hosil qiladi.
Usul Kaggle va UCI manbalaridan olingan 20 ta geterogen ma’lumotlar to‘plamida baholangan. Natijalar DE-HX ko‘plab ma’lumotlar to‘plamida klassik DE, standart KNN, distance-weighted KNN va ReliefF+KNNga nisbatan yuqoriroq Accuracy va Macro-F1 ta’minlaganini ko‘rsatadi. Ayniqsa ME/CFS vs. Depression, Diabetes Multiclass, Drug 200, Cryotherapy va Migraine Classification kabi ma’lumotlar to‘plamlarida sezilarli yutuqlar qayd etilgan.
Shu bilan birga, usul universal yaxshilash mexanizmi emas. DE-HX vaznlari ANN va Random Forestga o‘tkazilganda natijalar ma’lumotlar to‘plamiga qarab oshishi, o‘zgarmasligi yoki kamayishi mumkin. Tadqiqotning umumiy xulosasi shuki, optimallashtirilgan xususiyat vaznlarining eng tabiiy va izchil foydasi masofa geometriyasiga bevosita bog‘liq KNN kabi modellarda namoyon bo‘ladi.
Nima uchun KNN xususiyatlarni vaznlashdan ta’sirlanadi?
KNN yangi namunani tasniflashda uning ma’lumotlar to‘plamidagi boshqa namunalar bilan masofasini hisoblaydi va eng yaqin \(k\) qo‘shnining ko‘pchilik sinfini yangi namunaga tayinlaydi.
Standart Evklid masofasida barcha xususiyatlarning hissasi bir xil matematik miqyosda baholanadi. Biroq real ma’lumotlar to‘plamlarida ayrim xususiyatlar sinflarni kuchli ajratsa, boshqalari tasniflash nuqtayi nazaridan kamroq axborot tashishi mumkin.
Shu sababli tadqiqot har bir xususiyat qiymatini alohida vazn bilan ko‘paytirishni taklif qiladi:
\[ a_i^{(w)} = w_i a_i \]
Bu yerda \(a_i\) dastlabki xususiyat qiymati, \(w_i\) tegishli xususiyatning vazni, \(a_i^{(w)}\) esa vaznlangan qiymatdir.
Vazn oshganda tegishli xususiyat KNN masofa hisobida ko‘proq belgilovchi bo‘ladi. Kichik vazn esa shu o‘lchamning masofaga hissasini kamaytiradi.
DE-HX Klassik Differensial Evolyutsiyadan Qanday Farq Qiladi?
DE-HX klassik Differensial Evolyutsiya algoritmining populyatsiya, baholash va tanlash tuzilmasini saqlab qoladi; ammo standart binomial crossover bosqichini olib tashlab, uning o‘rniga Harmony Search tamoyillaridan ilhomlangan o‘lchamga asoslangan nomzod yaratish mexanizmini qo‘llaydi.
Klassik Differensial Evolyutsiya
DE uzluksiz optimallashtirish muammolari uchun qo‘llanadigan populyatsiyaga asoslangan metaevristik usuldir. Tadqiqotda har bir individ:
\[ W=[w_1,w_2,\ldots,w_n] \]
ko‘rinishidagi xususiyatlar vazni vektorini ifodalaydi.
Mutant vektor klassik tarzda:
\[ v_i^{g}=x_{r1}^{g}+F(x_{r2}^{g}-x_{r3}^{g}) \]
tenglama orqali hosil qilinadi.
Bu yerda \(F\) mutatsiya masshtablash koeffitsiyenti; \(r_1\), \(r_2\) va \(r_3\) populyatsiyadan tanlangan turli individlardir.
Keyin mutant va maqsad vektori binomial crossover orqali birlashtiriladi:
\[ u_{i,j}^{g}= \begin{cases} v_{i,j}^{g}, & rand_j \leq CR \text{ veya } j=j_{rand}\\ x_{i,j}^{g}, & \text{aksi halde} \end{cases} \]
Yangi sinov vektori yuqoriroq moslik bersa, mavjud individ o‘rnini egallaydi.
Harmony asosidagi nomzod yaratish
DE-HXning asosiy farqi crossover bosqichidadir. Tizim alohida Harmony Memory yaratmaydi. Mavjud DE populyatsiyasi ayni paytda nomzod komponentlari tanlanadigan xotira vazifasini bajaradi.
Har bir \(j\) o‘lcham uchun:
- ehtimollik \(HMCR\) bo‘lsa, qiymat mavjud populyatsiyadagi boshqa yechimdan olinadi,
- aks holda qidiruv chegaralari \([L_b,U_b]\) ichidan tasodifiy hosil qilinadi,
- ehtimollik \(PAR\) bo‘lsa, tanlangan qiymatga lokal sozlash qo‘llanadi,
- qiymat amal qiluvchi chegaralar ichida saqlanadi.
Tadqiqotda:
HMCR = 0,85
va
PAR = 0,75
sifatida qo‘llangan.
Ushbu tuzilma mavjud yaxshi yechimlardan foydalanish bilan yangi hududlarni izlash o‘rtasidagi exploration–exploitation muvozanatini klassik crossoverdan boshqacha tartibga soladi.
Moslik funksiyasi
Har bir nomzod vazn vektori avval ma’lumotlar to‘plamiga qo‘llanadi. So‘ng vaznlangan ma’lumot KNN bilan tasniflanadi.
Tadqiqotda moslik funksiyasi:
\[ fitness(W)=Accuracy(KNN(D\odot W)) \]
mantiqiga asoslanadi.
Bu yerda \(D\) ma’lumotlar to‘plamini, \(W\) vazn vektorini va \(\odot\) xususiyat bo‘yicha vaznlashni ifodalaydi.
KNN uchun \(k=5\) va Evklid masofasi ishlatilgan.
Ma’lumotlar Qanday Tayyorlandi?
Tadqiqotda Kaggle va UCI Machine Learning Repository manbalaridan olingan 20 ta turli ma’lumotlar to‘plami ishlatilgan.
Ma’lumotlar to‘plamlari sog‘liq, xulq-atvor, haydovchilik guvohnomasi, ichimlik tarkibi, o‘yin xulqi, shaxsiyat, suv sifati va vino tasnifi kabi turli muammo sohalarini qamrab oladi.
Kategorik o‘zgaruvchilar ikki usulda o‘zgartirilgan:
- tabiiy tartib mavjud kategoriyalar uchun ordinal encoding,
- tartibli munosabat mavjud bo‘lmagan kategoriyalar uchun one-hot encoding.
Sonli qiymatlar 1–10 oralig‘iga normallashtirilgan:
\[ Norm(x_i) = \frac{x_i-x_{min}} {x_{max}-x_{min}} \times 9 + 1 \]
Mualliflar ushbu masshtabdan, ayniqsa, juda kichik floating-point qiymatlar bilan ishlamaslik va xatolarni tuzatishni osonlashtirish uchun foydalanganliklarini bildiradi.
Tadqiqot Usuli va Natijalari
Tajriba protokoli
Barcha tajribalar 5-fold cross-validation bilan bajarilgan.
Asosiy parametrlar:
| Parametr | Qiymat |
|---|---|
| KNN qo‘shnilar soni | 5 |
| Masofa | Evklid |
| DE populyatsiyasi | 12 |
| DE masshtablash omili \(F\) | 1 |
| DE-HX HMCR | 0,85 |
| DE-HX PAR | 0,75 |
| Vazn oralig‘i | [0,1) |
| Random seed | 42 |
DE va DE-HX bir xil boshlang‘ich tuzilma, bir xil moslik funksiyasi va stagnationga asoslangan to‘xtatish mezonidan foydalangan.
DE-HX va standart DE taqqoslanishi
| Ma’lumotlar to‘plami | DE-HX Accuracy | DE Accuracy |
|---|---|---|
| Cirrhosis Patient Survival | 61,28 | 55,76 |
| Cryotherapy | 97,78 | 92,22 |
| Diabetes Multiclass | 98,87 | 96,23 |
| Drug 200 | 99,00 | 97,50 |
| ME/CFS vs. Depression | 99,60 | 90,80 |
| Migraine Classification | 91,50 | 86,25 |
| Spotify Recommendations | 96,41 | 93,85 |
DE-HX har bir ma’lumotlar to‘plamida ustun emas. Masalan, Body Performance va Customer Behavior kabi ayrim ma’lumotlar to‘plamlarida standart DE yuqoriroq Accuracy bergan. Shu sababli usulni barcha ma’lumotlar to‘plamlarida kafolatlangan ustunlik beradigan optimallashtirish usuli sifatida talqin qilish kerak emas.
WeightedKNN va ReliefF+KNN taqqoslanishi
DE-HX, shuningdek, distance-weighted KNN va ReliefF asosidagi KNN bilan taqqoslangan.
Masalan:
- Diabetes Multiclass: DE-HX %98,87, WeightedKNN %85,98, ReliefF+KNN %92,42
- Heart Failure Clinical: DE-HX %90,30, WeightedKNN %84,75, ReliefF+KNN %83,44
- Migraine Classification: DE-HX %91,50, WeightedKNN %79,50, ReliefF+KNN %81,00
- Spotify Recommendations: DE-HX %96,41, WeightedKNN %90,26, ReliefF+KNN %91,79
Ushbu natijalar ko‘rib chiqilgan tajriba tuzilmasida DE-HX ko‘plab ma’lumotlar to‘plamida kuchli xususiyatlarni vaznlash yondashuvi ekanini ko‘rsatadi.
Standart KNNga nisbatan yutuqlar
DE-HX bilan vaznlangan KNNning standart KNNga nisbatan Accuracy oshishi ayrim ma’lumotlar to‘plamlarida diqqatga sazovordir:
| Ma’lumotlar to‘plami | KNN | DE-HX | O‘sish |
|---|---|---|---|
| ME/CFS vs. Depression | 65,60 | 99,60 | 34,00 ball |
| Drug 200 | 80,00 | 99,00 | 19,00 ball |
| Diabetes Multiclass | 80,88 | 98,87 | 17,99 ball |
| Migraine Classification | 78,50 | 91,50 | 13,00 ball |
| Body Performance | 55,69 | 68,44 | 12,75 ball |
Macro-F1 yutuqlari
Macro-F1 bo‘yicha ham ayrim ma’lumotlar to‘plamlarida muhim farqlar qayd etilgan:
- ME/CFS vs. Depression: +39,16 ball
- Migraine Classification: +37,21 ball
- Drug 200: +27,13 ball
- Diabetes Multiclass: +18,21 ball
- Body Performance: +12,70 ball
Macro-F1, ayniqsa sinf taqsimoti nomutanosib bo‘lishi mumkin bo‘lgan ma’lumotlar to‘plamlarida faqat Accuracyga qaraganda muvozanatliroq ishlash bahosini beradi.
Statistik Testlar Nimani Ko‘rsatadi?
Friedman testi yetti usulning umumiy reytinglarida mazmunli farq mavjudligini ko‘rsatgan:
\[ \chi^2(6)=61{,}870,\quad p<0{,}001 \]
O‘rtacha reytinglar:
| Usul | O‘rtacha reyting |
|---|---|
| DE-HX | 6,58 |
| DE | 5,25 |
| Random Forest | 4,58 |
| ANN | 3,50 |
| ReliefF+KNN | 3,20 |
| WeightedKNN | 2,53 |
| KNN | 2,38 |
Holm post hoc tuzatishidan keyin DE-HX; RF, ANN, ReliefF+KNN, WeightedKNN va KNNdan sezilarli darajada farq qilgani aniqlangan. Biroq DE-HX bilan standart DE o‘rtasidagi tuzatilgan qiymat:
p = 0,0515
bo‘lgan. Bu qiymat an’anaviy 0,05 chegarasidan biroz yuqori.
Bunga qarshi, bevosita Wilcoxon signed-rank testida:
DE-HX vs. DE: p = 0,006, r = 0,652
natijasi qayd etilgan.
Shuning uchun ikki statistik tahlil turli tuzatish kontekstlarida o‘qilishi kerak; manba natijalarini “DE-HX barcha testlarda shubhasiz sezilarli ustunlik ko‘rsatdi” deb umumlashtirish to‘g‘ri emas.
DE-HX Vaznlari ANN va Random Forestni Ham Yaxshilaydimi?
Har doim emas. O‘rganilgan DE-HX vaznlari ANN va Random Forestga qo‘shimcha modelga xos qayta optimallashtirishsiz qo‘llangan. ANN ayrim ma’lumotlar to‘plamlarida sezilarli yaxshilanish ko‘rsatgan bo‘lsa, boshqalarida pasaygan; Random Forestda esa o‘zgarishlar ko‘pincha kichik va ma’lumotlar to‘plamiga bog‘liq.
ANNga ta’siri
Masalan, ANN Accuracy:
- Cryotherapyda %85,56 dan %93,26 ga,
- Diabetes Multiclassda %80,30 dan %86,31 ga,
- ME/CFS vs. Depressionda %92,50 dan %98,70 ga
oshgan.
Bunga qarshi, Migraine Classificationda %89,50 dan %82,46 ga tushgan.
Bu holat tashqi xususiyat vaznlari neyron tarmoqning o‘z ichki tasvirni o‘rganish dinamikasi bilan har doim ham mos kelmasligi mumkinligini ko‘rsatadi.
Random Forestga ta’siri
Random Forest natijalari kamroq o‘zgaradi. Manbada buning sababi RFning allaqachon random feature selection va bagging kabi o‘z ichki xususiyat tanlash mexanizmlariga ega ekani bilan bog‘langan.
Shu sababli oldindan qo‘llangan tashqi vaznlash RFga KNNdagidek aniq qo‘shimcha foyda bermaydi.
Usulning eng tabiiy qo‘llanish sohasi
Manbaning umumiy bahosiga ko‘ra DE-HX eng kuchli ta’sirini xususiyatlar fazosi geometriyasiga bevosita bog‘liq bo‘lgan masofaga asoslangan modellarda ko‘rsatadi.
KNN bu jihatdan tabiiy maqsaddir, chunki har bir xususiyat vazni masofa hisobini bevosita o‘zgartiradi.
Tadqiqotning Cheklovlari Nimalar?
- Bir nechta mustaqil optimallashtirish ishga tushirishlari bajarilmagan.
- Nested cross-validation ishlatilmagan.
- Taqqoslashlar qat’iy runtime yoki teng hisoblash budjeti asosida bajarilmagan.
- Convergence plot taqdim etilmagan.
- HMCR, PAR va boshqa giperparametrlar uchun batafsil sensitivity analysis bajarilmagan.
- O‘rganilgan vaznlarning ishga tushirishlar orasidagi barqarorligi tahlil qilinmagan.
- ANN va RFga o‘tkazish tajribalari modelga xos qayta tuning qilinmasdan bajarilgan.
- Natijalar ma’lumotlar to‘plamiga bog‘liq va DE-HX har bir holatda eng yuqori natijani bermaydi.
Mualliflar kelgusidagi ishlarda runtime va convergence tahlili, lokal qidiruv integratsiyasi, gibrid va ensemble tuzilmalar hamda nolga yaqin vaznlardan feature selection maqsadida foydalanish kabi yo‘nalishlarni o‘rganishni taklif qiladi.
Manba va Usul Haqida Izoh
Ushbu Verianla mazmuni Andrea Ortega-Guzmán, Salvador Ibarra-Martínez, José Antonio Castan-Rocha, J. David Teran-Villanueva, Mayra Guadalupe Treviño-Berrones va Aurelio Alejandro Santigo-Pineda tomonidan tayyorlangan Assessing Performance and Crossover Operators on Differential Evolution for Attribute Weighting nomli akademik tadqiqot asosida mustaqil ravishda tayyorlangan.
Maqola AI jurnalida 2026-yilda, 7-jild, 163-maqola sifatida nashr etilgan. DOI: 10.3390/ai7050163. Nashr sanasi 7-may 2026-yil. Tadqiqot MDPI tomonidan Creative Commons Attribution (CC BY) litsenziyasi ostida ochiq kirishda nashr etilgan.
Tadqiqotning asosiy usuli har bir ma’lumotlar to‘plami xususiyatiga uzluksiz vazn tayinlaydigan Differensial Evolyutsiyaga asoslangan optimallashtirish jarayonidir. Taklif qilingan DE-HX klassik DEdagi binomial crossover bosqichini Harmony Searchdan ilhomlangan nomzod yaratish mexanizmi bilan almashtiradi. Mavjud DE populyatsiyasi alohida Harmony Memorysiz manba xotirasi sifatida ishlatiladi.
KNNning 5-fold cross-validation aniqligi optimallashtirishning moslik funksiyasidir. Tajribalarda KNN uchun k=5 va Evklid masofasi; DE-HX uchun HMCR=0,85 va PAR=0,75; klassik DE uchun F=1 ishlatilgan.
Usul 20 ta ma’lumotlar to‘plamida baholangan; Accuracy va Macro-F1 bo‘yicha standart DE, KNN, WeightedKNN, ReliefF+KNN, ANN va Random Forest bilan taqqoslangan. Friedman, Holm va Wilcoxon testlari umumiy va juft statistik taqqoslashlar uchun ishlatilgan.
DE-HXning standart DEga qarshi bevosita Wilcoxon testida sezilarli ustunlik ko‘rsatgani qayd etilgan bo‘lsa-da, Holm ko‘p martalik taqqoslash tuzatishidan keyin DE-HX–DE farqi p=0,0515 bo‘lgani bildirilgan. Shu sababli statistik natijalar test konteksti saqlangan holda talqin qilinishi kerak.
Mualliflar tashqi moliyalashtirish olinmaganini bildirgan. Tajriba kodi hamda asl va oldindan qayta ishlangan ma’lumotlar to‘plamlari mavjud ekani ko‘rsatilgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan