

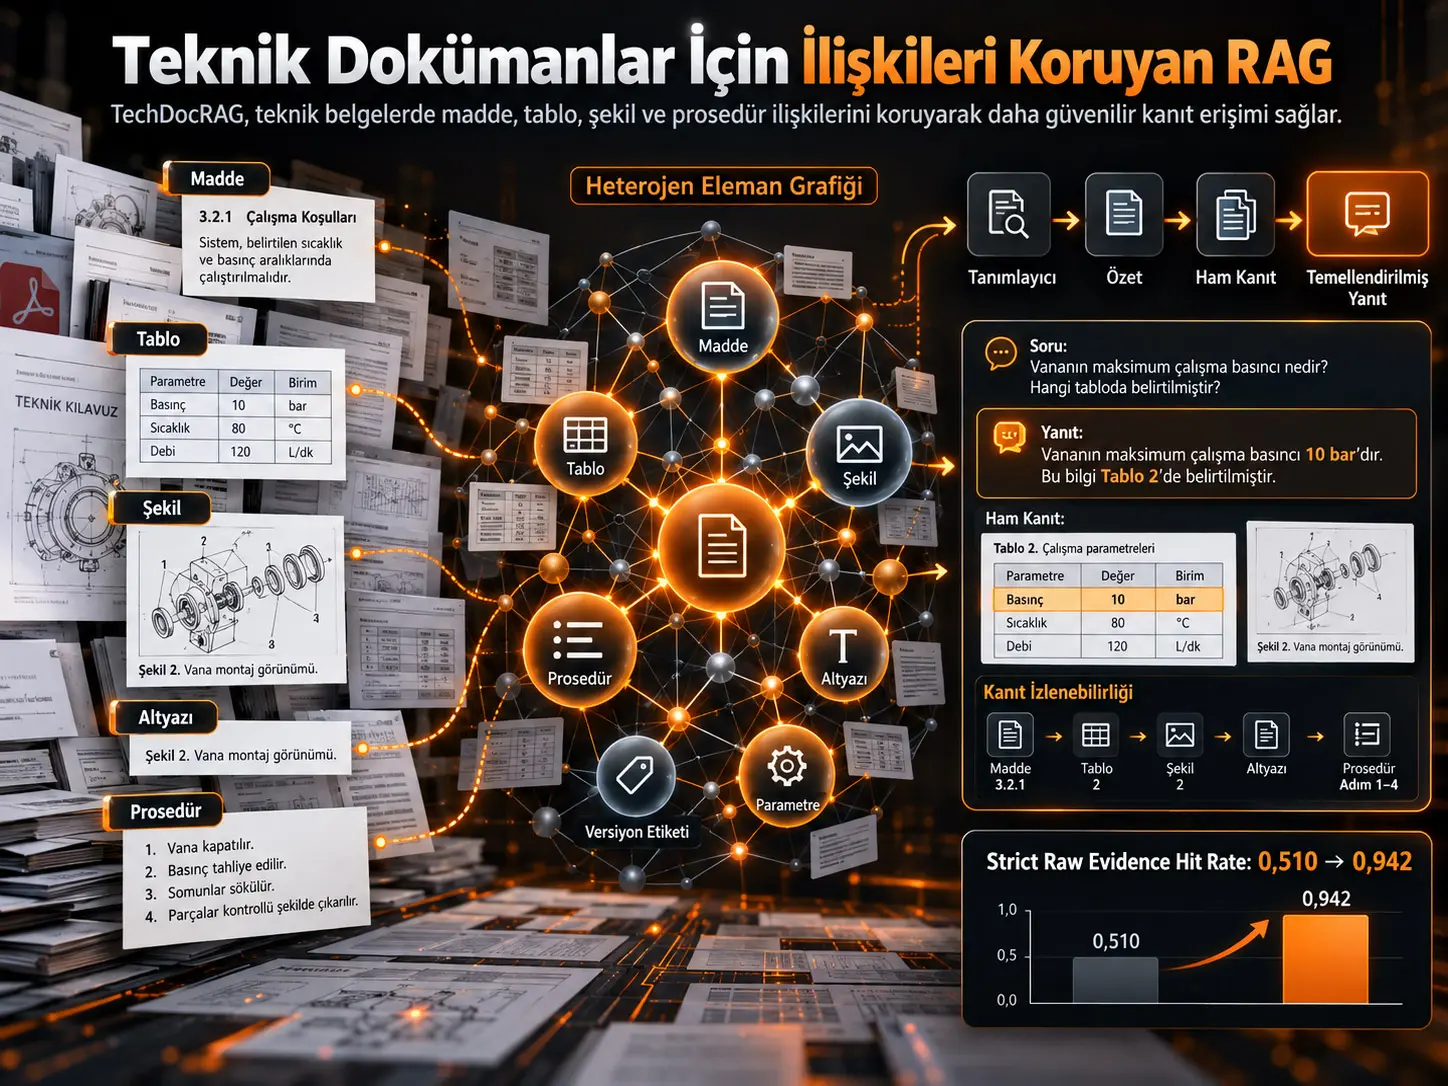
TechDocRAG, teknik dokümanları bağımsız metin parçalarından oluşan düz bir koleksiyon yerine; maddeler, paragraflar, tablolar, şekiller, altyazılar, bölümler ve prosedür adımları arasındaki ilişkileri koruyan heterojen bir eleman grafiği olarak temsil eden bir retrieval-augmented generation (RAG) çerçevesidir. Sistem her doküman elemanını üç eşleştirilmiş görünümle indeksler: teknik tanımlayıcılar, semantik özet ve ham kanıt. Sorgu sırasında önce teknik tanımlayıcılar üzerinden aday elemanlar bulunur, ardından sorgu niyetine göre ilişkili elemanlara graf üzerinden genişleme yapılır, semantik özetler yeniden sıralanır ve son aşamada birbiriyle bağlantılı ham kanıt nesneleri aynı bağlam paketi içinde üretici modele gönderilir.
Çalışma TechDocRAG'i MPMQA, DesignQA, MMLongBench-Doc ve LongDocURL olmak üzere dört benchmark üzerinde, dengelenmiş 7500'den fazla soru-cevap çiftiyle değerlendirmiştir. Aynı cevap üreticisinin ve karşılaştırılabilir bağlam bütçelerinin kullanıldığı deneylerde TechDocRAG; MPMQA'da 68,5, DesignQA'da 62,2, MMLongBench-Doc'ta 58,4 ve LongDocURL'de 55,2 skoruna ulaşmıştır. Dört benchmark ortalamasında en güçlü flat yaklaşım olan Hybrid Dense+BM25'e göre 20,3 puan, en güçlü non-flat yaklaşım olan VisRAG'e göre 9,3 puan daha yüksek sonuç raporlanmıştır.
Kanıt izlenebilirliği tarafında fark daha da belirgindir. Exact identifier eşleşmesini kullanan en sıkı Raw Evidence Hit Rate (REHR) değerlendirmesinde Hybrid RAG 0,510 iken TechDocRAG 0,942'ye ulaşmıştır. Ablasyon deneyleri identifier-aware recall çıkarıldığında ham kanıt erişiminin, ilişki kenarları çıkarıldığında kanıt bağlantısının, raw bundling kaldırıldığında ise üretilen iddiaların ham kanıtla desteklenmesinin belirgin biçimde zarar gördüğünü göstermektedir.
Bununla birlikte sistem teknik doküman ayrıştırmasının kalitesine bağımlıdır. Özellikle madde numarası, parametre adı, şekil veya tablo etiketi gibi teknik tanımlayıcıların ciddi biçimde bozulması ilk retrieval aşamasını çökertmektedir. Sonuçlar bu nedenle “graf kullanan her RAG daha iyidir” biçiminde değil; teknik dokümanlarda doğru kanıta ulaşabilmek için belge içi yapısal ve referans ilişkilerinin korunmasının önemli olduğuna dair deneysel kanıt olarak yorumlanmalıdır.
Teknik doküman RAG'i neden sıradan metin RAG'inden farklıdır?
Teknik şartnameler, kullanım kılavuzları, bakım dokümanları ve mühendislik standartları genellikle tek parça anlatı metni değildir. Bir gereksinimin tanımı Bölüm 4.2'de, sınır değeri Tablo 7'de, bağlantı düzeni Şekil 3'te ve özel durum uyarısı sonraki prosedür adımında bulunabilir.
Bu nedenle yalnız semantik olarak benzer bir paragrafı bulmak doğru cevabı üretmek için yeterli olmayabilir. Sistem doğru maddeyi bulsa bile madde tarafından atıf verilen tabloyu, şekli veya komşu prosedür adımını getiremezse kanıt zinciri eksik kalır.
TechDocRAG'in temel problemi tam olarak budur: ilgili metni bulmak ile cevabı destekleyen tam ve bağlantılı kanıtı bulmak aynı görev değildir.
TechDocRAG Standart RAG'den Nasıl Farklıdır?
Standart chunk tabanlı RAG, dokümanı çoğunlukla sabit uzunluklu veya semantik metin parçalarına böler ve bu parçaları bağımsız retrieval birimleri olarak işler. TechDocRAG ise madde, tablo, şekil, caption, prosedür adımı ve sürüm bilgisi gibi özgün doküman nesnelerini korur; bunların arasındaki table_ref, figure_ref, caption_of, step_next, version_of ve benzeri ilişkileri graf kenarları olarak saklar. Böylece retrieval yalnız “hangi içerik benziyor?” sorusuna değil, “bu kanıt hangi diğer kanıtlarla birlikte okunmalı?” sorusuna da cevap verir.
Belge bir heterojen eleman grafiğine dönüştürülüyor
Bir teknik doküman \(d\), çalışmada şu graf ile temsil edilir:
\[ G_d=(V_d,E_d) \]
Burada \(V_d\), dokümandaki eleman düğümlerini; \(E_d\) ise bu elemanlar arasındaki ilişkileri temsil eder.
Her düğüm:
\[ v=(\tau_v,r_v,k_v,s_v,m_v) \]
biçiminde tanımlanır.
- \(\tau_v\): Elemanın türü; örneğin madde, paragraf, tablo, şekil, caption veya prosedür adımı.
- \(r_v\): Ham doküman nesnesi.
- \(k_v\): Teknik tanımlayıcılar ve anahtar kelimeler.
- \(s_v\): Semantik özet.
- \(m_v\): Sayfa indeksi, bounding box, bölüm yolu, doküman türü, sürüm ve normative label gibi metadata.
Bu yapı, düz chunking sırasında kaybolabilecek belge kimliğini korur.
Graf kenarları hangi ilişkileri temsil ediyor?
| İlişki | Anlamı |
|---|---|
| contains | Bölüm veya üst elemanın alt elemanları içermesi |
| precedes | Yerel okuma sırasında bir elemanın diğerinden önce gelmesi |
| same_section | Aynı bölüm veya alt bölüm içinde bulunma |
| step_next | Prosedür adımlarının sıralı bağlantısı |
| clause_ref | Bir maddenin başka bir maddeye açık atfı |
| table_ref | Metinden tabloya yapılan referans |
| figure_ref | Metinden şekle yapılan referans |
| caption_of | Şekil veya tablo ile caption arasındaki bağlantı |
| same_identifier | Aynı teknik tanımlayıcının farklı elemanlarda tekrar kullanılması |
| version_of / supersedes | Dokümanın farklı sürümleri arasındaki ilişki |
Retrieval hedefi yalnız “en alakalı parça” değildir
Çalışma retrieval problemini ilişkili bir kanıt altgrafını bulma problemi olarak tanımlar:
\[ H_q^*=\arg\max_{H\subseteq G} \left[ Rel(q,H)+\lambda Conn(H)+\gamma Valid(q,H)-\mu Cost(H) \right] \]
Bu amaç fonksiyonunda:
- \(Rel(q,H)\), sorgu ile kanıt altgrafı arasındaki leksik ve semantik uygunluğu;
- \(Conn(H)\), kanıt düğümlerinin bağlantılılığını ve bütünlüğünü;
- \(Valid(q,H)\), doküman sürümü veya doküman türü gibi metadata tutarlılığını;
- \(Cost(H)\), retrieval ve bağlam oluşturma maliyetini
temsil eder.
\(\lambda\), \(\gamma\) ve \(\mu\) ise bu bileşenlerin amaç fonksiyonundaki ağırlıklarıdır. Matematiksel hedef yalnız en benzer düğümleri toplamak değil, yeterli derecede bağlantılı ve metadata açısından geçerli bir kanıt altgrafı oluşturmaktır.
Seçilen altgraf daha sonra cevap üreticisine aktarılır:
\[ (y_q,\Pi_q)=f_\theta(q,H_q^*) \]
Burada \(y_q\) üretilen cevabı, \(\Pi_q\) ise üretilen iddialardan ham kanıt düğümlerine uzanan provenance bağlantılarını temsil eder.
Üçlü “Identifier–Summary–Raw” Yapısı Ne İşe Yarıyor?
TechDocRAG her doküman elemanını aynı kimliğe bağlı üç retrieval görünümünde saklar: identifier görünümü tam teknik ankrajları bulmak, summary görünümü sorguyla semantik uygunluğu değerlendirmek, raw evidence görünümü ise son cevabın gerçekten dayandığı özgün metin, tablo, şekil veya prosedürü üretici modele aktarmak için kullanılır. Bu ayrım, semantik olarak yararlı fakat kaynakla doğrudan izlenemeyen özetlerin ham kanıtın yerine geçmesini önler.
Identifier ve özet nasıl üretiliyor?
Her düğüm için teknik identifier kümesi ve semantik özet:
\[ k_v=ExtractId(r_v,m_v), \qquad s_v=Summarize(r_v,N(v)) \]
olarak tanımlanır.
\(N(v)\), düğümün yerel ilişki komşuluğudur. Özet yalnız elemanın kendi ham içeriğinden değil, onu anlamlandıran yakın doküman bağlamından da yararlanabilir.
Her düğümün hizalanmış temsili:
\[ \phi(v)=\{k_v,s_v,r_v,m_v\} \]
şeklindedir.
Korpus düzeyindeki veritabanı ise:
\[ D=(I_{id},I_{sum},R,G) \]
olarak tanımlanır.
- \(I_{id}\): Teknik identifier indeksi.
- \(I_{sum}\): Semantik özet indeksi.
- \(R\): Ham kanıt deposu.
- \(G\): İlişki grafiği.
Identifier indeksi neden kritik?
Teknik dokümanlarda “Section 4.2”, “Table 7”, “parameter Z”, “error E105”, bir API komutu veya bir sürüm etiketi semantik olarak sıradan bir sözcükten çok daha güçlü bir ankraj olabilir.
Bu nedenle TechDocRAG ilk retrieval katmanında teknik tanımlayıcılara özel ağırlık verir. Ablasyon deneyinde identifier-aware recall kaldırıldığında REHR@10 değeri tam modeldeki 0,94'ten 0,65'e düşmektedir. Bu, sistemin önemli performans kaynaklarından birinin doğru teknik ankrajı erken aşamada bulmak olduğunu göstermektedir.
Sorgu önce analiz ediliyor
Her sorgu üç bileşene ayrılır:
\[ (k_q,e_q,z_q)=Analyze(q) \]
- \(k_q\): Sorgudaki teknik identifier ve anahtar kelimeler.
- \(e_q\): Semantik sorgu temsili.
- \(z_q\): Sorgu niyeti.
Kaynakta kullanılan niyet türleri arasında tanım/gereksinim araması, prosedür veya troubleshooting, metin-tablo akıl yürütmesi, metin-şekil grounding, cross-reference çözümleme ve sürüme duyarlı sorgular bulunmaktadır.
Aynı retrieval politikası her soru için kullanılmıyor
| Sorgu türü | Öne çıkan ilişkiler | Maksimum hop | Birincil hedef |
|---|---|---|---|
| Tanım / gereksinim | contains, same_identifier, clause_ref | 1-2 | Madde veya paragraf |
| Prosedür / troubleshooting | step_next, contains, same_section | 2 | Prosedür adımları |
| Metin-tablo | table_ref, caption_of, same_identifier | 2 | Tablo satırı / başlık yolu |
| Metin-şekil | figure_ref, caption_of, same_section | 2 | Şekil-caption çifti |
| Cross-reference | clause_ref, table_ref, figure_ref | 2 | Referans verilen eleman |
| Sürüme duyarlı sorgu | version_of, supersedes, same_identifier | 1 | Aktif revizyon düğümleri |
Bu politikanın mantığı şudur: “Bir parametre nedir?” sorusuyla “Sensör Y nasıl yeniden kalibre edilir?” sorusunun ihtiyaç duyduğu belge ilişkileri aynı değildir.
TechDocRAG Bir Sorguyu Adım Adım Nasıl İşliyor?
Online retrieval zinciri identifier-aware recall ile başlar, sorgu niyetine göre graf genişletme ile devam eder, genişletilmiş adaylar semantik özet alanında yeniden sıralanır, seçilen düğümler ham kanıt nesnelerine çözülür ve ilişkili kanıtlar bağlam bütçesi altında tek bir paket haline getirilir. Son cevap yalnız bu paket üzerinden oluşturulur ve iddialar provenance bağlantılarıyla ham kanıta bağlanır.
1. Identifier-aware recall
İlk aday kümesi kaynakta şu biçimde tanımlanır:
\[ C_{id}= TopK_{v\in V} \left[ \lambda_1 BM25(q,k_v) +\lambda_2 IdMatch(k_q,k_v) +\lambda_3 MetaMatch(q,m_v) \right] \]
BM25 leksik eşleşmeyi, IdMatch teknik identifier uyumunu, MetaMatch ise sorguyla metadata uyumunu değerlendirir.
2. İlişki grafında genişletme
İlk adayların sorgu niyetine uygun komşuları eklenir:
\[ C_{id}^{e}=C_{id}\cup Expand(C_{id},\Omega(z_q)) \]
\(\Omega(z_q)\), ilgili sorgu niyeti için hangi ilişki tiplerinin izleneceğini belirleyen politikadır.
3. Summary-level reranking
Genişletilmiş elemanlar semantik özet alanında yeniden sıralanır:
\[ C_{sum}=TopL_{v\in C_{id}^{e}} \left[ \alpha \cos(e_q,e_v) +\beta RelScore(v,C_{id}) +\gamma TypePrior(z_q,\tau_v) \right] \]
Buradaki temel fikir, ilk katmanın exact technical anchors için yüksek recall sağlaması; ikinci katmanın ise bu adayları sorgunun gerçek semantik amacı açısından daraltmasıdır.
4. Ham kanıt paketleme
Yeniden sıralanan düğümler ham kanıta dönüştürülür:
\[ C_{raw}=\bigcup_{v\in C_{sum}}Bundle(v) \]
Bir Bundle, tek bir metin parçasından daha fazlasını içerebilir. Örneğin bir madde + atıf verdiği tablo; veya bir şekil kırpımı + caption + şekle referans veren paragraf aynı kanıt paketi içinde tutulabilir.
5. Bağlam bütçesi
Ham kanıtlar bağlam bütçesi \(B\) altında paketlenir:
\[ E_q=Pack(C_{raw},B) \]
Deney protokolünde bağlam bütçesi 2048 metin tokenı ve multimodal yöntemler için 10 görsel bölge olarak normalize edilmiştir.
6. Grounded generation ve provenance
Son cevap:
\[ (\hat{y}_q,\Pi_q)=g_\theta(q,E_q) \]
ile üretilir.
İddia düzeyindeki provenance ise:
\[ \Pi_q=\{(c_i,U_i)\}_{i=1}^{M}, \qquad U_i\subseteq C_{raw} \]
şeklinde tanımlanır. Burada her \(c_i\) üretilen bir iddia, \(U_i\) ise bu iddiayı destekleyen ham kanıt nesneleridir.
PDF'nin Şekil 1'i ne anlatıyor?
Kaynak Şekil 1 mimariyi iki ana parçaya ayırır. Offline index construction tarafında teknik dokümanlar parse ve canonicalize edilir, heterojen eleman grafiği oluşturulur ve identifier index, summary index, raw store ile relation store eşleştirilir. Online query-time tarafında kullanıcı sorgusu analiz edilir, identifier-aware recall yapılır, ilişki genişletme ve summary reranking uygulanır, ham kanıt paketi oluşturulur ve provenance içeren cevap üretilir.
PDF'nin Şekil 2'si ne ekliyor?
Şekil 2 özellikle online karar akışına odaklanır. Sorgunun identifier ve niyet bileşenlerine ayrılmasının hangi relation policy'nin seçileceğini belirlediğini, retrieval sonrası bağlantılı komşuların alınmasını ve üretici modele bağımsız fragmentler yerine ilişkili ham kanıt paketlerinin gönderildiğini gösterir.
İlişkileri Korumak Gerçekten Performansı Artırdı mı?
Kaynak deneylerinde TechDocRAG dört benchmark'ın tamamında karşılaştırılan sistemlerden daha yüksek uçtan uca skor vermiştir. En büyük fark yalnız basit madde aramalarında değil; prosedür, metin-tablo, cross-reference ve sürüme duyarlı sorularda ortaya çıkmıştır. Bu desen, çalışmanın temel hipoteziyle uyumludur: yapısal ilişkilerin en büyük değeri, cevabın birden fazla bağlantılı doküman nesnesine dayandığı sorgularda ortaya çıkmaktadır.
Dört benchmark
- MPMQA: Ürün kılavuzlarında multimodal soru cevaplama; PM209 korpusu 209 kılavuz ve 22.021 insan etiketli soru-cevap çifti içerir.
- DesignQA: Formula SAE düzenlemeleri, CAD görüntüleri ve mühendislik çizimleri üzerinde grounded anlayış.
- MMLongBench-Doc: 130 uzun PDF üzerinde 1062 uzman etiketli soru; ortalama doküman uzunluğu 49,4 sayfa.
- LongDocURL: 33.000'den fazla sayfayı kapsayan 2325 soru-cevap çifti; anlama, akıl yürütme ve konum bulma görevleri.
Kontrollü değerlendirme, bu dört benchmark'tan seçilen dengeli 7500'den fazla soru-cevap çiftini kullanmıştır.
Karşılaştırılan RAG yöntemleri
TechDocRAG; Dense Chunk RAG, Hybrid Dense+BM25, Self-RAG, CRAG, RAPTOR, GraphRAG, LightRAG, HippoRAG 2 ve VisRAG ile karşılaştırılmıştır.
Adil karşılaştırma için tüm yöntemlerde mümkün olduğu ölçüde aynı cevap üreticisi kullanılmıştır: Gemini-3.1-Flash-Lite-Preview. Harici web erişimi kapatılmış, CRAG korpus içi retrieval ile sınırlandırılmış ve bağlam bütçeleri normalize edilmiştir.
TechDocRAG uygulama ayrıntıları
| Bileşen | Yapılandırma |
|---|---|
| Doküman parser | Layout segmentation, figure-caption alignment ve typed element extraction kullanan OCR tabanlı multimodal parser |
| Identifier canonicalization | Madde ID'leri, tablo/şekil etiketleri, parametre adları ve sürüm etiketleri için kural tabanlı normalizasyon; sorgu sırasında fuzzy matching |
| Identifier index | Normalize identifier, madde numarası, etiket ve alan anahtar kelimeleri üzerinde BM25 |
| Summary vector index | all-MiniLM-L6-v2 |
| Query analyzer | TinyLlama-1.1B-Chat-v1.0; batch size 16 |
| Answer generator | Gemini-3.1-Flash-Lite-Preview |
| Relation extraction | Açık cross-reference parsing + layout heuristics |
| Retrieval | Top-10 identifier recall, 2-hop graph expansion, top-5 summary reranking |
| Context budget | 2048 text tokenı + 10 visual region |
| Donanım | Single-GPU inference |
Çalışmanın Yöntemi ve Bulguları
End-to-end sonuçlar
| Yöntem | MPMQA | DesignQA | MMLong | LongDoc |
|---|---|---|---|---|
| Dense Chunk RAG | 44,8 | 40,5 | 33,2 | 31,4 |
| Hybrid Dense+BM25 | 48,2 | 44,1 | 36,5 | 34,2 |
| Self-RAG | 51,8 | 47,5 | 39,8 | 37,5 |
| CRAG | 52,4 | 48,8 | 40,5 | 38,2 |
| RAPTOR | 50,5 | 46,2 | 41,4 | 38,8 |
| GraphRAG | 54,8 | 50,5 | 44,8 | 42,4 |
| LightRAG | 55,6 | 51,2 | 46,1 | 43,8 |
| HippoRAG 2 | 56,5 | 52,8 | 47,5 | 45,2 |
| VisRAG | 54,2 | 57,5 | 48,8 | 46,5 |
| TechDocRAG | 68,5 | 62,2 | 58,4 | 55,2 |
Kaynak, dört benchmark ortalamasında Hybrid Dense+BM25'e göre 20,3 puan ve VisRAG'e göre 9,3 puan fark raporlamaktadır. Bunlar benchmark skorlarının mutlak puan farklarıdır; yüzde değişim değildir.
Raw Evidence Hit Rate neden önemli?
Raw Evidence Hit Rate (REHR), sistemin gerçek altın-standard ham kanıt düğümlerinden en az birini retrieval sonucu içinde yakalayıp yakalamadığını ölçer:
\[ REHR@K= \frac{1}{|Q|} \sum_{q\in Q} \mathbf{1} \left[ V_q^*\cap\hat{V}_q^{(K)}\neq\varnothing \right] \]
Exact identifier eşleşmesi gerektiren L0 düzeyinde sonuçlar şöyledir:
| Yöntem | Strict REHR |
|---|---|
| Dense | 0,452 |
| Hybrid | 0,510 |
| TechDocRAG | 0,942 |
Kriter 1-hop, 2-hop, 3-hop ve 4-hop komşuluğa gevşetildiğinde TechDocRAG REHR sırasıyla 0,965, 0,984, 0,992 ve 1,000 değerlerine ulaşmıştır.
Grounding metrikleri
Çalışma klasik Recall@10 ve Mean Reciprocal Rank yanında teknik doküman ilişkilerini değerlendirmek için özel metrikler tanımlamaktadır.
Summary-to-Raw Trace Accuracy (SRTA), getirilen özet düğümünün doğru ham kanıta izlenip izlenemediğini ölçer.
Evidence Connectivity Recall (ECR):
\[ ECR= \frac{1}{|Q|} \sum_{q\in Q} \frac{|\hat{E}_q\cap E_q^*|}{|E_q^*|} \]
ile retrieval sırasında gerekli relation edge'lerin ne kadarının geri kazanıldığını ölçer.
Version Consistency Score (VCS), üretilen iddiaların sorguyla ilgili doğru doküman sürümüne dayanma oranını değerlendirir.
Procedure Order Accuracy (POA), prosedür sorularında doğru adım sırasının korunmasını ölçer.
Claim Support Rate (CSR), üretilen iddiaların en az bir ham kanıt paketi tarafından desteklenme oranını ölçer.
| Yöntem | Recall@10 | MRR | REHR@10 | SRTA | ECR | CSR |
|---|---|---|---|---|---|---|
| Hybrid Dense+BM25 | 45,8 | 0,31 | 0,510 | 0,485 | 0,425 | 0,512 |
| HippoRAG 2 | 58,5 | 0,45 | 0,721 | 0,685 | 0,652 | 0,704 |
| VisRAG | 54,2 | 0,40 | 0,654 | 0,611 | 0,582 | 0,625 |
| TechDocRAG | 69,2 | 0,56 | 0,942 | 0,914 | 0,852 | 0,942 |
Sorgu türüne göre performans
TechDocRAG'in avantajı basit clause veya parameter sorgularında daha sınırlı, fakat belge ilişkilerini korumayı gerektiren sorgularda çok daha büyüktür.
| Sorgu türü | Hybrid Chunk RAG | TechDocRAG |
|---|---|---|
| Clause | 52,1 | 65,8 |
| Parameter | 48,4 | 64,2 |
| Procedure | 35,2 | 62,1 |
| Text–Table | 31,4 | 60,5 |
| Text–Figure | 28,5 | 58,4 |
| Cross-Reference | 25,1 | 57,2 |
| Version | 22,4 | 54,1 |
| Macro Average | 34,7 | 60,3 |
Ablasyon deneyleri ne gösteriyor?
| Varyant | Main Score | REHR@10 | ECR | CSR | VCS | POA |
|---|---|---|---|---|---|---|
| Tam model | 62,5 | 0,94 | 0,85 | 0,82 | 0,78 | 0,75 |
| Relation edge yok | 51,2 | 0,88 | 0,42 | 0,65 | 0,74 | 0,48 |
| Identifier recall yok | 54,8 | 0,65 | 0,72 | 0,75 | 0,68 | 0,65 |
| Summary routing yok | 56,4 | 0,91 | 0,81 | 0,78 | 0,72 | 0,70 |
| Raw bundling yok | 58,2 | 0,92 | 0,83 | 0,45 | 0,75 | 0,72 |
| Intent-aware expansion yok | 55,6 | 0,90 | 0,58 | 0,72 | 0,74 | 0,61 |
| Version metadata yok | 59,4 | 0,93 | 0,84 | 0,81 | 0,32 | 0,74 |
Bu tablo sistem bileşenlerinin farklı işlevlere sahip olduğunu gösterir. Relation edge'lerin kaldırılması ECR'yi 0,85'ten 0,42'ye düşürmektedir. Identifier recall kaldırılması REHR'yi 0,94'ten 0,65'e indirir. Raw bundling çıkarıldığında CSR 0,82'den 0,45'e düşmektedir. Version metadata kaldırıldığında ise VCS 0,78'den 0,32'ye geriler.
Dolayısıyla sistemin kazancı tek bir bileşenden gelmemektedir; exact anchor bulma, yapısal bağlantı, semantik yeniden sıralama, ham kanıt paketleme ve sürüm metadata'sı farklı hata türlerini hedeflemektedir.
Performans daha büyük hesaplama bütçesinden mi geliyor?
Kaynak profilleme bunu tek açıklama olarak desteklememektedir.
| Yöntem | Offline indexing | Index boyutu | Ortalama sorgu gecikmesi | Peak GPU bellek |
|---|---|---|---|---|
| Dense Chunk RAG | 2,5 s | 2,0 MB | 5,2 ms | ~150 MB |
| Hybrid Dense+BM25 | 3,8 s | 3,5 MB | 7,8 ms | ~180 MB |
| HippoRAG 2 | 12,4 s | 8,2 MB | 45,6 ms | ~450 MB |
| TechDocRAG | 6,36 s | 2,28 MB | 8,3 ms | 314,4 MB |
TechDocRAG'in offline indeks oluşturması Hybrid RAG'den daha pahalıdır; çünkü graf ve üçlü temsil oluşturulur. Buna karşılık ortalama query latency 8,3 ms ile Hybrid'in 7,8 ms değerine yakındır ve HippoRAG 2'nin 45,6 ms değerinden belirgin biçimde düşüktür.
Identifier bozulmasına karşı dayanıklılık
Çalışmanın robustness deneyinde OCR benzeri bozulmalar madde numaralarına, parametre adlarına ve tablo/şekil etiketlerine enjekte edilmiştir.
| Bozulma / kayıp oranı | REHR: identifier corruption | ECR: relation dropout |
|---|---|---|
| %0 | 1,0000 | 0,9875 |
| %5 | 1,0000 | 0,9825 |
| %10 | 1,0000 | 0,9725 |
| %20 | 0,0700 | 0,9525 |
| %30 | Raporlanmamış | 0,9310 |
Sonuç asimetriktir. Relation edge'lerin bir kısmının kaybolması sistem performansını kademeli azaltırken teknik identifier'ların ağır biçimde bozulması çok daha keskin bir hata üretir. Bu sonuç, sistemin graf ilişkileri açısından bir miktar fazlalığa sahip olduğunu fakat ilk retrieval ankrajının doğru parse edilmesine güçlü biçimde bağımlı kaldığını göstermektedir.
Çalışmanın sınırlılıkları
- TechDocRAG doküman parser kalitesine bağımlıdır.
- Tablo extraction, caption alignment ve clause numbering hataları relation graph'ını bozabilir.
- Açık cross-reference'lar örtük referanslardan daha güvenilir işlenmektedir.
- Standart dışı layout ve insan için anlaşılır fakat makine için örtük biçimsel ipuçları sorun yaratabilir.
- Farklı doküman sürümlerinde aynı identifier farklı koşullarla yeniden kullanılabilir.
- Relation-aware grounding metrikleri manuel kanıt anotasyonu gerektirmektedir.
- Performans sonuçları belirli benchmark'lar, retrieval yapılandırmaları ve ortak cevap üreticisi altında elde edilmiştir.
- Kaynak ana sonuç tablolarında tekrarlı deney varyansı, güven aralığı veya klasik anlamlılık testi raporlamamaktadır; bu nedenle skor farkları istatistiksel anlamlılık olarak genişletilmemelidir.
Pratik hata azaltma önerileri
Yazarlar düşük kaliteli OCR sayfalarını confidence-based filtering ile işaretlemeyi, problemli bölgeleri seçici biçimde yeniden parse etmeyi ve madde ID'si, tablo etiketi, şekil etiketi ve sürüm tag'leri için rule-based doğrulama kullanmayı önermektedir.
Daha pahalı vision/OCR işlemlerinin bütün sayfalara uygulanması yerine düşük güvenli bölgelere ayrılması da maliyet açısından önerilmektedir. Güven hâlâ düşükse sistem page-level veya region-level retrieval'a geri dönebilir ve provenance'ı belirsiz olarak işaretleyebilir.
Çalışma ne söylüyor?
Teknik dokümanlarda RAG başarısı yalnız daha fazla metin parçası retrieval etmekle açıklanamaz. Bir maddenin referans verdiği tablo, bir şeklin caption'ı, prosedür adımlarının sırası veya dokümanın doğru sürümü gibi ilişkilerin korunması; answer grounding ve evidence traceability açısından önemli performans kazancı sağlayabilir.
Çalışma ne söylemiyor?
TechDocRAG'in tüm RAG görevlerinde mutlak olarak en iyi yöntem olduğu gösterilmemiştir. Sonuçlar genel web QA, serbest biçimli bilgi arama veya ilişkisiz metin koleksiyonlarına doğrudan genellenemez. Ayrıca sistem kusursuz OCR veya parsing sorununu çözmemektedir; tam tersine ağır identifier bozulmasında performansının keskin biçimde düştüğü doğrudan deneyle gösterilmiştir.
Kaynak ve Yöntem Notu
Özgün çalışma: TechDocRAG: Relation-Preserving Retrieval-Augmented Generation (RAG) for Technical Documents
Yazarlar: Seungjoon Lee; Myungryul Choi.
Sorumlu yazar: Myungryul Choi.
Kurumlar: Department of EECI Engineering, Hanyang University; Division of Electrical Engineering, Hanyang University, Seoul, Republic of Korea.
Dergi: AI.
Yayınevi: MDPI.
Bibliyografik kayıt: AI 2026, 7(5), 161.
DOI: 10.3390/ai7050161
Kaynak türü: Araştırma makalesi.
Yayın süreci: Alındı 15 Mart 2026; revize edildi 21 Nisan 2026; kabul edildi 27 Nisan 2026; yayımlandı 6 Mayıs 2026.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Araştırma dış finansman almamıştır.
Veri erişilebilirliği: MPMQA, DesignQA, MMLongBench-Doc ve LongDocURL adlı kamuya açık benchmark veri kümeleri kullanılmıştır. Yeni büyük ölçekli bir benchmark oluşturulmamıştır. Türetilmiş anotasyonlar, promptlar ve uygulama ayrıntıları ilk yazardan talep edilebilir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemektedir.
Yazar katkıları: Seungjoon Lee kavramsallaştırma, metodoloji, yazılım, doğrulama, formal analiz, araştırma, kaynaklar, veri kürasyonu, ilk taslak ve görselleştirmeyi yürütmüştür. Seungjoon Lee ve Myungryul Choi gözden geçirme ve düzenlemeyi paylaşmış; Myungryul Choi süpervizyon ve proje yönetiminden sorumlu olmuştur.
Karşılaştırma yöntemi: Flat retrieval, adaptive/corrective RAG, hierarchical RAG, graph RAG, memory-oriented RAG ve multimodal retrieval yöntemleri karşılaştırılmıştır. Mümkün olduğu ölçüde aynı cevap üreticisi ve eşdeğer kanıt bütçesi kullanılmıştır. CRAG harici web erişimi olmaksızın corpus-only modda değerlendirilmiştir.
Temel yöntemsel sınır: Raporda benchmark skorlarına ilişkin klasik istatistiksel anlamlılık testleri, confidence interval veya run-to-run varyans raporlanmamıştır. Bu nedenle performans tabloları çalışma protokolü altında gözlenen karşılaştırmalı benchmark sonuçları olarak ele alınmalıdır.
Verianla içerik yöntemi: Bu Türkçe metin kaynak makalenin cümle cümle çevirisi değildir. Problem tanımı, heterojen eleman grafiği, identifier-summary-raw mimarisi, matematiksel retrieval formülasyonu, query intent politikaları, benchmark düzeni, evaluation metrikleri, ablasyonlar, kaynak maliyeti, robustness deneyleri ve yöntemsel sınırlılıklar korunarak bağımsız Türkçe bilimsel anlatım oluşturulmuştur. Kaynakta bulunmayan performans, istatistik veya sistem özelliği eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir