

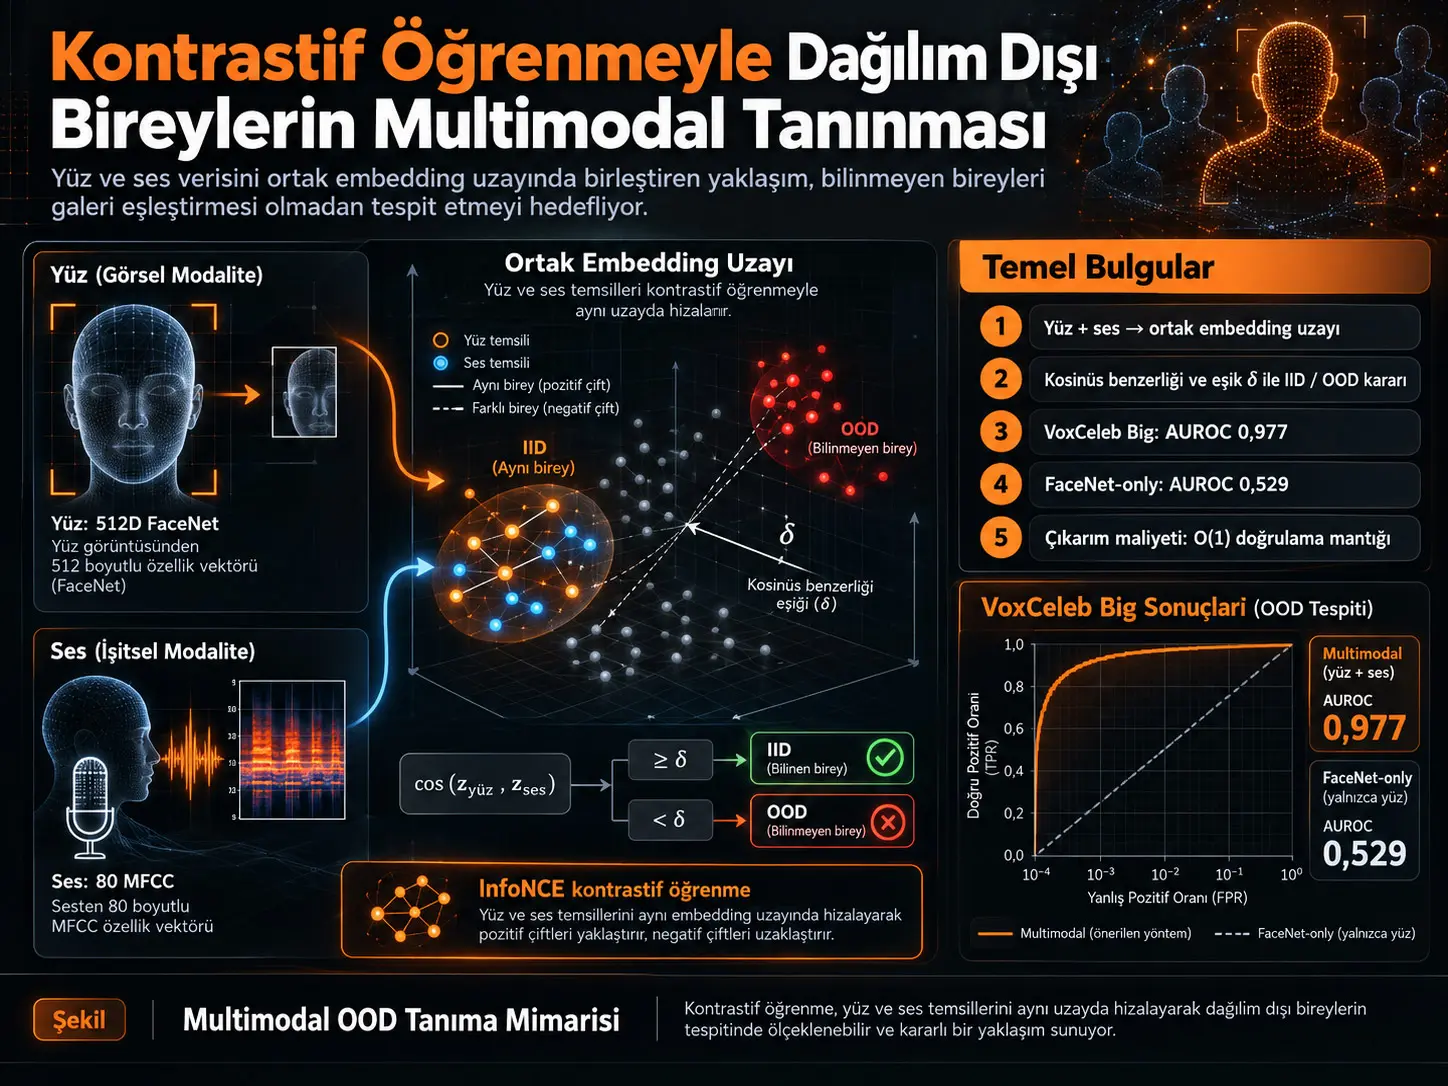
Dağılım dışı birey (out-of-distribution, OOD), bir kişi tanıma sisteminin eğitim sırasında öğrendiği kimlik dağılımının dışında kalan, daha önce görülmemiş bir bireyi ifade eder. Geleneksel kapalı-küme tanıma sistemlerinde böyle bir örnek geldiğinde model bilinmeyen kişiyi mevcut sınıflardan birine zorla atayabilir. Sergio Garcia, Francisco Gomez-Donoso ve Miguel Cazorla tarafından geliştirilen yöntem bu sorunu yalnız yüz veya yalnız ses üzerinden çözmek yerine, iki biyometrik modalitenin birbirleriyle ne kadar tutarlı olduğunu ölçmektedir.
Model bir yüz görüntüsünden FaceNet aracılığıyla 512 boyutlu özellik vektörü, ses kaydından ise 80 Mel-Frequency Cepstral Coefficient (MFCC) özelliği çıkarır. İki ayrı sinir ağı dalı bu temsilleri 1200 boyutlu ortak embedding uzayına projekte eder. Eğitim sırasında InfoNCE tabanlı kontrastif kayıp, aynı kişiye ait yüz-ses çiftlerini birbirine yaklaştırırken farklı kişilere ait çiftleri birbirinden uzaklaştırır.
Çıkarım sırasında kimlik galerisi içinde en yakın kişi aranmaz. Bunun yerine yüz embedding'i ile ses embedding'i arasındaki kosinüs benzerliği ölçülür. Değer belirlenen eşik \(\delta\)'nın altındaysa çift OOD, eşik üzerindeyse dağılım içi olarak sınıflandırılır.
Custom, LombardGrid ve VoxCeleb tabanlı deneylerde yöntem özellikle kimlik sayısı büyüdüğünde FaceNet-only karşılaştırmasına göre daha kararlı sonuçlar vermiştir. VoxCeleb Big deneyinde multimodal yöntemin AUROC değeri 0,977 iken FaceNet-only karşılaştırmasının değeri 0,529 olmuştur. Bununla birlikte sonuçlar tüm multimodal kişi tanıma yöntemlerine karşı kapsamlı bir state-of-the-art karşılaştırma değildir ve modelin gerçek dünyada büyük ölçekli etik ve operasyonel doğrulaması gelecekteki çalışma olarak bırakılmıştır.
Dağılım dışı birey problemi nedir?
Bir sinir ağı yalnız eğitim sırasında gördüğü sınıflar arasından seçim yapacak biçimde tasarlanmışsa, daha önce hiç karşılaşmadığı bir kimliği de bilinen sınıflardan birine atayabilir. Modelin yüksek güven üretmesi bu kişinin gerçekten tanındığı anlamına gelmeyebilir.
Bu sorun özellikle kişi tanıma sistemlerinde önemlidir. Bir sistemin “bu kişi eğitimde gördüğüm kişilerden biri değil” diyebilmesi, yalnız doğru sınıflandırma yapabilmesinden farklı bir yetenektir.
Makale bu problemi yüz ve ses olmak üzere iki ayrı biyometrik modaliteyi birlikte kullanarak ele almaktadır.
Yüz ve Ses Birlikte OOD Tespitini Nasıl Sağlıyor?
Önerilen sistemin temel varsayımı, aynı kişiye ait yüz ve ses temsillerinin kontrastif eğitim sonrasında ortak bir latent uzayda birbirleriyle uyumlu hale getirilebilmesidir. Model “kişinin kimliğini galeri içinde bulmaya” çalışmak yerine, yüz ve sesin öğrenilmiş temsil uzayında aynı kimliğe ait olacak kadar tutarlı olup olmadığını sorar.
Yüz tarafı: FaceNet
Yüz görüntüleri doğrudan önerilen kontrastif ağa ham piksel olarak verilmez. Önce FaceNet tarafından işlenir ve her görüntü için 512 boyutlu yüz embedding'i oluşturulur.
Bu temsil yüzün ayırt edici özelliklerini kompakt bir metrik uzayında kodlamak için kullanılır. Ardından 512 boyutlu vektör önerilen multimodal ağın yüz dalına aktarılır.
Ses tarafı: MFCC
Ses verisi için Mel-Frequency Cepstral Coefficients kullanılmıştır. Her ses parçasından 80 MFCC özelliği çıkarılmıştır.
MFCC çıkarımından önce ses genliği 0,03 hedef değerine doğrusal gain normalization ile normalize edilmiştir. Yazarlar bunun RMS veya peak normalization olmadığını özellikle belirtmektedir. Amaç kayıt ses seviyesindeki farklılıkların spektral özellikler üzerinde gereksiz değişkenlik oluşturmasını azaltmaktır.
İki modalite ortak uzayda buluşuyor
Yüz ve ses dalları benzer çok katmanlı yapılar kullanır. Her iki dalın sonunda temsil 1200 boyutlu ortak embedding uzayına projekte edilir.
| Dal | Girdi | Ara katmanlar | Çıkış |
|---|---|---|---|
| Yüz | 512D FaceNet embedding | 1024 → 512 → 256 | 1200D embedding |
| Ses | 80 MFCC özelliği | 1024 → 512 → 256 | 1200D embedding |
Her ara blokta Linear, BatchNorm1d, ReLU ve Dropout bileşenleri bulunmaktadır. Kaynakta model için toplam 2.544.480 eğitilebilir parametre raporlanmıştır.
Kontrastif Öğrenme Burada Ne Öğreniyor?
Kontrastif öğrenme, aynı kişiye ait yüz-ses çiftlerini embedding uzayında birbirine yaklaştırırken farklı kişilerin çiftlerini birbirinden uzaklaştırmayı amaçlamaktadır. Böylece sistem bir sınıf etiketi ezberlemek yerine iki farklı modalite arasındaki kimlik tutarlılığını öğrenmeye çalışır.
Pozitif ve negatif çiftler
Aynı kişiye ait yüz \(f_i\) ile ses \(a_i\) bir pozitif çift oluşturur.
Farklı kişilere ait yüz \(f_i\) ile ses \(a_j\), \(i \neq j\) olduğunda negatif çift oluşturur.
Kaynak, 40 yüz ve 40 ses örneği bulunan tek bir kişi için 1600 pozitif eşleşme kombinasyonu oluşabileceğini göstermektedir. Örnek olarak 50 kişilik bir durumda toplam 80.000 pozitif çift ve 3.920.000 olası negatif çift hesaplanmaktadır. Bu bölüm yöntemsel kombinasyon örneğidir; kullanılan tüm veri kümelerinin gerçekten 50 kişiden oluştuğu anlamına gelmez.
InfoNCE kaybı
Eğitimde kullanılan kontrastif kayıp:
\[ L_{\text{contrastive}} = -\frac{1}{N} \sum_{i=1}^{N} \log \frac{ \exp(sim(z_{f_i},z_{a_i})/\tau) }{ \sum_{j=1}^{N} \exp(sim(z_{f_i},z_{a_j})/\tau) } \]
biçimindedir.
Burada \(z_f\) yüz embedding'ini, \(z_a\) ses embedding'ini, \(N\) batch boyutunu ve \(\tau\) sıcaklık parametresini temsil eder.
Benzerlik ölçüsü kosinüs benzerliğidir:
\[ sim(z_f,z_a) = \frac{z_f \cdot z_a} {\|z_f\|\|z_a\|} \]
Eğitim parametreleri arasında 50 epoch, sınıf sayısına eşit batch size, 0,0005 learning rate ve \(\tau=0,05\) sıcaklık değeri bulunmaktadır.
Sistem Bilinmeyen Bir Kişiyi Nasıl Kararlaştırıyor?
Çıkarım sırasında bir yüz-ses çiftinin iki embedding'i üretilir ve aralarındaki kosinüs benzerliği hesaplanır. Kaynakta OOD kararı şu şekilde tanımlanır:
\[ OOD(z_f,z_a)= \begin{cases} 1, & sim(z_f,z_a)<\delta \\ 0, & \text{aksi halde} \end{cases} \]
\(\delta\), karar eşiğidir.
Kaynakta başlangıç eşiği eğitimdeki pozitif çiftlerin ortalama benzerliğinin yarısı kullanılarak ampirik biçimde oluşturulmuştur. Ancak yazarlar bu değeri optimize edilmiş sabit model parametresi olarak sunmamaktadır. Deneylerde geniş bir threshold aralığı taranarak yöntemin farklı çalışma noktalarındaki duyarlılığı ayrıca incelenmiştir.
Önemli nüans: “görülmemiş kişi” her zaman düşük benzerlik üretmez
Bu nokta yöntemi anlamak açısından kritiktir. Model daha önce görmediği bir kişinin yüzü ile sesini de ortak embedding uzayında iyi eşleştirebilir.
Dolayısıyla sistemin OOD mekanizması “bu kimliği daha önce ezberledim mi?” sorusuna dayanmamaktadır. Ölçülen şey yüz ve ses arasındaki cross-modal consistency'dir.
Eğitim öncesi ve sonrası benzerlik dağılımı
Kaynağın 9. sayfasındaki Şekil 2, kontrastif eğitimden önce yüz ve ses temsillerinin bütün veri kümelerinde yaklaşık sıfır çevresinde toplandığını göstermektedir. Başka bir ifadeyle FaceNet yüz özellikleri ile MFCC ses özellikleri doğal olarak aynı koordinat uzayında hizalanmış değildir.
Aynı sayfadaki Şekil 3 ve Şekil 4'te ise eğitim sonrasında LombardGrid pozitif yüz-ses çiftlerinin kosinüs benzerliklerinin hem eğitim hem test kümesinde 1'e yaklaştığı görülmektedir. Bu değişim, kontrastif modelin iki farklı modalite arasında ortak bir temsil öğrendiğinin doğrudan görsel göstergesidir.
Çalışmanın Yöntemi ve Bulguları
Kullanılan veri kümeleri
Çalışma üç ana veri kaynağı kullanmaktadır: araştırmacıların oluşturduğu custom veri kümesi, VoxCeleb1 ve Lombard Grid.
Custom veri kümesi
Özel veri kümesi 15 farklı kişiden yüz ve ses verileri içermektedir. Kaynaklar hem YouTube gibi kamuya açık platformlardaki videoları hem de onam veren kişilerin gerçek zamanlı kayıtlarını kapsamaktadır.
Her kişinin 3-10 arasında ses klibi bulunmaktadır ve seslerin ortalama uzunluğu 4-8 saniyedir. Eğitim verisine augmentation uygulanarak kişi başına 40 yüz karesi ve 40 ses örneğine ulaşılmıştır. Test için kişi başına üç yüz karesi ve üç ses örneği ayrılmış; test kayıtlarının eğitimde kullanılan kayıtlardan farklı kaynaklardan gelmesine dikkat edilmiştir.
VoxCeleb1
VoxCeleb1 toplam 1251 kişiye ait 100.000'den fazla ses klibi içeren geniş ölçekli bir konuşmacı veri kümesidir. Kayıtlar arka plan gürültüsü, aksan ve mikrofon koşulları açısından çeşitlilik göstermektedir.
Bu çalışmada test videoları eğitim videolarından ayrı tutulmuştur. Eğitim için kişi başına hedef 20 yüz karesi ve 20 ses örneği belirlenmiş, augmentation sonrasında 40 yüz ve 40 ses örneğine çıkılmıştır.
Lombard Grid
Lombard Grid 54 konuşmacı ve kişi başına 1000'den fazla ses klibi içermektedir. Seslerle eş zamanlı video kayıtlarının bulunması onu yüz-ses eşleştirmesi için uygun hale getirmektedir.
Bu çalışmada kişi başına eğitim için 20 yüz ve 20 ses, test için ise farklı kayıtlardan 5 yüz ve 5 ses seçilmiştir. Kontrollü veri yapısı nedeniyle augmentation uygulanmamıştır.
Custom veri kümesi sonuçları
Custom veri kümesinde multimodal yöntem ile FaceNet-only baseline'ın ikisi de IID ve OOD örnekleri yüksek başarıyla ayırmıştır. ROC analizinde:
| Yöntem | AUROC |
|---|---|
| Multimodal | 0,9928 |
| FaceNet-only | 0,9828 |
Fark çok büyük değildir; ancak threshold grafikleri multimodal yöntemin karar eşiğine karşı daha istikrarlı bir bölge oluşturduğunu göstermektedir.
LombardGrid sonuçları
Kontrollü LombardGrid veri kümesinde her iki yöntem de AUROC=1 değerine ulaşmıştır. Bu nedenle yalnız ROC eğrisi üzerinden multimodal yöntemin üstün olduğu söylenemez.
Kaynağın vurguladığı farklılık, multimodal yöntemin yüksek IID/OOD performansını daha geniş bir threshold aralığında korumasıdır. Başka bir ifadeyle aynı zirve performansına ulaşsalar da eşik seçimine duyarlılıkları aynı değildir.
VoxCeleb Mini
VoxCeleb Mini deneyinde multimodal sistem AUROC=0,974, FaceNet-only yöntem ise AUROC=0,971 elde etmiştir. ROC açısından yöntemler birbirine yakındır.
Ancak OOD tespit hedefi yükseldikçe IID doğruluğunun korunması açısından multimodal sistem daha istikrarlı kalmıştır.
| OOD tespiti | Multimodal IID | FaceNet IID |
|---|---|---|
| %90,0 | %95,0 | %93,0 |
| %91,8 | %95,0 | %88,5 |
| %93,5 | %92,5 | %85,0 |
| %95,2 | %90,0 | %85,0 |
| %97,0 | %87,5 | %66,7 |
VoxCeleb Big: ölçek büyüdüğünde ne oluyor?
Makalenin en belirgin ayrışması VoxCeleb Big deneyinde görülmektedir.
Multimodal yöntemin AUROC değeri 0,977 iken FaceNet-only karşılaştırmasının değeri 0,529'dur. İkincisi rastgele ayırıma yakın bir ROC performansını temsil etmektedir.
| OOD tespiti | Multimodal IID | FaceNet IID |
|---|---|---|
| %90,0 | %94,6 | %18,7 |
| %91,8 | %94,3 | %17,8 |
| %93,5 | %93,8 | %16,8 |
| %95,2 | %92,7 | %14,7 |
| %97,0 | %86,2 | %11,7 |
Yazarların açıklaması FaceNet-only sistemin çalışma biçimiyle ilişkilidir. Bu baseline, sorgu embedding'ini geniş bir kayıtlı kimlik galerisiyle karşılaştırmaktadır. Galeri büyüdükçe sınıflar arası benzerlik dağılımları üst üste gelmeye başlar ve bilinen-bilinmeyen ayrımında kullanılan eşik daha kırılgan hale gelir.
Multimodal yöntem ise bütün kayıtlı kimliklerle 1:N karşılaştırma yapmak yerine verilen yüz ve sesin kendi aralarındaki tutarlılığı ölçmektedir.
Hesaplama karmaşıklığı
Kaynak, önerilen yöntemin çıkarım sırasında yalnız:
- bir yüz embedding'i,
- bir ses embedding'i,
- bir kosinüs benzerliği hesabı
gerektirdiğini belirtmektedir.
Bu nedenle doğrulama başına işlem maliyeti galeri büyüklüğünden bağımsız olarak O(1) şeklinde ifade edilmiştir. Buna karşılık klasik 1:N galeri tabanlı kişi tanımada sorgu bütün kayıtlı kimliklerle karşılaştırıldığı için hesaplama miktarı galeri boyutuyla büyür.
Bu karmaşıklık iddiası çalışma tarafından tanımlanan doğrulama prosedürüne aittir; gerçek sistemin kamera, ses ön işleme, FaceNet feature extraction veya donanım gecikmesinin tamamının O(1) ve sabit süre olduğu anlamına gelmez.
Çalışmanın önemli sınırlılıkları
- Temel deneysel karşılaştırma yalnız FaceNet-only unimodal baseline'a karşı yapılmıştır.
- Diğer multimodal state-of-the-art yöntemlerle tam deneysel karşılaştırma yapılmamıştır.
- Basit feature concatenation gibi alternatif multimodal fusion baseline'ları ana karşılaştırmaya dahil edilmemiştir.
- Her modalitenin bağımsız katkısını nicel olarak ayıran ayrıntılı ablasyon analizi henüz yapılmamıştır.
- OOD karar eşiği ampirik bir çalışma noktasıdır; tek evrensel optimum eşik olarak sunulmamaktadır.
- Custom veri kümesi yalnız 15 kişiden oluşmaktadır.
- Gerçek dünya koşullarında çok daha geniş ölçekli doğrulama gelecek çalışma olarak bırakılmıştır.
- Etik, gizlilik ve gerçek sistem kullanımına ilişkin büyük ölçekli değerlendirme tamamlanmış değildir.
Gelecek çalışmalar
Yazarlar sisteme yürüyüş biçimi ve derinlik verisi gibi ek modaliteler dahil etmeyi, zamansal modelleme kullanmayı, self-supervised ve few-shot öğrenme yöntemlerini araştırmayı ve veri gereksinimini azaltmayı planlamaktadır.
Ayrıca daha geniş gerçek dünya validasyonu, etik değerlendirmeler ve her modalitenin sonuç üzerindeki katkısını ölçen daha derin ablasyon deneyleri gelecek araştırma başlıkları arasındadır.
Çalışma ne söylüyor?
Yüz ve ses temsillerinin kontrastif olarak aynı embedding uzayına hizalanması, özellikle kimlik galerisi büyüdüğünde cross-modal consistency üzerinden IID/OOD ayrımının daha kararlı yapılabilmesini sağlayabilir. Çalışmadaki en güçlü deneysel destek VoxCeleb Big sonuçlarından gelmektedir.
Çalışma ne söylemiyor?
Sistem daha önce görülmemiş bütün bireyleri hatasız biçimde tespit etmektedir sonucu çıkarılamaz. Yöntemin bütün multimodal biyometrik sistemlerden üstün olduğu gösterilmemiştir. Bu çalışma tek başına yüz-ses biyometrisinin güvenlik, gözetim veya kimlik doğrulama uygulamalarında dağıtıma hazır olduğunu da kanıtlamamaktadır.
Kaynak ve Yöntem Notu
Özgün çalışma: Multimodal Recognition of Out-of-Distribution Individuals Using Contrastive Learning
Yazarlar: Sergio Garcia; Francisco Gomez-Donoso; Miguel Cazorla.
Sorumlu yazar: Miguel Cazorla.
Kurum: University Institute for Computer Research, University of Alicante, Alicante, Spain.
Dergi: AI.
Yayınevi: MDPI.
Bibliyografik kayıt: AI 2026, 7, 162.
DOI: 10.3390/ai7050162
Makale türü: Deneysel yapay zekâ / multimodal kişi tanıma araştırması.
Yayın süreci: Alındı 31 Ocak 2026; revize edildi 6 Nisan 2026; kabul edildi 24 Nisan 2026; yayımlandı 6 Mayıs 2026.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Çalışma PID2022-138453OB-I00 hibesi çerçevesinde MICIU/AEI/10.13039/501100011033 ve “ERDF A way of making Europe” tarafından desteklenmiştir.
Etik: Çalışma Helsinki Bildirgesi'ne uygun olarak yürütülmüş ve University of Alicante Ethics Committee tarafından UA-2023-07-31 protokol koduyla Temmuz 2023'te onaylanmıştır.
Bilgilendirilmiş onam: Çalışmaya dahil edilen kişilerden bilgilendirilmiş onam alınmıştır.
Veri erişilebilirliği: Sonuçları destekleyen ham verilerin yazarlar tarafından talep üzerine sunulacağı bildirilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemektedir.
Yöntemsel çekirdek: FaceNet'ten çıkarılan 512 boyutlu yüz embedding'leri ile 80 MFCC ses özelliği iki ayrı sinir ağı dalıyla 1200 boyutlu ortak embedding uzayına projekte edilmiştir. InfoNCE kontrastif kaybıyla aynı kişiye ait yüz-ses çiftleri yakınlaştırılmış, farklı kişilerin çiftleri uzaklaştırılmıştır. OOD kararı yüz ve ses embedding'leri arasındaki kosinüs benzerliği ile ampirik bir threshold üzerinden verilmiştir.
Temel yorum sınırı: Çalışma geniş bir state-of-the-art multimodal baseline karşılaştırması gerçekleştirmemektedir. Sonuçların önemli bölümü FaceNet-only baseline ile kontrollü karşılaştırmaya dayanmakta ve daha geniş ablation, gerçek dünya ölçekleme ve etik değerlendirme gelecekteki çalışma olarak bırakılmaktadır.
Verianla içerik yöntemi: Bu Türkçe metin kaynak PDF'nin cümle cümle çevirisi değildir. Çalışmanın veri kümeleri, yüz ve ses temsilleri, ağ mimarisi, kontrastif kayıp, OOD eşik mekanizması, eğitim protokolü, ROC/AUROC sonuçları, ölçek analizi, hesaplama yaklaşımı, etik beyanları ve yöntemsel sınırları korunarak bağımsız Türkçe bilimsel anlatım oluşturulmuştur. Kaynakta bulunmayan performans, kişi sayısı, klinik/güvenlik sonucu veya dağıtım başarısı eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir