


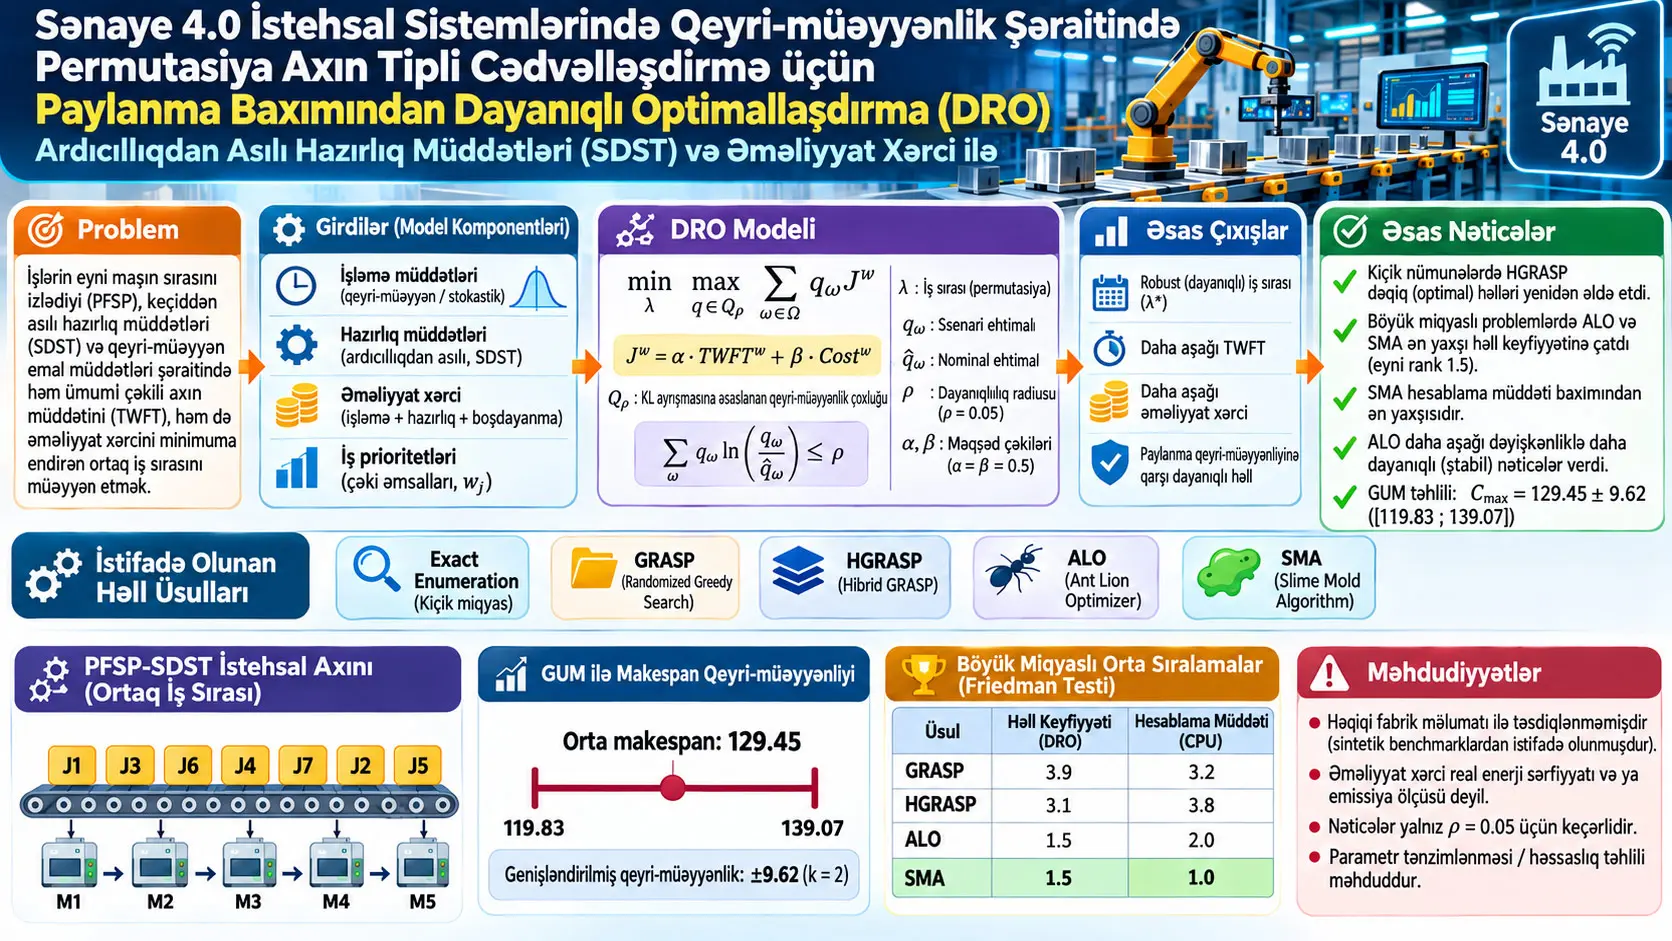
Paylanma Baxımından Dayanıqlı Optimallaşdırma (Distributionally Robust Optimization, DRO), qeyri-müəyyən parametrin yalnız bir və dəqiq ehtimal paylanmasından gəldiyini fərz etmək əvəzinə, mümkün paylanmalardan ibarət ambiguity set daxilində ən əlverişsiz gözlənilən nəticəni nəzərə alaraq qərar yaradan optimallaşdırma yanaşmasıdır. Bu tədqiqat DRO-nu bütün işlərin maşınları eyni ardıcıllıqla ziyarət etdiyi Permutation Flow Shop Scheduling Problem quruluşuna, ardıcıllıqdan asılı hazırlıq müddətlərinə (Sequence-Dependent Setup Times; SDST), qeyri-müəyyən processing times-a və processing/setup/idle müddətlərindən törəyən operational cost-a inteqrasiya edir. Məqsəd, Total Weighted Flow Time (TWFT) ilə operational cost-u çəkili vahid məqsəd funksiyasında birlikdə minimuma endirən ümumi iş ardıcıllığını müəyyən etməkdir.
Həqiqi processing-time distribution-ın tam məlum olmadığı qəbul edilir; sintetik processing scenarios nominal paylanma ətrafında yaradılır və mümkün scenario probability distributions, Kullback–Leibler divergence ilə müəyyən edilən ambiguity set daxilində qiymətləndirilir. Robustness radius \(\rho\), nominal paylanmadan nə qədər uzaqlaşmağa icazə verildiyini idarə edir. Tədqiqatdakı bütün əsas computational experiments üçün \(\rho=0.05\) sabitlənmişdir; buna görə əldə olunan alqoritm sıralamaları və robustness nəticələri fərqli \(\rho\) dəyərləri üçün sübut edilmiş deyil.
Kiçikmiqyaslı problemlər üçün IBM ILOG CPLEX dəstəkli exhaustive enumeration üsulu ilə global-optimum benchmark həlləri əldə edilmişdir. Medium və large instances üçün Greedy Randomized Adaptive Search Procedure (GRASP), tədqiqatın təklif etdiyi Hybrid GRASP (HGRASP), Ant Lion Optimizer (ALO) və Slime Mold Algorithm (SMA) müqayisə edilmişdir. Kiçik nümunələrdə HGRASP sınaqdan keçirilən bütün exact benchmarkları yenidən hasil etmiş; digər təxmini üsullar da əksər hallarda exact və ya çox yaxın nəticələrə çatmışdır. Böyükmiqyaslı problemlərdə Friedman testi solution quality və computational time baxımından alqoritmlər arasında əhəmiyyətli fərq olduğunu göstərmişdir. ALO və SMA solution quality baxımından eyni ən yaxşı mean rank dəyərinə çatmış və post-hoc təhlildə bir-birindən əhəmiyyətli şəkildə fərqlənməmişdir; SMA computational time baxımından ən yaxşı sıralamaya çatmışdır.
Tədqiqat real fabrikdən götürülmüş istehsal qeydləri üzərində doğrulanmamışdır. Processing times, setup times, job weights və machine cost coefficients sintetik şəkildə yaradılmışdır. Bundan əlavə, operational-cost coefficients real elektrik istehlakı, güc, enerji tarifi və ya emissiya ölçmələri deyil. Buna görə nəticələr proposed DRO framework-ün sintetik benchmarklar altındakı computational davranışını göstərir; real Industry 4.0 fabrikində eyni xərc və ya enerji qazancının baş verəcəyini sübut etmir.
PFSP-SDST Nədir və Bu Tədqiqatda Hansı Problem Həll Edilir?
PFSP-SDST eyni \(n\) işin eyni \(m\) maşını eyni texnoloji ardıcıllıqla ziyarət etdiyi və maşının yeni işə hazırlanma müddətinin yalnız həmin işdən deyil, dərhal əvvəl hansı işin emal edildiyindən də asılı olduğu kombinator cədvəlləşdirmə problemidir; bu tədqiqatda processing times əlavə olaraq stochastic qəbul edilir və ümumi iş ardıcıllığı TWFT ilə operational cost-u qeyri-müəyyənlik şəraitində birlikdə minimuma endirəcək şəkildə seçilir.
Permutation Flow Shop məntiqi
İş çoxluğu:
\[ J=\{1,\ldots,n\} \]
və maşın çoxluğu:
\[ M=\{1,\ldots,m\} \]
kimi müəyyən edilmişdir.
Hər iş bütün maşınları eyni ardıcıllıqla ziyarət edir. Bundan əlavə, yalnız texnoloji marşrut deyil, işlərin permutasiyası da bütün maşınlarda ortaqdır. Məsələn:
\[ \lambda=[J_3,J_1,J_4,J_2] \]
seçilibsə, bütün maşınlarda işlər bu ümumi ardıcıllığa görə irəliləyir.
Sequence-Dependent Setup Time niyə vacibdir?
Maşının \(J_i\) işindən sonra \(J_j\) işinə keçərkən tələb etdiyi hazırlıq müddəti:
\[ s_{i,j,k} \]
ilə təmsil olunur.
Beləliklə hazırlıq müddəti yalnız hədəf işdən asılı deyil; predecessor–successor cütü və maşın \(k\) birlikdə əhəmiyyətlidir.
Bu hal boya dəyişməsi, qəlib tənzimlənməsi, alət dəyişməsi, təmizləmə və ya məhsul ailəsinin dəyişməsi kimi sənaye keçidlərini modelləşdirə bilər. Mənbə konkret bir fabrik prosesinə aid real setup matrisindən istifadə etmir; idarə olunan sintetik benchmarklar yaradır.
Stochastic processing time necə təmsil olunur?
Job \(j\)-nin machine \(k\)-dakı scenario \(\omega\) processing time-ı:
\[ p^\omega_{j,k} \]
kimi müəyyən edilir.
İş sequence position \(r\)-yə təyin edildikdə position-level processing time:
\[ PT^\omega_{r,k} \]
olur.
Qeyri-müəyyənlik scenario set:
\[ \Omega=\{1,\ldots,S\} \]
vasitəsilə təmsil olunur.
Əsas dəyişənlər
| Simvol | Məna |
|---|---|
| \(n\) | İş sayı |
| \(m\) | Maşın sayı |
| \(\omega\) | Uncertainty scenario indeksi |
| \(\lambda\) | Ümumi job permutation |
| \(x_{j,r}\) | Job \(j\), position \(r\)-yə təyin edilərsə 1 olan binary variable |
| \(y_{i,j,r}\) | Position \(r-1\)-də \(i\), position \(r\)-də \(j\) olduqda 1 olan adjacency variable |
| \(p^\omega_{j,k}\) | Scenario \(\omega\)-da job \(j\)-nin machine \(k\)-dakı processing time-ı |
| \(s^0_{j,k}\) | Job \(j\) üçün initial setup time |
| \(s_{i,j,k}\) | \(i\rightarrow j\) keçidinin sequence-dependent setup time-ı |
| \(ST_{r,k}\) | Position \(r\)-də machine \(k\) setup duration |
| \(A^\omega_{r,k}\) | Setup completion time |
| \(B^\omega_{r,k}\) | Processing start time |
| \(C^\omega_{r,k}\) | Processing completion time |
| \(I^\omega_{r,k}\) | Machine idle time |
| \(w_j\) | Job \(j\)-nin TWFT priority weight-i |
| \(c_k^{run}\) | Machine \(k\) processing unit cost coefficient |
| \(c_k^{setup}\) | Machine \(k\) setup unit cost coefficient |
| \(c_k^{idle}\) | Machine \(k\) idle unit cost coefficient |
| \(\alpha,\beta\) | TWFT və operational-cost çəkiləri |
| \(q_\omega\) | Ambiguity set daxilində scenario probability |
| \(\hat q_\omega\) | Nominal scenario probability; mənbədə uniform \(\hat q_\omega=1/S\) |
| \(\rho\) | KL ambiguity-set robustness radius |
| \(\eta\) | DRO dual reformulation-dakı auxiliary variable |
Tənlik (1): Total Weighted Flow Time
\[ TWFT^\omega= \sum_{r\in R}\sum_{j\in J} w_j x_{j,r} C^\omega_{r,m} \tag{1} \]
Nəyi hesablayır? Hər job-ın son maşındakı completion time-ını job priority weight ilə vurur və cəmini hesablayır.
\(C^\omega_{r,m}\), scenario \(\omega\)-da position \(r\)-dəki işin son maşındakı completion time-ıdır.
\(w_j\) yüksəldikcə müvafiq job-ın gec tamamlanması objective üzərində daha böyük cəza yaradır. Beləliklə təcili və ya yüksək prioritetli işlər optimization daxilində daha çox çəki qazana bilər.
Tənlik (2): Operational Cost
\[ Cost^\omega= \sum_{k\in M} \left[ c_k^{run}\sum_{r\in R}PT^\omega_{r,k} + c_k^{setup}\sum_{r\in R}ST_{r,k} + c_k^{idle}\sum_{r\in R}I^\omega_{r,k} \right] \tag{2} \]
Cost function üç hissədən ibarətdir:
- processing cost,
- sequence-dependent setup cost,
- machine idle cost.
Mənbə mühüm fərq qoyur: sabit scenario üçün ümumi processing time işlərin ardıcıllığından asılı deyil. Buna görə processing-cost termini həmin scenario daxilində qaçılmaz baza xərc kimi davranır. Job sequencing qərarının xərc üzərində əsas təsiri setup və idle komponentlərindən gəlir.
Elmi sərhəd: \(c_k^{run}\), \(c_k^{setup}\) və \(c_k^{idle}\) fiziki enerji ölçmə cihazından götürülmüş dəyərlər deyil. Bu objective real kWh, elektrik hesabı və ya CO₂ emissiyasını hesablamır.
Tənlik (3): Vahid objective
\[ J^\omega= \alpha TWFT^\omega+ \beta Cost^\omega \tag{3} \]
İki məqsəd weighted aggregation ilə vahid objective-a çevrilir.
Computational experiments üçün:
\[ \alpha=\beta=0.5 \]
istifadə edilmişdir.
Lakin mənbə xüsusilə qeyd edir ki, bu seçim TWFT ilə cost-un numerical contribution-larının bərabər olması və ya ümumi decision-maker preference quruluşunu təmsil etməsi demək deyil. İki komponentin miqyası fərqli ola bilər.
DRO, Stochastic Programming və Klassik Robust Optimization-dan Necə Fərqlənir?
Stochastic programming adətən müəyyən probability distribution-ın doğru məlum olduğunu fərz etdiyi halda klassik Robust Optimization ayrı-ayrı parameter realizations-ın uncertainty set daxilində ən pis halına qarşı qoruma təmin edir; bu tədqiqatdakı DRO isə tək paylanma əvəzinə nominal paylanmaya KL divergence baxımından kifayət qədər yaxın olan probability distributions ailəsindəki ən pis gözlənilən objective dəyərini minimuma endirir.
Tənlik (4): Worst-case expected objective
\[ \min J_{DRO} = \min_\lambda \max_{q\in Q_\rho} \sum_{\omega\in\Omega}q_\omega J^\omega \tag{4} \]
Buradakı daxili maximization seçilmiş schedule üçün ambiguity set daxilində ən əlverişsiz probability distribution-ı axtarır.
Xarici minimization isə bu worst-case expected objective-ı mümkün qədər minimuma endirən job permutation-ı seçir.
Tənlik (5): Kullback–Leibler ambiguity set
\[ Q_\rho= \left\{ q\in\mathbb{R}_+^S: \sum_{\omega\in\Omega}q_\omega=1,\; \sum_{\omega\in\Omega} q_\omega \ln\left( \frac{q_\omega}{\hat q_\omega} \right) \le\rho \right\} \tag{5} \]
Birinci şərt probability values cəminin 1 olmasını təmin edir.
İkinci şərt candidate distribution \(q\)-nun nominal distribution \(\hat q\)-dan KL divergence baxımından ən çox \(\rho\) qədər uzaqlaşmasına icazə verir.
Robustness Radius \(\rho\) Nəyə Xidmət Edir?
\(\rho\), ambiguity set-in ölçüsünü idarə edir; daha kiçik \(\rho\) optimization-ı nominal probability distribution-a yaxın saxlayır, daha böyük \(\rho\) isə daha çox mümkün paylanmaya icazə verərək schedule-ı paylanma qeyri-müəyyənliyinə qarşı daha ehtiyatlı edir, lakin bu tədqiqatın bütün hesabatlandırılmış əsas nəticələri yalnız \(\rho=0.05\) şərtinə aiddir.
Buna görə “ALO hər \(\rho\) dəyərində eynidir” və ya “SMA bütün robustness səviyyələrində ən sürətlidir” nəticəsi çıxarıla bilməz.
Tənlik (6): Dual DRO reformulation
\[ J_{DRO} = \min_{\eta>0} \left[ \eta\rho+ \eta\ln \left( \sum_{\omega\in\Omega} \hat q_\omega \exp\left(\frac{J^\omega}{\eta}\right) \right) \right] \tag{6} \]
Bu reformulation, Equation (4)-dəki nested min-max quruluşun inner distribution maximization hissəsini Lagrangian duality istifadə etməklə birqatlı və computational baxımdan daha tətbiqolunan convex expression-a çevirir.
\(\eta\) auxiliary dual variable-dır və hər candidate permutation üçün optimallaşdırılır.
Exact enumeration implementation-da \(\eta\), MATLAB-ın bounded one-dimensional optimizer-i fminbnd ilə optimallaşdırılmışdır.
Equations (7)–(25): Feasibility və zamanlama məhdudiyyətləri
Mənbənin mathematical model-i yalnız objective function-dan ibarət deyil. Job assignment, predecessor–successor əlaqəsi, setup calculation, machine precedence, completion times və variable domains aşağıdakı constraints ilə müəyyən edilir.
\[ \sum_{j\in J}x_{j,r}=1,\qquad \forall r\in R \tag{7} \]
Hər sequence position-a dəqiq bir job təyin edilir.
\[ \sum_{r\in R}x_{j,r}=1,\qquad \forall j\in J \tag{8} \]
Hər job dəqiq bir position-a təyin edilir. Equations (7) və (8) birlikdə etibarlı permutation yaradır.
\[ y_{i,j,r}\le x_{i,r-1} \tag{9} \]
\[ y_{i,j,r}\le x_{j,r} \tag{10} \]
\[ y_{i,j,r}\ge x_{i,r-1}+x_{j,r}-1 \tag{11} \]
Equations (9)–(11), \(y_{i,j,r}\)-nin yalnız job \(i\) əvvəlki position-da və job \(j\) cari position-da olduqda 1 olmasını təmin edən linear adjacency formulation-dır.
\[ ST_{1,k} = \sum_{j\in J}s^0_{j,k}x_{j,1} \tag{12} \]
Birinci position üçün predecessor olmadığından initial setup, ilk seçilmiş job-a əsasən hesablanır.
\[ ST_{r,k} = \sum_{i\in J}\sum_{j\in J} s_{i,j,k}y_{i,j,r}, \qquad r=2,\ldots,n \tag{13} \]
Sonrakı position-larda setup time predecessor–successor cütündən asılıdır.
\[ PT^\omega_{r,k} = \sum_{j\in J} p^\omega_{j,k}x_{j,r} \tag{14} \]
Bu constraint, position \(r\)-yə hansı job təyin edilibsə, onun scenario-dependent processing time-ını position-a daşıyır.
\[ C^\omega_{0,k}=0 \tag{15} \]
\[ C^\omega_{r,0}=0 \tag{16} \]
Scheduling horizon başlanğıcında əvvəlki job və “machine 0” tərəfindəki completion times sıfırlanır.
\[ A^\omega_{r,k} = C^\omega_{r-1,k} + ST_{r,k} \tag{17} \]
Setup completion time eyni maşındakı əvvəlki job completion ilə tələb olunan setup duration-ın cəmidir.
\[ B^\omega_{r,k}\ge A^\omega_{r,k} \tag{18} \]
Processing setup tamamlanmadan başlaya bilməz.
\[ B^\omega_{r,k}\ge C^\omega_{r,k-1} \tag{19} \]
Job əvvəlki maşındakı emalı bitirmədən növbəti maşında başlaya bilməz.
\[ C^\omega_{r,k} = B^\omega_{r,k} + PT^\omega_{r,k} \tag{20} \]
Completion time = processing start + processing duration.
\[ I^\omega_{r,k} = B^\omega_{r,k} - A^\omega_{r,k} \tag{21} \]
Setup hazır olduğu halda processing başlayana qədər keçən fərq machine idle time-dır.
\[ ST_{r,k}\ge0 \tag{22} \]
\[ PT^\omega_{r,k}, A^\omega_{r,k}, B^\omega_{r,k}, C^\omega_{r,k}, I^\omega_{r,k}\ge0 \tag{23} \]
Temporal variables mənfi dəyər ala bilməz.
\[ x_{j,r}\in\{0,1\} \tag{24} \]
\[ y_{i,j,r}\in\{0,1\} \tag{25} \]
Assignment və adjacency variables binary-dir.
İllüstrativ nümunə: 7 iş, 5 maşın
Mənbə DRO məntiqini konkretləşdirmək üçün:
- \(n=7\) job,
- \(m=5\) machine,
- 300 generated processing-time scenarios,
- \(\rho=0.05\),
- \(\alpha=0.5\),
- \(\beta=0.5\)
istifadə edən illustrative instance təqdim edir.
Job weights:
\[ w=[4,2,5,3,1,4,2] \]
İlk izahedici feasible sequence:
\[ \lambda=[J_4,J_1,J_2,J_6,J_3,J_5,J_7] \]
kimi seçilmişdir.
DRO tərəfindən müəyyən edilən optimal robust permutation:
\[ \lambda^*=[J_1,J_3,J_6,J_4,J_7,J_2,J_5] \]
şəklindədir.
Üç representative processing-time scenario
Mənbə 300 generated scenario arasından şərhi asanlaşdırmaq üçün favourable, degraded və variable şəraitləri təmsil edən üç matrix seçir.
\[ PT^1= \begin{bmatrix} 2&17&9&11&14&9&11\\ 4&8&10&10&13&8&6\\ 7&14&8&9&15&7&11\\ 14&7&8&15&5&9&13\\ 11&9&6&9&8&8&10 \end{bmatrix} \]
\[ PT^2= \begin{bmatrix} 6&11&7&14&15&11&11\\ 7&8&12&11&13&8&5\\ 9&15&6&8&14&5&11\\ 15&9&10&14&4&10&12\\ 11&7&7&12&10&9&9 \end{bmatrix} \]
\[ PT^3= \begin{bmatrix} 10&12&10&14&15&9&9\\ 8&7&12&12&12&7&6\\ 9&15&5&12&16&6&11\\ 15&6&14&15&8&11&12\\ 10&8&8&8&7&10&8 \end{bmatrix} \]
Sətirlər maşınları, sütunlar işləri təmsil edir.
GUM Qeyri-müəyyənlik Təhlili DRO-ya Nə Əlavə Edir?
DRO job sequence-i probability-distribution ambiguity şəraitində robust seçdiyi halda GUM təhlili seçilmiş optimal schedule-ın makespan nəticəsinin scenario realizations boyunca nə qədər yayıldığını ayrıca kəmiyyətləndirir; mənbə 300 scenario üçün mean makespan, combined standard uncertainty və \(k=2\) expanded uncertainty hesablayaraq optimal makespan-i \(129.45\pm9.62\) və expanded interval-ı \([119.83,139.07]\) kimi hesabatlandırır.
Tənlik (26): Mean makespan
\[ \overline{C}_{max} = \frac{1}{N} \sum_{\omega=1}^{N} C_{max}(\omega) \tag{26} \]
Burada \(N=300\) generated scenario-dur.
Tənlik (27): Combined standard uncertainty
\[ u_c^2(C_{max}) = \frac{1}{N-1} \sum_{\omega=1}^{N} \left[ C_{max}(\omega)-\overline{C}_{max} \right]^2 \tag{27} \]
Bu ifadə scenario makespan values-ın variance-ını hesablayır. Combined standard uncertainty \(u_c\), variance-ın kvadrat köküdür.
Tənlik (28): Expanded uncertainty
\[ U=k\,u_c \tag{28} \]
Mənbə:
\[ k=2 \]
istifadə edir və bunu təxminən %95 coverage level ilə əlaqələndirir.
Tənlik (29): Makespan nəticəsi
\[ C_{max} = \overline{C}_{max} \pm U \tag{29} \]
Illustrative example üçün:
\[ C_{max}=129.45\pm9.62 \]
və expanded uncertainty interval:
\[ [119.83,\;139.07] \]
kimi verilmişdir.
Optimal DRO permutation ilə manual permutation müqayisəsi
| Scenario | Şərt | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 1406.2 | 546.07 | 976.14 |
| 2 | Degraded | 1612.7 | 558.08 | 1085.4 |
| 3 | Variable | 1787.2 | 586.98 | 1187.1 |
| Scenario | Şərt | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 2262.4 | 557.51 | 1410 |
| 2 | Degraded | 2335.7 | 570.81 | 1453.3 |
| 3 | Variable | 2359.1 | 591.22 | 1475.2 |
Eyni processing-time realizations, setup times, machine cost coefficients və job weights istifadə edildiyinə görə bu illustrative comparison-dakı fərq sequence selection-dan qaynaqlanır.
Source Figures 2–4, favourable, degraded və variable scenarios üçün optimal DRO schedule-ın Gantt charts-ını göstərir. Mənbə təsvirləri machine occupation, setup, idle və job progression-ın scenario dəyişdikcə necə uzandığını göstərir. Exact Gantt bar coordinates rəqəmsal cədvəl şəklində dərc olunmadığından Verianla bu çertyojları saxta dəqiqliklə yenidən yaratmır.
Tədqiqatın Metodu və Nəticələri
Computational experimental framework
| Parametr | Mənbə dəyəri |
|---|---|
| Job sayı | 4–300 |
| Machine sayı | 2–20 |
| \(\mu_P\) | \(U(5,15)\) |
| \(\sigma_P\) | \(U(0.5,2)\) |
| Scenario processing time | \(PT\sim N(\mu_P,\sigma_P^2)\) |
| Search scenario set | \(S_{small}=30\) |
| Final evaluation scenario set | \(S_{large}=300\) |
| Base random seed | 7 |
| Initial setup | \(setup_0\sim U(0.5,2.5)\) |
| Sequence-dependent setup | \(setup_{seq}\sim U(0.5,3.5)\) |
| Job weight | \(w_j\sim U(1,5)\) |
| Processing cost coefficient | \(c_k^{run}\sim U(1,1.5)\) |
| Setup cost coefficient | \(c_k^{setup}\sim U(0.6,1)\) |
| Idle cost coefficient | \(c_k^{idle}\sim U(0.2,0.5)\) |
| TWFT weight | \(\alpha=0.5\) |
| Operational-cost weight | \(\beta=0.5\) |
| Ambiguity radius | \(\rho=0.05\) |
| GRASP RCL parameter | \(\alpha_{RCL}=0.7\) |
| Maximum iterations | 100 |
| Random-Keys population | \(nPop=30\) |
| Independent runs | 50 |
| MATLAB | MATLAB R2021a |
| Exact solver | IBM ILOG CPLEX Optimization Studio 12.10.0 |
| Hardware | ASUS VivoBook X1502VA, 13th Gen Intel Core i9, 16 GB RAM |
\(\alpha_{RCL}\) niyə 0,7-dir?
Mənbə preliminary exploratory tests zamanı:
\[ \alpha_{RCL}\in\{0.3,0.5,0.7\} \]
dəyərlərini araşdırmış və solution quality ilə diversification arasında ən uyğun practical compromise kimi 0,7 dəyərini seçmişdir.
Bu proses systematic hyperparameter optimization kimi təqdim edilmir.
100 iteration bütün alqoritmlərə bərabər computational budget verirmi?
Xeyr. Mənbə bütün iterative algorithms üçün 100 iteration istifadə etsə də müxtəlif alqoritmlərin bir iteration daxilində fərqli sayda DRO objective evaluation edə biləcəyini açıq şəkildə bildirir.
Beləliklə 100 iteration hər üsula eyni computational work verilməsi demək deyil. Buna görə CPU time ayrıca müqayisə edilmişdir.
Exact enumeration necə işləyir?
Small instances üçün CPLEX assignment model hər iteration-da əvvəllər sınaqdan keçirilməmiş feasible permutation yaradır.
Permutation decode edildikdən sonra setup, processing, start/completion və idle variables kənarda hesablanaraq full DRO objective qiymətləndirilir.
Sonra eyni permutation-ın yenidən yaradılmasının qarşısını alan no-good cut əlavə edilir:
\[ \sum_{j\in J}\sum_{r\in R} x^*_{j,r}x_{j,r} \le n-1 \]
Hər feasible permutation dəqiq bir dəfə yaradıldığına görə small instances-da bütün \(n!\) permutations exhaustively qiymətləndirilir.
Mənbə exact procedure-ü ən çox 10 job olan instances ilə məhdudlaşdırmışdır.
GRASP-DRO
GRASP randomised greedy construction istifadə edir.
Initial job priority score:
\[ \phi_j= w_j \sum_{k=1}^{m} \mu P_{j,k} \]
ilə yaradılır.
Candidate solutions arasında Restricted Candidate List:
\[ RCL= \left\{ cand_t: DRO(cand_t) \le J_{min} +\alpha_{RCL}(J_{max}-J_{min}) \right\} \]
kimi müəyyən edilir və RCL daxilindən random candidate seçilir.
HGRASP-DRO
HGRASP dörd əsas komponenti birləşdirir:
- DRO-adapted NEH initialization,
- GRASP constructive search,
- swap-based local search,
- restart/diversification mechanism.
Növbəti iteration başlanğıcında %50 ehtimalla original robust NEH sequence yenidən istifadə olunur; əks halda random swaps ilə başlanğıc ardıcıllığı şaxələndirilir.
ALO-DRO
Ant Lion Optimizer təbii olaraq continuous search space üzərində işlədiyi üçün job permutation yaratmaq məqsədilə Random Keys representation istifadə edilmişdir.
Continuous vector dəyərləri sıralanaraq feasible permutation-a çevrilir. Population search zamanı elite solution qorunur və candidate schedules reduced scenario set vasitəsilə DRO objective ilə qiymətləndirilir.
SMA-DRO
Slime Mold Algorithm da Random Keys representation istifadə edir. Population adaptive weighting ilə update olunur; daha yaxşı solutions daha güclü influence qazanır, exploration itirilməsin deyə zəif solutions da population daxilində rolunu davam etdirir.
Mənbə bütün Random-Keys population settings üçün \(nPop=30\) istifadə etmişdir.
Small-scale exact benchmark nəticələri
| Instance | Exact | Exact CPU | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|---|---|
| 4×2 | 101.02 | 2.35 | 101.02 | 1.61 | 101.02 | 2.74 | 101.02 | 2.38 | 101.02 | 3.12 |
| 4×4 | 200.66 | 1.10 | 200.66 | 0.42 | 200.66 | 0.96 | 200.66 | 1.00 | 200.66 | 0.94 |
| 4×6 | 267.16 | 0.49 | 267.16 | 1.00 | 267.16 | 1.11 | 267.16 | 1.15 | 267.16 | 1.08 |
| 6×2 | 239.2 | 38.61 | 239.2 | 0.85 | 239.2 | 2.49 | 239.2 | 1.25 | 239.2 | 1.13 |
| 6×4 | 338.49 | 38.89 | 338.49 | 0.86 | 338.49 | 2.59 | 338.49 | 1.26 | 338.49 | 1.16 |
| 6×6 | 410.61 | 38.55 | 410.61 | 0.87 | 410.61 | 2.80 | 410.61 | 1.27 | 410.61 | 1.16 |
| 8×2 | 368.39 | 89,964 | 369.62 | 1.31 | 368.39 | 5.22 | 368.39 | 1.27 | 368.39 | 1.13 |
| 8×4 | 562.4 | 130,600 | 588.91 | 1.88 | 562.4 | 7.44 | 562.4 | 1.91 | 562.4 | 1.71 |
| 8×6 | 642.64 | 70,895 | 646.41 | 1.35 | 642.64 | 5.51 | 642.64 | 1.29 | 642.64 | 1.17 |
| 9×4 | 532.67 | 85,640 | 536.15 | 1.33 | 532.67 | 5.99 | 533.62 | 1.09 | 533.62 | 0.97 |
| 10×2 | 509.65 | 108,450 | 517.29 | 4.08 | 509.65 | 19.16 | 509.65 | 2.84 | 509.65 | 2.45 |
HGRASP bütün bu small-scale instances-da exact objective dəyərini yenidən hasil etmişdir.
Exact enumeration isə instance böyüdükcə çox sürətlə computationally expensive olur.
Medium-scale nəticələri
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 10×5 | 798.97 | 1.96 | 785.17 | 10.71 | 788.96 | 1.38 | 785.63 | 1.23 |
| 10×10 | 1413.7 | 2.04 | 1397.1 | 12.71 | 1397.1 | 1.44 | 1397.1 | 1.28 |
| 10×15 | 1932.2 | 2.15 | 1904.9 | 13.13 | 1904.9 | 1.51 | 1904.9 | 1.35 |
| 20×5 | 2674.7 | 7.38 | 2529.7 | 71.17 | 2535.7 | 1.96 | 2535.1 | 1.54 |
| 20×10 | 3679.1 | 26.49 | 3509.4 | 268.03 | 3524.6 | 7.72 | 3526.9 | 5.98 |
| 20×15 | 4339.95 | 7.77 | 4171.08 | 85.54 | 4183.04 | 2.15 | 4184.21 | 1.76 |
| 30×5 | 5078.17 | 13.02 | 4749.6 | 70.83 | 4528.46 | 2.07 | 4564.33 | 1.72 |
| 30×10 | 6352.42 | 14.07 | 6006.96 | 77.82 | 5888.47 | 2.22 | 5895.96 | 1.89 |
| 30×15 | 8242.85 | 15.28 | 8022.30 | 86 | 7876.46 | 2.45 | 7876.79 | 2.10 |
| 40×5 | 8846.77 | 27.5 | 8386.14 | 149.8 | 8016.26 | 4.81 | 7990.32 | 3.49 |
| 40×10 | 10,849.9 | 72.9 | 10,296.85 | 286.6 | 9860.56 | 6.78 | 9864.14 | 5.28 |
| 40×15 | 13,639.6 | 28.28 | 13,111.05 | 105.42 | 12,695.5 | 2.89 | 12,627.73 | 2.26 |
| 50×5 | 12,626.2 | 37.7 | 12,006.1 | 100.72 | 10,170.4 | 2.60 | 10,961.06 | 1.83 |
| 50×10 | 14,524.4 | 145.38 | 13,739.86 | 410.71 | 13,028.1 | 9.61 | 13,079.04 | 7.27 |
| 50×15 | 17,482 | 46 | 16,967 | 128.85 | 16,097 | 3.17 | 15,921 | 2.43 |
| 60×5 | 16,117 | 58.38 | 15,679 | 127.82 | 14,597 | 2.95 | 14,453 | 2.03 |
| 60×10 | 21,687 | 2028.5 | 21,143 | 616.84 | 19,656 | 13.27 | 19,724 | 9.57 |
| 60×15 | 26,425.6 | 70.51 | 26,124.06 | 160.05 | 24,834.7 | 3.48 | 24,842.04 | 2.65 |
| 70×5 | 22,505 | 1162.5 | 21,971 | 643.46 | 20,143 | 12.78 | 20,234 | 8.66 |
| 70×10 | 27,914 | 108.63 | 27,491 | 209.6 | 25,254 | 4.53 | 25,034 | 2.98 |
| 70×15 | 31,230.1 | 181.35 | 30,464.62 | 506.59 | 28,931.51 | 7.07 | 29,210.98 | 5.08 |
| 80×5 | 29,386.5 | 108.58 | 28,444.54 | 185.95 | 26,555.80 | 3.69 | 26,178.90 | 2.24 |
| 80×10 | 36,061.27 | 119.92 | 35,943.01 | 206.51 | 33,641.2 | 3.62 | 33,134.3 | 2.56 |
| 80×15 | 36,972.02 | 252 | 36,608.48 | 399.47 | 34,376.15 | 6.87 | 34,079.12 | 4.81 |
| 90×5 | 36,832.33 | 136.6 | 36,661.97 | 211.89 | 33,847.33 | 3.66 | 34,033.45 | 2.23 |
| 90×10 | 46,181.93 | 298.56 | 45,608.33 | 438.10 | 42,326.87 | 6.26 | 42,919.34 | 4.36 |
| 90×15 | 49,909.87 | 298.67 | 49,594.48 | 486.85 | 46,529.06 | 8.45 | 46,315.51 | 5.97 |
Medium scale böyüdükcə GRASP-ın solution quality-si nisbətən zəifləyir; HGRASP GRASP-ı yaxşılaşdırır, lakin daha böyük medium instances-da ALO və SMA əksər hallarda daha aşağı DRO values yaradır.
Large-scale nəticələri
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 100×10 | 53,070.93 | 217.7 | 52,270.26 | 322.65 | 48,791.98 | 4.49 | 49,201.7 | 3 |
| 100×20 | 64,020.76 | 407.75 | 62,724.74 | 487.28 | 59,460.94 | 7.05 | 59,525.17 | 5.49 |
| 150×10 | 112,800 | 1290.4 | 111,170 | 38,421 | 107,070 | 6.8078 | 106,940 | 4.2935 |
| 150×20 | 133,252 | 1305 | 129,020 | 4540.02 | 124,230 | 7.067 | 120,014 | 4.305 |
| 200×10 | 194,880 | 1477.5 | 194,030 | 5541.4 | 180,940 | 7.2912 | 181,040 | 4.5586 |
| 200×20 | 220,890 | 6762.9 | 218,310 | 12,749 | 203,980 | 10.55 | 210,250 | 7.7775 |
| 250×10 | 294,680 | 6529.8 | 295,280 | 12,448 | 278,100 | 36.944 | 284,340 | 21.774 |
| 250×20 | 326,430 | 17,367 | 321,590 | 53,927 | 306,210 | 56.61 | 305,190 | 41.28 |
| 300×10 | 416,760 | 13,019 | 413,900 | 3824.1 | 393,590 | 10.779 | 393,430 | 6.9293 |
| 300×20 | 466,740 | 8101 | 464,820 | 20,180 | 446,440 | 15.3965 | 442,830 | 11.7650 |
Large scale-da GRASP ümumilikdə ən yüksək objective values yaradır. HGRASP GRASP-ı yaxşılaşdırır, lakin intensiv local search səbəbindən computational time ciddi şəkildə artır.
ALO və SMA böyük problemlərdə açıq şəkildə daha competitive olur. Heç biri hər instance-da digərini keçmir.
Representative 300×20 instance: 50 müstəqil işə salma
| Üsul | Median DRO | Average DRO | Std. Dev. | Best DRO | Maximum DRO | Average CPU |
|---|---|---|---|---|---|---|
| GRASP | 1,010,536.65 | 1,006,974.81 | 7713.28 | Mənbə mətnində bu cümlədə verilməyib | 1,012,263.52 | — |
| HGRASP | 1,002,959.09 | 1,002,307.41 | 5487.10 | 996,523.57 | — | 12,697.84 s |
| ALO | 962,154.30 | 961,918.26 | 3583.37 | — | 965,377.78 | — |
| SMA | 966,327.54 | 964,057.76 | 6827.03 | 956,384.95 | 969,460.79 | 9.16 s |
Mənbə bu representative experiment-da ALO-nu daha aşağı median/average və daha aşağı variability səbəbilə ən robust üsul; SMA-nı isə ən yaxşı individual DRO solution və ən qısa average computational time səbəbilə güclü optimization performer kimi qiymətləndirir.
Figure 6 yalnız representative execution-ın convergence history-sidir; 50 run-ın statistical summary-si deyil. GRASP və HGRASP erkən plato yaradır, ALO və SMA isə daha uzun müddət təkmilləşməyə davam edir. Xam iteration-level series dərc olunmadığından Verianla Figure 6-nı saxta exact curve kimi yenidən yaratmır.
Medium-scale Friedman testi
| Üsul | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 4.000 | 3.074 |
| HGRASP | 2.630 | 3.926 |
| ALO | 1.630 | 2.000 |
| SMA | 1.741 | 1.000 |
Solution quality:
\[ \chi^2=60.115,\qquad df=3,\qquad p=5.56\times10^{-13} \]
Computational time:
\[ \chi^2=78.778,\qquad df=3,\qquad p=5.94\times10^{-17} \]
Bu nəticələr medium-scale algorithms-ın ekvivalent performans göstərdiyi null hypothesis-i rədd edir.
Large-scale Friedman testi
| Üsul | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 3.9 | 3.2 |
| HGRASP | 3.1 | 3.8 |
| ALO | 1.5 | 2.0 |
| SMA | 1.5 | 1.0 |
DRO objective:
\[ \chi^2=25.920,\qquad df=3,\qquad p=9.91\times10^{-6} \]
Computational time:
\[ \chi^2=28.080,\qquad df=3,\qquad p=3.49\times10^{-6} \]
ALO və SMA-dan Hansı Daha Yaxşıdır?
Bu tədqiqatın large-scale nəticələrində solution quality baxımından ALO və SMA-nın Friedman mean rank-i eyni 1,5-dir və Wilcoxon–Holm post-hoc testi aralarında əhəmiyyətli DRO fərqi göstərmir; ALO representative 300×20 işə salmalarında daha aşağı median/average və variability ilə daha robust görünür, SMA isə ən yaxşı individual solution-u və ən yaxşı computational-time rank-i yaradıb, buna görə mənbə hər ölçüdə bir alqoritmi mütləq üstün elan etmir.
Large-scale Wilcoxon–Holm post-hoc nəticələri
| Müqayisə | DRO Raw p | DRO Holm p | DRO | CPU Raw p | CPU Holm p | CPU |
|---|---|---|---|---|---|---|
| GRASP vs HGRASP | 0.003906 | 0.011719 | Əhəmiyyətli | 0.105469 | 0.105469 | Əhəmiyyətli deyil |
| GRASP vs ALO | 0.001953 | 0.011719 | Əhəmiyyətli | 0.001953 | 0.011719 | Əhəmiyyətli |
| GRASP vs SMA | 0.001953 | 0.011719 | Əhəmiyyətli | 0.001953 | 0.011719 | Əhəmiyyətli |
| HGRASP vs ALO | 0.001953 | 0.011719 | Əhəmiyyətli | 0.001953 | 0.011719 | Əhəmiyyətli |
| HGRASP vs SMA | 0.001953 | 0.011719 | Əhəmiyyətli | 0.001953 | 0.011719 | Əhəmiyyətli |
| ALO vs SMA | 1.000000 | 1.000000 | Əhəmiyyətli deyil | 0.001953 | 0.011719 | Əhəmiyyətli |
Solution quality baxımından ALO və ya SMA-dan birinin digərindən üstün olduğunu söyləmək bu test tərəfindən dəstəklənmir.
Computational time baxımından isə ALO–SMA fərqi əhəmiyyətlidir və Friedman ranking SMA-nı daha favorable göstərir.
Tədqiqatın dəstəklədiyi nəticələr
- DRO ilə PFSP-SDST, stochastic processing times və operational cost vahid optimization framework daxilində modelləşdirilə bilər.
- KL-divergence ambiguity set nominal probability distribution ətrafında distributional uncertainty müəyyən etmək üçün istifadə edilmişdir.
- Small instances üçün CPLEX-assisted exhaustive enumeration global optimum benchmark təmin etmişdir.
- HGRASP sınaqdan keçirilən bütün small-scale instances-da exact objective dəyərini yenidən hasil etmişdir.
- Medium və large scale böyüdükcə population-based ALO və SMA daha competitive olmuşdur.
- Large-scale solution quality üçün algorithms arasında Friedman testi əhəmiyyətli fərq göstərmişdir.
- Large-scale CPU time üçün algorithms arasında Friedman testi əhəmiyyətli fərq göstərmişdir.
- ALO və SMA large-scale DRO quality baxımından eyni mean rank almışdır.
- ALO–SMA pairwise DRO fərqi əhəmiyyətli deyil.
- SMA computational-time ranking baxımından ən favorable üsuldur.
- Representative 300×20 instance-da ALO daha aşağı median/average və standard deviation göstərmişdir.
- Eyni representative instance-da SMA ən yaxşı individual DRO solution-u yaratmışdır.
Tədqiqatın dəstəkləmədiyi nəticələr
- Framework real fabrikdə doğrulanmayıb.
- Operational cost real elektrik istehlakı ölçüsü deyil.
- Model CO₂/emission reduction hesablamır.
- \(\rho=0.05\) nəticələrinin başqa ambiguity radii üçün eyni qalacağı göstərilməyib.
- \(\alpha=\beta=0.5\), TWFT ilə cost-un real qərar əhəmiyyətinin və ya numerical scales-ın bərabər olduğunu göstərmir.
- ALO-nun bütün instances-da SMA-dan üstün olduğu göstərilməyib.
- SMA-nın solution quality baxımından ALO-dan statistik olaraq üstün olduğu göstərilməyib.
- Medium və large instances üçün global optimum məlum deyil.
- Sintetik benchmark nəticələri birbaşa commercial Industry 4.0 deployment performansı deyil.
- Parameter tuning exhaustive/systematic deyil.
Əsas məhdudiyyətlər
Sintetik məlumat: Public benchmark olmadığı üçün processing, setup və cost parameters controlled synthetic distributions əsasında yaradılmışdır.
Real sənaye validation-u yoxdur: Konkret production line üzərində sahə sınağı aparılmayıb.
Sabit ambiguity radius: Bütün əsas nəticələr \(\rho=0.05\) şərtindən asılıdır.
Sensitivity analysis yoxdur: Fərqli \(\rho\) dəyərlərində systematic calibration/sensitivity analysis future work kimi saxlanılmışdır.
Fixed algorithm settings: \(\alpha_{RCL}\), iteration limit, population sizes və digər algorithmic settings practical/preliminary seçimlərdir; systematic tuning aparılmayıb.
Bərabər iteration ≠ bərabər budget: Algorithms hər iteration-da fərqli sayda objective evaluation edə bilər.
Operational cost fiziki enerji deyil: Cost coefficients direct power, electricity-price və ya emissions measurements deyil.
Exact method scalability: Exhaustive enumeration combinatorial explosion səbəbindən yalnız small instances üçün tətbiq olunub.
Figure 5/6 əhatəsi: Robustness boxplot və convergence curves representative 300×20 instance-a aiddir; bütün instances üçün təkbaşına ümumiləşdirilə bilməz.
Code availability: MATLAB source code dərc zamanı public deyil.
Gələcək tədqiqatlar
Mənbə aşağıdakı genişləndirmələri təklif edir:
- stochastic setup times,
- machine disruptions,
- fluctuating energy prices,
- real industrial case studies,
- \(\rho\) calibration və sensitivity analysis,
- systematic metaheuristic parameter tuning,
- deterministic scheduling, stochastic programming, conventional DRO və RO ilə geniş comparison,
- fərqli uncertainty distributions altında out-of-sample evaluation,
- production efficiency, real energy consumption və sustainability indicators-ı eyni zamanda nəzərə alan multi-objective DRO.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Distributionally Robust Optimization for Permutation Flow Shop Scheduling with Sequence-Dependent Setup Times and Operational Cost Under Uncertainty in Industry 4.0 Manufacturing Systems.
Müəlliflər: Hafsa Mimouni, Abdelilah Jalid, Said Aqil.
Müəllif sırası: Mənbə PDF-də və rəsmi MDPI qeydindəki sıra qorunub.
Bərabər töhfə: Mənbədə equal-contribution bəyanı yoxdur.
Məsul müəllif: Hafsa Mimouni.
Qurum 1: Mechanical and Thermal Processes and Controls (PCMT) Laboratory, National Graduate School of Arts and Crafts, Mohamed V University, Rabat, Morocco.
Qurum 2: Intelligent Systems, Industrial and Mechanical Engineering (LISIME) Laboratory, National Graduate School of Arts and Crafts, Hassan II University, Casablanca, Morocco.
Jurnal: Sustainability.
Nəşriyyat: MDPI, Basel, Switzerland.
Cild / nömrə: 18(18).
Məqalə nömrəsi: 9278.
Nəşr ili: 2026.
Received: 26 June 2026.
Revised: 1 September 2026.
Accepted: 3 September 2026.
Published: 9 September 2026.
DOI: 10.3390/su18189278.
Mənbə növü: Peer-reviewed computational optimization research article.
Preprint: Mənbədə ayrıca preprint versiyası göstərilmir.
Lisenziya: Creative Commons Attribution (CC BY).
Tədqiqat növü: Sintetik benchmarklara əsaslanan mathematical optimization və computational-comparison tədqiqatı.
Əsas problem: PFSP-SDST with uncertain processing times.
Əsas üsul: Kullback–Leibler divergence ambiguity set istifadə edən Distributionally Robust Optimization.
Əsas məqsədlər: Total Weighted Flow Time və machine-dependent operational cost-un weighted aggregation ilə minimizasiyası.
Exact həll: IBM ILOG CPLEX Optimization Studio 12.10.0 dəstəkli exhaustive enumeration + no-good cuts; small instances, maksimum 10 job.
Approximate methods: GRASP, proposed HGRASP, ALO və SMA.
Proqramlaşdırma mühiti: MATLAB R2021a; CPLEX 12.10.0.
Hardware: ASUS VivoBook X1502VA, 13th Generation Intel Core i9, 16 GB RAM.
Benchmark ölçüsü: 4–300 job, 2–20 machine.
Processing mean: \(\mu_P\sim U(5,15)\).
Processing standard deviation: \(\sigma_P\sim U(0.5,2)\).
Scenario generation: \(PT\sim N(\mu_P,\sigma_P^2)\), lazım olduqda strictly-positive lower bound tətbiq edilir.
Scenario sets: \(S_{small}=30\), \(S_{large}=300\).
Base seed: 7.
Initial setup: \(U(0.5,2.5)\).
Sequence-dependent setup: \(U(0.5,3.5)\).
Job weights: \(U(1,5)\).
Run-cost coefficient: \(U(1,1.5)\).
Setup-cost coefficient: \(U(0.6,1)\).
Idle-cost coefficient: \(U(0.2,0.5)\).
Objective weights: \(\alpha=\beta=0.5\).
Ambiguity radius: \(\rho=0.05\).
GRASP RCL: \(\alpha_{RCL}=0.7\); 0.3, 0.5 və 0.7 preliminary exploratory olaraq araşdırılmışdır.
Iteration limit: 100.
Random-Keys population: 30.
Independent stochastic runs: 50.
Illustrative GUM nəticəsi: \(129.45\pm9.62\), expanded interval \([119.83,139.07]\), \(k=2\).
Medium Friedman — DRO: χ² = 60.115, df = 3, p = 5.56 × 10⁻13.
Medium Friedman — CPU: χ² = 78.778, df = 3, p = 5.94 × 10⁻17.
Large Friedman — DRO: χ² = 25.920, df = 3, p = 9.91 × 10⁻6.
Large Friedman — CPU: χ² = 28.080, df = 3, p = 3.49 × 10⁻6.
Large solution-quality ranking: ALO = 1.5, SMA = 1.5, HGRASP = 3.1, GRASP = 3.9.
Large computational-time ranking: SMA = 1, ALO = 2, GRASP = 3.2, HGRASP = 3.8.
ALO–SMA post-hoc DRO: Holm-adjusted p = 1.000000; əhəmiyyətli fərq yoxdur.
ALO–SMA post-hoc computational time: Holm-adjusted p = 0.011719; əhəmiyyətli fərq var.
Real sahə doğrulaması: Yoxdur; future work kimi təklif edilmişdir.
Real enerji istehlakı: Ölçülməyib. Operational-cost coefficients direct physical energy, electricity price, power və ya emissions deyil.
Funding: External funding yoxdur.
Institutional Review Board: Not applicable.
Informed Consent: Not applicable.
Data Availability: Synthetic datasets və run-level outputs standalone historical files kimi arxivlənməyib; generation procedures, scenario settings, parameter values və seed məqalədə verilib. Synthetic instances/output corresponding author-dan reasonable request ilə yenidən yaradıla/təqdim edilə bilər.
Source code: MATLAB implementation public deyil; ongoing research implementation kimi inkişaf etdirilməyə davam edir.
Conflicts of Interest: Authors declare no conflicts of interest.
Müəllif töhfələri: Conceptualization: H.M., A.J.; methodology: H.M., A.J.; software: H.M.; validation: H.M., A.J., S.A.; formal analysis: H.M.; investigation: H.M.; data curation: H.M.; original draft: H.M.; review/editing: H.M., A.J., S.A.; visualization: H.M.; supervision: A.J., S.A.
Terminologiya qeydi: Tədqiqat əsasən PFSP-SDST ifadəsini istifadə edir; bəzi computational-method paraqraflarında PFSSP/PFSSP-SDST yazılışı görünür. Mənbə bunları ayrı problem sinfi kimi müəyyən etmədiyinə görə Verianla əsas canonical termin olaraq PFSP-SDST-ni qoruyur.
Əsas şərh sərhədi: Bütün comparative computational findings sintetik benchmark conditions, fixed \(\rho=0.05\) və istifadə olunan fixed algorithm settings üçün keçərlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib