


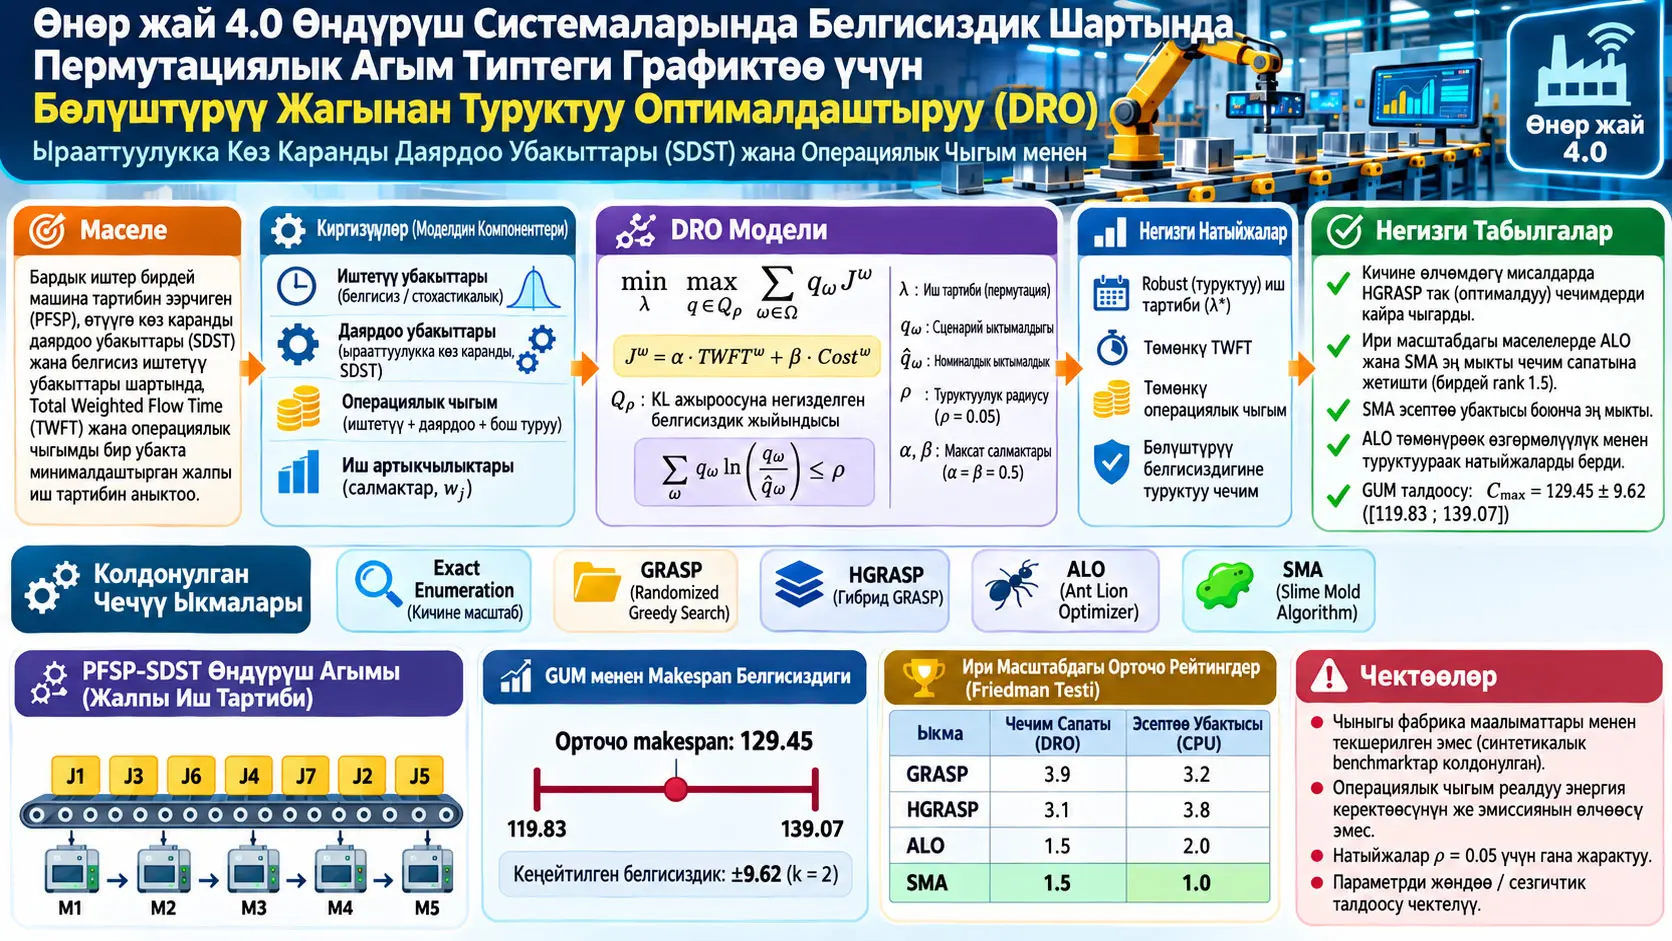
Бөлүштүрүү Жагынан Туруктуу Оптималдаштыруу (Distributionally Robust Optimization, DRO) — белгисиз параметр бир гана так ыктымалдык бөлүштүрүүдөн алынат деп божомолдоонун ордуна, мүмкүн болгон бөлүштүрүүлөрдөн турган ambiguity set ичиндеги эң жагымсыз күтүлгөн натыйжаны эске алып чечим чыгарган оптималдаштыруу ыкмасы. Бул изилдөө DROну бардык иштер машиналарды бирдей тартипте өтө турган Permutation Flow Shop Scheduling Problem түзүлүшүнө, ырааттуулукка көз каранды даярдоо убакыттарына (Sequence-Dependent Setup Times; SDST), белгисиз processing times жана processing/setup/idle убакыттарынан алынган operational cost менен интеграциялайт. Максат — Total Weighted Flow Time (TWFT) менен operational costту салмакталган бирдиктүү максат функциясында чогуу минималдаштырган жалпы иш тартибин аныктоо.
Чыныгы processing-time distribution толук белгилүү эмес деп кабыл алынат; синтетикалык processing scenarios номиналдык бөлүштүрүүнүн айланасында түзүлөт жана мүмкүн болгон scenario probability distributions Kullback–Leibler divergence менен аныкталган ambiguity set ичинде бааланат. Robustness radius \(\rho\) номиналдык бөлүштүрүүдөн канчалык алыстоого уруксат берилерин көзөмөлдөйт. Изилдөөдөгү бардык негизги computational experiments үчүн \(\rho=0.05\) туруктуу коюлган; ошондуктан алынган алгоритм рейтингдери жана robustness натыйжалары башка \(\rho\) маанилери үчүн далилденген эмес.
Кичине масштабдагы маселелер үчүн IBM ILOG CPLEX колдогон exhaustive enumeration ыкмасы менен global-optimum benchmark чечимдер алынган. Medium жана large instances үчүн Greedy Randomized Adaptive Search Procedure (GRASP), изилдөө сунуштаган Hybrid GRASP (HGRASP), Ant Lion Optimizer (ALO) жана Slime Mold Algorithm (SMA) салыштырылган. Кичине мисалдарда HGRASP сыналган бардык exact benchmarkтарды кайра өндүргөн; башка жакындатылган ыкмалар да көпчүлүк учурда exact же өтө жакын натыйжаларга жеткен. Ири масштабдагы маселелерде Friedman тести solution quality жана computational time боюнча алгоритмдердин ортосунда маанилүү айырма бар экенин көрсөткөн. ALO менен SMA solution quality боюнча бирдей эң жакшы mean rank маанисине жетип, post-hoc талдоодо бири-биринен маанилүү айырмаланган эмес; SMA computational time боюнча эң жакшы орунга жеткен.
Изилдөө чыныгы фабрикадан алынган өндүрүш жазуулары менен текшерилген эмес. Processing times, setup times, job weights жана machine cost coefficients синтетикалык түрдө түзүлгөн. Мындан тышкары, operational-cost coefficients чыныгы электр энергиясын керектөө, кубат, энергия тарифи же эмиссия өлчөөлөрү эмес. Ошондуктан натыйжалар proposed DRO frameworkтин синтетикалык benchmarkтардагы computational жүрүм-турумун көрсөтөт; чыныгы Industry 4.0 фабрикасында ошол эле чыгым же энергия үнөмү болот деп далилдебейт.
PFSP-SDST Деген Эмне жана Бул Изилдөөдө Кайсы Маселе Чечилет?
PFSP-SDST — бирдей \(n\) иш бирдей \(m\) машинаны бирдей технологиялык ырааттуулукта өтүүчү жана машинаны жаңы ишке даярдоо убактысы ошол ишке гана эмес, андан мурда кайсы иш аткарылганына да көз каранды болгон комбинатордук график түзүү маселеси; бул изилдөөдө processing times кошумча stochastic деп кабыл алынып, жалпы иш тартиби TWFT менен operational costту белгисиздик шартында чогуу минималдаштыргандай тандалат.
Permutation Flow Shop логикасы
Иштердин жыйындысы:
\[ J=\{1,\ldots,n\} \]
жана машиналардын жыйындысы:
\[ M=\{1,\ldots,m\} \]
деп аныкталган.
Ар бир иш бардык машиналарды бирдей тартипте өтөт. Мындан тышкары, технологиялык маршрут гана эмес, иштердин пермутациясы да бардык машиналарда бирдей. Мисалы:
\[ \lambda=[J_3,J_1,J_4,J_2] \]
тандалса, бардык машиналарда иштер ушул жалпы тартип боюнча жүрөт.
Sequence-Dependent Setup Time эмне үчүн маанилүү?
Машина \(J_i\) ишинен кийин \(J_j\) ишине өткөндө талап кылынган даярдоо убактысы:
\[ s_{i,j,k} \]
менен көрсөтүлөт.
Демек, даярдоо убактысы максаттуу ишке гана байланыштуу эмес; predecessor–successor жуптугу жана машина \(k\) бирге маанилүү.
Бул абал боёкту алмаштыруу, калыпты жөндөө, аспапты алмаштыруу, тазалоо же продукция үй-бүлөсүн алмаштыруу сыяктуу өндүрүштүк өтүүлөрдү моделдей алат. Булак белгилүү бир фабрика процессинин чыныгы setup матрицасын колдонбойт; көзөмөлдөнгөн синтетикалык benchmarkтарды түзөт.
Stochastic processing time кантип көрсөтүлөт?
Job \(j\)нин machine \(k\)дагы scenario \(\omega\) processing timeы:
\[ p^\omega_{j,k} \]
деп аныкталат.
Иш sequence position \(r\)ге дайындалганда position-level processing time:
\[ PT^\omega_{r,k} \]
болот.
Белгисиздик scenario set:
\[ \Omega=\{1,\ldots,S\} \]
аркылуу көрсөтүлөт.
Негизги өзгөрмөлөр
| Белги | Мааниси |
|---|---|
| \(n\) | Иштердин саны |
| \(m\) | Машиналардын саны |
| \(\omega\) | Uncertainty scenario индекси |
| \(\lambda\) | Жалпы job permutation |
| \(x_{j,r}\) | Job \(j\), position \(r\)ге дайындалса 1 болгон binary variable |
| \(y_{i,j,r}\) | Position \(r-1\)де \(i\), position \(r\)де \(j\) болсо 1 болгон adjacency variable |
| \(p^\omega_{j,k}\) | Scenario \(\omega\)да job \(j\)нин machine \(k\)дагы processing timeы |
| \(s^0_{j,k}\) | Job \(j\) үчүн initial setup time |
| \(s_{i,j,k}\) | \(i\rightarrow j\) өтүүсүнүн sequence-dependent setup timeы |
| \(ST_{r,k}\) | Position \(r\)де machine \(k\) setup duration |
| \(A^\omega_{r,k}\) | Setup completion time |
| \(B^\omega_{r,k}\) | Processing start time |
| \(C^\omega_{r,k}\) | Processing completion time |
| \(I^\omega_{r,k}\) | Machine idle time |
| \(w_j\) | Job \(j\)нин TWFT priority weightи |
| \(c_k^{run}\) | Machine \(k\) processing unit cost coefficient |
| \(c_k^{setup}\) | Machine \(k\) setup unit cost coefficient |
| \(c_k^{idle}\) | Machine \(k\) idle unit cost coefficient |
| \(\alpha,\beta\) | TWFT жана operational-cost салмактары |
| \(q_\omega\) | Ambiguity set ичиндеги scenario probability |
| \(\hat q_\omega\) | Nominal scenario probability; булакта uniform \(\hat q_\omega=1/S\) |
| \(\rho\) | KL ambiguity-set robustness radius |
| \(\eta\) | DRO dual reformulationдагы auxiliary variable |
Теңдеме (1): Total Weighted Flow Time
\[ TWFT^\omega= \sum_{r\in R}\sum_{j\in J} w_j x_{j,r} C^\omega_{r,m} \tag{1} \]
Эмнени эсептейт? Ар бир jobдун акыркы машинадагы completion timeын job priority weightке көбөйтүп, алардын суммасын алат.
\(C^\omega_{r,m}\), scenario \(\omega\)да position \(r\)деги иштин акыркы машинадагы completion timeы.
\(w_j\) өскөн сайын тиешелүү jobдун кеч бүтүшү objectiveке чоңураак жаза жаратат. Ошентип шашылыш же жогорку артыкчылыктуу иштер optimization ичинде көбүрөөк салмак ала алат.
Теңдеме (2): Operational Cost
\[ Cost^\omega= \sum_{k\in M} \left[ c_k^{run}\sum_{r\in R}PT^\omega_{r,k} + c_k^{setup}\sum_{r\in R}ST_{r,k} + c_k^{idle}\sum_{r\in R}I^\omega_{r,k} \right] \tag{2} \]
Cost function үч бөлүктөн турат:
- processing cost,
- sequence-dependent setup cost,
- machine idle cost.
Булак маанилүү айырманы белгилейт: туруктуу scenario үчүн жалпы processing time иштердин тартибине көз каранды эмес. Ошондуктан processing-cost термини ошол scenario ичинде сөзсүз базалык чыгым сыяктуу иштейт. Job sequencing чечиминин чыгымга негизги таасири setup жана idle компоненттеринен келип чыгат.
Илимий чек: \(c_k^{run}\), \(c_k^{setup}\) жана \(c_k^{idle}\) физикалык энергия өлчөөчү түзмөктөн алынган маанилер эмес. Бул objective чыныгы kWh, электр эсеби же CO₂ эмиссиясын эсептебейт.
Теңдеме (3): Бириктирилген objective
\[ J^\omega= \alpha TWFT^\omega+ \beta Cost^\omega \tag{3} \]
Эки максат weighted aggregation аркылуу бир objectiveке айландырылат.
Computational experiments үчүн:
\[ \alpha=\beta=0.5 \]
колдонулган.
Бирок булак бул тандоо TWFT менен costтун numerical contributionдары тең экенин же жалпы decision-maker preference түзүлүшүн билдирбесин өзгөчө белгилейт. Эки компоненттин масштабдары ар башка болушу мүмкүн.
DRO, Stochastic Programming жана Классикалык Robust Optimizationдан Кантип Айырмаланат?
Stochastic programming адатта белгилүү probability distribution туура белгилүү деп божомолдосо, классикалык Robust Optimization өзүнчө parameter realizationsдын uncertainty set ичиндеги эң начар абалына каршы коргойт; бул изилдөөдөгү DRO болсо бир гана бөлүштүрүүнүн ордуна номиналдык бөлүштүрүүгө KL divergence боюнча жетиштүү жакын probability distributions үй-бүлөсүндөгү эң начар күтүлгөн objective маанисин минималдаштырат.
Теңдеме (4): Worst-case expected objective
\[ \min J_{DRO} = \min_\lambda \max_{q\in Q_\rho} \sum_{\omega\in\Omega}q_\omega J^\omega \tag{4} \]
Бул жердеги ички maximization тандалган schedule үчүн ambiguity set ичиндеги эң жагымсыз probability distributionды издейт.
Тышкы minimization болсо ушул worst-case expected objectiveти мүмкүн болушунча азайткан job permutationды тандайт.
Теңдеме (5): Kullback–Leibler ambiguity set
\[ Q_\rho= \left\{ q\in\mathbb{R}_+^S: \sum_{\omega\in\Omega}q_\omega=1,\; \sum_{\omega\in\Omega} q_\omega \ln\left( \frac{q_\omega}{\hat q_\omega} \right) \le\rho \right\} \tag{5} \]
Биринчи шарт probability values суммасы 1 болушун камсыздайт.
Экинчи шарт candidate distribution \(q\) номиналдык distribution \(\hat q\)дан KL divergence боюнча эң көп \(\rho\) өлчөмүндө алыстоого уруксат берет.
Robustness Radius \(\rho\) Эмне Үчүн Керек?
\(\rho\) ambiguity setтин өлчөмүн көзөмөлдөйт; кичине \(\rho\) optimizationды номиналдык probability distributionга жакын кармайт, чоңураак \(\rho\) болсо көбүрөөк мүмкүн болгон бөлүштүрүүгө уруксат берип scheduleды бөлүштүрүү белгисиздигине каршы этият кылат, бирок бул изилдөөнүн бардык негизги билдирилген натыйжалары \(\rho=0.05\) шартына гана тиешелүү.
Ошондуктан “ALO ар бир \(\rho\) маанисинде бирдей” же “SMA бардык robustness деңгээлдеринде эң тез” деген тыянак чыгарууга болбойт.
Теңдеме (6): Dual DRO reformulation
\[ J_{DRO} = \min_{\eta>0} \left[ \eta\rho+ \eta\ln \left( \sum_{\omega\in\Omega} \hat q_\omega \exp\left(\frac{J^\omega}{\eta}\right) \right) \right] \tag{6} \]
Бул reformulation Equation (4)төгү nested min-max түзүлүштүн inner distribution maximization бөлүгүн Lagrangian duality колдонуу менен бир катмарлуу жана computational жактан ишке ашырууга ыңгайлуу convex expressionга айландырат.
\(\eta\) auxiliary dual variable болуп, ар бир candidate permutation үчүн оптималдаштырылат.
Exact enumeration implementationда \(\eta\), MATLABтын bounded one-dimensional optimizerи fminbnd менен оптималдаштырылган.
Equations (7)–(25): Feasibility жана убакыттык график чектөөлөрү
Булактын mathematical modelи objective functionдан гана турбайт. Job assignment, predecessor–successor байланышы, setup calculation, machine precedence, completion times жана variable domains төмөнкү constraints менен аныкталат.
\[ \sum_{j\in J}x_{j,r}=1,\qquad \forall r\in R \tag{7} \]
Ар бир sequence positionга так бир job дайындалат.
\[ \sum_{r\in R}x_{j,r}=1,\qquad \forall j\in J \tag{8} \]
Ар бир job так бир positionга дайындалат. Equations (7) жана (8) чогуу жарактуу permutation түзөт.
\[ y_{i,j,r}\le x_{i,r-1} \tag{9} \]
\[ y_{i,j,r}\le x_{j,r} \tag{10} \]
\[ y_{i,j,r}\ge x_{i,r-1}+x_{j,r}-1 \tag{11} \]
Equations (9)–(11), \(y_{i,j,r}\) job \(i\) мурунку positionда жана job \(j\) учурдагы positionда болгондо гана 1 болушун камсыз кылган linear adjacency formulation.
\[ ST_{1,k} = \sum_{j\in J}s^0_{j,k}x_{j,1} \tag{12} \]
Биринчи position үчүн predecessor жок болгондуктан initial setup биринчи тандалган jobго жараша эсептелет.
\[ ST_{r,k} = \sum_{i\in J}\sum_{j\in J} s_{i,j,k}y_{i,j,r}, \qquad r=2,\ldots,n \tag{13} \]
Кийинки positionдарда setup time predecessor–successor жуптугуна көз каранды.
\[ PT^\omega_{r,k} = \sum_{j\in J} p^\omega_{j,k}x_{j,r} \tag{14} \]
Бул constraint position \(r\)ге кайсы job дайындалса, анын scenario-dependent processing timeын positionга өткөрөт.
\[ C^\omega_{0,k}=0 \tag{15} \]
\[ C^\omega_{r,0}=0 \tag{16} \]
Scheduling horizon башында мурунку job жана “machine 0” тарабындагы completion times нөлгө түшүрүлөт.
\[ A^\omega_{r,k} = C^\omega_{r-1,k} + ST_{r,k} \tag{17} \]
Setup completion time ошол эле машинадагы мурунку job completion менен керектүү setup durationдын суммасы.
\[ B^\omega_{r,k}\ge A^\omega_{r,k} \tag{18} \]
Processing setup бүтмөйүнчө баштала албайт.
\[ B^\omega_{r,k}\ge C^\omega_{r,k-1} \tag{19} \]
Job мурунку машинадагы иштетүүнү бүтүрбөй туруп кийинки машинада баштала албайт.
\[ C^\omega_{r,k} = B^\omega_{r,k} + PT^\omega_{r,k} \tag{20} \]
Completion time = processing start + processing duration.
\[ I^\omega_{r,k} = B^\omega_{r,k} - A^\omega_{r,k} \tag{21} \]
Setup даяр болгондон processing башталганга чейинки айырма machine idle time болуп эсептелет.
\[ ST_{r,k}\ge0 \tag{22} \]
\[ PT^\omega_{r,k}, A^\omega_{r,k}, B^\omega_{r,k}, C^\omega_{r,k}, I^\omega_{r,k}\ge0 \tag{23} \]
Temporal variables терс маани ала албайт.
\[ x_{j,r}\in\{0,1\} \tag{24} \]
\[ y_{i,j,r}\in\{0,1\} \tag{25} \]
Assignment жана adjacency variables binary.
Illustrative example: 7 иш, 5 машина
Булак DRO логикасын тактоо үчүн:
- \(n=7\) job,
- \(m=5\) machine,
- 300 generated processing-time scenarios,
- \(\rho=0.05\),
- \(\alpha=0.5\),
- \(\beta=0.5\)
колдонулган illustrative instance берет.
Job weights:
\[ w=[4,2,5,3,1,4,2] \]
Биринчи түшүндүрүүчү feasible sequence:
\[ \lambda=[J_4,J_1,J_2,J_6,J_3,J_5,J_7] \]
деп тандалган.
DRO аныктаган optimal robust permutation:
\[ \lambda^*=[J_1,J_3,J_6,J_4,J_7,J_2,J_5] \]
түрүндө.
Үч representative processing-time scenario
Булак 300 generated scenario ичинен түшүндүрүүнү жеңилдетүү үчүн favourable, degraded жана variable шарттарды чагылдырган үч matrix тандайт.
\[ PT^1= \begin{bmatrix} 2&17&9&11&14&9&11\\ 4&8&10&10&13&8&6\\ 7&14&8&9&15&7&11\\ 14&7&8&15&5&9&13\\ 11&9&6&9&8&8&10 \end{bmatrix} \]
\[ PT^2= \begin{bmatrix} 6&11&7&14&15&11&11\\ 7&8&12&11&13&8&5\\ 9&15&6&8&14&5&11\\ 15&9&10&14&4&10&12\\ 11&7&7&12&10&9&9 \end{bmatrix} \]
\[ PT^3= \begin{bmatrix} 10&12&10&14&15&9&9\\ 8&7&12&12&12&7&6\\ 9&15&5&12&16&6&11\\ 15&6&14&15&8&11&12\\ 10&8&8&8&7&10&8 \end{bmatrix} \]
Саптар машиналарды, мамычалар иштерди көрсөтөт.
GUM Белгисиздик Талдоосу DROго Эмне Кошот?
DRO job sequenceти probability-distribution ambiguity шартында robust тандаса, GUM талдоосу тандалган optimal scheduleдын makespan жыйынтыгы scenario realizations боюнча канчалык таралганын өзүнчө сандык баалайт; булак 300 scenario үчүн mean makespan, combined standard uncertainty жана \(k=2\) expanded uncertainty эсептеп, optimal makespanды \(129.45\pm9.62\) жана expanded intervalды \([119.83,139.07]\) деп билдирет.
Теңдеме (26): Mean makespan
\[ \overline{C}_{max} = \frac{1}{N} \sum_{\omega=1}^{N} C_{max}(\omega) \tag{26} \]
Бул жерде \(N=300\) generated scenario.
Теңдеме (27): Combined standard uncertainty
\[ u_c^2(C_{max}) = \frac{1}{N-1} \sum_{\omega=1}^{N} \left[ C_{max}(\omega)-\overline{C}_{max} \right]^2 \tag{27} \]
Бул туюнтма scenario makespan valuesдын varianceын эсептейт. Combined standard uncertainty \(u_c\), varianceтын квадраттык тамыры.
Теңдеме (28): Expanded uncertainty
\[ U=k\,u_c \tag{28} \]
Булак:
\[ k=2 \]
колдонот жана муну болжол менен %95 coverage level менен байланыштырат.
Теңдеме (29): Makespan натыйжасы
\[ C_{max} = \overline{C}_{max} \pm U \tag{29} \]
Illustrative example үчүн:
\[ C_{max}=129.45\pm9.62 \]
жана expanded uncertainty interval:
\[ [119.83,\;139.07] \]
деп берилген.
Optimal DRO permutation менен manual permutation салыштыруу
| Scenario | Шарт | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 1406.2 | 546.07 | 976.14 |
| 2 | Degraded | 1612.7 | 558.08 | 1085.4 |
| 3 | Variable | 1787.2 | 586.98 | 1187.1 |
| Scenario | Шарт | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 2262.4 | 557.51 | 1410 |
| 2 | Degraded | 2335.7 | 570.81 | 1453.3 |
| 3 | Variable | 2359.1 | 591.22 | 1475.2 |
Бир эле processing-time realizations, setup times, machine cost coefficients жана job weights колдонулгандыктан бул illustrative comparisonдагы айырма sequence selectionдан келип чыгат.
Source Figures 2–4 favourable, degraded жана variable scenarios үчүн optimal DRO scheduleдын Gantt chartsын көрсөтөт. Булак сүрөттөрү machine occupation, setup, idle жана job progression scenario өзгөргөн сайын кантип узарарын көрсөтөт. Exact Gantt bar coordinates сандык таблица түрүндө жарыяланбагандыктан Verianla бул чиймелерди жасалма тактык менен кайра түзбөйт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Computational experimental framework
| Параметр | Булактагы маани |
|---|---|
| Job саны | 4–300 |
| Machine саны | 2–20 |
| \(\mu_P\) | \(U(5,15)\) |
| \(\sigma_P\) | \(U(0.5,2)\) |
| Scenario processing time | \(PT\sim N(\mu_P,\sigma_P^2)\) |
| Search scenario set | \(S_{small}=30\) |
| Final evaluation scenario set | \(S_{large}=300\) |
| Base random seed | 7 |
| Initial setup | \(setup_0\sim U(0.5,2.5)\) |
| Sequence-dependent setup | \(setup_{seq}\sim U(0.5,3.5)\) |
| Job weight | \(w_j\sim U(1,5)\) |
| Processing cost coefficient | \(c_k^{run}\sim U(1,1.5)\) |
| Setup cost coefficient | \(c_k^{setup}\sim U(0.6,1)\) |
| Idle cost coefficient | \(c_k^{idle}\sim U(0.2,0.5)\) |
| TWFT weight | \(\alpha=0.5\) |
| Operational-cost weight | \(\beta=0.5\) |
| Ambiguity radius | \(\rho=0.05\) |
| GRASP RCL parameter | \(\alpha_{RCL}=0.7\) |
| Maximum iterations | 100 |
| Random-Keys population | \(nPop=30\) |
| Independent runs | 50 |
| MATLAB | MATLAB R2021a |
| Exact solver | IBM ILOG CPLEX Optimization Studio 12.10.0 |
| Hardware | ASUS VivoBook X1502VA, 13th Gen Intel Core i9, 16 GB RAM |
\(\alpha_{RCL}\) эмне үчүн 0,7?
Булак preliminary exploratory tests учурунда:
\[ \alpha_{RCL}\in\{0.3,0.5,0.7\} \]
маанилерин карап, solution quality менен diversification ортосундагы эң ылайыктуу practical compromise катары 0,7 маанисин тандаган.
Бул процесс systematic hyperparameter optimization катары берилбейт.
100 iteration бардык алгоритмдерге бирдей computational budget береби?
Жок. Булак бардык iterative algorithms үчүн 100 iteration колдонгону менен, ар башка алгоритмдер бир iteration ичинде ар башка санда DRO objective evaluation аткарышы мүмкүн экенин ачык белгилейт.
Демек, 100 iteration ар бир ыкмага бирдей computational work берилгенин билдирбейт. Ошондуктан CPU time өзүнчө салыштырылган.
Exact enumeration кантип иштейт?
Small instances үчүн CPLEX assignment model ар бир iterationда мурда сыналбаган feasible permutation чыгарат.
Permutation decode болгондон кийин setup, processing, start/completion жана idle variables сыртта эсептелип full DRO objective бааланат.
Андан соң ошол эле permutation кайра чыгарылышына жол бербеген no-good cut кошулат:
\[ \sum_{j\in J}\sum_{r\in R} x^*_{j,r}x_{j,r} \le n-1 \]
Ар бир feasible permutation так бир жолу чыгарылгандыктан small instancesда бардык \(n!\) permutations exhaustively бааланат.
Булак exact procedureну эң көп 10 job камтыган instances менен чектеген.
GRASP-DRO
GRASP randomised greedy construction колдонот.
Initial job priority score:
\[ \phi_j= w_j \sum_{k=1}^{m} \mu P_{j,k} \]
менен түзүлөт.
Candidate solutions арасында Restricted Candidate List:
\[ RCL= \left\{ cand_t: DRO(cand_t) \le J_{min} +\alpha_{RCL}(J_{max}-J_{min}) \right\} \]
деп аныкталып, RCL ичинен random candidate тандалат.
HGRASP-DRO
HGRASP төрт негизги компонентти бириктирет:
- DRO-adapted NEH initialization,
- GRASP constructive search,
- swap-based local search,
- restart/diversification mechanism.
Кийинки iteration башында %50 ыктымалдык менен original robust NEH sequence кайра колдонулат; башка учурда random swaps менен баштапкы тартип ар түрдүүлөнөт.
ALO-DRO
Ant Lion Optimizer табигый түрдө continuous search spaceте иштегендиктен job permutation түзүү үчүн Random Keys representation колдонулган.
Continuous vector маанилери иреттелип feasible permutationга айландырылат. Population search учурунда elite solution сакталат жана candidate schedules reduced scenario set аркылуу DRO objective менен бааланат.
SMA-DRO
Slime Mold Algorithm да Random Keys representation колдонот. Population adaptive weighting менен update болот; жакшыраак solutions күчтүүрөөк influence алат, exploration жоголбошу үчүн начар solutions да population ичинде ролун сактайт.
Булак бардык Random-Keys population settings үчүн \(nPop=30\) колдонгон.
Small-scale exact benchmark жыйынтыктары
| Instance | Exact | Exact CPU | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|---|---|
| 4×2 | 101.02 | 2.35 | 101.02 | 1.61 | 101.02 | 2.74 | 101.02 | 2.38 | 101.02 | 3.12 |
| 4×4 | 200.66 | 1.10 | 200.66 | 0.42 | 200.66 | 0.96 | 200.66 | 1.00 | 200.66 | 0.94 |
| 4×6 | 267.16 | 0.49 | 267.16 | 1.00 | 267.16 | 1.11 | 267.16 | 1.15 | 267.16 | 1.08 |
| 6×2 | 239.2 | 38.61 | 239.2 | 0.85 | 239.2 | 2.49 | 239.2 | 1.25 | 239.2 | 1.13 |
| 6×4 | 338.49 | 38.89 | 338.49 | 0.86 | 338.49 | 2.59 | 338.49 | 1.26 | 338.49 | 1.16 |
| 6×6 | 410.61 | 38.55 | 410.61 | 0.87 | 410.61 | 2.80 | 410.61 | 1.27 | 410.61 | 1.16 |
| 8×2 | 368.39 | 89,964 | 369.62 | 1.31 | 368.39 | 5.22 | 368.39 | 1.27 | 368.39 | 1.13 |
| 8×4 | 562.4 | 130,600 | 588.91 | 1.88 | 562.4 | 7.44 | 562.4 | 1.91 | 562.4 | 1.71 |
| 8×6 | 642.64 | 70,895 | 646.41 | 1.35 | 642.64 | 5.51 | 642.64 | 1.29 | 642.64 | 1.17 |
| 9×4 | 532.67 | 85,640 | 536.15 | 1.33 | 532.67 | 5.99 | 533.62 | 1.09 | 533.62 | 0.97 |
| 10×2 | 509.65 | 108,450 | 517.29 | 4.08 | 509.65 | 19.16 | 509.65 | 2.84 | 509.65 | 2.45 |
HGRASP ушул small-scale instancesдын баарында exact objective маанисин кайра өндүргөн.
Exact enumeration болсо instance чоңойгон сайын өтө тез computationally expensive болуп калат.
Medium-scale жыйынтыктары
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 10×5 | 798.97 | 1.96 | 785.17 | 10.71 | 788.96 | 1.38 | 785.63 | 1.23 |
| 10×10 | 1413.7 | 2.04 | 1397.1 | 12.71 | 1397.1 | 1.44 | 1397.1 | 1.28 |
| 10×15 | 1932.2 | 2.15 | 1904.9 | 13.13 | 1904.9 | 1.51 | 1904.9 | 1.35 |
| 20×5 | 2674.7 | 7.38 | 2529.7 | 71.17 | 2535.7 | 1.96 | 2535.1 | 1.54 |
| 20×10 | 3679.1 | 26.49 | 3509.4 | 268.03 | 3524.6 | 7.72 | 3526.9 | 5.98 |
| 20×15 | 4339.95 | 7.77 | 4171.08 | 85.54 | 4183.04 | 2.15 | 4184.21 | 1.76 |
| 30×5 | 5078.17 | 13.02 | 4749.6 | 70.83 | 4528.46 | 2.07 | 4564.33 | 1.72 |
| 30×10 | 6352.42 | 14.07 | 6006.96 | 77.82 | 5888.47 | 2.22 | 5895.96 | 1.89 |
| 30×15 | 8242.85 | 15.28 | 8022.30 | 86 | 7876.46 | 2.45 | 7876.79 | 2.10 |
| 40×5 | 8846.77 | 27.5 | 8386.14 | 149.8 | 8016.26 | 4.81 | 7990.32 | 3.49 |
| 40×10 | 10,849.9 | 72.9 | 10,296.85 | 286.6 | 9860.56 | 6.78 | 9864.14 | 5.28 |
| 40×15 | 13,639.6 | 28.28 | 13,111.05 | 105.42 | 12,695.5 | 2.89 | 12,627.73 | 2.26 |
| 50×5 | 12,626.2 | 37.7 | 12,006.1 | 100.72 | 10,170.4 | 2.60 | 10,961.06 | 1.83 |
| 50×10 | 14,524.4 | 145.38 | 13,739.86 | 410.71 | 13,028.1 | 9.61 | 13,079.04 | 7.27 |
| 50×15 | 17,482 | 46 | 16,967 | 128.85 | 16,097 | 3.17 | 15,921 | 2.43 |
| 60×5 | 16,117 | 58.38 | 15,679 | 127.82 | 14,597 | 2.95 | 14,453 | 2.03 |
| 60×10 | 21,687 | 2028.5 | 21,143 | 616.84 | 19,656 | 13.27 | 19,724 | 9.57 |
| 60×15 | 26,425.6 | 70.51 | 26,124.06 | 160.05 | 24,834.7 | 3.48 | 24,842.04 | 2.65 |
| 70×5 | 22,505 | 1162.5 | 21,971 | 643.46 | 20,143 | 12.78 | 20,234 | 8.66 |
| 70×10 | 27,914 | 108.63 | 27,491 | 209.6 | 25,254 | 4.53 | 25,034 | 2.98 |
| 70×15 | 31,230.1 | 181.35 | 30,464.62 | 506.59 | 28,931.51 | 7.07 | 29,210.98 | 5.08 |
| 80×5 | 29,386.5 | 108.58 | 28,444.54 | 185.95 | 26,555.80 | 3.69 | 26,178.90 | 2.24 |
| 80×10 | 36,061.27 | 119.92 | 35,943.01 | 206.51 | 33,641.2 | 3.62 | 33,134.3 | 2.56 |
| 80×15 | 36,972.02 | 252 | 36,608.48 | 399.47 | 34,376.15 | 6.87 | 34,079.12 | 4.81 |
| 90×5 | 36,832.33 | 136.6 | 36,661.97 | 211.89 | 33,847.33 | 3.66 | 34,033.45 | 2.23 |
| 90×10 | 46,181.93 | 298.56 | 45,608.33 | 438.10 | 42,326.87 | 6.26 | 42,919.34 | 4.36 |
| 90×15 | 49,909.87 | 298.67 | 49,594.48 | 486.85 | 46,529.06 | 8.45 | 46,315.51 | 5.97 |
Medium scale чоңойгон сайын GRASPтын solution qualityси салыштырмалуу начарлайт; HGRASP GRASPты жакшыртат, бирок чоңураак medium instancesда ALO жана SMA көбүнчө төмөн DRO values чыгарат.
Large-scale жыйынтыктары
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 100×10 | 53,070.93 | 217.7 | 52,270.26 | 322.65 | 48,791.98 | 4.49 | 49,201.7 | 3 |
| 100×20 | 64,020.76 | 407.75 | 62,724.74 | 487.28 | 59,460.94 | 7.05 | 59,525.17 | 5.49 |
| 150×10 | 112,800 | 1290.4 | 111,170 | 38,421 | 107,070 | 6.8078 | 106,940 | 4.2935 |
| 150×20 | 133,252 | 1305 | 129,020 | 4540.02 | 124,230 | 7.067 | 120,014 | 4.305 |
| 200×10 | 194,880 | 1477.5 | 194,030 | 5541.4 | 180,940 | 7.2912 | 181,040 | 4.5586 |
| 200×20 | 220,890 | 6762.9 | 218,310 | 12,749 | 203,980 | 10.55 | 210,250 | 7.7775 |
| 250×10 | 294,680 | 6529.8 | 295,280 | 12,448 | 278,100 | 36.944 | 284,340 | 21.774 |
| 250×20 | 326,430 | 17,367 | 321,590 | 53,927 | 306,210 | 56.61 | 305,190 | 41.28 |
| 300×10 | 416,760 | 13,019 | 413,900 | 3824.1 | 393,590 | 10.779 | 393,430 | 6.9293 |
| 300×20 | 466,740 | 8101 | 464,820 | 20,180 | 446,440 | 15.3965 | 442,830 | 11.7650 |
Large scaleда GRASP жалпысынан эң жогорку objective values чыгарат. HGRASP GRASPты жакшыртат, бирок интенсивдүү local search себептүү computational time олуттуу өсөт.
ALO жана SMA чоң маселелерде ачык түрдө көбүрөөк competitive болуп калат. Алардын эч бири ар бир instanceда экинчисинен ашып кетпейт.
Representative 300×20 instance: 50 көз карандысыз иштетүү
| Ыкма | Median DRO | Average DRO | Std. Dev. | Best DRO | Maximum DRO | Average CPU |
|---|---|---|---|---|---|---|
| GRASP | 1,010,536.65 | 1,006,974.81 | 7713.28 | Булак текстинде бул сүйлөмдө берилген эмес | 1,012,263.52 | — |
| HGRASP | 1,002,959.09 | 1,002,307.41 | 5487.10 | 996,523.57 | — | 12,697.84 s |
| ALO | 962,154.30 | 961,918.26 | 3583.37 | — | 965,377.78 | — |
| SMA | 966,327.54 | 964,057.76 | 6827.03 | 956,384.95 | 969,460.79 | 9.16 s |
Булак бул representative experimentте ALOну төмөн median/average жана төмөн variability себептүү эң robust ыкма; SMAны болсо эң жакшы individual DRO solution жана эң кыска average computational time себептүү күчтүү optimization performer деп баалайт.
Figure 6 representative executionдун convergence historyси гана; 50 runдын statistical summaryси эмес. GRASP жана HGRASP эрте платого жетет, ALO жана SMA болсо узагыраак жакшыртууну улантат. Чийки iteration-level series жарыяланбагандыктан Verianla Figure 6 сүрөтүн жасалма exact curve катары кайра түзбөйт.
Medium-scale Friedman тести
| Ыкма | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 4.000 | 3.074 |
| HGRASP | 2.630 | 3.926 |
| ALO | 1.630 | 2.000 |
| SMA | 1.741 | 1.000 |
Solution quality:
\[ \chi^2=60.115,\qquad df=3,\qquad p=5.56\times10^{-13} \]
Computational time:
\[ \chi^2=78.778,\qquad df=3,\qquad p=5.94\times10^{-17} \]
Бул натыйжалар medium-scale algorithms бирдей performance көрсөтөт деген null hypothesisти четке кагат.
Large-scale Friedman тести
| Ыкма | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 3.9 | 3.2 |
| HGRASP | 3.1 | 3.8 |
| ALO | 1.5 | 2.0 |
| SMA | 1.5 | 1.0 |
DRO objective:
\[ \chi^2=25.920,\qquad df=3,\qquad p=9.91\times10^{-6} \]
Computational time:
\[ \chi^2=28.080,\qquad df=3,\qquad p=3.49\times10^{-6} \]
ALO менен SMAнын Кайсынысы Жакшыраак?
Бул изилдөөнүн large-scale натыйжаларында solution quality боюнча ALO жана SMAнын Friedman mean rankи бирдей 1,5 жана Wilcoxon–Holm post-hoc тести алардын ортосунда маанилүү DRO айырмасын көрсөтпөйт; ALO representative 300×20 иштетүүлөрүндө төмөн median/average жана variability менен robustураак көрүнсө, SMA эң жакшы individual solutionду жана эң жакшы computational-time rankти чыгарган, ошондуктан булак бир алгоритмди бардык критерийлер боюнча абсолюттук үстөм деп жарыялабайт.
Large-scale Wilcoxon–Holm post-hoc жыйынтыктары
| Салыштыруу | DRO Raw p | DRO Holm p | DRO | CPU Raw p | CPU Holm p | CPU |
|---|---|---|---|---|---|---|
| GRASP vs HGRASP | 0.003906 | 0.011719 | Маанилүү | 0.105469 | 0.105469 | Маанилүү эмес |
| GRASP vs ALO | 0.001953 | 0.011719 | Маанилүү | 0.001953 | 0.011719 | Маанилүү |
| GRASP vs SMA | 0.001953 | 0.011719 | Маанилүү | 0.001953 | 0.011719 | Маанилүү |
| HGRASP vs ALO | 0.001953 | 0.011719 | Маанилүү | 0.001953 | 0.011719 | Маанилүү |
| HGRASP vs SMA | 0.001953 | 0.011719 | Маанилүү | 0.001953 | 0.011719 | Маанилүү |
| ALO vs SMA | 1.000000 | 1.000000 | Маанилүү эмес | 0.001953 | 0.011719 | Маанилүү |
Solution quality боюнча ALO же SMAнын бирин экинчисинен үстөм деп айтуу бул тест менен колдоого алынбайт.
Computational time боюнча болсо ALO–SMA айырмасы маанилүү жана Friedman ranking SMAны көбүрөөк favorable көрсөтөт.
Изилдөө колдогон жыйынтыктар
- DRO менен PFSP-SDST, stochastic processing times жана operational cost бир optimization framework ичинде моделдениши мүмкүн.
- KL-divergence ambiguity set номиналдык probability distribution айланасында distributional uncertainty аныктоо үчүн колдонулган.
- Small instances үчүн CPLEX-assisted exhaustive enumeration global optimum benchmark камсыз кылган.
- HGRASP сыналган бардык small-scale instancesда exact objective маанисин кайра өндүргөн.
- Medium жана large scale чоңойгон сайын population-based ALO жана SMA көбүрөөк competitive болгон.
- Large-scale solution quality үчүн algorithms арасында Friedman тести маанилүү айырма көрсөткөн.
- Large-scale CPU time үчүн algorithms арасында Friedman тести маанилүү айырма көрсөткөн.
- ALO жана SMA large-scale DRO quality боюнча бирдей mean rank алган.
- ALO–SMA pairwise DRO айырмасы маанилүү эмес.
- SMA computational-time ranking боюнча эң favorable ыкма.
- Representative 300×20 instanceда ALO төмөн median/average жана standard deviation көрсөткөн.
- Ошол representative instanceда SMA эң жакшы individual DRO solutionду чыгарган.
Изилдөө колдобогон жыйынтыктар
- Framework чыныгы фабрикада текшерилген эмес.
- Operational cost чыныгы электр энергиясын керектөө өлчөмү эмес.
- Модель CO₂/emission reduction эсептебейт.
- \(\rho=0.05\) натыйжалары башка ambiguity radii үчүн да ошол бойдон каларын көрсөткөн эмес.
- \(\alpha=\beta=0.5\), TWFT менен costтун чыныгы чечим маанилүүлүгү же numerical scales тең экенин көрсөтпөйт.
- ALO бардык instancesда SMAдан үстөм экени көрсөтүлгөн эмес.
- SMA solution quality боюнча ALOдон статистикалык жактан үстөм экени көрсөтүлгөн эмес.
- Medium жана large instances үчүн global optimum белгисиз.
- Синтетикалык benchmark натыйжалары түздөн-түз commercial Industry 4.0 deployment performance эмес.
- Parameter tuning exhaustive/systematic эмес.
Негизги чектөөлөр
Синтетикалык маалымат: Public benchmark жок болгондуктан processing, setup жана cost parameters controlled synthetic distributions аркылуу түзүлгөн.
Чыныгы өнөр жай validation жок: Белгилүү production lineда талаа сыноосу жүргүзүлгөн эмес.
Туруктуу ambiguity radius: Бардык негизги натыйжалар \(\rho=0.05\) шартына көз каранды.
Sensitivity analysis жок: Ар башка \(\rho\) маанилериндеги systematic calibration/sensitivity analysis future work катары калтырылган.
Fixed algorithm settings: \(\alpha_{RCL}\), iteration limit, population sizes жана башка algorithmic settings practical/preliminary тандоолор; systematic tuning жүргүзүлгөн эмес.
Бирдей iteration ≠ бирдей budget: Algorithms ар iterationда ар башка санда objective evaluation аткара алат.
Operational cost физикалык энергия эмес: Cost coefficients direct power, electricity-price же emissions measurements эмес.
Exact method scalability: Exhaustive enumeration combinatorial explosion себептүү small instances үчүн гана колдонулган.
Figure 5/6 камтуусу: Robustness boxplot жана convergence curves representative 300×20 instanceга тиешелүү; бардык instances үчүн өз алдынча жалпылоого болбойт.
Code availability: MATLAB source code жарыяланган учурда public эмес.
Келечектеги изилдөөлөр
Булак төмөнкү кеңейтүүлөрдү сунуштайт:
- stochastic setup times,
- machine disruptions,
- fluctuating energy prices,
- чыныгы industrial case studies,
- \(\rho\) calibration жана sensitivity analysis,
- systematic metaheuristic parameter tuning,
- deterministic scheduling, stochastic programming, conventional DRO жана RO менен кеңири comparison,
- ар башка uncertainty distributions шартында out-of-sample evaluation,
- production efficiency, чыныгы energy consumption жана sustainability indicatorsди бир убакта караган multi-objective DRO.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска изилдөө: Distributionally Robust Optimization for Permutation Flow Shop Scheduling with Sequence-Dependent Setup Times and Operational Cost Under Uncertainty in Industry 4.0 Manufacturing Systems.
Авторлор: Hafsa Mimouni, Abdelilah Jalid, Said Aqil.
Авторлордун тартиби: Булак PDFдеги жана расмий MDPI жазуусундагы тартип сакталган.
Тең салым: Булакта equal-contribution билдирүүсү жок.
Жооптуу автор: Hafsa Mimouni.
Мекеме 1: Mechanical and Thermal Processes and Controls (PCMT) Laboratory, National Graduate School of Arts and Crafts, Mohamed V University, Rabat, Morocco.
Мекеме 2: Intelligent Systems, Industrial and Mechanical Engineering (LISIME) Laboratory, National Graduate School of Arts and Crafts, Hassan II University, Casablanca, Morocco.
Журнал: Sustainability.
Басмачы: MDPI, Basel, Switzerland.
Том / сан: 18(18).
Макала номери: 9278.
Жарыяланган жылы: 2026.
Received: 26 June 2026.
Revised: 1 September 2026.
Accepted: 3 September 2026.
Published: 9 September 2026.
DOI: 10.3390/su18189278.
Булактын түрү: Peer-reviewed computational optimization research article.
Preprint: Булакта өзүнчө preprint версиясы көрсөтүлгөн эмес.
Лицензия: Creative Commons Attribution (CC BY).
Изилдөө түрү: Синтетикалык benchmarkтарга негизделген mathematical optimization жана computational-comparison изилдөөсү.
Негизги маселе: PFSP-SDST with uncertain processing times.
Негизги ыкма: Kullback–Leibler divergence ambiguity set колдонгон Distributionally Robust Optimization.
Негизги максаттар: Total Weighted Flow Time жана machine-dependent operational costту weighted aggregation аркылуу минималдаштыруу.
Exact чечим: IBM ILOG CPLEX Optimization Studio 12.10.0 колдогон exhaustive enumeration + no-good cuts; small instances, эң көп 10 job.
Approximate methods: GRASP, proposed HGRASP, ALO жана SMA.
Программалоо чөйрөсү: MATLAB R2021a; CPLEX 12.10.0.
Hardware: ASUS VivoBook X1502VA, 13th Generation Intel Core i9, 16 GB RAM.
Benchmark өлчөмү: 4–300 job, 2–20 machine.
Processing mean: \(\mu_P\sim U(5,15)\).
Processing standard deviation: \(\sigma_P\sim U(0.5,2)\).
Scenario generation: \(PT\sim N(\mu_P,\sigma_P^2)\), зарыл болсо strictly-positive lower bound колдонулат.
Scenario sets: \(S_{small}=30\), \(S_{large}=300\).
Base seed: 7.
Initial setup: \(U(0.5,2.5)\).
Sequence-dependent setup: \(U(0.5,3.5)\).
Job weights: \(U(1,5)\).
Run-cost coefficient: \(U(1,1.5)\).
Setup-cost coefficient: \(U(0.6,1)\).
Idle-cost coefficient: \(U(0.2,0.5)\).
Objective weights: \(\alpha=\beta=0.5\).
Ambiguity radius: \(\rho=0.05\).
GRASP RCL: \(\alpha_{RCL}=0.7\); 0.3, 0.5 жана 0.7 preliminary exploratory түрдө каралган.
Iteration limit: 100.
Random-Keys population: 30.
Independent stochastic runs: 50.
Illustrative GUM натыйжасы: \(129.45\pm9.62\), expanded interval \([119.83,139.07]\), \(k=2\).
Medium Friedman — DRO: χ² = 60.115, df = 3, p = 5.56 × 10⁻13.
Medium Friedman — CPU: χ² = 78.778, df = 3, p = 5.94 × 10⁻17.
Large Friedman — DRO: χ² = 25.920, df = 3, p = 9.91 × 10⁻6.
Large Friedman — CPU: χ² = 28.080, df = 3, p = 3.49 × 10⁻6.
Large solution-quality ranking: ALO = 1.5, SMA = 1.5, HGRASP = 3.1, GRASP = 3.9.
Large computational-time ranking: SMA = 1, ALO = 2, GRASP = 3.2, HGRASP = 3.8.
ALO–SMA post-hoc DRO: Holm-adjusted p = 1.000000; маанилүү айырма жок.
ALO–SMA post-hoc computational time: Holm-adjusted p = 0.011719; маанилүү айырма бар.
Чыныгы талаа текшерүүсү: Жок; future work катары сунушталган.
Чыныгы энергия керектөөсү: Өлчөнгөн эмес. Operational-cost coefficients direct physical energy, electricity price, power же emissions эмес.
Funding: External funding жок.
Institutional Review Board: Not applicable.
Informed Consent: Not applicable.
Data Availability: Synthetic datasets жана run-level outputs standalone historical files катары архивделген эмес; generation procedures, scenario settings, parameter values жана seed макалада берилген. Synthetic instances/output corresponding authorдон reasonable request менен кайра түзүлүп/берилиши мүмкүн.
Source code: MATLAB implementation public эмес; ongoing research implementation катары өнүктүрүлүп жатат.
Conflicts of Interest: Authors declare no conflicts of interest.
Авторлордун салымы: Conceptualization: H.M., A.J.; methodology: H.M., A.J.; software: H.M.; validation: H.M., A.J., S.A.; formal analysis: H.M.; investigation: H.M.; data curation: H.M.; original draft: H.M.; review/editing: H.M., A.J., S.A.; visualization: H.M.; supervision: A.J., S.A.
Терминологиялык эскертүү: Изилдөө негизинен PFSP-SDST терминин колдонот; айрым computational-method абзацтарында PFSSP/PFSSP-SDST жазылышы кездешет. Булак муну өзүнчө маселе классы деп аныктабагандыктан Verianla негизги canonical термин катары PFSP-SDSTни сактайт.
Негизги чечмелөө чеги: Бардык comparative computational findings синтетикалык benchmark conditions, fixed \(\rho=0.05\) жана колдонулган fixed algorithm settings үчүн жарактуу.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген