

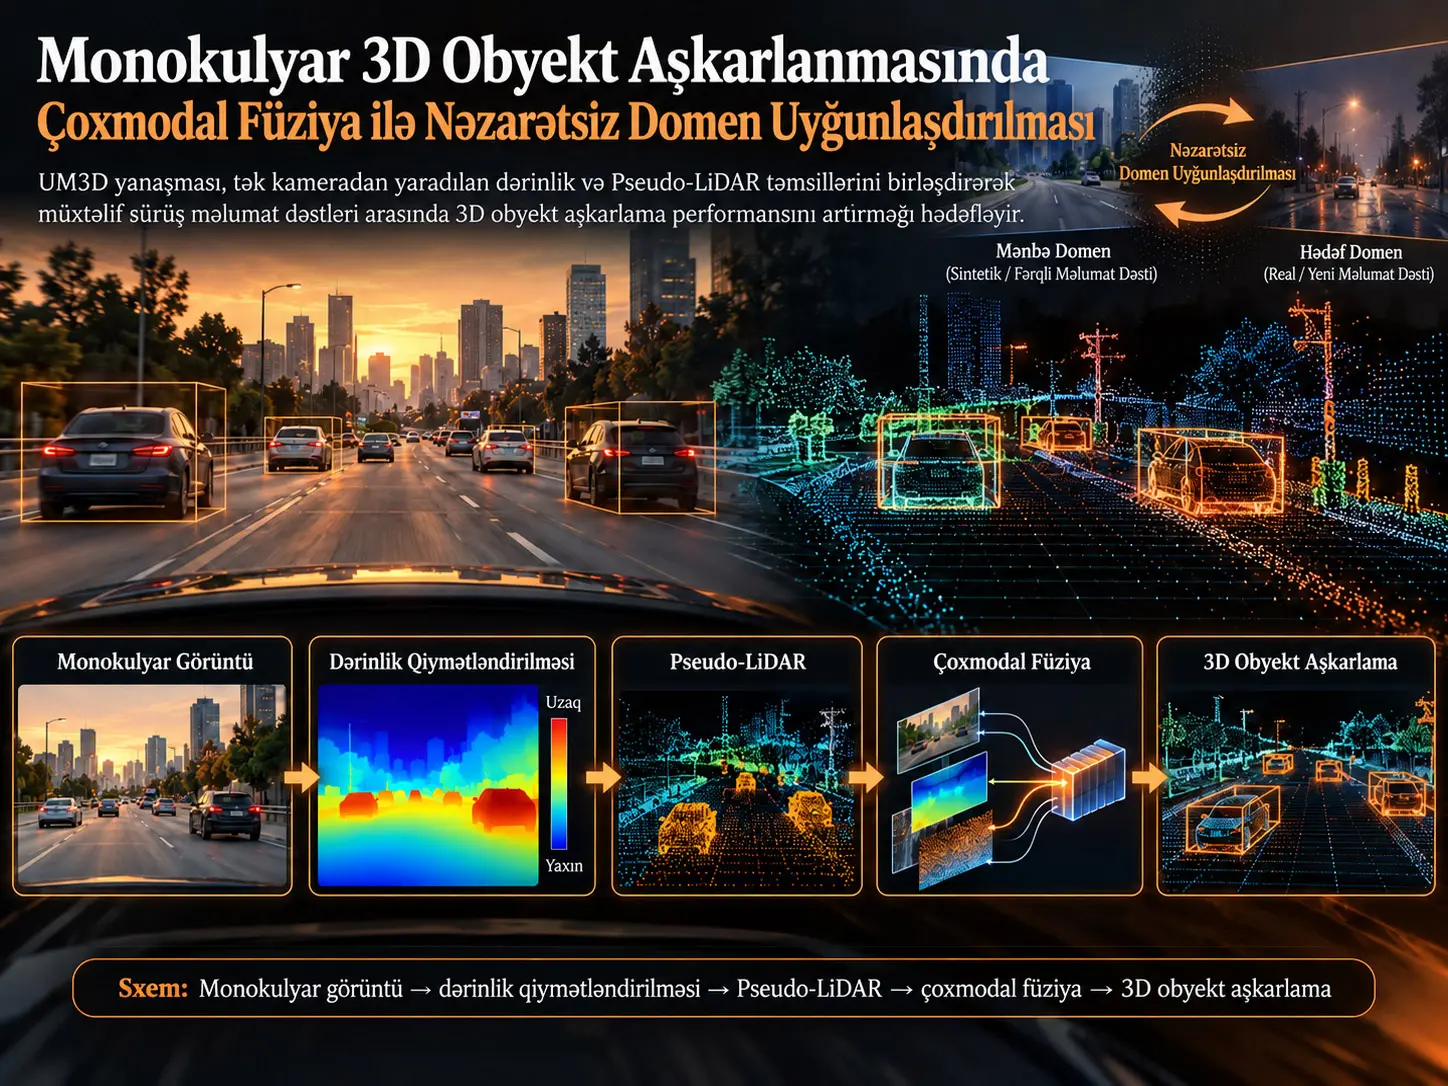
Nəzarətsiz Monokulyar 3D Aşkarlama modeli UM3D (Unsupervised Monocular 3D Detection), etiketlənmiş mənbə domendə öyrənilən üçölçülü aşkarlama biliyini hədəf domendə 3D qutu etiketlərinə ehtiyac olmadan ötürmək üçün özünənəzarətli dərinlik qiymətləndirilməsi, Pseudo-LiDAR yaradılması, keyfiyyətə həssas psevdо-etiketləmə və təsvir–nöqtə buludu füziyasını vahid ucdan-uca öyrənmə xəttində birləşdirən nəzarətsiz domen uyğunlaşdırma çərçivəsidir. Tədqiqat KITTI, Waymo Open Dataset (WOD), nuScenes və Lyft verilənlər dəstləri üzərində qiymətləndirilmişdir. UM3D xüsusilə domen dəyişməsi səbəbindən müxtəlif mühitlər arasında zəifləyən monokulyar 3D aşkarlama performansını yaxşılaşdırmağı hədəfləyir. Çıxarış mərhələsində real LiDAR tələb etmir; Pseudo-LiDAR təsviri eyni monokulyar təsvirdən qiymətləndirilən dərinlik əsasında daxildə yaradılır. Bununla belə, performans xüsusilə uzaq obyektlərdə dərinlik qiymətləndirilməsinin dəqiqliyi ilə məhdudlaşır və təcrübələrin əsas diqqəti avtomobil sinfinə yönəlmişdir.
Metodun iki əsas müdaxiləsi vardır. Birincisi, obyekt səviyyəsində təsadüfi miqyaslama mənbə və hədəf domenlər arasındakı nəqliyyat vasitəsi ölçüsü fərqlərinin ilkin psevdо-etiketləri pozmasını azaltmağa çalışır. İkincisi, IoU əsaslı keyfiyyət qiymətləndirilməsindən istifadə edən üç intervalı yaddaş bankı psevdо-etiketləri yalnız bir etibar balına görə qəbul etmək əvəzinə tarixi proqnozlarla uyğunlaşdırır və yeniləyir. Bu quruluş LoGoNet əsaslı təsvir–nöqtə buludu füziyası və diferensiallana bilən Change of Representation (CoR) qatı ilə birləşdirilərək aşkarlama xətasının dərinlik şəbəkəsinə qədər geri yayılmasını təmin edir.
WOD → KITTI nöqtə buludu domen uyğunlaşdırılmasında LoGoNet əsaslı UM3D, APBEV/AP3D dəyərlərində 85,71/67,44 nəticəsinə çatmışdır. Mənbə məqalənin xülasə və nəticə bölmələri WOD → KITTI üçün APBEV domen fərqinin %76,81-nin bağlandığını vurğulayır; lakin eyni tədqiqatın Cədvəl 2-sində SECOND əsaslı UM3D üçün %97,89 APBEV Closed Gap hesabat edilir. Buna görə %76,81 dəyəri məqalədəki bütün konfiqurasiyaların mütləq maksimumu kimi deyil, LoGoNet konfiqurasiyasında hesabat verilən nəticə kimi qiymətləndirilməlidir.
UM3D Nədir və Hansı Problemi Həll Edir?
UM3D müxtəlif verilənlər dəstləri və sürücülük mühitləri arasındakı paylanma dəyişməsinin monokulyar 3D obyekt aşkarlanmasında yaratdığı performans itkisini hədəf domendə real 3D qutu etiketlərinə söykənmədən azaltmağı nəzərdə tutan ucdan-uca nəzarətsiz domen uyğunlaşdırma çərçivəsidir. Sistem tək təsvirdən dərinlik çıxarır, bu dərinliyi Pseudo-LiDAR nöqtə buluduna çevirir, keyfiyyət nəzarətli psevdо-etiketlərlə hədəf domenə uyğunlaşır və təsvir xüsusiyyətləri ilə üçölçülü həndəsi xüsusiyyətləri birlikdə emal edir.
Əsas problem: tək kameradan dərinlik çıxarmaq niyə çətindir?
Monokulyar kamerada eyni ikiölçülü təsvir proyeksiyası müxtəlif üçölçülü səhnə həndəsələri ilə uyğun ola bilər. Başqa sözlə, təsvir dərinliyi birbaşa ölçmür. LiDAR fiziki məsafə ölçümü təmin etdiyi halda, monokulyar sistem dərinliyi təsvir ipuclarından qiymətləndirməli olur. Buna görə dərinlikdəki xəta Pseudo-LiDAR nöqtəsinin fəzadakı mövqeyini, daha sonra isə 3D qutunun yerini, ölçüsünü və ya istiqamətlənməsini poza bilər.
İkinci çətinlik domen dəyişməsidir. Bir detektor bir verilənlər dəstində öyrədildikdə, başqa verilənlər dəstində kamera həndəsəsi, coğrafi mühit, sensor sıxlığı, nəqliyyat vasitələrinin ölçü paylanmaları və annotasiya protokolları fərqli ola bilər. Buna görə mənbə domendə güclü olan model hədəf domendə eyni performansı göstərməyə bilər.
UM3D-nin elmi arxitekturası
- Özünənəzarətli mütləq dərinlik qiymətləndirilməsi: RSANet istifadə edilməklə monokulyar təsvirdən mütləq miqyaslı dərinlik xəritəsi yaradılır.
- Pseudo-LiDAR çevrilməsi: Piksel koordinatları və dərinlik iynə dəliyi kamera həndəsəsi ilə üçölçülü nöqtələrə çevrilir.
- Sıxlığa əsaslanan interval nümunələmə: Sıx Pseudo-LiDAR buludunun seyrək və sıx bölgələri tarazlaşdırılmağa çalışılır.
- Keyfiyyətə həssas psevdо-etiketləmə: Obyekt səviyyəsində təsadüfi miqyaslama və IoU əsaslı üç intervalı yaddaş bankından istifadə olunur.
- Çoxmodal füziya: Təsvir xüsusiyyətləri ilə Pseudo-LiDAR həndəsəsi LoGoNet əsaslı iki mərhələli füziya və öz-diqqət çəkiləndirilməsi ilə birləşdirilir.
- Ucdan-uca birgə optimallaşdırma: Diferensiallana bilən CoR qatı sayəsində 3D aşkarlama itkisinin qradiyenti dərinlik qiymətləndirmə şəbəkəsinə geri çatır.
Pseudo-LiDAR Bu Tədqiqatda Necə Yaradılır?
Pseudo-LiDAR monokulyar təsvir üçün qiymətləndirilən mütləq dərinlik xəritəsindəki hər pikselin kameranın daxili parametrlərindən istifadə etməklə üçölçülü koordinata geri proyeksiya edilməsi ilə yaradılır; UM3D daha sonra koordinat sistemini nəqliyyat vasitəsi–LiDAR oxlarına çevirir, 64 xətli LiDAR əldə edilməsini təqlid edən bucaq nümunələməsi tətbiq edir və yüksək sıxlıqlı nöqtə buludunu sıxlığa əsaslanan interval nümunələməsi ilə seyrəkləşdirir.
Təsvir müstəvisindən üçölçülü nöqtəyə çevrilmə
Mənbə tədqiqatın Tənlik (1)-ində təsvirdəki (i, j) mövqeyi, mütləq dərinlik dəyəri D(i,j) və kameranın daxili parametrlərindən istifadə olunur:
\[ x=\frac{(i-c_i)D(i,j)}{f_x},\qquad y=\frac{(j-c_j)D(i,j)}{f_y},\qquad z=D(i,j) \tag{1} \]
Burada \(f_x\) və \(f_y\) üfüqi və şaquli fokus məsafələrini; \(c_i\) və \(c_j\) əsas nöqtə koordinatlarını göstərir. \(i\), \(j\), \(f_x\), \(f_y\), \(c_i\) və \(c_j\) təsvir/piksel koordinat sistemindədir. \(D\) hansı uzunluq miqyasında ifadə edilirsə, yaradılan \(x\), \(y\) və \(z\) koordinatları da eyni fiziki miqyası daşıyır.
Kamera koordinatlarının nəqliyyat vasitəsindəki LiDAR koordinat sisteminə çevrilməsi mənbədə aşağıdakı ox uyğunlaşdırılması ilə verilir:
\[ x=-z,\qquad y=-x,\qquad z=y \tag{2} \]
64 xətli LiDAR əldə edilməsini təqlid etmək üçün hər nöqtənin şaquli bucağı və sensora qədər məsafəsi hesablanır:
\[ \vartheta(n)= \arctan\left( \frac{z(n)} {\sqrt{x^2(n)+y^2(n)}} \right), \qquad l(n)=\sqrt{x^2(n)+y^2(n)+z^2(n)} \tag{3} \]
Nöqtələr şaquli bucağa görə skan xətlərinə təyin edilir, xətt daxilində məsafəyə görə sıralanır və azimut hüceyrələrinə ayrılır. Hər xətt–azimut hüceyrəsində sensora ən yaxın nöqtənin saxlanması tək qayıdışlı LiDAR ölçməsini sxematik şəkildə təqlid edir. Tədqiqatda sensorun başlanğıc nöqtəsindən 1 m yuxarıda yerləşən nöqtələrin çıxarıldığı və əksolunma intensivliklərinin 1-ə təyin edildiyi bildirilir.
Sıxlığa əsaslanan interval nümunələmə
Yüksək ayırdetməli dərinlik xəritəsindən yaradılan Pseudo-LiDAR çox sıx ola bilər. UM3D fəzanı \(n\) kubik bölgəyə ayırır:
\[ \Omega=\{\omega_1,\omega_2,\ldots,\omega_n\} \tag{4} \]
Hər \(\omega_i\) bölgəsindəki nöqtələrin sayı \(m_i\) üçün tərs sıxlıq çəkisi:
\[ k_i=\frac{1}{m_i+\sigma} \tag{5} \]
kimi təyin edilir. \(\sigma\) sıfıra bölmənin qarşısını alan kiçik müsbət dəyərdir. Seyrək bölgələrin \(k_i\) dəyəri daha yüksək olduğuna görə nümunələmədə nisbi töhfələri artır. Hər bölgədən əldə edilən nümunə çoxluğu:
\[ P_i=\{p_{i1},p_{i2},\ldots,p_{ij}\} \tag{6} \]
və yekun nümunələnmiş bulud:
\[ \Gamma=\bigcup_{i=1}^{n}P_i \tag{7} \]
şəklində yaradılır. Mənbə \(\sigma\)-nın ədədi dəyərini, kubik intervalların tam həndəsi ölçülərini və ya \(j\)-nin \(k_i\)-dən hansı dəqiq nümunə sayı qaydası ilə yaradıldığını ətraflı hesabat etmir; bu dəyərlər Verianla tərəfindən tamamlanmamışdır.
Obyekt səviyyəsində təsadüfi miqyaslama niyə istifadə olunur?
Mənbə domendəki nəqliyyat vasitələrinin fiziki ölçü paylanması hədəf domendəkilərdən fərqlidirsə, mənbədə öyrədilmiş 3D detektor hədəf domendəki qutuları sistematik şəkildə yanlış ölçüləndirə bilər. UM3D-nin Object-Level Random Scaling Strategy (ORSS) komponenti bu qərəzi azaltmaq üçün etiketlənmiş mənbə-domen obyektlərini yerli qutu koordinat sistemində miqyaslayır.
Ölçüsü \((l,w,h)\), mərkəzi \((u,v,d)\) və istiqamətlənməsi \(\omega\) olan qutudakı nöqtə əvvəlcə yerli koordinata çevrilir:
\[ (p_{il},p_{iw},p_{ih})= (p_{ix}-u,p_{iy}-v,p_{iz}-d) \begin{bmatrix} \cos\omega & -\sin\omega & 0\\ \sin\omega & \cos\omega & 0\\ 0 & 0 & 1 \end{bmatrix} \tag{8} \]
Daha sonra ölçüsüz \(f_l\), \(f_w\), \(f_h\) miqyas əmsalları tətbiq olunur və nöqtə yenidən qlobal koordinata daşınır:
\[ (p_{ix},p_{iy},p_{iz})= (p_{il}f_l,p_{iw}f_w,p_{ih}f_h) \begin{bmatrix} \cos\omega & \sin\omega & 0\\ -\sin\omega & \cos\omega & 0\\ 0 & 0 & 1 \end{bmatrix} +(u,v,d) \tag{9} \]
Mənbə məqalə \(f_l\), \(f_w\) və \(f_h\) üçün istifadə olunan təsadüfi nümunələmə intervallarını ədədi şəkildə vermir. Buna görə bu parametrlərin paylanması və ya sərhədləri burada fərz edilməmişdir.
Psevdо-etiket keyfiyyəti necə nəzarətdə saxlanılır?
UM3D detektora əlavə edilən IoU reqressiya başlığı ilə proqnozlaşdırılan 3D qutunun keyfiyyət balını öyrənir. Mənbədə keyfiyyət itkisi ikili çarpaz entropiya şəklində verilir:
\[ L_{\mathrm{quality}} =-(1-\hat{s})\log(1-s)-\hat{s}\log(s) \tag{10} \]
\(s\) modelin qutu üçün proqnozlaşdırdığı IoU keyfiyyət dəyərini; \(\hat{s}\) isə proqnoz qutusunun real qutu və ya psevdо-etiketlə hesablanan IoU dəyərini ifadə edir.
Tətbiqdə müsbət hədd \(Thr_p=0.5\), mənfi hədd \(Thr_n=0.2\) kimi verilmişdir. \(s_i>Thr_p\) olan qutular müsbət nümunə kimi yaddaşa alınır; \(Thr_n<s_i<Thr_p\) intervalındakı qutular təlim zamanı nəzərə alınmayacaq bölgələri göstərmək üçün yaddaşda saxlanılır; \(s_i<Thr_n\) olanlar isə atılır.
Tarixi psevdо-etiket çoxluğu \(H\) və cari çoxluq \(C\) üçün 3D IoU:
\[ \mathrm{IoU}(H,C)= \frac{\cap_{H,C}}{\cup_{H,C}} \tag{11} \]
üzərindən hesablanır və hər tarixi qutu üçün ən güclü cari uyğunluq seçilir:
\[ \mathrm{optimum}(H,C) = \underset{C}{\arg\max}\, |\mathrm{IoU}(H,C)| \tag{12} \]
Uyğunlaşmayan tarixi qutular üçün sayğac mexanizmi istifadə olunur:
\[ \mathrm{state}= \begin{cases} 1, & \mathrm{counter}(H)\lt Thr_i\\ 0, & Thr_i\leq \mathrm{counter}(H)\lt Thr_r\\ -1, & \mathrm{counter}(H)\geq Thr_r \end{cases} \tag{13} \]
\(\mathrm{state}=1\) yaddaşda saxlama, \(\mathrm{state}=0\) nəzərə almama, \(\mathrm{state}=-1\) isə silmə deməkdir. Mənbə \(Thr_i\) və \(Thr_r\) hədlərini konseptual olaraq müəyyənləşdirir, lakin tətbiq detallarında onların ədədi dəyərlərini hesabat etmir. Bunun əvəzində cari–tarixi psevdо-etiket uyğunlaşdırılmasında istifadə olunan IoU həddi 0,1 olaraq göstərilmişdir.
Təsvir və Pseudo-LiDAR xüsusiyyətləri necə birləşdirilir?
UM3D-nin çoxmodal detektoru LoGoNet arxitekturasını əsas götürür. Nöqtə buludu voxel quruluşuna çevrilərək 3D backbone və Region Proposal Network (RPN) tərəfindən emal edilir. Eyni zamanda əvvəlcədən öyrədilmiş 2D detektor monokulyar təsvirdən təsvir xüsusiyyətlərini çıxarır.
LoGoNet-in iki füziya mərhələsi qorunur. Namizəd bölgədənkənar füziya voxel mərkəzlərini təsvir müstəvisinə proyeksiya edərək qlobal həndəsi quruluşu əlaqələndirir. Namizəd bölgədaxili füziya isə hər təklif daxilindəki yerli detalları çarpaz-diqqət ilə emal edir. Tədqiqatın dəyişdirdiyi hissə bu iki çıxışın sadəcə birləşdirilməsi əvəzinə öz-diqqət əsaslı çəkili xüsusiyyət toplanmasıdır.
\[ F=[F_{\mathrm{out}};F_{\mathrm{in}}], \qquad Q=W_QF,\quad K=W_KF,\quad V=W_VF \tag{14} \]
Burada \(F_{\mathrm{out}}\) bölgədənkənar, \(F_{\mathrm{in}}\) isə bölgədaxili füziya xüsusiyyətidir. \(W_Q\), \(W_K\) və \(W_V\) öyrənilə bilən proyeksiya matrisləridir. Miqyaslanmış nöqtəvi hasil diqqəti:
\[ \mathrm{Attention}(Q,K,V) = \mathrm{softmax} \left( \frac{QK^\top}{\sqrt{d_k}} \right)V \tag{15} \]
şəklindədir. \(d_k\) açar vektorlarının ölçüsüdür. Riyazi baxımdan mexanizm hər xüsusiyyət mövqeyinin digər xüsusiyyət mövqeləri ilə əlaqəsini çəkiləndirərək təsnifat və qutu reqressiyası üçün daha seçici birləşik təsvir yaradır.
Diferensiallana bilən CoR niyə kritikdir?
Klassik voxelləşdirmə bir nöqtənin hüceyrənin daxilində olub-olmamasını 0 və ya 1 ilə ifadə edir. Bu kəskin qərar koordinat dəyişməsinin kiçik dəyişiklikləri qarşısında kəsik olduğuna görə dərinlik şəbəkəsinə geri yayılacaq qradiyenti kəsə bilər. UM3D E2E-PL-dən götürülən Change of Representation (CoR) yanaşmasını sıxlığa əsaslanan nümunələmə ilə birlikdə istifadə edir və voxel doluluğunu yumşaq RBF çəkiləri ilə ifadə edir.
Bir hüceyrə \(u\) daxilindəki \(P_u\) nöqtələri üçün:
\[ W(u) = \frac{1}{|P_u|} \sum_{p\in P_u} e^{-\|p-p_c\|_2^2/\delta^2} \tag{16} \]
və qonşu hüceyrələr \(\Upsilon_u\) nəzərə alındıqda:
\[ T_{\mathrm{softquantization}}(u) = W(u)+ \frac{1}{|\Upsilon_u|} \sum_{\bar{u}\in\Upsilon_u} W(\bar{u}) \tag{17} \]
alınır. \(p_c\) voxel mərkəzidir; \(\delta\) RBF zolaq eni ilə əlaqəlidir. Təcrübə parametrlərində \(\delta^2=0.01\) və 26 qonşulu 3×3×3 yumşaltma nüvəsi istifadə olunmuşdur. Bu yumşaq təsvirin əsas alqoritmik funksiyası aşkarlama xətasının nöqtə təsviri vasitəsilə dərinlik şəbəkəsinə geri yayıla bilməsini təmin etməkdir.
Ümumi öyrənmə məqsədi
Ucdan-uca ümumi itki:
\[ L=\alpha L_{\mathrm{depth}}+\beta L_{\mathrm{detection}} \tag{18} \]
şəklindədir. Təcrübələrdə \(\alpha=1\) və \(\beta=0.01\) istifadə edilmişdir.
Mənbədə dərinlik itkisi Tənlik (19) ilə aşağıdakı formada hesabat edilir:
\[ L_{\mathrm{depth}} = \min_{t'} p_e(I_t,I_{t'\rightarrow t})L_p +\mu L_{\mathrm{smooth}} \tag{19} \]
Fotometrik komponent və hamarlıq komponenti:
\[ L_p=\sum_{t'}\ell(I_t,I_{t'\rightarrow t}) \tag{20} \]
\[ L_{\mathrm{smooth}} = |\nabla_x d_t^*|e^{-|\nabla_x I_t|} + |\nabla_y d_t^*|e^{-|\nabla_y I_t|} \tag{21} \]
şəklindədir. \(d_t^*\) normallaşdırılmış tərs dərinliyi, \(\nabla_x\) və \(\nabla_y\) isə üfüqi və şaquli qradiyentləri göstərir. Hamarlıq çəkisi təcrübələrdə \(\mu=0.001\)-dir.
Aşkarlama itkisi:
\[ L_{\mathrm{detection}} = L_{\mathrm{RPN}} + L_{\mathrm{conf}} + \lambda L_{\mathrm{reg}} \tag{22} \]
kimi verilir. \(L_{\mathrm{RPN}}\) bölgə təklifi şəbəkəsinin itkisi, \(L_{\mathrm{conf}}\) etibar/proqnoz itkisi və \(L_{\mathrm{reg}}\) qutu reqressiya itkisidir. Təcrübələrdə \(\lambda=2.0\) istifadə edilmişdir.
Üç mərhələli təlim məntiqi
- Mənbə domen ilkin təlimi: Real etiketli mənbə-domen nöqtə buludu məlumatları ilə IoU başlıqlı detektor ORSS istifadə edilməklə əvvəlcədən öyrədilir.
- Hədəf domen özünütəlimi: Hədəf domendə proqnoz qutuları və IoU keyfiyyət balları yaradılır; üç intervalı yaddaş bankı yenilənir və psevdо-etiketlərlə təlim davam etdirilir.
- Ucdan-uca monokulyar birgə optimallaşdırma: Təsvirdən dərinlik yaradılır, diferensiallana bilən CoR ilə Pseudo-LiDAR hazırlanır, psevdо-etiketlər yenilənir və dərinlik → CoR → çoxmodal aşkarlama zənciri vahid ümumi itki altında birlikdə optimallaşdırılır.
Tədqiqatın Metodu və Nəticələri
Tətbiq detalları
| Element | Mənbədə hesabat verilən dəyər |
|---|---|
| Hədəf-domen self-training optimizer | Adam |
| Self-training öyrənmə sürəti | 0.0015 |
| Self-training müddəti | 40 epoch |
| Psevdо-etiket yenilənməsi | Hər epoch |
| Ucdan-uca giriş/çıxış ayırdetməsi | 1024 × 320 |
| Framework | PyTorch 1.10.0 |
| Ucdan-uca optimizer | Adam |
| Başlanğıc öyrənmə sürəti | 0.001 |
| Öyrənmə sürətinin azaldılması | Hər 10 epoch-da ×0.1 |
| Ucdan-uca təlim | 30 epoch |
| \(\alpha\) | 1 |
| \(\beta\) | 0.01 |
| \(\mu\) | 0.001 |
| \(\lambda\) | 2.0 |
| RBF | \(\delta^2=0.01\) |
| Yumşaltma qonşuluğu | 26 qonşu, 3×3×3 |
| \(Thr_p\) | 0.5 |
| \(Thr_n\) | 0.2 |
| Yaddaş bankı IoU uyğunlaşdırma həddi | 0.1 |
Verilənlər dəstləri və qiymətləndirmə sahəsi
| Verilənlər dəsti | Mənbədə verilən əhatə | Tədqiqatdakı rolu |
|---|---|---|
| KITTI | 7481 təlim, 7518 test nümunəsi; Easy/Moderate/Hard qiymətləndirməsi | Mühüm hədəf domenlərdən biri |
| Waymo Open Dataset (WOD) | 798 təlim, 202 doğrulama, 150 test ardıcıllığı | Mənbə domen / çarpaz verilənlər dəsti ötürülməsi |
| nuScenes | 1000 səhnə; Boston və Sinqapur | Mənbə və ya hədəf domen |
| Lyft | 55.000-dən çox annotasiya edilmiş kadr | Mənbə və ya hədəf domen |
Bütün verilənlər dəstləri üçün aşkarlama sahəsi \(X/Y\in[-75.2,75.2]\) m və \(Z\in[-2,4]\) m olaraq müəyyən edilmişdir. SECOND və LoGoNet üçün voxel ölçüsü \((0.1,0.1,0.15)\) m-dir. Məlumat artırma qlobal təsadüfi miqyaslama, fırlatma, sürüşdürmə və obyekt başına miqyaslama/fırlatmanı əhatə edir.
Closed Gap Metriki Nə Deməkdir?
Closed Gap mənbə domendə öyrədilib hədəf domenə birbaşa tətbiq edilən model ilə hədəf domendə tam nəzarətli öyrədilən Oracle arasındakı performans fərqinin domen uyğunlaşdırma metodu tərəfindən nə qədərinin bağlandığını faizlə ifadə edir; dəyər yüksəldikcə uyğunlaşdırılmış model Oracle performansına yaxınlaşır, lakin nisbət istifadə olunan Source Only və Oracle istinadlarından asılıdır və müxtəlif təcrübə quruluşları arasında kontekstdən qoparılaraq müqayisə edilməməlidir.
Mənbədə istifadə olunan tənlik:
\[ \mathrm{Closed\ Gap} = \frac{AP_{\mathrm{model}}-AP_{\mathrm{sourceonly}}} {AP_{\mathrm{oracle}}-AP_{\mathrm{sourceonly}}} \times100\% \tag{23} \]
Nöqtə buludu UDA nəticələri
Aşağıdakı cədvəl mənbə Tables 2–4-dəki faktiki dəyərlərin Verianla üçün yeni cədvəl quruluşunda birləşdirilmiş halıdır. AP sütunlarında sıra APBEV/AP3D-dir.
| Ötürmə | Detektor | Source Only | SN | ST3D | UM3D | Oracle | UM3D Closed Gap BEV/3D |
|---|---|---|---|---|---|---|---|
| nuScenes → KITTI | LoGoNet | 54.56/23.15 | 47.69/32.38 | 78.26/57.41 | 80.17/58.20 | 90.72/84.87 | 70.84%/56.79% |
| nuScenes → KITTI | SECOND | 51.84/17.92 | 40.03/21.23 | 75.94/54.13 | 76.25/54.38 | 83.29/73.45 | 77.62%/65.66% |
| WOD → KITTI | LoGoNet | 69.12/31.59 | 79.95/62.25 | 84.67/65.39 | 85.71/67.44 | 90.72/84.87 | 76.81%/67.27% |
| WOD → KITTI | SECOND | 67.64/27.48 | 78.96/59.20 | 82.19/61.83 | 82.96/62.75 | 83.29/73.45 | 97.89%/76.73% |
| WOD → nuScenes | LoGoNet | 39.28/24.65 | 40.15/26.36 | 42.58/28.14 | 44.10/29.57 | 55.62/39.18 | 29.49%/33.86% |
| WOD → nuScenes | SECOND | 32.91/17.24 | 33.23/18.57 | 35.92/20.19 | 36.84/23.62 | 51.88/34.87 | 20.72%/36.18% |
| WOD → Lyft | LoGoNet | 74.87/57.61 | 74.93/57.89 | 78.14/59.93 | 79.06/61.28 | 85.33/71.52 | 40.05%/26.38% |
| WOD → Lyft | SECOND | 72.92/54.34 | 72.33/54.34 | 76.32/59.24 | 76.14/59.19 | 84.47/68.78 | 27.88%/33.59% |
Nəticələr tək bir model/ötürmə cütündə mütləq üstünlük iddiasına endirilməməlidir. Məsələn, WOD → Lyft SECOND konfiqurasiyasında ST3D-nin APBEV dəyəri 76,32 ikən UM3D 76,14-dür; buna qarşılıq UM3D-nin AP3D dəyəri 59,19, ST3D-nin dəyəri 59,24-dür. Yəni bu konfiqurasiyada fərqlər çox kiçikdir və UM3D hər xanada ən yüksək nəticəni vermir.
Monokulyar WOD/nuScenes/Lyft → KITTI nəticələri
KITTI hədəf domenində Source Only dəyərləri tədqiqatda bütün Easy/Moderate/Hard APBEV və AP3D xanaları üçün 0 olaraq hesabat edilmişdir. Aşağıdakı cədvəl STMono3D, UM3D və Oracle nəticələrini göstərir.
| Ötürmə | Metod | APBEV Easy | APBEV Mod. | APBEV Hard | AP3D Easy | AP3D Mod. | AP3D Hard |
|---|---|---|---|---|---|---|---|
| nuScenes → KITTI | STMono3D | 35.63 | 27.37 | 23.95 | 28.65 | 21.89 | 19.55 |
| nuScenes → KITTI | UM3D | 36.81 | 27.60 | 22.94 | 29.37 | 22.16 | 18.93 |
| nuScenes → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
| Lyft → KITTI | STMono3D | 26.46 | 20.71 | 17.66 | 18.14 | 13.32 | 11.83 |
| Lyft → KITTI | UM3D | 28.23 | 21.59 | 17.98 | 19.32 | 13.35 | 11.16 |
| Lyft → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
| WOD → KITTI | STMono3D | 35.69 | 26.94 | 23.19 | 28.34 | 20.21 | 18.03 |
| WOD → KITTI | UM3D | 36.10 | 27.67 | 23.48 | 29.08 | 20.92 | 18.84 |
| WOD → KITTI | Oracle | 33.46 | 23.62 | 22.18 | 29.01 | 19.88 | 17.17 |
Bəzi monokulyar xanalarda UM3D-nin Oracle dəyərini aşması ehtiyatla şərh edilməlidir. Məqalədəki Oracle hədəf domendə tam nəzarətli öyrədilən təsvir əsaslı FCOS3D-dir. UM3D isə tək kamera ilə çıxarış etməsinə baxmayaraq eyni təsvirdən törətdiyi Pseudo-LiDAR həndəsəsini təsvir xüsusiyyətləri ilə birləşdirir və daha geniş mənbə-domen ilkin təlimindən yararlanır. Buna görə burada müqayisə edilən iki sistemin təsvir quruluşları eyni deyil. Bu nəticə “nəzarətsiz öyrənmə ümumiyyətlə tam nəzarətli öyrənmədən üstündür” demək deyil.
nuScenes hədəf domenində monokulyar nəticələr
| Ötürmə | Metod | mAP | mATE | mASE | mAOE |
|---|---|---|---|---|---|
| WOD → nuScenes | Source Only | 2.4 | 1.302 | 0.190 | 0.802 |
| WOD → nuScenes | STMono3D | 23.5 | 0.843 | 0.171 | 0.349 |
| WOD → nuScenes | UM3D | 25.7 | 0.820 | 0.168 | 0.311 |
| WOD → nuScenes | Oracle | 28.2 | 0.798 | 0.160 | 0.209 |
| Lyft → nuScenes | Source Only | 2.4 | 1.302 | 0.190 | 0.802 |
| Lyft → nuScenes | STMono3D | 21.3 | 0.911 | 0.170 | 0.355 |
| Lyft → nuScenes | UM3D | 22.1 | 0.898 | 0.173 | 0.304 |
| Lyft → nuScenes | Oracle | 28.2 | 0.798 | 0.160 | 0.209 |
mAP üçün daha yüksək dəyər daha yaxşı aşkarlama həssaslığını ifadə etdiyi halda, mATE, mASE və mAOE xəta metrikləridir; buna görə onlar üçün daha aşağı dəyər üstün tutulur. WOD → nuScenes ötürülməsində UM3D, STMono3D ilə müqayisədə mAP-ni 23,5-dən 25,7-yə yüksəldərkən mATE-ni 0,843-dən 0,820-yə, mASE-ni 0,171-dən 0,168-ə və mAOE-ni 0,349-dan 0,311-ə endirmişdir.
ORSS və PLGM ablasiya təhlili
| Modul | Detektor | APBEV | AP3D |
|---|---|---|---|
| Source Only | SECOND | 67.64 | 27.48 |
| Source Only | LoGoNet | 69.12 | 31.59 |
| Baseline + ORSS | SECOND | 78.29 | 55.13 |
| Baseline + ORSS | LoGoNet | 79.46 | 56.08 |
| Baseline + PLGM | SECOND | 81.30 | 59.42 |
| Baseline + PLGM | LoGoNet | 83.25 | 61.91 |
| Baseline + PLGM + ORSS | SECOND | 82.96 | 62.75 |
| Baseline + PLGM + ORSS | LoGoNet | 85.71 | 67.44 |
LoGoNet bazasında yalnız ORSS əlavə edilməsi Source Only ilə müqayisədə APBEV/AP3D-ni 69,12/31,59-dan 79,46/56,08-ə yüksəldir. Yalnız PLGM 83,25/61,91 nəticəsinə çatır. İki komponentin birlikdə istifadə edilməsi 85,71/67,44 ilə ən yüksək nəticəni verir. Bu cədvəl tədqiqatın psevdо-etiket yaddaşı ilə obyekt miqyaslama müdaxilələrinin eyni funksiyanı təkrarlamadığını, bir-birini tamamlayan təsirlər verdiyini göstərən əsas ablasiya sübutudur.
Ucdan-uca birgə təlimin ablasiya təhlili
| Birgə optimallaşdırılan şəbəkə | APBEV Easy | APBEV Mod. | APBEV Hard | AP3D Easy | AP3D Mod. | AP3D Hard |
|---|---|---|---|---|---|---|
| Depth | 30.26 | 20.71 | 17.35 | 25.51 | 16.06 | 14.48 |
| RCNN | 32.01 | 22.56 | 18.55 | 26.75 | 17.69 | 15.41 |
| RPN | 32.64 | 22.87 | 18.94 | 26.14 | 17.52 | 14.34 |
| RCNN + RPN | 33.89 | 23.42 | 19.80 | 26.99 | 17.10 | 15.85 |
| Depth + RPN | 35.62 | 26.36 | 21.16 | 28.74 | 19.23 | 16.19 |
| Depth + RCNN | 35.98 | 26.73 | 23.20 | 29.32 | 19.15 | 17.41 |
| Depth + RCNN + RPN | 36.10 | 27.67 | 23.48 | 29.08 | 20.92 | 18.84 |
Moderate APBEV RCNN + RPN birgə təlimində 23,42 olduğu halda, dərinlik şəbəkəsi də birgə optimallaşdırmaya qoşulduqda 27,67-yə yüksəlir. Mənbə müəllifləri bu 4,25 ballıq fərqi aşkarlama qradiyentinin dərinlik qiymətləndirilməsinə geri axmasının əhəmiyyəti ilə əlaqələndirirlər. Tam üç şəbəkəli quruluş altı AP xanasının beşində ən yüksək dəyərə çatır; yeganə istisna Easy AP3D-dir. Burada Depth + RCNN 29,32, tam quruluş isə 29,08 nəticəsi vermişdir.
Tədqiqatın xülasəsində göstərilən %19,30 nisbi APBEV artımı da Easy şərtində yalnız Depth sətrindəki 30,26 ilə tam Depth + RCNN + RPN sətrindəki 36,10 müqayisəsinə uyğundur.
Keyfiyyət nəticələri nə göstərir?
Mənbə Şəkil 5-də WOD → KITTI nöqtə buludu uyğunlaşdırılması vizuallaşdırılır. Source Only modelinin domenlərarası həndəsi uyğunsuzluq səbəbindən bəzi avtomobil qutularını nəzərəçarpacaq dərəcədə kiçik yaratdığı; ST3D-nin bunu yaxşılaşdırdığı; UM3D-nin qutu mövqeyi və ölçülərini Oracle-a daha çox yaxınlaşdırdığı görünür.
Mənbə Şəkil 6-da eyni ötürülmə monokulyar 3D görünüş və BEV üzərindən müqayisə edilir. Source Only modelinin 2D obyektləri tapmasına baxmayaraq dərinlik qiymətləndirilməsindəki böyük xəta səbəbindən 3D AP-nin demək olar sıfıra düşdüyü; STMono3D-nin dərinlik xətasını azaltdığı; UM3D proqnozlarının isə bir çox nümunədə Oracle-a daha çox yaxınlaşdığı hesabat edilir. Bu şəkillər kəmiyyət cədvəllərini əvəz etmir; yalnız qutu həndəsəsindəki domen uyğunlaşdırma təsirini vizual olaraq dəstəkləyir.
Hesablama xərci
Tək NVIDIA RTX 3080 üzərində bir kadrın çıxarışı təxminən 127 ms, yəni 7,9 FPS olaraq ölçülmüşdür. Bunun təxminən 15,5 ms-si 14,5 milyon parametrli RSANet dərinlik şəbəkəsinə, 8,1 ms-si CoR və sıxlığa əsaslanan Pseudo-LiDAR yaradılmasına, 103,7 ms-si isə çoxmodal detektora aiddir. Ümumi model təxminən 60,5 milyon parametr ehtiva edir. Buna görə mövcud tətbiqdə darboğaz dərinlik qiymətləndirilməsi deyil, 3D voxel backbone, RPN, 2D xüsusiyyət çıxarıcı və iki mərhələli çarpaz-modal füziyanı ehtiva edən aşkarlama qatıdır.
Tədqiqatın dəstəklədiyi nəticələr
- UM3D araşdırılan bir çox mənbə→hədəf ötürülməsində Source Only və müqayisə edilən UDA metodları ilə müqayisədə performans artımı təmin edir.
- ORSS və PLGM birlikdə istifadə edildikdə WOD → KITTI ablasiya təhlilində hər iki detektor üçün də ən yüksək birləşik nəticə əldə edilir.
- Dərinlik qiymətləndirilməsinin aşkarlama məqsədi ilə birlikdə optimallaşdırılması yalnız aşkarlama alt şəbəkələrini birgə öyrətməklə müqayisədə nəzərəçarpacaq APBEV qazancı verir.
- Təsvir və Pseudo-LiDAR füziyası yalnız bir modalitetə əsaslanan domen uyğunlaşdırılmasına qarşı mənbə tədqiqatın mərkəzi dizayn üstünlüyüdür.
- Çıxarış mərhələsində Pseudo-LiDAR eyni monokulyar təsvirdən yaradıldığı üçün əlavə LiDAR sensoru tələb olunmur.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr və məhdudiyyətlər
- Nəticələr bütün obyekt sinifləri üçün eyni uğuru sübut etmir; tədqiqat əsasən avtomobil sinfinə yönəlmişdir.
- Uzaq məsafədə aşkarlama özünənəzarətli dərinlik qiymətləndirilməsinin dəqiqliyi ilə məhdudlaşır.
- Hesabat verilən 7,9 FPS-lik RTX 3080 tətbiqi tam real-zamanlı avtomobildaxili istehsal sisteminin doğrulandığı anlamına gəlmir; müəlliflər model sıxılmasını və çıxarışın sürətləndirilməsini gələcək iş kimi göstərirlər.
- KITTI və ya nuScenes benchmark uğuru başqa kamera həndəsələri, hava şəraiti, ölkələr və ya istehsal nəqliyyat vasitələri üçün eyni performansa zəmanət vermir.
- Bəzi monokulyar təcrübələrdə Oracle-ın aşılması ümumilikdə nəzarətsiz öyrənmənin tam nəzarətli öyrənmədən üstün olduğunu göstərmir; müqayisə edilən Oracle-ın təsvir əsaslı FCOS3D olması və UM3D-nin Pseudo-LiDAR həndəsəsi ilə fərqli xüsusiyyət təsvirindən istifadə etməsi nəzərə alınmalıdır.
- Mənbə \(f_l,f_w,f_h\) miqyas intervallarını, \(\sigma\)-nın ədədi dəyərini və yaddaş bankındakı \(Thr_i\), \(Thr_r\) hədlərinin ədədi dəyərlərini hesabat etmədiyinə görə yalnız məqalə mətni əsasında hər detalı ilə yenidən istehsal mümkün deyil.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Unsupervised Domain Adaptation with Multimodal Fusion for Monocular 3D Object Detection
Müəlliflər: Jin Jiang; Jidong Dai; Wei Li; Yuquan Zhou; Maozhang Ye; Jianhuan Zhang; Chentao Zhang.
Məsul müəllif: Chentao Zhang.
Qurumlar: Xiamen King Long United Automotive Industry Co., Ltd., Xiamen, Çin; Pen-Tung Sah Institute of Micro-Nano Science and Technology, Xiamen University, Xiamen, Çin; School of Artificial Intelligence, Quanzhou Vocational College of Economics and Business, Quanzhou, Çin.
Jurnal: Vehicles.
Nəşriyyat: MDPI, Basel, Switzerland.
Biblioqrafik qeyd: Vehicles 2026, 8(5), 98.
DOI: 10.3390/vehicles8050098
Rəsmi DOI bağlantısı: https://doi.org/10.3390/vehicles8050098
Tarixçə: Göndəriş 7 Mart 2026; reviziya 22 Aprel 2026; qəbul 25 Aprel 2026; nəşr 1 May 2026.
Mənbə növü: Nəşr olunmuş akademik tədqiqat məqaləsi.
Lisenziya: Creative Commons Attribution (CC BY). Bu Verianla mətni lisenziyanın mövcudluğuna baxmayaraq orijinal məqalənin cümlə, abzas və ya şəkil quruluşunu yenidən yayımlamaq əvəzinə elmi faktlar, metodlar, riyazi əlaqələr və hesabat verilən məlumatlar əsasında müstəqil tədris quruluşu kimi hazırlanmışdır.
Maliyyələşdirmə: Major Science and Technology Special Project of Fujian Province, Grant No. 2024HZ022013; Applied Technology Engineering Center of Fujian Provincial Higher Education for Visual Perception and Intelligent Analysis, Grant No. SJGZ202501.
Məlumatların əlçatanlığı: Müəlliflər orijinal töhfələrin məqalə daxilində olduğunu, əlavə sualların məsul müəllifə yönəldilə biləcəyini bildirirlər.
Etik bəyanatlar: Institutional Review Board və informed consent sahələri tədqiqat üçün tətbiq edilə bilən deyil.
Maraqlar toqquşması: Jin Jiang və Wei Li Xiamen King Long United Automotive Industry Co., Ltd. əməkdaşlarıdır. Digər müəlliflər tədqiqatın potensial maraqlar toqquşması kimi şərh edilə biləcək kommersiya və ya maliyyə münasibətləri olmadan aparıldığını bəyan etmişlər.
Müəllif töhfələri: Konseptuallaşdırma Jin Jiang və Chentao Zhang; metod Jin Jiang və Wei Li; proqram təminatı Jidong Dai; doğrulama Jidong Dai və Yuquan Zhou; formal təhlil Jidong Dai və Jianhuan Zhang; tədqiqat Jin Jiang, Wei Li və Maozhang Ye; resurslar Wei Li və Maozhang Ye; məlumat kurasiyası Jidong Dai və Yuquan Zhou; ilkin layihə Jin Jiang; nəzərdən keçirmə/redaktə Jianhuan Zhang və Chentao Zhang; vizuallaşdırma Jidong Dai və Yuquan Zhou; nəzarət Jin Jiang, Jianhuan Zhang və Chentao Zhang; layihə idarəetməsi Chentao Zhang; maliyyələşdirmənin əldə edilməsi Jin Jiang və Chentao Zhang tərəfindən həyata keçirilmişdir.
Mənbədaxili hesabat qeydi: Xülasə və nəticə bölməsi WOD → KITTI üçün APBEV domen fərqinin %76,81-ə qədər bağlandığını bildirdiyi halda, Cədvəl 2-nin SECOND sətri %97,89 APBEV Closed Gap hesabat edir. Mənbə bu fərqi ayrıca izah etmədiyi üçün hər iki dəyər öz təcrübə kontekstləri ilə qorunmalıdır.
Metodoloji sərhəd: Tədqiqat müxtəlif benchmark verilənlər dəstləri üzərində alqoritmik çarpaz-domen doğrulaması təqdim edir. Bu sübut real istehsal nəqliyyat vasitəsində uzunmüddətli sahə təhlükəsizliyi, bütün obyekt siniflərində ümumiləşdirilə bilmə və ya hər yeni sensor/coğrafiya kombinasiyasında eyni uğur səviyyəsi demək deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib