

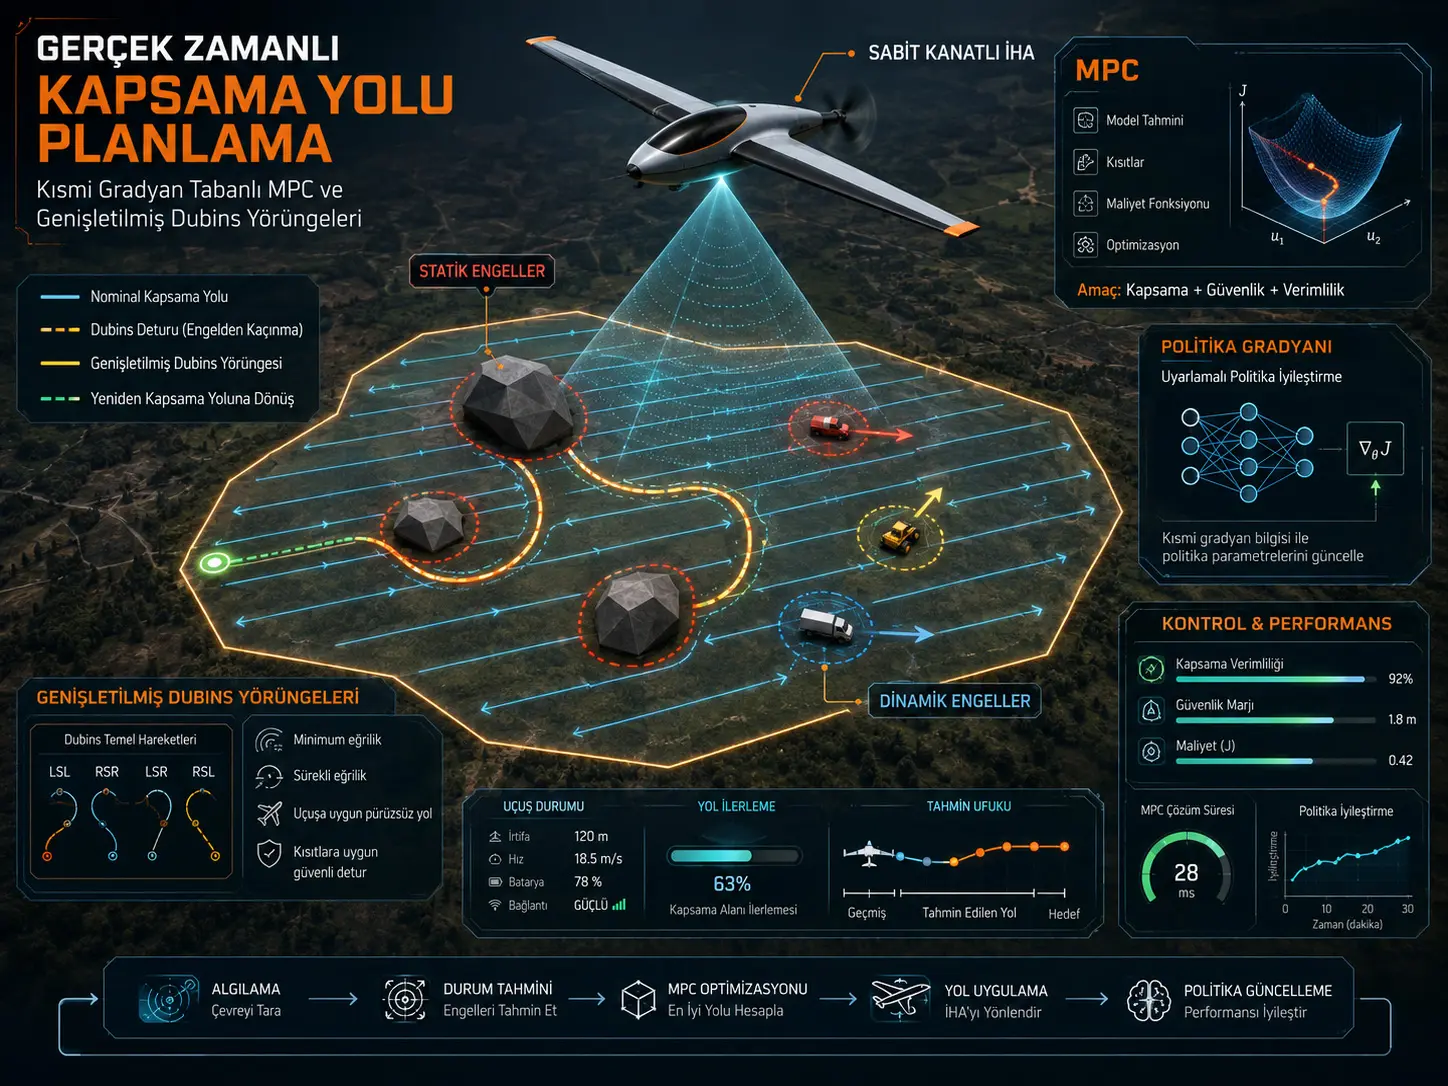
Bu tədqiqat sabit qanadlı pilotsuz uçuş aparatının əvvəlcədən tamamilə naməlum statik və hərəkətli maneələr ola bilən bir ərazidə bütün sahəni əhatə edəcək şəkildə uçmasını təmin edən hibrid marşrut planlaşdırma və idarəetmə çərçivəsi hazırlayır. Metod əvvəlcə oflayn olaraq back-and-forth formasında nominal əhatə marşrutu yaradır; uçuşun onlayn mərhələsində isə Model Predictive Control (MPC), Policy Gradient (PG) əsaslı idarəetmə yenilənməsi və virtual waypoint-lərlə genişləndirilmiş Dubins Path (ADP) həndəsəsini birlikdə istifadə edir. Üç simulyasiya ssenarisində təklif olunan PG-MPC, xüsusilə mürəkkəb mühitlərdə klassik gradient-based NLP-MPC ilə müqayisədə maksimum hesablama yükünü azaltmış və optimallaşdırmanın yaxınlaşma dərəcəsini artırmışdır. Ən çətin üçüncü ssenaridə maksimum hesablama müddəti 0,9157 saniyədən 0,5404 saniyəyə düşmüş, lakin tədqiqatın özünün 0,5 saniyəlik real vaxt nümunələmə həddini az da olsa aşmışdır. Nəticələr yalnız simulyasiyaya əsaslanır; fiziki sabit qanadlı PUA uçuşu və birləşdirilmiş PG-MPC quruluşunun nəzəri qapalı dövrə sabitlik sübutu bu tədqiqatda yoxdur.
Təklif olunan arxitektura ikiqatlıdır. Oflayn mərhələ kamera baxış sahəsi və region həndəsəsinə görə bütün hədəf sahəni əhatə edən paralel sweep line-lardan ibarət nominal marşrut yaradır. Onlayn mərhələdə LiDAR tərəfindən aşkar edildiyi fərz edilən yeni maneələr mühit modelinə əlavə olunur; MPC idarəetmə girişlərini və proqnozlaşdırılan vəziyyəti optimallaşdırır; Policy Gradient hissəsi idarəetmə siyasətini yeni vəziyyətlərə uyğun yeniləyir; genişləndirilmiş Dubins metodu isə maneədən yayınmaq üçün nominal xətdən çıxan vasitənin sabit qanadlı uçuşun dönmə radiusu məhdudiyyətlərinə uyğun, daha hamar bir yolla yenidən əhatə xəttinə qayıtmasını hədəfləyir.
PG-MPC-nin üstünlüyü bütün hesablama göstəricilərində eyni deyil. Scenario 1 və Scenario 2-də orta emal müddəti klassik NLP-MPC-dən bir qədər yüksəkdir. Bunun əvəzində mühitin mürəkkəbliyi artdıqda pik emal müddətləri nəzərəçarpacaq dərəcədə azalır. Scenario 2-də maksimum müddət 0,718 s-dən 0,3621 s-yə, Scenario 3-də 0,9157 s-dən 0,5404 s-yə enmişdir. Yaxınlaşma dərəcəsi Scenario 2-də %92,30-dan %96,87-yə, Scenario 3-də %91,919-dan %94,34-ə yüksəlmişdir.
Augmented Dubins Path yanaşması klassik Dubins Path ilə müqayisədə daha hamar və sabit qanadlı vasitənin kinematik dönmə məhdudiyyətlərinə daha uyğun keçidlər təmin etməyi hədəfləyir. Lakin bu həndəsi üstünlük pulsuz deyil: Cədvəl 4-də ADP üç ssenarinin hamısında klassik DP ilə müqayisədə bir qədər daha uzun ümumi yol və bir qədər daha yüksək ümumi execution time yaratmışdır. Buna görə tədqiqat “ADP hər vəziyyətdə yolu qısaldır” nəticəsini dəstəkləmir.
Türkiyə baxımından: Tədqiqat qrupunda Adana Alparslan Türkeş Elm və Texnologiya Universiteti ilə Gebze Texniki Universitetinin tədqiqatçılarının olması və işin TÜBİTAK tərəfindən dəstəklənməsi sabit qanadlı avtonom sistemlərdə yerli akademik idarəetmə və yol planlaşdırma işlərinin miqyasına dair konkret nümunə təqdim edir. Hazırlanmış yanaşma nəzəri olaraq geniş sahəli ekoloji monitorinq, fəlakətdən sonrakı skan və ya oxşar əhatə missiyaları üçün araşdırıla bilər. Bununla belə, mövcud nəticələrin hamısı simulyasiyadır; Türkiyənin real hava məkanında, real sensorlarla və ya real sabit qanadlı platformada missiya uğuru bu tədqiqatla sübut edilməyib.
Tədqiqat hansı problemi həll etməyə çalışır?
Coverage Path Planning (CPP) hava robotunun əlçatan hədəf bölgənin hamısını müşahidə edəcək və ya üzərindən keçəcək şəkildə yol yaratması problemidir. Sabit qanadlı PUA-larda bu problem multirotor sistemlərdən daha çətindir; çünki vasitə yerində dönə bilmir, minimum dönmə radiusuna və fasiləsiz irəli hərəkətə bağlı kinematik məhdudiyyətlərə malikdir.
Tədqiqatın hədəflədiyi ikinci problem mühitin əvvəlcədən tam bilinməməsidir. Klassik back-and-forth əhatə yolları həndəsi baxımdan bütün bölgəni skan edə bilər; lakin uçuş zamanı əvvəllər xəritədə olmayan bina, qadağan olunmuş zona və ya hərəkətli hava vasitəsi ortaya çıxdıqda yol yerli olaraq yenidən təşkil edilməlidir.
Buna görə tədqiqat üç tələbi eyni riyazi çərçivədə birləşdirməyə çalışır:
- bölgənin əhatə bütövlüyünü qorumaq,
- sabit qanadlı vasitənin kinematik və idarəetmə məhdudiyyətlərinə əməl etmək,
- yeni statik və dinamik maneələrə onlayn olaraq reaksiya vermək.
Çərçivə niyə iki mərhələli hazırlanıb?
Sistem oflayn və onlayn olmaqla iki əsas fazadan ibarətdir. Oflayn mərhələdə maneələr nəzərə alınmadan ideal nominal əhatə marşrutu hazırlanır. Onlayn mərhələdə isə vasitə bu marşrutu izləyərkən sensor məlumatına görə yeni maneələri aşkarlayır, qısa müddətli idarəetmə qərarlarını yeniləyir və lazım olduqda nominal yoldan çıxıb yenidən eyni əhatə quruluşuna qayıdır.
Tədqiqatın sistem arxitekturasını göstərən Şəkil 4 bu ayrımı aydın şəkildə göstərir. Sol tərəfdə bölgə sərhədinin müəyyənləşdirilməsi, sweep-line yaradılması və nominal back-and-forth marşrutu; sağ tərəfdə feature detection/localization, MPC, policy update və Augmented Dubins Path komponentləri yerləşir.
Nominal əhatə marşrutu necə yaradılır?
Hədəf bölgə hesablama mürəkkəbliyini azaltmaq məqsədilə qeyri-müntəzəm kənarları olan, lakin konveks poliqon kimi modelləşdirilmişdir. Sweep istiqaməti müəyyənləşdirilərkən hər poliqon kənarından ən uzaq təpəyə olan məsafə hesablanır; namizəd maksimum enlər arasından ən kiçiyi əhatə xətlərinin istiqamətini müəyyən etmək üçün istifadə olunur.
Əldə olunan marşrut paralel skan xətlərindən ibarət klassik zigzag və ya back-and-forth quruluşudur. Hər sweep seqmentinin son nöqtəsi növbəti seqmentin başlanğıc istinadı kimi istifadə olunur.
Kamera əhatə xətlərinin intervalına necə təsir edir?
Tədqiqat qonşu uçuş xətləri arasındakı məsafəni kameranın baxış bucağı, təsvirlərin üst-üstə düşməsi və uçuş hündürlüyü ilə əlaqələndirir. Mənbədə xətt intervalı belə verilib:
\[ d= 2\frac{A(1-v)}{\tan(\mu)} \]
Burada \(A\) uçuş hündürlüyü, \(v\) tələb olunan görüntü overlap nisbəti və \(\mu\) kameranın şaquli baxış sahəsinin yarım bucağıdır. Verianla mənbə formulunu dəyişdirmədən təqdim edir.
Simulyasiyada necə bir sabit qanadlı platforma fərz edilib?
| Parametr | Mənbə dəyəri |
|---|---|
| PUA kütləsi | 3,9 kg |
| Minimum cruise sürəti | 10 m/s |
| Cruise hündürlüyü | 100 m |
| Endurance | 460 dəqiqə |
| Minimum dönmə radiusu | 28 m |
| Kamera fokus məsafəsi | 2,75 mm |
| Kamera sensoru | 6,45 × 3,63 mm |
| Kamera ayırdetməsi | 11,9 MP |
| Üfüqi / şaquli FoV | 102° / 67° |
| LiDAR maksimum məsafəsi | 60 m |
| LiDAR minimum məsafəsi | 0,05 m |
| LiDAR FoV | 70° |
| LiDAR skan tezliyi | 10 Hz |
Bu dəyərlər simulyasiyadakı agent və qavrayış sisteminin parametrləridir; tədqiqatda bu xüsusiyyətlərə malik fiziki hava vasitəsinin uçuş sınağı aparılmayıb.
Sabit qanadlı PUA-nın hərəkət modeli necə müəyyən edilib?
Ümumi üçölçülü kinematika mənbədə:
\[ \dot{x}=V\cos\theta\cos\psi \]
\[ \dot{y}=V\cos\theta\sin\psi \]
\[ \dot{z}=V\sin\theta \]
\[ \dot{\theta}=q \]
\[ \dot{\psi}=r= \frac{g\tan\phi} {V\cos\theta} \]
şəklində verilir.
Tədqiqatda uçuş hündürlüyü sabit qəbul edildiyi üçün \(\dot{z}=0\), \(\theta=0\) və \(q=0\) götürülmüş; idarəetmə problemi müstəvi hərəkətinə endirilmişdir. Bu sadələşdirmə real sabit qanadlı uçuşun tam altı sərbəstlik dərəcəli aerodinamik modelini təmsil etmir.
Mühit ssenariləri necə yaradılıb?
Tədqiqatda üç müxtəlif simulyasiya mühiti istifadə olunub:
- Scenario 1: statik və ya hərəkətli maneə olmayan baza mühiti.
- Scenario 2: əvvəlcədən bilinməyən statik poliqonal maneələr və hərəkətli maneə.
- Scenario 3: mühit mürəkkəbliyini artırmaq məqsədilə eyni bölgədə bir neçə dinamik maneə.
Hərəkətli maneələr qapalı trayektoriyalarda sabit 20 m/s sürətlə hərəkət edir. Statik maneələr həm konveks, həm də non-konveks poliqonlar şəklində yaradılıb.
Şəkil 3-də ikinci ssenaridə poliqon maneələrlə bir dinamik maneə, üçüncü ssenaridə isə müxtəlif qapalı trayektoriyalarda hərəkət edən çoxsaylı dinamik maneələr görünür.
Maneələr uçuş zamanı necə aşkarlanır?
Simulyasiya quruluşunda LiDAR mühitə dair məsafə/depth məlumatı yaradır. Şəkil 6 nümunə mühit təsvirinin yanında pixel-wise relative-depth xəritəsini göstərir. Yeni maneə aşkarlandıqda onun həndəsi məlumatı mühit modelinə əlavə edilir və MPC məhdudiyyətləri yenilənir.
Lakin bu LiDAR nəticələri real uçuşda qeydə alınmış sensor məlumatları deyil; simulyasiya mühitinin perception modelinin çıxışlarıdır.
MPC-nin vəzifəsi nədir?
Model Predictive Control hər idarəetmə addımında sonlu bir prediction horizon üzrə gələcək vəziyyətləri proqnozlaşdırır və ən uyğun idarəetmə ardıcıllığını yenidən hesablayır. Tədqiqatda davamlı sistem zero-order hold fərziyyəsi ilə diskretləşdirilmiş və vəziyyət fəzası modeli:
\[ X_{k+1}=A_kX_k+B_ku_k \]
\[ Y_k=C_kX_k \]
şəklində qurulmuşdur.
Planar halda vəziyyət vektoru mövqe və sürət komponentlərini, idarəetmə vektoru isə x və y istiqamətli idarəetmə girişlərini ehtiva edir.
Optimallaşdırma eyni zamanda nəyi azaltmağa çalışır?
CPP constrained Multi-Objective Optimization Problem kimi formullaşdırılmışdır. Mənbədəki birləşdirilmiş xərc:
\[ J= \sum_{k=1}^{N} \left\{ \|p_k-p_{ref}\| + Q_u\|u_k\| + Q_d\|d(p_k,Z)\| \right\} \]
şəklindədir.
Üç əsas komponent bunlardır:
- mövcud mövqe ilə hədəf/reference nöqtəsi arasındakı məsafə,
- idarəetmə səyi,
- nominal zigzag əhatə xəttindən cross-track sapma.
Tədqiqatda path deviation çəkisi \(Q_d=5\), control-effort çəkisi \(Q_u=2\) seçilib. Beləliklə nominal əhatə yoluna bağlılıq idarəetmə əmrinin kiçikliyindən daha yüksək çəki alır.
Maneə təhlükəsizliyi necə riyazi məhdudiyyətə çevrilir?
Statik poliqonal maneələr fiziki vasitə ölçüsünü və təhlükəsizlik məsafəsini əhatə edəcək şəkildə Minkowski sum yanaşması ilə genişləndirilir. Genişləndirilmiş təhlükəsizlik bölgəsi:
\[ O_i^{aug} = \left\{ P_i^{aug}\in\mathbb{R}^2 \mid dist(P_i^{aug},O_i)\leq\delta \right\} \]
kimi müəyyən edilir.
Optimallaşdırma parametrlərində statik maneə safety margin dəyəri 50 m, dinamik maneə radiusu 30 m və minimum separation distance 8 m-dir.
Tənlik uyğunluğu qeydi: Mənbənin Tənlik (11)-dəki dinamik maneə cəza ifadəsi ilə daha sonra birləşdirilmiş optimallaşdırmanı xülasə edən Tənlik (14)-dəki dinamik maneə ifadəsi eyni riyazi formada deyil. Verianla bu fərqi səssiz şəkildə tək bir tənliyə çevirmir.
Policy Gradient hissəsi necə işləyir?
Tədqiqatda PG metod mətni boyunca Policy Gradient yanaşmasını ifadə edir. Sistem vəziyyəti beş ayrı hərəkət əmrinin ehtimal paylanmasına çevrilir:
- sola dön,
- düz get,
- sağa dön,
- sürətlən,
- yavaşı.
Siyasət xətti funksiya yaxınlaşdırması ilə:
\[ h_u(X)=\eta(X)^T\vartheta_u \]
kimi müəyyən edilir və SoftMax istifadə edilərək hərəkət ehtimalları:
\[ Q(u|X)= \frac{e^{h_u(X)}} {\sum_{u'}e^{h_{u'}(X)}} \]
şəklində hesablanır.
Critic niyə əlavə edilib?
Saf Policy Gradient yenilənmələrində reward/cost siqnalının variasiyası yüksək ola bildiyi üçün tədqiqatda xətti value-function approximator istifadə olunub:
\[ V(X_k)=w^T\eta(X_k) \]
Temporal-Difference xətası:
\[ \delta_k= J_k+\lambda V(X_{k+1})-V(X_k) \]
kimi hesablanır.
Siyasət parametri isə:
\[ \vartheta_u \leftarrow \vartheta_u+ \alpha\delta_k \eta(X_k) \left( I(u_k)-Q(u_k|X_k) \right) \]
qaydası ilə yenilənir.
Tədqiqatçılar bu öyrənmə prosesinin əvvəlcədən toplanmış məlumat dəstinə və ya experience replay-ə ehtiyac olmadan onlayn baş verdiyini bildirirlər.
Augmented Dubins Path klassik Dubins-dən necə fərqlənir?
Klassik Dubins problemi sabit minimum dönmə radiusuna malik irəli hərəkət edən vasitənin iki konfiqurasiya arasındakı uyğun əyri kombinasiyalarından istifadə edir. Tədqiqat virtual waypoint əlavə etməklə mümkün trayektoriya ailəsini klassik altı tipdən on tipə çıxarır:
\[ D= \{ LSL,RSR,RSL,LSR,RLR,LRL, RLSLR,LRSRL,SLR,SRL \} \]
Yeni yollardan RLSLR və LRSRL dörd əyri + bir düz seqment; SLR və SRL isə iki əyri + bir düz seqment ehtiva edir.
Şəkil 7 bu virtual waypoint-lərin dönüşün daha gec başlanmasını və istiqamət dəyişikliklərinin waypoint yaxınlığındakı daha məhdud bölgələrdə həyata keçirilməsini təmin edən həndəsəsini göstərir.
ADP niyə mütləq daha qısa deyil?
Tədqiqatın öz nəticələri ADP-nin əsas məqsədinin minimum mütləq məsafə olmadığını göstərir. Əlavə virtual waypoint-lər və daha kinematik uyğun keçidlər cüzi məsafə və execution-time artımı yarada bilər.
| Smoothing | Scenario 1 müddət (s) | Scenario 2 müddət (s) | Scenario 3 müddət (s) | Scenario 1 məsafə (m) | Scenario 2 məsafə (m) | Scenario 3 məsafə (m) |
|---|---|---|---|---|---|---|
| DP | 27.223 | 27.447 | 27.990,30 | 272.233,4 | 274.474,5 | 279.903,1 |
| ADP | 27.294 | 27.532 | 28.127,72 | 272.937,3 | 275.325,7 | 281.277,21 |
Cədvəldəki nəticə ADP-nin üç ssenaridə də klassik DP-dən bir qədər daha uzun məsafə və müddət yaratmasına baxmayaraq, müəlliflərin qiymətləndirməsinə görə daha hamar və kinematik baxımdan daha tətbiqolunan lokal keçidlər yaratmasıdır.
Öyrənmə parametrləri necə seçilib?
Policy learning rate və discount factor birbaşa tək bir dəyər kimi fərz edilməyib; 100 simulyasiya işə salınmasına əsaslanan sensitivity analysis ilə qiymətləndirilib.
Learning rate üçün:
\[ 0.0001,\;0.0005,\;0.001,\;0.005,\;0.01 \]
dəyərləri; discount factor üçün:
\[ 0.90,\;0.93,\;0.96,\;0.99 \]
dəyərləri sınanıb.
Şəkil 9-dakı korrelyasiya xəritələri aşağı–orta öyrənmə sürətlərinin və 0,93–0,96 discount factor bölgəsinin cost ilə computation time arasında daha uyğun tarazlıq verdiyini göstərir. Yekun modeldə learning rate 0,001, discount factor 0,96 seçilib.
Simulyasiyadakı əsas optimallaşdırma parametrləri hansılardır?
| Parametr | Dəyər | İzah |
|---|---|---|
| Sampling time | 0,5 s | MPC idarəetmə yenilənmə intervalı |
| Prediction horizon | 100 | MPC proqnoz üfüqü |
| Policy learning rate | 0,001 | PG yenilənməsi |
| Discount factor | 0,96 | Gələcək TD təsirinin çəkisi |
| Minimum separation | 8 m | Maneə / agent təhlükəsizlik ayrımı |
| Control input aşağı həddi | −2 m/s² | Minimum acceleration command |
| Control input yuxarı həddi | 2 m/s² | Maksimum acceleration command |
| Statik maneə sayı | 4 | Poliqonal maneələr |
| Obstacle safety margin | 50 m | Statik maneə buffer məsafəsi |
| Dynamic obstacle radius | 30 m | Dinamik maneə modeli |
| Waypoint acceptance threshold | 20 m | Növbəti seqmentə keçid həddi |
| Control effort weight | 2 | \(Q_u\) |
| Path deviation weight | 5 | \(Q_d\) |
PG-MPC real vaxtlıdır?
Scenario 2-də öz real vaxt meyarını qarşılayır; Scenario 3-də ən pis hal isə 0,5 saniyəlik həddi aşır. Tədqiqatçılar bir idarəetmə dövrünün real vaxtlı sayılması üçün perception, optimization və control əməliyyatlarının cəminin sampling interval-i aşmamalı olduğunu bildirir. Sampling interval 0,5 saniyədir.
Şəkil 10-da Scenario 2 üçün maksimum computation time təxminən 0,36 saniyədir. Cədvəl 4 bu dəyəri 0,3621 saniyə kimi verir və 0,5 saniyəlik həddin altındadır.
Lakin Scenario 3 üçün PG-MPC maksimum dəyəri 0,5404 saniyədir. Buna görə tədqiqatın “real-time feasibility” nəticəsi ən çətin ssenaridə bütün idarəetmə dövrlərinin 0,5 saniyədən aşağı qaldığı mənasına gəlməməlidir.
Klassik NLP-MPC ilə PG-MPC arasındakı tam nəticələr nədir?
| Metrik | NLP-MPC S1 | NLP-MPC S2 | NLP-MPC S3 | PG-MPC S1 | PG-MPC S2 | PG-MPC S3 |
|---|---|---|---|---|---|---|
| Orta computation time (s) | 0,095 | 0,1618 | 0,1898 | 0,128 | 0,2000 | 0,1891 |
| Maksimum computation time (s) | 0,2295 | 0,7180 | 0,9157 | 0,2549 | 0,3621 | 0,5404 |
| Optimization convergence rate (%) | 99,993 | 92,30 | 91,919 | 99,993 | 96,87 | 94,34 |
| Constraint violation occurrence (%) | 0 | 5,67 | 3,2938 | 0 | 4,22 | 3,2864 |
Cədvəl təklif olunan metodun üstünlüyünün xüsusilə mürəkkəb ssenarilərdə pik emal yükünü məhdudlaşdırmaq və yaxınlaşma dərəcəsini artırmaq olduğunu göstərir. Bununla belə PG-MPC Scenario 1 və 2-də orta hesablama müddəti baxımından klassik NLP-MPC-dən daha sürətli deyil.
Constraint violation Scenario 2-də %5,67-dən %4,22-yə düşərkən Scenario 3-də %3,2938-dən %3,2864-ə yalnız çox kiçik dəyişiklik göstərir. Mənbə bu nəticələri improved constraint satisfaction kimi şərh edir; lakin ayrıca statistik əhəmiyyət testi təqdim edilmir.
Tədqiqatın dəstəklədiyi nəticələr
- Back-and-forth CPP, MPC, onlayn Policy Gradient yenilənməsi və augmented Dubins smoothing eyni simulyasiya çərçivəsində birlikdə tətbiq oluna bilib.
- Təklif olunan quruluş statik və dinamik maneələrin olduğu simulyasiyalarda nominal əhatə yolundan lokal olaraq çıxıb yenidən marşruta qayıda bilir.
- PG-MPC Scenario 2 və Scenario 3-də klassik NLP-MPC ilə müqayisədə maksimum hesablama müddətini azaldıb.
- Scenario 2-də convergence rate %92,30-dan %96,87-yə yüksəlib.
- Scenario 3-də convergence rate %91,919-dan %94,34-ə yüksəlib.
- Scenario 2-də constraint violation occurrence %5,67-dən %4,22-yə düşüb.
- Augmented Dubins yanaşması simulyasiya görüntülərində klassik Dubins ilə müqayisədə daha hamar və kinematik baxımdan daha tətbiqolunan lokal keçidlər yaradır.
- Scenario 2-də PG-MPC-nin maksimum emal müddəti 0,3621 s olmaqla 0,5 s nümunələmə periodunun altında qalıb.
Tədqiqatın dəstəkləmədiyi və ya sınaqdan keçirmədiyi nəticələr
- Metod real sabit qanadlı PUA üzərində uçuş sınağı ilə doğrulanmayıb.
- Real LiDAR səs-küyü, sensor gecikməsi və ya paket itkisi altında performans ölçülməyib.
- Real külək və atmosfer disturbance şəraitində fiziki uçuş uğuru göstərilməyib.
- Real aktuator doyma halları və aerodinamik model qeyri-müəyyənliyi aparat üzərində sınaqdan keçirilməyib.
- Birləşdirilmiş PG-MPC sisteminin qapalı dövrə sabitliyi üçün rigoröz nəzəri sübut verilməyib.
- Scenario 3-də bütün idarəetmə dövrlərinin 0,5 saniyəlik real vaxt həddinin altında qaldığı göstərilməyib; maksimum müddət 0,5404 s-dir.
- ADP-nin klassik Dubins yolundan daha qısa marşrut yaratdığı göstərilməyib; üç ssenaridə də kumulyativ məsafə bir qədər yüksəkdir.
- PG-MPC-nin klassik NLP-MPC-dən hər vəziyyətdə daha aşağı orta computation time təmin etdiyi göstərilməyib.
- Simulyasiya nəticələrinin real fəlakət, kənd təsərrüfatı və ya ekoloji monitorinq missiyalarına eyni performans rəqəmləri ilə ümumiləşdirilə biləcəyi sübut edilməyib.
- Tədqiqat tam altı sərbəstlik dərəcəli aerodinamik fixed-wing model istifadə etmir; idarəetmə problemi sabit hündürlüklü planar modelə endirilib.
Tədqiqatın Metodu və Nəticələri
Proqram təminatı və hesablama mühiti
Çərçivə MATLAB R2024b mühitində tətbiq olunub. Simulyasiyaların işə salındığı kompüter:
- 4,7 GHz Intel Core i7 prosessor,
- 16 GB RAM,
- NVIDIA RTX 3070 GPU
ehtiva edir. Mənbə kompüterin GPU-ya malik olduğunu bildirir; lakin bütün optimallaşdırma hesablamalarının GPU üzərində sürətləndirildiyini ayrıca göstərmir.
Oflayn planlaşdırma alqoritmi
Algorithm 1 konveks poliqonun hər kənarı ilə bütün təpələri arasındakı məsafəni hesablayır. Hər kənar üçün ən uzaq vertex seçilir və bu maksimum məsafələr arasından ən kiçiyi direction sweep orientation kimi istifadə olunur.
Kamera footprint eni və görüntü overlap tələbi istifadə edilərək paralel sweep xətləri bölgəyə yerləşdirilir. Nominal marşrut heç bir bilinməyən maneəni nəzərə almadan tam əhatə təmin etməyi hədəfləyir.
Onlayn PG-MPC dövrəsi
Onlayn sistem hər idarəetmə addımında əsasən bu əməliyyatları yerinə yetirir:
- Mövcud vəziyyət \(X_k\) alınır.
- Aşkar olunmuş statik və hərəkətli maneələr mühit modelinə əlavə edilir.
- Siyasət xüsusiyyətləri hesablanır.
- SoftMax üzərindən control action ehtimalları yaradılır.
- İdarəetmə girişi müəyyən edilir.
- Yeni vəziyyət proqnozlaşdırılır.
- Ani xərc hesablanır.
- TD error tapılır.
- Critic parametri yenilənir.
- Policy parametrləri yenilənir.
- Lokal yol Augmented Dubins həndəsəsi ilə hamarlanır.
Tədqiqat bu dövrəni onlayn learning kimi müəyyən edir və əvvəlcədən tam təlim keçmiş siyasət tələb etmədiyini bildirir.
Çoxaxınlı quruluş
PG-MPC tətbiqi optimization, perception və navigation modullarının eyni vaxtda işləməsini dəstəkləyən multi-threaded architecture kimi modelləşdirilib. Məqsəd real uçuş kompüterindəki asinxron tapşırıq quruluşunu təxmini təmsil etməkdir.
Lakin bu arxitektura fiziki avionics kompüterində işə salınmış Hardware-in-the-Loop və ya flight-test benchmark deyil.
Scenario 1 nə göstərir?
Maneəsiz baza ssenarisi framework-ün nominal əhatə naxışını izləməsini sınayır. Klassik və təklif olunan optimizer üçün hər ikisində convergence rate %99,993 və constraint violation %0-dır.
Bu ən asan halda PG-MPC-nin maksimum hesablama müddəti 0,2549 s, NLP-MPC-nin 0,2295 s dəyərindən bir qədər yüksəkdir. Buna görə təklif olunan PG yenilənməsinin asan mühitdə birbaşa sürət üstünlüyü yoxdur.
Scenario 2 nə göstərir?
Statik və hərəkətli maneələr əlavə edildikdə classical NLP-MPC-nin maksimum computation time dəyəri 0,718 s-yə yüksəldiyi halda PG-MPC 0,3621 s-də qalır.
Convergence rate eyni ssenaridə %92,30-dan %96,87-yə, constraint violation dəyəri %5,67-dən %4,22-yə dəyişir.
Bu ssenari tədqiqatın “peak computation burden” baxımından ən aydın üstünlüklərindən birini göstərir.
Scenario 3 nə göstərir?
Çoxsaylı dinamik maneələrin olduğu üçüncü ssenari ən çətin şərtdir. Klassik NLP-MPC-nin maksimum hesablama müddəti 0,9157 s, PG-MPC-ninki 0,5404 s-dir.
Mənbə bu dəyişimi təxminən %41,1 azalma kimi təqdim edir. PG-MPC böyük pik müddət üstünlüyü versə də, 0,5404 s dəyəri 0,5 s sampling interval-dan yüksəkdir. Buna görə tədqiqat daxilində müəyyən edilən sərt real vaxt meyarı baxımından təkil worst-case aşımı var.
Yaxınlaşma dərəcəsi %91,919-dan %94,34-ə yüksəlmiş; constraint violation occurrence isə %3,2938-dən %3,2864-ə çox cüzi azalmışdır.
Şəkil 10-un əsas mesajı nədir?
Şəkil 10 mühitdə müəyyən maneə bölgələrinin yaxınlığında hesablama müddətinin və objective cost-un yüksəldiyini göstərir. Bu nöqtələr controller-in birbaşa nominal yolu izləmək əvəzinə collision avoidance və feasibility şərtlərinə prioritet verdiyi bölgələrdir.
Hesablama yükünün mühit boyunca sabit olmaması metodun worst-case müddətinin orta müddətdən niyə daha vacib olduğunu da göstərir. Real vaxtlı flight-control tətbiqində idarəetmə dövrəsinin deadline-ını müəyyən edən metrik çox vaxt orta deyil, pik hesablama müddətidir.
Şəkil 11 nə göstərir?
Şəkil 11 üç ssenaridə MPC-ADP və MPC-DP yollarını yan-yana müqayisə edir. Maneəsiz halda hər iki quruluş nominal sweep pattern-ə yaxın irəliləyir. Statik və dinamik maneələr əlavə ediləndə lokal sapmalar yaranır.
Yaxınlaşdırılmış bölgələrdə ADP dönüşlərinin klassik DP ilə müqayisədə daha tədrici görünməsi müəlliflərin “smoother and dynamically feasible” şərhinin vizual əsasını təşkil edir.
Bununla belə eyni tədqiqatın Cədvəl 4-ü ADP-nin ümumi məsafəsini üç ssenarinin hamısında bir qədər artırdığını göstərir. Şəkildəki hamarlıq ilə ümumi yol uzunluğu eyni performans ölçüsü deyil.
Metodun əsas trade-off-u nədir?
Tədqiqatın məlumatları tək bir “hər baxımdan daha yaxşı” alqoritm nəticəsi vermir. Təklif olunan metod xüsusilə mürəkkəb maneə mühitlərində peak optimisation time və convergence baxımından üstünlük göstərir; lakin onlayn policy update bəzi ssenarilərdə orta hesablama yükünü artırır.
Eyni şəkildə Augmented Dubins marşrut həndəsəsi daha hamar və kinematik baxımdan tətbiqolunan keçidlər təmin edərkən az miqdarda əlavə məsafə və execution time yaradır.
Beləliklə çərçivənin əsas mühəndislik kompromisi sırf minimum hesablama müddəti və ya minimum məsafə əvəzinə əhatə davamlılığı + kinematik tətbiqolunma + dinamik maneəyə uyğunlaşma kombinasiyasına prioritet verməsidir.
Tədqiqatın güclü tərəfləri
- Əhatə planlaşdırması və onlayn idarəetməni tək optimallaşdırma quruluşunda birləşdirir.
- Sabit qanadlı vasitənin minimum dönmə davranışını Dubins həndəsəsi ilə açıq şəkildə nəzərə alır.
- Bilinməyən statik və dinamik maneələri eyni çərçivədə emal edir.
- Policy Gradient-i MPC yenilənməsinə birbaşa inteqrasiya edir.
- Öyrənmə sürəti və discount factor üçün sensitivity analysis aparır.
- Klassik NLP-MPC ilə eyni şəraitdə kəmiyyət müqayisəsi təqdim edir.
- Average və maximum computation time dəyərlərini ayrıca bildirir.
- Convergence və constraint violation göstəricilərini birlikdə verir.
- DP və ADP smoothing xərclərini ayrıca müqayisə edir.
Tədqiqatın əsas məhdudiyyətləri
- Bütün doğrulama simulyasiyadır.
- Fiziki fixed-wing UAV uçuş sınağı yoxdur.
- Real sensor noise və communication delay sınaqdan keçirilməyib.
- Külək və real atmosfer disturbance gələcək tədqiqata saxlanıb.
- Aktuator qeyri-müəyyənlikləri və real flight-computer deadline davranışı sınaqdan keçirilməyib.
- Model sabit hündürlüklü, aşağı dəqiqlikli planar dynamics yanaşması istifadə edir.
- Qapalı dövrə PG-MPC sabitliyinin rigoröz nəzəri analizi aparılmayıb.
- Scenario 3 worst-case müddəti 0,5 s idarəetmə periodunun üzərindədir.
- ADP az da olsa əlavə yol uzunluğu və execution time yaradır.
- Tədqiqat başlığındakı “Partial Gradient” ilə metod daxilindəki “Policy Gradient” terminologiyası uyğun gəlmir.
Gələcək tədqiqatlar hansı problemləri həll etməlidir?
Müəlliflər metodun real sabit qanadlı platformalarda tətbiqini mühüm gələcək addım kimi göstərirlər. Bu doğrulamanın külək pozuntuları, sensor səs-küyü, communication delays və actuator uncertainties ehtiva etməsi tövsiyə olunur.
Tədqiqat həmçinin birləşdirilmiş PG-MPC quruluşunun rigorous closed-loop stability analysis-nin aparılmadığını açıq şəkildə qəbul edir və bunu nəzəri gələcək iş istiqaməti kimi müəyyənləşdirir.
Əlavə olaraq Sliding Mode Control kimi robust nonlinear control yanaşmalarının disturbance rejection və model uncertainty dayanıqlığını artırmaq üçün çərçivəyə inteqrasiyası təklif olunur.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: Real-Time Coverage Path Planning for Fixed-Wing Aerial Robots Using Partial Gradient-Based MPC and Augmented Dubins Trajectories
Müəlliflər: Mohammad Khaneghaei; Benyamin Ebrahimi; Davood Asadi; Onder Tutsoy; Seyed-Yaser Nabavi-Chashmi; Hassan Haghighi.
Müəllif sırası: Mənbədəki orijinal sıra eynilə qorunub.
Bərabər töhfə/bərabər birinci müəllif: Mənbədə qeyd edilməyib.
Məsul müəllif: Davood Asadi.
Qurumlar: Department of Electrical Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; Department of Aerospace Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; College of Arts, Technology and Environment, University of the West England, Bristol, UK; Department of Aeronautical Engineering, Gebze Technical University, Gebze, Türkiye; Laboratoire d’Informatique et Systèmes, Aix-Marseille University, Marseille, France.
Afiliyasiya qeydi: Mənbənin üçüncü afiliasiyası “University of the West England” formasında verilib. Verianla biblioqrafik qeydi mənbədə olduğu şəkildə qoruyub və qurum adını səssizcə yenidən yazmayıb.
Başlıq terminologiyası qeydi: Orijinal başlıq “Partial Gradient-Based MPC” ifadəsini istifadə edir. Məqalə gövdəsindəki PG metodu isə “Policy Gradient” kimi müəyyən edilir və tənliklər bu yanaşmaya əsasən qurulur. Verianla orijinal başlığı dəyişməyib.
Mənbə növü: Hakemli tədqiqat məqaləsi; alqoritm inkişafı və simulyasiya əsaslı müqayisəli doğrulama işidir.
Jurnal: Aerospace
Nəşriyyat: MDPI
Cild / say / məqalə nömrəsi: 13(8), 713
Nəşr tarixi: 9 avqust 2026
DOI: 10.3390/aerospace13080713
Rəsmi nəşr bağlantısı: https://www.mdpi.com/2226-4310/13/8/713
DOI bağlantısı: https://doi.org/10.3390/aerospace13080713
Hakemlik vəziyyəti: Tədqiqat hakemli Aerospace jurnalında dərc edilmiş tədqiqat məqaləsidir.
Lisenziya: Creative Commons Attribution (CC BY) açıq giriş lisenziyası.
Maliyyələşdirmə: Tədqiqat Türkiyə Elmi və Texnoloji Tədqiqat Şurası (TÜBİTAK) tərəfindən 125M675 və 223M312 nömrəli dəstəklər çərçivəsində maliyyələşdirilib.
Məlumat əlçatanlığı: Məlumatların sorğu əsasında təqdim ediləcəyi bildirilib.
Maraqlar toqquşması: Müəlliflər məlum rəqabətli maliyyə marağı və ya tədqiqata təsir edə biləcək şəxsi münasibət bildirməyiblər.
Müəllif töhfələri: Mohammad Khaneghaei; nəzərdən keçirmə və redaktə, ilk layihə, vizuallaşdırma, doğrulama, metodologiya, resurslar, tədqiqat, formal analiz, məlumat kurasiyası və konseptuallaşdırma. Benyamin Ebrahimi; nəzərdən keçirmə və redaktə, ilk layihə, vizuallaşdırma, doğrulama, metodologiya, tədqiqat, formal analiz, məlumat kurasiyası və konseptuallaşdırma. Davood Asadi; nəzərdən keçirmə və redaktə, ilk layihə, nəzarət, tədqiqat, formal analiz, məlumat kurasiyası və konseptuallaşdırma. Onder Tutsoy; nəzərdən keçirmə və redaktə, ilk layihə, doğrulama, metodologiya, resurslar və nəzarət. Seyed-Yaser Nabavi-Chashmi; nəzərdən keçirmə və redaktə, doğrulama və nəzarət. Hassan Haghighi; nəzərdən keçirmə və redaktə və doğrulama.
Simulyasiya səviyyəsi: Bütün müqayisələr MATLAB R2024b-də aparılan simulyasiyalara əsaslanır. Tədqiqat real sabit qanadlı PUA uçuş eksperimenti, hardware-in-the-loop sınağı və ya sahə nümayişi ehtiva etmir.
Real vaxtlılıq həddi: Mənbə real vaxt meyarını computation/control müddətinin 0,5 s sampling interval-i aşmaması kimi müəyyən edir. PG-MPC Scenario 2-də 0,3621 s maksimum dəyərlə bunu qarşılayır; Scenario 3-də 0,5404 s maksimum dəyərlə həddin üzərində qalır. Buna görə Verianla “bütün ssenarilərdə hər idarəetmə addımı qəti şəkildə real vaxtlıdır” ifadəsini istifadə etmir.
Tənlik uyğunluğu qeydi: Mənbənin dinamik obstacle penalty termini Tənlik (11) ilə birləşdirilmiş problem ifadəsi Tənlik (14)-də eyni riyazi formada təqdim edilmir. Verianla bu fərqi fərziyyə ilə düzəltməyib.
ADP şərh həddi: Augmented Dubins Path-in üstünlüyü daha hamar və kinematik baxımdan tətbiqolunan transition yaratmasıdır. Mənbənin Cədvəl 4 dəyərləri ADP-nin üç ssenaridə də klassik DP-dən bir qədər daha yüksək kumulyativ məsafə və execution time yaratdığını göstərir.
Sabitlik həddi: Müəlliflər birləşdirilmiş PG-MPC sisteminin closed-loop stability-si üçün rigoröz nəzəri analiz təqdim etmədiklərini və bunu gələcək iş kimi saxladıqlarını açıq şəkildə bildirirlər.
Elmi hədd: Model nəticələri sintetik statik/dinamik maneələr, ideallaşdırılmış perception modeli və sabit hündürlüklü planar fixed-wing dinamikası altında əldə olunub. Real külək, sensor noise, communication delay, actuator uncertainty və fiziki uçuş sistemi təsirləri eksperimental olaraq qiymətləndirilməyib.
Məzmun istehsal üsulu: Bu Verianla izahındakı elmi metod, tənliklər, simulyasiya parametrləri, performans göstəriciləri, şəkil şərhləri və məhdudiyyətlər yüklənmiş mənbə tədqiqata əsaslanır. Xarici doğrulama yalnız biblioqrafik kimlik, rəsmi nəşr qeydi və hakemlik məlumatının yoxlanması üçün istifadə olunub; xarici mənbələrdən yeni elmi performans nəticəsi və ya mənbədə olmayan alqoritmik nəticə əsas mətnə əlavə edilməyib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib