

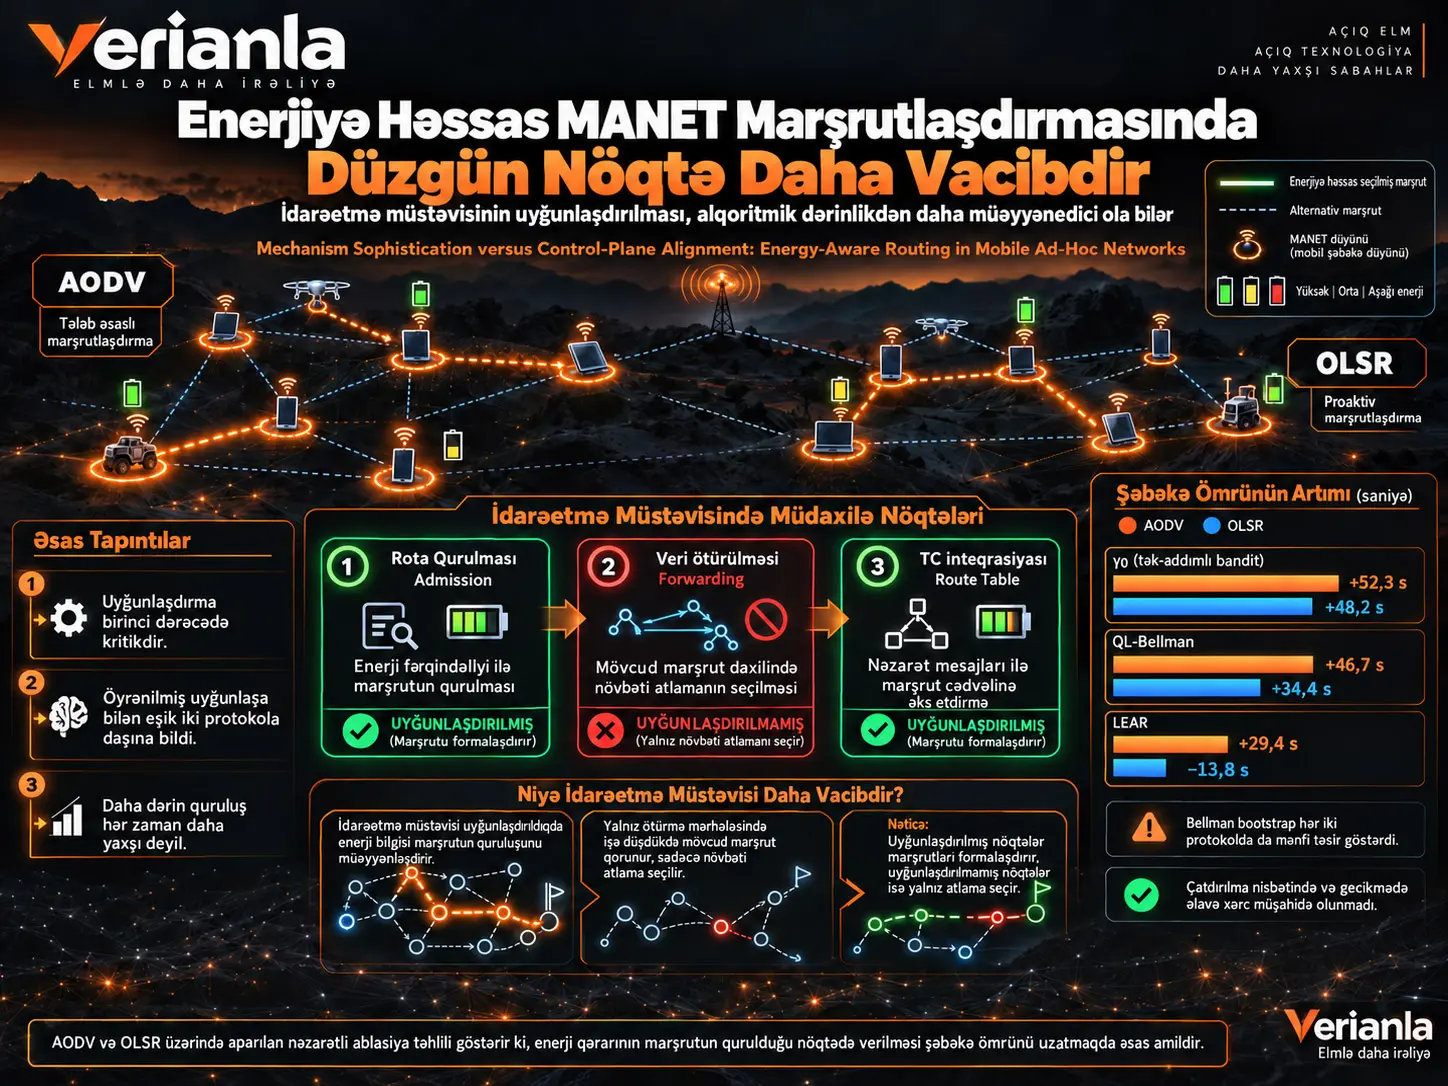
Mobil ad hoc şəbəkələrdə enerjiyə qənaət üçün hazırlanmış marşrutlaşdırma mexanizmləri getdikcə daha mürəkkəb öyrənmə üsullarından istifadə edə bilir. Lakin bir mexanizmin şəbəkənin ömrünü uzatması həqiqətən onun nə qədər təkmil olmasından qaynaqlanır, yoxsa enerji qərarının marşrutlaşdırma protokolunun düzgün nöqtəsində tətbiq edilməsi daha vacibdir? Bu tədqiqat bu iki təsiri bir-birindən ayırmaq üçün AODV və OLSR protokolları üzərində nəzarətli ablasiya təhlili aparır.
Tədqiqatın əsas anlayışı idarəetmə müstəvisinin uyğunlaşdırılmasıdır. Enerji qərarı protokolun marşrutları yaratdığı və ya route table-ı formalaşdırdığı nöqtədə tətbiq edilirsə, uyğunlaşdırılmış hesab olunur. AODV-də bu nöqtə RREQ mesajlarının qəbul edilməsi və yenidən yayımlanması zamanı ortaya çıxır. OLSR-də isə enerji qərarının MPR seçiminə təsir edən willingness mexanizminə və ya topology-control məlumatının route table-a inteqrasiyasına bağlanması lazımdır. Bunun əksinə, məlumat paketinin ötürülməsi zamanı edilən next-hop dəyişikliyi marşrut artıq yaradıldığı üçün struktur baxımından daha gec müdaxilədir.
Müəlliflər uyğunlaşdırılmış və öyrənən enerji veto mexanizmi olan QL-Bellman-ı başlanğıc nöqtəsi kimi götürürlər. Daha sonra hərəkət, enerji məlumatı, uyğunlaşdırma, öyrənmə və Bellman bootstrap kimi komponentləri bir-bir çıxararaq şəbəkə ömrü qazancını hansı xüsusiyyətin daşıdığını ölçürlər. Təcrübələr ns-3 üzərində 50 mobil düyün, altı trafik yükü və hər şərt üçün 20 cütləşdirilmiş təsadüfi toxumla aparılır.
Nəticələr mexanizmin düzgün idarəetmə nöqtəsində yerləşməsinin birinci dərəcəli əhəmiyyət daşıdığını göstərir. Öyrənilmiş adaptiv enerji həddi həm AODV, həm də OLSR-də ömür müddətini artırdığı halda, sabit həddli LEAR AODV-də faydalı olsa da OLSR-də ömür müddətini azaldır. Daha əhəmiyyətlisi, qonşunun dəyərini gələcəyə daşıyan Bellman bootstrap hər iki protokolda performansı aşağı salır. Bu eksperimental rejimdə ən yüksək orta ömür müddəti bootstrap-ı aradan qaldıran \(\gamma=0\) biraddımlı bandit versiyası ilə əldə edilir.
İdarəetmə müstəvisi ilə verilənlər müstəvisi arasındakı fərq
Marşrutlaşdırma protokolunda idarəetmə müstəvisi hansı marşrutların mövcud olacağını və şəbəkədə marşrutlaşdırma məlumatının necə yaradılacağını müəyyən edən mexanizmlərdən ibarətdir. Verilənlər müstəvisi isə yaradılmış bu marşrutlaşdırma qərarlarından istifadə edərək real paketlərin daşınmasını həyata keçirir.
Enerjiyə həssas mexanizmin hansı müstəvidə və hansı mərhələdə işləməsi buna görə vacibdir. Bir düyün enerjisi az olduğu üçün marşrut yaradılmamışdan əvvəl namizəd yoldan çıxarılırsa, sonrakı bütün məlumat trafikinin istifadə edəcəyi marşrutlar çoxluğu dəyişir. Eyni enerji məlumatı paket ötürülməsi zamanı istifadə olunursa, mexanizm artıq hansı marşrutların mövcud olduğunu dəyişə bilməz; yalnız əvvəldən yaradılmış seçimlər arasında qərar verə bilər.
İdarəetmə Müstəvisinin Uyğunlaşdırılması Nə Deməkdir?
Tədqiqatda mexanizm, onun hərəkət nöqtəsi protokolun marşrut yaratma və ya route-state yaratma mərhələsi ilə üst-üstə düşürsə, uyğunlaşdırılmış hesab olunur. Bu, sadəcə yaxşı mövqe seçimi deyil; hərəkət nöqtəsinin mexanizmin səbəb-nəticə funksiyasını dəyişdirdiyi irəli sürülür.
AODV-də uyğunlaşdırma
AODV reaktiv protokoldur. Ehtiyac yarandıqda marşrut kəşfi aparılır və RREQ mesajları şəbəkədə yayımlanaraq mümkün yollar yaradılır.
Enerji veto mexanizmi düyünün RREQ mesajını qəbul edib yenidən yayımlayıb-yayımlamayacağını müəyyən edirsə, aşağı enerjili düyün namizəd yolun içinə ümumiyyətlə daxil olmaya bilər. Beləliklə, enerji qərarı birbaşa hansı marşrutların mövcud olacağını formalaşdırır.
Tədqiqatın uyğunlaşdırılmış AODV mexanizmləri bu nöqtədə işləyir.
OLSR-də uyğunlaşdırma
OLSR isə proaktiv protokoldur. Marşrutları tələb üzrə kəşf etmək əvəzinə topologiya məlumatını davamlı saxlayır və Multipoint Relay (MPR) strukturundan istifadə edir.
Buna görə AODV-dəki RREQ veto mexanizmini OLSR-yə sözbəsöz köçürmək mümkün deyil. Funksional olaraq uyğun gələn idarəetmə nöqtələri enerji səviyyəsinin MPR seçiminə təsir edən willingness mexanizminə və topology-control məlumatının yerli route table-a inteqrasiyasına bağlanmasıdır.
Bu fərq məqalənin əsas iddiasını təşkil edir: alqoritmin protokollar arasında daşına bilməsini yalnız qərar qaydasının eyni olmasına baxaraq qiymətləndirmək kifayət deyil; qərarın yeni protokolda hələ də marşrut yaratma nöqtəsinə toxunub-toxunmadığı yoxlanmalıdır.
Yanlış yerdə işləyən mexanizm
Mənbədə override variantı enerji qərarını AODV-də data-forwarding mərhələsinə keçirir. Burada enerji məlumatı hələ də mövcuddur və öyrənmə mexanizmi hələ də işləyə bilər; lakin marşrut daha əvvəl qurulub.
Bu variant yalnız mövcud marşrutlar arasında next-hop reselection edə bilər. Təcrübələrdə ömür müddəti qazancının böyük ölçüdə itməsi müəlliflərin uyğunlaşdırmanı yalnız hiperparametr deyil, mexanizmin nə edə bildiyini müəyyən edən struktur xüsusiyyət kimi şərh etməsinin əsas dayaqlarından biridir.
QL-Bellman Enerji Veto Mexanizmi Necə İşləyir?
İstinad mexanizmi enerji vəziyyətini bir neçə kobud sinfə ayıran və iki hərəkət arasında onlayn öyrənmə aparan paylanmış admission-control sistemidir. Hərəkətlər sadədir: daxil olan idarəetmə mesajını qəbul etmək və ya veto etmək.
Enerji vəziyyətinin diskretləşdirilməsi
Normallaşdırılmış enerji
\[ e\in[0,1] \]
dörd kobud vəziyyətə ayrılır:
\[ s=\lfloor 4e\rfloor. \]
Dörd vəziyyətdən istifadə şüurlu seçimdir. Vəziyyətlər çox incə bölünərsə, hər vəziyyətə daha az baş çəkilir və onlayn öyrənmə üçün kifayət qədər nümunə yaranmaya bilər.
Mükafat siqnalı
Enerjidən asılı mükafat üç səviyyəlidir:
\[ r= \begin{cases} +1, & e\geq\theta_{\mathrm{hi}},\\ -1, & e<\theta_{\mathrm{lo}},\\ 0, & \text{diğer durumlarda}. \end{cases} \]
Mənbədə
\[ \theta_{\mathrm{hi}}=0.66, \qquad \theta_{\mathrm{lo}}=0.33 \]
istifadə olunur.
Bellman yenilənməsi
Qəbul hərəkəti üçün:
\[ q_{\mathrm{acc}} \leftarrow (1-\alpha)q_{\mathrm{acc}} + \alpha \left( r+\gamma V_{\mathrm{nbr}} \right), \]
veto hərəkəti üçün isə:
\[ q_{\mathrm{veto}} \leftarrow (1-\alpha)q_{\mathrm{veto}} + \alpha(-r). \]
Buradakı
\[ \gamma V_{\mathrm{nbr}} \]
termini qonşu düyünün dəyərini cari qərara daşıyan Bellman bootstrap-dır.
Əsas QL-Bellman konfiqurasiyasında
\[ \alpha=0.3,\qquad \gamma=0.9 \]
istifadə olunur.
\(\gamma=0\) edildikdə gələcək/qonşu dəyərinin bootstrap təsiri tamamilə aradan qaldırılır və mexanizm biraddımlı bandit halına gəlir.
Tədqiqatın Metodu və Nəticələri
Ablasiya dizaynı
| Variant | Enerji siqnalı | Düzgün hərəkət nöqtəsi | Öyrənmə | Bellman bootstrap | Sınaqdan keçirilən fikir |
|---|---|---|---|---|---|
| Vanilla | Yoxdur | Yoxdur | Yoxdur | Yoxdur | Dəyişdirilməmiş protokol |
| QL-Bellman | Var | Var | Var | Var | Tam istinad mexanizmi |
| LEAR | Var | Var | Yoxdur | Yoxdur | Sabit hədd |
| \(\gamma_0\) | Var | Var | Var | Yoxdur | Bootstrap lazımdırmı? |
| veto-off | Var | Var | Var | Var | Öyrənmək, amma hərəkət etməmək |
| blind | Təsadüfi | Var | Xeyr | Xeyr | Enerji məlumatının dəyəri |
| override | Var | Yanlış / forwarding | Var | Var | Hərəkət nöqtəsinin təsiri |
Niyə klassik “alqoritm yarışı” aparılmır?
Tədqiqatda müxtəlif proqram sistemlərinin nəticələrini yan-yana qoymaq əvəzinə eyni kod bazasında compile-time flag-lərlə xüsusiyyətlər açılıb-söndürülür. Bütün flag-lər söndürüləndə binar faylın dəyişdirilməmiş ns-3 protokolu ilə byte-identical olduğu yoxlanılıb.
Bundan əlavə, variantlar eyni təsadüfi toxumlarla cütləşdirilib. Beləliklə, eyni seed bütün variantlarda eyni hərəkətliliyi və başlanğıc enerji şərtlərini yaradır. Fərq ölçümü:
\[ \Delta HND = HND_{\mathrm{varyant}} - HND_{\mathrm{vanilla}} \]
şəklində eyni eksperimental şəraitdəki cütləşdirilmiş fərq üzərindən aparılır.
ns-3 eksperimental mühiti
| Parametr | Dəyər |
|---|---|
| Simulyator | ns-3.46.1 |
| Düyün sayı | 50 |
| Sahə | 1000 × 1000 m |
| Hərəkət | Random Waypoint |
| Sürət | 1–5 m/s |
| Gözləmə | 0–2 s |
| Radio | IEEE 802.11g, 54 Mbps |
| Məsafə modeli | 250 m cap |
| Paket | 512 B UDP |
| Trafik | Axın başına 4 paket/s |
| Axın sayları | 10, 15, 20, 25, 30, 35 |
| Başlanğıc enerjisi | 3,3–3,7 J |
| Müddət | 500 s |
| Təsadüfi toxum | Hər xana üçün 20 |
Half-Node-Death niyə istifadə olunur?
Əsas performans ölçüsü Half-Node-Death (HND), yəni 50 düyünlü şəbəkədə 25-ci düyünün öldüyü vaxtdır.
Bir düyünün qeyri-adi dərəcədə erkən və ya gec ölməsinə həddindən artıq həssas olmadığı üçün şəbəkənin istismar ömrünü təmsil edən daha ümumi end-of-life ölçüsüdür.
Mənbədə ümumilikdə 1560 eksperimental xananın hamısında 25-ci düyün 500 saniyəlik sınaq bitməmiş ölüb. Buna görə HND nəticəsi senzuralaşdırılmayıb və ya təxmin edilməyib.
Ömür müddəti nəticələri
| Mexanizm | AODV ΔHND | OLSR ΔHND |
|---|---|---|
| \(\gamma_0\) biraddımlı bandit | +52,3 s | +48,2 s |
| QL-Bellman | +46,7 s | +34,4 s |
| LEAR | +29,4 s | −13,8 s |
| Blind veto | +12,2 s | +4,9 s |
| Veto-off | +0,4 s | −0,3 s |
| Override | −2,6 s | Mənbədə yalnız AODV |
Ən Böyük Qazanc Alqoritmik Dərinlikdənmi Gəlir?
Bu təcrübələrdə yox. Ən yüksək ömür müddəti qazancını tam Bellman yenilənməsi deyil, qonşu dəyərini bootstrap etməyən \(\gamma=0\) biraddımlı bandit versiyası təmin edib. Lakin bu nəticə “gücləndirici öyrənmə lazımsızdır” demək deyil. Sabit hədd əvəzinə adaptiv öyrənilmiş qərar qaydası xüsusilə OLSR-də kritik töhfə verib.
AODV üçün töhfələrin ayrılması
Mənbənin additive scale təhlili:
\[ \underbrace{+29.4}_{\text{hizalanmış sabit veto}} + \underbrace{22.9}_{\text{öğrenilmiş kural}} - \underbrace{5.6}_{\text{Bellman bootstrap}} = \underbrace{46.7}_{\text{QL-Bellman toplamı}} \quad\mathrm{s} \]
şəklindədir.
Yəni AODV-də düzgün nöqtəyə enerji həddi qoymaq böyük ilkin qazanc yaradır; öyrənmə bunun üzərinə əlavə qazanc gətirir; çoxaddımlı bootstrap isə bu qazancın bir hissəsini geri alır.
OLSR üçün töhfələrin ayrılması
OLSR-də öyrənilmiş, uyğunlaşdırılmış TC veto:
\[ +48.2\ \mathrm{s} \]
qazanc təmin edərkən Bellman bootstrap:
\[ -13.8\ \mathrm{s} \]
töhfə verir və ümumi QL-Bellman qazancı:
\[ +34.4\ \mathrm{s} \]
olur.
OLSR-dəki sabit LEAR willingness yanaşması isə ayrıca mexanizm kimi
\[ -13.8\ \mathrm{s} \]
nəticəsini verir.
Bellman bootstrap niyə zərər vermiş ola bilər?
Mənbənin izahında iki struktur səbəb önə çıxır:
- Hərəkət yalnız admit və ya veto şəklində ikilidir; buna görə uzun çoxaddımlı dəyər zəncirinin istifadə edə biləcəyi zəngin qərar strukturu olmaya bilər.
- Mobil və davamlı enerji sərf edən şəbəkədə qonşunun öyrənilmiş dəyəri zamanla sürətlə köhnələ bilər. Bootstrap bu köhnə dəyəri hop-lar boyunca yayaraq əlavə səs-küy yarada bilər.
Buna görə tədqiqat şəraitində dayaz, biraddımlı öyrənmə daha sabit iş nöqtəsi yaradıb.
Sabit Enerji Həddi Niyə AODV-də İşlədiyi Halda OLSR-də Çökür?
LEAR-ın AODV-də +29,4 saniyə ömür müddəti qazancı təmin edib OLSR-də −13,8 saniyəyə düşməsi eyni tip enerji həddinin müxtəlif protokol ailələrinə birbaşa daşınmaya biləcəyini göstərir. Mənbə bunu yalnız pis hədd tənzimlənməsi ilə izah etmir; OLSR willingness həddi 0,1 ilə 0,5 arasında skan edildikdə bütün sabit dəyərlərin ömür müddətini azaltdığı bildirilir.
Öyrənilmiş \(\gamma_0\) veto isə yenidən tənzimləmə aparılmadan:
\[ +52.3\ \mathrm{s} \]
AODV və
\[ +48.2\ \mathrm{s} \]
OLSR qazancı təmin edir.
Buna görə tədqiqatın “rule quality” nəticəsi öyrənilmiş adaptiv həddin sabit həddə nisbətən protokol dəyişikliyinə daha dayanıqlı olduğunu göstərir.
Uyğunlaşdırmanın statistik təsiri
| Protokol | Lever | Orta ΔHND | %95 etibar intervalı | p | Cliff's δ |
|---|---|---|---|---|---|
| AODV | Alignment | +46,3 s | [+41,2, +51,3] | <10⁻⁴ | +1,00 |
| AODV | Point | +49,3 s | [+44,0, +54,4] | <10⁻⁴ | +1,00 |
| AODV | Intelligence | +34,5 s | [+29,9, +39,2] | <10⁻⁴ | +1,00 |
| AODV | Rule quality | +17,3 s | [+13,4, +21,9] | <10⁻⁴ | +1,00 |
| AODV | Bellman bootstrap | −5,5 s | [−9,0, −2,2] | 0,0037 | −0,60 |
| OLSR | Alignment | +34,8 s | [+28,7, +40,9] | <10⁻⁴ | +1,00 |
| OLSR | Rule quality | +48,2 s | [+42,0, +54,6] | <10⁻⁴ | +1,00 |
| OLSR | Bellman bootstrap | −13,7 s | [−16,8, −10,7] | <10⁻⁴ | −1,00 |
\(\delta=+1\), müqayisə edilən 20 cütləşdirilmiş seed-in hamısının eyni istiqamətdə nəticə verdiyini göstərir. Buna görə uyğunlaşdırma, enerji məlumatından istifadə və öyrənilmiş qayda kimi böyük təsirlər yalnız ortalamadakı bir neçə kənar şərtdən qaynaqlanmayıb.
Daha Uzun Şəbəkə Ömrü Paket Çatdırılmasından Güzəştə Getməkləmi Əldə Edilir?
Mənbədə araşdırılan müsbət ömür müddəti mexanizmləri üçün belə bir mübadilə müşahidə edilməyib. PDR dəyişikliyi ya müsbət, ya da statistik baxımdan neytraldır; end-to-end delay də əsas enerjiyə həssas iş nöqtələrində neytral və ya daha aşağıdır.
PDR üzərində uyğunlaşdırma təsiri
AODV üçün uyğunlaşdırma:
\[ \Delta PDR=+1.77 \]
faiz bəndi; OLSR üçün:
\[ \Delta PDR=+1.07 \]
faiz bəndi kimi bildirilir.
AODV-də aşağı dəyərli RREQ trafikin budanması simsiz mühitdə toqquşma və congestion yükünü azalda bilər. OLSR-də isə TC veto flooding miqdarını eyni şəkildə azaltmadığı üçün mənbənin şərhi daha çox trafikin enerjisi tükənən düyünlərdən uzaqlaşdırılmasıdır.
Gecikmə nəticəsi
\(\gamma_0\) variantı AODV-də vanilla ilə müqayisədə:
\[ -1.48\ \mathrm{ms} \]
fərq yaradıb, lakin etibar intervalı sıfırı ehtiva etdiyinə görə əhəmiyyətli yavaşlama və ya sürətlənmə göstərilməyib.
OLSR-də isə:
\[ -2.08\ \mathrm{ms} \]
və %95 etibar intervalı
\[ [-3.01,-1.19]\ \mathrm{ms} \]
kimi bildirilir; yəni bu tədqiqat şəraitində daha sürətlidir.
Bunun əksinə, AODV-də yanlış uyğunlaşdırılmış override təxminən +5,45 ms, signal-blind veto isə +4,69 ms gecikmə əlavə edib.
Tədqiqatın dəstəklədiyi nəticələr
- Araşdırılan AODV və OLSR arxitekturalarında enerji qərarının route-construction ilə uyğunlaşdırılması şəbəkə ömrü qazancının böyük və zəruri komponentidir.
- Yalnız öyrənmək, mexanizm hərəkəti həqiqətən tətbiq etmirsə, ömür müddəti qazancı vermir.
- Enerjiyə əsaslanan qərar təsadüfi veto tətbiqindən aydın şəkildə daha təsirlidir.
- Adaptiv öyrənilmiş hədd hər iki protokola daşına bildiyi halda sabit LEAR qaydası OLSR-də uğursuz olub.
- Bu eksperimental rejimdə Bellman bootstrap əlavə etmək hər iki protokolda ömür müddətini azaldıb.
- \(\gamma=0\) biraddımlı bandit araşdırılan variantlar arasında ən yüksək orta HND qazancını verib.
- Müsbət ömür müddəti qazancı daha az paket çatdırılması və ya daha yüksək gecikmə hesabına yaranmayıb.
Tədqiqatın dəstəkləmədiyi şərhlər
- Tədqiqat “gücləndirici öyrənmə lazımsızdır” nəticəsini dəstəkləmir; öyrənilmiş adaptiv hədd mühüm müsbət töhfədir.
- Bellman bootstrap-ın bütün şəbəkələrdə və ya bütün RL problemlərində zərərli olduğu göstərilməyib.
- İdarəetmə müstəvisinin uyğunlaşdırılmasının bütün protokol ailələrində universal qanun olduğu sübut edilməyib.
- Nəticələr iki protokol, 50 düyünlü bir ssenari ailəsi və altı trafik yükü üzərində əldə edilib.
- DSR, OLSRv2 və ya digər protokollarda eyni böyüklükdə təsirin göstərildiyi sübut edilməyib.
- Nəticələr real fiziki MANET sahə yerləşdirməsi deyil, ns-3 simulyasiyasıdır.
- Düyün sıxlığı, fərqli hərəkətlilik modelləri və fərqli ilkin enerji paylanmaları üçün nəticələrin eyni qalacağı göstərilməyib.
Mənbə və Metod Qeydi
Orijinal başlıq: Mechanism Sophistication versus Control-Plane Alignment: Energy-Aware Routing in Mobile Ad-Hoc Networks
Müəlliflər: Redha Mili; Salim Chikhi.
Müəllif kimliyi qeydi: Araşdırılan PDF ikiqat-kor qiymətləndirmə versiyasıdır və müəllif adlarını göstərmir. Müəllif kimliyi SSRN biblioqrafik qeydindən təsdiqlənib.
Affiliasiya: SSRN, Salim Chikhi üçün University of Constantine 2 məlumatını verir; Redha Mili üçün SSRN-də affiliasiya məlumatı göstərilməyib.
Mənbə növü: Mobil ad hoc şəbəkələr və gücləndirici öyrənmə sahəsində nəzarətli ablasiya və şəbəkə simulyasiyası tədqiqatı.
Platforma: SSRN.
SSRN Abstract ID: 6963867.
DOI: 10.2139/ssrn.6963867.
SSRN nəşr tarixi: 18 iyun 2026.
Rəyçi qiymətləndirməsi statusu: Araşdırılan PDF açıq şəkildə “Preprint not peer reviewed” ifadəsini daşıyır.
Müəllif hüquqları/lisenziya yanaşması: PDF-də açıq Creative Commons və ya oxşar açıq təkrar istifadə lisenziyası göstərilmir. Buna görə Verianla mətni qoruyucu müəllif hüquqları yanaşması ilə hazırlanıb; mənbə cümlələri, orijinal fiqurlar və qrafik dizaynlar yenidən dərc edilməyib. Elmi faktlar, ədədi nəticələr və metod strukturu müstəqil öyrədici anlatım və yenidən qurulmuş cədvəllərlə izah edilib.
Simulyator: ns-3.46.1.
Təcrübənin əhatəsi: 50 mobil düyün, altı trafik yükü, AODV və OLSR protokolları, 20 cütləşdirilmiş seed, 500 saniyəlik iş müddəti.
Birincil ölçü: Half-Node-Death (HND), yəni 25-ci düyünün ölüm vaxtı.
İkincil ölçülər: Packet Delivery Ratio (PDR) və tətbiq səviyyəsində end-to-end delay.
Statistika: Cütləşdirilmiş seed fərqləri; 10.000 yenidən nümunələməli bootstrap %95 etibar intervalı; exact paired Wilcoxon signed-rank testi; Cliff's delta.
Senzuralaşdırma: Mənbə ümumilikdə 1560 xananın heç birinin HND baxımından senzuralanmadığını bildirir.
Reproduksiya: Mənbə kampaniya skriptlərinin, ns-3 enerji-modeli konfiqurasiyasının və bütün işlərə aid xam per-node death trace-lərinin məqalə ilə birlikdə yayımlandığını bildirir.
Əsas məhdudiyyət: Müəlliflərin öz ifadəsinə görə tədqiqat iki protokolda ölçülmüş decomposition nəticəsidir; “alignment sophistication-dan həmişə daha vacibdir” şəklində bütün şəbəkə sistemlərinə tətbiq edilə bilən universal teorem deyil.
Vizual yenidən qurma: Uyğundur. Ən güclü orijinal sxem eyni enerji siqnalının AODV RREQ admission, data forwarding və OLSR TC integration nöqtələrində üç fərqli səbəb-nəticə funksiyasına çevrilməsini göstərə bilər.
Verianla Live / Live Figure: Uyğundur. AODV və OLSR axınlarında enerji mexanizminin hərəkət nöqtəsi dəyişdirildikdə marşrutun necə “yaradıldığı”, “yalnız istifadə edildiyi” və ya “route table-ın yenidən formalaşdırıldığı” sabit verilərlə animasiya şəklində göstərilə bilər.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib