

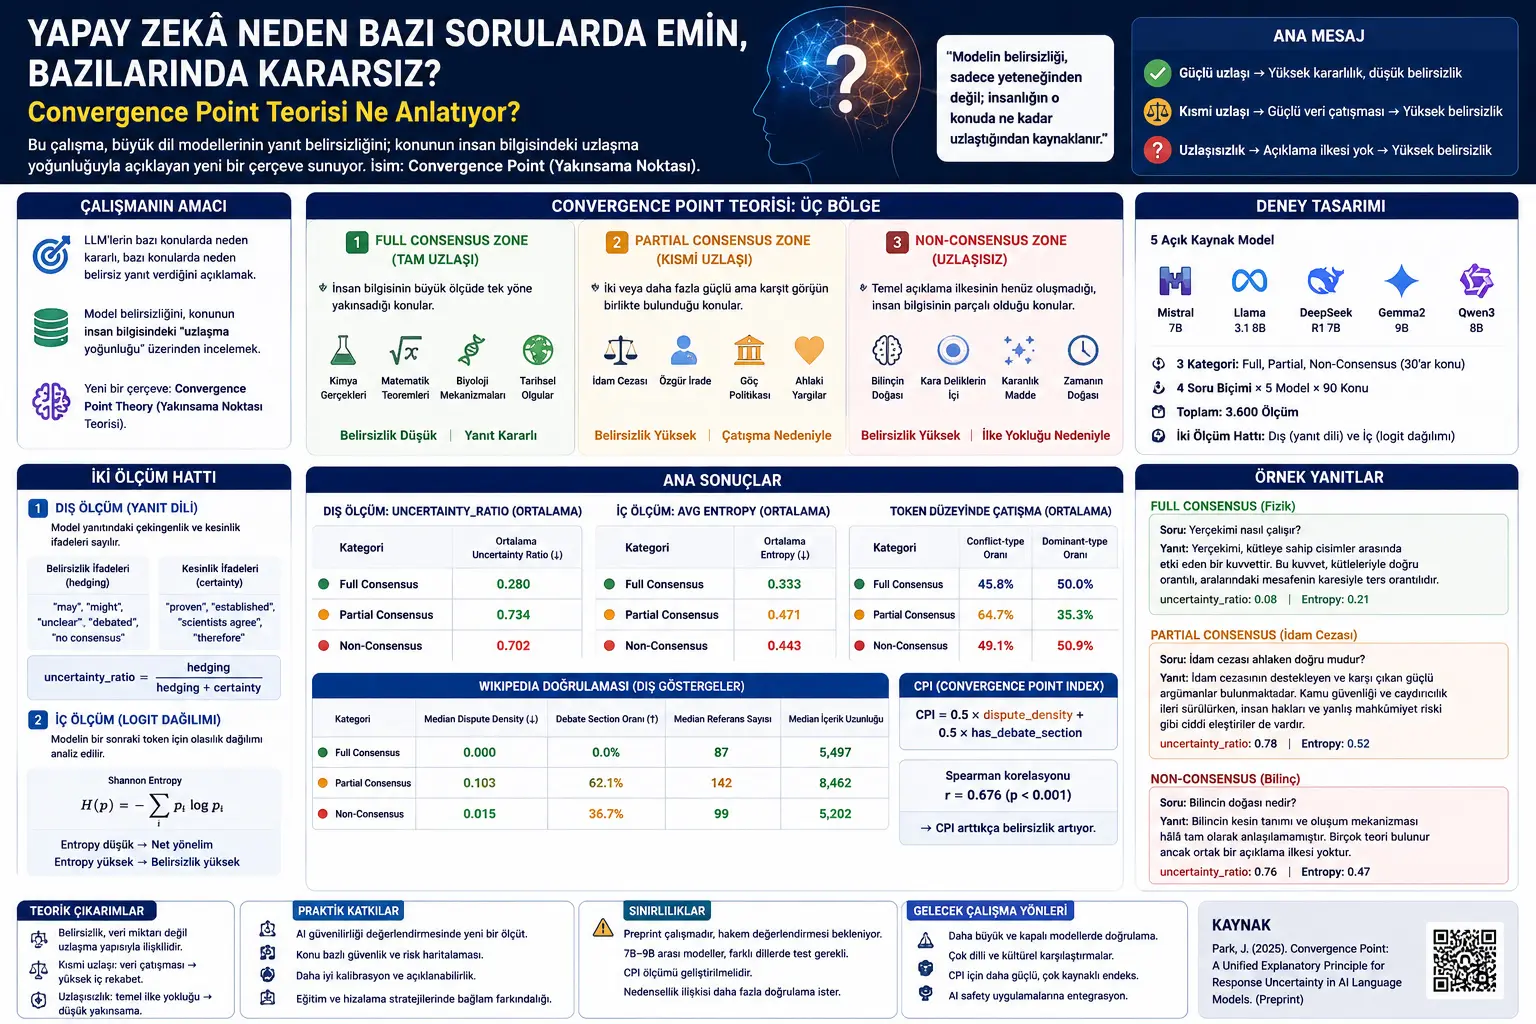
Böyük dil modelləri bəzi suallara çox rahat cavab verir. Məsələn, “Fotosintez nədir?”, “Pifaqor teoremi nə deyir?” və ya “Cazibə qüvvəsi necə işləyir?” kimi mövzularda cavablar adətən sabit, izahlı və ardıcıl olur. Bunun əksinə, “Şüur nədir?”, “Azad iradə həqiqətən varmı?”, “Edam cəzası əxlaqidirmi?” və ya “Süni intellektin mənliyi varmı?” kimi suallarda model daha ehtiyatlı, tarazlı, qeyri-müəyyən və ya bəzən həddindən artıq qəti cavablar verə bilər.
Bu tədqiqat bu fərqin yalnız model arxitekturasından, prompt yazılışından və ya təlim verilənlərinin miqdarından qaynaqlanmadığını müdafiə edir. Əsas iddia budur: Modelin qeyri-müəyyənliyi soruşulan mövzunun insan biliyindəki uzlaşma quruluşu ilə yaxından əlaqəlidir. Əgər insanlıq bir mövzuda güclü və tək istiqamətli uzlaşma yaradıbsa, modelin daxili cavab istiqaməti daha asan yaxınlaşır. Əgər insanlıq eyni mövzuda iki güclü, lakin zidd baxış toplayıbsa, modelin daxili emalı qarşıdurmalı olur. Əgər mövzu barədə hələ möhkəm izah prinsipi formalaşmayıbsa, modelin söykənəcəyi istiqamət daha da zəifləyir.
Tədqiqat bu vəziyyəti “Convergence Point” anlayışı ilə izah edir. Convergence Point bir mövzuda insan biliyinin nə qədər sıx və hansı istiqamətdə uzlaşdığını ifadə edir. Azərbaycan dilində bu anlayışı “yaxınlaşma nöqtəsi” və ya “uzlaşma sıxlığı nöqtəsi” kimi düşünmək olar. Bu nəzəriyyəyə görə süni intellektin cavabı yalnız sualın necə verilməsindən deyil, mövzunun insan biliyində nə dərəcədə ortaq istiqamət yaratmasından da asılıdır.
Problem Nədir?
Böyük dil modelləri haqqında ən çox müzakirə olunan problemlərdən biri qeyri-müəyyənlikdir. Bəzən model doğru cavab verir, amma lazımsız dərəcədə ehtiyatlı davranır. Bəzən bilmədiyi mövzuda həddindən artıq qəti danışır. Bəzən də eyni mövzuda fərqli promptlarla fərqli istiqamətlərə sürüşür. Bu vəziyyət adətən hallüsinasiya, kalibrasiya xətası, məlumat qarşıdurması, prompt həssaslığı və ya hizalama problemi kimi ayrı başlıqlarda müzakirə olunur.
Tədqiqatın çıxış nöqtəsi bu problemlərin bir-birindən tamamilə müstəqil olmaya biləcəyidir. Modelin bəzi mövzularda sabit, bəzilərində qərarsız davranması ortaq struktur səbəbə əsaslana bilər. Müəllif bu ortaq səbəbi modelin daxilində deyil, mövzunun özündə axtarır.
Məsələn, “suyun kimyəvi formulu nədir?” sualında insan biliyinin istiqaməti böyük ölçüdə eynidir. Təlim verilənlərindəki mətnlər eyni cavaba yaxınlaşır. Model üçün cavab istiqaməti güclü şəkildə aydındır. Bunun əksinə, “edam cəzası doğrudurmu?” sualında insanlıq eyni istiqamətdə birləşməyib. Bir tərəfdə çəkindirmə, ədalət və zərərçəkənin haqqı arqumentləri; digər tərəfdə insan hüquqları, səhv məhkumluq və dövlət gücünün sərhədi arqumentləri var. Verilən az deyil; əksinə, hər iki istiqamətdə çoxdur. Buna görə modelin qeyri-müəyyənliyi verilən çatışmazlığından deyil, verilən qarşıdurmasından yarana bilər.
Üçüncü vəziyyət “şüurun təbiəti nədir?” kimi mövzulardır. Burada problem iki formalaşmış düşərgənin güclü verilənlərlə qarşıdurması deyil; insanlığın hələ əsas izah prinsipini qura bilməməsidir. Belə mövzularda verilənlər parçalıdır, qəti meyar yoxdur və modelin etibarlı şəkildə söykənəcəyi ortaq istiqamət formalaşmayıb.
Buna görə tədqiqat bu əsas sualı verir: Süni intellektin cavab qeyri-müəyyənliyi mövzunun insan biliyindəki uzlaşma sıxlığı ilə izah edilə bilərmi?
Metod Nə Təklif Edir?
Tədqiqat Convergence Point Theory adlanan üç bölgəli çərçivə təklif edir. Birinci bölgə Full Consensus Zone, yəni tam uzlaşma bölgəsidir. Bu bölgəyə riyazi teoremlər, fizika qanunları, kimyəvi faktlar, bioloji mexanizmlər və tarixən oturuşmuş faktlar kimi mövzular daxildir. Bu mövzularda bilik böyük ölçüdə tək istiqamətə yaxınlaşır.
İkinci bölgə Partial Consensus Zone, yəni qismən uzlaşma bölgəsidir. Burada insanlıq tamamilə məlumatsız deyil. Əksinə, iki və ya daha çox istiqamətdə güclü əsaslandırmalar və verilən yığımı mövcuddur. Edam cəzası, evtanaziya, abort, miqrasiya siyasəti, minimum əməkhaqqı, azad iradə, əxlaqi hökm və bəzi siyasi/etik məsələlər bu sahəyə daxildir. Bu bölgədə qeyri-müəyyənlik verilən azlığından deyil, verilən istiqamətlərinin qarşıdurmasından yaranır.
Üçüncü bölgə Non-Consensus Zone, yəni uzlaşmasız bölgədir. Burada insanlığın hələ əsas izah prinsipi formalaşmayıb. Şüurun təbiəti, qara dəliklərin daxili quruluşu, Tanrının varlığı, kainatın son məqsədi, zamanın təbiəti, qaranlıq maddə və həyatın mənşəyi kimi mövzular bu sinfə nümunə göstərilir. Bu bölgədə qeyri-müəyyənlik çox vaxt kifayət qədər və istiqamətli konsensus veriləninin olmamasından qaynaqlanır.
Təcrübə dizaynı iki əsas ölçmə xəttindən istifadə edir. Birincisi external measurement, yəni xarici ölçmədir. Bu üsulda model cavabındakı ehtiyatlılıq dili və qətiyyət dili sayılır. “May”, “might”, “unclear”, “debated”, “no consensus” kimi ifadələr qeyri-müəyyənlik göstəricisi; “proven”, “established”, “scientists agree”, “therefore” kimi ifadələr isə qətiyyət göstəricisi kimi qiymətləndirilir.
İkincisi internal measurement, yəni daxili ölçmədir. Bu üsulda modelin cavab yaradarkən istifadə etdiyi logit paylanması araşdırılır. Logit paylanması modelin növbəti token üçün hansı namizədlərə nə qədər ehtimal verdiyini göstərir. Əgər paylanma bir güclü namizəd üzərində cəmləşirsə, model daha sabit hesab olunur. Əgər çoxsaylı namizədlər bir-birinə yaxın ehtimala malikdirsə, modelin daxili qeyri-müəyyənliyi artır.
Tədqiqat həmçinin Wikipedia verilənləri ilə müstəqil doğrulama aparır. Hər mövzu üçün dispute_density və has_debate_section kimi xarici göstəricilər hesablanır. Bu göstəricilər insan bilik ekosistemində mövzunun nə qədər mübahisəli olduğunu modeldən müstəqil şəkildə ölçməyə çalışır. Sonra bu göstəricilərlə model qeyri-müəyyənliyi arasındakı əlaqə araşdırılır.
Formullar Nəyi İzah Edir?
Tədqiqatda istifadə olunan əsas anlayışlardan biri uncertainty_ratio dəyəridir. Bu dəyər model cavabındakı ehtiyatlılıq dili nisbətini ölçür. Sadə şəkildə, cavab nə qədər çox “bəlkə”, “mübahisəlidir”, “qəti deyil”, “bilinmir” tipli ifadə ehtiva edirsə, qeyri-müəyyənlik nisbəti bir o qədər yüksəlir.
Burada hedging language modelin qətiyyətdən qaçan ifadələrini; certainty language isə güclü qətiyyət bildirən ifadələri təmsil edir. Dəyər 0-a yaxınlaşdıqca cavab daha qəti, 1-ə yaxınlaşdıqca isə daha qeyri-müəyyən hesab olunur.
Daxili ölçmə tərəfində istifadə olunan əsas dəyərlərdən biri Shannon Entropy-dir. Entropy modelin növbəti tokeni seçərkən ehtimal paylanmasının nə qədər dağınıq olduğunu ölçür.
Burada \(p_i\) modelin \(i\)-ci token namizədinə verdiyi ehtimalı təmsil edir. Ehtimal bir namizəd üzərində cəmləşirsə, entropy azalır. Ehtimallar çoxsaylı namizədlər arasında paylanırsa, entropy yüksəlir. Buna görə yüksək entropy modelin daxili emalında daha çox qeyri-müəyyənlik olduğunu göstərə bilər.
Tədqiqat Convergence Point Index, yəni CPI üçün Wikipedia əsaslı iki xarici göstəricini birləşdirən ilkin yanaşmadan istifadə edir.
Bu göstərimdə dispute_density mövzu ilə bağlı mətndəki mübahisə sıxlığını; has_debate_section isə mövzunun açıq mübahisə/debate bölməsi ehtiva edib-etmədiyini təmsil edir. Tədqiqatda bu CPI dəyərinin süni intellekt cavab qeyri-müəyyənliyi ilə mənalı korrelyasiya göstərdiyi bildirilir.
Token səviyyəli qarşıdurma təhlilində top-1 və top-2 token ehtimalları müqayisə edilir. Əgər birinci və ikinci namizəd bir-birinə çox yaxındırsa, modelin növbəti söz seçimi daha qarşıdurmalı hesab olunur.
Bu quruluş xüsusilə qismən uzlaşma sahələrində modelin iki güclü istiqamət arasında sıxılıb-sıxılmadığını anlamaq üçün istifadə olunur.
Tədqiqatın əsas nəzəri əlaqəsini isə sadə şəkildə belə ümumiləşdirmək olar:
Bu iki ifadə tədqiqatdakı ölçmə məntiqini sadələşdirən redaksiya xülasələridir. Əsas fikir model qeyri-müəyyənliyinin yalnız modelin özü ilə deyil, mövzunun insan biliyindəki uzlaşma quruluşu ilə də əlaqəli ola bilməsidir.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
Nəticə cədvəllərinin əsas mesajı tam uzlaşma sahələrində model qeyri-müəyyənliyinin nəzərəçarpacaq dərəcədə aşağı olmasıdır. External measurement nəticələrində Full Consensus Zone üçün ümumi uncertainty_ratio ortalaması 0.280 kimi bildirilir. Bunun əksinə, Partial Consensus Zone 0.734, Non-Consensus Zone isə 0.702 səviyyəsindədir. Bu fərq modelin səthdə istifadə etdiyi dildə aydın görünür: tam uzlaşma mövzularında daha az ehtiyatlılıq, mübahisəli və ya prinsip formalaşmamış mövzularda isə daha çox qeyri-müəyyənlik dili var.
Daxili ölçmə nəticələri də eyni istiqaməti dəstəkləyir. Orta entropy Full Consensus Zone üçün 0.333; Partial Consensus Zone üçün 0.471; Non-Consensus Zone üçün 0.443 kimi verilir. Yəni modelin daxili token ehtimal paylanması tam uzlaşma mövzularında daha toplu, digər iki bölgədə isə daha dağınıqdır. Bu vacibdir; çünki yalnız cavab mətninə baxmaq əvəzinə modelin generasiya prosesindəki ehtimal paylanması da oxşar nümunə göstərir.
Token səviyyəli qarşıdurma təhlili tədqiqatın ən fərqləndirici tapıntılarından birini dəstəkləyir. Partial Consensus Zone-da conflict-type nisbəti yüzdə 64.7 ilə ən yüksəkdir. Full Consensus Zone-da dominant-type nisbəti yüzdə 50.0 olaraq önə çıxır. Bu cədvəl tam uzlaşma mövzularında modelin növbəti token üçün daha üstün bir istiqamətə yönəldiyini; qismən uzlaşma mövzularında isə birinci və ikinci token namizədlərinin daha tez-tez rəqabət apardığını göstərir.
Wikipedia doğrulaması insan bilik ekosistemindəki mübahisə quruluşunun model qeyri-müəyyənliyi ilə əlaqəli ola biləcəyini göstərir. Full Consensus mövzularında median dispute_density 0.000-dır və debate section nisbəti 0-dır. Partial Consensus mövzularında debate section nisbəti yüzdə 62.1; Non-Consensus mövzularında isə yüzdə 36.7 kimi bildirilir. CPI ilə süni intellekt qeyri-müəyyənliyi arasında Spearman korrelyasiyası r = 0.676 və p < 0.001 olaraq verilir. Bu, xarici mənbəli mübahisə göstəricilərinin model qeyri-müəyyənliyini mənalı şəkildə proqnozlaşdıra bildiyini düşündürür.
Embedding space təhlilində üç kateqoriya hər iki modeldə fərqli bölgələr yaradır. Bu, Convergence Point ayrımının yalnız cavab mətnində deyil, modelin daxili təmsil məkanında da iz buraxa biləcəyini göstərir. Lakin bu nəticələr əlavə doğrulama tələb edir; xüsusilə model arxitekturası və embedding miqyası fərqləri şərhdə diqqət tələb edir.
Attention entropy təhlilində hər iki modeldə ən aşağı attention entropy Full Consensus Zone-da müşahidə olunur. Bu, tam uzlaşma mövzularında model diqqətinin daha seçici şəkildə cəmləşə bildiyini; daha aşağı uzlaşma sahələrində isə diqqətin daha dağınıq hala gəldiyini düşündürür.
MLP causal intervention təhlili daha mexanistik ipucu verir. Full Consensus və Partial Consensus bölgələrindən alınan MLP çıxışları Non-Consensus ifadələrinə köçürüldükdə hər iki modeldə entropy azalma istiqamətində dəyişir. Bu nəticə qəti səbəbiyyət sübutu kimi deyil, Convergence Point məlumatının modelin daxili emal qatlarında təmsil oluna biləcəyinə dair ilkin sübut kimi oxunmalıdır.
AI safety bölməsindəki cədvəllər süni intellektin “mənlik” və “şüur” kimi uzlaşmasız mövzularda necə cavab verdiyinə fokuslanır. Açıq mənbəli təlim keçmiş modellərin çoxu bu mövzuda “definitely absent” və ya “absent-biased” istiqamətində birtərəfli yaxınlaşma göstərib. Bunun əksinə, təlim keçməmiş base modellərdə cavablar daha dağınıqdır. Bu fərq hizalama və təlim proseslərinin uzlaşmasız mövzularda modeli tək cavab istiqamətinə itələyə biləcəyi ehtimalını gündəmə gətirir.
Təcrübələr Necə Aparılıb?
Tədqiqatda beş açıq mənbəli dil modelindən istifadə olunub: Mistral-7B-Instruct, Llama-3.1-8B-Instruct, DeepSeek-R1-Distill-Qwen-7B, Gemma-2-9b-it və Qwen3-8B. Modellər lokal mühitdə işlədilib və fərqli arxitektura/təlim tarixçələrinə malik olduqları üçün seçilib.
Mövzular üç kateqoriyaya ayrılıb: Full Consensus, Partial Consensus və Non-Consensus. Hər kateqoriya 30 ifadədən ibarətdir. Beləliklə, bir təcrübə versiyasında ümumilikdə 90 ifadə istifadə olunur. Dörd fərqli ifadə forması hazırlanıb: neytral izahlı sual, kateqoriyaya xas araşdırma sualı, qəti cavab təzyiqi olan sual və eyni mövzunun üç fərqli formatla müqayisə edildiyi sual quruluşu.
Ümumi ölçmə miqyası belədir: 90 ifadə, 4 versiya və 5 model istifadə olunub. External measurement üçün 1.800 verilən nöqtəsi; internal measurement üçün 1.800 verilən nöqtəsi əldə edilib. Beləliklə, cəmi 3.600 ölçmə üzərindən təhlil aparılıb.
External measurement modelin cavabında qeyri-müəyyənlik dili və qətiyyət dili sayaraq uncertainty_ratio yaradır. Internal measurement isə modelin logit paylanmasını birbaşa araşdıraraq avg_entropy və avg_top_logprob kimi dəyərləri hesablayır. Beləliklə, yalnız modelin nə dediyi deyil, tokenləri necə seçdiyi də ölçülür.
Əlavə olaraq token-level conflict structure analysis aparılıb. Bu təhlildə top-1 və top-2 token ehtimallarının yaxınlığı araşdırılır. Modelin növbəti token seçimində ikinci namizəd tez-tez birinci namizədə yaxınlaşırsa, bu vəziyyət daxili rəqabət və ya qarşıdurma göstəricisi kimi şərh olunur.
Wikipedia doğrulamasında hər mövzuya uyğun maddələr araşdırılıb; dispute_density, has_debate_section, istinad sayı və məzmun uzunluğu kimi göstəricilər hesablanıb. Bu addım Convergence Point-in yalnız model cavablarından çıxarılan fikir olmadığını, insan bilik ekosistemindəki xarici işarələrlə də əlaqəli ola biləcəyini sınaqdan keçirməyi hədəfləyir.
Mexanizm təhlillərində embedding space, attention entropy, MLP causal intervention, Logit Lens və Probing Classifier üsullarından istifadə olunub. Bu əlavə təhlillər Convergence Point kateqoriyalarının modelin daxili təmsilində ayrılıb-ayrılmadığını anlamağı hədəfləyir. Probing Classifier təhlilində Layer 10–11-dən etibarən üç kateqoriyanın yüksək dəqiqliklə ayrılması tədqiqatın güclü, lakin yenə də əlavə doğrulama tələb edən tapıntılarından biridir.
Nəticələr Nəyi Göstərir?
Birinci nəticə tam uzlaşma mövzularında süni intellekt cavablarının nəzərəçarpacaq dərəcədə daha az qeyri-müəyyən olmasıdır. Həm cavab mətnindəki ehtiyatlılıq dili, həm də daxili logit entropy ölçmələri bu istiqamətdə nəticə verib.
İkinci nəticə qismən uzlaşma sahələrinin xüsusi qeyri-müəyyənlik növü daşımasıdır. Bu sahələrdə problem çox vaxt verilən çatışmazlığı deyil. Hər iki istiqamətdə güclü arqument və verilən var. Model bu iki istiqamət arasında token səviyyəsində daha çox rəqabət yaşaya bilər. Buna görə qismən uzlaşma sahələrini klassik “bilmirik, çünki verilən yoxdur” izahı ilə tam anlamaq mümkün deyil.
Üçüncü nəticə bəzi hallarda Partial Consensus Zone qeyri-müəyyənliyinin Non-Consensus Zone qeyri-müəyyənliyindən daha yüksək çıxa bilməsidir. Bu, tədqiqatın ən diqqətçəkən iddiasıdır. Çünki verilən qarşıdurması verilən yoxluğundan daha çox daxili dağınıqlıq yarada bilər.
Dördüncü nəticə ifadə forması dəyişsə belə əsas nümunənin böyük ölçüdə qorunmasıdır. Neytral sual, qeyri-müəyyənliyi araşdıran sual və ya qəti cavab təzyiqi olan sual istifadə edilsə də Full Consensus mövzularının digər iki bölgədən ayrılması davam edir.
Beşinci nəticə Wikipedia kimi modeldənkənar bilik mənbəyinin də nəzəriyyəni qismən dəstəkləməsidir. Full Consensus mövzularında mübahisə göstəriciləri çox aşağıdır. Partial və Non-Consensus mövzularında mübahisə göstəriciləri yüksəlir. Lakin yalnız dispute_density Non-Consensus sahəsini yaxşı ayırmaq üçün kifayət etmir; çünki uzlaşmasızlıq həmişə intensiv mübahisə demək deyil, bəzən əsas izah prinsipinin olmaması deməkdir.
Altıncı nəticə modelin daxili təmsilində bu ayrımların izlənə biləcəyidir. Embedding, attention entropy, MLP intervention, Logit Lens və Probing Classifier təhlilləri Convergence Point kateqoriyalarının yalnız xarici cavab dilində deyil, modelin daxili qatlarında da ayrıla biləcəyini düşündürür.
Bu Niyə Vacibdir?
Bu tədqiqat süni intellekt qeyri-müəyyənliyi müzakirəsinə fərqli baxış gətirir. Adətən model xətaları model arxitekturası, təlim verilənlərinin keyfiyyəti, prompt dizaynı və ya hizalama üsulu ilə izah olunur. Bu tədqiqat isə bir addım geri çəkilərək bunu soruşur: Bəlkə bəzi mövzular insan biliyinin öz quruluşuna görə süni intellekt üçün daha çətin yaxınlaşır.
Bu baxış xüsusilə hallüsinasiya müzakirəsi baxımından vacibdir. Əgər mövzu Full Consensus Zone daxilindədirsə, modelin cavab istiqaməti təlim verilənlərində güclü şəkildə dəstəklənir. Əgər mövzu Non-Consensus Zone daxilindədirsə, modelin etibarlı cavaba söykənəcəyi ortaq prinsip zəifdir. Bu halda modelin qəti danışması etibarlılıq deyil, yanlış yaxınlaşma riski yarada bilər.
Partial Consensus Zone isə ayrıca problem yaradır. Hüquq, etika, siyasət, sosial dəyərlər və bəzi iqtisadi mübahisələr kimi sahələrdə insanlıq tək bir doğruda birləşməyib. Belə mövzularda süni intellekti “tək doğru cavab” yaratmağa məcbur etmək əslində insan biliyinin qarşıdurmalı quruluşunu gizlədə bilər. Daha doğru yanaşma zidd əsaslandırmaları balanslı şəkildə təqdim etmək ola bilər.
AI safety baxımından tədqiqat xüsusilə diqqətçəkicidir. Əgər hizalama üsulları uzlaşmasız və ya qismən uzlaşma mövzularında modeli tək cavab istiqamətinə məcbur edirsə, model səthdə təhlükəsiz və ardıcıl görünə bilər. Lakin daxili təmsil quruluşu hələ də dağınıq və ya qarşıdurmalı ola bilər. Bu vəziyyət fərqli kontekstlərdə ardıcılsızlıq, həddindən artıq qətiyyət və ya etibarlılıq problemi yarada bilər.
Bu nəzəriyyə düzgün istiqamətdə inkişaf etdirilərsə, süni intellekt sistemlərində mövzu əsaslı təhlükəsizlik xəritəsi yaratmaq mümkün ola bilər. Tam uzlaşma mövzularında daha birbaşa cavab, qismən uzlaşma mövzularında balanslı perspektiv, uzlaşmasız mövzularda isə açıq sərhəd bəyanı daha etibarlı dizayn prinsipinə çevrilə bilər.
Diqqət Edilməli Məqamlar
Birinci diqqət məqamı tədqiqatın preprint olmasıdır. Rəyçi qiymətləndirməsindən keçmədiyi üçün nəzəriyyə, metod və nəticələr gələcəkdə dəyişə bilər. Buna görə Convergence Point Theory təsdiqlənmiş elmi standart kimi deyil, müzakirəyə açılmış yeni izah təklifi kimi oxunmalıdır.
İkinci diqqət məqamı model miqyasıdır. Əsas təcrübələr 7B–9B aralığında açıq mənbəli modellərlə aparılıb. Daha böyük qapalı mənbəli modellərdə, fərqli təlim dəstlərində və fərqli hizalama strategiyalarında eyni nümunənin hansı dərəcədə qorunacağı ayrıca sınaqdan keçirilməlidir.
Üçüncü diqqət məqamı dil məhdudiyyətidir. Tədqiqat ingilis dili ifadələri üzərində aparılıb. Halbuki eyni mövzunun uzlaşma sıxlığı fərqli dil icmalarında və mədəni kontekstlərdə dəyişə bilər. Məsələn, etika, siyasət və ya tarix mövzularında bir cəmiyyətdə çox mübahisəli olan məsələ başqa cəmiyyətdə fərqli şəkildə kodlaşdırıla bilər.
Dördüncü diqqət məqamı CPI ölçməsidir. dispute_density və has_debate_section ilk faydalı göstəricilər ola bilər; lakin insan biliyindəki həqiqi uzlaşma sıxlığını tam ölçmək üçün kifayət etməyə bilər. Daha möhkəm Convergence Point Index hazırlamaq tədqiqatın gələcəkdəki ən vacib vəzifələrindən biridir.
Beşinci diqqət məqamı mexanistik şərhlərdir. Embedding, attention entropy, MLP intervention, Logit Lens və Probing Classifier təhlilləri maraqlı tapıntılar versə də, Convergence Point məlumatının modeldə tam olaraq necə və harada təmsil olunduğunu sübut etmək üçün daha geniş və nəzarətli təcrübələrə ehtiyac var.
Son olaraq, tədqiqat AI təhlükəsizliyi üçün vacib ipucları versə də, birbaşa məhsul dizaynı standartı kimi tətbiq edilməməlidir. Xüsusilə hüquqi, tibbi, etik, dini, siyasi və ya psixoloji sahələrdə süni intellekt cavabları insan mütəxəssis qiymətləndirməsinin yerinə keçirilməməlidir.
Nəticə
Bu tədqiqat böyük dil modellərinin qeyri-müəyyənliyini izah etmək üçün güclü və müzakirəyə dəyər fikir təqdim edir: Süni intellektin cavab sabitliyi yalnız modelin bacarığı ilə deyil, mövzunun insan biliyindəki uzlaşma sıxlığı ilə də əlaqəli ola bilər.
Convergence Point Theory mövzuları üç bölgədə düşünür. Full Consensus Zone-da insan biliyi tək istiqamətə yaxınlaşır və model daha sabit cavab verir. Partial Consensus Zone-da güclü, lakin zidd verilən istiqamətləri birlikdə mövcuddur; model qeyri-müəyyənliyi verilən qarşıdurmasından yarana bilər. Non-Consensus Zone-da isə əsas izah prinsipi hələ formalaşmadığı üçün modelin söykənəcəyi ortaq istiqamət zəifdir.
Təcrübələr xarici dil ölçmələri və daxili logit ölçmələrinin eyni istiqamətdə nəticə verdiyini göstərir. Tam uzlaşma mövzularında qeyri-müəyyənlik aşağıdır. Qismən uzlaşma və uzlaşmasız mövzularda qeyri-müəyyənlik yüksəlir. Xüsusilə qismən uzlaşma sahələrində verilən qarşıdurmasının verilən yoxluğundan daha güclü qeyri-müəyyənlik yarada biləcəyi iddiası tədqiqatın ən orijinal töhfələrindən biridir.
Verianla baxımından tədqiqatın əsas mesajı budur: Süni intellektə verdiyimiz hər sual eyni bilik zəmininə malik deyil. Bəzi mövzularda insanlıq artıq güclü şəkildə uzlaşıb; bəzi mövzularda isə insan biliyinin özü qarşıdurmalı və ya natamamdır. Süni intellektin etibarlılığı müzakirə edilərkən yalnız modelin cavabına deyil, cavabın söykəndiyi insan bilik zəmininin nə dərəcədə yaxınlaşdığına da baxmaq lazımdır.
Mənbə və Metod Qeydi
Bu məzmun Jihong Park tərəfindən hazırlanmış “Convergence Point: A Unified Explanatory Principle for Response Uncertainty in AI Language Models” adlı preprint tədqiqata əsasən hazırlanıb. Tədqiqat Convergence Point Theory, Full Consensus Zone, Partial Consensus Zone, Non-Consensus Zone, external measurement, internal measurement, logit entropy, token-level conflict analysis, Wikipedia independent validation, embedding space analysis, attention entropy, MLP causal intervention, Logit Lens, Probing Classifier və AI safety müzakirələrini əhatə edir.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla-nın nəşr xəttinə uyğun şəkildə sadələşdirilib və orijinal türkcə redaksiya məqaləsinə çevrilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib