

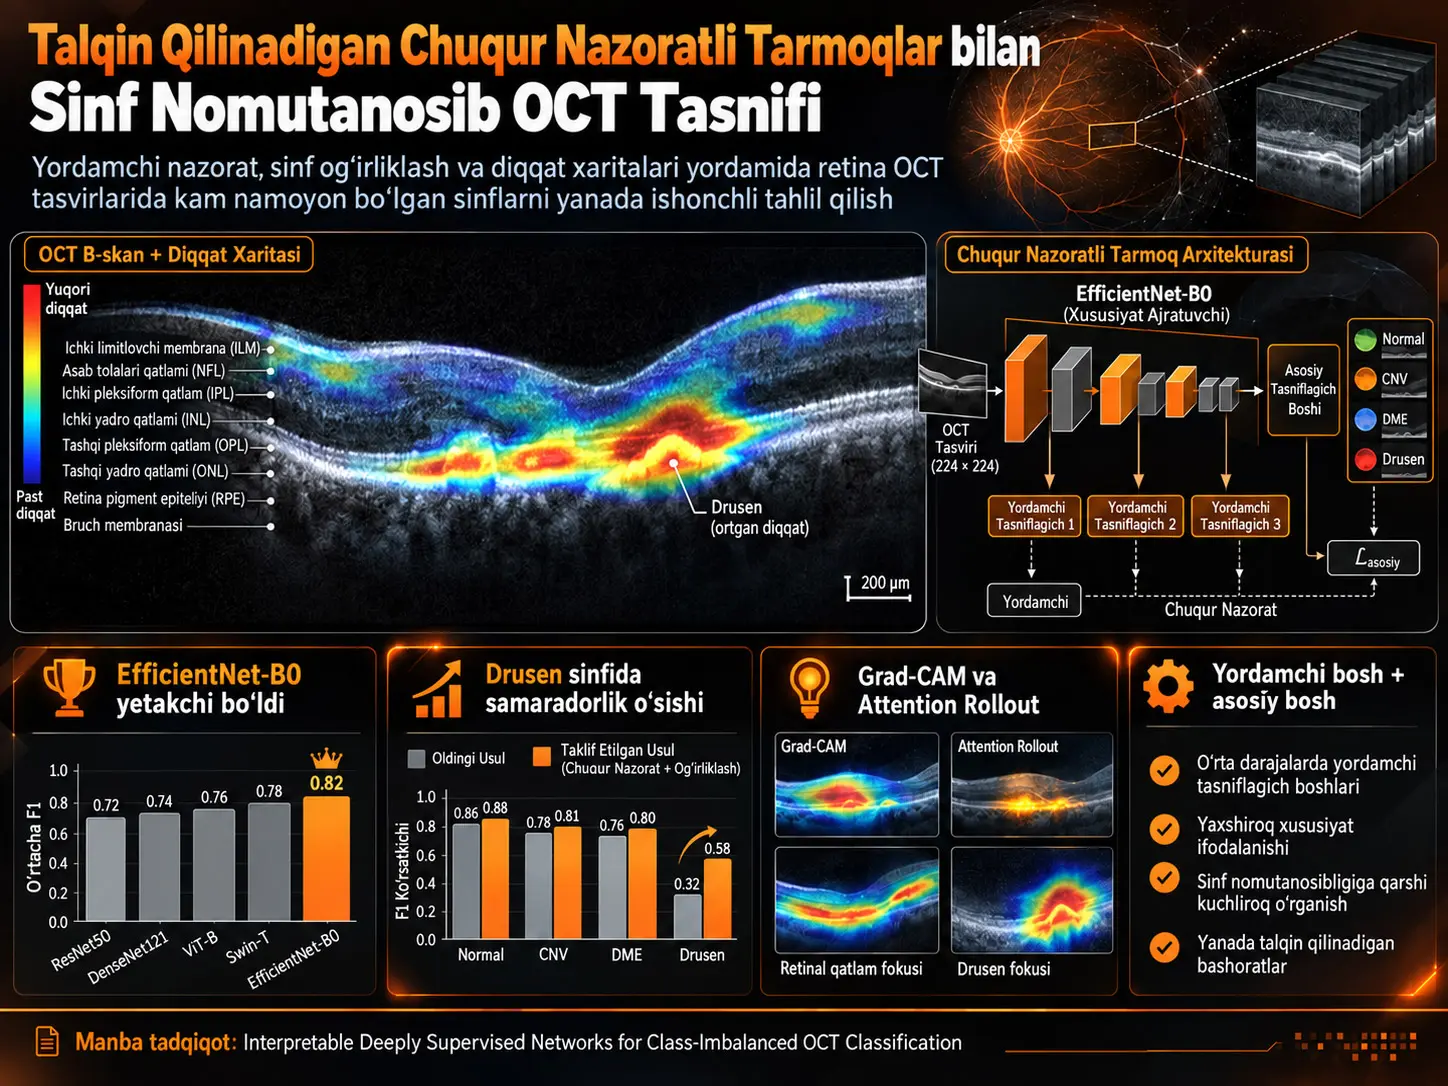
Ushbu tadqiqot sinf taqsimoti nomutanosib bo‘lgan retina optik kogerent tomografiya tasvirlarini tasniflashda kam namoyon bo‘lgan kasallik sinflarini ishonchliroq o‘rganishga qaratilgan oraliq qatlam yordamchi nazorat yondashuvini o‘rganadi. Oraliq qatlam yordamchi nazorati asosiy klassifikatorga qo‘shimcha ravishda tarmoqning o‘rta darajadagi xususiyatlariga ikkinchi klassifikator boshini ulaydigan va bu boshni faqat o‘qitish vaqtida asosiy vazifa bilan birga optimallashtiradigan chuqur o‘rganish tuzilmasidir. Tadqiqotchilar ushbu tuzilmani ResNet-18, ResNet-50, EfficientNet-B0 va Vision Transformer ViT-B/16 modellarida, to‘rtta sinfdan iborat 84.495 ta OCT skani bilan baholagan. Ma’lumotlar to‘plamida Drusen taxminan %10,6 bilan eng kam namoyon bo‘lgan sinfdir.
Usul ikki mexanizmni birgalikda qo‘llaydi. Birinchidan, namunasi kam sinflarning o‘qitish yo‘qotishiga qo‘shgan hissasi teskari sinf chastotasi orqali oshiriladi. Ikkinchidan, bir xil to‘rt sinfli diagnostik yorliq tarmoqning faqat oxirgi qatlamiga emas, balki arxitekturaga qarab tanlangan oraliq qatlamga ham qo‘llanadi. Asosiy yo‘qotish bilan yordamchi yo‘qotish o‘rtasidagi muvozanat \(\lambda\) koeffitsiyenti bilan boshqariladi va tadqiqotda \(\lambda \in \{0.0, 0.3, 0.5, 0.7, 0.9\}\) qiymatlari tizimli ravishda taqqoslanadi.
Eng kuchli umumiy natija EfficientNet-B0 uchun \(\lambda=0.3\) sharoitida olingan: umumiy aniqlik %97,78 ga yetgan, Drusen sinfida precision %92,54, sezgirlik/recall %94,51, spetsifiklik %99,29 va F1-skori %93,51 deb qayd etilgan. EfficientNet-B0 ning asosiy ablation jadvalidagi vaznsiz \(\lambda=0\) sharoitida Drusen F1-skori %90,87 bo‘lgani uchun o‘sish 2,64 foiz punktini tashkil etadi. ResNet-18 va ResNet-50 ham o‘rta darajadagi yordamchi yo‘qotishdan foyda ko‘rgan, ViT-B/16 uchun esa eng maqbul qiymat \(\lambda=0.5\) bo‘lgan.
Natijalar faqat umumiy aniqlik bo‘yicha baholanmagan. Grad-CAM va Attention Rollout tahlillari mos yordamchi nazorat ostida, ayniqsa Drusen namunalarida, model e’tibori klinik jihatdan tegishli retinal tuzilmalarga yaxshiroq jamlanishi mumkinligini ko‘rsatgan. Biroq ViT-B/16 ma’lumotlar to‘plamidagi oq chetlar va padding hududlariga konvolyutsion modellarga qaraganda ko‘proq sezgirlik ko‘rsatgan. Tadqiqot bitta benchmark ma’lumotlar to‘plamiga asoslangan va tashqi, ko‘p markazli yoki prospektiv klinik validatsiyani o‘z ichiga olmagani sababli natijalarni bevosita real klinik foydalanishdagi muvaffaqiyat sifatida talqin qilmaslik kerak.
Asosiy muammo: yuqori umumiy aniqlik ozchilik sinfidagi xatoni yashirishi mumkin
Optik kogerent tomografiya (optical coherence tomography, OCT) retinaning qatlamli tuzilishini kesim ko‘rinishida tasvirlaydigan invaziv bo‘lmagan tasvirlash usulidir. Tadqiqotda foydalanilgan ma’lumotlar to‘plami to‘rtta diagnostik toifani o‘z ichiga oladi: xoroidal neovaskulyarizatsiya (CNV), diabetik makula shishi (DME), Drusen va normal retina. Sinflar taqsimoti teng emas: CNV taxminan %44,5, normal retina %31,5, DME %13,6 va Drusen %10,6 ulushga ega.
Bunday taqsimotda faqat umumiy aniqlikka qarash chalg‘itishi mumkin. Model ko‘pchilik sinflarni juda yaxshi o‘rgansa, yuqori umumiy aniqlik hosil qilishi mumkin; biroq Drusen kabi kamroq uchraydigan sinfning precision, recall yoki F1-skori sezilarli darajada past bo‘lib qolishi mumkin. Shu sababli tadqiqotning markaziy muammosi “model nechta tasvirni to‘g‘ri tasniflaydi?” degan savoldan torroq va klinik jihatdan muhimroq savolga aylanadi: kam namoyon bo‘lgan retinal patologiya sinflarining xususiyatlari tarmoqning tasvirlash makonida yetarlicha kuchli o‘rganiladimi?
Manbada keltirilgan OCT namunalari, shuningdek, tasvirlarning barchasi faqat retinal to‘qimadan iborat emasligini ko‘rsatadi. Ayrim skanlarda qiyalik, aylantirish va ayniqsa tasvir chetlarida anatomik ma’lumot tashimaydigan oq fon/padding hududlari mavjud. Bu tafsilot keyinchalik ViT-B/16 va konvolyutsion tarmoqlar o‘rtasida kuzatilgan e’tibor farqini talqin qilish uchun muhimdir.
Oraliq Nazorat Sinf Nomutanosibligini Qanday Nishonga Oladi?
Oraliq nazorat bir xil diagnostik yorliqni tarmoqning faqat yakuniy klassifikator boshiga emas, balki o‘rta darajadagi xususiyatlariga ulangan ikkinchi yordamchi boshga ham qo‘llab, o‘qitish gradientining tarmoqning oldingi qatlamlariga bevosita yetib borishini ta’minlaydi; ushbu tadqiqotda yordamchi yo‘qotish teskari sinf chastotalari bilan vaznlanganligi sababli ozchilik sinflari tasvirining o‘rta xususiyat darajasida ham kuchaytirilishi ko‘zlangan.
Bu yondashuv yangi segmentatsiya yorlig‘i, leziya niqobi yoki alohida klinik annotatsiyani talab qilmaydi. Yordamchi va asosiy bosh bir xil to‘rt sinfli to‘g‘ri yorliqdan foydalanadi. Demak, qo‘shimcha nazorat yangi semantik vazifani belgilash o‘rniga, ayni tasniflash muammosini tarmoqning turli chuqurliklarida qayta ko‘rinadigan qiladi.
Teskari chastota sinf vaznlari
Har bir sinf uchun vazn Tenglama (1) bilan aniqlanadi:
\[ w_i=\frac{N}{C\,n_i} \]
Bu yerda \(N\) o‘qitish namunalarining umumiy sonini, \(C\) sinflar sonini va \(n_i\) tegishli \(i\) sinfidagi namunalar sonini bildiradi. Sinfdagi namunalar soni kamaygani sayin \(n_i\) kichrayadi va \(w_i\) kattalashadi. Matematik jihatdan bu kam namoyon bo‘lgan sinflardagi noto‘g‘ri tasniflashlar yo‘qotish funksiyasida yuqoriroq vazn olishini anglatadi. Ushbu tadqiqot uchun \(C=4\).
Teskari Chastota Sinf Vazni Nega Faqat Yakuniy Qatlamga Qoldirilmagan?
Tadqiqot yondashuvi faqat yakuniy klassifikatordagi namuna vaznlarini o‘zgartirish bilan cheklanmaydi; xuddi shu vaznlangan diagnostik maqsadni oraliq xususiyatlar darajasida ham qo‘llaydi, shu tariqa ozchilik sinfining o‘rganish signali tarmoq xususiyatlar ierarxiyasining oldingi qismiga ko‘chiriladi va yordamchi bosh bilan asosiy bosh birgalikda optimallashtiriladi.
Arxitekturalarga ko‘ra yordamchi ulanish nuqtalari bir xil emas. ResNet-18 va ResNet-50 uchun yordamchi bosh layer3 chiqishiga ulanadi; oraliq tasvir o‘lchamlari mos ravishda 256 va 1024 kanaldir. EfficientNet-B0 da o‘rta kengayish/MBConv hududining taxminan 6-8-bloklari ishlatiladi. ViT-B/16 uchun yordamchi nazorat oltinchi transformer blokining 768 o‘lchamli tasviriga qo‘llanadi.
Yordamchi bosh oraliq aktivatsiyani global average pooling orqali siqadi va to‘liq bog‘langan qatlam orqali to‘rtta logit hosil qiladi:
\[ \mathbf{f}_{aux}=FC(GAP(\mathbf{A}_{int})), \qquad \mathbf{A}_{int}\in\mathbb{R}^{H'\times W'\times C} \]
\(H'\) va \(W'\) oraliq xususiyat xaritasining fazoviy o‘lchamlarini, \(C\) esa kanallar sonini bildiradi. Global average pooling har bir xususiyat kanalini fazoviy jihatdan umumlashtiradi; to‘liq bog‘langan qatlam esa ushbu tasvirni to‘rtta diagnostik sinfga oid logitlarga aylantiradi.
Asosiy va yordamchi yo‘qotishni birlashtirish
Umumiy o‘qitish maqsadi Tenglama (3) bilan tuzilgan:
\[ \mathcal{L}_{total} = \mathcal{L}_{main}(\hat{\mathbf{y}}_{main},\mathbf{y}) + \lambda\,\mathcal{L}_{aux}(\hat{\mathbf{y}}_{aux},\mathbf{y}) \]
Bu yerda \(\mathcal{L}_{main}\) asosiy boshning, \(\mathcal{L}_{aux}\) esa yordamchi boshning teskari chastota bilan vaznlangan cross-entropy yo‘qotishidir. \(\lambda\) yordamchi boshning umumiy optimallashtirishdagi ta’sirini belgilaydi. \(\lambda=0\) bo‘lganda yordamchi yo‘qotish umumiy maqsadga hissa qo‘shmaydi va o‘qitish standart bitta boshli holatga qaytadi.
Yordamchi Yo‘qotish Vazni Lambda Nega Muhim?
\(\lambda\) yordamchi tasniflash maqsadining umumiy xususiyatlar makonini qanchalik kuchli yo‘naltirishini belgilagani uchun muhim giperparametrdir; tadqiqot juda past yordamchi ta’sir ozchilik sinfi uchun cheklangan foyda berishini, haddan tashqari yuqori ta’sir esa precision-recall muvozanatini buzishi mumkinligini va eng yaxshi natijalar ko‘pchilik konvolyutsion tarmoqlarda \(\lambda=0.3\), ViT-B/16 da esa \(\lambda=0.5\) atrofida yuzaga kelganini ko‘rsatgan.
Bu natija \(\lambda\) ni “qancha katta bo‘lsa, shuncha yaxshi” tarzida talqin qilib bo‘lmasligini ko‘rsatadi. Yordamchi yo‘qotish asosiy vazifani qo‘llab-quvvatlaydigan regulyator sifatida ishlashi kerak; u asosiy vazifa optimallashtirilishini bosib qo‘yadigan darajada kuchli bo‘lsa, ozchilik sinfidagi precision va F1 qiymatlari pasayishi mumkin.
O‘qitish protokoli
To‘rtta modelning barchasi ImageNet-1K da oldindan o‘qitilgan vaznlardan boshlangan. AdamW optimizatori uchun boshlang‘ich o‘rganish tezligi \(1\times10^{-4}\), weight decay \(1\times10^{-4}\), batch o‘lchami 16 va o‘qitish byudjeti 20 epoch qilib belgilangan. Cosine annealing rejalashtirgichida minimal o‘rganish tezligi \(1\times10^{-6}\) deb belgilangan.
Ma’lumotlar bemor darajasida stratified sampling bilan %70 o‘qitish, %15 validatsiya va %15 test bo‘limlariga ajratilgan; bir bemorning bir nechta bo‘limga tushib qolmasligi ta’minlangan. Giperparametrlarni sozlash validatsiya to‘plamida amalga oshirilgan va test to‘plami yakuniy baholash uchun ajratilgan. Manba, shuningdek, bemor darajasida besh qatlamli stratified cross-validation qo‘llanganini va yakuniy samaradorlik qatlamlar bo‘yicha o‘rtacha qiymat sifatida hisobot qilinganini bildiradi. Biroq asosiy natijalar jadvallarida qatlamlararo standart og‘ish yoki ishonch oralig‘i alohida keltirilmagan.
Tajribalar Python 3.11 va PyTorch 2.5.1+CU121 bilan; CUDA/cuDNN faol NVIDIA RTX 2000 Ada Generation GPU, Intel Core Ultra 9 285 2.50 GHz protsessor va 32 GB tizim xotirasida bajarilgan.
Softmax va sinf ehtimollari
To‘rtta sinfga tegishli xom logitlar \(Z_i\), softmax yordamida ehtimollarga aylantiriladi:
\[ \hat{y}_i = \frac{e^{Z_i}} {\sum_{j=1}^{4}e^{Z_j}} \]
Ushbu o‘zgartirish har bir sinf uchun manfiy bo‘lmagan ehtimollarni hosil qiladi va to‘rtta ehtimol yig‘indisini 1 ga tenglashtiradi.
Grad-CAM va Attention Rollout Ushbu Tadqiqotda Nimani Ko‘rsatadi?
Grad-CAM va Attention Rollout model faqat to‘g‘ri yoki noto‘g‘ri qaror berganini emas, balki bu qarorni chiqarishda tasvirning qaysi hududlariga ko‘proq og‘irlik berganini o‘rganish uchun ishlatilgan; Grad-CAM ResNet-18, ResNet-50 va EfficientNet-B0 da, Attention Rollout esa ViT-B/16 da qo‘llangan va optimal yordamchi nazorat ostida, ayniqsa Drusen namunalarida, e’tibor retinal patologiya hududlariga ko‘proq jamlanishi mumkinligi kuzatilgan.
Grad-CAM matematikasi
Maqsad sinf \(c\) uchun \(A^k\) xususiyat xaritasining sinf skoriga qo‘shgan hissasi gradientlarning fazoviy o‘rtachasi bilan vaznlanadi:
\[ \alpha_k^c = \frac{1}{Z} \sum_i\sum_j \frac{\partial y^c}{\partial A_{ij}^k} \]
Shundan so‘ng sinfga xos Grad-CAM xaritasi:
\[ L_{\mathrm{Grad-CAM}}^c = ReLU\left( \sum_k \alpha_k^c A^k \right) \]
orqali hisoblanadi. ReLU amali maqsad sinfga ijobiy hissa qo‘shadigan hududlarni saqlaydi. Manbada yaratilgan issiqlik xaritalari 224 × 224 OCT tasviriga qayta masshtablanib, retinal tuzilma ustiga joylashtirilgan.
ViT-B/16 uchun Attention Rollout
Transformerning har bir qatlamida \(H\) attention head dan kelgan e’tibor matritsalari o‘rtachalanadi va residual bog‘lanishni hisobga olish uchun birlik matritsa qo‘shiladi:
\[ \tilde{A}^{\,l} = \frac{1}{H} \sum_{h=1}^{H}A_h^{\,l} + I \]
Manba usulida qatorlar normallashtirilgach, qatlamlar bo‘ylab o‘zgartirilgan attention matritsalari ketma-ket ko‘paytiriladi. Shu tariqa sinf tokenidan kirish patch larigacha tarqaladigan kumulyativ e’tibor bog‘lanishi olinadi. Patch darajasidagi qiymatlar yana tasvir tekisligiga ko‘chirilib, OCT ustiga joylashtiriladi.
Baholash metrikalari
| Metrika | Formula | Ilmiy ma’no |
|---|---|---|
| Accuracy | \(\displaystyle Acc=\frac{TP+TN}{TP+TN+FP+FN}\) | Barcha namunalar ichida to‘g‘ri tasniflanganlar ulushi; sinf nomutanosibligida yolg‘iz o‘zi yetarli emas. |
| Precision | \(\displaystyle Precision_c=\frac{TP_c}{TP_c+FP_c}\) | Model sinf \(c\) deb belgilagan namunalarning qanchasi haqiqatan ham shu sinfga tegishli ekanini ko‘rsatadi. |
| Recall | \(\displaystyle Recall_c=\frac{TP_c}{TP_c+FN_c}\) | Haqiqiy sinf \(c\) namunalarining qanchasi aniqlanganini o‘lchaydi. |
| Specificity | \(\displaystyle Specificity_c=\frac{TN_c}{TN_c+FP_c}\) | Sinf \(c\) ga tegishli bo‘lmagan namunalarning to‘g‘ri ravishda manfiy deb ajratilish ulushidir. |
| F1-skori | \(\displaystyle F1_c=2\frac{Precision_c\times Recall_c}{Precision_c+Recall_c}\) | Precision va recall o‘rtasidagi garmonik muvozanatni o‘lchaydi; ozchilik sinfini baholashda ayniqsa foydalidir. |
| AUROC | \(\displaystyle AUROC_c=\int_0^1 TPR_c(FPR_c^{-1}(u))\,du\) | Bitta aniq qaror chegarasiga bog‘lanmasdan sinfning ajratiluvchanligini o‘lchaydi. |
Tadqiqot Usuli va Natijalari
Ablation dizayni
Har bir backbone arxitekturasida yordamchi yo‘qotish koeffitsiyenti \(\lambda=0.0, 0.3, 0.5, 0.7, 0.9\) qiymatlarida o‘zgartirilgan. Ushbu dizaynning maqsadi faqat eng yuqori umumiy aniqlikni topish emas, balki ayniqsa Drusen sinfida precision, recall, specificity, F1 va AUROC qiymatlarining yordamchi nazoratga qanday javob berishini aniqlashdir.
Qaysi Yordamchi Yo‘qotish Darajasi Eng Yaxshi Natijani Berdi?
ResNet-18, ResNet-50 va EfficientNet-B0 uchun eng muvozanatli natijalar \(\lambda=0.3\) atrofida olingan bo‘lsa, ViT-B/16 uchun eng maqbul nuqta \(\lambda=0.5\) bo‘lgan; eng yuqori umumiy samaradorlikni EfficientNet-B0 \(\lambda=0.3\) bilan %97,78 aniqlik va %93,51 Drusen F1-skori orqali ko‘rsatgan.
| Model | Eng maqbul \(\lambda\) | Umumiy aniqlik (%) | Drusen precision (%) | Drusen recall (%) | Drusen specificity (%) | Drusen F1 (%) | Drusen AUROC (%) |
|---|---|---|---|---|---|---|---|
| ResNet-18 | 0.3 | 97.58 | 87.61 | 95.90 | 98.49 | 91.28 | 99.6 |
| ResNet-50 | 0.3 | 97.02 | 88.02 | 95.69 | 98.58 | 91.69 | 99.5 |
| EfficientNet-B0 | 0.3 | 97.78 | 92.54 | 94.51 | 99.29 | 93.51 | 99.5 |
| ViT-B/16 | 0.5 | 95.76 | 84.94 | 89.73 | 98.23 | 87.27 | 98.9 |
Drusen sinfidagi o‘zgarish
| Model | \(\lambda=0\) Drusen F1 (%) | Optimal Drusen F1 (%) | O‘zgarish (foiz punkti) |
|---|---|---|---|
| ResNet-18 | 89.80 | 91.28 | +1.48 |
| ResNet-50 | 89.08 | 91.69 | +2.61 |
| EfficientNet-B0 | 90.87 | 93.51 | +2.64 |
| ViT-B/16 | 85.25 | 87.27 | +2.02 |
Ushbu jadval yordamchi nazorat ta’siri arxitekturaga qarab bir xil emasligini ko‘rsatadi. EfficientNet-B0 eng yuqori Drusen F1 qiymatini bergan, ViT-B/16 esa boshlang‘ich holatda eng past Drusen F1 qiymatiga ega bo‘lgan va yordamchi nazoratdan foyda ko‘rsa-da, konvolyutsion modellar darajasiga yetmagan.
Nega haddan tashqari yuqori lambda foydali bo‘lmadi?
Manba jadvallarida \(\lambda\) oshgani sari samaradorlik monoton ravishda ortmasligi ko‘rinadi. Masalan, ResNet-18 da \(\lambda=0.9\) sharoitida Drusen precision %83,59 va F1 %88,37 ga tushadi. EfficientNet-B0 da ham \(\lambda=0.9\) Drusen F1 qiymati %90,37 bo‘lib, \(\lambda=0.3\) dagi %93,51 darajadan past. Yordamchi vazifaning haddan tashqari katta vazn olishi umumiy tasvir makonida precision-recall muvozanatini buzadigan bosim hosil qilishi mumkin.
To‘liq muvozanatlangan pastdan tanlash bilan taqqoslash
Tadqiqotchilar usul foydasi faqat sinflarni son jihatdan tenglashtirishdan kelib chiqadimi-yo‘qmi, buni tekshirish uchun alohida tajriba o‘tkazgan. Drusen sinfidagi 8.957 ta namuna mezon sifatida olingan va boshqa uch sinf tasodifiy ravishda 8.957 ta namunagacha kamaytirilib, jami 35.828 ta tasvirdan iborat muvozanatlangan quyi to‘plamlar tuzilgan. Uch xil tasodifiy seed bilan uchta mustaqil muvozanatlangan ma’lumotlar quyi to‘plami tayyorlangan va EfficientNet-B0 xuddi shu o‘qitish sozlamalari bilan qayta o‘qitilgan.
| O‘qitish strategiyasi | Accuracy (%) | Macro-F1 (%) | Drusen-F1 (%) |
|---|---|---|---|
| Nomutanosib ma’lumot baseline | 97.29 | 96.11 | 89.87 |
| Muvozanatlangan undersampling | 95.64 | 95.38 | 91.65 |
| Taklif etilgan usul | 97.78 | 96.87 | 93.51 |
Muvozanatlangan undersampling Drusen sinfini yaxshilagan bo‘lsa-da, ko‘pchilik sinflarga tegishli ko‘plab tasvirlarni o‘qitishdan chiqarib tashlagani uchun umumiy aniqlik va Macro-F1 pasaygan. Taklif etilgan yondashuv esa ma’lumotlar to‘plamining barchasini saqlagan holda optimallashtirish jarayonida sinf nomutanosibligiga ta’sir qiladi. Manbadagi 6-jadvalda “Imbalanced Baseline” Drusen-F1 qiymati %89,87 bo‘lsa, asosiy EfficientNet-B0 ablation jadvalida \(\lambda=0\) Drusen F1 %90,87; manba bu farq sababini alohida tushuntirmaydi.
Hisoblash xarajati va inference
| Model | O‘qitish vaqti (s) | GPU xotirasi (GB) | Inference (ms) |
|---|---|---|---|
| ResNet-18 | 179.71 | 0.51 | 9.68 |
| Yordamchi nazoratli ResNet-18 | 201.52 | 0.74 | 9.71 |
| ResNet-50 | 371.34 | 1.70 | 12.40 |
| Yordamchi nazoratli ResNet-50 | 443.79 | 2.18 | 12.38 |
| EfficientNet-B0 | 243.05 | 1.67 | 11.13 |
| Yordamchi nazoratli EfficientNet-B0 | 294.84 | 2.04 | 11.16 |
| ViT-B/16 | 1356.21 | 3.10 | 12.33 |
| Yordamchi nazoratli ViT-B/16 | 1862.17 | 3.75 | 12.54 |
Yordamchi bosh o‘qitishda qo‘shimcha oldinga/orqaga tarqatish va xotira xarajatini keltirib chiqaradi. Biroq manba usulida yordamchi bosh inference vaqtida o‘chirib qo‘yiladi. Shu sababli taklif etilgan tizimning asosiy afzalliklaridan biri o‘rganish vaqtida qo‘shimcha nazoratdan foydalanib, joylashtirish bosqichida taxminan asosiy backbone ning inference xarajatini saqlab qolishidir. 7-jadvalda o‘lchangan kichik millisekund farqlar amalda baseline bilan bir xil inference darajasida qoladi.
Talqin qilinuvchanlik: Drusenda ko‘proq yo‘naltirilgan aktivatsiya
Manbadagi Grad-CAM va Attention Rollout taqqoslashida Drusen yordamchi yo‘qotish bilan birga eng sezilarli vizual o‘zgarishni ko‘rsatgan sinfdir. ResNet-18, ResNet-50 va EfficientNet-B0 ning baseline xaritalarida aktivatsiya kengroq hududlarga tarqalgan bo‘lsa, optimal \(\lambda\) ostida e’tibor tashqi retinal qatlam va Drusen hududiga tomon keskinroq jamlangani ko‘rinadi.
CNV namunalarida ham baseline, ham yordamchi nazoratli modellar allaqachon kuchli va lokalizatsiyalangan e’tibor ko‘rsatgan. DME da aktivatsiyalar markaziy retinal qatlamlar va intraretinal suyuqlik hududlari bilan umuman mos bo‘lib qolgan. Bu holat yordamchi nazorat ko‘pchilik yoki osonroq ajratiladigan sinflar samaradorligini yaxshilash evaziga buzishdan ko‘ra, ayniqsa qiyin va kam uchraydigan sinfdagi xususiyat tasvirini kuchaytiradi, degan talqinni qo‘llab-quvvatlaydi.
ViT-B/16 va oq padding ga sezgirlik
ViT-B/16 OCT tasvirini 16 × 16 patch larga bo‘ladi va global self-attention bilan qayta ishlaydi. Manba 6-rasmda anatomik ma’lumot tashimaydigan oq chet hududlari ViT e’tibor xaritasida CNN larga qaraganda ko‘proq ko‘rinishi ko‘rsatilgan. ResNet va EfficientNet ning lokal konvolyutsiyalari retinal qatlamlarga zichroq aktivatsiya hosil qilgan bo‘lsa, ViT ning e’tibor taqsimoti kengroqdir.
Bu kuzatuv manbada arxitekturaviy izoh bilan bog‘langan: konvolyutsion modellar lokal receptive field va translation-equivariance turidagi induktiv og‘ishlarga ega, ViT esa ilk qatlamlardanoq barcha patch lar o‘rtasida global bog‘lanish o‘rnatishi mumkin. Shunga qaramay, tadqiqot padding ViT samaradorligi pasayishining yagona va aniq sababi ekanini eksperimental ravishda ajratib ko‘rsatmagan. Fonni niqoblash yoki retinal qatlamni kesib olish kabi maxsus oldindan ishlov berishlar sinovdan o‘tkazilmaganligi sababli bu mexanizm kuchli kuzatuvga asoslangan izoh sifatida saqlanishi kerak.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Oraliq qatlam yordamchi tasnifi bilan teskari chastota asosida vaznlangan yo‘qotishni birgalikda qo‘llash tekshirilgan to‘rtta arxitekturada Drusen F1 samaradorligini baseline ga nisbatan oshirgan.
- Konvolyutsion modellar uchun \(\lambda=0.3\), ViT-B/16 uchun \(\lambda=0.5\) eng maqbul yordamchi ta’sir darajasini bergan.
- EfficientNet-B0 tekshirilgan konfiguratsiyalar ichida eng yuqori umumiy aniqlik va eng yuqori Drusen F1-skorini ko‘rsatgan.
- Optimal yordamchi nazorat Grad-CAM va Attention Rollout xaritalarida ayniqsa Drusen uchun ko‘proq yo‘naltirilgan anatomik e’tibor bilan birga kuzatilgan.
- Yordamchi boshni inference vaqtida olib tashlash mumkinligi sababli samaradorlik o‘sishi sezilarli test-vaqti hisoblash yukini talab qilmagan.
- Tasodifiy undersampling ozchilik sinfini qisman yaxshilagan bo‘lsa-da, barcha ma’lumot xilma-xilligini saqlagan taklif etilgan usul alohida taqqoslashda yuqoriroq aggregate samaradorlik ko‘rsatgan.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- Natijalar usul turli OCT qurilmalarida yoki turli shifoxonalarda ayni samaradorlikni ko‘rsatishini isbotlamaydi.
- Tadqiqot prospektiv klinik tadqiqot emas va real klinik ish jarayonida bemor natijalarining yaxshilanishini ko‘rsatmagan.
- Grad-CAM yoki Attention Rollout xaritasining anatomik jihatdan mazmunli ko‘rinishi o‘zi model qarori klinik jihatdan to‘g‘ri mexanizmga asoslanganini qat’iy isbotlamaydi.
- ViT-B/16 ning past samaradorligi faqat oq padding sababli ekanligi isbotlanmagan; maxsus padding olib tashlash ablation i bajarilmagan.
- Yordamchi nazorat ta’siri bilan teskari sinf vaznlashning mustaqil ta’sirlari to‘liq faktorial ablation orqali ajratilmagan.
- Bitta benchmark ma’lumotlar to‘plamidagi yuqori aniqlik model boshqa populyatsiyalar yoki qurilmalarda klinik foydalanishga tayyor degani emas.
Asosiy cheklovlar va kelajakdagi tadqiqotlar
Tadqiqotning birinchi cheklovi barcha tajribalar bitta benchmark ma’lumotlar to‘plami va qat’iy to‘rt sinfli diagnostik taksonomiyada o‘tkazilganidir. Ko‘p markazli yoki prospektiv tashqi validatsiya mavjud bo‘lmagani sababli ma’lumotlar to‘plamiga xos tasvir xususiyatlari model xulqiga qay darajada ta’sir qilishi to‘liq noma’lum.
Ikkinchi cheklov taklif etilgan usulning ikki asosiy komponenti — teskari chastota bo‘yicha vaznlash va oraliq qatlam yordamchi nazorati — ning mustaqil va birgalikdagi ta’sirlari to‘liq faktorial tarzda ajratilmaganidir. Manba \(\lambda\) uchun keng ablation taqdim etadi, biroq “faqat sinf vazni”, “faqat yordamchi bosh” va “ikkalasi birga” shartlarining barcha arxitekturalarda alohida mexanistik matritsasi berilmagan.
Uchinchi cheklov ViT-B/16 ning padding ga sezgirligidir. Avtomatik fon niqoblash, faqat retina hududini kesib olish yoki konvolyutsiya-attention gibrid arxitekturalari kelajakda baholanishi mumkin. Manba, shuningdek, adaptive auxiliary weighting, leziya segmentatsiyasi va kasallik darajalash kabi qo‘shimcha yordamchi vazifalarni o‘rganishni tavsiya qiladi.
Manba va Usul Haqida Izoh
Asl tadqiqot: Interpretable Deeply Supervised Networks for Class-Imbalanced OCT Classification
Mualliflar: Maria V. Leyba-Mesa; Buket D. Barkana.
Mas’ul muallif: Buket D. Barkana.
Muassasa: Department of Biomedical Engineering, College of Engineering and Polymer Science, The University of Akron, Akron, Ohio, AQSH.
Jurnal: AI.
Nashriyot: MDPI, Basel, Switzerland.
Bibliografik yozuv: AI 2026, 7(5), 164.
DOI: 10.3390/ai7050164.
Rasmiy nashr havolasi: MDPI rasmiy maqola sahifasi.
Nashr jarayoni: Qabul qilindi 16 Mart 2026; qayta ko‘rib chiqildi 5 May 2026; ma’qullandi 6 May 2026; nashr etildi 8 May 2026. Rasmiy MDPI versiya qaydlarida Version of Record PDF 8 May 2026, yangilangan PDF esa 14 May 2026 sanasida qayd etilgan.
Manba turi: Taqriz jarayonidan o‘tgan tadqiqot maqolasi.
Litsenziya: Ochiq kirish, Creative Commons Attribution (CC BY). Shunga qaramay, Verianla bayoni original gap tuzilishi va mustaqil ta’limiy arxitektura bilan tayyorlangan; manba rasmlari aynan ko‘chirib olinmagan.
Ma’lumot: Kermany OCT ma’lumotlar to‘plami; manba tadqiqotida 84.495 ta OCT skani, to‘rtta diagnostik sinf va bemor darajasida ma’lumotlarni ajratish qo‘llangan. Maqolaning ma’lumotlardan foydalanish mumkinligi bayonotida ishlatilgan ma’lumot Kaggle dagi Kermany2018 ma’lumotlar to‘plamida joylashgani va kirish sanasi 12 Sentyabr 2024 ekani aytilgan.
Moliyalashtirish: Mualliflar tadqiqot tashqi moliyalashtirish olmaganini bildirgan.
Etik bayonotlar: Institutional Review Board Statement “Not Applicable”; Informed Consent Statement “Not applicable” deb berilgan.
Minnatdorchilik: Mualliflar The University of Akron dagi Margaret F. Donovan Endowment qo‘llab-quvvatlashini e’tirof etadilar.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildirgan.
Mualliflar hissasi: Konseptuallashtirish M.V.L.-M. va B.D.B.; metodologiya, dasturiy ta’minot, formal tahlil, tadqiqot, ma’lumotlar kuratsiyasi va vizuallashtirish asosan M.V.L.-M.; resurslar, nazorat va loyiha boshqaruvi B.D.B.; validatsiya ikki muallif; dastlabki qoralama M.V.L.-M.; ko‘rib chiqish va tahrirlash B.D.B. tomonidan bajarilgan deb hisobot qilingan.
Manba ichidagi texnik izoh 1: ViT-B/16 natijalari berilgan 4.4-bo‘limning kirish gapida 5-jadval xato tarzda “ResNet-50 classifier” deb atalgan. Jadval sarlavhasi, matn davomi va qiymatlar ViT-B/16 ga tegishli; ushbu Verianla matnida ViT-B/16 sifatida ko‘rib chiqilgan.
Manba ichidagi texnik izoh 2: ResNet-50 muhokamasida \(\lambda=0.5\) dan keyingi paragrafda “\(\lambda=0\)” deb yozilgan. 3-jadvaldagi ketma-ketlik va shu paragrafdagi %96,69 aniqlik hamda %89,56 Drusen F1 qiymatlari buning \(\lambda=0.7\) shartiga to‘g‘ri kelishini ko‘rsatadi. Manbadagi yozuv nomuvofiqligi yashirilmagan.
Manba ichidagi texnik izoh 3: Asosiy EfficientNet-B0 ablation jadvalida \(\lambda=0\) uchun Drusen F1 %90,87 bo‘lsa, alohida balanced-dataset tajribasining 6-jadvalida “Imbalanced Baseline” Drusen-F1 %89,87 deb qayd etilgan. Manba bu farq sababini tushuntirmagani uchun ikki qiymat o‘z tajriba kontekstlarida alohida saqlangan.
Asosiy talqin chegarasi: Ushbu tadqiqot bitta benchmark OCT ma’lumotlar to‘plamidagi mashinaviy o‘rganish tajribasidir. Natijalar ko‘p markazli tashqi validatsiya, prospektiv klinik tadqiqot yoki bemor natijasiga asoslangan klinik samaradorlik dalili emas.
Vizual qayta chizish uchun moslik: Yuqori. Ikki boshli o‘qitish arxitekturasi, sinf nomutanosibligi oqimi, lambda-ablation natijalari va CNN-ViT e’tibor farqi manba ma’lumotlariga sodiq original sxemalar bilan qayta qurilishi mumkin.
Verianla Live / Live Figure uchun moslik: Qisman mos. Qat’iy manba ma’lumotlari asosida arxitektura va \(\lambda\) taqqoslashlarini bosqichma-bosqich ko‘rsatish mos keladi. Foydalanuvchining \(\lambda\) yoki boshqa giperparametrlarni o‘zgartirib, manbada bo‘lmagan yangi samaradorlik qiymatlarini yaratishi mos emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan