

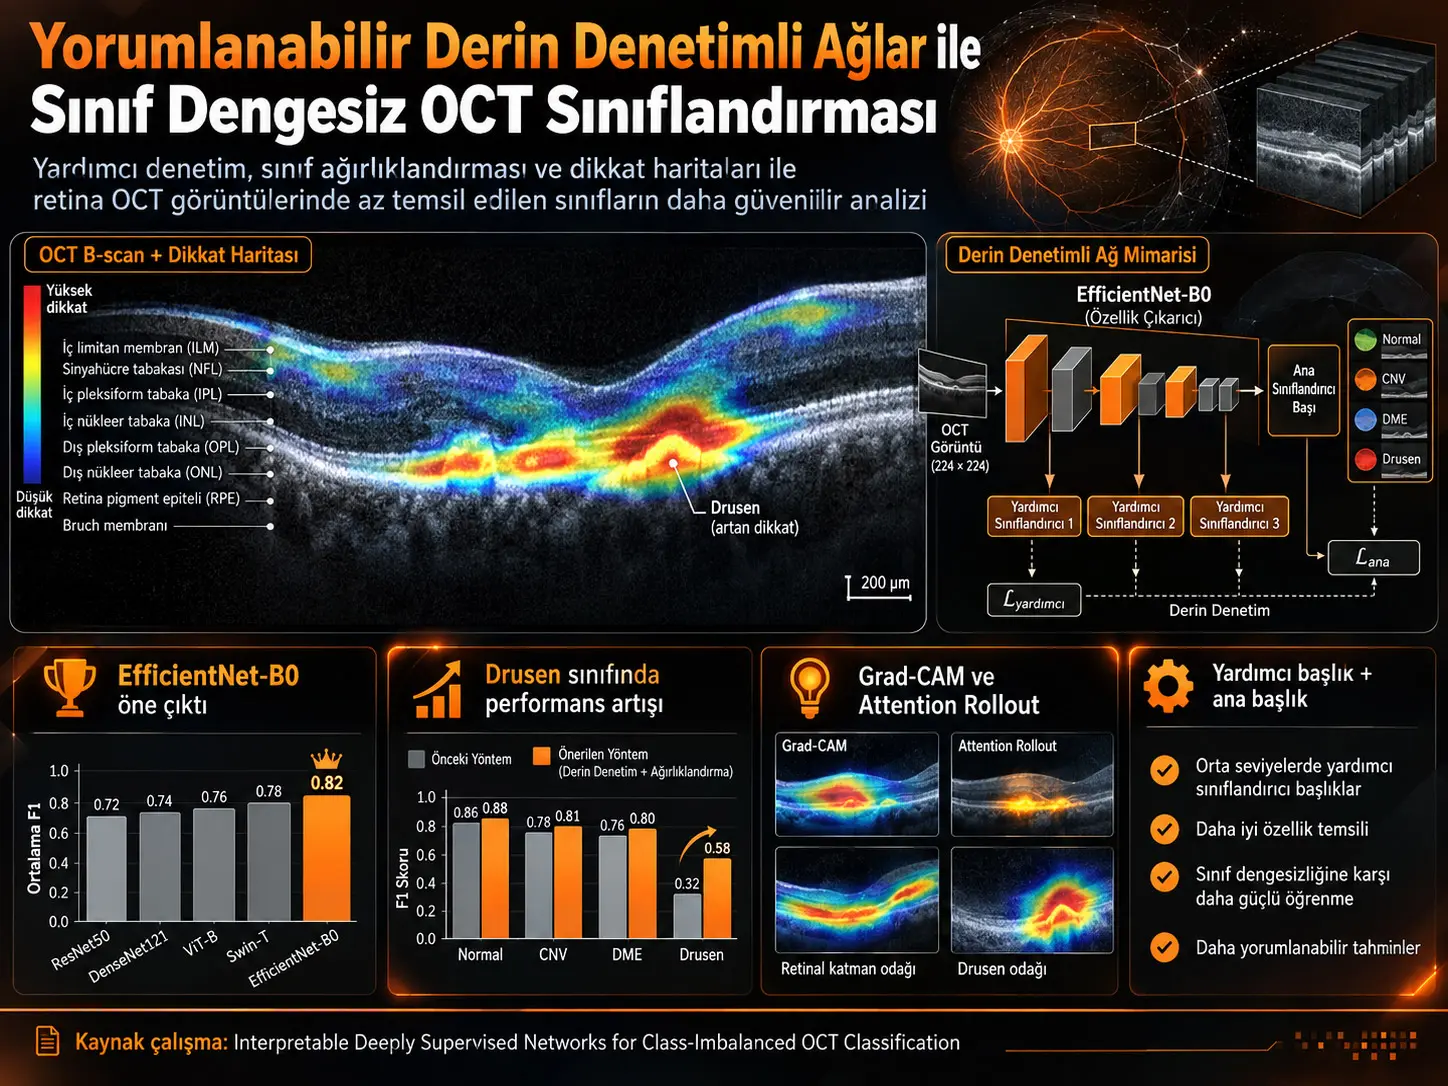
Bu çalışma, sınıf dağılımı dengesiz retina optik koherens tomografi görüntülerinin sınıflandırılmasında az temsil edilen hastalık sınıflarının daha güvenilir öğrenilmesini hedefleyen ara katman yardımcı denetim yaklaşımını inceliyor. Ara katman yardımcı denetim, ana sınıflandırıcıya ek olarak ağın orta düzey özelliklerine ikinci bir sınıflandırıcı başlık bağlayan ve bu başlığı yalnız eğitim sırasında ana görevle birlikte optimize eden bir derin öğrenme düzenidir. Araştırmacılar bu düzeni ResNet-18, ResNet-50, EfficientNet-B0 ve Vision Transformer ViT-B/16 üzerinde, dört sınıftan oluşan 84.495 OCT taramasıyla değerlendirmiştir. Veri setinde Drusen yaklaşık %10,6 ile en az temsil edilen sınıftır.
Yöntem iki mekanizmayı birlikte kullanır. İlk olarak, az örneğe sahip sınıfların eğitim kaybına katkısı ters sınıf frekansıyla artırılır. İkinci olarak, aynı dört sınıflı tanı etiketi ağın yalnız son katmanına değil, mimariye göre seçilmiş bir ara katmana da uygulanır. Ana kayıp ile yardımcı kayıp arasındaki denge \(\lambda\) katsayısıyla kontrol edilir ve çalışmada \(\lambda \in \{0.0, 0.3, 0.5, 0.7, 0.9\}\) değerleri sistematik biçimde karşılaştırılır.
En güçlü genel sonuç EfficientNet-B0 için \(\lambda=0.3\) koşulunda elde edilmiştir: genel doğruluk %97,78'e ulaşırken Drusen sınıfında hassasiyet %92,54, duyarlılık/recall %94,51, özgüllük %99,29 ve F1-skoru %93,51 olarak raporlanmıştır. EfficientNet-B0'nun ana ablation tablosundaki ağırlıksız \(\lambda=0\) koşulunda Drusen F1-skoru %90,87 olduğundan artış 2,64 yüzde puanıdır. ResNet-18 ve ResNet-50 de orta düzey yardımcı kayıptan yararlanırken ViT-B/16'nın en uygun değeri \(\lambda=0.5\) olmuştur.
Sonuçlar yalnız genel doğruluk üzerinden değerlendirilmemiştir. Grad-CAM ve Attention Rollout incelemeleri, uygun yardımcı denetim altında özellikle Drusen örneklerinde model dikkatinin klinik açıdan ilgili retinal yapılara daha iyi yoğunlaşabildiğini göstermiştir. Bununla birlikte ViT-B/16, veri setindeki beyaz kenar ve padding bölgelerine konvolüsyonel modellere göre daha fazla duyarlılık göstermiştir. Çalışma tek bir benchmark veri setine dayandığı ve dış, çok merkezli veya prospektif klinik doğrulama içermediği için sonuçlar doğrudan gerçek klinik kullanım başarısı olarak yorumlanmamalıdır.
Temel problem: yüksek genel doğruluk azınlık sınıfındaki hatayı gizleyebilir
Optik koherens tomografi (optical coherence tomography, OCT), retinanın katmanlı yapısını kesitsel olarak görüntüleyen, invaziv olmayan bir görüntüleme yöntemidir. Çalışmada kullanılan veri seti dört tanısal kategori içerir: koroidal neovaskülarizasyon (CNV), diyabetik maküla ödemi (DME), Drusen ve normal retina. Sınıfların dağılımı eşit değildir: CNV yaklaşık %44,5, normal retina %31,5, DME %13,6 ve Drusen %10,6 oranındadır.
Bu dağılım altında yalnız genel doğruluğa bakmak yanıltıcı olabilir. Model çoğunluk sınıflarını çok iyi öğrendiğinde yüksek toplam doğruluk üretebilir; buna karşılık daha seyrek görülen Drusen gibi bir sınıfın hassasiyeti, recall değeri veya F1-skoru belirgin biçimde daha düşük kalabilir. Araştırmanın merkezi problemi bu nedenle “model kaç görüntüyü doğru sınıflandırıyor?” sorusundan daha dar ve klinik açıdan daha önemli bir soruya dönüşür: az temsil edilen retinal patoloji sınıflarının özellikleri ağın temsil uzayında yeterince güçlü öğrenilebiliyor mu?
Kaynakta verilen OCT örnekleri ayrıca görüntülerin tamamının yalnız retinal dokudan oluşmadığını gösterir. Bazı taramalarda eğim, döndürme ve özellikle görüntü kenarlarında anatomik bilgi taşımayan beyaz arka plan/padding alanları bulunur. Bu ayrıntı, daha sonra ViT-B/16 ile konvolüsyonel ağlar arasında gözlenen dikkat farkının yorumlanması açısından önemlidir.
Ara Denetim Sınıf Dengesizliğini Nasıl Hedefliyor?
Ara denetim, aynı tanısal etiketi ağın yalnız son sınıflandırıcı başlığına değil, orta düzey özelliklerine bağlı ikinci bir yardımcı başlığa da uygulayarak eğitim gradyanının ağın daha erken katmanlarına doğrudan ulaşmasını sağlar; bu çalışmada yardımcı kayıp ters sınıf frekanslarıyla ağırlıklandırıldığı için azınlık sınıflarının temsilinin orta özellik düzeyinde de güçlendirilmesi hedeflenmiştir.
Bu yaklaşım yeni bir segmentasyon etiketi, lezyon maskesi veya ayrı klinik anotasyon istemez. Yardımcı ve ana başlık aynı dört sınıflı doğru etiketi kullanır. Dolayısıyla ek denetim, yeni bir semantik görev tanımlamak yerine aynı sınıflandırma problemini ağın farklı derinliklerinde tekrar görünür hale getirir.
Ters frekans sınıf ağırlıkları
Her sınıf için ağırlık Denklem (1) ile tanımlanır:
\[ w_i=\frac{N}{C\,n_i} \]
Burada \(N\) eğitim örneklerinin toplam sayısını, \(C\) sınıf sayısını ve \(n_i\) ilgili \(i\) sınıfındaki örnek sayısını gösterir. Bir sınıfta örnek sayısı azaldıkça \(n_i\) küçülür ve \(w_i\) büyür. Matematiksel olarak bu, az temsil edilen sınıflardaki yanlış sınıflandırmaların kayıp fonksiyonunda daha yüksek ağırlık alması anlamına gelir. Bu çalışma için \(C=4\)'tür.
Ters Frekans Sınıf Ağırlığı Neden Tek Başına Son Katmana Bırakılmamıştır?
Çalışmanın yaklaşımı yalnız son sınıflandırıcıdaki örnek ağırlıklarını değiştirmekle yetinmez; aynı ağırlıklı tanı hedefini ara özellik seviyesinde de uygular, böylece azınlık sınıfının öğrenme sinyali ağın özellik hiyerarşisinin daha erken bir bölümüne taşınır ve yardımcı başlık ile ana başlık birlikte optimize edilir.
Mimarilere göre yardımcı bağlantı noktaları aynı değildir. ResNet-18 ve ResNet-50 için yardımcı başlık layer3 çıkışına bağlanır; ara temsil boyutları sırasıyla 256 ve 1024 kanaldır. EfficientNet-B0'da orta genişleme/MBConv bölgesinin yaklaşık 6-8. blokları kullanılır. ViT-B/16 için yardımcı denetim altıncı transformer bloğunun 768 boyutlu gösterimine uygulanır.
Yardımcı başlık ara aktivasyonu global average pooling ile sıkıştırır ve tam bağlı katman üzerinden dört logit üretir:
\[ \mathbf{f}_{aux}=FC(GAP(\mathbf{A}_{int})), \qquad \mathbf{A}_{int}\in\mathbb{R}^{H'\times W'\times C} \]
\(H'\) ve \(W'\) ara özellik haritasının uzamsal boyutlarını, \(C\) kanal sayısını gösterir. Global average pooling, her özellik kanalını uzamsal olarak özetler; tam bağlı katman ise bu temsili dört tanısal sınıfa ait logitlere dönüştürür.
Ana ve yardımcı kaybın birleştirilmesi
Toplam eğitim amacı Denklem (3) ile kurulmuştur:
\[ \mathcal{L}_{total} = \mathcal{L}_{main}(\hat{\mathbf{y}}_{main},\mathbf{y}) + \lambda\,\mathcal{L}_{aux}(\hat{\mathbf{y}}_{aux},\mathbf{y}) \]
Burada \(\mathcal{L}_{main}\) ana başlığın, \(\mathcal{L}_{aux}\) yardımcı başlığın ters frekans ağırlıklı çapraz entropi kaybıdır. \(\lambda\), yardımcı başlığın toplam optimizasyondaki etkisini belirler. \(\lambda=0\) olduğunda yardımcı kayıp toplam hedefe katkı vermez ve eğitim standart tek başlıklı duruma indirgenir.
Yardımcı Kayıp Ağırlığı Lambda Neden Kritik?
\(\lambda\), yardımcı sınıflandırma hedefinin paylaşılan özellik uzayını ne kadar güçlü yönlendirdiğini belirlediği için kritik bir hiperparametredir; çalışma, çok düşük yardımcı etkinin azınlık sınıfı için sınırlı yarar sağladığını, aşırı yüksek etkinin ise hassasiyet-recall dengesini bozabildiğini ve en iyi sonuçların çoğu konvolüsyonel ağda \(\lambda=0.3\), ViT-B/16'da ise \(\lambda=0.5\) çevresinde ortaya çıktığını göstermiştir.
Bu sonuç \(\lambda\)'nın “ne kadar büyük, o kadar iyi” biçiminde yorumlanamayacağını gösterir. Yardımcı kayıp ana görevi destekleyen bir düzenleyici olarak çalışmalıdır; ana görevin optimizasyonunu bastıracak kadar güçlü hale geldiğinde azınlık sınıfındaki precision ve F1 değerleri gerileyebilir.
Eğitim protokolü
Dört model de ImageNet-1K ile önceden eğitilmiş ağırlıklardan başlatılmıştır. AdamW optimize edicisi için ilk öğrenme oranı \(1\times10^{-4}\), weight decay \(1\times10^{-4}\), batch boyutu 16 ve eğitim bütçesi 20 epoch'tur. Cosine annealing zamanlayıcısında minimum öğrenme oranı \(1\times10^{-6}\) olarak belirlenmiştir.
Veri, hasta düzeyinde stratified sampling ile %70 eğitim, %15 doğrulama ve %15 test bölümlerine ayrılmış; aynı hastanın birden fazla bölüme düşmemesi sağlanmıştır. Hiperparametre ayarı doğrulama setiyle gerçekleştirilmiş ve test seti son değerlendirme için ayrılmıştır. Kaynak ayrıca hasta düzeyinde beş katlı stratified cross-validation uygulandığını ve nihai performansın katlar üzerindeki ortalama olarak raporlandığını belirtir. Buna karşın ana sonuç tablolarında katlar arası standart sapma veya güven aralığı ayrıca sunulmamaktadır.
Deneyler Python 3.11 ve PyTorch 2.5.1+CU121 ile; CUDA/cuDNN etkin bir NVIDIA RTX 2000 Ada Generation GPU, Intel Core Ultra 9 285 2.50 GHz işlemci ve 32 GB sistem belleği üzerinde yürütülmüştür.
Softmax ve sınıf olasılıkları
Dört sınıfa ait ham logitler \(Z_i\), softmax ile olasılığa dönüştürülür:
\[ \hat{y}_i = \frac{e^{Z_i}} {\sum_{j=1}^{4}e^{Z_j}} \]
Bu dönüşüm her sınıf için negatif olmayan olasılıklar üretir ve dört olasılığın toplamını 1'e eşitler.
Grad-CAM ve Attention Rollout Bu Çalışmada Neyi Gösteriyor?
Grad-CAM ve Attention Rollout, modelin yalnız doğru veya yanlış karar verdiğini değil, bu kararı üretirken görüntünün hangi bölgelerine ağırlık verdiğini incelemek için kullanılmıştır; Grad-CAM ResNet-18, ResNet-50 ve EfficientNet-B0'da, Attention Rollout ise ViT-B/16'da uygulanmış ve optimum yardımcı denetim altında özellikle Drusen örneklerinde dikkatin retinal patoloji bölgelerine daha fazla yoğunlaşabildiği gözlenmiştir.
Grad-CAM matematiği
Bir hedef sınıf \(c\) için özellik haritası \(A^k\)'nın sınıf skoruna katkısı, gradyanların uzamsal ortalamasıyla ağırlıklandırılır:
\[ \alpha_k^c = \frac{1}{Z} \sum_i\sum_j \frac{\partial y^c}{\partial A_{ij}^k} \]
Ardından sınıfa özgü Grad-CAM haritası:
\[ L_{\mathrm{Grad-CAM}}^c = ReLU\left( \sum_k \alpha_k^c A^k \right) \]
ile hesaplanır. ReLU işlemi hedef sınıfa pozitif katkıda bulunan bölgeleri korur. Kaynakta üretilen ısı haritaları 224 × 224 OCT görüntüsüne yeniden ölçeklenerek retinal yapı üzerine bindirilmiştir.
ViT-B/16 için Attention Rollout
Transformer'ın her katmanında \(H\) attention head'den gelen dikkat matrisleri ortalanır ve residual bağlantıyı hesaba katmak için kimlik matrisi eklenir:
\[ \tilde{A}^{\,l} = \frac{1}{H} \sum_{h=1}^{H}A_h^{\,l} + I \]
Kaynak yöntemde satırlar normalize edildikten sonra katmanlar boyunca değiştirilmiş attention matrisleri ardışık olarak çarpılır. Böylece sınıf tokeninin giriş patch'lerine kadar yayılan kümülatif dikkat ilişkisi elde edilir. Patch düzeyindeki değerler tekrar görüntü düzlemine taşınarak OCT üzerine bindirilir.
Değerlendirme metrikleri
| Metrik | Formül | Bilimsel anlam |
|---|---|---|
| Accuracy | \(\displaystyle Acc=\frac{TP+TN}{TP+TN+FP+FN}\) | Tüm örnekler içinde doğru sınıflandırılanların oranı; sınıf dengesizliğinde tek başına yeterli değildir. |
| Precision | \(\displaystyle Precision_c=\frac{TP_c}{TP_c+FP_c}\) | Modelin sınıf \(c\) dediği örneklerin ne kadarının gerçekten o sınıfa ait olduğunu gösterir. |
| Recall | \(\displaystyle Recall_c=\frac{TP_c}{TP_c+FN_c}\) | Gerçek sınıf \(c\) örneklerinin ne kadarının yakalandığını ölçer. |
| Specificity | \(\displaystyle Specificity_c=\frac{TN_c}{TN_c+FP_c}\) | Sınıf \(c\)'ye ait olmayan örneklerin doğru biçimde negatif olarak ayrılma oranıdır. |
| F1-skoru | \(\displaystyle F1_c=2\frac{Precision_c\times Recall_c}{Precision_c+Recall_c}\) | Precision ve recall arasındaki harmonik dengeyi ölçer; azınlık sınıfı değerlendirmesinde özellikle yararlıdır. |
| AUROC | \(\displaystyle AUROC_c=\int_0^1 TPR_c(FPR_c^{-1}(u))\,du\) | Belirli tek bir karar eşiğine bağlı kalmadan sınıfın ayırt edilebilirliğini ölçer. |
Çalışmanın Yöntemi ve Bulguları
Ablation tasarımı
Her omurga mimarisinde yardımcı kayıp katsayısı \(\lambda=0.0, 0.3, 0.5, 0.7, 0.9\) değerlerinde değiştirilmiştir. Bu tasarımın amacı yalnız en yüksek genel doğruluğu bulmak değil, özellikle Drusen sınıfında precision, recall, specificity, F1 ve AUROC değerlerinin yardımcı denetime nasıl tepki verdiğini ortaya koymaktır.
Hangi Yardımcı Kayıp Düzeyi En İyi Sonucu Verdi?
ResNet-18, ResNet-50 ve EfficientNet-B0 için en dengeli sonuçlar \(\lambda=0.3\) çevresinde elde edilirken ViT-B/16 için en uygun nokta \(\lambda=0.5\) olmuştur; en yüksek genel performansı EfficientNet-B0 \(\lambda=0.3\) ile %97,78 doğruluk ve %93,51 Drusen F1-skoruyla üretmiştir.
| Model | En uygun \(\lambda\) | Genel doğruluk (%) | Drusen precision (%) | Drusen recall (%) | Drusen specificity (%) | Drusen F1 (%) | Drusen AUROC (%) |
|---|---|---|---|---|---|---|---|
| ResNet-18 | 0.3 | 97.58 | 87.61 | 95.90 | 98.49 | 91.28 | 99.6 |
| ResNet-50 | 0.3 | 97.02 | 88.02 | 95.69 | 98.58 | 91.69 | 99.5 |
| EfficientNet-B0 | 0.3 | 97.78 | 92.54 | 94.51 | 99.29 | 93.51 | 99.5 |
| ViT-B/16 | 0.5 | 95.76 | 84.94 | 89.73 | 98.23 | 87.27 | 98.9 |
Drusen sınıfındaki değişim
| Model | \(\lambda=0\) Drusen F1 (%) | Optimum Drusen F1 (%) | Değişim (yüzde puanı) |
|---|---|---|---|
| ResNet-18 | 89.80 | 91.28 | +1.48 |
| ResNet-50 | 89.08 | 91.69 | +2.61 |
| EfficientNet-B0 | 90.87 | 93.51 | +2.64 |
| ViT-B/16 | 85.25 | 87.27 | +2.02 |
Bu tablo, yardımcı denetimin etkisinin mimariye göre aynı olmadığını gösterir. EfficientNet-B0 en yüksek Drusen F1 değerini üretirken, ViT-B/16 başlangıçta en düşük Drusen F1 değerine sahiptir ve yardımcı denetimden yararlansa da konvolüsyonel modellerin seviyesine ulaşmamıştır.
Neden aşırı yüksek lambda yararlı olmadı?
Kaynak tablolarında \(\lambda\) yükseldikçe performansın monoton biçimde artmadığı görülür. Örneğin ResNet-18'de \(\lambda=0.9\) koşulunda Drusen precision %83,59 ve F1 %88,37'ye geriler. EfficientNet-B0'da da \(\lambda=0.9\) Drusen F1'i %90,37'dir ve \(\lambda=0.3\)'teki %93,51 seviyesinin altındadır. Yardımcı görevin aşırı ağırlık kazanması, paylaşılan temsil üzerinde precision-recall dengesini bozabilecek bir baskı oluşturabilir.
Tam dengeli alt örnekleme ile karşılaştırma
Araştırmacılar yöntemin yararının yalnızca sınıfları sayısal olarak eşitlemekten kaynaklanıp kaynaklanmadığını sınamak için ayrı bir deney gerçekleştirmiştir. Drusen sınıfındaki 8.957 örnek referans alınmış ve diğer üç sınıf rastgele 8.957 örneğe indirilerek toplam 35.828 görüntülük dengeli alt kümeler oluşturulmuştur. Üç farklı rastgele seed ile üç bağımsız dengeli veri alt kümesi hazırlanmış ve EfficientNet-B0 aynı eğitim ayarlarıyla yeniden eğitilmiştir.
| Eğitim stratejisi | Accuracy (%) | Macro-F1 (%) | Drusen-F1 (%) |
|---|---|---|---|
| Dengesiz veri baseline | 97.29 | 96.11 | 89.87 |
| Dengeli undersampling | 95.64 | 95.38 | 91.65 |
| Önerilen yöntem | 97.78 | 96.87 | 93.51 |
Dengeli undersampling Drusen sınıfını iyileştirirken çoğunluk sınıflarına ait çok sayıda görüntüyü eğitimden çıkardığı için genel doğruluk ve Macro-F1 gerilemiştir. Önerilen yaklaşım ise veri setinin tamamını koruyarak optimizasyon sırasında sınıf dengesizliğine müdahale etmektedir. Kaynaktaki Tablo 6'nın “Imbalanced Baseline” Drusen-F1 değeri %89,87 iken ana EfficientNet-B0 ablation tablosunda \(\lambda=0\) Drusen F1 %90,87'dir; kaynak bu farkın nedenini ayrıca açıklamamaktadır.
Hesaplama maliyeti ve çıkarım
| Model | Eğitim süresi (s) | GPU belleği (GB) | Çıkarım (ms) |
|---|---|---|---|
| ResNet-18 | 179.71 | 0.51 | 9.68 |
| Yardımcı denetimli ResNet-18 | 201.52 | 0.74 | 9.71 |
| ResNet-50 | 371.34 | 1.70 | 12.40 |
| Yardımcı denetimli ResNet-50 | 443.79 | 2.18 | 12.38 |
| EfficientNet-B0 | 243.05 | 1.67 | 11.13 |
| Yardımcı denetimli EfficientNet-B0 | 294.84 | 2.04 | 11.16 |
| ViT-B/16 | 1356.21 | 3.10 | 12.33 |
| Yardımcı denetimli ViT-B/16 | 1862.17 | 3.75 | 12.54 |
Yardımcı başlık eğitimde ek ileri/geri yayılım ve bellek maliyeti oluşturur. Ancak kaynak yönteminde yardımcı başlık çıkarım sırasında devre dışı bırakılır. Bu nedenle önerilen sistemin temel avantajlarından biri, öğrenme sırasında ek denetim kullanırken dağıtım aşamasında yaklaşık olarak ana omurganın çıkarım maliyetini korumasıdır. Tablo 7'de ölçülen küçük milisaniye farklılıkları pratik olarak baseline ile aynı çıkarım düzeyinde kalmaktadır.
Yorumlanabilirlik: Drusen'de daha odaklı aktivasyon
Kaynağın Grad-CAM ve Attention Rollout karşılaştırmasında Drusen, yardımcı kayıpla birlikte en belirgin görsel değişimi gösteren sınıftır. ResNet-18, ResNet-50 ve EfficientNet-B0'nun baseline haritalarında aktivasyon daha geniş alanlara yayılırken optimum \(\lambda\) altında dikkatin dış retinal katman ve Drusen bölgesine doğru keskinleştiği görülür.
CNV örneklerinde hem baseline hem yardımcı denetimli modeller zaten güçlü ve lokalize dikkat sergilemiştir. DME'de aktivasyonlar santral retinal katmanlar ve intraretinal sıvı bölgeleriyle genel olarak uyumlu kalmıştır. Bu durum yardımcı denetimin çoğunluk veya daha kolay ayrılan sınıfların performansını iyileştirmek uğruna bozmaktan çok, özellikle zor ve seyrek sınıftaki özellik temsilini güçlendirdiği yorumunu desteklemektedir.
ViT-B/16 ve beyaz padding duyarlılığı
ViT-B/16, OCT görüntüsünü 16 × 16 patch'lere böler ve global self-attention ile işler. Kaynak Şekil 6'da, anatomik bilgi taşımayan beyaz kenar alanlarının ViT dikkat haritasında CNN'lere kıyasla daha fazla görünür olduğu gösterilmiştir. ResNet ve EfficientNet'in yerel konvolüsyonları retinal katmanlara daha yoğun aktivasyon üretirken ViT'nin dikkat dağılımı daha geniştir.
Bu gözlem kaynakta mimari bir açıklamayla ilişkilendirilir: konvolüsyonel modeller yerel receptive field ve translation-equivariance türü endüktif önyargılara sahipken ViT ilk katmanlardan itibaren bütün patch'ler arasında global ilişki kurabilir. Buna rağmen çalışma, padding'in ViT performans kaybının tek ve kesin nedeni olduğunu deneysel olarak izole etmiş değildir. Arka plan maskeleme veya retinal katman kırpma gibi özel ön işlemler test edilmediği için bu mekanizma güçlü bir gözlemsel açıklama olarak tutulmalıdır.
Çalışmanın desteklediği sonuçlar
- Ara katman yardımcı sınıflandırma ile ters frekans ağırlıklı kaybın birlikte kullanılması, incelenen dört mimaride Drusen F1 performansını baseline'a göre artırmıştır.
- Konvolüsyonel modeller için \(\lambda=0.3\), ViT-B/16 için \(\lambda=0.5\) en uygun yardımcı etki düzeyini vermiştir.
- EfficientNet-B0, incelenen yapılandırmalar arasında en yüksek genel doğruluğu ve en yüksek Drusen F1-skorunu üretmiştir.
- Optimum yardımcı denetim, Grad-CAM ve Attention Rollout haritalarında özellikle Drusen için daha odaklı anatomik dikkat ile birlikte görülmüştür.
- Yardımcı başlığın çıkarım sırasında kaldırılabilmesi nedeniyle performans artışı belirgin bir test-zamanı hesaplama yükü gerektirmemiştir.
- Rastgele undersampling azınlık sınıfını kısmen iyileştirse de bütün veri çeşitliliğini koruyan önerilen yöntem ayrı karşılaştırmada daha yüksek aggregate performans göstermiştir.
Çalışmanın desteklemediği sonuçlar
- Sonuçlar, yöntemin farklı OCT cihazlarında veya farklı hastanelerde aynı performansı göstereceğini kanıtlamaz.
- Çalışma prospektif klinik çalışma değildir ve gerçek klinik iş akışında hasta sonucu iyileşmesi göstermemiştir.
- Grad-CAM veya Attention Rollout haritasının anatomik olarak anlamlı görünmesi tek başına model kararının klinik açıdan doğru mekanizmaya dayandığını kesin olarak kanıtlamaz.
- ViT-B/16'nın düşük performansının yalnız beyaz padding'den kaynaklandığı kanıtlanmamıştır; özel padding giderme ablasyonu yapılmamıştır.
- Yardımcı denetimin etkisi ile ters sınıf ağırlıklandırmasının bağımsız etkileri tam faktöriyel ablasyonla ayrıştırılmamıştır.
- Tek benchmark veri setindeki yüksek doğruluk, modelin başka popülasyonlarda veya cihazlarda klinik kullanıma hazır olduğu anlamına gelmez.
Temel sınırlılıklar ve gelecek çalışmalar
Çalışmanın ilk sınırı, bütün deneylerin tek bir benchmark veri seti ve sabit dört sınıflı tanı taksonomisi üzerinde yapılmasıdır. Çok merkezli veya prospektif harici doğrulama bulunmadığından veri setine özgü görüntü özelliklerinin model davranışını ne ölçüde etkilediği tam olarak bilinmemektedir.
İkinci sınır, önerilen yöntemin iki ana bileşeninin — ters frekans ağırlıklandırma ve ara katman yardımcı denetim — bağımsız ve ortak etkilerinin tam faktöriyel biçimde ayrıştırılmamasıdır. Kaynak \(\lambda\) için kapsamlı ablation sunar, ancak “yalnız sınıf ağırlığı”, “yalnız yardımcı başlık” ve “ikisi birlikte” koşullarının bütün mimarilerde ayrı bir mekanistik matrisi verilmemiştir.
Üçüncü sınır ViT-B/16'nın padding duyarlılığıdır. Otomatik arka plan maskeleme, yalnız retina bölgesinin kırpılması veya konvolüsyon-attention hibrit mimarileri gelecekte değerlendirilebilir. Kaynak ayrıca adaptive auxiliary weighting, lezyon segmentasyonu ve hastalık derecelendirmesi gibi ek yardımcı görevlerin araştırılmasını önermektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Interpretable Deeply Supervised Networks for Class-Imbalanced OCT Classification
Yazarlar: Maria V. Leyba-Mesa; Buket D. Barkana.
Sorumlu yazar: Buket D. Barkana.
Kurum: Department of Biomedical Engineering, College of Engineering and Polymer Science, The University of Akron, Akron, Ohio, ABD.
Dergi: AI.
Yayınevi: MDPI, Basel, Switzerland.
Bibliyografik kayıt: AI 2026, 7(5), 164.
DOI: 10.3390/ai7050164.
Resmî yayın bağlantısı: MDPI resmî makale sayfası.
Yayın süreci: Alınma 16 Mart 2026; revizyon 5 Mayıs 2026; kabul 6 Mayıs 2026; yayın 8 Mayıs 2026. Resmî MDPI sürüm notlarında Version of Record PDF'si 8 Mayıs 2026, güncellenmiş PDF ise 14 Mayıs 2026 tarihinde kayıtlıdır.
Kaynak türü: Hakem sürecinden geçmiş araştırma makalesi.
Lisans: Açık erişim, Creative Commons Attribution (CC BY). Verianla anlatımı buna rağmen özgün cümle yapısı ve bağımsız eğitimsel mimariyle hazırlanmıştır; kaynak şekilleri birebir kopyalanmamıştır.
Veri: Kermany OCT veri seti; kaynak çalışmada 84.495 OCT taraması, dört tanısal sınıf ve hasta düzeyinde veri ayrımı kullanılmıştır. Makalenin veri erişilebilirliği beyanı, kullanılan verinin Kaggle üzerindeki Kermany2018 veri setinde bulunduğunu ve erişim tarihinin 12 Eylül 2024 olduğunu belirtmektedir.
Finansman: Yazarlar araştırmanın dış finansman almadığını bildirmiştir.
Etik beyanlar: Institutional Review Board Statement “Not Applicable”; Informed Consent Statement “Not applicable” olarak verilmiştir.
Teşekkür: Yazarlar The University of Akron'daki Margaret F. Donovan Endowment desteğini kabul etmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma M.V.L.-M. ve B.D.B.; metodoloji, yazılım, formal analiz, araştırma, veri kürasyonu ve görselleştirme ağırlıklı olarak M.V.L.-M.; kaynaklar, gözetim ve proje yönetimi B.D.B.; doğrulama iki yazar; özgün taslak M.V.L.-M.; gözden geçirme ve düzenleme B.D.B. tarafından raporlanmıştır.
Kaynak-içi teknik not 1: ViT-B/16 sonuçlarının bulunduğu 4.4 bölümünün giriş cümlesinde Tablo 5 yanlışlıkla “ResNet-50 classifier” olarak adlandırılmıştır. Tablo başlığı, metnin devamı ve değerler ViT-B/16'ya aittir; bu Verianla metninde ViT-B/16 olarak ele alınmıştır.
Kaynak-içi teknik not 2: ResNet-50 tartışmasında \(\lambda=0.5\)'ten sonraki paragrafta “\(\lambda=0\)” yazmaktadır. Tablo 3'ün sırası ve aynı paragraftaki %96,69 doğruluk ile %89,56 Drusen F1 değerleri bunun \(\lambda=0.7\) koşuluna karşılık geldiğini göstermektedir. Kaynak yazım tutarsızlığı gizlenmemiştir.
Kaynak-içi teknik not 3: Ana EfficientNet-B0 ablation tablosunda \(\lambda=0\) için Drusen F1 %90,87 iken, ayrı balanced-dataset deneyinin Tablo 6'sında “Imbalanced Baseline” Drusen-F1 %89,87 olarak raporlanmıştır. Kaynak bu farkın nedenini açıklamadığından iki değer kendi deney bağlamlarında ayrı tutulmuştur.
Temel yorum sınırı: Bu çalışma tek benchmark OCT veri seti üzerinde bir makine öğrenmesi deneyidir. Sonuçlar çok merkezli harici doğrulama, prospektif klinik çalışma veya hasta sonucuna dayalı klinik etkinlik kanıtı değildir.
Görsel yeniden çizim uygunluğu: Yüksek. Çift başlıklı eğitim mimarisi, sınıf dengesizliği akışı, lambda-ablation sonuçları ve CNN-ViT dikkat farkı kaynak verisine sadık özgün şemalarla yeniden kurulabilir.
Verianla Live / Live Figure uygunluğu: Kısmen uygun. Sabit kaynak verileri üzerinden mimari ve \(\lambda\) karşılaştırmalarının adım adım gösterimi uygundur. Kullanıcının \(\lambda\) veya başka hiperparametreleri değiştirerek kaynakta bulunmayan yeni performans değerleri üretmesi uygun değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir