

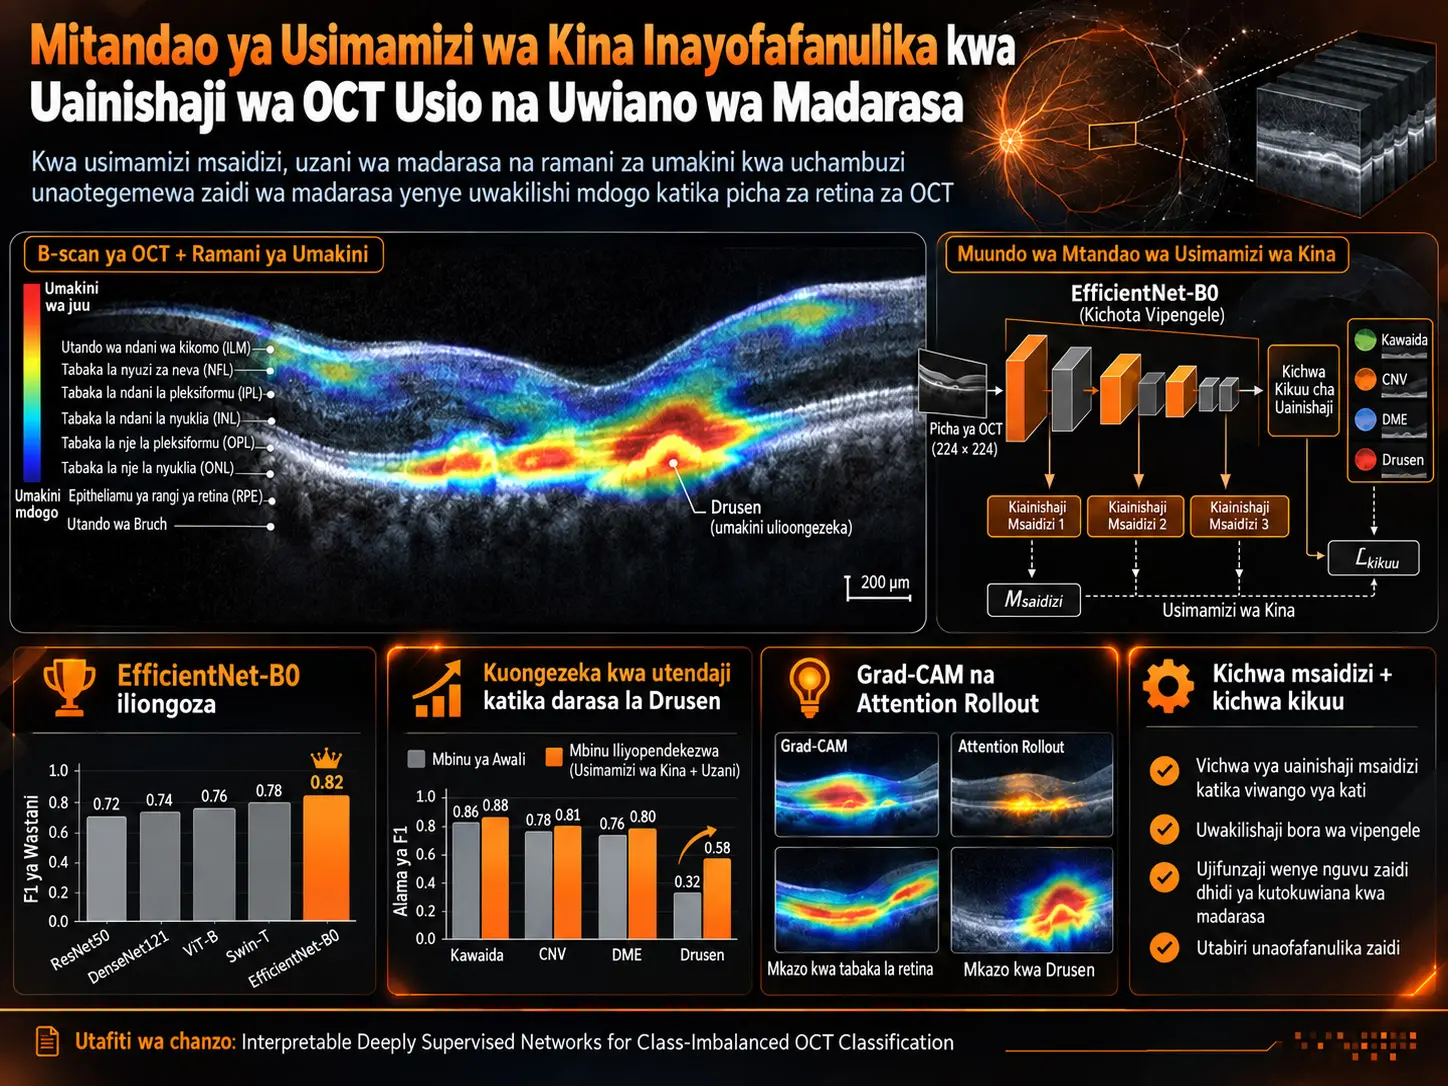
Utafiti huu unachunguza mbinu ya usimamizi msaidizi katika tabaka la kati inayolenga kujifunza kwa kutegemewa zaidi madarasa ya magonjwa yenye uwakilishi mdogo katika uainishaji wa picha za tomografia ya mshikamano wa macho ya retina zenye usambazaji wa madarasa usio na uwiano. Usimamizi msaidizi katika tabaka la kati ni mpangilio wa ujifunzaji wa kina unaounganisha kichwa cha pili cha uainishaji kwenye vipengele vya kiwango cha kati vya mtandao, pamoja na kiainishaji kikuu, na kukiboresha kichwa hicho pamoja na jukumu kuu wakati wa mafunzo pekee. Watafiti walitathmini mpangilio huu kwenye ResNet-18, ResNet-50, EfficientNet-B0 na Vision Transformer ViT-B/16 kwa kutumia skani 84.495 za OCT za madarasa manne. Katika seti ya data, Drusen ndilo darasa lenye uwakilishi mdogo zaidi kwa takriban %10,6.
Mbinu hutumia taratibu mbili kwa pamoja. Kwanza, mchango wa madarasa yenye sampuli chache katika hasara ya mafunzo huongezwa kwa kutumia marudio ya darasa yaliyo kinyume. Pili, lebo ileile ya uchunguzi yenye madarasa manne haitumiki tu kwenye tabaka la mwisho la mtandao bali pia kwenye tabaka la kati lililochaguliwa kulingana na usanifu. Uwiano kati ya hasara kuu na hasara msaidizi hudhibitiwa kwa mgawo \(\lambda\), na katika utafiti huu thamani \(\lambda \in \{0.0, 0.3, 0.5, 0.7, 0.9\}\) zinalinganishwa kwa utaratibu.
Matokeo bora zaidi ya jumla yalipatikana kwa EfficientNet-B0 katika hali ya \(\lambda=0.3\): usahihi wa jumla ulifikia %97,78, huku katika darasa la Drusen precision ikiwa %92,54, sensitivity/recall %94,51, specificity %99,29 na alama ya F1 %93,51. Kwa kuwa katika jedwali kuu la ablation la EfficientNet-B0 alama ya Drusen F1 katika hali isiyo na uzani ya \(\lambda=0\) ilikuwa %90,87, ongezeko ni pointi 2,64 za asilimia. ResNet-18 na ResNet-50 pia zilinufaika na hasara msaidizi ya kiwango cha kati, huku thamani inayofaa zaidi kwa ViT-B/16 ikiwa \(\lambda=0.5\).
Matokeo hayakutathminiwa kwa usahihi wa jumla pekee. Uchambuzi wa Grad-CAM na Attention Rollout ulionyesha kuwa chini ya usimamizi msaidizi unaofaa, hasa katika sampuli za Drusen, umakini wa modeli unaweza kuelekezwa vizuri zaidi kwenye miundo ya retina yenye umuhimu wa kitabibu. Hata hivyo, ViT-B/16 ilionyesha unyeti mkubwa zaidi kwa mipaka meupe na maeneo ya padding katika seti ya data kuliko modeli za convolution. Kwa kuwa utafiti unategemea seti moja tu ya data ya benchmark na hauna uthibitishaji wa nje, wa vituo vingi au wa kitabibu wa matarajio, matokeo hayapaswi kufasiriwa moja kwa moja kama mafanikio ya matumizi halisi ya kitabibu.
Tatizo la msingi: usahihi mkubwa wa jumla unaweza kuficha kosa katika darasa la wachache
Tomografia ya mshikamano wa macho (optical coherence tomography, OCT) ni mbinu isiyo vamizi ya upigaji picha inayoonyesha muundo wa tabaka za retina kwa mwonekano wa mkato. Seti ya data iliyotumiwa katika utafiti ina makundi manne ya uchunguzi: neovascularization ya choroid (CNV), edema ya makula ya kisukari (DME), Drusen na retina ya kawaida. Usambazaji wa madarasa si sawa: CNV ni takriban %44,5, retina ya kawaida %31,5, DME %13,6 na Drusen %10,6.
Katika usambazaji huu, kuangalia usahihi wa jumla pekee kunaweza kupotosha. Modeli inapojifunza madarasa ya wengi vizuri sana inaweza kutoa usahihi mkubwa wa jumla; lakini precision, recall au alama ya F1 ya darasa linaloonekana mara chache zaidi kama Drusen inaweza kubaki chini kwa kiwango kinachoonekana. Kwa hiyo, tatizo kuu la utafiti linabadilika kutoka swali “modeli inaainisha kwa usahihi picha ngapi?” kwenda kwenye swali finyu zaidi na muhimu zaidi kitabibu: je, vipengele vya madarasa ya patholojia ya retina yenye uwakilishi mdogo vinajifunzwa kwa nguvu ya kutosha katika nafasi ya uwakilishi ya mtandao?
Sampuli za OCT zilizotolewa katika chanzo pia zinaonyesha kuwa picha zote hazijaundwa na tishu za retina pekee. Baadhi ya skani zina mteremko, mzunguko na hasa maeneo ya usuli mweupe/padding kwenye kingo za picha ambayo hayabebi taarifa ya anatomia. Maelezo haya ni muhimu baadaye katika kufasiri tofauti ya umakini iliyoonekana kati ya ViT-B/16 na mitandao ya convolution.
Usimamizi wa Kati Unalengaje Kutokuwa na Uwiano wa Madarasa?
Usimamizi wa kati hutumia lebo ileile ya uchunguzi si kwenye kichwa cha mwisho cha uainishaji cha mtandao pekee bali pia kwenye kichwa cha pili msaidizi kilichounganishwa na vipengele vya kiwango cha kati, hivyo kuruhusu gradient ya mafunzo kufikia moja kwa moja tabaka za awali zaidi za mtandao; katika utafiti huu, kwa kuwa hasara msaidizi imepewa uzani kwa marudio ya madarasa yaliyo kinyume, lengo ni kuimarisha uwakilishi wa madarasa ya wachache pia katika kiwango cha vipengele vya kati.
Mbinu hii haihitaji lebo mpya ya segmentation, barakoa ya lesion au annotation tofauti ya kitabibu. Kichwa msaidizi na kichwa kikuu hutumia lebo ileile sahihi ya madarasa manne. Kwa hiyo, badala ya kufafanua jukumu jipya la kisemantiki, usimamizi wa ziada hufanya tatizo lilelile la uainishaji lionekane tena katika kina tofauti za mtandao.
Uzani wa madarasa kwa marudio yaliyo kinyume
Uzani wa kila darasa hufafanuliwa kwa Mlinganyo (1):
\[ w_i=\frac{N}{C\,n_i} \]
Hapa \(N\) inaonyesha jumla ya idadi ya sampuli za mafunzo, \(C\) idadi ya madarasa na \(n_i\) idadi ya sampuli katika darasa husika \(i\). Kadiri idadi ya sampuli katika darasa inavyopungua, \(n_i\) hupungua na \(w_i\) huongezeka. Kihisabati, hii ina maana kuwa uainishaji usio sahihi katika madarasa yenye uwakilishi mdogo hupata uzani mkubwa zaidi katika kazi ya hasara. Kwa utafiti huu \(C=4\).
Kwa Nini Uzani wa Darasa wa Marudio Yaliyo Kinyume Haukuachwa Kwenye Tabaka la Mwisho Pekee?
Mbinu ya utafiti haiishii katika kubadilisha uzani wa sampuli kwenye kiainishaji cha mwisho pekee; pia hutumia lengo lilelile la uchunguzi lenye uzani katika kiwango cha vipengele vya kati, hivyo kuhamisha ishara ya kujifunza ya darasa la wachache hadi sehemu ya awali zaidi ya hierarkia ya vipengele vya mtandao na kuboresha kichwa msaidizi na kichwa kikuu kwa pamoja.
Mahali pa kuunganisha kichwa msaidizi si sawa katika usanifu tofauti. Kwa ResNet-18 na ResNet-50, kichwa msaidizi huunganishwa kwenye pato la layer3; vipimo vya uwakilishi wa kati ni chaneli 256 na 1024 mtawalia. Katika EfficientNet-B0 hutumiwa takriban blok 6-8 za eneo la upanuzi wa kati/MBConv. Kwa ViT-B/16, usimamizi msaidizi hutumika kwenye uwakilishi wa vipimo 768 wa blok ya sita ya transformer.
Kichwa msaidizi hubana uanzishaji wa kati kwa global average pooling na kutoa logit nne kupitia tabaka lililounganishwa kikamilifu:
\[ \mathbf{f}_{aux}=FC(GAP(\mathbf{A}_{int})), \qquad \mathbf{A}_{int}\in\mathbb{R}^{H'\times W'\times C} \]
\(H'\) na \(W'\) zinaonyesha vipimo vya anga vya ramani ya vipengele vya kati, na \(C\) idadi ya chaneli. Global average pooling hufupisha kila chaneli ya kipengele katika anga; tabaka lililounganishwa kikamilifu hubadilisha uwakilishi huo kuwa logit za madarasa manne ya uchunguzi.
Kuunganisha hasara kuu na hasara msaidizi
Lengo la jumla la mafunzo limeundwa kwa Mlinganyo (3):
\[ \mathcal{L}_{total} = \mathcal{L}_{main}(\hat{\mathbf{y}}_{main},\mathbf{y}) + \lambda\,\mathcal{L}_{aux}(\hat{\mathbf{y}}_{aux},\mathbf{y}) \]
Hapa \(\mathcal{L}_{main}\) ni hasara ya cross-entropy ya kichwa kikuu na \(\mathcal{L}_{aux}\) ni ya kichwa msaidizi, zote zikiwa zimepewa uzani wa marudio ya kinyume. \(\lambda\) huamua athari ya kichwa msaidizi katika uboreshaji wa jumla. Wakati \(\lambda=0\), hasara msaidizi haichangii katika lengo la jumla na mafunzo hurudi katika hali ya kawaida ya kichwa kimoja.
Kwa Nini Uzani wa Hasara Msaidizi Lambda Ni Muhimu?
\(\lambda\) ni hyperparameter muhimu kwa sababu huamua ni kwa nguvu kiasi gani lengo la uainishaji msaidizi linaelekeza nafasi ya vipengele inayoshirikiwa; utafiti umeonyesha kuwa athari ndogo sana ya usimamizi msaidizi hutoa manufaa machache kwa darasa la wachache, athari kubwa kupita kiasi inaweza kuvuruga uwiano wa precision-recall, na matokeo bora zaidi yalijitokeza karibu na \(\lambda=0.3\) katika mitandao mingi ya convolution na karibu na \(\lambda=0.5\) katika ViT-B/16.
Matokeo haya yanaonyesha kuwa \(\lambda\) haiwezi kufasiriwa kama “kadiri inavyokuwa kubwa, ndivyo bora zaidi”. Hasara msaidizi inapaswa kufanya kazi kama kirekebishaji kinachounga mkono jukumu kuu; inapokuwa na nguvu kiasi cha kukandamiza uboreshaji wa jukumu kuu, thamani za precision na F1 katika darasa la wachache zinaweza kushuka.
Itifaki ya mafunzo
Modeli zote nne zilianzishwa kutoka kwa uzani uliofunzwa awali kwenye ImageNet-1K. Kwa optimizer ya AdamW, learning rate ya awali ilikuwa \(1\times10^{-4}\), weight decay \(1\times10^{-4}\), ukubwa wa batch 16 na bajeti ya mafunzo 20 epoch. Katika mpangilio wa Cosine annealing, learning rate ya chini iliwekwa kuwa \(1\times10^{-6}\).
Data iligawanywa katika kiwango cha mgonjwa kwa stratified sampling kuwa %70 mafunzo, %15 uthibitishaji na %15 majaribio; ilihakikishwa kuwa mgonjwa yuleyule haingii katika sehemu zaidi ya moja. Urekebishaji wa hyperparameter ulifanywa kwa seti ya uthibitishaji na seti ya majaribio ilitengwa kwa tathmini ya mwisho. Chanzo pia kinasema kuwa stratified cross-validation ya mikunjo mitano katika kiwango cha mgonjwa ilitumika na utendaji wa mwisho uliripotiwa kama wastani wa mikunjo. Hata hivyo, katika majedwali makuu ya matokeo, mkengeuko sanifu au confidence interval kati ya mikunjo haukuwasilishwa kando.
Majaribio yalifanywa kwa Python 3.11 na PyTorch 2.5.1+CU121; kwenye NVIDIA RTX 2000 Ada Generation GPU yenye CUDA/cuDNN, prosesa ya Intel Core Ultra 9 285 2.50 GHz na kumbukumbu ya mfumo ya 32 GB.
Softmax na uwezekano wa madarasa
Logit ghafi \(Z_i\) za madarasa manne hubadilishwa kuwa uwezekano kwa softmax:
\[ \hat{y}_i = \frac{e^{Z_i}} {\sum_{j=1}^{4}e^{Z_j}} \]
Mabadiliko haya huzalisha uwezekano usio hasi kwa kila darasa na kufanya jumla ya uwezekano wa madarasa manne kuwa 1.
Grad-CAM na Attention Rollout Zinaonyesha Nini Katika Utafiti Huu?
Grad-CAM na Attention Rollout zilitumiwa kuchunguza si tu kama modeli ilitoa uamuzi sahihi au usio sahihi, bali pia ni maeneo gani ya picha yaliyopata uzani wakati wa kutengeneza uamuzi huo; Grad-CAM ilitumika kwa ResNet-18, ResNet-50 na EfficientNet-B0, huku Attention Rollout ikitumika kwa ViT-B/16, na chini ya usimamizi msaidizi bora ilionekana kuwa umakini unaweza kuelekezwa zaidi kwenye maeneo ya patholojia ya retina, hasa katika sampuli za Drusen.
Hisabati ya Grad-CAM
Kwa darasa lengwa \(c\), mchango wa ramani ya kipengele \(A^k\) kwenye alama ya darasa hupewa uzani kwa wastani wa anga wa gradient:
\[ \alpha_k^c = \frac{1}{Z} \sum_i\sum_j \frac{\partial y^c}{\partial A_{ij}^k} \]
Kisha ramani ya Grad-CAM ya darasa husika:
\[ L_{\mathrm{Grad-CAM}}^c = ReLU\left( \sum_k \alpha_k^c A^k \right) \]
huhesabiwa. Operesheni ya ReLU huhifadhi maeneo yanayochangia kwa chanya katika darasa lengwa. Ramani za joto zilizozalishwa katika chanzo zilipimwa upya hadi picha ya OCT ya 224 × 224 na kuwekwa juu ya muundo wa retina.
Attention Rollout kwa ViT-B/16
Katika kila tabaka la Transformer, matriksi za umakini kutoka kwa \(H\) attention head huchukuliwa wastani na matriksi ya utambulisho huongezwa ili kuzingatia residual connection:
\[ \tilde{A}^{\,l} = \frac{1}{H} \sum_{h=1}^{H}A_h^{\,l} + I \]
Katika mbinu ya chanzo, baada ya mistari kunormalishwa, matriksi za attention zilizobadilishwa huzidishwa kwa mfululizo kupitia tabaka. Kwa njia hii hupatikana uhusiano wa umakini unaojumlisha kutoka token ya darasa hadi patch za ingizo. Thamani za kiwango cha patch hurudishwa kwenye ndege ya picha na kuwekwa juu ya OCT.
Vipimo vya tathmini
| Kipimo | Fomula | Maana ya kisayansi |
|---|---|---|
| Accuracy | \(\displaystyle Acc=\frac{TP+TN}{TP+TN+FP+FN}\) | Uwiano wa sampuli zilizoainishwa kwa usahihi kati ya sampuli zote; pekee yake haitoshi katika hali ya kutokuwa na uwiano wa madarasa. |
| Precision | \(\displaystyle Precision_c=\frac{TP_c}{TP_c+FP_c}\) | Huonyesha ni sampuli ngapi kati ya zile ambazo modeli imesema ni darasa \(c\) kwa kweli ni za darasa hilo. |
| Recall | \(\displaystyle Recall_c=\frac{TP_c}{TP_c+FN_c}\) | Hupima ni kiasi gani cha sampuli halisi za darasa \(c\) kimetambuliwa. |
| Specificity | \(\displaystyle Specificity_c=\frac{TN_c}{TN_c+FP_c}\) | Ni uwiano wa sampuli zisizo za darasa \(c\) zilizotenganishwa kwa usahihi kama hasi. |
| Alama ya F1 | \(\displaystyle F1_c=2\frac{Precision_c\times Recall_c}{Precision_c+Recall_c}\) | Hupima uwiano wa harmoniki kati ya precision na recall; ni muhimu hasa katika tathmini ya darasa la wachache. |
| AUROC | \(\displaystyle AUROC_c=\int_0^1 TPR_c(FPR_c^{-1}(u))\,du\) | Hupima uwezo wa kutenganisha darasa bila kutegemea kizingiti kimoja maalum cha uamuzi. |
Mbinu na Matokeo ya Utafiti
Muundo wa ablation
Katika kila usanifu wa backbone, mgawo wa hasara msaidizi ulibadilishwa katika thamani \(\lambda=0.0, 0.3, 0.5, 0.7, 0.9\). Lengo la muundo huu halikuwa tu kupata usahihi mkubwa zaidi wa jumla, bali pia kubaini hasa katika darasa la Drusen jinsi thamani za precision, recall, specificity, F1 na AUROC zinavyoitikia usimamizi msaidizi.
Ni Kiwango Gani cha Hasara Msaidizi Kilitoa Matokeo Bora Zaidi?
Kwa ResNet-18, ResNet-50 na EfficientNet-B0, matokeo yenye uwiano bora zaidi yalipatikana karibu na \(\lambda=0.3\), huku kwa ViT-B/16 sehemu inayofaa zaidi ikiwa \(\lambda=0.5\); utendaji wa juu zaidi kwa jumla ulitolewa na EfficientNet-B0 kwa \(\lambda=0.3\), ikiwa na usahihi wa %97,78 na alama ya Drusen F1 ya %93,51.
| Modeli | \(\lambda\) inayofaa zaidi | Usahihi wa jumla (%) | Drusen precision (%) | Drusen recall (%) | Drusen specificity (%) | Drusen F1 (%) | Drusen AUROC (%) |
|---|---|---|---|---|---|---|---|
| ResNet-18 | 0.3 | 97.58 | 87.61 | 95.90 | 98.49 | 91.28 | 99.6 |
| ResNet-50 | 0.3 | 97.02 | 88.02 | 95.69 | 98.58 | 91.69 | 99.5 |
| EfficientNet-B0 | 0.3 | 97.78 | 92.54 | 94.51 | 99.29 | 93.51 | 99.5 |
| ViT-B/16 | 0.5 | 95.76 | 84.94 | 89.73 | 98.23 | 87.27 | 98.9 |
Mabadiliko katika darasa la Drusen
| Modeli | \(\lambda=0\) Drusen F1 (%) | Drusen F1 bora (%) | Mabadiliko (pointi za asilimia) |
|---|---|---|---|
| ResNet-18 | 89.80 | 91.28 | +1.48 |
| ResNet-50 | 89.08 | 91.69 | +2.61 |
| EfficientNet-B0 | 90.87 | 93.51 | +2.64 |
| ViT-B/16 | 85.25 | 87.27 | +2.02 |
Jedwali hili linaonyesha kuwa athari ya usimamizi msaidizi si sawa katika usanifu wote. EfficientNet-B0 ilitoa thamani ya juu zaidi ya Drusen F1, huku ViT-B/16 ikiwa na thamani ya chini zaidi ya Drusen F1 mwanzoni na, ingawa ilinufaika na usimamizi msaidizi, haikufikia kiwango cha modeli za convolution.
Kwa nini lambda kubwa kupita kiasi haikuwa na manufaa?
Majedwali ya chanzo yanaonyesha kuwa utendaji hauongezeki kwa namna ya monotoni kadiri \(\lambda\) inavyoongezeka. Kwa mfano, katika ResNet-18 chini ya \(\lambda=0.9\), Drusen precision hushuka hadi %83,59 na F1 hadi %88,37. Katika EfficientNet-B0 pia, Drusen F1 kwa \(\lambda=0.9\) ni %90,37, chini ya kiwango cha %93,51 katika \(\lambda=0.3\). Jukumu msaidizi likipata uzani mkubwa kupita kiasi linaweza kuweka shinikizo kwenye uwakilishi unaoshirikiwa ambalo linaweza kuvuruga uwiano wa precision-recall.
Ulinganisho na undersampling yenye uwiano kamili
Watafiti walifanya jaribio tofauti ili kupima kama manufaa ya mbinu yalitokana tu na kufanya idadi ya madarasa iwe sawa. Sampuli 8.957 za darasa la Drusen zilitumiwa kama rejea, na madarasa mengine matatu yalipunguzwa kwa nasibu hadi sampuli 8.957 kila moja, hivyo kuunda seti ndogo zenye uwiano zenye jumla ya picha 35.828. Seti ndogo tatu huru zenye uwiano ziliandaliwa kwa seed tatu tofauti za nasibu, na EfficientNet-B0 ikafunzwa upya kwa mipangilio ileile ya mafunzo.
| Mkakati wa mafunzo | Accuracy (%) | Macro-F1 (%) | Drusen-F1 (%) |
|---|---|---|---|
| Baseline ya data isiyo na uwiano | 97.29 | 96.11 | 89.87 |
| Undersampling yenye uwiano | 95.64 | 95.38 | 91.65 |
| Mbinu iliyopendekezwa | 97.78 | 96.87 | 93.51 |
Undersampling yenye uwiano iliboresha darasa la Drusen, lakini kwa kuwa iliondoa picha nyingi za madarasa ya wengi kutoka kwenye mafunzo, usahihi wa jumla na Macro-F1 zilishuka. Mbinu iliyopendekezwa, kwa upande mwingine, huhifadhi seti nzima ya data huku ikiingilia kutokuwa na uwiano wa madarasa wakati wa uboreshaji. Katika Jedwali la 6 la chanzo, thamani ya Drusen-F1 ya “Imbalanced Baseline” ni %89,87, ilhali katika jedwali kuu la ablation la EfficientNet-B0, Drusen F1 kwa \(\lambda=0\) ni %90,87; chanzo hakielezi tofauti hii kando.
Gharama ya kompyuta na inference
| Modeli | Muda wa mafunzo (s) | Kumbukumbu ya GPU (GB) | Inference (ms) |
|---|---|---|---|
| ResNet-18 | 179.71 | 0.51 | 9.68 |
| ResNet-18 yenye usimamizi msaidizi | 201.52 | 0.74 | 9.71 |
| ResNet-50 | 371.34 | 1.70 | 12.40 |
| ResNet-50 yenye usimamizi msaidizi | 443.79 | 2.18 | 12.38 |
| EfficientNet-B0 | 243.05 | 1.67 | 11.13 |
| EfficientNet-B0 yenye usimamizi msaidizi | 294.84 | 2.04 | 11.16 |
| ViT-B/16 | 1356.21 | 3.10 | 12.33 |
| ViT-B/16 yenye usimamizi msaidizi | 1862.17 | 3.75 | 12.54 |
Kichwa msaidizi huongeza gharama ya ziada ya usambazaji mbele/nyuma na kumbukumbu wakati wa mafunzo. Hata hivyo, katika mbinu ya chanzo kichwa msaidizi huzimwa wakati wa inference. Kwa hiyo, moja ya faida kuu za mfumo uliopendekezwa ni kwamba hutumia usimamizi wa ziada wakati wa kujifunza huku ukihifadhi takriban gharama ya inference ya backbone kuu katika hatua ya matumizi. Tofauti ndogo za milisekunde zilizopimwa katika Jedwali la 7 hubaki kivitendo katika kiwango kilekile cha inference kama baseline.
Ufafanuzi wa modeli: uanzishaji uliolengwa zaidi katika Drusen
Katika ulinganisho wa Grad-CAM na Attention Rollout wa chanzo, Drusen ndilo darasa linaloonyesha mabadiliko ya kuona yaliyo wazi zaidi pamoja na hasara msaidizi. Katika ramani za baseline za ResNet-18, ResNet-50 na EfficientNet-B0, uanzishaji huenea katika maeneo mapana zaidi, ilhali chini ya \(\lambda\) bora umakini huonekana kukaza zaidi kuelekea tabaka la nje la retina na eneo la Drusen.
Katika sampuli za CNV, modeli za baseline na zenye usimamizi msaidizi tayari zilionyesha umakini wenye nguvu na uliolocalize. Katika DME, uanzishaji uliendelea kwa ujumla kuendana na tabaka za kati za retina na maeneo ya maji ndani ya retina. Hali hii inaunga mkono tafsiri kwamba usimamizi msaidizi, badala ya kuvuruga madarasa ya wengi au yale rahisi kutenganisha ili kuboresha utendaji, huimarisha hasa uwakilishi wa vipengele katika darasa gumu na linaloonekana mara chache.
ViT-B/16 na unyeti kwa padding nyeupe
ViT-B/16 hugawanya picha ya OCT katika patch za 16 × 16 na kuichakata kwa global self-attention. Katika Kielelezo cha 6 cha chanzo, maeneo meupe ya pembeni yasiyobeba taarifa ya anatomia yanaonekana zaidi kwenye ramani ya umakini ya ViT kuliko kwenye CNN. Convolution za eneo za ResNet na EfficientNet huzalisha uanzishaji uliokolea zaidi kwenye tabaka za retina, huku usambazaji wa umakini wa ViT ukiwa mpana zaidi.
Uchunguzi huu umehusishwa katika chanzo na maelezo ya usanifu: modeli za convolution zina upendeleo wa kiinduktivu wa aina ya receptive field ya eneo na translation-equivariance, wakati ViT inaweza kuunda mahusiano ya kimataifa kati ya patch zote tangu tabaka za mwanzo. Hata hivyo, utafiti haujatenganisha kwa majaribio kuwa padding ndiyo sababu pekee na ya uhakika ya kushuka kwa utendaji wa ViT. Kwa kuwa uchakataji maalum wa awali kama kufunika usuli au kukata eneo la retina haukujaribiwa, utaratibu huu unapaswa kubaki kama maelezo yenye nguvu ya uchunguzi, si hitimisho lililothibitishwa.
Hitimisho zinazoungwa mkono na utafiti
- Matumizi ya pamoja ya uainishaji msaidizi wa tabaka la kati na hasara iliyopewa uzani wa marudio ya kinyume yaliongeza utendaji wa Drusen F1 ikilinganishwa na baseline katika usanifu wote minne iliyochunguzwa.
- Kwa modeli za convolution, \(\lambda=0.3\), na kwa ViT-B/16, \(\lambda=0.5\), vilitoa kiwango kinachofaa zaidi cha athari ya usimamizi msaidizi.
- EfficientNet-B0 ilitoa usahihi mkubwa zaidi wa jumla na alama ya juu zaidi ya Drusen F1 kati ya usanidi uliotathminiwa.
- Usimamizi msaidizi bora uliambatana na umakini wa anatomia uliolengwa zaidi, hasa kwa Drusen, katika ramani za Grad-CAM na Attention Rollout.
- Kwa kuwa kichwa msaidizi kinaweza kuondolewa wakati wa inference, ongezeko la utendaji halikuhitaji mzigo mkubwa wa ziada wa kompyuta wakati wa majaribio.
- Ingawa undersampling ya nasibu iliboresha kwa kiasi fulani darasa la wachache, mbinu iliyopendekezwa inayohifadhi utofauti wote wa data ilionyesha utendaji wa aggregate wa juu zaidi katika ulinganisho tofauti.
Hitimisho zisizoungwa mkono na utafiti
- Matokeo hayathibitishi kuwa mbinu itatoa utendaji uleule kwenye vifaa tofauti vya OCT au katika hospitali tofauti.
- Utafiti huu si jaribio la kliniki la matarajio na haujaonyesha kuboreka kwa matokeo ya mgonjwa katika mtiririko halisi wa kazi ya kliniki.
- Kuonekana kwa ramani ya Grad-CAM au Attention Rollout kuwa na maana ya anatomia pekee hakuthibitishi kwa uhakika kwamba uamuzi wa modeli unatokana na utaratibu sahihi wa kitabibu.
- Haijathibitishwa kuwa utendaji wa chini wa ViT-B/16 unatokana tu na padding nyeupe; ablation maalum ya kuondoa padding haikufanywa.
- Athari huru za usimamizi msaidizi na uzani wa darasa wa marudio ya kinyume hazijatenganishwa kwa ablation kamili ya kifaktoria.
- Usahihi mkubwa katika seti moja ya data ya benchmark haumaanishi kuwa modeli iko tayari kwa matumizi ya kliniki katika idadi nyingine za watu au vifaa vingine.
Vikwazo vikuu na tafiti zijazo
Kizuizi cha kwanza cha utafiti ni kwamba majaribio yote yalifanywa kwenye seti moja ya data ya benchmark na taksonomia ya uchunguzi ya madarasa manne isiyobadilika. Kwa kuwa hakuna uthibitishaji wa nje wa vituo vingi au wa matarajio, haijulikani kikamilifu ni kwa kiwango gani vipengele vya picha vinavyotokana na seti hiyo ya data vinaathiri tabia ya modeli.
Kizuizi cha pili ni kwamba athari huru na za pamoja za vipengele viwili vikuu vya mbinu iliyopendekezwa — uzani wa marudio ya kinyume na usimamizi msaidizi wa tabaka la kati — hazijatenganishwa kwa mfumo kamili wa kifaktoria. Chanzo kinatoa ablation pana kwa \(\lambda\), lakini hakitoi matriksi tofauti ya kimakanika ya hali “uzani wa darasa pekee”, “kichwa msaidizi pekee” na “vyote viwili kwa pamoja” katika usanifu wote.
Kizuizi cha tatu ni unyeti wa ViT-B/16 kwa padding. Kufunika usuli kiotomatiki, kukata eneo la retina pekee au usanifu mseto wa convolution-attention vinaweza kutathminiwa katika siku zijazo. Chanzo pia kinapendekeza kuchunguza majukumu msaidizi ya ziada kama adaptive auxiliary weighting, segmentation ya lesion na uainishaji wa kiwango cha ugonjwa.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Interpretable Deeply Supervised Networks for Class-Imbalanced OCT Classification
Waandishi: Maria V. Leyba-Mesa; Buket D. Barkana.
Mwandishi anayewasiliana: Buket D. Barkana.
Taasisi: Department of Biomedical Engineering, College of Engineering and Polymer Science, The University of Akron, Akron, Ohio, Marekani.
Jarida: AI.
Mchapishaji: MDPI, Basel, Switzerland.
Rekodi ya bibliografia: AI 2026, 7(5), 164.
DOI: 10.3390/ai7050164.
Kiungo rasmi cha uchapishaji: ukurasa rasmi wa makala wa MDPI.
Mchakato wa uchapishaji: Imepokelewa 16 Machi 2026; marekebisho 5 Mei 2026; imekubaliwa 6 Mei 2026; imechapishwa 8 Mei 2026. Katika madokezo rasmi ya matoleo ya MDPI, Version of Record PDF imerekodiwa tarehe 8 Mei 2026, na PDF iliyosasishwa tarehe 14 Mei 2026.
Aina ya chanzo: Makala ya utafiti iliyopitia mchakato wa peer review.
Leseni: Ufikiaji wazi, Creative Commons Attribution (CC BY). Hata hivyo, maelezo ya Verianla yametayarishwa kwa muundo asilia wa sentensi na usanifu huru wa kielimu; vielelezo vya chanzo havikunakiliwa moja kwa moja.
Data: Seti ya data ya Kermany OCT; utafiti wa chanzo ulitumia skani 84.495 za OCT, madarasa manne ya uchunguzi na mgawanyo wa data katika kiwango cha mgonjwa. Taarifa ya upatikanaji wa data ya makala inasema kwamba data iliyotumiwa inapatikana katika seti ya Kermany2018 kwenye Kaggle na tarehe ya kufikiwa ilikuwa 12 Septemba 2024.
Ufadhili: Waandishi waliripoti kuwa utafiti haukupokea ufadhili wa nje.
Taarifa za maadili: Institutional Review Board Statement “Not Applicable”; Informed Consent Statement “Not applicable” zimetolewa.
Shukrani: Waandishi wanatambua msaada wa Margaret F. Donovan Endowment katika The University of Akron.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Michango ya waandishi: Uundaji wa dhana M.V.L.-M. na B.D.B.; metodolojia, programu, uchambuzi rasmi, uchunguzi, uratibu wa data na uwasilishaji wa kuona hasa M.V.L.-M.; rasilimali, usimamizi na usimamizi wa mradi B.D.B.; uthibitishaji waandishi wote wawili; rasimu ya awali M.V.L.-M.; mapitio na uhariri B.D.B. kama ilivyoripotiwa.
Dokezo la kiufundi ndani ya chanzo 1: Katika sentensi ya utangulizi ya sehemu ya 4.4 yenye matokeo ya ViT-B/16, Jedwali la 5 limeitwa kimakosa “ResNet-50 classifier”. Kichwa cha jedwali, mwendelezo wa maandishi na thamani zinahusu ViT-B/16; katika maandishi haya ya Verianla imechukuliwa kama ViT-B/16.
Dokezo la kiufundi ndani ya chanzo 2: Katika mjadala wa ResNet-50, aya inayofuata \(\lambda=0.5\) inaandika “\(\lambda=0\)”. Mpangilio wa Jedwali la 3 na thamani za usahihi %96,69 pamoja na Drusen F1 %89,56 katika aya hiyo zinaonyesha kuwa hii inalingana na hali ya \(\lambda=0.7\). Kutokulingana huku kwa uandishi katika chanzo hakujafichwa.
Dokezo la kiufundi ndani ya chanzo 3: Katika jedwali kuu la ablation la EfficientNet-B0, Drusen F1 kwa \(\lambda=0\) ni %90,87, ilhali katika Jedwali la 6 la jaribio tofauti la balanced-dataset, “Imbalanced Baseline” Drusen-F1 imeripotiwa kuwa %89,87. Kwa kuwa chanzo hakielezi sababu ya tofauti hii, thamani hizi mbili zimehifadhiwa kando katika muktadha wa majaribio yao.
Kikomo kikuu cha tafsiri: Utafiti huu ni jaribio la ujifunzaji wa mashine kwenye seti moja ya data ya benchmark ya OCT. Matokeo si ushahidi wa uthibitishaji wa nje wa vituo vingi, jaribio la kliniki la matarajio au ufanisi wa kliniki unaotegemea matokeo ya mgonjwa.
Ufaafu wa kuchora upya taswira: Juu. Usanifu wa mafunzo wenye vichwa viwili, mtiririko wa kutokuwa na uwiano wa madarasa, matokeo ya lambda-ablation na tofauti ya umakini ya CNN-ViT vinaweza kujengwa upya kwa michoro asilia inayobaki mwaminifu kwa data ya chanzo.
Ufaafu wa Verianla Live / Live Figure: Unafaa kwa kiasi. Uonyeshaji wa hatua kwa hatua wa ulinganisho wa usanifu na \(\lambda\) kwa kutumia data thabiti ya chanzo unafaa. Si sahihi kumruhusu mtumiaji kubadilisha \(\lambda\) au hyperparameter nyingine na kutengeneza thamani mpya za utendaji ambazo hazipo katika chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *