

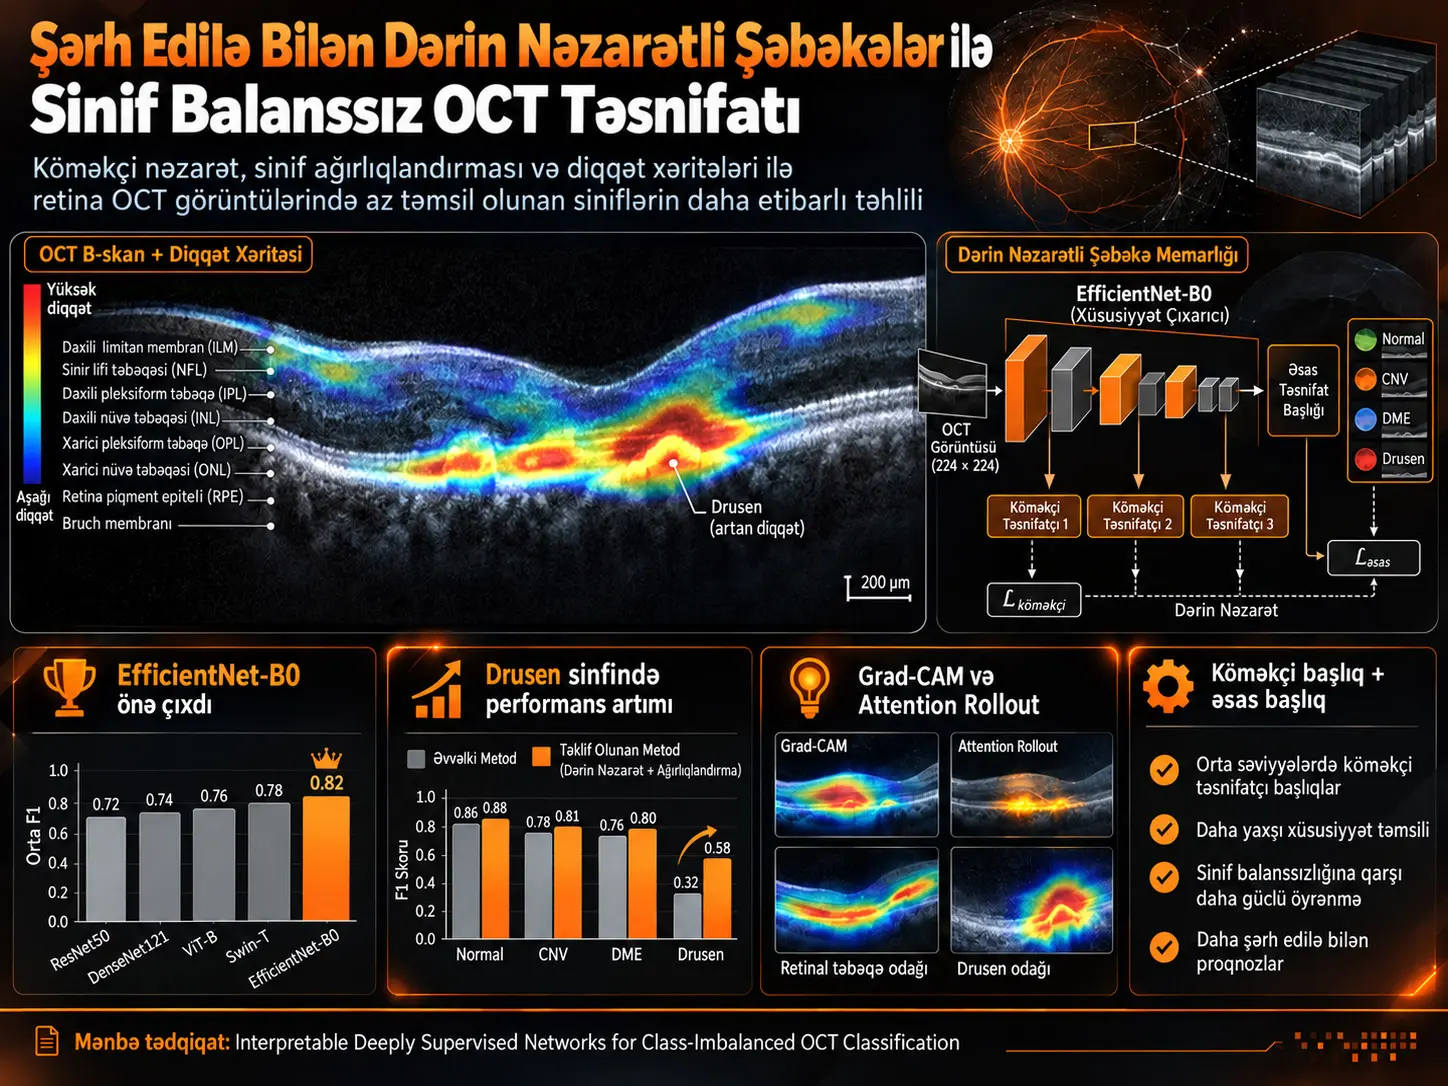
Bu tədqiqat sinif paylanması balanssız olan retinal optik koherent tomoqrafiya görüntülərinin təsnifatında az təmsil olunan xəstəlik siniflərinin daha etibarlı öyrənilməsini hədəfləyən aralıq qat köməkçi nəzarət yanaşmasını araşdırır. Aralıq qat köməkçi nəzarəti əsas təsnifatçıya əlavə olaraq şəbəkənin orta səviyyəli xüsusiyyətlərinə ikinci bir təsnifat başlığı qoşan və bu başlığı yalnız təlim zamanı əsas tapşırıqla birlikdə optimallaşdıran dərin öyrənmə quruluşudur. Tədqiqatçılar bu quruluşu ResNet-18, ResNet-50, EfficientNet-B0 və Vision Transformer ViT-B/16 üzərində, dörd sinifdən ibarət 84.495 OCT skanı ilə qiymətləndirmişlər. Məlumat dəstində Drusen təxminən %10,6 ilə ən az təmsil olunan sinifdir.
Metod iki mexanizmdən birlikdə istifadə edir. Birincisi, az nümunəsi olan siniflərin təlim itkisinə töhfəsi tərs sinif tezliyi ilə artırılır. İkincisi, eyni dörd sinifli diaqnostik etiket şəbəkənin yalnız son qatına deyil, arxitekturaya görə seçilmiş aralıq qata da tətbiq olunur. Əsas itki ilə köməkçi itki arasındakı balans \(\lambda\) əmsalı ilə idarə olunur və tədqiqatda \(\lambda \in \{0.0, 0.3, 0.5, 0.7, 0.9\}\) qiymətləri sistemli şəkildə müqayisə edilir.
Ən güclü ümumi nəticə EfficientNet-B0 üçün \(\lambda=0.3\) şəraitində əldə edilmişdir: ümumi dəqiqlik %97,78-ə çatarkən Drusen sinfində precision %92,54, həssaslıq/recall %94,51, spesifiklik %99,29 və F1-skoru %93,51 kimi bildirilmişdir. EfficientNet-B0-nun əsas ablation cədvəlindəki çəkisiz \(\lambda=0\) şəraitində Drusen F1-skoru %90,87 olduğuna görə artım 2,64 faiz bəndidir. ResNet-18 və ResNet-50 də orta səviyyəli köməkçi itkidən faydalanarkən ViT-B/16 üçün ən uyğun qiymət \(\lambda=0.5\) olmuşdur.
Nəticələr yalnız ümumi dəqiqlik əsasında qiymətləndirilməmişdir. Grad-CAM və Attention Rollout araşdırmaları uyğun köməkçi nəzarət altında, xüsusilə Drusen nümunələrində, model diqqətinin klinik baxımdan əlaqəli retinal strukturlara daha yaxşı cəmlənə bildiyini göstərmişdir. Bununla belə, ViT-B/16 məlumat dəstindəki ağ kənar və padding sahələrinə konvolyusion modellərlə müqayisədə daha çox həssaslıq göstərmişdir. Tədqiqat yalnız bir benchmark məlumat dəstinə əsaslandığı və xarici, çoxmərkəzli və ya prospektiv klinik doğrulama ehtiva etmədiyi üçün nəticələr birbaşa real klinik istifadə uğuru kimi şərh edilməməlidir.
Əsas problem: yüksək ümumi dəqiqlik azlıq sinfindəki xətanı gizlədə bilər
Optik koherent tomoqrafiya (optical coherence tomography, OCT) retinanın qatlı quruluşunu kəsik şəklində görüntüləyən, invaziv olmayan görüntüləmə metodudur. Tədqiqatda istifadə olunan məlumat dəsti dörd diaqnostik kateqoriya ehtiva edir: xoroidal neovaskulyarizasiya (CNV), diabetik makula ödemi (DME), Drusen və normal retina. Siniflərin paylanması bərabər deyil: CNV təxminən %44,5, normal retina %31,5, DME %13,6 və Drusen %10,6 nisbətindədir.
Bu paylanma şəraitində yalnız ümumi dəqiqliyə baxmaq yanıltıcı ola bilər. Model çoxluq siniflərini çox yaxşı öyrəndikdə yüksək ümumi dəqiqlik yarada bilər; buna qarşılıq daha seyrək rast gəlinən Drusen kimi bir sinfin precision, recall və ya F1-skoru nəzərəçarpacaq dərəcədə aşağı qala bilər. Buna görə tədqiqatın mərkəzi problemi “model neçə görüntünü düzgün təsnif edir?” sualından daha dar və klinik baxımdan daha mühüm bir suala çevrilir: az təmsil olunan retinal patologiya siniflərinin xüsusiyyətləri şəbəkənin təmsil məkanında kifayət qədər güclü öyrənilə bilirmi?
Mənbədə verilən OCT nümunələri həmçinin göstərir ki, görüntülərin hamısı yalnız retinal toxumadan ibarət deyil. Bəzi skanlarda meyillənmə, fırlanma və xüsusilə görüntü kənarlarında anatomik məlumat daşımayan ağ fon/padding sahələri mövcuddur. Bu detal sonradan ViT-B/16 ilə konvolyusion şəbəkələr arasında müşahidə olunan diqqət fərqinin şərhi baxımından əhəmiyyətlidir.
Aralıq Nəzarət Sinif Balanssızlığını Necə Hədəfləyir?
Aralıq nəzarət eyni diaqnostik etiketi şəbəkənin yalnız son təsnifat başlığına deyil, orta səviyyəli xüsusiyyətlərinə bağlı ikinci köməkçi başlığa da tətbiq edərək təlim qradientinin şəbəkənin daha erkən qatlarına birbaşa çatmasını təmin edir; bu tədqiqatda köməkçi itki tərs sinif tezlikləri ilə çəkiləndiyi üçün azlıq siniflərinin təmsilinin orta xüsusiyyət səviyyəsində də gücləndirilməsi hədəflənmişdir.
Bu yanaşma yeni segmentasiya etiketi, lezyon maskası və ya ayrıca klinik annotasiya tələb etmir. Köməkçi və əsas başlıq eyni dörd sinifli düzgün etiketi istifadə edir. Buna görə əlavə nəzarət yeni semantik tapşırıq müəyyən etmək əvəzinə eyni təsnifat problemini şəbəkənin fərqli dərinliklərində yenidən görünən edir.
Tərs tezlik sinif çəkiləri
Hər sinif üçün çəki Tənlik (1) ilə müəyyən edilir:
\[ w_i=\frac{N}{C\,n_i} \]
Burada \(N\) təlim nümunələrinin ümumi sayını, \(C\) sinif sayını və \(n_i\) müvafiq \(i\) sinfindəki nümunələrin sayını göstərir. Bir sinifdə nümunə sayı azaldıqca \(n_i\) kiçilir və \(w_i\) böyüyür. Riyazi baxımdan bu, az təmsil olunan siniflərdəki yanlış təsnifatların itki funksiyasında daha yüksək çəki alması deməkdir. Bu tədqiqat üçün \(C=4\)-dür.
Tərs Tezlik Sinif Çəkisi Niyə Təkcə Son Qata Buraxılmayıb?
Tədqiqatın yanaşması yalnız son təsnifatçıdakı nümunə çəkilərini dəyişməklə kifayətlənmir; eyni çəkili diaqnostik hədəfi aralıq xüsusiyyət səviyyəsində də tətbiq edir, beləliklə azlıq sinfinin öyrənmə siqnalı şəbəkənin xüsusiyyət iyerarxiyasının daha erkən hissəsinə daşınır və köməkçi başlıqla əsas başlıq birlikdə optimallaşdırılır.
Arxitekturalara görə köməkçi qoşulma nöqtələri eyni deyil. ResNet-18 və ResNet-50 üçün köməkçi başlıq layer3 çıxışına qoşulur; aralıq təmsil ölçüləri müvafiq olaraq 256 və 1024 kanaldır. EfficientNet-B0-da orta genişlənmə/MBConv bölgəsinin təxminən 6-8-ci bloklarından istifadə olunur. ViT-B/16 üçün köməkçi nəzarət altıncı transformer blokunun 768 ölçülü təmsilinə tətbiq olunur.
Köməkçi başlıq aralıq aktivləşməni global average pooling ilə sıxlaşdırır və tam bağlı qat vasitəsilə dörd logit yaradır:
\[ \mathbf{f}_{aux}=FC(GAP(\mathbf{A}_{int})), \qquad \mathbf{A}_{int}\in\mathbb{R}^{H'\times W'\times C} \]
\(H'\) və \(W'\) aralıq xüsusiyyət xəritəsinin fəza ölçülərini, \(C\) isə kanal sayını göstərir. Global average pooling hər xüsusiyyət kanalını fəza üzrə ümumiləşdirir; tam bağlı qat isə bu təmsili dörd diaqnostik sinfə aid logitlərə çevirir.
Əsas və köməkçi itkinin birləşdirilməsi
Ümumi təlim məqsədi Tənlik (3) ilə qurulmuşdur:
\[ \mathcal{L}_{total} = \mathcal{L}_{main}(\hat{\mathbf{y}}_{main},\mathbf{y}) + \lambda\,\mathcal{L}_{aux}(\hat{\mathbf{y}}_{aux},\mathbf{y}) \]
Burada \(\mathcal{L}_{main}\) əsas başlığın, \(\mathcal{L}_{aux}\) isə köməkçi başlığın tərs tezlik çəkili çarpaz entropiya itkisidir. \(\lambda\) köməkçi başlığın ümumi optimallaşdırmadakı təsirini müəyyən edir. \(\lambda=0\) olduqda köməkçi itki ümumi hədəfə töhfə vermir və təlim standart tək başlıqlı vəziyyətə endirilir.
Köməkçi İtki Çəkisi Lambda Niyə Kritikdir?
\(\lambda\), köməkçi təsnifat hədəfinin ortaq xüsusiyyət məkanını nə qədər güclü istiqamətləndirdiyini müəyyən etdiyi üçün kritik hiperparametrdir; tədqiqat çox aşağı köməkçi təsirin azlıq sinfi üçün məhdud fayda verdiyini, həddən artıq yüksək təsirin isə precision-recall balansını poza bildiyini və ən yaxşı nəticələrin əksər konvolyusion şəbəkələrdə \(\lambda=0.3\), ViT-B/16-da isə \(\lambda=0.5\) ətrafında ortaya çıxdığını göstərmişdir.
Bu nəticə \(\lambda\)-nın “nə qədər böyükdürsə, bir o qədər yaxşıdır” şəklində şərh edilə bilməyəcəyini göstərir. Köməkçi itki əsas tapşırığı dəstəkləyən tənzimləyici kimi işləməlidir; əsas tapşırığın optimallaşdırılmasını basdıracaq qədər güclü olduqda azlıq sinfində precision və F1 qiymətləri geriləyə bilər.
Təlim protokolu
Dörd modelin hamısı ImageNet-1K ilə əvvəlcədən öyrədilmiş çəkilərdən başladılmışdır. AdamW optimizatoru üçün ilkin öyrənmə sürəti \(1\times10^{-4}\), weight decay \(1\times10^{-4}\), batch ölçüsü 16 və təlim büdcəsi 20 epoch-dur. Cosine annealing planlayıcısında minimum öyrənmə sürəti \(1\times10^{-6}\) kimi müəyyən edilmişdir.
Məlumat xəstə səviyyəsində stratified sampling ilə %70 təlim, %15 doğrulama və %15 test bölmələrinə ayrılmış; eyni xəstənin birdən çox bölməyə düşməməsi təmin edilmişdir. Hiperparametr sazlanması doğrulama dəsti ilə aparılmış və test dəsti son qiymətləndirmə üçün ayrılmışdır. Mənbə həmçinin xəstə səviyyəsində beş qatlı stratified cross-validation tətbiq edildiyini və yekun performansın qatlar üzrə orta qiymət kimi bildirildiyini qeyd edir. Buna baxmayaraq, əsas nəticə cədvəllərində qatlararası standart sapma və ya etibar intervalı ayrıca təqdim edilmir.
Təcrübələr Python 3.11 və PyTorch 2.5.1+CU121 ilə; CUDA/cuDNN aktiv NVIDIA RTX 2000 Ada Generation GPU, Intel Core Ultra 9 285 2.50 GHz prosessor və 32 GB sistem yaddaşı üzərində aparılmışdır.
Softmax və sinif ehtimalları
Dörd sinfə aid xam logitlər \(Z_i\), softmax ilə ehtimala çevrilir:
\[ \hat{y}_i = \frac{e^{Z_i}} {\sum_{j=1}^{4}e^{Z_j}} \]
Bu çevrilmə hər sinif üçün mənfi olmayan ehtimallar yaradır və dörd ehtimalın cəmini 1-ə bərabərləşdirir.
Grad-CAM və Attention Rollout Bu Tədqiqatda Nəyi Göstərir?
Grad-CAM və Attention Rollout modelin yalnız düzgün və ya yanlış qərar verdiyini deyil, bu qərarı yaradarkən görüntünün hansı bölgələrinə çəki verdiyini araşdırmaq üçün istifadə edilmişdir; Grad-CAM ResNet-18, ResNet-50 və EfficientNet-B0-da, Attention Rollout isə ViT-B/16-da tətbiq edilmiş və optimal köməkçi nəzarət altında xüsusilə Drusen nümunələrində diqqətin retinal patologiya bölgələrinə daha çox cəmlənə bildiyi müşahidə edilmişdir.
Grad-CAM riyaziyyatı
Hədəf sinif \(c\) üçün xüsusiyyət xəritəsi \(A^k\)-nın sinif skoruna töhfəsi qradientlərin fəza ortalaması ilə çəkiləndirilir:
\[ \alpha_k^c = \frac{1}{Z} \sum_i\sum_j \frac{\partial y^c}{\partial A_{ij}^k} \]
Daha sonra sinfə xas Grad-CAM xəritəsi:
\[ L_{\mathrm{Grad-CAM}}^c = ReLU\left( \sum_k \alpha_k^c A^k \right) \]
ilə hesablanır. ReLU əməliyyatı hədəf sinfə müsbət töhfə verən bölgələri saxlayır. Mənbədə yaradılan istilik xəritələri 224 × 224 OCT görüntüsünə yenidən miqyaslanaraq retinal struktur üzərinə bindirilmişdir.
ViT-B/16 üçün Attention Rollout
Transformer-in hər qatında \(H\) attention head-dən gələn diqqət matrisləri ortalanır və residual bağlantını nəzərə almaq üçün vahid matris əlavə olunur:
\[ \tilde{A}^{\,l} = \frac{1}{H} \sum_{h=1}^{H}A_h^{\,l} + I \]
Mənbə metodunda sətirlər normallaşdırıldıqdan sonra qatlar boyunca dəyişdirilmiş attention matrisləri ardıcıl olaraq vurulur. Beləliklə, sinif tokeninin giriş patch-lərinə qədər yayılan kumulyativ diqqət əlaqəsi əldə edilir. Patch səviyyəsindəki qiymətlər yenidən görüntü müstəvisinə daşınaraq OCT üzərinə bindirilir.
Qiymətləndirmə metrikləri
| Metrik | Formula | Elmi məna |
|---|---|---|
| Accuracy | \(\displaystyle Acc=\frac{TP+TN}{TP+TN+FP+FN}\) | Bütün nümunələr içində düzgün təsnif edilənlərin nisbəti; sinif balanssızlığında təkbaşına kifayət deyil. |
| Precision | \(\displaystyle Precision_c=\frac{TP_c}{TP_c+FP_c}\) | Modelin sinif \(c\) dediyi nümunələrin nə qədərinin həqiqətən həmin sinfə aid olduğunu göstərir. |
| Recall | \(\displaystyle Recall_c=\frac{TP_c}{TP_c+FN_c}\) | Həqiqi sinif \(c\) nümunələrinin nə qədərinin aşkarlandığını ölçür. |
| Specificity | \(\displaystyle Specificity_c=\frac{TN_c}{TN_c+FP_c}\) | Sinif \(c\)-yə aid olmayan nümunələrin düzgün şəkildə mənfi kimi ayrılma nisbətidir. |
| F1-skoru | \(\displaystyle F1_c=2\frac{Precision_c\times Recall_c}{Precision_c+Recall_c}\) | Precision və recall arasındakı harmonik tarazlığı ölçür; azlıq sinfinin qiymətləndirilməsində xüsusilə faydalıdır. |
| AUROC | \(\displaystyle AUROC_c=\int_0^1 TPR_c(FPR_c^{-1}(u))\,du\) | Müəyyən bir qərar həddinə bağlı qalmadan sinfin fərqləndirilə bilməsini ölçür. |
Tədqiqatın Metodu və Nəticələri
Ablation dizaynı
Hər backbone arxitekturasında köməkçi itki əmsalı \(\lambda=0.0, 0.3, 0.5, 0.7, 0.9\) qiymətlərində dəyişdirilmişdir. Bu dizaynın məqsədi yalnız ən yüksək ümumi dəqiqliyi tapmaq deyil, xüsusilə Drusen sinfində precision, recall, specificity, F1 və AUROC qiymətlərinin köməkçi nəzarətə necə reaksiya verdiyini ortaya qoymaqdır.
Hansı Köməkçi İtki Səviyyəsi Ən Yaxşı Nəticəni Verdi?
ResNet-18, ResNet-50 və EfficientNet-B0 üçün ən balanslı nəticələr \(\lambda=0.3\) ətrafında əldə edilərkən ViT-B/16 üçün ən uyğun nöqtə \(\lambda=0.5\) olmuşdur; ən yüksək ümumi performansı EfficientNet-B0 \(\lambda=0.3\) ilə %97,78 dəqiqlik və %93,51 Drusen F1-skoru ilə göstərmişdir.
| Model | Ən uyğun \(\lambda\) | Ümumi dəqiqlik (%) | Drusen precision (%) | Drusen recall (%) | Drusen specificity (%) | Drusen F1 (%) | Drusen AUROC (%) |
|---|---|---|---|---|---|---|---|
| ResNet-18 | 0.3 | 97.58 | 87.61 | 95.90 | 98.49 | 91.28 | 99.6 |
| ResNet-50 | 0.3 | 97.02 | 88.02 | 95.69 | 98.58 | 91.69 | 99.5 |
| EfficientNet-B0 | 0.3 | 97.78 | 92.54 | 94.51 | 99.29 | 93.51 | 99.5 |
| ViT-B/16 | 0.5 | 95.76 | 84.94 | 89.73 | 98.23 | 87.27 | 98.9 |
Drusen sinfindəki dəyişiklik
| Model | \(\lambda=0\) Drusen F1 (%) | Optimal Drusen F1 (%) | Dəyişiklik (faiz bəndi) |
|---|---|---|---|
| ResNet-18 | 89.80 | 91.28 | +1.48 |
| ResNet-50 | 89.08 | 91.69 | +2.61 |
| EfficientNet-B0 | 90.87 | 93.51 | +2.64 |
| ViT-B/16 | 85.25 | 87.27 | +2.02 |
Bu cədvəl köməkçi nəzarətin təsirinin arxitekturaya görə eyni olmadığını göstərir. EfficientNet-B0 ən yüksək Drusen F1 qiymətini yaradarkən, ViT-B/16 başlanğıcda ən aşağı Drusen F1 qiymətinə malikdir və köməkçi nəzarətdən faydalansa da konvolyusion modellərin səviyyəsinə çatmamışdır.
Niyə həddən artıq yüksək lambda faydalı olmadı?
Mənbə cədvəllərində \(\lambda\) yüksəldikcə performansın monoton şəkildə artmadığı görünür. Məsələn, ResNet-18-də \(\lambda=0.9\) şəraitində Drusen precision %83,59 və F1 %88,37-yə geriləyir. EfficientNet-B0-da da \(\lambda=0.9\) Drusen F1-i %90,37-dir və \(\lambda=0.3\)-dəki %93,51 səviyyəsinin altındadır. Köməkçi tapşırığın həddən artıq çəki qazanması ortaq təmsil üzərində precision-recall tarazlığını poza biləcək təzyiq yarada bilər.
Tam balanslı alt nümunələmə ilə müqayisə
Tədqiqatçılar metodun faydasının yalnız sinifləri say baxımından bərabərləşdirməkdən qaynaqlanıb-qaynaqlanmadığını sınamaq üçün ayrıca təcrübə aparmışlar. Drusen sinfindəki 8.957 nümunə istinad kimi götürülmüş və digər üç sinif təsadüfi olaraq 8.957 nümunəyə endirilərək cəmi 35.828 görüntüdən ibarət balanslı alt dəstlər yaradılmışdır. Üç fərqli təsadüfi seed ilə üç müstəqil balanslı məlumat alt dəsti hazırlanmış və EfficientNet-B0 eyni təlim parametrləri ilə yenidən öyrədilmişdir.
| Təlim strategiyası | Accuracy (%) | Macro-F1 (%) | Drusen-F1 (%) |
|---|---|---|---|
| Balanssız məlumat baseline | 97.29 | 96.11 | 89.87 |
| Balanslı undersampling | 95.64 | 95.38 | 91.65 |
| Təklif olunan metod | 97.78 | 96.87 | 93.51 |
Balanslı undersampling Drusen sinfini yaxşılaşdırsa da çoxluq siniflərinə aid çoxlu sayda görüntünü təlimdən çıxardığı üçün ümumi dəqiqlik və Macro-F1 geriləmişdir. Təklif olunan yanaşma isə məlumat dəstinin hamısını qoruyaraq optimallaşdırma zamanı sinif balanssızlığına müdaxilə edir. Mənbədəki Cədvəl 6-nın “Imbalanced Baseline” Drusen-F1 qiyməti %89,87 ikən əsas EfficientNet-B0 ablation cədvəlində \(\lambda=0\) Drusen F1 %90,87-dir; mənbə bu fərqin səbəbini ayrıca izah etmir.
Hesablama xərci və inference
| Model | Təlim müddəti (s) | GPU yaddaşı (GB) | Inference (ms) |
|---|---|---|---|
| ResNet-18 | 179.71 | 0.51 | 9.68 |
| Köməkçi nəzarətli ResNet-18 | 201.52 | 0.74 | 9.71 |
| ResNet-50 | 371.34 | 1.70 | 12.40 |
| Köməkçi nəzarətli ResNet-50 | 443.79 | 2.18 | 12.38 |
| EfficientNet-B0 | 243.05 | 1.67 | 11.13 |
| Köməkçi nəzarətli EfficientNet-B0 | 294.84 | 2.04 | 11.16 |
| ViT-B/16 | 1356.21 | 3.10 | 12.33 |
| Köməkçi nəzarətli ViT-B/16 | 1862.17 | 3.75 | 12.54 |
Köməkçi başlıq təlimdə əlavə irəli/geri yayılma və yaddaş xərci yaradır. Lakin mənbə metodunda köməkçi başlıq inference zamanı deaktiv edilir. Buna görə təklif olunan sistemin əsas üstünlüklərindən biri, öyrənmə zamanı əlavə nəzarətdən istifadə edərkən yerləşdirmə mərhələsində təxminən əsas backbone-un inference xərcini qorumasıdır. Cədvəl 7-də ölçülən kiçik millisaniyə fərqləri praktik olaraq baseline ilə eyni inference səviyyəsində qalır.
Şərh edilə bilmə: Drusen-də daha fokuslu aktivləşmə
Mənbənin Grad-CAM və Attention Rollout müqayisəsində Drusen, köməkçi itki ilə birlikdə ən nəzərəçarpan vizual dəyişiklik göstərən sinifdir. ResNet-18, ResNet-50 və EfficientNet-B0-nun baseline xəritələrində aktivləşmə daha geniş sahələrə yayılarkən optimal \(\lambda\) altında diqqətin xarici retinal qat və Drusen bölgəsinə doğru kəskinləşdiyi görünür.
CNV nümunələrində həm baseline, həm də köməkçi nəzarətli modellər artıq güclü və lokallaşdırılmış diqqət nümayiş etdirmişdir. DME-də aktivləşmələr mərkəzi retinal qatlar və intraretinal maye bölgələri ilə ümumilikdə uyğun qalmışdır. Bu vəziyyət köməkçi nəzarətin çoxluq və ya daha asan ayrılan siniflərin performansını yaxşılaşdırmaq naminə pozmaqdan çox, xüsusilə çətin və seyrək sinifdə xüsusiyyət təmsilini gücləndirdiyi şərhini dəstəkləyir.
ViT-B/16 və ağ padding həssaslığı
ViT-B/16 OCT görüntüsünü 16 × 16 patch-lərə bölür və global self-attention ilə emal edir. Mənbə Şəkil 6-da anatomik məlumat daşımayan ağ kənar sahələrin ViT diqqət xəritəsində CNN-lərlə müqayisədə daha çox göründüyü göstərilmişdir. ResNet və EfficientNet-in yerli konvolyusiyaları retinal qatlara daha sıx aktivləşmə yaradarkən ViT-nin diqqət paylanması daha genişdir.
Bu müşahidə mənbədə arxitektur izahla əlaqələndirilir: konvolyusion modellər yerli receptive field və translation-equivariance tipli induktiv qərəzlərə malik olduğu halda, ViT ilk qatlardan etibarən bütün patch-lər arasında qlobal əlaqə qura bilər. Buna baxmayaraq, tədqiqat padding-in ViT performans itkisinə yeganə və qəti səbəb olduğunu eksperimental olaraq təcrid etməmişdir. Fon maskalanması və ya retinal qatın kəsilməsi kimi xüsusi ön emal üsulları sınaqdan keçirilmədiyi üçün bu mexanizm güclü müşahidə xarakterli izah kimi saxlanmalıdır.
Tədqiqatın dəstəklədiyi nəticələr
- Aralıq qat köməkçi təsnifat ilə tərs tezlik çəkili itkinin birlikdə istifadəsi araşdırılan dörd arxitekturada Drusen F1 performansını baseline-a nisbətən artırmışdır.
- Konvolyusion modellər üçün \(\lambda=0.3\), ViT-B/16 üçün \(\lambda=0.5\) ən uyğun köməkçi təsir səviyyəsini vermişdir.
- EfficientNet-B0 araşdırılan konfiqurasiyalar arasında ən yüksək ümumi dəqiqliyi və ən yüksək Drusen F1-skorunu yaratmışdır.
- Optimal köməkçi nəzarət Grad-CAM və Attention Rollout xəritələrində xüsusilə Drusen üçün daha fokuslu anatomik diqqətlə birlikdə müşahidə edilmişdir.
- Köməkçi başlığın inference zamanı çıxarıla bilməsi səbəbindən performans artımı nəzərəçarpan test-zamanı hesablama yükü tələb etməmişdir.
- Təsadüfi undersampling azlıq sinfini qismən yaxşılaşdırsa da bütün məlumat müxtəlifliyini qoruyan təklif olunan metod ayrıca müqayisədə daha yüksək aggregate performans göstərmişdir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Nəticələr metodun fərqli OCT cihazlarında və ya fərqli xəstəxanalarda eyni performans göstərəcəyini sübut etmir.
- Tədqiqat prospektiv klinik tədqiqat deyil və real klinik iş axınında xəstə nəticələrinin yaxşılaşmasını göstərməmişdir.
- Grad-CAM və ya Attention Rollout xəritəsinin anatomik baxımdan mənalı görünməsi təkbaşına model qərarının klinik baxımdan düzgün mexanizmə əsaslandığını qəti şəkildə sübut etmir.
- ViT-B/16-nın aşağı performansının yalnız ağ padding-dən qaynaqlandığı sübut edilməmişdir; xüsusi padding aradan qaldırma ablation-u aparılmamışdır.
- Köməkçi nəzarətin təsiri ilə tərs sinif çəkiləndirməsinin müstəqil təsirləri tam faktorial ablation ilə ayrılmamışdır.
- Tək benchmark məlumat dəstində yüksək dəqiqlik modelin başqa populyasiyalarda və ya cihazlarda klinik istifadəyə hazır olduğu mənasına gəlmir.
Əsas məhdudiyyətlər və gələcək tədqiqatlar
Tədqiqatın birinci məhdudiyyəti bütün təcrübələrin tək benchmark məlumat dəsti və sabit dörd sinifli diaqnostik taksonomiya üzərində aparılmasıdır. Çoxmərkəzli və ya prospektiv xarici doğrulama olmadığından məlumat dəstinə xas görüntü xüsusiyyətlərinin model davranışına nə dərəcədə təsir etdiyi tam bilinmir.
İkinci məhdudiyyət təklif olunan metodun iki əsas komponentinin — tərs tezlik çəkiləndirməsi və aralıq qat köməkçi nəzarəti — müstəqil və birgə təsirlərinin tam faktorial şəkildə ayrılmamasıdır. Mənbə \(\lambda\) üçün geniş ablation təqdim edir, lakin “yalnız sinif çəkisi”, “yalnız köməkçi başlıq” və “hər ikisi birlikdə” şərtlərinin bütün arxitekturalarda ayrıca mexanistik matrisi verilmir.
Üçüncü məhdudiyyət ViT-B/16-nın padding həssaslığıdır. Avtomatik fon maskalanması, yalnız retina bölgəsinin kəsilməsi və ya konvolyusiya-attention hibrid arxitekturaları gələcəkdə qiymətləndirilə bilər. Mənbə həmçinin adaptive auxiliary weighting, lezyon segmentasiyası və xəstəlik dərəcələndirilməsi kimi əlavə köməkçi tapşırıqların araşdırılmasını təklif edir.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Interpretable Deeply Supervised Networks for Class-Imbalanced OCT Classification
Müəlliflər: Maria V. Leyba-Mesa; Buket D. Barkana.
Məsul müəllif: Buket D. Barkana.
Qurum: Department of Biomedical Engineering, College of Engineering and Polymer Science, The University of Akron, Akron, Ohio, ABŞ.
Jurnal: AI.
Nəşriyyat: MDPI, Basel, Switzerland.
Biblioqrafik qeyd: AI 2026, 7(5), 164.
DOI: 10.3390/ai7050164.
Rəsmi nəşr bağlantısı: MDPI rəsmi məqalə səhifəsi.
Nəşr prosesi: Alınma 16 Mart 2026; reviziya 5 May 2026; qəbul 6 May 2026; nəşr 8 May 2026. Rəsmi MDPI versiya qeydlərində Version of Record PDF-i 8 May 2026, yenilənmiş PDF isə 14 May 2026 tarixində qeydiyyata alınıb.
Mənbə növü: Rəy prosesindən keçmiş tədqiqat məqaləsi.
Lisenziya: Açıq giriş, Creative Commons Attribution (CC BY). Verianla təqdimatı buna baxmayaraq orijinal cümlə quruluşu və müstəqil tədris arxitekturası ilə hazırlanmışdır; mənbə fiqurları birbaşa kopyalanmamışdır.
Məlumat: Kermany OCT məlumat dəsti; mənbə tədqiqatda 84.495 OCT skanı, dörd diaqnostik sinif və xəstə səviyyəsində məlumat bölgüsü istifadə edilmişdir. Məqalənin məlumat əlçatanlığı bəyanatı istifadə olunan məlumatın Kaggle-dakı Kermany2018 məlumat dəstində olduğunu və giriş tarixinin 12 Sentyabr 2024 olduğunu bildirir.
Maliyyələşdirmə: Müəlliflər tədqiqatın xarici maliyyələşdirmə almadığını bildirmişlər.
Etik bəyanatlar: Institutional Review Board Statement “Not Applicable”; Informed Consent Statement “Not applicable” kimi verilmişdir.
Təşəkkür: Müəlliflər The University of Akron-dakı Margaret F. Donovan Endowment dəstəyini qeyd edirlər.
Maraq toqquşması: Müəlliflər maraq toqquşması bildirməmişlər.
Müəllif töhfələri: Konseptuallaşdırma M.V.L.-M. və B.D.B.; metodologiya, proqram təminatı, formal analiz, tədqiqat, məlumat kurasiyası və vizuallaşdırma əsasən M.V.L.-M.; resurslar, nəzarət və layihə idarəetməsi B.D.B.; doğrulama hər iki müəllif; ilkin layihə M.V.L.-M.; nəzərdən keçirmə və redaktə B.D.B. tərəfindən bildirilib.
Mənbədaxili texniki qeyd 1: ViT-B/16 nəticələrinin yer aldığı 4.4 bölməsinin giriş cümləsində Cədvəl 5 səhvən “ResNet-50 classifier” adlandırılmışdır. Cədvəl başlığı, mətnin davamı və qiymətlər ViT-B/16-ya aiddir; bu Verianla mətnində ViT-B/16 kimi işlənmişdir.
Mənbədaxili texniki qeyd 2: ResNet-50 müzakirəsində \(\lambda=0.5\)-dən sonrakı abzasda “\(\lambda=0\)” yazılıb. Cədvəl 3-ün sırası və eyni abzasdakı %96,69 dəqiqlik ilə %89,56 Drusen F1 qiymətləri bunun \(\lambda=0.7\) şərtinə uyğun gəldiyini göstərir. Mənbənin yazı uyğunsuzluğu gizlədilməyib.
Mənbədaxili texniki qeyd 3: Əsas EfficientNet-B0 ablation cədvəlində \(\lambda=0\) üçün Drusen F1 %90,87 ikən, ayrıca balanced-dataset təcrübəsinin Cədvəl 6-sında “Imbalanced Baseline” Drusen-F1 %89,87 kimi bildirilib. Mənbə bu fərqin səbəbini izah etmədiyindən iki qiymət öz təcrübə kontekstlərində ayrı saxlanılıb.
Əsas şərh sərhədi: Bu tədqiqat tək benchmark OCT məlumat dəsti üzərində maşın öyrənməsi təcrübəsidir. Nəticələr çoxmərkəzli xarici doğrulama, prospektiv klinik tədqiqat və ya xəstə nəticəsinə əsaslanan klinik effektivlik sübutu deyil.
Vizual yenidən çəkilmə uyğunluğu: Yüksək. İki başlıqlı təlim arxitekturası, sinif balanssızlığı axını, lambda-ablation nəticələri və CNN-ViT diqqət fərqi mənbə məlumatına sadiq orijinal sxemlərlə yenidən qurula bilər.
Verianla Live / Live Figure uyğunluğu: Qismən uyğun. Sabit mənbə məlumatları üzərindən arxitektura və \(\lambda\) müqayisələrinin addım-addım göstərilməsi uyğundur. İstifadəçinin \(\lambda\) və ya başqa hiperparametrləri dəyişdirərək mənbədə olmayan yeni performans qiymətləri yaratması uyğun deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib