

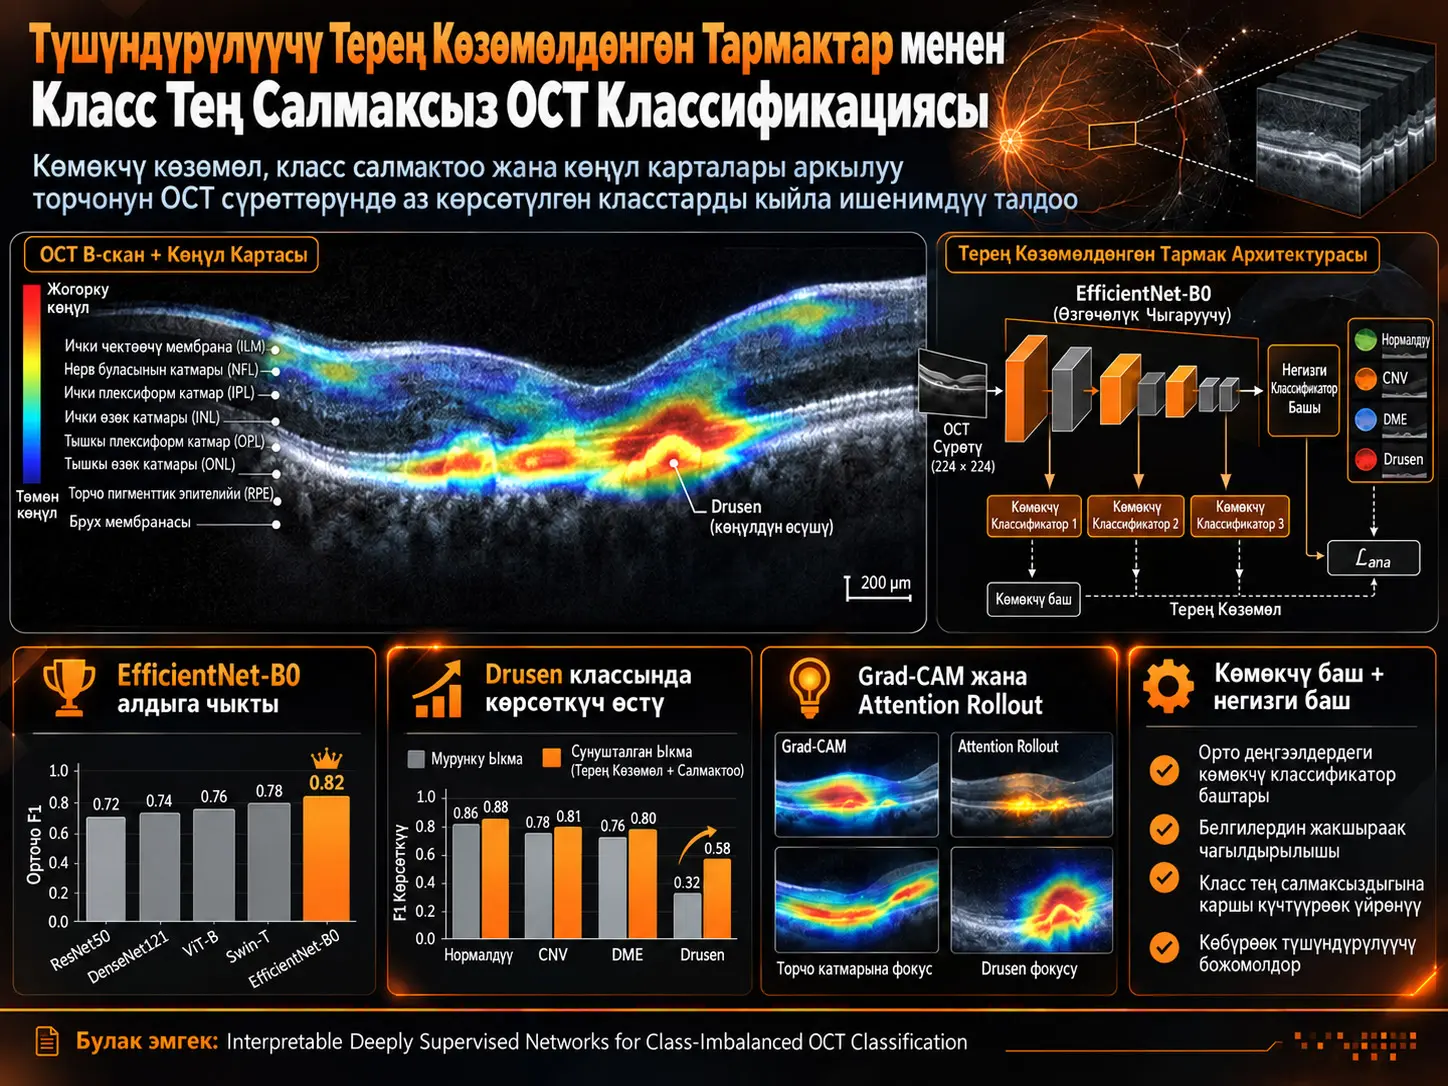
Бул изилдөө класстардын бөлүштүрүлүшү тең салмаксыз болгон торчонун оптикалык когеренттик томография сүрөттөрүн классификациялоодо аз көрсөтүлгөн оорулардын класстарын ишенимдүүрөөк үйрөнүүгө багытталган аралык катмардагы көмөкчү көзөмөл ыкмасын карайт. Аралык катмардагы көмөкчү көзөмөл — негизги классификаторго кошумча катары тармактын орто деңгээлдеги белгилерине экинчи классификатор башын туташтырып, бул башты негизги тапшырма менен бирге тек гана окутуу маалында оптималдаштырган терең үйрөнүү түзүлүшү. Изилдөөчүлөр бул түзүлүштү ResNet-18, ResNet-50, EfficientNet-B0 жана Vision Transformer ViT-B/16 моделдеринде төрт класстан турган 84.495 OCT сканы менен баалашкан. Маалымат топтомунда Drusen болжол менен %10,6 үлүшү менен эң аз көрсөтүлгөн класс болуп саналат.
Ыкма эки механизмди чогуу колдонот. Биринчиден, үлгүлөрү аз класстардын окутуу жоготуусуна кошкон салымы класстын тескери жыштыгы аркылуу көбөйтүлөт. Экинчиден, ошол эле төрт класстуу диагностикалык белги тармактын акыркы катмарына гана эмес, архитектурага жараша тандалган аралык катмарга да колдонулат. Негизги жоготуу менен көмөкчү жоготуунун ортосундагы тең салмак \(\lambda\) коэффициенти аркылуу башкарылат жана изилдөөдө \(\lambda \in \{0.0, 0.3, 0.5, 0.7, 0.9\}\) маанилери системалуу түрдө салыштырылат.
Эң күчтүү жалпы натыйжа EfficientNet-B0 үчүн \(\lambda=0.3\) шартында алынган: жалпы тактык %97,78 ге жетип, Drusen классында precision %92,54, сезгичтик/recall %94,51, specificity %99,29 жана F1-баа %93,51 деп билдирилген. EfficientNet-B0 моделинин негизги ablation таблицасындагы салмаксыз \(\lambda=0\) шартында Drusen F1-баа %90,87 болгондуктан өсүш 2,64 пайыздык пунктту түзөт. ResNet-18 жана ResNet-50 да орто деңгээлдеги көмөкчү жоготуудан пайда көргөн, ал эми ViT-B/16 үчүн эң ылайыктуу маани \(\lambda=0.5\) болгон.
Натыйжалар жалпы тактык менен гана бааланган эмес. Grad-CAM жана Attention Rollout талдоолору ылайыктуу көмөкчү көзөмөл шартында, өзгөчө Drusen үлгүлөрүндө, моделдин көңүлү клиникалык жактан тиешелүү торчо түзүлүштөрүнө жакшыраак топтоло аларын көрсөткөн. Ошол эле учурда ViT-B/16 маалымат топтомундагы ак четтерге жана padding аймактарына конволюциялык моделдерге караганда көбүрөөк сезгичтик көрсөткөн. Изилдөө бир гана benchmark маалымат топтомуна негизделген жана тышкы, көп борборлуу же проспективдүү клиникалык текшерүүнү камтыбагандыктан, натыйжаларды түздөн-түз чыныгы клиникалык колдонуудагы ийгилик катары чечмелөөгө болбойт.
Негизги көйгөй: жогорку жалпы тактык азчылык класстагы катаны жашырышы мүмкүн
Оптикалык когеренттик томография (optical coherence tomography, OCT) — торчонун катмарлуу түзүлүшүн кесиндилик көрүнүштө сүрөттөгөн инвазивдүү эмес сүрөттөө ыкмасы. Изилдөөдө колдонулган маалымат топтому төрт диагностикалык категорияны камтыйт: хориоидалдык неоваскуляризация (CNV), диабеттик макула шишиги (DME), Drusen жана нормалдуу торчо. Класстардын бөлүштүрүлүшү тең эмес: CNV болжол менен %44,5, нормалдуу торчо %31,5, DME %13,6 жана Drusen %10,6.
Мындай бөлүштүрүүдө жалпы тактыкты гана кароо жаңылыш болушу мүмкүн. Модель көпчүлүк класстарды абдан жакшы үйрөнгөндө жогорку жалпы тактыкка жетиши мүмкүн; бирок Drusen сыяктуу сейрек кездешкен класстын precision, recall же F1-баасы кыйла төмөн бойдон калышы мүмкүн. Ошондуктан изилдөөнүн борбордук көйгөйү “модель канча сүрөттү туура классификациялайт?” деген суроодон кыйла тар жана клиникалык жактан маанилүүрөөк суроого өтөт: аз көрсөтүлгөн торчо патологиясы класстарынын белгилери тармактын өкүлчүлүк мейкиндигинде жетиштүү күчтүү үйрөнүлөбү?
Булакта берилген OCT үлгүлөрү сүрөттөрдүн баары эле торчо ткандарынан гана турбасын да көрсөтөт. Айрым скандарда эңкейүү, айландыруу жана өзгөчө сүрөт четтеринде анатомиялык маалымат бербеген ак фон/padding аймактары бар. Бул деталь кийин ViT-B/16 менен конволюциялык тармактардын ортосунда байкалган көңүл буруу айырмасын түшүндүрүү үчүн маанилүү.
Аралык Көзөмөл Класстын Тең Салмаксыздыгын Кантип Бутага Алат?
Аралык көзөмөл ошол эле диагностикалык белгини тармактын акыркы классификатор башына гана эмес, орто деңгээлдеги белгилерге туташкан экинчи көмөкчү башка да колдонуу аркылуу окутуу градиентинин тармактын эртерээк катмарларына түз жетишин камсыз кылат; бул изилдөөдө көмөкчү жоготуу класстардын тескери жыштыгы менен салмакталгандыктан, азчылык класстарынын өкүлчүлүгүн орто белгилер деңгээлинде да күчөтүү максат кылынган.
Бул ыкма жаңы сегментация белгисин, жабыркоо маскасын же өзүнчө клиникалык аннотацияны талап кылбайт. Көмөкчү жана негизги баш бир эле төрт класстуу туура белгини колдонушат. Демек, кошумча көзөмөл жаңы семантикалык тапшырманы аныктоонун ордуна, ошол эле классификация маселесин тармактын ар башка тереңдиктеринде кайра көрүнүктүү кылат.
Тескери жыштыктагы класс салмактары
Ар бир класс үчүн салмак Теңдеме (1) менен аныкталат:
\[ w_i=\frac{N}{C\,n_i} \]
Бул жерде \(N\) окутуу үлгүлөрүнүн жалпы санын, \(C\) класстардын санын жана \(n_i\) тиешелүү \(i\) классындагы үлгүлөрдүн санын көрсөтөт. Класстагы үлгүлөрдүн саны азайган сайын \(n_i\) кичирейип, \(w_i\) өсөт. Математикалык жактан бул аз көрсөтүлгөн класстардагы туура эмес классификациялар жоготуу функциясында көбүрөөк салмак алаарын билдирет. Бул изилдөө үчүн \(C=4\).
Тескери Жыштыктагы Класс Салмагы Эмне Үчүн Жалгыз Акыркы Катмарга Калтырылган Эмес?
Изилдөөнүн ыкмасы акыркы классификатордогу үлгү салмактарын өзгөртүү менен гана чектелбейт; ошол эле салмакталган диагностикалык максатты аралык белгилер деңгээлинде да колдонот, ошентип азчылык классынын үйрөнүү сигналы тармактын белгилер иерархиясынын эртерээк бөлүгүнө өткөрүлүп, көмөкчү баш менен негизги баш чогуу оптималдаштырылат.
Архитектураларга жараша көмөкчү туташуу чекиттери бирдей эмес. ResNet-18 жана ResNet-50 үчүн көмөкчү баш layer3 чыгышына туташат; аралык өкүлчүлүктүн өлчөмдөрү тиешелүүлүгүнө жараша 256 жана 1024 канал. EfficientNet-B0 моделинде орто кеңейүү/MBConv аймагынын болжол менен 6-8-блоктору колдонулат. ViT-B/16 үчүн көмөкчү көзөмөл алтынчы transformer блогунун 768 өлчөмдүү өкүлчүлүгүнө колдонулат.
Көмөкчү баш аралык активдешүүнү global average pooling аркылуу кысып, толук байланышкан катмар аркылуу төрт logit чыгарат:
\[ \mathbf{f}_{aux}=FC(GAP(\mathbf{A}_{int})), \qquad \mathbf{A}_{int}\in\mathbb{R}^{H'\times W'\times C} \]
\(H'\) жана \(W'\) аралык белгилер картасынын мейкиндик өлчөмдөрүн, \(C\) каналдардын санын көрсөтөт. Global average pooling ар бир белги каналын мейкиндик боюнча жыйынтыктайт; толук байланышкан катмар болсо бул өкүлчүлүктү төрт диагностикалык класска тиешелүү logitтерге айландырат.
Негизги жана көмөкчү жоготууну бириктирүү
Жалпы окутуу максаты Теңдеме (3) менен түзүлгөн:
\[ \mathcal{L}_{total} = \mathcal{L}_{main}(\hat{\mathbf{y}}_{main},\mathbf{y}) + \lambda\,\mathcal{L}_{aux}(\hat{\mathbf{y}}_{aux},\mathbf{y}) \]
Бул жерде \(\mathcal{L}_{main}\) негизги баштын, \(\mathcal{L}_{aux}\) көмөкчү баштын тескери жыштык менен салмакталган cross-entropy жоготуусу. \(\lambda\) көмөкчү баштын жалпы оптималдаштыруудагы таасирин аныктайт. \(\lambda=0\) болгондо көмөкчү жоготуу жалпы максатка салым кошпойт жана окутуу стандарттуу бир баштуу абалга түшөт.
Көмөкчү Жоготуунун Салмагы Lambda Эмне Үчүн Критикалык?
\(\lambda\) көмөкчү классификация максаты жалпы белгилер мейкиндигин канчалык күчтүү багыттаарын аныктагандыктан критикалык гиперпараметр болуп саналат; изилдөө өтө төмөн көмөкчү таасир азчылык классына чектелүү пайда берерин, өтө жогорку таасир precision-recall тең салмагын бузушу мүмкүн экенин жана эң жакшы натыйжалар көпчүлүк конволюциялык тармактарда \(\lambda=0.3\), ViT-B/16 да болсо \(\lambda=0.5\) тегерегинде чыкканын көрсөткөн.
Бул жыйынтык \(\lambda\) маанисин “канчалык чоң болсо, ошончолук жакшы” деп чечмелөөгө болбой турганын көрсөтөт. Көмөкчү жоготуу негизги тапшырманы колдогон жөнгө салуучу катары иштеши керек; негизги тапшырманын оптималдашуусун баса тургандай күчтүү болуп калганда, азчылык класстагы precision жана F1 көрсөткүчтөрү төмөндөшү мүмкүн.
Окутуу протоколу
Төрт моделдин баары ImageNet-1K менен алдын ала үйрөтүлгөн салмактардан башталган. AdamW оптимизатору үчүн баштапкы үйрөнүү ылдамдыгы \(1\times10^{-4}\), weight decay \(1\times10^{-4}\), batch өлчөмү 16 жана окутуу бюджети 20 epoch болгон. Cosine annealing пландоочусунда минималдуу үйрөнүү ылдамдыгы \(1\times10^{-6}\) деп белгиленген.
Маалымат бейтап деңгээлинде stratified sampling аркылуу %70 окутуу, %15 валидация жана %15 тест бөлүктөрүнө ажыратылып, бир эле бейтаптын бир нече бөлүккө түшүп калбашы камсыздалган. Гиперпараметрлерди жөндөө валидация топтому менен жүргүзүлүп, тест топтому акыркы баалоо үчүн бөлүнгөн. Булак ошондой эле бейтап деңгээлинде беш катмарлуу stratified cross-validation колдонулганын жана акыркы натыйжа катмарлар боюнча орточо мааниде берилгенин белгилейт. Бирок негизги жыйынтык таблицаларында катмарлар аралык стандарттык четтөө же ишеним интервалы өзүнчө көрсөтүлгөн эмес.
Эксперименттер Python 3.11 жана PyTorch 2.5.1+CU121 менен; CUDA/cuDNN иштетилген NVIDIA RTX 2000 Ada Generation GPU, Intel Core Ultra 9 285 2.50 GHz процессору жана 32 GB системалык эс тутумда жүргүзүлгөн.
Softmax жана класс ыктымалдыктары
Төрт класска тиешелүү чийки logitтер \(Z_i\), softmax аркылуу ыктымалдыкка айландырылат:
\[ \hat{y}_i = \frac{e^{Z_i}} {\sum_{j=1}^{4}e^{Z_j}} \]
Бул өзгөртүү ар бир класс үчүн терс эмес ыктымалдыктарды чыгарып, төрт ыктымалдыктын суммасын 1 ге теңейт.
Grad-CAM жана Attention Rollout Бул Изилдөөдө Эмнени Көрсөтөт?
Grad-CAM жана Attention Rollout модель туура же туура эмес чечим чыгарганын гана эмес, бул чечимди чыгарууда сүрөттүн кайсы аймактарына көбүрөөк көңүл бурганын изилдөө үчүн колдонулган; Grad-CAM ResNet-18, ResNet-50 жана EfficientNet-B0 моделдеринде, Attention Rollout болсо ViT-B/16 да колдонулуп, оптималдуу көмөкчү көзөмөлдө өзгөчө Drusen үлгүлөрүндө көңүл торчо патологиясы жайгашкан аймактарга көбүрөөк топтоло алары байкалган.
Grad-CAM математикасы
Максаттуу \(c\) класс үчүн \(A^k\) белгилер картасынын класс баллына кошкон салымы градиенттердин мейкиндик боюнча орточосу менен салмакталат:
\[ \alpha_k^c = \frac{1}{Z} \sum_i\sum_j \frac{\partial y^c}{\partial A_{ij}^k} \]
Андан кийин класска тиешелүү Grad-CAM картасы:
\[ L_{\mathrm{Grad-CAM}}^c = ReLU\left( \sum_k \alpha_k^c A^k \right) \]
менен эсептелет. ReLU операциясы максаттуу класска оң салым кошкон аймактарды сактайт. Булакта түзүлгөн жылуулук карталары 224 × 224 OCT сүрөтүнө кайра масштабдалып, торчо түзүлүшүнүн үстүнө кабатталган.
ViT-B/16 үчүн Attention Rollout
Transformerдин ар бир катмарында \(H\) attention head дан келген көңүл матрицалары орточолонуп, residual байланыш эске алынышы үчүн бирдик матрица кошулат:
\[ \tilde{A}^{\,l} = \frac{1}{H} \sum_{h=1}^{H}A_h^{\,l} + I \]
Булактагы ыкмада саптар нормалдаштырылгандан кийин катмарлар боюнча өзгөртүлгөн attention матрицалары ырааттуу түрдө көбөйтүлөт. Мунун натыйжасында класс tokenинен кириш patchтерине чейин тараган жыйынды көңүл байланышы алынат. Patch деңгээлиндеги маанилер кайра сүрөт тегиздигине көчүрүлүп, OCT үстүнө кабатталат.
Баалоо метрикалары
| Метрика | Формула | Илимий мааниси |
|---|---|---|
| Accuracy | \(\displaystyle Acc=\frac{TP+TN}{TP+TN+FP+FN}\) | Бардык үлгүлөрдүн ичинен туура классификациялангандардын үлүшү; класс тең салмаксыз болгондо жалгыз өзү жетишсиз. |
| Precision | \(\displaystyle Precision_c=\frac{TP_c}{TP_c+FP_c}\) | Модель \(c\) классы деп белгилеген үлгүлөрдүн канчасы чынында ошол класска тиешелүү экенин көрсөтөт. |
| Recall | \(\displaystyle Recall_c=\frac{TP_c}{TP_c+FN_c}\) | Чыныгы \(c\) классынын үлгүлөрүнүн канчасы табылганын өлчөйт. |
| Specificity | \(\displaystyle Specificity_c=\frac{TN_c}{TN_c+FP_c}\) | \(c\) классына тиешелүү эмес үлгүлөрдүн туура түрдө терс деп ажыратылган үлүшү. |
| F1-баа | \(\displaystyle F1_c=2\frac{Precision_c\times Recall_c}{Precision_c+Recall_c}\) | Precision менен recall ортосундагы гармониялык тең салмакты өлчөйт; азчылык классын баалоодо өзгөчө пайдалуу. |
| AUROC | \(\displaystyle AUROC_c=\int_0^1 TPR_c(FPR_c^{-1}(u))\,du\) | Белгилүү бир чечим босогосуна байланбастан класстын айырмалануу жөндөмүн өлчөйт. |
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Ablation дизайны
Ар бир backbone архитектурасында көмөкчү жоготуу коэффициенти \(\lambda=0.0, 0.3, 0.5, 0.7, 0.9\) маанилеринде өзгөртүлгөн. Бул дизайн жалпы тактыктын эң жогорку маанисин гана табуу үчүн эмес, өзгөчө Drusen классында precision, recall, specificity, F1 жана AUROC көрсөткүчтөрүнүн көмөкчү көзөмөлгө кандай жооп берерин аныктоо үчүн түзүлгөн.
Көмөкчү Жоготуунун Кайсы Деңгээли Эң Жакшы Натыйжа Берди?
ResNet-18, ResNet-50 жана EfficientNet-B0 үчүн эң тең салмактуу натыйжалар \(\lambda=0.3\) тегерегинде алынган, ал эми ViT-B/16 үчүн эң ылайыктуу чекит \(\lambda=0.5\) болгон; эң жогорку жалпы натыйжаны EfficientNet-B0 \(\lambda=0.3\) менен %97,78 тактык жана %93,51 Drusen F1-баасы аркылуу көрсөткөн.
| Модель | Эң ылайыктуу \(\lambda\) | Жалпы тактык (%) | Drusen precision (%) | Drusen recall (%) | Drusen specificity (%) | Drusen F1 (%) | Drusen AUROC (%) |
|---|---|---|---|---|---|---|---|
| ResNet-18 | 0.3 | 97.58 | 87.61 | 95.90 | 98.49 | 91.28 | 99.6 |
| ResNet-50 | 0.3 | 97.02 | 88.02 | 95.69 | 98.58 | 91.69 | 99.5 |
| EfficientNet-B0 | 0.3 | 97.78 | 92.54 | 94.51 | 99.29 | 93.51 | 99.5 |
| ViT-B/16 | 0.5 | 95.76 | 84.94 | 89.73 | 98.23 | 87.27 | 98.9 |
Drusen классындагы өзгөрүү
| Модель | \(\lambda=0\) Drusen F1 (%) | Оптималдуу Drusen F1 (%) | Өзгөрүү (пайыздык пункт) |
|---|---|---|---|
| ResNet-18 | 89.80 | 91.28 | +1.48 |
| ResNet-50 | 89.08 | 91.69 | +2.61 |
| EfficientNet-B0 | 90.87 | 93.51 | +2.64 |
| ViT-B/16 | 85.25 | 87.27 | +2.02 |
Бул таблица көмөкчү көзөмөлдүн таасири архитектурага жараша бирдей эмес экенин көрсөтөт. EfficientNet-B0 эң жогорку Drusen F1 маанисин берген, ал эми ViT-B/16 баштапкыда эң төмөн Drusen F1 маанисине ээ болуп, көмөкчү көзөмөлдөн пайда көрсө да конволюциялык моделдердин деңгээлине жеткен эмес.
Эмне үчүн өтө жогорку lambda пайдалуу болгон жок?
Булактагы таблицаларда \(\lambda\) өскөн сайын натыйжа монотондуу түрдө көбөйбөй турганы көрүнөт. Мисалы, ResNet-18 үчүн \(\lambda=0.9\) шартында Drusen precision %83,59 жана F1 %88,37 ге төмөндөйт. EfficientNet-B0 үчүн да \(\lambda=0.9\) Drusen F1 көрсөткүчү %90,37 болуп, \(\lambda=0.3\) шартындагы %93,51 деңгээлинен төмөн. Көмөкчү тапшырманын өтө чоң салмакка ээ болушу жалпы өкүлчүлүктө precision-recall тең салмагын буза турган басым жаратышы мүмкүн.
Толук тең салмакталган азайтып тандоо менен салыштыруу
Изилдөөчүлөр ыкманын пайдасы класстарды сан жагынан теңдөөдөн гана келип чыгабы же жокпу текшерүү үчүн өзүнчө эксперимент жүргүзүшкөн. Drusen классындагы 8.957 үлгү негиз катары алынып, калган үч класс туш келди түрдө 8.957 үлгүгө чейин азайтылып, жалпысынан 35.828 сүрөттөн турган тең салмакталган ички топтомдор түзүлгөн. Үч башка туш келди seed менен үч көз карандысыз тең салмакталган маалымат ички топтому даярдалып, EfficientNet-B0 ошол эле окутуу параметрлери менен кайра үйрөтүлгөн.
| Окутуу стратегиясы | Accuracy (%) | Macro-F1 (%) | Drusen-F1 (%) |
|---|---|---|---|
| Тең салмаксыз маалымат baseline | 97.29 | 96.11 | 89.87 |
| Тең салмакталган undersampling | 95.64 | 95.38 | 91.65 |
| Сунушталган ыкма | 97.78 | 96.87 | 93.51 |
Тең салмакталган undersampling Drusen классын жакшыртканы менен, көпчүлүк класстарга тиешелүү көп сандагы сүрөттөрдү окутуудан алып салгандыктан жалпы тактык жана Macro-F1 төмөндөгөн. Сунушталган ыкма болсо маалымат топтомунун баарын сактап, оптималдаштыруу учурунда класс тең салмаксыздыгына кийлигишет. Булактагы 6-таблицада “Imbalanced Baseline” Drusen-F1 мааниси %89,87 болсо, негизги EfficientNet-B0 ablation таблицасында \(\lambda=0\) Drusen F1 %90,87; булак бул айырманын себебин өзүнчө түшүндүрбөйт.
Эсептөө чыгымы жана inference
| Модель | Окутуу убактысы (s) | GPU эс тутуму (GB) | Inference (ms) |
|---|---|---|---|
| ResNet-18 | 179.71 | 0.51 | 9.68 |
| Көмөкчү көзөмөлдүү ResNet-18 | 201.52 | 0.74 | 9.71 |
| ResNet-50 | 371.34 | 1.70 | 12.40 |
| Көмөкчү көзөмөлдүү ResNet-50 | 443.79 | 2.18 | 12.38 |
| EfficientNet-B0 | 243.05 | 1.67 | 11.13 |
| Көмөкчү көзөмөлдүү EfficientNet-B0 | 294.84 | 2.04 | 11.16 |
| ViT-B/16 | 1356.21 | 3.10 | 12.33 |
| Көмөкчү көзөмөлдүү ViT-B/16 | 1862.17 | 3.75 | 12.54 |
Көмөкчү баш окутууда кошумча алдыга/артка таратуу жана эс тутум чыгымын жаратат. Бирок булактагы ыкмада көмөкчү баш inference маалында өчүрүлөт. Ошондуктан сунушталган системанын негизги артыкчылыктарынын бири — үйрөнүүдө кошумча көзөмөл колдонулганы менен, жайылтуу баскычында негизги backbone моделинин inference чыгымын болжол менен сактап калуусу. 7-таблицада өлчөнгөн кичине миллисекунд айырмачылыктар практикалык жактан baseline менен бирдей inference деңгээлинде калат.
Түшүндүрмөлүүлүк: Drusen үчүн көбүрөөк топтолгон активдешүү
Булактагы Grad-CAM жана Attention Rollout салыштыруусунда Drusen көмөкчү жоготуу менен бирге эң көрүнүктүү визуалдык өзгөрүүнү көрсөткөн класс болуп саналат. ResNet-18, ResNet-50 жана EfficientNet-B0 моделдеринин baseline карталарында активдешүү кененирээк аймактарга тараса, оптималдуу \(\lambda\) шартында көңүл сырткы торчо катмарына жана Drusen аймагына карай такыраак топтолгону көрүнөт.
CNV үлгүлөрүндө baseline да, көмөкчү көзөмөлдүү моделдер да мурда эле күчтүү жана локалдашкан көңүл көрсөткөн. DMEде активдешүүлөр борбордук торчо катмарлары жана интраретиналдык суюктук аймактары менен жалпысынан шайкеш бойдон калган. Бул көрүнүш көмөкчү көзөмөл көпчүлүк же оңойураак ажыратылуучу класстардын көрсөткүчүн жакшыртуу үчүн аларды бузгандан көрө, өзгөчө татаал жана сейрек класстагы белгилердин өкүлчүлүгүн күчөтөт деген чечмелөөнү колдойт.
ViT-B/16 жана ак padding сезгичтиги
ViT-B/16 OCT сүрөтүн 16 × 16 patchтерге бөлүп, global self-attention менен иштетет. Булактагы 6-сүрөттө анатомиялык маалымат бербеген ак чет аймактар ViT көңүл картасында CNN моделдерине салыштырмалуу көбүрөөк көрүнөрү көрсөтүлгөн. ResNet жана EfficientNet моделдеринин жергиликтүү конволюциялары торчо катмарларына тыгызыраак активдешүү жаратса, ViT моделинин көңүл бөлүштүрүлүшү кеңирээк.
Бул байкоо булакта архитектуралык түшүндүрмө менен байланышкан: конволюциялык моделдер жергиликтүү receptive field жана translation-equivariance түрүндөгү индуктивдүү ыктоолорго ээ, ал эми ViT алгачкы катмарлардан тартып бардык patchтердин ортосунда глобалдык байланыш түзө алат. Ошого карабастан, изилдөө padding ViT көрсөткүчүнүн төмөндөшүнүн жалгыз жана так себеби экенин эксперименталдык түрдө бөлүп көрсөткөн эмес. Фонду маскалоо же торчо катмарын кесүү сыяктуу атайын алдын ала иштетүүлөр текшерилбегендиктен, бул механизм күчтүү байкоого негизделген түшүндүрмө катары гана сакталууга тийиш.
Изилдөө колдогон жыйынтыктар
- Аралык катмардагы көмөкчү классификация менен тескери жыштык боюнча салмакталган жоготууну бирге колдонуу каралган төрт архитектурада Drusen F1 көрсөткүчүн baseline га салыштырмалуу жогорулаткан.
- Конволюциялык моделдер үчүн \(\lambda=0.3\), ViT-B/16 үчүн \(\lambda=0.5\) эң ылайыктуу көмөкчү таасир деңгээлин берген.
- EfficientNet-B0 каралган конфигурациялардын ичинен эң жогорку жалпы тактыкты жана эң жогорку Drusen F1-баасын көрсөткөн.
- Оптималдуу көмөкчү көзөмөл Grad-CAM жана Attention Rollout карталарында, өзгөчө Drusen үчүн, анатомиялык жактан көбүрөөк топтолгон көңүл менен коштолгон.
- Көмөкчү баш inference маалында алынып салынгандыктан, көрсөткүчтүн жогорулашы тест маалында олуттуу кошумча эсептөө жүгүн талап кылган эмес.
- Туш келди undersampling азчылык классын жарым-жартылай жакшыртса да, маалыматтын бардык ар түрдүүлүгүн сактаган сунушталган ыкма өзүнчө салыштырууда жогорураак aggregate көрсөткүч берген.
Изилдөө колдобогон жыйынтыктар
- Натыйжалар ыкма башка OCT аппараттарында же башка ооруканаларда ошол эле көрсөткүчтү берерин далилдебейт.
- Изилдөө проспективдүү клиникалык изилдөө эмес жана чыныгы клиникалык иш агымында бейтаптын жыйынтыгы жакшырганын көрсөткөн эмес.
- Grad-CAM же Attention Rollout картасынын анатомиялык жактан маанилүү көрүнүшү өзүнчө эле модель чечими клиникалык жактан туура механизмге негизделгенин так далилдей албайт.
- ViT-B/16 моделинин төмөн көрсөткүчү тек гана ак paddingден улам экени далилденген эмес; атайын padding алып салуу ablation жүргүзүлгөн эмес.
- Көмөкчү көзөмөлдүн таасири менен тескери класс салмактоонун өз алдынча таасирлери толук факториалдык ablation аркылуу ажыратылган эмес.
- Бир benchmark маалымат топтомундагы жогорку тактык модель башка популяцияларда же аппараттарда клиникалык колдонууга даяр дегенди билдирбейт.
Негизги чектөөлөр жана келечектеги изилдөөлөр
Изилдөөнүн биринчи чектөөсү — бардык эксперименттер бир benchmark маалымат топтомунда жана туруктуу төрт класстуу диагностикалык таксономияда жүргүзүлгөн. Көп борборлуу же проспективдүү тышкы валидация болбогондуктан, маалымат топтомуна мүнөздүү сүрөт өзгөчөлүктөрү моделдин жүрүм-турумуна канчалык деңгээлде таасир этери толук белгисиз.
Экинчи чектөө — сунушталган ыкманын эки негизги компонентинин, тактап айтканда тескери жыштык менен салмактоо жана аралык катмардагы көмөкчү көзөмөлдүн, өз алдынча жана биргелешкен таасирлери толук факториалдык түрдө ажыратылган эмес. Булак \(\lambda\) үчүн кеңири ablation берет, бирок “класс салмагы гана”, “көмөкчү баш гана” жана “экөө бирге” шарттарынын бардык архитектураларда өзүнчө механисттик матрицасы берилбейт.
Үчүнчү чектөө — ViT-B/16 моделинин paddingге сезгичтиги. Фонду автоматтык маскалоо, торчо аймагын гана кесүү же конволюция-attention гибрид архитектуралары келечекте бааланышы мүмкүн. Булак ошондой эле adaptive auxiliary weighting, жабыркоону сегментациялоо жана оорунун даражасын аныктоо сыяктуу кошумча көмөкчү тапшырмаларды изилдөөнү сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түп нуска изилдөө: Interpretable Deeply Supervised Networks for Class-Imbalanced OCT Classification
Авторлор: Maria V. Leyba-Mesa; Buket D. Barkana.
Жооптуу автор: Buket D. Barkana.
Мекеме: Department of Biomedical Engineering, College of Engineering and Polymer Science, The University of Akron, Akron, Ohio, АКШ.
Журнал: AI.
Басмакана: MDPI, Basel, Switzerland.
Библиографиялык жазуу: AI 2026, 7(5), 164.
DOI: 10.3390/ai7050164.
Расмий жарыя шилтемеси: MDPI расмий макала барагы.
Жарыялоо процесси: Алынган 16 Март 2026; оңдолгон 5 Май 2026; кабыл алынган 6 Май 2026; жарыяланган 8 Май 2026. MDPIнин расмий версия эскертүүлөрүндө Version of Record PDF 8 Май 2026, жаңыртылган PDF болсо 14 Май 2026 күнү катталган.
Булактын түрү: Рецензиялоо процессинен өткөн изилдөө макаласы.
Лицензия: Ачык жеткиликтүүлүк, Creative Commons Attribution (CC BY). Ошого карабастан Verianla баяны өз алдынча сүйлөм түзүлүшү жана көз карандысыз билим берүү архитектурасы менен даярдалган; булактагы сүрөттөр түз көчүрүлгөн эмес.
Маалымат: Kermany OCT маалымат топтому; булак изилдөөдө 84.495 OCT сканы, төрт диагностикалык класс жана бейтап деңгээлиндеги маалымат бөлүштүрүү колдонулган. Макаланын маалымат жеткиликтүүлүгү жөнүндөгү билдирүүсү колдонулган маалымат Kaggle платформасындагы Kermany2018 маалымат топтомунда экенин жана жетүү датасы 12 Сентябрь 2024 болгонун көрсөтөт.
Каржылоо: Авторлор изилдөө тышкы каржылоо албаганын билдиришкен.
Этикалык билдирүүлөр: Institutional Review Board Statement “Not Applicable”; Informed Consent Statement “Not applicable” деп берилген.
Ыраазычылык: Авторлор The University of Akron мекемесиндеги Margaret F. Donovan Endowment колдоосун белгилешет.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышын билдиришкен эмес.
Авторлордун салымы: Концептуалдаштыруу M.V.L.-M. жана B.D.B.; методология, программалык камсыздоо, формалдык талдоо, изилдөө, маалыматтарды курациялоо жана визуалдаштыруу негизинен M.V.L.-M.; ресурстар, көзөмөл жана долбоорду башкаруу B.D.B.; валидация эки автор; баштапкы кол жазма M.V.L.-M.; карап чыгуу жана редакциялоо B.D.B. тарабынан жүргүзүлгөн деп билдирилген.
Булак ичиндеги техникалык эскертүү 1: ViT-B/16 жыйынтыктары берилген 4.4-бөлүмдүн кириш сүйлөмүндө 5-таблица жаңылыш түрдө “ResNet-50 classifier” деп аталган. Таблицанын аталышы, тексттин уландысы жана маанилер ViT-B/16 га тиешелүү; бул Verianla текстинде ViT-B/16 катары каралган.
Булак ичиндеги техникалык эскертүү 2: ResNet-50 талкуусунда \(\lambda=0.5\) ден кийинки абзацта “\(\lambda=0\)” деп жазылган. 3-таблицанын ирети жана ошол эле абзацтагы %96,69 тактык менен %89,56 Drusen F1 маанилери мунун \(\lambda=0.7\) шартына туура келерин көрсөтөт. Булактагы жазуудагы дал келбестик жашырылган эмес.
Булак ичиндеги техникалык эскертүү 3: Негизги EfficientNet-B0 ablation таблицасында \(\lambda=0\) үчүн Drusen F1 %90,87 болсо, өзүнчө balanced-dataset экспериментиндеги 6-таблицада “Imbalanced Baseline” Drusen-F1 %89,87 деп берилген. Булак бул айырманын себебин түшүндүрбөгөндүктөн, эки маани өз эксперименттик контексттеринде өзүнчө сакталган.
Негизги чечмелөө чеги: Бул изилдөө бир benchmark OCT маалымат топтомунда жүргүзүлгөн машиналык үйрөнүү эксперименти. Натыйжалар көп борборлуу тышкы валидация, проспективдүү клиникалык изилдөө же бейтаптын жыйынтыгына негизделген клиникалык натыйжалуулуктун далили эмес.
Визуалдык кайра чийүүгө ылайыктуулук: Жогорку. Эки баштуу окутуу архитектурасы, класс тең салмаксыздыгынын агымы, lambda-ablation натыйжалары жана CNN-ViT көңүл айырмасы булак маалыматтарына берилген оригиналдуу схемалар менен кайра түзүлүшү мүмкүн.
Verianla Live / Live Figure ылайыктуулугу: Жарым-жартылай ылайыктуу. Туруктуу булак маалыматтары боюнча архитектура жана \(\lambda\) салыштырууларын кадам сайын көрсөтүү ылайыктуу. Колдонуучунун \(\lambda\) же башка гиперпараметрлерди өзгөртүп, булакта жок жаңы көрсөткүч маанилерин жаратышы ылайыктуу эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген