

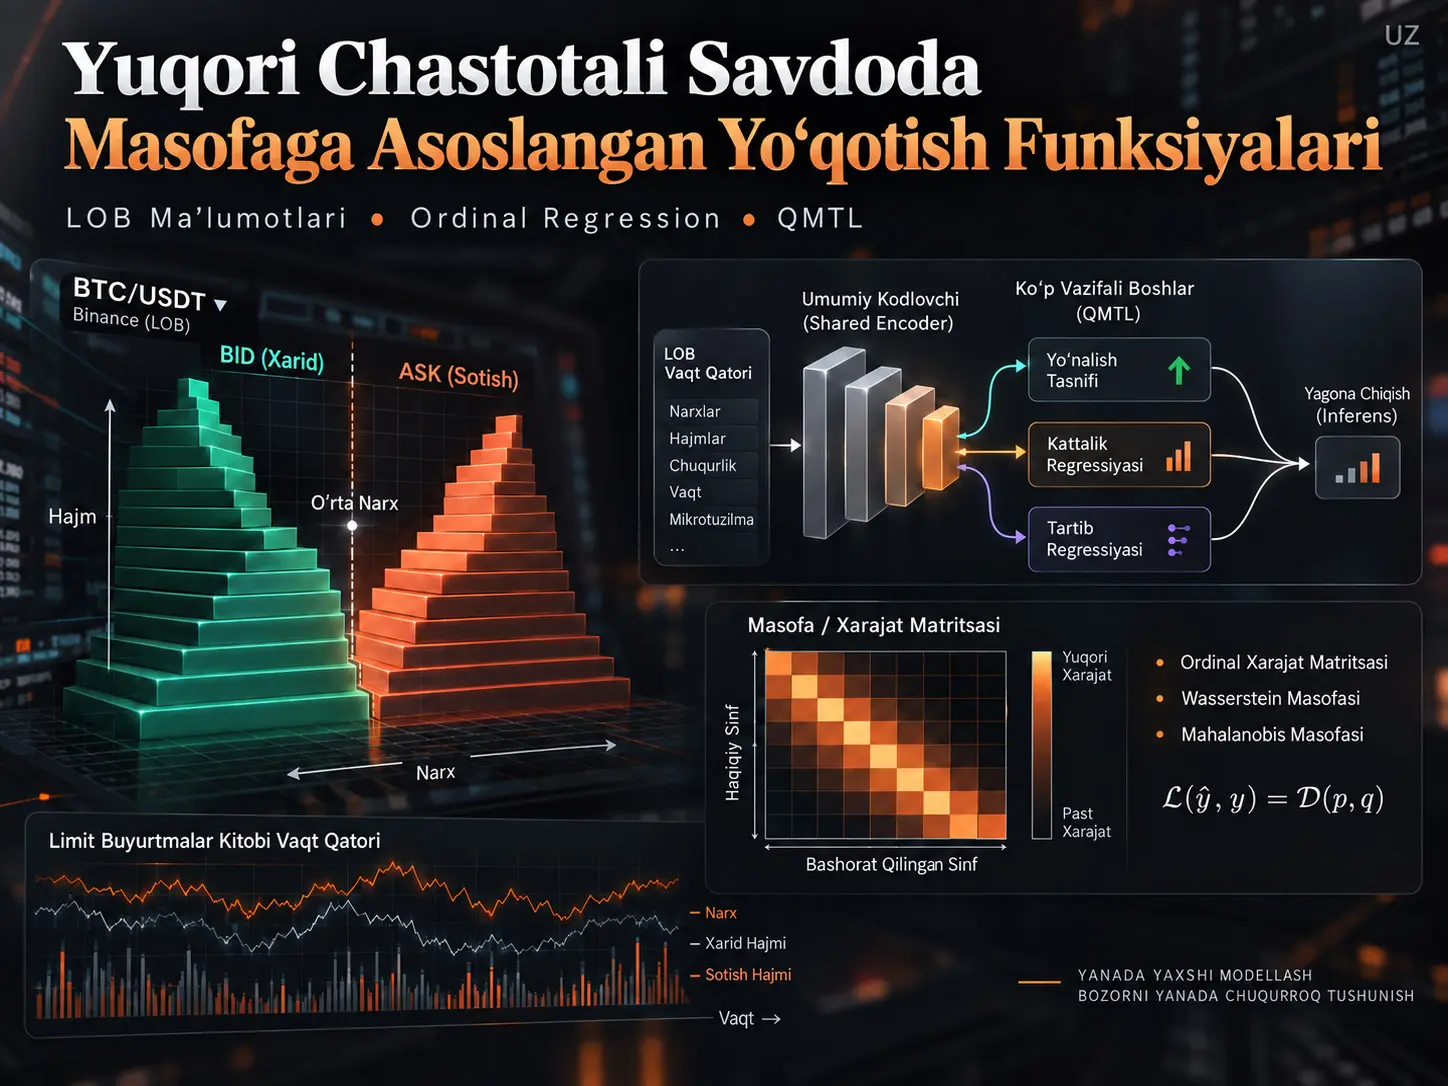
Ushbu tadqiqot yuqori chastotali savdoda (High-Frequency Trading, HFT) qisqa muddatli bozor yoʻnalishini bashorat qiladigan chuqur oʻrganish modellarini xulosa chiqarish bosqichidagi arxitekturani kattalashtirmasdan, oʻqitish jarayonida qanday yaxshilash mumkinligini oʻrganadi. Tadqiqotda Binance BTC/USDT bozoridan CryptoHFTData orqali olingan Limit Order Book (LOB) maʼlumotlaridan foydalanilgan; 1 oktyabr-30 noyabr 2025 davridagi buyurtmalar daftari oqimi 250 ms oraliqlarda namunalanib, kelajakdagi oʻrta narx harakati −1, 0 va +1 dan iborat uch sinfga ajratilgan. Asosiy usullar — sinflar orasidagi xatolar bir xil ahamiyatga ega emasligini hisobga oladigan Ordinal Log-Loss (OLL), maʼlumot taqsimotlaridan hosil qilingan xarajat matritsalari hamda oʻqitish vaqtida bir xil vazifani bajaradigan bir nechta boshdan foydalanadigan Quasi-Multi-Task Learning (QMTL) yondashuvidir. Tajribalarda Wasserstein masofasi asosida tuzilgan xarajat matritsasi standart cross-entropy va boshqa xarajat matritsasi dizaynlariga nisbatan umuman olganda eng izchil natijani koʻrsatgan; QMTL esa ayrim arxitektura va metrikalarda ko'p boshli oʻqitishdan keyin faqat bitta bosh qoldirilganda ham foydali boʻlishi mumkinligiga eksperimental dalil bergan. Biroq natijalar bitta kriptoaktiv, bitta birja, ikki oylik tarixiy maʼlumot va tasniflash metrikalari bilan cheklangan; tadqiqot real vaqt buyurtma ijrosini yoki sof savdo rentabelligini isbotlamaydi.
Limit Buyurtmalar Daftari (Limit Order Book, LOB)muayyan aktivga tegishli kutilayotgan limitli xarid va sotuv buyurtmalarini narx darajalari va hajmlari bilan ifodalovchi elektron bozor tuzilmasidir. Ordinal Log-Loss (OLL)tasniflash xatolarini xarajat matritsasi orqali turli ogʻirlikda jazolay oladigan ordinal tasniflash yoʻqotishidir. Quasi-Multi-Task Learning (QMTL) esa bir xil maqsadni bashorat qiluvchi bir nechta boshni umumiy enkoder bilan birga oʻqitib, xulosa chiqarish bosqichida bu qoʻshimcha boshlarni olib tashlash imkonini beradigan ko'p vazifali oʻqitish yondashuvidir.
| Element | Manbada ishlatilgan qiymat |
|---|---|
| Bozor | Binance BTC/USDT |
| Maʼlumot manbai | CryptoHFTData |
| Davr | 1 oktyabr-30 noyabr 2025 |
| Vaqt bo‘yicha namunalash | 250 ms |
| LOB darajasi | Dastlabki 10 daraja |
| Kirish oynasi | 100 ta LOB oniy tasviri |
| Oyna qadami | 20 namuna |
| Yorliqlar | −1, 0, +1 |
| Yorliqlash | Triple Barrier Method; α = 0.001, k = 100 |
| Sinovdan oʻtkazilgan modellar | Baseline CNN, DeepLOB, MLPLOB |
Nega muammo faqat kattaroq model qurishdan iborat emas?
Yuqori chastotali savdoda model bashoratining sifati qanchalik muhim boʻlsa, bashoratning qanchalik tez ishlab chiqilishi ham shunchalik muhim. Katta neyron tarmoq tasniflash aniqligini oshirsa ham, xulosa chiqarish vaqtini uzaytirsa, kechikishga sezgir foydalanish uchun amaliy qiymatini yoʻqotishi mumkin. Shu sababli tadqiqotning maqsadi yangi va kattaroq HFT arxitekturasini yaratish emas. Tadqiqot mavjud arxitekturalarning oʻqitish tartibini oʻzgartirish orqali ayni xulosa chiqarish arxitekturasi bilan yaxshiroq bashorat xulqiga erishish mumkinmi, degan savolni oʻrganadi.
Bu tanlov tadqiqotni bir-birini toʻldiruvchi ikki yoʻnalishga olib boradi. Birinchi yoʻnalish −1, 0 va +1 bozor yoʻnalishi sinflarining tabiiy tartibi mavjudligini hisobga oladigan ordinal regressiyadir. Ikkinchi yoʻnalish esa model faqat oʻqitish vaqtida bir nechta chiqish boshi bilan ishlaydigan QMTL-dir. Har ikkala yondashuv ham joylashtirish paytida model tanasini majburan kattalashtirmasdan oʻqitish maʼlumotini boyitishni maqsad qiladi.
LOB maʼlumoti model kirishiga qanday aylantiriladi?
Bitta LOB oniy tasvirida har bir daraja uchun xarid narxi, xarid hajmi, sotuv narxi va sotuv hajmi mavjud. Tadqiqot dastlabki \(N=10\) darajadan foydalanadi. Shunday qilib, bitta LOB tasviri \(4N=40\) xususiyatga ega boʻladi. Model kirishi tuzilganda ketma-ket \(W=100\) tasvir birlashtiriladi va kirish tenzori \(4N \times W = 40 \times 100\) oʻlchamiga yetadi.
Xom CryptoHFTData oqimi faqat muntazam oniy tasvirlardan iborat emas; u soatlik toʻliq tasvirlar bilan ular orasidagi oʻzgarish yangilanishlarini birgalikda oʻz ichiga oladi. Tadqiqotda bu hodisaga asoslangan oqim avval qayta tiklanadi, soʻng \(\delta t=250\,\mathrm{ms}\) oraliqlarda muntazam namunalanadi. Bir oraliqda bir nechta oʻzgarish boʻlsa, oxirgi holat tanlanadi; oʻzgarish boʻlmasa, avvalgi LOB holati davom ettiriladi.
Kirish oynasi 100 namuna uzunligida va yangi maʼlumot nuqtasini yaratish uchun oyna 20 namuna oldinga suriladi. Shu sababli qoʻshni kirishlar qisman ustma-ust tushadi. Tadqiqot bu tanlovdan maʼlumot miqdorini oshirish va kichik vaqt siljishlariga nisbatan barqarorroq namunalar yaratish uchun foydalanadi.
Oʻrta narx va kelajakdagi harakat sinflari
Eng yaxshi sotuv narxi \(p_t^{a1}\), eng yaxshi xarid narxi \(p_t^{b1}\) bilan ifodalanganda spread:
\[ s_t=p_t^{a1}-p_t^{b1} \]
va oʻrta narx:
\[ m_t=\frac{p_t^{a1}+p_t^{b1}}{2} \]
deb taʼriflanadi. Tadqiqotning maqsadi kelajakdagi narx darajasini toʻgʻridan-toʻgʻri regressiya orqali bashorat qilish emas, balki oʻrta narx yaqin kelajakda mazmunli tarzda pasayishi, oʻzgarmas qolishi yoki koʻtarilishini tasniflashdir.
Kirishlar standart z-ball bilan normallashtiriladi:
\[ \tilde{x}_i=\frac{x_i-\mu}{\sigma} \]
Manbada oʻqitish, validatsiya va test bo‘limlari o‘zlarining \(\mu\) va \(\sigma\) qiymatlari bilan alohida normallashtirilishi ko‘rsatilgan.
Triple Barrier Method bilan yorliq yaratish
Tadqiqot faqat kelajakdagi oʻrtacha narx oʻzgarishiga qarash oʻrniga Triple Barrier Method (TBM) dan foydalanadi. Joriy oʻrta narx \(m_t\) va nisbiy chegara \(\alpha\) uchun yuqori va quyi toʻsiqlar:
\[ u_t=m_t(1+\alpha) \]
\[ \ell_t=m_t(1-\alpha) \]
koʻrinishidadir. Manba tajribalarida \(\alpha=0.001\) va vaqt ufqi \(k=100\) tanlangan. Kelajakdagi narx qatori davomida avval yuqori toʻsiq buzilsa, yorliq \(+1\), avval quyi toʻsiq buzilsa \(−1\), vaqt toʻsigʻigacha ikkalasi ham buzilmasa \(0\) hosil qilinadi. Shunday qilib, yorliq faqat kelajakdagi narxning muayyan vaqtdagi qiymatiga emas, belgilangan ufq ichida qaysi narx toʻsigʻi avval sodir boʻlishiga bogʻliq.
Nega Ordinal Regressiya Ushbu HFT Muammosida Muhim?
Ordinal regressiya bu muammoda muhim, chunki −1, 0 va +1 sinflari tabiiy ravishda \(−1 \prec 0 \prec +1\) tartibiga ega va barcha tasniflash xatolari bir xil iqtisodiy yoʻnalishni ifodalamaydi. Haqiqiy sinf +1 boʻlganda 0 ni bashorat qilish bilan haqiqiy sinf +1 boʻlganda −1 ni bashorat qilish bir xil masofadagi xato emas; tadqiqot bu tuzilmani yoʻqotish funksiyasiga olib kirib, model xatolar ogʻirligini ham oʻrganishini maqsad qiladi.
Standart ko‘p sinfli cross-entropy toʻgʻri sinfga berilgan ehtimolni ragʻbatlantiradi, biroq notoʻgʻri sinflarning bir-biridan qanchalik uzoqligini bevosita ishlatmaydi. Manbada klassik cross-entropy:
\[ \mathcal{L}_{CE}=-\mathbf{y}^{T}\log(\mathbf{p}) \]
deb yoziladi. Bu yerda \(\mathbf{y}\) haqiqiy sinfning one-hot ifodasi, \(\mathbf{p}\) esa modelning sinf ehtimollaridir.
Tadqiqotda qoʻllanadigan Ordinal Log-Loss esa \(\mathbf{C}\) xarajat matritsasini qoʻshadi:
\[ \mathcal{L}_{OLL} =-\sum_{l\in\mathcal{L}}\log(1-p_l)c_{y,l}^{\alpha} \]
Manba tadqiqotida OLL uchun \(\alpha=1\) olinadi. Shunda ifoda:
\[ \mathcal{L}_{OLL} =-\mathbf{y}^{T}\mathbf{C}\log(\mathbf{1}-\mathbf{p}) \]
koʻrinishiga keltiriladi. Bu tenglamada \(c_{y,l}\), haqiqiy sinf \(y\) bo‘lganda \(l\) sinfiga yoʻnalgan ehtimol qanchalik ogʻir jazolanishini belgilaydi. Tadqiqotning muhim qismi aynan bu xarajatlar qanday hisoblanishiga qaratilgan.
Toʻrtta xarajat matritsasi yondashuvi
Tadqiqot toʻrtta usulni taqqoslaydi: Linear (L), SLACE (S), Mahalanobis (M) va Wasserstein (W). Barcha matritsalar faqat oʻqitish maʼlumotlaridan hisoblanadi va maʼlumot sizib chiqishining oldini olish uchun validatsiya yoki test maʼlumotlari xarajat matritsasini tuzishda ishlatilmaydi. Taqqoslashni osonlashtirish uchun har bir matritsa oʻzining eng katta elementiga boʻlinib, \([0,1]\) oraligʻiga masshtablanadi.
Linear usul faqat sinflar tartibiga asoslanadi:
\[ c_{i,j}=|i-j| \]
Bu yondashuv −1 bilan +1 oʻrtasidagi xatoni qoʻshni sinflar oʻrtasidagi xatoga qaraganda ogʻirroq jazolaydi; biroq sinflar maʼlumot taqsimotlari amalda qanchalik oʻxshashligini hisobga olmaydi.
SLACE asosidagi usulsinf chastotalaridan hosil qilingan proximity qiymatlaridan foydalanadi. Maʼlumotlar toʻplamidagi juda kuchli sinf nomutanosibligi sababli hosil boʻlgan xarajat matritsasi aniq asimmetrikdir. Tajribalar bu xususiyat, ayniqsa, neytral sinfga haddan tashqari yoʻnalish bilan bogʻliq boʻlishi mumkinligini ko‘rsatadi.
Mahalanobis yondashuvi\(40\times100\) oʻlchamli kirishni uzunligi \(4000\) boʻlgan vektorga aylantiradi va sinf vakillari oʻrtasidagi farqni maʼlumot kovariatsiyasi bilan masshtablaydi:
\[ c_{i,j} = \sqrt{(\bar{\mathbf v}_i-\bar{\mathbf v}_j)^T \mathbf{\Sigma}^{-1} (\bar{\mathbf v}_i-\bar{\mathbf v}_j)} \]
Bu yerda \(\mathbf{\Sigma}\) kirishlarning baholangan kovariatsiya matritsasidir. Manba matni \(\bar{\mathbf v}_j\) miqdorini tegishli sinfdagi kirishlar oʻrtachasi sifatida taʼriflaydi. Biroq manbaning Tenglama (5.12) sida ushbu oʻrtacha uchun namuna soniga boʻlish hadi ko‘rinmaydi; bu notatsiya farqi bu yerda jimgina tuzatilmagan.
Wasserstein Asosidagi Xarajat Matritsasi Qanday Tuziladi?
Wasserstein asosidagi xarajat matritsasi har bir sinfning LOB kirishlarini bir oʻlchovli Order Book Imbalance vakiliga aylantiradi, −1, 0 va +1 sinflari uchun alohida OBI taqsimotlarini tuzadi hamda sinflar orasidagi xarajatni ushbu taqsimotlarning Wasserstein-1 masofasi sifatida belgilaydi. Shu tariqa jazo faqat sinf indeksiga emas, sinflarning oʻqitish maʼlumotlaridagi statistik ajralishiga ham bogʻliq boʻladi.
Bir oʻlchovli ikki taqsimotning kumulyativ taqsimot funksiyalari \(U\) va \(V\) boʻlsa, Wasserstein-1 masofasi:
\[ W_1(u,v)=\int_{-\infty}^{+\infty}|U(x)-V(x)|\,dx \]
koʻrinishida ifodalanadi.
LOB kirishlari ko‘p oʻlchovli boʻlgani uchun tadqiqot avval narxlarni chiqarib tashlaydi va faqat xarid/sotuv hajmlaridan foydalanadi. Kirish xarid/sotuv yoʻnalishi, LOB darajasi va vaqt oʻqlarini oʻz ichiga olgan \(X_{ijk}\) tenzoriga aylantiriladi. Tadqiqotda taklif qilingan OBI akslantirish:
\[ \mathrm{OBI} = \sum_{i=1}^{2} \sum_{j=1}^{N} \sum_{k=1}^{W} (-1)^i\lambda^{j+k}X_{ijk} \]
koʻrinishidadir. \(\lambda\) chuqurroq LOB darajalari va eskiroq vaqt namunalarining taʼsirini eksponensial ravishda kamaytiradi. Tajribalarda \(\lambda=0.5\) ishlatilgan. Har bir yorliqning OBI qiymatlari alohida taqsimotni hosil qiladi va xarajat:
\[ c_{i,j}=W_1(u_i,u_j) \]
deb taʼriflanadi.
Manbaning 6-rasmida sinfga shartlangan OBI taqsimotlari ko‘rsatiladi. −1 va +1 sinflari OBI oʻqining turli yoʻnalishlariga siljigan paytda, neytral sinf 0 atrofida markazlashganroq va kengroq dumli taqsimotni ko‘rsatadi. Ushbu taqsimot tuzilmasi xarajat matritsasida qoʻshni sinflar orasidagi masofalar nega bir-biriga yaqin, ammo noldan mazmunli darajada farq qilishini tushuntirish uchun ishlatiladi.
QMTL Xulosa Chiqarish Xarajatini Oshirmasdan Qanday Ishlatilishi Mumkin?
QMTL oʻqitish vaqtida umumiy enkoderga bir xil maqsadni bashorat qiluvchi bir nechta chiqish boshini ulaydi; oʻqitish tugagach qoʻshimcha boshlar olib tashlanib, faqat bitta bosh ishlatilgani uchun joylashtirilgan modelning asosiy xulosa chiqarish arxitekturasi kattalashishi shart emas. Ushbu tadqiqotda QMTL ensemble sifatida ishlatilmaydi; maqsad ko‘p boshli oʻqitishning umumiy enkoderga bergan oʻqitish taʼsirini bitta boshli xulosa chiqarishga olib oʻtishdir.
QMTL da har bir bosh bir xil −1/0/+1 maqsadini bashorat qiladi. Manba oʻqitish oxirida bitta boshga oʻtishning turli variantlarini muhokama qiladi; tajribalarda eng sodda yondashuv tanlanadi va boshlarning bittasi tasodifiy saqlanadi. Bu tanlov, ayniqsa, kelgusi tadqiqotlar uchun ochiq rivojlantirish sohasi sifatida ko‘rsatilgan.
Bir nechta bosh yoʻqotishlarini muvozanatlash uchun Gradient Normalization (GradNorm) ishlatiladi. Umumiy ko‘p vazifali yoʻqotish:
\[ \mathcal{L}_{total}=\sum_{i=1}^{m}w_i\mathcal{L}_i \]
sifatida qaralishi mumkin. GradNorm vazifalarning nisbiy oʻrganish tezliklariga ko‘ra \(w_i\) vaznlarini oʻqitish vaqtida moslashni maqsad qiladi. Bu tadqiqotda vazifalarning maqsadlari bir xil boʻlsa ham, turli boshlarning oʻrganish tezliklari teng boʻlmagani sababli GradNorm tanlangan.
Sinovdan oʻtkazilgan uchta arxitektura
Baseline modelLOB kirishini qayta ishlaydigan toʻrtta konvolyutsion qatlam guruhi va uch sinfga chiqadigan toʻliq bogʻlangan qatlamga asoslanadi. QMTL moslashtirishida CNN qismi umumiy enkoder, oxirgi toʻliq bogʻlangan qism esa bosh sifatida ishlatiladi.
DeepLOBkonvolyutsion qatlamlarni inception tuzilmasi va LSTM bilan birlashtiradi. Tadqiqotda CNN va inception qismi umumiy tana, LSTM hamda oxirgi toʻliq bogʻlangan qism esa vazifa boshi sifatida ishlatiladi. Bu tanlov har bir boshga toʻgʻri keladigan hisoblash xarajatini oshirgani sababli QMTL ning oʻqitish vaqti DeepLOB da ancha sezilarli ortadi.
MLPLOBasosan toʻliq bogʻlangan qatlamlar hamda fazoviy/vaqt oʻqlari bo‘yicha navbatma-navbat ishlov beradigan MLP tuzilmasidan iborat. Oxirgi toʻliq bogʻlangan bloklar bosh, oldingi qism esa umumiy enkoder sifatida olinadi.
Tadqiqot Usuli va Natijalari
Maʼlumotlarni bo‘lish va sinf nomutanosibligi
Tadqiqot 2025 yil oktyabr maʼlumotlarini oʻqitish va validatsiya, 2025 yil noyabr maʼlumotlarini esa test uchun ishlatadi. Oktyabr maʼlumotlari ichkarida %80 oʻqitish va %20 validatsiyaga boʻlingan. Test qismining umumiy maʼlumotning taxminan yarmini tashkil etishi klassik mashinaviy oʻrganish tadqiqotlariga nisbatan noodatiy; manba buni maʼlumot hajmi juda katta ekani, asosiy toʻsiq esa oʻqitishdagi hisoblash xarajati ekanligi bilan izohlaydi.
| Boʻlim | LOB oniy tasviri | Model kirishi |
|---|---|---|
| Oʻqitish | 8.570.879 | 428.540 |
| Validatsiya | 2.142.720 | 107.132 |
| Test | 10.499.327 | 524.962 |
| Jami | 21.212.926 | 1.060.634 |
| Boʻlim | −1 | 0 | +1 |
|---|---|---|---|
| Oʻqitish | 5.400 (%1,3) | 417.869 (%97,5) | 5.271 (%1,2) |
| Validatsiya | 1.050 (%1,0) | 104.936 (%98,0) | 1.146 (%1,1) |
| Test | 5.932 (%1,1) | 513.518 (%97,8) | 5.512 (%1,0) |
Maʼlumotlarning taxminan %98 qismi 0 sinfida bo‘lishi xom aniqlikning o‘zi chalg‘ituvchi bo‘lishiga olib kelishi mumkin. Model barcha namunalarni 0 deb bashorat qilib juda yuqori accuracy olishi mumkin, ammo −1 va +1 yo‘nalish harakatlarini ajrata olish qobiliyatiga ega bo‘lmasligi mumkin. Shu sababli tadqiqot sinf vaznlaridan foydalanadi:
\[ w_i=\frac{N}{C\,n_i} \]
Bu yerda \(N\) umumiy namuna soni, \(C\) sinflar soni va \(n_i\) tegishli sinfdagi namunalar sonidir.
Baholash metrikalari
Accuracy, precision, recall va F1-score bilan birga Cohen's kappa va Restricted Accuracy (RA) ishlatiladi. Cohen's kappa:
\[ \kappa=\frac{p_o-p_e}{1-p_e} \]
ifodasi orqali kuzatilgan tasniflash mosligi faqat tasodif tufayli kutiladigan moslikdan qanchalik yuqori ekanini o‘lchaydi. Ayniqsa juda nomutanosib maʼlumotlar to‘plamida u faqat accuracy qiymatiga qaraganda tushuntiruvchanroq bo‘lishi mumkin.
Restricted Accuracy tadqiqot taʼrifiga ko‘ra, ayniqsa −1 va +1 yo‘nalish bashoratlari bir-biridan qanchalik to‘g‘ri ajratilishini kuzatish uchun ishlab chiqilgan. Manbadagi Tenglama (3.16) maxrajida bir xil \(n_{-1,+1}\) hadi ikki marta bosilgan ko‘rinadi. Shu sababli formula bu yerda manbada yo‘q tuzatish kiritilgan holda qayta yozilmagan; metrika muallifning matnli izohiga ko‘ra talqin qilingan.
Oʻqitish protokoli
- Uskuna: NVIDIA A40 GPU klasteri; har bir alohida modelni oʻqitish bitta GPU da.
- Optimizer: Adam.
- Learning rate: \(10^{-3}\).
- Weight decay: \(10^{-4}\).
- Early stopping: birlashtirilgan validatsiya yoʻqotishi bo‘yicha patience = 10.
- Test bosqichi: eng yaxshi validatsiya yoʻqotishiga ega checkpoint.
- QMTL test bashorati: boshlarning faqat bittasi va tadqiqotdagi tajriba protokolida tasodifiy tanlov.
- Xato chiziqlari: takroriy tajribalar o‘rtachasi uchun %95 ishonch oralig‘i.
- Baseline xarajat/bosh kombinatsiyalari: har bir kombinatsiya 100 takror.
- Ilgʻor arxitektura kombinatsiyalari: har bir kombinatsiya 40 takror.
Manbaning asosiy tajriba setup bo‘limida mini-batch o‘lchami va tasodifiylik seed-i ochiq ravishda berilmagan. Bu maʼlumotlar qayta ishlab chiqarish to‘liqligi nuqtai nazaridan manbada yetishmaydigan parametrlardir; bu yerda qiymat uydirilmagan.
Maʼlumotlardan olingan xarajat matritsalari
Quyidagi qiymatlar faqat oʻqitish maʼlumotlaridan hisoblangan va har bir matritsaning maksimal qiymati 1 bo‘ladigan qilib normallashtirilgan. Qatorlar haqiqiy sinfni, ustunlar esa xarajat qo‘llanadigan sinfni ko‘rsatadi.
| Haqiqiy \ Maqsad | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,500 | 1,000 |
| 0 | 0,500 | 0 | 0,500 |
| +1 | 1,000 | 0,500 | 0 |
| Haqiqiy \ Maqsad | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,138 | 1,000 |
| 0 | 0,860 | 0 | 0,865 |
| +1 | 0,995 | 0,137 | 0 |
| Haqiqiy \ Maqsad | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,796 | 1,000 |
| 0 | 0,796 | 0 | 0,921 |
| +1 | 1,000 | 0,921 | 0 |
| Haqiqiy \ Maqsad | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,639 | 1,000 |
| 0 | 0,639 | 0 | 0,625 |
| +1 | 1,000 | 0,625 | 0 |
Baseline tajribalarida yoʻqotish funksiyalarining xatti-harakati
Manbaning 7-rasmida 1 dan 5 gacha QMTL boshi bo‘lgan konfiguratsiyalar taqqoslanadi. Har bir bosh-yoʻqotish kombinatsiyasi 100 marta ishga tushirilgani uchun grafikdagi tendensiyalar bitta oʻqitish ishga tushirishiga emas, takrorlar oʻrtachasiga asoslanadi.
Wasserstein usuli F1-score va Cohen's kappa nuqtai nazaridan eng kuchli va eng izchil usuldir. Boshlar soni oshgani sari F1 qiymatida ham bosqichma-bosqich o‘sish kuzatiladi. Mahalanobis ayrim konfiguratsiyalarda yaqinlashsa-da, tajribalar orasida yuqoriroq variatsiyani ko‘rsatadi.
SLACE asosidagi usul esa muhim sinf nomutanosibligi muammosini yuzaga chiqaradi. Taxminan %98 accuracy berganiga qaramay, Cohen's kappa nolga yaqin, Restricted Accuracy esa nolga teng. Manbadagi bashorat tekshiruvi model amalda faqat 0 sinfini tanlashini ko‘rsatadi. Bu natija juda nomutanosib tasniflashda yuqori accuracy ning o‘zi nega ishonchli muvaffaqiyat mezoni emasligining aniq misolidir.
Linear usul bir boshli holatda past natija ko‘rsatsa-da, boshlar soni oshganda precision va Restricted Accuracy qiymatlarida sezilarli yaxshilanish beradi. Wasserstein usuli allaqachon kuchli bo‘lgan bir boshli natijalarini ko‘p boshli oʻqitishda nisbatan kamroq, ammo kuzatiladigan darajada yaxshilaydi.
Accuracy bo‘yicha usullar tartibi boshqa metrikalardan farq qiladi. Manba matnida SLACE va Linear taxminan %98, Wasserstein taxminan %87, Cross-Entropy va Mahalanobis esa taxminan %76 darajasida qayd etilgan. Bu farq yuqori accuracy asosan ustun 0 sinfini bashorat qilishdan kelib chiqishi mumkinligini va uni yo‘nalish harakatlarini ushlash muvaffaqiyati bilan birga baholash kerakligini ko‘rsatadi.
QMTL ning oʻqitish xarajati
Ko‘p boshli oʻqitish xulosa chiqarish xarajatiga ko‘chmasa-da, oʻqitish bepul emas. Manbaning 8-rasmi boshlar soni oshgani sari haqiqiy oʻqitish vaqti taxminan chiziqli ravishda ortishini ko‘rsatadi. Biroq ko‘plab konfiguratsiyalarda boshlar soni oshgani sari early stopping ga yetish uchun zarur epoch soni kamayadi. Muallif bu xatti-harakat tezroq yaqinlashish, ko‘p boshli oʻqitishning regularizatsiya taʼsiri yoki har ikki mexanizmning birikmasi bilan bog‘liq bo‘lishi mumkinligini muhokama qiladi; tadqiqot ushbu mexanizmlardan qaysi biri aniq sabab ekanini ko‘rsatmaydi.
DeepLOB va MLPLOB bilan ilgʻor arxitektura tajribalari
Hisoblash xarajatini cheklash uchun ilgʻor arxitekturalarda faqat standart Cross-Entropy (C) bilan eng muvaffaqiyatli xarajat yondashuvi bo‘lgan Wasserstein (W) taqqoslangan. Manbaning 9-rasmida Baseline, DeepLOB va MLPLOB uchun 1-5 bosh oralig‘ida jami 40 takror bo‘yicha natijalar berilgan.
Umumiy naqshda Wasserstein yoʻqotishi ayni arxitekturaning Cross-Entropy versiyasiga qaraganda metrikalarning ko‘pida yaxshiroq natija beradi. Eng sezilarli umumiy istisno recall bo‘lib, uchala arxitekturada ham Cross-Entropy recall bo‘yicha yuqoriroq qiymatlarga erishadi. DeepLOB uchun precision va Restricted Accuracy, Baseline uchun esa Restricted Accuracy ayrim konfiguratsiyalarda Wasserstein ning umumiy ustunligidan istisno bo‘ladi.
MLPLOB da Wasserstein bilan boshlar soni oshgani sari F1-score, Cohen's kappa va accuracy kabi ayrim metrikalar oshadi, Restricted Accuracy esa kamayadi. Manba buni allaqachon taxminan %98 ni tashkil etadigan neytral sinfni yaxshiroq tasniflash bilan kam uchraydigan ±1 sinflariga eʼtibor qaratish o‘rtasidagi ishlash almashinuvi bilan bog‘laydi.
DeepLOB da ayrim yo‘nalish-harakat metrikalari boshlar soni bilan yaxshilansa, accuracy va Cohen's kappa pasayishi mumkin. Demak, QMTL taʼsiri arxitektura va tanlangan metrikaga bog‘liq; tadqiqot “ko‘proq bosh har doim yaxshiroq” degan xulosani qo‘llab-quvvatlamaydi.
Modellararo taqqoslashda Baseline F1 va precision bo‘yicha kuchli; DeepLOB accuracy va Cohen's kappa bo‘yicha yuqori natija beradi; MLPLOB esa recall va ayniqsa Restricted Accuracy bo‘yicha kuchli. Shu sababli manba bitta arxitekturani barcha maqsadlar uchun ustun deb eʼlon qilmaydi.
Bu Natijalar Foydali HFT Strategiyasini Isbotlaydimi?
Yoʻq. Tadqiqot tarixiy BTC/USDT LOB maʼlumotlarida bozor yoʻnalishini tasniflash metrikalari va oʻqitish xatti-harakatini oʻlchaydi; sof foyda, tranzaksiya xarajatlari, bid-ask spread taʼsiri, slippage, buyurtma navbatidagi o‘rin, haqiqiy uchidan-uchigacha kechikish yoki jonli buyurtma ijrosi ko‘rsatkichlari tajribalarning asosiy chiqish o‘zgaruvchilari emas. Shu sababli yuqoriroq F1, kappa yoki Restricted Accuracy ni to‘g‘ridan-to‘g‘ri foydali HFT strategiyasi sifatida talqin qilib bo‘lmaydi.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- −1, 0 va +1 bozor yoʻnalishi vazifasi ordinal tuzilma sifatida modellashtirilishi mumkin.
- OLL ichidagi xarajat matritsasi dizayni model xatti-harakatini kuchli ravishda oʻzgartirishi mumkin.
- Ushbu maʼlumotlar to‘plamida Wasserstein asosidagi xarajat matritsasi ko‘rib chiqilgan muqobillar orasida umuman olganda eng izchil natijalarni beradi.
- QMTL ayrim yoʻqotish funksiyalari va arxitekturalarda bir boshli xulosa chiqarishdan oldingi oʻqitishni yaxshilashi mumkin.
- Ko‘p boshli oʻqitishdan so‘ng qo‘shimcha boshlarni olib tashlash, qo‘shimcha boshlarning hisoblash xarajati asosiy joylashtirish arxitekturasiga ko‘chishining oldini oladi.
- Kuchli sinf nomutanosibligi sababli accuracy ning o‘zi yetarli baholash metrikasi emas.
Tadqiqot qoʻllab-quvvatlamaydigan umumlashtirishlar
- Natijalarni barcha aksiya, valyuta yoki kripto bozorlariga avtomatik tarzda umumlashtirib bo‘lmaydi.
- Wasserstein xarajat matritsasi har bir maʼlumotlar to‘plamida Cross-Entropy dan ustun bo‘lishi ko‘rsatilmagan.
- Ko‘proq QMTL boshi har bir arxitektura va har bir metrikada ishlashni oshirishi ko‘rsatilmagan.
- Tasniflash samaradorligining oshishi haqiqiy savdo foydasi oshishini isbotlamaydi.
- Tadqiqot jonli HFT infratuzilmasida uchidan-uchigacha kechikish ustunligini tasdiqlamagan.
- Faqat BTC/USDT va ikki oylik davr o‘rganilgani sababli boshqa bozor rejimlari uchun alohida tekshiruv zarur.
Hisoblash xarajati va barqarorlik
Tezis model oʻqitishlarining energiya xarajatini ham oʻlchaydi. So‘nggi tajriba guruhida Baseline jami 150,44 soat oʻqitish va 16,55 kWh; DeepLOB 726,02 soat va 177,87 kWh; MLPLOB 27,7 soat va 5,54 kWh sarflagan. Uchalasi birgalikda 904,16 soat GPU oʻqitishi va 199,96 kWh energiya sarfini tashkil qilgan.
| Model | Jami oʻqitish vaqti | Oʻrtacha quvvat | Energiya |
|---|---|---|---|
| Baseline | 150,44 soat | 110 W | 16,55 kWh |
| DeepLOB | 726,02 soat | 245 W | 177,87 kWh |
| MLPLOB | 27,7 soat | 200 W | 5,54 kWh |
| Jami | 904,16 soat | - | 199,96 kWh |
Muallif ishlab chiqish davrida amalga oshirilgan qo‘shimcha oʻqitishlarni hisobga olish uchun jami model oʻqitish sarfini taxminan 399,92 kWh deb baholaydi. Ishlab chiqish kompyuterining taxminiy sarfi ham qo‘shilganda loyiha uchun taxminan 487,92 kWh hisoblanadi. Ushbu bo‘limning maqsadi xulosa chiqarishda kichik modeldan foydalanishning ehtimoliy energiya foydasi bilan murakkabroq oʻqitish tartiblarining qo‘shimcha oʻqitish xarajatini birgalikda baholash kerakligini ko‘rsatishdir.
Manba va Usul Haqida Izoh
Asl sarlavha: Distance-based Loss functions for High-Frequency Trading
Muallif: Jonathan Rodríguez Barja
Tezis rahbari: Daniel P. Palomar
Mahalliy tutor: Jordi Castro
Muassasalar: Universitat Politècnica de Catalunya - BarcelonaTech (UPC); tadqiqot HKUST da amalga oshirilgan. Hujjat Centre de Formació Interdisciplinària Superior (CFIS) doirasidagi Data Science & Engineering / Engineering Physics qoʻsh bakalavriat dasturiga tegishli.
Manba turi: Bakalavriat bitiruv tezisi / Bachelor thesis / Treball Final de Grau.
Sana: PDF muqova sanasi fevral 2026; rasmiy repository roʻyxatga olish sanasi 26 fevral 2026.
Platforma: UPCommons, Universitat Politècnica de Catalunya ning institutsional akademik arxivi.
Doimiy yozuv identifikatori: 2117/457644.
DOI: Manbada va rasmiy repository yozuvida DOI ko‘rsatilmagan.
Jurnal / jild / son: Qoʻllanilmaydi; tadqiqot jurnal maqolasi emas.
Taqriz holati: Taqrizdan o‘tgan jurnal maqolasi emas. Universitet bakalavriat bitiruv ishidir.
Kirish va litsenziya: Rasmiy repository yozuvi ochiq kirishni taʼminlaydi va asarni CC BY-NC-ND 4.0 litsenziyasi ostida ko‘rsatadi. NoDerivatives sharti tufayli Verianla matni manba matnining tarjimasi yoki yaqin qayta yozilishi sifatida yaratilmagan; manba rasmlari o‘zgartirilib yoki qayta stilizatsiya qilinib ishlatilmagan. Ilmiy usul, tekshiriladigan sonlar, tenglamalar va natijalar mustaqil tushuntiruvchi bayon bilan qayta tuzilgan.
Maʼlumot manbai: CryptoHFTData orqali Binance BTC/USDT LOB maʼlumotlari. Tadqiqotda ishlatilgan sana oralig‘i 1 oktyabr-30 noyabr 2025.
Dasturiy taʼminot va ishlab chiqish: Tadqiqot LibMTL asosidagi freymvorkni moslashtirgan; QMTL, early stopping va Weights & Biases bilan logging kabi komponentlarni qo‘shgan. Manbada alohida kod mavjudligi yoki kod litsenziyasi bayonoti berilmagan.
Moliyalashtirish: Manbada standart shakldagi alohida moliyalashtirish bayonoti yoʻq. Minnatdorchilik bo‘limida CFIS yordami qayd etilgan; bu ifoda tadqiqot fondi yoki loyiha granti sifatida qayta talqin qilinmagan.
Manfaatlar toʻqnashuvi: Manbada alohida manfaatlar toʻqnashuvi bayonoti aniqlanmagan.
Asosiy uslubiy cheklovlar: Bitta aktiv va bitta birja; faqat ikki oylik tarixiy davr; taxminan %98 neytral sinfni o‘z ichiga olgan kuchli sinf nomutanosibligi; haqiqiy savdo foydaliligi o‘rniga tasniflash metrikalari; QMTL da xulosa chiqarish boshining tasodifiy tanlanishi; Wasserstein xarajatining ilovaga xos OBI akslantirishiga bog‘liqligi; mini-batch o‘lchami va random seed kabi ayrim oʻqitish tafsilotlarining ochiq hisobot qilinmaganligi.
Manba ichidagi notatsiya ogohlantirishi 1: Tenglama (3.16) dagi Restricted Accuracy maxrajida bir cross-classification hadi takrorlangan ko‘rinadi. Verianla bu ifodani jimgina tuzatmagan.
Manba ichidagi notatsiya ogohlantirishi 2: Tenglama (5.12) matnda sinf o‘rtachasi sifatida tushuntirilgan \(\bar{\mathbf v}_j\) uchun yig‘indi ifodasini beradi, ammo ko‘rinadigan formulada sinf namunalari soniga bo‘lish hadi yo‘q. Mahalanobis usuli bayonida bu farq alohida saqlangan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan