

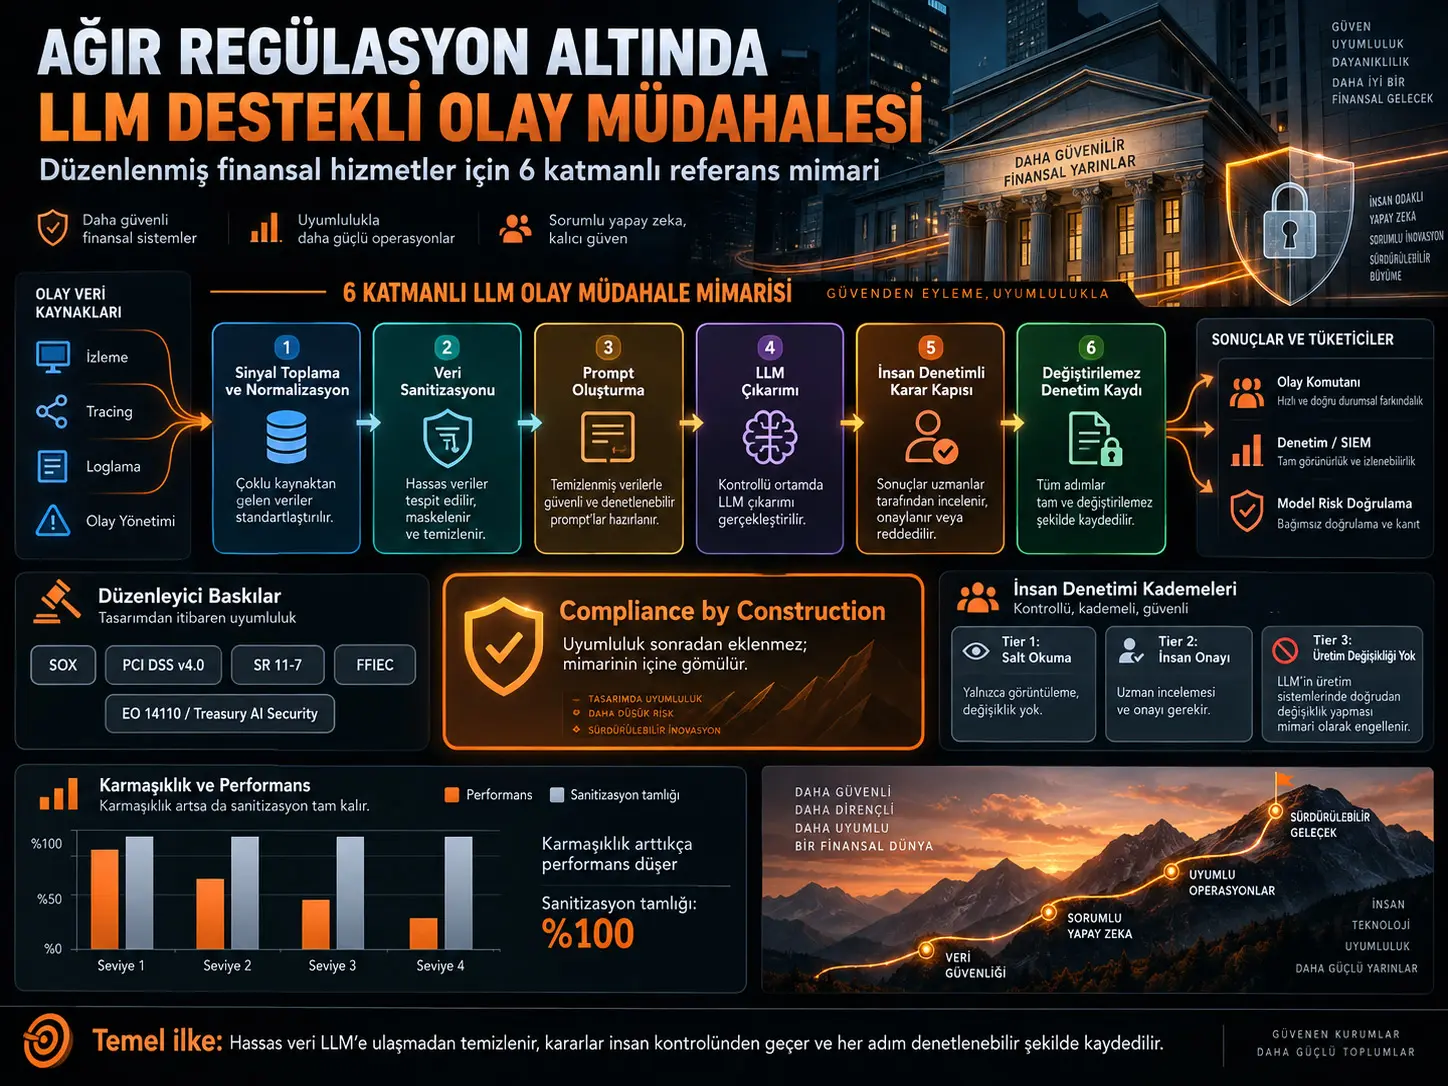
Bu çalışma, büyük dil modellerinin finansal hizmetlerde olay müdahalesi ve kök neden analizi için kullanılmasını, klasik teknoloji şirketlerinden farklı olarak yoğun düzenleyici gereksinimler altında ele alan bir referans mimari önermektedir. Yazarın temel iddiası, bankaların Google, Microsoft veya diğer teknoloji şirketlerinde kullanılan LLM destekli operasyon modellerini doğrudan kopyalayamayacağıdır; çünkü SOX, PCI DSS v4.0, SR 11-7, FFIEC ve AI odaklı siber güvenlik rehberleri birlikte değerlendirildiğinde veri akışı, prompt değişiklikleri, model doğrulaması, üçüncü taraf kullanımı, audit trail ve insan denetimi üzerinde yapısal kısıtlar ortaya çıkmaktadır.
Makalenin merkezinde compliance by construction — uyumluluğun tasarım yoluyla sağlanması ilkesi yer almaktadır. Buna göre uyumluluk, üretim sonrasında kontrol edilen bir prosedür değil, sistemin içinden geçilmesi zorunlu katmanlarının kendisidir. Hassas verilerin LLM’e ulaşmasını önleyen zorunlu sanitizasyon, versiyonlanmış prompt yönetimi, sağlayıcıdan bağımsız inference katmanı, insan onayı gerektiren karar kapısı ve değiştirilemez audit trail birlikte çalışmaktadır.
Çalışma ayrıca üretim verisi paylaşmadan gerçekleştirilebilecek sentetik bir değerlendirme yöntemi sunmaktadır. Sonuçlar, düşük karmaşıklıktaki olaylarda yüksek performans bildirilirken olay belirsizliği ve karmaşıklığı arttıkça sınıflandırma doğruluğu ve root-cause performansının düştüğünü, hallüsinasyon oranlarının arttığını göstermektedir. Sanitizasyon tamlığı bütün sentetik test seviyelerinde %100 raporlanmıştır. Bu sonuçlar bağımsız bir endüstri benchmark'ı değil, çalışmada tanımlanan referans sistemin sentetik değerlendirmesidir.
Compliance by Construction Nedir?
Compliance by construction, düzenleyici zorunlulukların sistem tamamlandıktan sonra eklenen politika veya kontrol noktaları olarak değil, veri ve karar akışının zorunlu mimari katmanları olarak tasarlanması yaklaşımıdır; böylece belirli uyumsuz davranışlar yalnız yasaklanmaz, teknik olarak gerçekleştirilemez hâle getirilir.
Çalışmanın temel farkı buradadır. Geleneksel yaklaşımda sistem çalışır, ardından compliance ekipleri neyin izinli olup olmadığını kontrol eder. Bu mimaride ise veri, regülasyon gereği geçmesi gereken kapılardan fiziksel olarak geçmeden LLM’e ulaşamaz.
Benzer biçimde üretim durumunu değiştirecek eylemler için sadece “model bunu yapmamalı” şeklinde prompt kuralı yoktur. Sisteme bu işlemleri yapabilecek credential, tool binding veya execution path hiç verilmez.
Böylece bazı kontroller davranışsal değil yapısal hâle gelir.
Bankalarda LLM Destekli Incident Response Neden Farklıdır?
Bankalardaki LLM destekli olay müdahalesi; üretim loglarının hassas finansal veri içerebilmesi, prompt değişikliklerinin kontrollü değişiklik süreçlerine tabi olması, modellerin bağımsız doğrulama gerektirmesi, üçüncü taraf sağlayıcı riskinin yönetilmesi ve AI hizmeti kullanılamadığında operasyonun insanlarla devam edebilmesi zorunlulukları nedeniyle genel teknoloji şirketlerindeki uygulamalardan daha sıkı mimari sınırlar gerektirir.
SOX: Prompt da kontrollü değişikliktir
Kaynak, finansal raporlamayı etkileyebilecek sistemlerde kullanılan prompt şablonlarının sıradan metin değil, kontrollü üretim konfigürasyonu gibi ele alınması gerektiğini savunmaktadır.
Bu yaklaşımda:
- Her prompt sürümü kayıt altına alınır.
- Onay mekanizmasından geçer.
- Üretim dışı ortamda test edilir.
- Rollback planı bulunur.
- LLM etkileşimleri uzun süreli audit kayıtlarına girer.
PCI DSS: Telemetri hassas veri taşıyabilir
Kaynağa göre ödeme sistemlerinin logları PAN, CVV, authentication token, hesap numarası ve benzeri hassas içerik barındırabilir.
Bu nedenle LLM katmanından önce bağımsız bir sanitizasyon sınırı gerekir.
Kaynak buradaki hedefi “hassas veriyi azaltmak” değil, yetkisiz inference katmanına sıfır hassas veri geçirmek olarak tanımlamaktadır.
SR 11-7: LLM model risk yönetimine girebilir
Yazar, incident classification veya root-cause analysis yapan LLM’in model risk yönetimi kapsamında değerlendirilmesi gerektiğini savunmaktadır.
Bunun sonuçları:
- Teorik temel ve sınırlılıkların belgelenmesi.
- Hallüsinasyon davranışlarının tanımlanması.
- Bağımsız validation.
- Model inventory kaydı.
- Risk tiering.
- Sürekli performans monitoring.
FFIEC: Sistem LLM olmadan da çalışmalıdır
Kaynak, LLM’in olay müdahalesi için bir iyileştirici araç olması gerektiğini, operasyonun bağımlılık noktası olmaması gerektiğini savunmaktadır.
LLM API erişimi kesildiğinde veya model davranışı bozulduğunda sistem insan-only mode’a geçebilmelidir.
Prompt injection neden doğrudan güvenlik sorunudur?
Olay verisinin kendisinin saldırgan tarafından manipüle edilmiş olabileceği varsayılmaktadır.
Örneğin saldırgan, triage sistemine gireceğini bildiği bir hata mesajına AI’ya yönelik gizli talimat ekleyebilir.
Bu nedenle input validation, output sandboxing ve adversarial test, makalede opsiyonel iyileştirme değil launch requirement olarak ele alınmaktadır.
Çalışmanın Yöntemi ve Bulguları
Altı katmanlı referans mimari
Kaynağın 5. sayfasındaki Şekil 1, sistemi altı ana katmana ayırmaktadır:
- Signal Ingestion & Normalization
- Data Sanitization Pipeline
- Prompt Construction
- LLM Inference
- Human-in-the-Loop Decision Gate
- Audit Trail
Altı Katmanlı Mimari Nasıl Çalışır?
Mimari; monitoring, tracing, logging ve incident-management kaynaklarından gelen sinyalleri normalize ederek başlar, hassas bilgileri sanitizasyon katmanında kaldırır, yalnız temizlenmiş bağlamla prompt oluşturur, sağlayıcıdan bağımsız LLM inference çalıştırır, sonucu insan-denetimli karar kapısından geçirir ve bütün süreci değiştirilemez audit kaydına yazar.
1. Signal Ingestion & Normalization
Alert, metric, trace ve log verileri ortak bir incident-context nesnesine dönüştürülür.
Bu katmanda:
- Deduplication
- Signal correlation
- Initial severity scoring
gerçekleştirilir.
2. Data Sanitization Pipeline
Kaynak bu katmanı sistemin uyumluluk açısından en kritik bölümü olarak tanımlamaktadır.
| Aşama | İşlev |
|---|---|
| 1. Regex + Luhn | PAN, SSN, routing number ve token gibi yapılandırılmış hassas verileri yakalar. |
| 2. NER | Ad, adres ve serbest metindeki diğer PII unsurlarını tespit eder. |
| 3. Domain Rules | Kuruma özgü hesap numarası, session token veya internal-ID formatlarını yakalar. |
| 4. Conservative Fallback | Güvenli olduğu kesin belirlenemeyen içeriği typed placeholder ile redakte eder. |
Örnek placeholder:
[REDACTED:PAN]
Bu yaklaşım LLM’e semantik olarak “burada kart numarası vardı” bilgisini korurken gerçek değeri göndermez.
3. Prompt Construction
Kaynak prompt mimarisini üç parçaya ayırmaktadır:
- System prompt: Rol, sınırlar ve çıktı formatı.
- Dynamic context: Sanitized incident verisi ve geçmiş olaylar.
- Task instruction: Classify, diagnose veya recommend gibi görevler.
RAG corpus’una yalnız root cause’u post-incident review ile doğrulanmış olayların alınması önerilmektedir.
Amaç, yanlış teşhis edilmiş eski vakaların yeni model önerilerini kirletmesini önlemektir.
4. LLM Inference
Model sağlayıcısı provider-independent API arkasında soyutlanmaktadır.
Bunun gerekçeleri:
- Vendor concentration risk.
- Model değiştirebilme.
- Shadow A/B testing.
- Farklı incident türlerini farklı modellere yönlendirebilme.
Beklenen schema’ya uymayan çıktı human-only fallback’i tetikler.
5. Human-in-the-Loop Decision Gate
Kaynak üç ayrı autonomy tier önermektedir:
| Tier | İzin verilen davranış |
|---|---|
| Tier 1 | Read-only diagnostic toplama ve monitor sorgulama; otonom çalışabilir. |
| Tier 2 | Severity classification veya routing önerisi; insan onayı gerekir. |
| Tier 3 | Production state değiştiren işlemler; teknik olarak mümkün değildir. |
Tier 3’te yalnız politika yasağı yoktur. Tool binding, credential ve execution path bulunmaz.
Bu nedenle başarılı bir prompt injection dahi üretim durumunu değiştirecek işlem yaptıramaz.
6. Audit Trail
Her etkileşim için aşağıdaki alanlar saklanmaktadır:
- Sanitizasyon sonrası input context
- Tam prompt
- Model response
- Confidence score
- İnsan kararı
- Nihai incident sonucu
Depolama append-only ve kriptografik bütünlük kontrolüne sahip olarak tasarlanmıştır.
Progressive Trust Nedir?
Progressive trust, LLM destekli olay müdahalesini doğrudan aktif üretim kararlarına bağlamak yerine önce shadow mode, sonra advisory mode ve en son standart iş akışına entegrasyon olmak üzere aşamalı biçimde devreye alma yaklaşımıdır.
Shadow mode
Model bütün incident’ları insanlarla paralel işler fakat çıktıları operasyon ekibine gösterilmez.
Kaynakta shadow run yaklaşık dokuz hafta sürmüştür.
Advisory mode
Öneriler görünür hâle gelir fakat bağlayıcı değildir.
Operatör:
- Kabul edebilir.
- Değiştirebilir.
- Reddedebilir.
Integrated mode
Araç standart workflow’un parçasına dönüşür ancak Tier 2 ve Tier 3 sınırları korunur.
Sentetik Benchmark Nasıl Kurulmuştur?
Çalışma, üretim bankacılık verisini yayımlamadan değerlendirme yapabilmek için kamuya açık banka kesintileri, ödeme sağlayıcılarının post-mortem'ları ve dağıtık sistem arıza örüntülerinden türetilmiş sentetik incident senaryolarını dört karmaşıklık düzeyinde sınıflandırmaktadır.
| Seviye | Örüntü | Zorluk |
|---|---|---|
| 1 | Tek sinyal, bilinen failure mode | Düşük |
| 2 | Çoklu ilişkili sinyaller, bilinen pattern | Orta |
| 3 | Çoklu sinyal, yeni kombinasyon | Yüksek |
| 4 | Belirsiz sinyaller, birden fazla olası neden | Çok yüksek |
LLM Performansı Karmaşıklık Arttıkça Nasıl Değişti?
Kaynağın sentetik değerlendirmesinde olay karmaşıklığı arttıkça sınıflandırma, root-cause ve remediation performansı düzenli biçimde düşerken hallüsinasyon oranları yükselmiş; ayrı ve yapısal sanitizasyon katmanı ise bütün karmaşıklık seviyelerinde %100 tamlık göstermiştir.
| Metrik | Level 1 | Level 2 | Level 3 | Level 4 |
|---|---|---|---|---|
| Classification accuracy | %92–97 | %85–92 | %72–83 | %58–70 |
| Root cause in top-3 | %95–98 | %88–94 | %70–82 | %52–65 |
| Appropriate remediation | %94–98 | %86–93 | %74–85 | %60–72 |
| Hallucination rate | <%2 | %2–5 | %5–10 | %8–15 |
| Sanitization completeness | %100 | %100 | %100 | %100 |
Yazar, Level 3 ve Level 4 olaylarda aracın rolünü “doğru cevabı verme”den çok araştırmacının arama alanını daraltan bir başlangıç noktası üretmek olarak tanımlamaktadır.
Compliance validation sonuçları
| Kısıt | Test | Sonuç |
|---|---|---|
| Change control | Tüm prompt değişikliklerinde audit record üretimi | Pass |
| Audit completeness | Gerekli alanların tüm etkileşimlerde dolu olması | Pass |
| Sanitization | Sentetik CHD enjeksiyonu; inference layer'a %0 geçiş | Pass |
| Fallback | LLM devre dışıyken human-only moda geçiş | Pass |
| Scope enforcement | Tier 3 işlem yaptırmaya çalışan prompt injection | Pass |
Bu sonuçlar kaynak yazarının tanımladığı sistem ve test düzenine aittir.
Sınırlılıklar ve Uygulama Çıkarımları
Mimari Neden Sanitizasyona LLM'den Daha Fazla Önem Veriyor?
Kaynağın yaklaşımında yanlış bir LLM önerisi insan denetimiyle durdurulabilirken hassas finansal verinin yetkisiz bir inference sağlayıcısına sızması doğrudan uyumluluk ihlali doğurabileceği için sanitizasyon katmanı, LLM entegrasyonundan bile daha yüksek test önceliğine sahip olmalıdır.
Yazar, ekiplerin sanitizasyon katmanına orantısız ölçüde yatırım yapmasını önermektedir.
Sanitizasyonun bedeli
Muhafazakâr sanitizasyon, bazı teşhis bilgilerini kaybettirir.
Bazen redakte edilen değer root cause’u daha hızlı bulmayı sağlayabilecek kritik sinyal olabilir.
Kaynak, bu nedenle privacy ile diagnostic utility arasında çözülmemiş bir gerilim bulunduğunu kabul etmektedir.
Bu Sistem İnsan Incident Commander'ın Yerini Alıyor mu?
Hayır. Çalışmanın mimarisinde LLM özellikle yüksek karmaşıklık seviyelerinde karar verici değil, hipotez üreten ve arama alanını daraltan yardımcıdır; üretim durumunu değiştiren Tier 3 eylemleri sistem tarafından gerçekleştirilemez.
Bu nedenle insan accountability mimarinin merkezinde kalmaktadır.
Prompt governance
Kaynakta önerilen prompt ilkeleri şunlardır:
- Model eksik bağlam varsa bunu açıkça söylemelidir.
- Yetersiz bilgiyle tahmin üretmek yerine hangi ek verinin gerektiğini belirtmelidir.
- Her öneri ilgili log, metric veya historical incident ID ile kanıtlanmalıdır.
- Out-of-scope sistemlere yönelik öneriler otomatik flag edilmelidir.
Auditor için tasarım
Makale sistemin iki ayrı kullanıcı grubu olduğunu vurgulamaktadır:
- Gece 03.00'te hızlı öneri isteyen incident commander.
- Aylar sonra belirli kararın neden verildiğini soran auditor.
Bu nedenle audit interface, debug logunun sonradan güzelleştirilmiş versiyonu olmamalı; en baştan ayrı bir ürün yüzeyi gibi tasarlanmalıdır.
Bu Mimari Bankacılık Dışında Kullanılabilir mi?
Kaynağa göre temel ilke diğer yüksek düzenlemeli sektörlere aktarılabilir; ancak hassas veri türleri, değişiklik yönetimi ve denetim gereksinimlerine göre katmanların ayrıntıları değişmelidir.
Örnek olarak:
- Sağlık: HIPAA ve PHI sanitizasyonu.
- Enerji: NERC CIP değişiklik yönetimi.
- Kamu: FedRAMP, FISMA ve veri egemenliği.
- AB yüksek riskli AI sistemleri: AI Act ile örtüşen yönetişim ihtiyaçları.
Çalışmanın desteklediği sonuçlar
- Düzenleyici gereksinimler LLM sistem mimarisini temel düzeyde değiştirebilir.
- Sanitizasyon inference'dan bağımsız bir katman olarak kurulabilir.
- Tier 3 işlemlerin teknik olarak imkânsız olması prompt tabanlı yasağa göre daha güçlü kontroldür.
- Shadow mode, validation için önemli kanıt üretir.
- Model-provider abstraction concentration riskini azaltabilir.
- Audit trail hem compliance hem post-incident review için değerlidir.
- Karmaşık incident’larda LLM performansı düşse bile hipotez daraltma değeri sağlayabilir.
Çalışmanın desteklemediği sonuçlar
- LLM'in incident response'u tamamen otomatikleştirmesi önerilmemektedir.
- Sentetik benchmark sonuçları bütün bankalara veya bütün LLM'lere otomatik olarak genellenemez.
- %100 sanitization sonucu gerçek dünyada hiçbir veri kaçağı olmayacağının evrensel garantisi değildir.
- Tier 3 otonomisinin bugün güvenli olduğu savunulmamaktadır.
- Regülasyonların gelecekte değişmeden kalacağı varsayılmamaktadır.
- Üretim verisindeki accuracy kaybı bu çalışma tarafından doğrudan ölçülmemiştir.
Açık problemler
Kaynak üç önemli problemi çözülmemiş bırakmaktadır:
- Sanitizasyonun teşhis doğruluğunda ne kadar bilgi kaybettirdiği.
- Production-modifying AI eylemlerinin ne zaman güvenli biçimde genişletilebileceği.
- Geleneksel Model Risk Management çerçevelerinin non-deterministic ve emergent LLM sistemlerine nasıl uyarlanacağı.
Kaynak ve Yöntem Notu
Özgün başlık: A Reference Architecture for LLM-Powered Incident Response in Regulated Financial Services
Yazar: Ganesh Kutty Murugan
E-posta: ganesh6776@gmail.com
Çalışma türü: Referans mimari, uygulayıcı deneyimi ve sentetik değerlendirme.
Yayın tarihi: PDF içinde açık biçimde belirtilmemiştir.
DOI: Kaynak PDF’de verilmemiştir.
Dergi / yayınevi / cilt / sayı: Kaynakta belirtilmemiştir.
Hakemlik durumu: PDF içinde hakemli yayın bilgisi bulunmamaktadır.
Temel düzenleyici kaynaklar: SOX/PCAOB AS 2201, PCI DSS v4.0.1, OCC Bulletin 2011-12 / Federal Reserve SR 11-7, FFIEC IT Examination Handbook, U.S. Treasury AI cybersecurity guidance, EO 14110 ve NIST AI RMF.
Temel teknik kaynaklar: Microsoft/EuroSys root-cause çalışması, Google SRE AI-assisted incident-management materyali, log-anomaly literatürü, SRE kitapları ve AIOps kaynakları.
Değerlendirme yöntemi: Kamuya açık banking outage kayıtları, payment-processor post-mortem'ları ve sentetik distributed-system failure pattern'larından dört zorluk seviyeli incident corpus'u.
Değerlendirilen model: Kaynak, erken 2025 döneminde “current-generation commercial LLM” ifadesini kullanmakta ancak model adını açıklamamaktadır.
Kaynakta belirtilen uygulama deneyimi: Yaklaşık dokuz haftalık shadow mode; ilk fikirden shadow validation sonuna yaklaşık 14 aylık geliştirme süreci.
Temel yorum sınırı: Bu sonuçlar yazarın mimari deneyimi ve sentetik test düzenine dayanmaktadır. Üretim bankacılık verileri yayımlanmamış, bağımsız kurumlar arası replikasyon sunulmamıştır.
Yazar hakkında: Kaynak, Ganesh Kutty Murugan’ın 17 yıllık üretim altyapısı ve dağıtık sistem deneyimine sahip Principal Site Reliability Engineer olduğunu ve M.S. Software Engineering derecesini BITS Pilani’den aldığını belirtmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir