

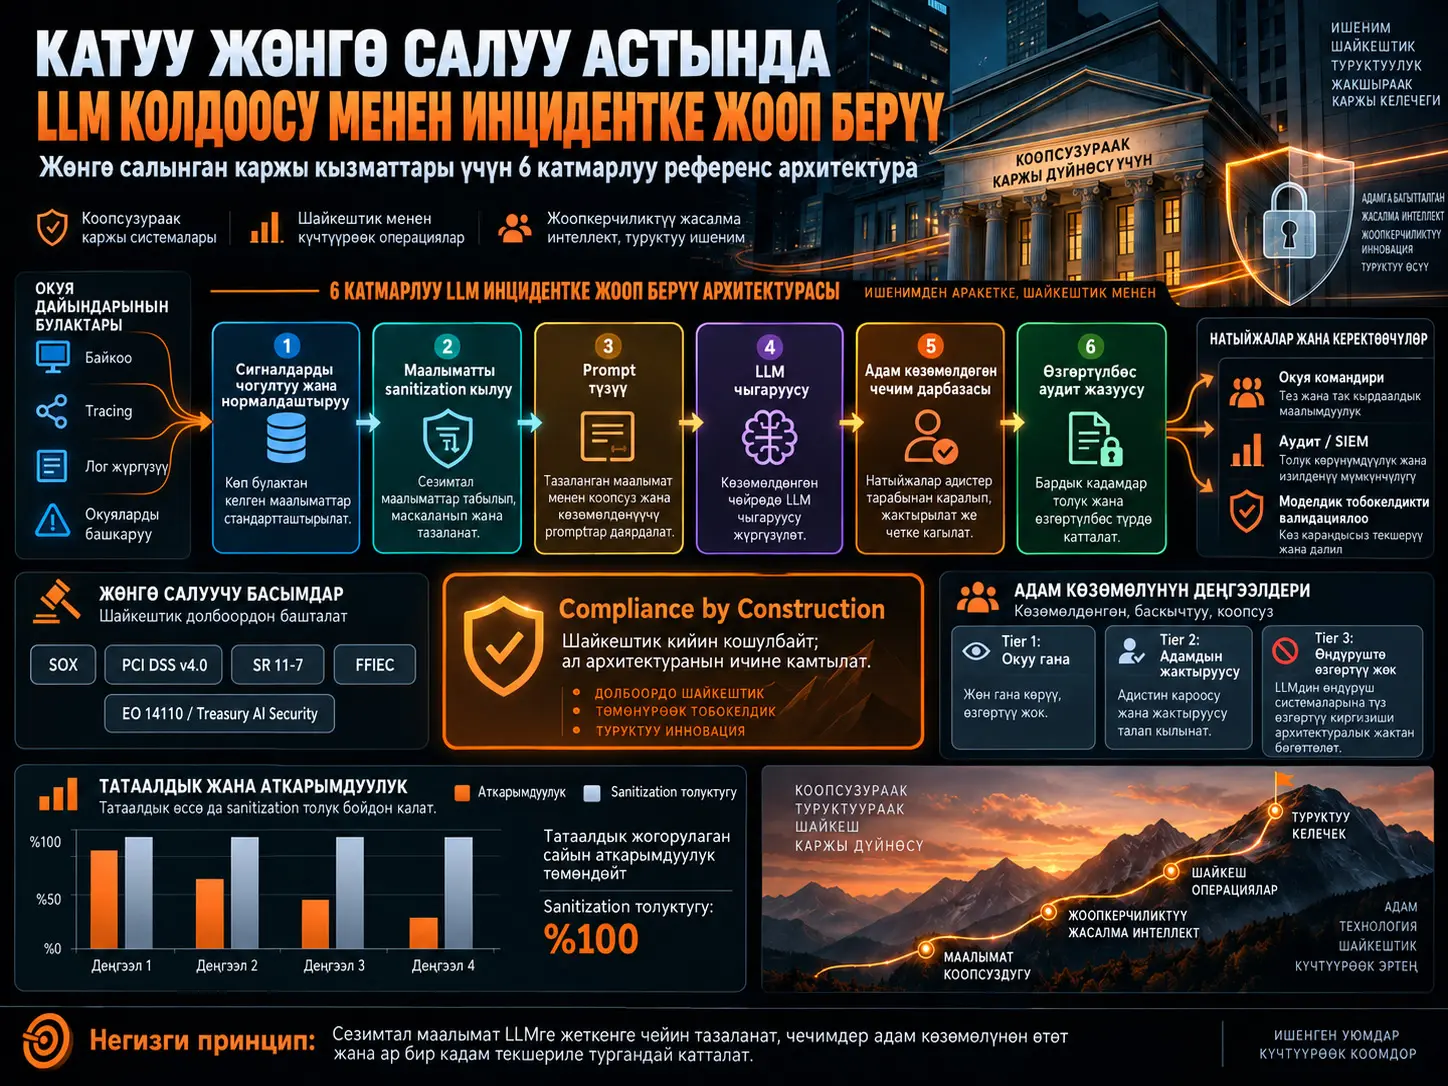
Бул иш чоң тил моделдерин каржы кызматтарында инциденттерге жооп берүү жана түпкү себепти талдоо үчүн колдонууну, кадимки технологиялык компаниялардан айырмаланып, жогорку жөнгө салуучу талаптардын шартында караган референс архитектурасын сунуштайт. Автордун негизги жүйөсү банктар Google, Microsoft же башка технологиялык компанияларда колдонулган LLM колдоочу операциялык моделдерди түз көчүрө албайт деген ойго негизделет; анткени SOX, PCI DSS v4.0, SR 11-7, FFIEC жана AI багытындагы киберкоопсуздук көрсөтмөлөрү чогуу каралганда маалымат агымына, prompt өзгөртүүлөрүнө, моделди валидациялоого, үчүнчү тарапты колдонууга, audit trail жана адамдык көзөмөлгө структуралык чектөөлөр жаралат.
Макаланын борборунда compliance by construction — шайкештикти долбоордун өзүндө камсыз кылуу принциби турат. Бул жерде compliance өндүрүштөн кийин текшерилүүчү процедура эмес, системанын сөзсүз өтүлө турган архитектуралык катмарларынын өзү болуп эсептелет. Сезимтал маалыматтын LLMге жетишине бөгөт койгон милдеттүү sanitization, версияланган prompt башкаруу, провайдерден көз каранды эмес inference катмары, адамдын жактыруусун талап кылган чечим дарбазасы жана өзгөртүлбөй турган audit trail бирге иштейт.
Иш ошондой эле өндүрүш маалыматтарын бөлүшпөстөн жүргүзүлө турган синтетикалык баалоо ыкмасын сунуштайт. Натыйжалар төмөн татаалдыктагы окуяларда жогорку көрсөткүчтөр болгонун, бирок окуянын белгисиздиги жана татаалдыгы өскөн сайын классификациянын тактыгы жана root-cause көрсөткүчү төмөндөп, hallüsinasyon көрсөткүчтөрү өскөнүн көрсөтөт. Sanitization completeness бардык синтетикалык тест деңгээлдеринде %100 деп билдирилген. Бул жыйынтыктар көз карандысыз тармактык benchmark эмес, иште аныкталган референс системанын синтетикалык баалоосу.
Compliance by Construction Деген Эмне?
Compliance by construction — жөнгө салуучу талаптарды система бүткөндөн кийин кошулган саясат же контрол пункттары катары эмес, маалымат жана чечим агымы сөзсүз өтө турган архитектуралык катмарлар катары долбоорлоо ыкмасы; мунун натыйжасында айрым шайкеш эмес аракеттер жөн гана тыюу салынбастан, техникалык жактан мүмкүн болбой калат.
Иштин негизги айырмасы ушунда. Салттуу ыкмада система иштеп турат, андан кийин compliance топтору эмнеге уруксат берилерин текшерет. Бул архитектурада болсо маалымат регуляция боюнча өтүүгө тийиш болгон дарбазалардан физикалык жактан өтмөйүнчө LLMге жетпейт.
Ошондой эле өндүрүш абалын өзгөртө турган аракеттер үчүн “модель муну жасабашы керек” деген prompt эрежеси гана жок. Системага мындай аракеттерди аткарууга мүмкүндүк бере турган credential, tool binding же execution path таптакыр берилбейт.
Ошентип айрым контролдор жүрүм-турумдук эмес, структуралык болуп калат.
Банктарда LLM Колдоочу Incident Response Эмне Үчүн Өзгөчө?
Банктардагы LLM колдоочу инцидентке жооп берүү; өндүрүш logдорунда сезимтал каржы маалыматы болушу мүмкүн болгондуктан, prompt өзгөрүүлөрү көзөмөлдөнгөн өзгөртүү процессине баш ийиши керек болгондуктан, моделдер көз карандысыз validation талап кылгандыктан, үчүнчү тарап провайдеринин тобокелдиги башкарылышы керек болгондуктан жана AI кызматы жеткиликсиз болгондо операция адамдар менен уланууга тийиш болгондуктан жалпы технологиялык компанияларга караганда кыйла катуу архитектуралык чек талап кылат.
SOX: Prompt да көзөмөлдөнгөн өзгөртүү
Булак каржылык отчеттуулукка таасир бере турган системаларда колдонулган prompt шаблондорун кадимки текст эмес, көзөмөлдөнгөн өндүрүш конфигурациясы катары кароо керек деп эсептейт.
Бул ыкмада:
- Ар бир prompt версиясы катталат.
- Жактыруу механизминен өтөт.
- Өндүрүштөн тышкаркы чөйрөдө тесттен өтөт.
- Rollback планы болот.
- LLM өз ара аракеттери узак мөөнөттүү audit жазууларына киргизилет.
PCI DSS: Телеметрия сезимтал маалымат ташышы мүмкүн
Булакка ылайык төлөм системаларынын logдору PAN, CVV, authentication token, эсеп номери жана ушуга окшогон сезимтал мазмунду камтышы мүмкүн.
Ошондуктан LLM катмарына чейин көз карандысыз sanitization чек арасы керек.
Бул жерде максат “сезимтал маалыматты азайтуу” эмес, уруксатсыз inference катмарына нөл сезимтал маалымат өткөрүү деп аныкталат.
SR 11-7: LLM model risk management чөйрөсүнө кириши мүмкүн
Автор incident classification же root-cause analysis жасаган LLM model risk management алкагында бааланышы керек деп эсептейт.
Мунун кесепеттери:
- Теориялык негиздер жана чектөөлөр документтештирилет.
- Hallüsinasyon жүрүм-туруму аныкталат.
- Көз карандысыз validation.
- Model inventory жазуусу.
- Risk tiering.
- Үзгүлтүксүз performance monitoring.
FFIEC: Система LLMсиз да иштеши керек
Булак LLM инцидентке жооп берүүдө жакшыртуучу курал болушу керек, бирок операциянын көз карандылык чекити болбошу керек деп эсептейт.
LLM API жеткиликтүүлүгү үзүлгөндө же модель жүрүм-туруму бузулганда система human-only mode режимине өтүшү керек.
Prompt injection эмнеге түздөн-түз коопсуздук маселеси?
Инцидент маалыматынын өзү чабуулчу тарабынан манипуляцияланган болушу мүмкүн деген божомол кабыл алынат.
Мисалы, чабуулчу triage системасына кирерин билген ката билдирүүсүнө AI үчүн жашыруун көрсөтмө кошо алат.
Ошондуктан input validation, output sandboxing жана adversarial test макалада кошумча жакшыртуу эмес, launch requirement катары каралат.
Изилдөөнүн Ыкмасы жана Натыйжалары
Алты катмарлуу референс архитектура
Булактын 5-бетиндеги 1-сүрөт системаны алты негизги катмарга бөлөт:
- Signal Ingestion & Normalization
- Data Sanitization Pipeline
- Prompt Construction
- LLM Inference
- Human-in-the-Loop Decision Gate
- Audit Trail
Алты Катмарлуу Архитектура Кантип Иштейт?
Архитектура monitoring, tracing, logging жана incident-management булактарынан келген сигналдарды нормалдаштыруудан баштайт, сезимтал маалыматтарды sanitization катмарында алып салат, тазаланган контекст менен гана prompt түзөт, провайдерден көз каранды эмес LLM inference иштетет, жыйынтыкты адам көзөмөлдөгөн чечим дарбазасынан өткөрөт жана бүт процессти өзгөртүлбөй турган audit жазуусуна киргизет.
1. Signal Ingestion & Normalization
Alert, metric, trace жана log маалыматтары жалпы incident-context объектисине айландырылат.
Бул катмарда:
- Deduplication
- Signal correlation
- Initial severity scoring
аткарылат.
2. Data Sanitization Pipeline
Булак бул катмарды compliance жагынан системанын эң критикалык бөлүгү катары аныктайт.
| Баскыч | Функция |
|---|---|
| 1. Regex + Luhn | PAN, SSN, routing number жана token сыяктуу структураланган сезимтал маалыматтарды табат. |
| 2. NER | Ат, дарек жана эркин тексттеги башка PII элементтерин аныктайт. |
| 3. Domain Rules | Мекемеге тиешелүү эсеп номерлерин, session token же internal-ID форматтарын табат. |
| 4. Conservative Fallback | Коопсуз экендиги так аныкталбаган мазмунду typed placeholder менен редактирлейт. |
Мисал placeholder:
[REDACTED:PAN]
Бул ыкма LLMге семантикалык жактан “бул жерде карта номери бар эле” деген маалыматты сактайт, бирок чыныгы маанини жөнөтпөйт.
3. Prompt Construction
Булак prompt архитектурасын үч бөлүккө бөлөт:
- System prompt: Роль, чек аралар жана чыгыш форматы.
- Dynamic context: Sanitized incident маалыматы жана өткөн окуялар.
- Task instruction: Classify, diagnose же recommend сыяктуу тапшырмалар.
RAG corpusка root cause post-incident review менен тастыкталган окуялар гана киргизилиши сунушталат.
Максат — туура эмес диагноз коюлган эски учурлар жаңы моделдин сунуштарын булгабашы.
4. LLM Inference
Модель провайдери provider-independent API артында абстракцияланат.
Мунун себептери:
- Vendor concentration risk.
- Моделди алмаштыра алуу.
- Shadow A/B testing.
- Ар кандай incident түрлөрүн ар кандай моделдерге багыттай алуу.
Күтүлгөн schemaга туура келбеген чыгыш human-only fallbackти иштетет.
5. Human-in-the-Loop Decision Gate
Булак үч өзүнчө autonomy tier сунуштайт:
| Tier | Уруксат берилген жүрүм-турум |
|---|---|
| Tier 1 | Read-only diagnostic чогултуу жана monitor суроолору; автономдуу иштей алат. |
| Tier 2 | Severity classification же routing сунушу; адамдын жактыруусу талап кылынат. |
| Tier 3 | Production state өзгөрткөн аракеттер; техникалык жактан мүмкүн эмес. |
Tier 3тө жөн гана саясаттык тыюу жок. Tool binding, credential жана execution path таптакыр берилбейт.
Ошондуктан ийгиликтүү prompt injection да өндүрүш абалын өзгөртө турган аракетти жасата албайт.
6. Audit Trail
Ар бир өз ара аракет үчүн төмөнкү талаалар сакталат:
- Sanitizationдан кийинки input context
- Толук prompt
- Model response
- Confidence score
- Адам чечими
- Акыркы incident жыйынтыгы
Сактоо append-only жана криптографиялык бүтүндүк текшерүүсү менен долбоорлонгон.
Progressive Trust Деген Эмне?
Progressive trust — LLM колдоочу инцидентке жооп берүүнү дароо активдүү өндүрүш чечимдерине байлабастан, алгач shadow mode, андан кийин advisory mode жана эң соңунда стандарттуу workflowго интеграциялоо жолу менен этап-этабы менен жайылтуу ыкмасы.
Shadow mode
Модель бардык incidentтерди адамдар менен параллел иштетет, бирок чыгыштары операциялык топко көрсөтүлбөйт.
Булакта shadow run болжол менен тогуз жума уланган.
Advisory mode
Сунуштар көрүнөт, бирок милдеттүү эмес.
Оператор:
- Кабыл ала алат.
- Өзгөртө алат.
- Четке кага алат.
Integrated mode
Курал стандарттуу workflowнун бөлүгүнө айланат, бирок Tier 2 жана Tier 3 чек аралары сакталат.
Синтетикалык Benchmark Кантип Түзүлгөн?
Иш өндүрүштүк банк маалыматын жарыялабай баалоо үчүн ачык банк өчүүлөрүнөн, төлөм провайдерлеринин post-mortemдарынан жана бөлүштүрүлгөн системалардагы бузулуу үлгүлөрүнөн чыгарылган синтетикалык incident сценарийлерин төрт татаалдык деңгээлине бөлөт.
| Деңгээл | Үлгү | Кыйындык |
|---|---|---|
| 1 | Бир сигнал, белгилүү failure mode | Төмөн |
| 2 | Бир нече байланышкан сигнал, белгилүү pattern | Орто |
| 3 | Бир нече сигнал, жаңы комбинация | Жогорку |
| 4 | Белгисиз сигналдар, бир нече мүмкүн болгон себеп | Өтө жогорку |
LLM Көрсөткүчү Татаалдык Өскөн Сайын Кантип Өзгөрдү?
Булактын синтетикалык баалоосунда окуя татаалдыгы өскөн сайын classification, root-cause жана remediation көрсөткүчтөрү үзгүлтүксүз төмөндөп, hallüsinasyon көрсөткүчтөрү жогорулаган; өзүнчө жана структураланган sanitization катмары болсо бардык татаалдык деңгээлдеринде %100 completeness көрсөткөн.
| Метрика | Level 1 | Level 2 | Level 3 | Level 4 |
|---|---|---|---|---|
| Classification accuracy | %92–97 | %85–92 | %72–83 | %58–70 |
| Root cause in top-3 | %95–98 | %88–94 | %70–82 | %52–65 |
| Appropriate remediation | %94–98 | %86–93 | %74–85 | %60–72 |
| Hallucination rate | <%2 | %2–5 | %5–10 | %8–15 |
| Sanitization completeness | %100 | %100 | %100 | %100 |
Автор Level 3 жана Level 4 окуяларда куралдын ролун “туура жооп берүү” эмес, изилдөөчүнүн издөө мейкиндигин тарыткан баштапкы чекитти түзүү катары аныктайт.
Compliance validation жыйынтыктары
| Чектөө | Тест | Жыйынтык |
|---|---|---|
| Change control | Бардык prompt өзгөртүүлөрүндө audit record түзүлүшү | Pass |
| Audit completeness | Керектүү талаалардын бардык өз ара аракеттерде толтурулушу | Pass |
| Sanitization | Синтетикалык CHD injection; inference layerга %0 өтүү | Pass |
| Fallback | LLM өчкөндө human-only modeго өтүү | Pass |
| Scope enforcement | Tier 3 аракетин жасатууга аракет кылган prompt injection | Pass |
Бул жыйынтыктар булак автору аныктаган система жана тест түзүлүшүнө тиешелүү.
Чектөөлөр жана Колдонуу Натыйжалары
Архитектура Эмне Үчүн Sanitizationга LLMден Да Көбүрөөк Маани Берет?
Булактын мамилесинде туура эмес LLM сунушун адамдын көзөмөлү токтото алат, ал эми сезимтал каржы маалыматы уруксатсыз inference провайдерине агып кетсе түздөн-түз compliance бузулуусу жаралышы мүмкүн; ошондуктан sanitization катмары LLM интеграциясынан да жогорку тест приоритетине ээ болушу керек.
Автор командаларга sanitization катмарына салыштырмалуу көбүрөөк инвестиция кылууну сунуштайт.
Sanitizationдын баасы
Консервативдүү sanitization айрым диагностикалык маалыматтын жоголушуна алып келет.
Кээде редакцияланган маани root causeду тезирээк табууга жардам бере турган критикалык сигнал болушу мүмкүн.
Булак ошондуктан privacy менен diagnostic utility ортосунда чечилбеген чыңалуу бар экенин кабыл алат.
Бул Система Адам Incident Commanderдин Ордуна Өтөбү?
Жок. Бул архитектурада LLM өзгөчө жогорку татаалдыкта чечим чыгаруучу эмес, гипотеза сунуштаган жана издөө мейкиндигин тарыткан жардамчы; өндүрүш абалын өзгөртө турган Tier 3 аракеттери система тарабынан аткарылбайт.
Ошондуктан адам accountability архитектуранын борборунда калат.
Prompt governance
Булакта сунушталган prompt принциптери:
- Эгер контекст жетишсиз болсо модель аны ачык айтууга тийиш.
- Жетишсиз маалымат менен божомол чыгаруунун ордуна кайсы кошумча маалымат керек экенин көрсөтүшү керек.
- Ар бир сунуш тиешелүү log, metric же historical incident ID менен далилдениши керек.
- Out-of-scope системаларга карата сунуштар автоматтык flag болушу керек.
Auditor үчүн дизайн
Макала системанын эки өзүнчө колдонуучу тобу бар экенин баса белгилейт:
- Түнкү 03.00дө тез сунуш каалаган incident commander.
- Айлар өткөндөн кийин белгилүү чечим эмнеге кабыл алынганын сураган auditor.
Ошондуктан audit interface кийин кооздолгон debug log версиясы болбошу керек; башынан эле өзүнчө продукт интерфейси катары долбоорлонушу керек.
Бул Архитектура Банктан Тышкары Колдонулушу Мүмкүнбү?
Булакка ылайык негизги принцип башка катуу жөнгө салынган тармактарга өткөрүлүшү мүмкүн; бирок сезимтал маалымат түрлөрүнө, өзгөрүүлөрдү башкарууга жана аудит талаптарына жараша катмарлардын деталдары өзгөрөт.
Мисал катары:
- Саламаттык: HIPAA жана PHI sanitization.
- Энергетика: NERC CIP change management.
- Мамлекеттик сектор: FedRAMP, FISMA жана маалымат суверендүүлүгү.
- ЕБ жогорку тобокел AI системалары: AI Act менен дал келген governance муктаждыктары.
Изилдөө колдогон жыйынтыктар
- Жөнгө салуучу талаптар LLM система архитектурасын фундаменталдуу өзгөртө алат.
- Sanitization inferenceдан көз карандысыз катмар катары курулушу мүмкүн.
- Tier 3 аракеттерин техникалык жактан мүмкүн эмес кылуу prompt негизиндеги тыюудан күчтүүрөөк контрол.
- Shadow mode validation үчүн маанилүү далил түзөт.
- Model-provider abstraction concentration riskти азайта алат.
- Audit trail compliance үчүн да, post-incident review үчүн да баалуу.
- Татаал incidentтерде LLM көрсөткүчү төмөндөсө да, гипотеза издөө аймагын тарытуу баалуулугун бере алат.
Изилдөө колдобогон жыйынтыктар
- LLM incident responseту толук автоматташтыруусу сунушталбайт.
- Синтетикалык benchmark жыйынтыктарын бардык банктарга же бардык LLMдерге автоматтык түрдө жалпылоого болбойт.
- %100 sanitization жыйынтыгы реалдуу дүйнөдө маалымат агып кетпейт деген универсал кепилдик эмес.
- Tier 3 автономиясы бүгүн коопсуз деген пикир айтылбайт.
- Регуляциялар келечекте өзгөрбөйт деп болжолдонбойт.
- Өндүрүш маалыматындагы accuracy жоготуусу бул иште түз өлчөнгөн эмес.
Ачык маселелер
Булак үч маанилүү маселени чечилбеген бойдон калтырат:
- Sanitization диагностикалык тактыкта канча маалымат жоготот.
- Production-modifying AI аракеттери качан коопсуз кеңейтилиши мүмкүн.
- Салттуу Model Risk Management алкактары non-deterministic жана emergent LLM системаларына кантип ылайыкташтырылат.
Булак жана Ыкма Эскертүүсү
Түпнуска аталыш: A Reference Architecture for LLM-Powered Incident Response in Regulated Financial Services
Автор: Ganesh Kutty Murugan
E-mail: ganesh6776@gmail.com
Иштин түрү: Референс архитектура, практик тажрыйбасы жана синтетикалык баалоо.
Жарыя күнү: PDF ичинде так көрсөтүлгөн эмес.
DOI: Булак PDFде берилген эмес.
Журнал / басмакана / том / саны: Булакта көрсөтүлгөн эмес.
Peer-review абалы: PDF ичинде рецензияланган жарыя тууралуу маалымат жок.
Негизги жөнгө салуучу булактар: SOX/PCAOB AS 2201, PCI DSS v4.0.1, OCC Bulletin 2011-12 / Federal Reserve SR 11-7, FFIEC IT Examination Handbook, U.S. Treasury AI cybersecurity guidance, EO 14110 жана NIST AI RMF.
Негизги техникалык булактар: Microsoft/EuroSys root-cause иши, Google SRE AI-assisted incident-management материалдары, log-anomaly адабияты, SRE китептери жана AIOps булактары.
Баалоо ыкмасы: Коомчулукка ачык banking outage жазуулары, payment-processor post-mortemдары жана синтетикалык distributed-system failure patternдарынан төрт кыйындык деңгээлиндеги incident corpus.
Бааланган модель: Булак 2025-жылдын башында “current-generation commercial LLM” деген сөз айкашын колдонот, бирок моделдин атын айтпайт.
Булакта көрсөтүлгөн колдонуу тажрыйбасы: Болжол менен тогуз жумалык shadow mode; биринчи идеядан shadow validation аягына чейин болжол менен 14 айлык иштеп чыгуу.
Негизги чечмелөө чеги: Бул жыйынтыктар автордун архитектуралык тажрыйбасына жана синтетикалык тест түзүлүшүнө негизделет. Өндүрүш банк маалыматтары жарыяланган эмес жана көз карандысыз мекемелер аралык репликация берилген эмес.
Автор жөнүндө: Булак Ganesh Kutty Murugan 17 жылдык өндүрүш инфраструктурасы жана бөлүштүрүлгөн системалар тажрыйбасы бар Principal Site Reliability Engineer экенин жана M.S. Software Engineering даражасын BITS Pilaniден алганын белгилейт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген