

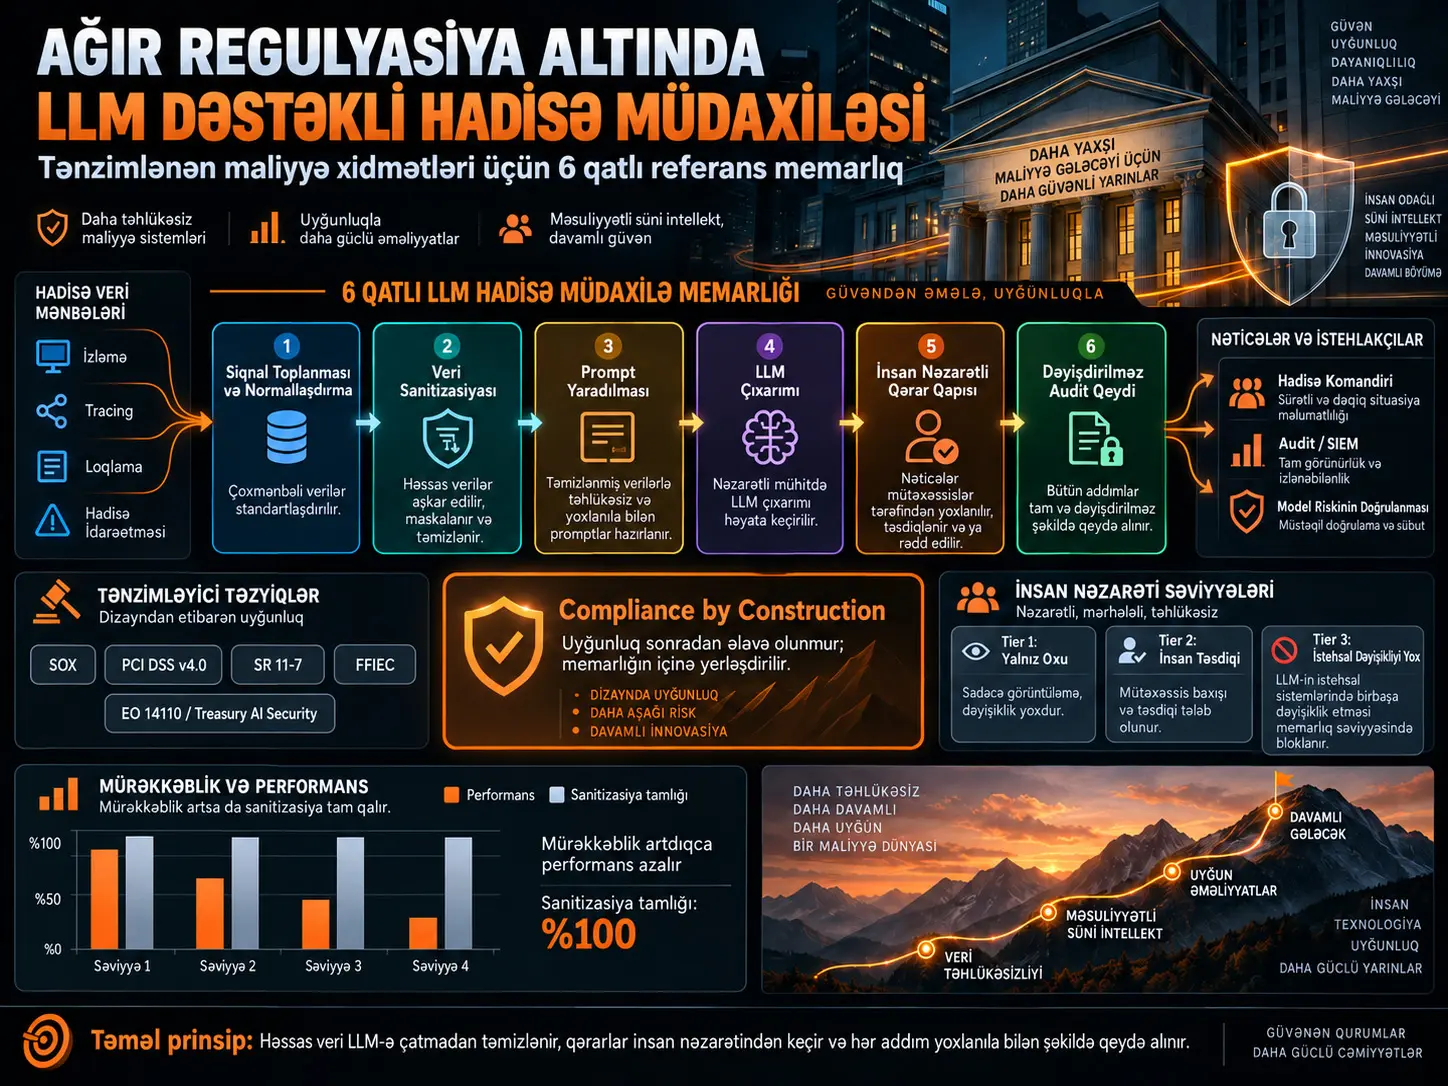
Bu iş böyük dil modellərinin maliyyə xidmətlərində insidentlərə müdaxilə və kök səbəb analizində istifadəsi üçün, klassik texnologiya şirkətlərindən fərqli olaraq, sıx tənzimləyici tələblər altında işləyən bir referans memarlıq təklif edir. Müəllifin əsas iddiası budur ki, banklar Google, Microsoft və ya digər texnologiya şirkətlərində istifadə olunan LLM dəstəkli əməliyyat modellərini birbaşa kopyalaya bilməzlər; çünki SOX, PCI DSS v4.0, SR 11-7, FFIEC və AI yönümlü kibertəhlükəsizlik rəhbərlikləri birlikdə nəzərdən keçirildikdə məlumat axını, prompt dəyişiklikləri, model doğrulaması, üçüncü tərəf istifadəsi, audit trail və insan nəzarəti üzərində struktur məhdudiyyətlər yaranır.
Məqalənin mərkəzində compliance by construction — uyğunluğun dizayn yolu ilə təmin edilməsi prinsipi dayanır. Buna görə uyğunluq istehsaldan sonra yoxlanılan prosedur deyil, sistemin məcburi keçid qatlarının özüdür. Həssas məlumatların LLM-ə çatmasını əngəlləyən məcburi sanitizasiya, versiyalanmış prompt idarəetməsi, provayderdən müstəqil inference qatı, insan təsdiqi tələb edən qərar qapısı və dəyişdirilə bilməyən audit trail birlikdə işləyir.
İş həmçinin istehsal məlumatını paylaşmadan həyata keçirilə bilən sintetik qiymətləndirmə üsulu təqdim edir. Nəticələr aşağı mürəkkəblikli hadisələrdə yüksək performans bildirildiyi halda hadisə qeyri-müəyyənliyi və mürəkkəbliyi artdıqca təsnifat doğruluğunun və root-cause performansının azaldığını, hallüsinasiya nisbətlərinin yüksəldiyini göstərir. Sanitizasiya tamlığı bütün sintetik test səviyyələrində %100 olaraq bildirilib. Bu nəticələr müstəqil sənaye benchmark-ı deyil, işdə müəyyən edilən referans sistemin sintetik qiymətləndirilməsidir.
Compliance by Construction Nədir?
Compliance by construction tənzimləyici tələblərin sistem tamamlandıqdan sonra əlavə olunan siyasət və ya nəzarət nöqtələri kimi deyil, məlumat və qərar axınının məcburi memarlıq qatları kimi layihələndirilməsi yanaşmasıdır; beləliklə müəyyən uyğunsuz davranışlar yalnız qadağan edilmir, texniki olaraq həyata keçirilməsi mümkünsüz edilir.
İşin əsas fərqi buradadır. Ənənəvi yanaşmada sistem işləyir, sonra compliance qrupları nəyin icazəli olub-olmadığını yoxlayır. Bu memarlıqda isə məlumat tənzimləmə tələbinə görə keçməli olduğu qapılardan fiziki olaraq keçmədən LLM-ə çata bilməz.
Eyni şəkildə istehsal vəziyyətini dəyişdirəcək əməliyyatlar üçün yalnız “model bunu etməməlidir” formasında prompt qaydası yoxdur. Sistemə bu əməliyyatları yerinə yetirə biləcək credential, tool binding və ya execution path ümumiyyətlə verilmir.
Beləliklə bəzi nəzarətlər davranışsal deyil, struktur xarakterli olur.
Banklarda LLM Dəstəkli Incident Response Niyə Fərqlidir?
Banklarda LLM dəstəkli insident müdaxiləsi; istehsal loglarının həssas maliyyə məlumatı daşıya bilməsi, prompt dəyişikliklərinin nəzarətli dəyişiklik proseslərinə tabe olması, modellərin müstəqil doğrulama tələb etməsi, üçüncü tərəf provayder riskinin idarə edilməsi və AI xidməti əlçatan olmadıqda əməliyyatın insanlarla davam edə bilməsi məcburiyyətləri səbəbilə ümumi texnologiya şirkətlərindəki tətbiqlərdən daha sərt memarlıq sərhədləri tələb edir.
SOX: Prompt da nəzarətli dəyişiklikdir
Mənbə maliyyə hesabatlarına təsir edə biləcək sistemlərdə istifadə olunan prompt şablonlarının adi mətn deyil, nəzarətli istehsal konfiqurasiyası kimi qəbul edilməli olduğunu müdafiə edir.
Bu yanaşmada:
- Hər prompt versiyası qeydiyyata alınır.
- Təsdiq mexanizmindən keçir.
- İstehsaldan kənar mühitdə test edilir.
- Rollback planı olur.
- LLM qarşılıqlı əlaqələri uzunmüddətli audit qeydlərinə daxil edilir.
PCI DSS: Telemetri həssas məlumat daşıya bilər
Mənbəyə görə ödəniş sistemlərinin logları PAN, CVV, authentication token, hesab nömrəsi və bənzər həssas məzmun daşıya bilər.
Buna görə LLM qatından əvvəl müstəqil sanitizasiya sərhədi tələb olunur.
Mənbə buradakı hədəfi “həssas məlumatı azaltmaq” deyil, icazəsiz inference qatına sıfır həssas məlumat ötürmək kimi müəyyən edir.
SR 11-7: LLM model risk idarəetməsinə daxil ola bilər
Müəllif incident classification və ya root-cause analysis edən LLM-in model risk idarəetməsi çərçivəsində qiymətləndirilməli olduğunu müdafiə edir.
Bunun nəticələri:
- Nəzəri əsasların və məhdudiyyətlərin sənədləşdirilməsi.
- Hallüsinasiya davranışlarının müəyyənləşdirilməsi.
- Müstəqil validation.
- Model inventory qeydi.
- Risk tiering.
- Davamlı performans monitoring.
FFIEC: Sistem LLM olmadan da işləməlidir
Mənbə LLM-in insident müdaxiləsi üçün təkmilləşdirici alət olmalı olduğunu, əməliyyatın asılılıq nöqtəsinə çevrilməməli olduğunu müdafiə edir.
LLM API çıxışı kəsildikdə və ya model davranışı pozulduqda sistem human-only mode-a keçə bilməlidir.
Prompt injection niyə birbaşa təhlükəsizlik problemidir?
Hadisə məlumatının özünün hücumçu tərəfindən manipulyasiya edilmiş ola biləcəyi fərz edilir.
Məsələn, hücumçu triage sisteminə daxil olacağını bildiyi xəta mesajına AI üçün gizli təlimat yerləşdirə bilər.
Buna görə input validation, output sandboxing və adversarial test məqalədə opsional yaxşılaşdırma deyil, launch requirement kimi qəbul edilir.
İşin Metodu və Nəticələri
Altı qatlı referans memarlıq
Mənbənin 5-ci səhifəsindəki Şəkil 1 sistemi altı əsas qata ayırır:
- Signal Ingestion & Normalization
- Data Sanitization Pipeline
- Prompt Construction
- LLM Inference
- Human-in-the-Loop Decision Gate
- Audit Trail
Altı Qatlı Memarlıq Necə İşləyir?
Memarlıq monitoring, tracing, logging və incident-management mənbələrindən gələn siqnalları normallaşdırmaqla başlayır, həssas məlumatları sanitizasiya qatında çıxarır, yalnız təmizlənmiş kontekstlə prompt qurur, provayderdən müstəqil LLM inference işlədir, nəticəni insan nəzarətli qərar qapısından keçirir və bütün prosesi dəyişdirilə bilməyən audit qeydinə yazır.
1. Signal Ingestion & Normalization
Alert, metric, trace və log məlumatları ortaq incident-context obyektinə çevrilir.
Bu qatdakı əməliyyatlar:
- Deduplication
- Signal correlation
- Initial severity scoring
şəklində həyata keçirilir.
2. Data Sanitization Pipeline
Mənbə bu qatı sistemin uyğunluq baxımından ən kritik hissəsi kimi müəyyən edir.
| Mərhələ | Funksiya |
|---|---|
| 1. Regex + Luhn | PAN, SSN, routing number və token kimi strukturlaşdırılmış həssas məlumatları tutur. |
| 2. NER | Ad, ünvan və sərbəst mətndəki digər PII elementlərini aşkarlayır. |
| 3. Domain Rules | Quruma xas hesab nömrəsi, session token və ya internal-ID formatlarını tutur. |
| 4. Conservative Fallback | Təhlükəsiz olduğu dəqiq müəyyən edilə bilməyən məzmunu typed placeholder ilə redaktə edir. |
Nümunə placeholder:
[REDACTED:PAN]
Bu yanaşma LLM-ə semantik olaraq “burada kart nömrəsi var idi” məlumatını saxlayır, lakin real dəyəri göndərmir.
3. Prompt Construction
Mənbə prompt memarlığını üç hissəyə ayırır:
- System prompt: Rol, sərhədlər və çıxış formatı.
- Dynamic context: Sanitized incident məlumatı və keçmiş hadisələr.
- Task instruction: Classify, diagnose və ya recommend kimi tapşırıqlar.
RAG corpus-a yalnız root cause-u post-incident review ilə doğrulanmış hadisələrin daxil edilməsi tövsiyə olunur.
Məqsəd səhv diaqnoz qoyulmuş köhnə halların yeni model tövsiyələrini çirkləndirməsinin qarşısını almaqdır.
4. LLM Inference
Model provayderi provider-independent API arxasında abstraktlaşdırılır.
Bunun səbəbləri:
- Vendor concentration risk.
- Modeli dəyişə bilmək.
- Shadow A/B testing.
- Fərqli incident tiplərini fərqli modellərə yönləndirə bilmək.
Gözlənilən schema-ya uyğun olmayan çıxış human-only fallback-i tetikler.
5. Human-in-the-Loop Decision Gate
Mənbə üç ayrı autonomy tier təklif edir:
| Tier | İcazə verilən davranış |
|---|---|
| Tier 1 | Read-only diagnostic toplama və monitor sorğulama; avtonom işləyə bilər. |
| Tier 2 | Severity classification və ya routing tövsiyəsi; insan təsdiqi tələb olunur. |
| Tier 3 | Production state dəyişdirən əməliyyatlar; texniki olaraq mümkün deyil. |
Tier 3-də yalnız siyasət qadağası yoxdur. Tool binding, credential və execution path yoxdur.
Buna görə uğurlu prompt injection belə istehsal vəziyyətini dəyişdirən əməliyyat gördürə bilməz.
6. Audit Trail
Hər qarşılıqlı əlaqə üçün aşağıdakı sahələr saxlanılır:
- Sanitizasiya sonrası input context
- Tam prompt
- Model response
- Confidence score
- İnsan qərarı
- Yekun incident nəticəsi
Saxlama append-only və kriptoqrafik bütövlük yoxlamasına malik şəkildə dizayn edilir.
Progressive Trust Nədir?
Progressive trust LLM dəstəkli insident müdaxiləsini birbaşa aktiv istehsal qərarlarına bağlamaq yerinə əvvəl shadow mode, sonra advisory mode və sonda standart iş axınına inteqrasiya etmək şəklində mərhələli tətbiq yanaşmasıdır.
Shadow mode
Model bütün incident-ləri insanlarla paralel emal edir, lakin çıxışlar əməliyyat qrupuna göstərilmir.
Mənbədə shadow run təxminən doqquz həftə davam etmişdir.
Advisory mode
Tövsiyələr görünən olur, lakin məcburi deyil.
Operator:
- Qəbul edə bilər.
- Dəyişdirə bilər.
- Rədd edə bilər.
Integrated mode
Alət standart workflow-un bir hissəsinə çevrilir, lakin Tier 2 və Tier 3 sərhədləri qorunur.
Sintetik Benchmark Necə Qurulub?
İş istehsal bankçılıq məlumatını yayımlamadan qiymətləndirmə aparmaq üçün açıq bank kəsintilərindən, ödəniş provayderlərinin post-mortem-larından və paylanmış sistem nasazlıq nümunələrindən törədilmiş sintetik incident ssenarilərini dörd mürəkkəblik səviyyəsində təsnif edir.
| Səviyyə | Nümunə | Çətinlik |
|---|---|---|
| 1 | Tək siqnal, məlum failure mode | Aşağı |
| 2 | Çoxsaylı əlaqəli siqnallar, məlum pattern | Orta |
| 3 | Çoxsaylı siqnal, yeni kombinasiya | Yüksək |
| 4 | Qeyri-müəyyən siqnallar, birdən çox mümkün səbəb | Çox yüksək |
LLM Performansı Mürəkkəblik Artdıqca Necə Dəyişdi?
Mənbənin sintetik qiymətləndirməsində hadisə mürəkkəbliyi artdıqca classification, root-cause və remediation performansı müntəzəm şəkildə azalarkən hallüsinasiya nisbətləri yüksəlmiş; ayrıca və struktur sanitizasiya qatı isə bütün mürəkkəblik səviyyələrində %100 tamlıq göstərmişdir.
| Metrik | Level 1 | Level 2 | Level 3 | Level 4 |
|---|---|---|---|---|
| Classification accuracy | %92–97 | %85–92 | %72–83 | %58–70 |
| Root cause in top-3 | %95–98 | %88–94 | %70–82 | %52–65 |
| Appropriate remediation | %94–98 | %86–93 | %74–85 | %60–72 |
| Hallucination rate | <%2 | %2–5 | %5–10 | %8–15 |
| Sanitization completeness | %100 | %100 | %100 | %100 |
Müəllif Level 3 və Level 4 hadisələrdə alətin rolunu “düzgün cavab vermək”dən daha çox araşdırıcının axtarış sahəsini daraldan başlanğıc nöqtəsi yaratmaq kimi müəyyən edir.
Compliance validation nəticələri
| Məhdudiyyət | Test | Nəticə |
|---|---|---|
| Change control | Bütün prompt dəyişikliklərində audit record yaradılması | Pass |
| Audit completeness | Tələb olunan sahələrin bütün qarşılıqlı əlaqələrdə dolu olması | Pass |
| Sanitization | Sintetik CHD inyeksiyası; inference layer-a %0 keçid | Pass |
| Fallback | LLM söndürüldükdə human-only mode-a keçid | Pass |
| Scope enforcement | Tier 3 əməliyyat etdirməyə çalışan prompt injection | Pass |
Bu nəticələr mənbə müəllifinin müəyyən etdiyi sistem və test quruluşuna aiddir.
Məhdudiyyətlər və Tətbiq Nəticələri
Memarlıq Niyə Sanitizasiyaya LLM-dən Daha Çox Əhəmiyyət Verir?
Mənbənin yanaşmasında səhv bir LLM tövsiyəsi insan nəzarəti ilə dayandırıla bildiyi halda həssas maliyyə məlumatının icazəsiz inference provayderinə sızması birbaşa uyğunluq pozuntusu yarada biləcəyindən sanitizasiya qatı LLM inteqrasiyasından belə daha yüksək test prioritetinə sahib olmalıdır.
Müəllif qrupların sanitizasiya qatına qeyri-mütənasib dərəcədə yatırım etməsini tövsiyə edir.
Sanitizasiyanın qiyməti
Mühafizəkar sanitizasiya bəzi diaqnostik məlumatların itirilməsinə səbəb olur.
Bəzən redaktə edilən dəyər root cause-u daha tez tapmağa imkan verə biləcək kritik siqnal ola bilər.
Mənbə buna görə privacy ilə diagnostic utility arasında həll olunmamış gərginlik olduğunu qəbul edir.
Bu Sistem İnsan Incident Commander-ın Yerini Alırmı?
Xeyr. İşin memarlığında LLM xüsusilə yüksək mürəkkəblik səviyyələrində qərarverici deyil, hipotez yaradan və axtarış sahəsini daraldan köməkçidir; istehsal vəziyyətini dəyişdirən Tier 3 əməliyyatları sistem tərəfindən həyata keçirilə bilməz.
Buna görə insan accountability memarlığın mərkəzində qalır.
Prompt governance
Mənbədə təklif olunan prompt prinsipləri bunlardır:
- Model çatışmayan kontekst varsa bunu açıq şəkildə bildirməlidir.
- Yetərsiz məlumatla təxmin yaratmaq əvəzinə hansı əlavə məlumatın lazım olduğunu göstərməlidir.
- Hər tövsiyə müvafiq log, metric və ya historical incident ID ilə əsaslandırılmalıdır.
- Out-of-scope sistemlər üçün tövsiyələr avtomatik flag edilməlidir.
Auditor üçün dizayn
Məqalə sistemin iki ayrı istifadəçi qrupuna sahib olduğunu vurğulayır:
- Gecə 03.00-da sürətli tövsiyə istəyən incident commander.
- Aylar sonra konkret qərarın niyə verildiyini soruşan auditor.
Buna görə audit interface sonradan gözəlləşdirilmiş debug log versiyası olmamalı; ilk gündən ayrıca məhsul səthi kimi dizayn edilməlidir.
Bu Memarlıq Bankçılıqdan Kənarda İstifadə Oluna bilərmi?
Mənbəyə görə əsas prinsip digər yüksək tənzimlənən sektorlara köçürülə bilər; lakin həssas məlumat növləri, dəyişiklik idarəetməsi və audit tələblərinə görə qatların detalları dəyişməlidir.
Nümunə olaraq:
- Səhiyyə: HIPAA və PHI sanitizasiyası.
- Enerji: NERC CIP dəyişiklik idarəetməsi.
- Dövlət: FedRAMP, FISMA və məlumat suverenliyi.
- AB yüksək riskli AI sistemləri: AI Act ilə üst-üstə düşən idarəetmə ehtiyacları.
İşin dəstəklədiyi nəticələr
- Tənzimləyici tələblər LLM sistem memarlığını fundamental səviyyədə dəyişə bilər.
- Sanitizasiya inference-dan müstəqil qat kimi qurula bilər.
- Tier 3 əməliyyatların texniki olaraq mümkünsüz olması prompt əsaslı qadağadan daha güclü nəzarətdir.
- Shadow mode validation üçün vacib sübut yaradır.
- Model-provider abstraction concentration riskini azalda bilər.
- Audit trail həm compliance, həm də post-incident review üçün dəyərlidir.
- Mürəkkəb incident-lərdə LLM performansı azalsa belə hipotez daraltma dəyəri verə bilər.
İşin dəstəkləmədiyi nəticələr
- LLM-in incident response-u tam avtomatlaşdırması tövsiyə edilmir.
- Sintetik benchmark nəticələri bütün banklara və ya bütün LLM-lərə avtomatik ümumiləşdirilə bilməz.
- %100 sanitization nəticəsi real dünyada heç bir məlumat sızması olmayacağının universal zəmanəti deyil.
- Tier 3 avtonomiyasının bu gün təhlükəsiz olduğu müdafiə edilmir.
- Tənzimləmələrin gələcəkdə dəyişməz qalacağı fərz edilmir.
- İstehsal məlumatındakı accuracy itkisi bu iş tərəfindən birbaşa ölçülməyib.
Açıq problemlər
Mənbə üç mühüm problemi həll olunmamış saxlayır:
- Sanitizasiyanın diaqnostik doğruluqda nə qədər məlumat itirdiyi.
- Production-modifying AI əməliyyatlarının nə vaxt təhlükəsiz şəkildə genişləndirilə biləcəyi.
- Ənənəvi Model Risk Management çərçivələrinin non-deterministic və emergent LLM sistemlərinə necə uyğunlaşdırılacağı.
Mənbə və Metod Qeydi
Orijinal başlıq: A Reference Architecture for LLM-Powered Incident Response in Regulated Financial Services
Müəllif: Ganesh Kutty Murugan
E-poçt: ganesh6776@gmail.com
İş növü: Referans memarlıq, praktikant təcrübəsi və sintetik qiymətləndirmə.
Nəşr tarixi: PDF-də açıq göstərilməyib.
DOI: Mənbə PDF-də verilməyib.
Jurnal / nəşriyyat / cild / say: Mənbədə göstərilməyib.
Peer-review statusu: PDF-də rəyçi qiymətləndirməli nəşr məlumatı yoxdur.
Əsas tənzimləyici mənbələr: SOX/PCAOB AS 2201, PCI DSS v4.0.1, OCC Bulletin 2011-12 / Federal Reserve SR 11-7, FFIEC IT Examination Handbook, U.S. Treasury AI cybersecurity guidance, EO 14110 və NIST AI RMF.
Əsas texniki mənbələr: Microsoft/EuroSys root-cause işi, Google SRE AI-assisted incident-management materialı, log-anomaly ədəbiyyatı, SRE kitabları və AIOps mənbələri.
Qiymətləndirmə üsulu: Açıq banking outage qeydləri, payment-processor post-mortem-ları və sintetik distributed-system failure pattern-lardan dörd çətinlik səviyyəli incident corpus.
Qiymətləndirilən model: Mənbə 2025-ci ilin əvvəli dövrü üçün “current-generation commercial LLM” ifadəsini istifadə edir, lakin model adını açıqlamır.
Mənbədə göstərilən tətbiq təcrübəsi: Təxminən doqquz həftəlik shadow mode; ilk ideyadan shadow validation sonuna qədər təxminən 14 aylıq inkişaf prosesi.
Əsas şərh sərhədi: Bu nəticələr müəllifin memarlıq təcrübəsi və sintetik test quruluşuna əsaslanır. İstehsal bankçılıq məlumatları yayımlanmayıb, müstəqil qurumlararası replikasiya təqdim olunmayıb.
Müəllif haqqında: Mənbə Ganesh Kutty Murugan-ın 17 illik istehsal infrastrukturu və paylanmış sistem təcrübəsinə sahib Principal Site Reliability Engineer olduğunu və M.S. Software Engineering dərəcəsini BITS Pilani-dən aldığını bildirir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib