

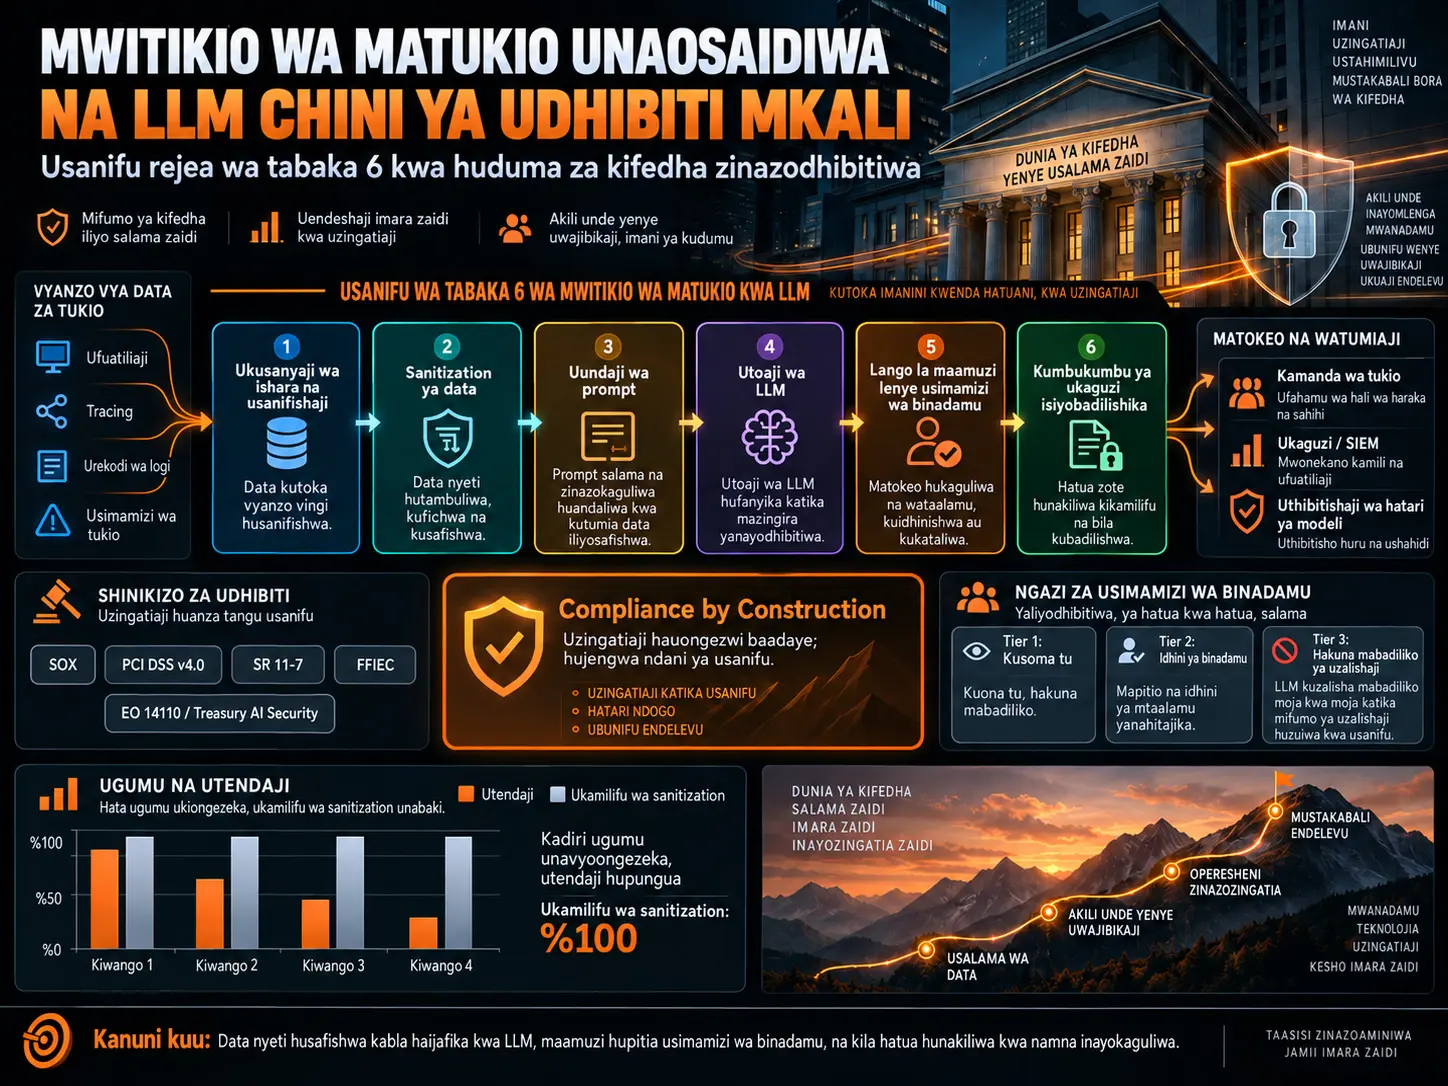
Utafiti huu unapendekeza usanifu rejea wa kutumia miundo mikubwa ya lugha katika mwitikio wa matukio na uchanganuzi wa chanzo kikuu katika huduma za kifedha, chini ya mahitaji makali ya udhibiti ambayo ni tofauti na mazingira ya kawaida ya kampuni za teknolojia. Dai kuu la mwandishi ni kwamba benki haziwezi kunakili moja kwa moja miundo ya uendeshaji inayosaidiwa na LLM inayotumiwa katika Google, Microsoft au kampuni nyingine za teknolojia; kwa sababu SOX, PCI DSS v4.0, SR 11-7, FFIEC na miongozo ya usalama wa mtandao inayolenga AI, zinapotathminiwa kwa pamoja, huweka vikwazo vya kimuundo juu ya mtiririko wa data, mabadiliko ya prompt, uthibitishaji wa modeli, matumizi ya wahusika wa tatu, audit trail na usimamizi wa binadamu.
Katika kiini cha makala kuna kanuni ya compliance by construction — kujenga uzingatiaji ndani ya muundo wenyewe. Kwa mtazamo huu, compliance si utaratibu unaokaguliwa baada ya mfumo kuwekwa uzalishoni; bali ni tabaka za lazima ambazo data na maamuzi lazima zipitie. Sanitization ya lazima inayozuia data nyeti kufikia LLM, usimamizi wa prompt ulio na matoleo, tabaka la inference lisilotegemea mtoa huduma, lango la uamuzi linalohitaji idhini ya binadamu na audit trail isiyoweza kubadilishwa hufanya kazi kwa pamoja.
Utafiti pia unapendekeza mbinu ya tathmini ya sintetiki inayoweza kufanywa bila kushiriki data za uzalishaji. Matokeo yanaonyesha utendaji wa juu katika matukio yenye ugumu mdogo, lakini kadiri kutokuwa na uhakika na ugumu wa tukio unavyoongezeka, usahihi wa classification na utendaji wa root-cause hupungua huku viwango vya hallüsinasyon vikiongezeka. Sanitization completeness iliripotiwa kuwa %100 katika viwango vyote vya majaribio ya sintetiki. Matokeo haya si benchmark huru ya sekta, bali ni tathmini ya sintetiki ya mfumo rejea uliofafanuliwa katika utafiti.
Compliance by Construction ni Nini?
Compliance by construction ni mbinu ya kubuni masharti ya udhibiti si kama sera au pointi za ukaguzi zinazoongezwa baada ya mfumo kukamilika, bali kama tabaka za lazima za usanifu katika mtiririko wa data na maamuzi; hivyo baadhi ya tabia zisizokubaliana na kanuni hazikatazwi tu, bali zinafanywa kuwa zisizowezekana kiufundi.
Hapa ndipo tofauti kuu ya utafiti ilipo. Katika mbinu ya kawaida, mfumo hufanya kazi kwanza, kisha timu za compliance hukagua kinachoruhusiwa na kisichoruhusiwa. Katika usanifu huu, data haiwezi kufika kwa LLM bila kupita kimwili kwenye malango ambayo kanuni zinahitaji.
Vivyo hivyo, kwa vitendo vinavyoweza kubadilisha hali ya uzalishaji, hakuna kanuni ya prompt pekee inayosema “modeli isifanye hivi”. Mfumo haupewi credential, tool binding au execution path inayoweza kutekeleza vitendo hivyo.
Kwa njia hii, baadhi ya vidhibiti huwa vya kimuundo badala ya kitabia.
Kwa Nini Incident Response Inayotumia LLM ni Tofauti Katika Benki?
Incident response inayosaidiwa na LLM katika benki inahitaji mipaka mikali zaidi ya usanifu kwa sababu log za uzalishaji zinaweza kuwa na data nyeti za kifedha, mabadiliko ya prompt yanapaswa kufuata taratibu za controlled change, modeli zinahitaji independent validation, hatari za third-party provider zinapaswa kudhibitiwa, na operesheni lazima ziendelee kwa kutumia binadamu wakati huduma ya AI haipatikani.
SOX: Prompt pia ni controlled change
Chanzo kinahoji kwamba prompt templates zinazotumika katika mifumo inayoweza kuathiri taarifa za kifedha zinapaswa kuchukuliwa si kama maandishi ya kawaida bali kama controlled production configuration.
Katika mbinu hii:
- Kila toleo la prompt hurekodiwa.
- Hupitia utaratibu wa idhini.
- Hujaribiwa katika mazingira yasiyo ya uzalishaji.
- Huambatana na rollback plan.
- Mwingiliano wa LLM huingia kwenye rekodi za muda mrefu za audit.
PCI DSS: Telemetry inaweza kubeba data nyeti
Kulingana na chanzo, log za mifumo ya malipo zinaweza kuwa na PAN, CVV, authentication token, namba za akaunti na maudhui mengine nyeti.
Kwa hiyo, mpaka huru wa sanitization unahitajika kabla ya tabaka la LLM.
Chanzo kinafafanua lengo hapa si “kupunguza data nyeti” bali kupitisha sifuri ya data nyeti kwenda kwenye inference layer isiyoidhinishwa.
SR 11-7: LLM inaweza kuingia katika model risk management
Mwandishi anasema LLM inayofanya incident classification au root-cause analysis inapaswa kutathminiwa ndani ya mfumo wa model risk management.
Matokeo yake ni:
- Kuandika msingi wa kinadharia na mipaka.
- Kufafanua tabia za hallüsinasyon.
- Independent validation.
- Model inventory record.
- Risk tiering.
- Continuous performance monitoring.
FFIEC: Mfumo lazima ufanye kazi hata bila LLM
Chanzo kinasema LLM inapaswa kuwa chombo cha kuboresha incident response, si kuwa utegemezi muhimu wa operesheni.
Wakati ufikiaji wa LLM API unapokatika au tabia ya modeli inapoharibika, mfumo unapaswa kuweza kuingia human-only mode.
Kwa nini prompt injection ni tatizo la moja kwa moja la usalama?
Inachukuliwa kwamba data ya tukio yenyewe inaweza kuwa imedanganywa na mshambuliaji.
Kwa mfano, mshambuliaji anaweza kuongeza maagizo ya siri kwa AI ndani ya ujumbe wa kosa ambao anajua utaingia kwenye mfumo wa triage.
Kwa sababu hiyo, input validation, output sandboxing na adversarial test zinachukuliwa katika makala si kama maboresho ya hiari bali kama launch requirement.
Mbinu na Matokeo ya Utafiti
Usanifu rejea wa tabaka sita
Kielelezo 1 kwenye ukurasa wa 5 wa chanzo kinagawa mfumo katika tabaka kuu sita:
- Signal Ingestion & Normalization
- Data Sanitization Pipeline
- Prompt Construction
- LLM Inference
- Human-in-the-Loop Decision Gate
- Audit Trail
Usanifu wa Tabaka Sita Unafanyaje Kazi?
Usanifu huanza kwa kunormalize ishara kutoka monitoring, tracing, logging na incident-management, huondoa taarifa nyeti kwenye tabaka la sanitization, huunda prompt kwa kutumia muktadha uliosafishwa pekee, huendesha LLM inference isiyotegemea provider, hupitisha matokeo kwenye lango la uamuzi lenye usimamizi wa binadamu na huandika mchakato mzima kwenye audit record isiyoweza kubadilishwa.
1. Signal Ingestion & Normalization
Data za alert, metric, trace na log hubadilishwa kuwa incident-context object ya pamoja.
Katika tabaka hili hufanywa:
- Deduplication
- Signal correlation
- Initial severity scoring
.
2. Data Sanitization Pipeline
Chanzo kinafafanua tabaka hili kuwa sehemu muhimu zaidi ya mfumo kwa upande wa compliance.
| Hatua | Kazi |
|---|---|
| 1. Regex + Luhn | Hutambua data nyeti zilizopangwa kama PAN, SSN, routing number na token. |
| 2. NER | Hutambua jina, anwani na vipengele vingine vya PII katika maandishi huru. |
| 3. Domain Rules | Hutambua namba za akaunti, session token au miundo ya internal-ID maalum kwa taasisi. |
| 4. Conservative Fallback | Huredakti maudhui ambayo usalama wake hauwezi kuthibitishwa kwa kutumia typed placeholder. |
Mfano wa placeholder:
[REDACTED:PAN]
Mbinu hii huhifadhi kwa LLM maana ya kimantiki kwamba “kulikuwa na namba ya kadi hapa”, lakini haitumi thamani halisi.
3. Prompt Construction
Chanzo kinagawa usanifu wa prompt katika sehemu tatu:
- System prompt: Jukumu, mipaka na format ya output.
- Dynamic context: Sanitized incident data na matukio ya zamani.
- Task instruction: Majukumu kama Classify, diagnose au recommend.
Inapendekezwa kuwa RAG corpus ijumuishwe tu matukio ambayo root cause yake imethibitishwa kupitia post-incident review.
Lengo ni kuzuia kesi za zamani zilizotambuliwa vibaya kuharibu mapendekezo mapya ya modeli.
4. LLM Inference
Mtoa modeli anafichwa nyuma ya provider-independent API.
Sababu ni:
- Vendor concentration risk.
- Uwezo wa kubadilisha modeli.
- Shadow A/B testing.
- Uwezo wa kuelekeza aina tofauti za incident kwa modeli tofauti.
Output isiyolingana na schema inayotarajiwa huanzisha human-only fallback.
5. Human-in-the-Loop Decision Gate
Chanzo kinapendekeza autonomy tier tatu tofauti:
| Tier | Tabia inayoruhusiwa |
|---|---|
| Tier 1 | Read-only diagnostic collection na monitor queries; inaweza kufanya kazi kiotomatiki. |
| Tier 2 | Severity classification au routing recommendation; inahitaji idhini ya binadamu. |
| Tier 3 | Vitendo vinavyobadilisha Production state; haviwezekani kiufundi. |
Katika Tier 3 hakuna tu marufuku ya sera. Hakuna Tool binding, credential wala execution path.
Kwa hiyo hata prompt injection iliyofanikiwa haiwezi kulazimisha hatua inayobadilisha hali ya uzalishaji.
6. Audit Trail
Kwa kila mwingiliano, sehemu zifuatazo huhifadhiwa:
- Input context baada ya sanitization
- Prompt kamili
- Model response
- Confidence score
- Uamuzi wa binadamu
- Matokeo ya mwisho ya incident
Hifadhi imeundwa kuwa append-only na kuwa na ukaguzi wa uadilifu wa kriptografia.
Progressive Trust ni Nini?
Progressive trust ni mbinu ya kuanzisha incident response inayosaidiwa na LLM kwa hatua badala ya kuiunganisha moja kwa moja na maamuzi hai ya uzalishaji: kwanza shadow mode, kisha advisory mode na hatimaye ujumuishaji katika standard workflow.
Shadow mode
Modeli hushughulikia incident zote sambamba na binadamu lakini outputs hazionyeshwi kwa timu ya operesheni.
Kwenye chanzo, shadow run ilidumu takriban wiki tisa.
Advisory mode
Mapendekezo yanaonekana lakini si ya lazima.
Operator anaweza:
- Kukubali.
- Kubadilisha.
- Kukataa.
Integrated mode
Chombo kinakuwa sehemu ya standard workflow lakini mipaka ya Tier 2 na Tier 3 inaendelea kuhifadhiwa.
Benchmark ya Sintetiki Iliundwaje?
Utafiti unaweka scenario za sintetiki za incident katika viwango vinne vya ugumu, zikiwa zimetokana na rekodi za hadharani za kukatika kwa huduma za benki, post-mortem za watoa huduma za malipo na distributed-system failure patterns, ili kufanya tathmini bila kuchapisha data za uzalishaji wa benki.
| Kiwango | Muundo | Ugumu |
|---|---|---|
| 1 | Ishara moja, failure mode inayojulikana | Chini |
| 2 | Ishara nyingi zinazohusiana, pattern inayojulikana | Wastani |
| 3 | Ishara nyingi, mchanganyiko mpya | Juu |
| 4 | Ishara zisizo wazi, sababu kadhaa zinazowezekana | Juu sana |
Utendaji wa LLM Ulibadilikaje Kadiri Ugumu Ulivyoongezeka?
Katika tathmini ya sintetiki ya chanzo, kadiri ugumu wa incident ulivyoongezeka, utendaji wa classification, root-cause na remediation ulipungua kwa utaratibu huku viwango vya hallüsinasyon vikiongezeka; tabaka huru na la kimuundo la sanitization lilionyesha %100 completeness katika viwango vyote vya ugumu.
| Kipimo | Level 1 | Level 2 | Level 3 | Level 4 |
|---|---|---|---|---|
| Classification accuracy | %92–97 | %85–92 | %72–83 | %58–70 |
| Root cause in top-3 | %95–98 | %88–94 | %70–82 | %52–65 |
| Appropriate remediation | %94–98 | %86–93 | %74–85 | %60–72 |
| Hallucination rate | <%2 | %2–5 | %5–10 | %8–15 |
| Sanitization completeness | %100 | %100 | %100 | %100 |
Mwandishi anafafanua jukumu la chombo katika matukio ya Level 3 na Level 4 si kama “kutoa jibu sahihi” bali kama kuunda sehemu ya kuanzia inayopunguza eneo la utafutaji la mpelelezi.
Matokeo ya compliance validation
| Kizuizi | Jaribio | Matokeo |
|---|---|---|
| Change control | Kutengenezwa kwa audit record katika kila mabadiliko ya prompt | Pass |
| Audit completeness | Sehemu zinazohitajika kujazwa katika mwingiliano wote | Pass |
| Sanitization | Synthetic CHD injection; %0 kupenya kwenye inference layer | Pass |
| Fallback | LLM ikiwa imezimwa, mfumo kuingia human-only mode | Pass |
| Scope enforcement | Prompt injection inayojaribu kutekeleza Tier 3 action | Pass |
Matokeo haya yanahusu mfumo na mpangilio wa majaribio uliofafanuliwa na mwandishi wa chanzo.
Vikwazo na Maana za Utekelezaji
Kwa Nini Usanifu Unatoa Kipaumbele Zaidi kwa Sanitization Kuliko LLM?
Katika mbinu ya chanzo, pendekezo baya la LLM linaweza kuzuiwa na usimamizi wa binadamu, lakini kuvuja kwa taarifa nyeti za kifedha kwenda kwa inference provider asiyeidhinishwa kunaweza kusababisha ukiukaji wa compliance moja kwa moja; kwa hiyo tabaka la sanitization linapaswa kuwa na kipaumbele cha juu cha majaribio hata kuliko ujumuishaji wa LLM.
Mwandishi anapendekeza timu ziweke uwekezaji mkubwa usio sawia katika tabaka la sanitization.
Gharama ya sanitization
Sanitization ya kihafidhina husababisha baadhi ya taarifa za uchunguzi kupotea.
Wakati mwingine thamani iliyoredaktiwa inaweza kuwa ishara muhimu ambayo ingesaidia kupata root cause kwa haraka zaidi.
Kwa hiyo chanzo kinakubali kuwa kuna mvutano ambao bado haujatatuliwa kati ya privacy na diagnostic utility.
Je, Mfumo Huu Unachukua Nafasi ya Incident Commander wa Binadamu?
Hapana. Katika usanifu wa utafiti, hasa katika viwango vya juu vya ugumu, LLM si mtoa uamuzi bali ni msaidizi anayezalisha hypothesis na kupunguza eneo la utafutaji; vitendo vya Tier 3 vinavyobadilisha hali ya uzalishaji haviwezi kutekelezwa na mfumo.
Kwa hiyo human accountability inabaki katikati ya usanifu.
Prompt governance
Kanuni za prompt zinazopendekezwa katika chanzo ni:
- Modeli lazima itaje wazi ikiwa muktadha hautoshi.
- Badala ya kubashiri kwa taarifa isiyotosha, inapaswa kueleza data gani ya ziada inahitajika.
- Kila pendekezo lazima liungwe mkono na log, metric au historical incident ID inayohusika.
- Mapendekezo kwa mifumo ya out-of-scope yanapaswa kuwekewa flag kiotomatiki.
Muundo kwa auditor
Makala inasisitiza kwamba mfumo una makundi mawili tofauti ya watumiaji:
- Incident commander anayetaka pendekezo la haraka saa 03.00 usiku.
- Auditor anayeuliza miezi baadaye kwa nini uamuzi fulani ulifanywa.
Kwa hiyo audit interface haipaswi kuwa toleo lililopambwa baadaye la debug log; inapaswa kubuniwa tangu mwanzo kama sehemu tofauti ya bidhaa.
Je, Usanifu Huu Unaweza Kutumika Nje ya Benki?
Kulingana na chanzo, kanuni kuu inaweza kuhamishwa kwenda katika sekta nyingine zenye udhibiti mkali; lakini maelezo ya tabaka yanapaswa kubadilishwa kulingana na aina za data nyeti, change management na mahitaji ya audit.
Mifano:
- Afya: HIPAA na PHI sanitization.
- Nishati: NERC CIP change management.
- Serikali: FedRAMP, FISMA na data sovereignty.
- Mifumo ya AI ya hatari kubwa katika EU: mahitaji ya governance yanayolingana na AI Act.
Matokeo yanayoungwa mkono na utafiti
- Mahitaji ya udhibiti yanaweza kubadilisha usanifu wa mfumo wa LLM katika kiwango cha msingi.
- Sanitization inaweza kujengwa kama tabaka linalojitegemea kutoka inference.
- Kufanya Tier 3 actions kuwa zisizowezekana kiufundi ni udhibiti wenye nguvu zaidi kuliko marufuku inayotegemea prompt.
- Shadow mode hutoa ushahidi muhimu kwa validation.
- Model-provider abstraction inaweza kupunguza concentration risk.
- Audit trail ni muhimu kwa compliance na post-incident review.
- Hata utendaji wa LLM ukipungua katika incident ngumu, inaweza kutoa thamani kwa kupunguza nafasi ya hypothesis.
Matokeo yasiyoungwa mkono na utafiti
- Haipendekezwi kwamba LLM i-automate incident response kikamilifu.
- Matokeo ya benchmark ya sintetiki hayawezi kujumlishwa moja kwa moja kwa benki zote au LLM zote.
- Matokeo ya %100 sanitization si dhamana ya ulimwengu halisi kwamba hakutakuwa na data leakage.
- Haidaiwi kwamba Tier 3 autonomy ni salama leo.
- Haidhaniwi kwamba kanuni hazitabadilika siku zijazo.
- Accuracy loss katika data za uzalishaji haijapimwa moja kwa moja na utafiti huu.
Masuala yaliyo wazi
Chanzo kinaacha masuala matatu muhimu bila kutatuliwa:
- Ni taarifa kiasi gani sanitization hupoteza katika diagnostic accuracy.
- Ni lini production-modifying AI actions zinaweza kupanuliwa kwa usalama.
- Jinsi framework za jadi za Model Risk Management zinavyoweza kubadilishwa kwa mifumo ya non-deterministic na emergent LLM.
Maelezo ya Chanzo na Mbinu
Kichwa asili: A Reference Architecture for LLM-Powered Incident Response in Regulated Financial Services
Mwandishi: Ganesh Kutty Murugan
Barua pepe: ganesh6776@gmail.com
Aina ya kazi: Usanifu rejea, uzoefu wa mtaalamu na tathmini ya sintetiki.
Tarehe ya uchapishaji: Haijaelezwa wazi ndani ya PDF.
DOI: Haijatolewa katika PDF ya chanzo.
Jarida / mchapishaji / juzuu / toleo: Haijaelezwa katika chanzo.
Hali ya peer-review: PDF haina taarifa inayoonyesha uchapishaji uliopitia peer review.
Vyanzo vikuu vya udhibiti: SOX/PCAOB AS 2201, PCI DSS v4.0.1, OCC Bulletin 2011-12 / Federal Reserve SR 11-7, FFIEC IT Examination Handbook, U.S. Treasury AI cybersecurity guidance, EO 14110 na NIST AI RMF.
Vyanzo vikuu vya kiufundi: Microsoft/EuroSys root-cause study, Google SRE AI-assisted incident-management material, log-anomaly literature, vitabu vya SRE na vyanzo vya AIOps.
Mbinu ya tathmini: Rekodi za hadharani za banking outage, payment-processor post-mortem na synthetic distributed-system failure patterns zikitengeneza incident corpus yenye viwango vinne vya ugumu.
Modeli iliyotathminiwa: Chanzo kinatumia usemi “current-generation commercial LLM” kwa kipindi cha mapema 2025 lakini hakitaji jina la modeli.
Uzoefu wa utekelezaji uliotajwa katika chanzo: Takriban wiki tisa za shadow mode; karibu miezi 14 ya maendeleo kutoka wazo la kwanza hadi mwisho wa shadow validation.
Kikomo kikuu cha tafsiri: Matokeo haya yanategemea uzoefu wa usanifu wa mwandishi na mpangilio wa majaribio ya sintetiki. Data za uzalishaji wa benki hazijachapishwa na hakuna replication huru kati ya taasisi iliyowasilishwa.
Kuhusu mwandishi: Chanzo kinasema Ganesh Kutty Murugan ni Principal Site Reliability Engineer mwenye miaka 17 ya uzoefu katika production infrastructure na distributed systems, na ana shahada ya M.S. Software Engineering kutoka BITS Pilani.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *