

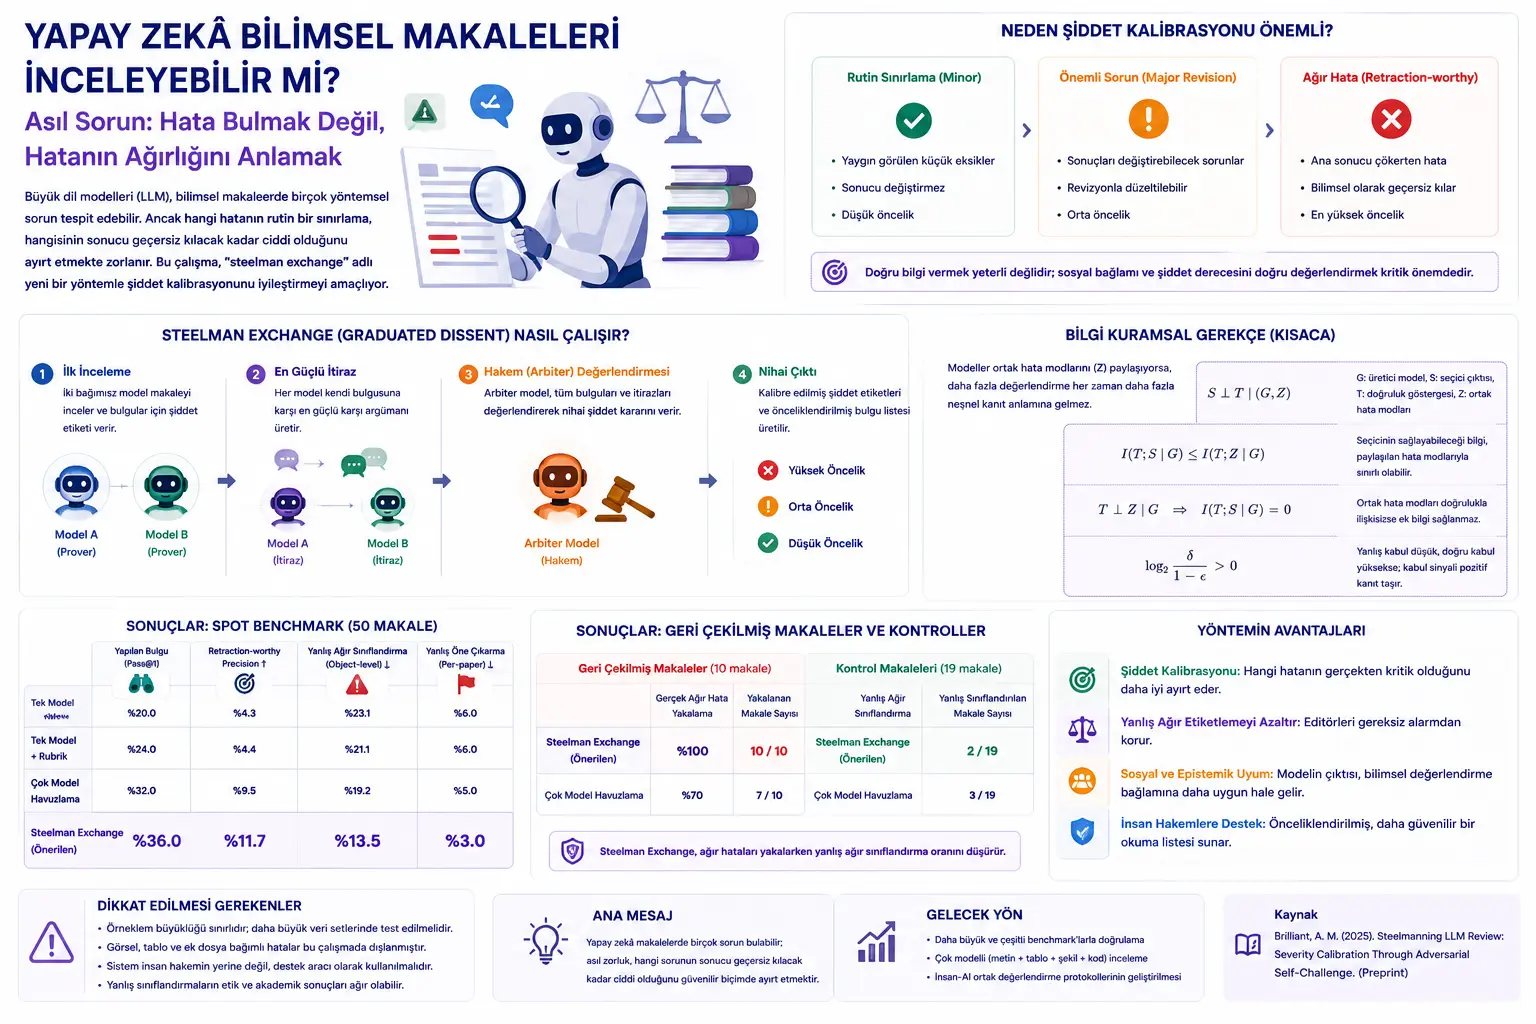
Miundo mikubwa ya lugha inazidi kutambua matatizo ya kimbinu, mapungufu ya kuripoti na uwezekano wa kutokuwiana katika makala za kisayansi. Lakini hoja muhimu ambayo utafiti huu unasisitiza ni hii: ikiwa mfumo wa akili bandia unaorodhesha matokeo mengi hauwezi kusema ni lipi muhimu kweli, badala ya kumsaidia mhariri au mhakiki huzalisha tu mzigo mpya wa kusoma.
Dhana iliyo katikati ya utafiti ni “severity calibration”, yaani kalibrasheni ya uzito. Tatizo hapa ni kutofautisha kama kosa fulani ni kubwa kiasi cha kubatilisha hitimisho kuu la makala, au kama ni kikomo cha kawaida tu. Kwa tathmini ya kisayansi, tofauti hii ni ya msingi. Kwa sababu si kila dosari ina uzito uleule.
Mwandishi anapendekeza mbinu ya kiadversarial inayoitwa “steelman exchange” kwa tatizo hili. Kwanza, modeli mbili tofauti hutathmini makala na kutoa lebo ya uzito kwa matokeo yao. Kisha kila modeli huzalisha hoja pinzani yenye nguvu zaidi dhidi ya tathmini yake ya kwanza: “Je, ugunduzi huu kweli ni mzito kiasi hiki, au umepewa uzito mkubwa kupita kiasi?” Katika hatua ya mwisho, modeli ya arbiter huona nyenzo zote na kutoa uamuzi wa uzito ulio wa tahadhari zaidi.
Matokeo makuu ni haya: Kukusanya tu matokeo kutoka modeli nyingi kunaweza kutoa ugunduzi zaidi, lakini hakuboreshi moja kwa moja kalibrasheni ya uzito. Kinyume chake, modeli zinazolazimishwa kuzalisha pingamizi lenye nguvu dhidi ya madai yao wenyewe zinaweza kutoa matokeo ya uangalifu zaidi na yenye matumizi zaidi, hasa katika uainishaji wa makosa mazito ya kiwango cha “yanayostahili uondoaji wa makala”.
Problem Ne?
Katika ukaguzi wa makala za kisayansi, akili bandia ina ahadi inayoonekana kuvutia sana mwanzoni: inaweza kusoma makala haraka, kuorodhesha matatizo ya kimbinu, kuashiria kutokuwiana kwa takwimu na kusaidia wahakiki. Lakini tatizo linalojitokeza kiutendaji si kupata kosa tu. Tatizo kuu ni kutofautisha ni makosa gani kati ya hayo ni muhimu kweli.
Ikiwa mfumo unazalisha matokeo 15 kwa makala moja, lakini sehemu ndogo sana kati yao ndiyo muhimu kweli, mhariri binadamu bado analazimika kutathmini orodha yote moja moja. Katika hali hii mfumo haujafanya triage, yaani kupanga vipaumbele; umeunda tu orodha ya kusoma yenye kelele nyingi.
Hiki ndicho kikwazo cha msingi kinachoshughulikiwa na utafiti: Miundo mikubwa ya lugha inaweza kupata matatizo mengi katika maandishi ya kisayansi; lakini haiwezi kila mara kutofautisha kwa kuaminika kati ya “upungufu mdogo wa kuripoti”, “tatizo kubwa la kimbinu linalohitaji marekebisho makubwa” na “kosa fatal linaloangusha hitimisho kuu la makala”.
Tatizo hili linakuwa muhimu zaidi katika uchapishaji wa kisayansi unaosaidiwa na akili bandia. Kadiri matumizi ya AI katika uandishi wa makala yanavyoongezeka, ubora wa juu juu wa uandishi unaweza kuacha kuwa kiashiria cha kuaminika cha ubora. Kile ambacho wahariri na wahakiki wanahitaji si mifumo inayosema tu “huenda kuna tatizo katika makala hii”; wanahitaji mifumo inayojibu kwa kalibrasheni bora zaidi swali la “tatizo hili ni kubwa kiasi gani?”
Yöntem Ne Öneriyor?
Utafiti unapendekeza usanifu wa tathmini wa hatua nyingi unaoitwa “graduated dissent”. Usanifu huu hauoni ukaguzi wa makala ya kisayansi kama pato la mara moja la modeli moja, bali kama mchakato unaodhibitiwa wa pingamizi na tathmini upya.
Katika hatua ya kwanza, modeli mbili tofauti za prover huchunguza makala iliyofichwa utambulisho kwa kujitegemea. Kila modeli huzalisha matokeo yake na kuyaweka katika mojawapo ya madarasa matatu ya uzito: retraction-worthy, major-revision au minor. Retraction-worthy humaanisha kosa zito linalofanya hitimisho kuu la makala lisiweze kuungwa mkono na data. Major-revision hueleza matatizo makubwa yanayoweza kubadilisha matokeo lakini hayaangushi utafiti kabisa. Minor ni ukosoaji wa kawaida unaoweza kuonekana katika machapisho mengi na ambao hautarajiwi kubadilisha hitimisho.
Hatua ya pili ndiyo sehemu asilia zaidi ya utafiti. Kila modeli hulazimishwa kujenga hoja yenye nguvu zaidi dhidi ya alama ya uzito iliyoitoa yenyewe. Hii ni kinyume cha mbinu ya kawaida ya “modeli ijitetee”. Mfumo hauiulizi modeli “kwa nini uko sahihi?”; unaiuliza “kwa nini ugunduzi huu unaweza kuwa si mzito kiasi unavyodhani?”
Katika hatua ya tatu, modeli ya arbiter huingia. Arbiter huona tathmini za kwanza, hoja pinzani na rubriki ya uzito pamoja. Lengo ni kupunguza lebo nzito zisizo za lazima na kutenganisha kwa uangalifu zaidi matokeo yaliyo muhimu kweli.
Mbinu hii ni tofauti na kukusanya matokeo kutoka modeli nyingi kwa namna rahisi. Kukusanya modeli nyingi huleta pamoja matokeo kutoka modeli tofauti. Lakini kwa kuwa modeli zinaweza kutoka katika taratibu zinazofanana za mafunzo na miundo sawa ya mrejesho wa binadamu, zinaweza kukuza aina zilezile za makosa kwa pamoja. Steelman exchange inalenga kuvunja kwa kiasi upendeleo huu wa pamoja kwa kuzilazimisha modeli kufikiri dhidi ya hukumu zao za awali.
Formüller Ne Anlatıyor?
Katika utafiti kuna matokeo ya majaribio pamoja na uhalalishaji wa kinadharia wa habari. Wazo la msingi ni hili: ikiwa modeli kadhaa zinashiriki maeneo yale yale ya upofu, kuzifanya zitathmini kosa lilelile tena na tena hakuzalishi ushahidi huru. Hili linaweza kuongeza tu ujasiri wa kimaoni; lakini huenda lisiongeze usahihi wa kimalengo kwa kiwango kilekile.
Usemi wa kwanza wa kinadharia wa habari katika utafiti unaeleza kwamba taarifa inayotolewa na kichaguaji inaweza kupunguzwa na modi za makosa zinazoshirikiwa. Hapa \(G\) huwakilisha modeli ya uzalishaji, \(S\) pato la kichaguaji/mtathmini, na \(T\) kiashiria cha ukweli. \(Z\) huwakilisha modi za pamoja za makosa ambazo modeli zinashiriki.
Usemi huu unaeleza kwamba \(G\) na modi ya pamoja ya kosa \(Z\) vikijulikana, pato la kichaguaji huenda lisibebe taarifa huru ya ziada kuhusu ukweli. Yaani watathmini wanaoshiriki maeneo yale yale ya upofu, hata wakiongezeka kwa mwonekano, huenda wasizalishe ushahidi huru kwa maana halisi.
Kikomo cha taarifa katika utafiti hutolewa hivi:
Hapa \(I(\cdot;\cdot)\) ni mutual information, yaani kipimo cha taarifa ya pamoja katika nadharia ya habari. Ujumbe mkuu ni huu: Taarifa ambayo mtathmini anaweza kutoa kuhusu ukweli inaweza kubaki imefungwa na taarifa inayobebwa na modi za makosa zinazoshirikiwa.
Katika hali maalumu, ikiwa modi ya pamoja ya kosa \(Z\) haina uhusiano wa masharti na ukweli, matokeo yafuatayo hupatikana:
Hili ni onyo kali lakini muhimu: ikiwa muundo wa kosa unaoshirikiwa na modeli hauhusiani na ukweli halisi, raundi za ziada za tathmini hazitoi taarifa mpya yenye maana kuhusu ukweli.
Kikomo kinachotolewa kwa ukosoaji binafsi unaorudiwa au vichaguaji vingi hufuata mantiki ileile:
Hapa \(A_{1:k}\) huwakilisha ishara nyingi za tathmini au kukubali. Tafsiri yake ni hii: katika hali ya makosa yenye uhusiano wa pamoja, tathmini nyingi zaidi hazimaanishi ushahidi wa kimalengo zaidi.
Hali inayolengwa na steelman exchange ni kwamba ishara ya kukubali ibebe ushahidi chanya kweli. Katika utafiti, wazo hili linaelezwa kwa sharti lifuatalo:
Ikiwa uwezekano wa kukubali katika hali isiyo sahihi ni mdogo, na uwezekano wa kukubali katika hali sahihi ni mkubwa, basi ishara ya kukubali hubeba taarifa chanya kuhusu ukweli.
Katika hali hii, kiasi cha ushahidi kinachotolewa na kukubali huonyeshwa hivi:
Fomula hii inaeleza kwa nini steelman exchange inaweza kufanya kazi: lengo si kuzifanya modeli nyingi zaidi zizungumze, bali kufanya iwe vigumu kwa uainishaji mzito usio sahihi kukubaliwa kirahisi.
Grafik, Tablo ve Şema Ana Mesajı
Ujumbe mkuu wa jedwali la matokeo ni kwamba mbinu ya steelman exchange inaleta tofauti zaidi katika kalibrasheni ya uzito kuliko katika ugunduzi ghafi wa makosa. Katika jaribio la SPOT, usanifu wa steelman unafikia thamani ya asilimia 36 ya pass@1. Retraction-worthy precision, yaani kiwango cha makosa muhimu kweli ndani ya darasa zito zaidi la kosa, ni asilimia 11,7. Kiwango hiki ni cha juu zaidi kuliko katika usanifu mbadala na modeli huzalisha arifa chache zaidi za kiwango cha juu.
Mbinu ya modeli moja hufanya ugunduzi uliopunguka zaidi. Modeli moja iliyopewa rubriki huongeza kiwango cha ugunduzi, lakini bado hubaki dhaifu katika kalibrasheni ya uzito. Kukusanya modeli nyingi kunaweza kunasa baadhi ya makosa zaidi; lakini hakuleti uboreshaji wa wazi katika kutofautisha kwa usahihi zaidi darasa la kosa zito. Hili linaendana na onyo kuu la utafiti: kuongeza idadi ya modeli hakuongezi kiotomatiki ubora wa hukumu ikiwa makosa yana uhusiano wa pamoja.
Jaribio la pili lililofanywa kwa makala zilizofutwa na makala za udhibiti linaonyesha upande mwingine wa mbinu. Steelman exchange hunasa makosa yote 10 yaliyosababisha uondoaji; katika makala za udhibiti, kulingana na ukaguzi wa modeli huru ya nje, hutoa uainishaji mzito usio sahihi katika 2 kati ya makala 19 za udhibiti. Kukusanya modeli nyingi hunasa makosa 7 kati ya 10 na hufanya uainishaji mzito usio sahihi katika 3 kati ya makala 19 za udhibiti. Matokeo haya yanadokeza kwamba mbinu ya steelman inaweza kufanya kazi kwa usawa zaidi hasa katika kutofautisha “ni kosa zito la uondoaji au siyo?”
Ulinganisho uliosawazishwa kwa bajeti pia ni muhimu. Wakati idadi ileile ya miito ya API inatumika, kuongeza tu raundi zaidi za kufikiri au tafakari isiyoegemea upande wowote hakuletei kalibrasheni kama steelman. Yaani matokeo hayaonekani kutokea “kwa sababu modeli nyingi zaidi zimeendeshwa”; yanaweza kuwa yanatokana na kulazimishwa kwa modeli kutoa pingamizi kali dhidi ya hukumu zao za kwanza za uzito.
Skimu ya jumla ya utafiti hufanya tofauti ya hatua tatu katika tathmini ya makala za kisayansi ionekane wazi: kwanza kosa linapatikana, kisha umuhimu wa kosa unajadiliwa, na mwishowe mpangilio wa vipaumbele unaoweza kuchukuliwa hatua na binadamu hutolewa. Mchango mkuu wa utafiti ni kutambua hatua ya pili, yaani kalibrasheni ya uzito, kama tatizo tofauti.
Deneyler Nasıl Yapılmış?
Katika utafiti, hali kuu nne za tathmini hulinganishwa. Hali ya kwanza ni tathmini ya modeli moja. Hali ya pili ni modeli moja kupewa rubriki wazi ya uzito. Hali ya tatu ni kukusanya matokeo kutoka modeli nyingi. Hali ya nne ni graduated dissent, yaani usanifu wa modeli nyingi wa kiadversarial unaojumuisha steelman exchange.
Benchmark ya kwanza ni sehemu ndogo ya seti ya data ya SPOT yenye makosa yanayoweza kutambuliwa kupitia maandishi. Makala zinazohitaji kosa linalotegemea picha huondolewa na makala 50 hutathminiwa. Lengo hapa ni kupima kama mfumo hupata kosa lililoandikwa na kuliliweka kwa usahihi kiasi gani katika darasa la uzito.
Benchmark ya pili huundwa kwa makala zilizofutwa na makala za udhibiti zisizofutwa. Katika seti hii kuna makala 10 zilizofutwa na makala 19 za udhibiti. Lengo si tu kunasa kosa zito halisi, bali pia kutoweka makala imara za udhibiti kwa makosa kama “zinazostahili kufutwa”.
Kwa uthibitishaji, muundo wa udhibiti wa tabaka nyingi hutumiwa. Rekodi za makosa zilizothibitishwa na binadamu za SPOT, itifaki ya kulinganisha ya LLM-as-judge, ukaguzi wa modeli za kiadversarial, human spot-check na uthibitishaji kipofu wa binadamu hutumiwa pamoja. Katika benchmark ya makala zilizofutwa, matokeo chanya yasiyo sahihi hukaguliwa tena kwa ukaguzi wa modeli za in-family na out-of-family.
Katika majukumu ya modeli hutumiwa familia tofauti za modeli. Modeli mbili za prover hufanya ukaguzi kwa kujitegemea; modeli ya arbiter hutoa uamuzi wa mwisho. Lengo la utafiti si kulinganisha familia za modeli, bali kupima athari ya miundo tofauti ya usanifu juu ya kalibrasheni ya uzito.
Sonuçlar Ne Gösteriyor?
Hitimisho la kwanza ni kwamba katika ukaguzi wa makala za kisayansi, kupata kosa ghafi hakutoshi tena peke yake. Miundo mikubwa ya lugha inaweza kuashiria matatizo mengi; lakini ikiwa haiwezi kuyapa kipaumbele, inaweza kuongeza mzigo wa mhakiki binadamu badala ya kuupunguza.
Hitimisho la pili ni kwamba mbinu ya steelman exchange huzalisha matokeo yenye matumizi zaidi katika kalibrasheni ya uzito. Katika jaribio la SPOT, thamani ya juu zaidi ya pass@1 na retraction-worthy precision ya juu zaidi vinaonekana katika mbinu hii. Wakati huo huo, idadi ndogo ya arifa za kiwango cha juu inamaanisha kwamba mhakiki binadamu hukutana na kelele chache zaidi.
Hitimisho la tatu ni kwamba kukusanya modeli nyingi kuna mipaka. Kukusanya matokeo kutoka modeli kadhaa kunaweza kuongeza kiwango cha ugunduzi kidogo; lakini ikiwa upendeleo na mifumo ya tathmini ya aina moja inashirikiwa, uainishaji wa makosa mazito hauboreshwi. Kuongeza modeli si sawa na kuzalisha ushahidi huru.
Hitimisho la nne ni kwamba pingamizi la kiadversarial dhidi ya tathmini ya mtu mwenyewe lina kazi tofauti. Modeli inapolazimishwa kutoa pingamizi lenye nguvu dhidi ya ugunduzi wake badala ya kuutetea, sehemu ya uainishaji mzito kupita kiasi huondolewa. Hili ni muhimu sana katika uchapishaji wa kisayansi; kwa sababu lebo isiyo sahihi ya “inastahili kufutwa” inaweza kuleta matokeo makubwa kwa mtafiti, mhariri na mfumo wa uchapishaji.
Hitimisho la tano ni kwamba mbinu bado imejaribiwa kwa sampuli finyu. Ingawa matokeo yanatia matumaini, yanapaswa kujaribiwa tena kwa seti kubwa zaidi za data, kutoka nyanja tofauti, na zinazojumuisha makosa yanayotegemea picha/jedwali.
Bu Neden Önemli?
Msaada wa akili bandia katika uchapishaji wa kisayansi unaongezeka kwa namna ambayo haiwezi kuepukika. Wahariri, wahakiki na timu za uadilifu wa utafiti wanaweza kuhitaji mifumo inayoweza kuchuja idadi kubwa ya makala kwa haraka zaidi. Lakini kasi peke yake haitoshi. Mfumo unaozalisha arifa za uongo hauleti uaminifu; badala yake hutumia muda wa wataalamu binadamu.
Utafiti huu unaonyesha kwamba kipimo cha msingi katika ukaguzi wa kisayansi unaosaidiwa na akili bandia kinapaswa kubadilika. Swali “Je, modeli ilipata kosa?” ni muhimu, lakini kivitendo swali “Je, modeli iliweza kutofautisha kosa lipi ni muhimu kweli?” ni muhimu sawa, hata zaidi.
Tofauti hii ni nyeti kwa ekolojia ya kitaaluma. Kuwasilisha upungufu mdogo wa kuripoti katika makala kama anguko zito la kimbinu kunaweza kusababisha madhara yasiyo ya haki. Kwa upande mwingine, kuonyesha kosa linalobatilisha kweli matokeo kama “kikomo cha kawaida” pia kunaweza kuchafua fasihi ya kisayansi. Kwa hiyo kalibrasheni ya uzito inapaswa kuwa kiini cha udhibiti wa ubora wa kisayansi.
Utafiti pia unatoa somo la jumla zaidi kwa mifumo ya akili bandia yenye mawakala wengi. Kutumia modeli nyingi peke yake si dhamana ya uaminifu. Kinachoamua ni jinsi modeli zinavyokaguliwa na kuzalisha pingamizi dhidi ya nyingine, kiwango cha uhuru zilicho nacho, na katika kazi gani zinalazimishwa kutoa aina gani ya pingamizi.
Dikkat Noktaları
Hoja ya kwanza ya tahadhari ni ukubwa wa sampuli. Benchmark ya makala zilizofutwa ina makala 10 zilizofutwa na makala 19 za udhibiti. Hii inatoa ishara ya awali yenye nguvu kwa mbinu, lakini haitoshi kwa ujumlishaji mkubwa.
Hoja ya pili ya tahadhari ni sehemu ndogo ya SPOT. Tathmini imefanywa tu kwa makosa yanayoweza kutambuliwa kupitia maandishi. Makosa yanayohitaji grafu, jedwali, picha au faili ya ziada ya data yako nje ya wigo huu. Sehemu muhimu ya makosa ya kisayansi inaweza kutegemea picha, faili za takwimu au maelezo ya muundo wa majaribio.
Hoja ya tatu ya tahadhari ni upangaji alama. Ingawa utafiti hutumia uthibitishaji wa tabaka nyingi, katika baadhi ya hali kunaweza kuwa na kutokubaliana kati ya wakaguzi huru. Hii hukumbusha kwamba tathmini ya kosa la kisayansi yenyewe pia inaweza kuwa ya kutafsiriwa.
Hoja ya nne ya tahadhari ni uhusiano wa modeli. Steelman exchange inalenga kupunguza mifumo ya makosa inayoshirikiwa; lakini haiwezi kuondoa kabisa kufanana kwa kiwango cha parameta kati ya modeli kubwa zilizofunzwa katika ekolojia ileile ya data. Kwa hiyo mfumo unapaswa kufikiriwa kama msaada wa kupanga kipaumbele, si kama mbadala wa mhakiki binadamu.
Hoja ya tano ya tahadhari ni gharama na mtiririko wa kazi. Inaelezwa kwamba pipeline kamili hufanya kazi kwa gharama ya takribani dola 1,25 kwa kila makala. Gharama hii inaweza kuonekana ndogo; lakini katika mitiririko mikubwa ya uchapishaji, gharama halisi ya kiutendaji pamoja na uthibitishaji wa ziada na ukaguzi wa binadamu inapaswa kuhesabiwa kivyake.
Hatimaye, maudhui haya si ushauri wa maadili ya uchapishaji au uamuzi wa kiuhariri. Maamuzi kama kufuta makala, kuikataa au kuituma kwa marekebisho makubwa yanapaswa kutathminiwa na wataalamu wa eneo, wahariri, watakwimu na kamati za maadili.
Sonuç
Utafiti huu unaashiria hatua muhimu katika ukaguzi wa makala za kisayansi kwa kutumia akili bandia. Suala si tena tu “Je, LLM inaweza kupata kosa katika makala?” Swali muhimu zaidi ni hili: Je, LLM inaweza kutofautisha ni lipi kati ya makosa inayopata ni zito kweli?
Mbinu inayopendekezwa ya steelman exchange inalenga kupunguza tathmini nzito kupita kiasi na kupanga makosa muhimu kwa namna yenye matumizi zaidi kwa kuzilazimisha modeli kufikiri dhidi ya hukumu zao za kwanza. Matokeo ya majaribio yanaonyesha kwamba usanifu huu unaweza kutoa kalibrasheni bora zaidi ya uzito kuliko kukusanya modeli nyingi kwa urahisi, katika benchmark ya SPOT na katika benchmark ya makala zilizofutwa.
Kwa Verianla, ujumbe mkuu wa utafiti ni wazi: Katika tathmini ya kisayansi, thamani ya akili bandia haipimwi kwa idadi ya matatizo inayoorodhesha, bali kwa uwezo wake wa kutofautisha kwa kuaminika ni tatizo gani ni muhimu kweli. Kutumia modeli nyingi hakutoshi; kinachoamua ni jinsi modeli hizo zinavyopingana na jinsi uamuzi wa uzito unavyokalibrishwa.
Kaynak ve Yöntem Notu
Maudhui haya yameandaliwa kwa kutegemea utafiti wenye kichwa “Steelmanning LLM Review: Severity Calibration Through Adversarial Self-Challenge” ulioandikwa na Andrew Michael Brilliant. Utafiti unachunguza kalibrasheni ya uzito katika tathmini ya makala za kisayansi inayotegemea LLM, steelman exchange, graduated dissent, kukusanya modeli nyingi na fremu ya kinadharia ya habari kuhusu uhusiano wa makosa.
Maudhui haya si tafsiri ya neno kwa neno; wazo kuu la utafiti limegeuzwa kuwa makala asilia ya kiuhariri ya Kituruki kwa mtindo wa uchapishaji wa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *