

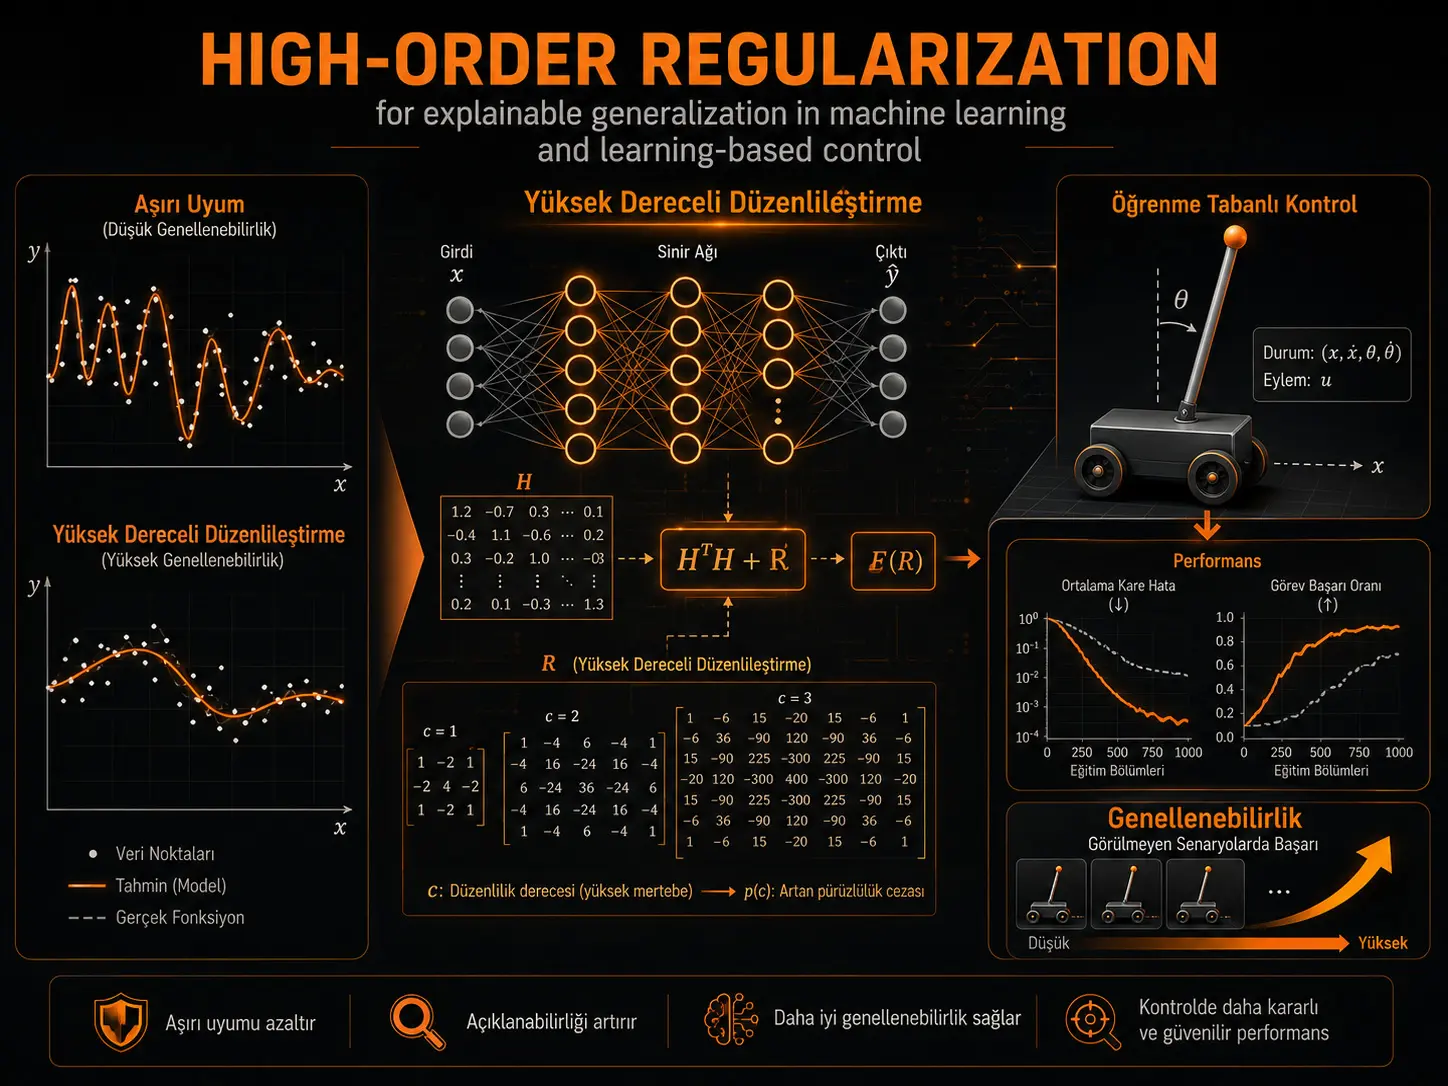
Utafiti huu unapendekeza mbinu inayoitwa High-Order Regularization (HR) — Urekebishaji wa Daraja la Juu kwa lengo la kueleza kihisabati kwa nini na kwa namna gani regularization hubadilisha uwezo wa ku-generalize huku ikipunguza overfitting katika mitandao ya neva. HR huchukulia ukokotoaji wa uzani unaojifunzwa unaotoka kwenye safu ya mwisho iliyofichwa ya mtandao wa neva hadi kwenye pato kama tatizo la inverse mapping, na hukadiria inverse ya matriksi ya taarifa \(H^\top H\) kwa mfululizo wenye kikomo wa powers za matriksi. Regularization ya kawaida ya L2-norm hujitokeza katika mfumo huu kama hali maalum ya daraja la chini yenye \(c=0\), huku katika matumizi mengi ya utafiti huu ikitumika \(c=1\). Sehemu ya kinadharia hutengeneza convergence, mipaka ya chini na ya juu ya kosa inayoweza kukokotolewa, na kigezo cha generalization kinachodhibiti condition number kupitia regularization matrix. Katika majaribio, HR ilitoa reward/accuracy ya juu au RMSE ya chini kuliko mbinu zilizolinganishwa katika udhibiti wa Cart-Pole, uainishaji wa IRIS na MNIST, na matatizo matatu ya regression. Hata hivyo, majaribio yalifanywa kwenye idadi ndogo ya matatizo, mgawanyo wa data uliundwa mahsusi ili kuhimiza overfitting, na scalability katika usanifu mkubwa wa kisasa wa deep neural networks bado haijaonyeshwa kwa majaribio.
Katika jaribio la Cart-Pole ambapo kikomo cha time step kiliondolewa, wastani wa reward wa episodes 50 za mwisho uliripotiwa kuwa 207,4 kwa Q-network, 208,2 kwa EQLM na 273,4 kwa HR iliyopendekezwa. Waandishi wanaeleza matokeo haya kuwa ni uboreshaji wa %31,8 dhidi ya Q-network na %31,3 dhidi ya EQLM. Hata hivyo, variability kati ya runs kwa HR ni kubwa; jedwali hilo hilo linatoa standard deviation ya 323,7 kwa HR. Kwa hiyo wastani mkubwa wa performance haumaanishi variance ndogo.
Katika jaribio la Cart-Pole lenye kikomo cha kawaida cha time step 200, reward ya HR kwa episodes 50 za mwisho ni 175,2 wakati Q-network ni 123,8; thamani za AUC zimeripotiwa kuwa \(87,5\times10^3\) na \(71,0\times10^3\) mtawalia. Waandishi wanazitafsiri kama ongezeko la %41,5 na %23,2 mtawalia. Katika jaribio hili lililodhibitiwa, usambazaji wa reward za HR ni mwembamba zaidi kuliko katika jaribio lisilo na kikomo cha time step.
Mwelekeo huohuo unaonekana katika majaribio ya machine learning. Test accuracy ya IRIS ni %95,0 kwa HR; %94,2 kwa Dropout; %93,3 kwa L2-norm na %87,5 kwa FNN bila regularization. Katika MNIST, wakati picha 1.000 tu za mafunzo zinatumika, HR ilitoa accuracy ya %84,1, Dropout %83,4, L2-norm %82,7 na FNN %59,0. Ulinganisho huu unaonyesha faida ya HR katika test zilizochaguliwa; lakini utafiti hauripoti distribution ya majaribio yaliyorudiwa, confidence interval au statistical significance test kati ya mbinu kwa matokeo haya ya jedwali.
Kwa mtazamo wa Uturuki: Mbinu ya HR inatoa njia ya kihisabati inayoweza kuchunguzwa katika machine learning, robotiki, adaptive control, industrial automation au decision systems zinazofanya kazi na data ya mafunzo yenye ukomo/upendeleo nchini Uturuki. Hata hivyo, thamani za performance katika utafiti huu haziwezi kuhamishwa moja kwa moja kwenye mfumo wowote halisi nchini Uturuki. Kwa matumizi ya ndani, data distribution husika, network architecture, vifaa vya kukokotoa, real-time constraints, safety requirements na independent benchmark dhidi ya mbinu zilizopo lazima zithibitishwe tofauti.
Tatizo kuu la utafiti ni nini?
Regularization hutumiwa kwa upana ili kuzuia mtandao wa neva ku-overfit data ya mafunzo na kusaidia ufanye vizuri zaidi kwenye data ambayo haijaonekana. Ingawa mafanikio ya vitendo ya L2, L1, dropout, mixup, early stopping na mbinu zinazofanana yanajulikana, pengo linalolengwa na utafiti huu ni kueleza kwa uwazi zaidi regularization inabadilisha vipi suluhisho la awali kihisabati, inazalisha bias gani, na usawa kati ya bias hiyo na generalization unaweza kukokotolewaje.
Kielelezo 1 kinaonyesha tatizo hili kupitia regression na classification. Modeli changamano zinazojipinda sana ili kufuata training points zinaonyeshwa kwa rangi ya bluu, na modeli zilizoregularize zenye complexity ndogo kwa mistari myeusi. Ujumbe mkuu wa mchoro ni kwamba modeli inayofuatilia training samples vizuri zaidi si lazima iwe modeli bora kwa data ambayo haijaonekana.
Kwa nini uchanganuzi umejengwa juu ya Extreme Learning Machine?
Utafiti unatumia usanifu wa Extreme Learning Machine (ELM) ili kuweza kutoa theory kwa uwazi. ELM ni feedforward network yenye hidden layer moja; weights kutoka input hadi hidden layer na bias inayowezekana huwekwa kwa nasibu, huku weights za \(\beta\) kutoka hidden layer hadi output pekee ndizo hukokotolewa analytically.
Kielelezo 2 kinaonyesha usanifu wa ELM ambapo input nodes zinaunganishwa na hidden nodes, na hidden nodes na outputs. Kwa input sample \(x_j\), output ya mtandao inaandikwa:
\[ \sum_{i=1}^{L}\beta_i g_i(x_j) = \sum_{i=1}^{L}\beta_i g_i(w_i\cdot x_j+b_i) = o_j \]
Hapa \(L\) ni idadi ya hidden nodes, \(w_i\) ni random input weights, \(b_i\) ni bias, \(g_i\) ni activation function, na \(\beta_i\) ni learnable output weight.
Tatizo la msingi la mafunzo linaandikwa:
\[ \min_{\beta\in\mathbb{R}^{L\times k}} \left\|H\beta-Y\right\|^2 \]
\(H\) ni hidden-layer output matrix na \(Y\) ni training label. Bila regularization, minimum-norm least-squares solution hupatikana kwa Moore–Penrose pseudoinverse:
\[ \hat{\beta}=H^\dagger Y \]
.
L2 regularization inaonekanaje ndani ya muundo huu?
Chanzo kinatoa classic L2-regularized solution kama:
\[ \hat{\beta} = \left( H^\top H+\frac{I}{\mu} \right)^\dagger H^\top Y \]
. Operesheni hii inaweza kufanya \(H^\top H\) iliyo badly conditioned kuwa numerically stable zaidi; lakini regularization pia huleta estimation bias ikilinganishwa na theoretical optimal solution. HR inajaribu kufafanua bias hii moja kwa moja kama approximate inverse-mapping error.
High-Order Regularization inatolewaje?
Sehemu ya kuanzia ya HR ni:
\[ F(R) := R\left(H^\top H+R\right)^{-1} \]
. Hapa \(R\) ni regularization matrix inayoweza kuchaguliwa. Chini ya sharti linalofaa la spectral radius:
\[ (I-F(R))^{-1} = \sum_{i=0}^{\infty}F^i(R), \qquad \rho(F(R))<1 \]
matrix power series inaweza kutumika. Infinite series ikikatwa baada ya terms \(c+1\), suluhisho la HR linalopendekezwa linapatikana:
\[ \hat{\beta}_{hr} = \left(H^\top H+R\right)^{-1} \sum_{i=0}^{c} F^i(R)H^\top Y, \qquad \rho(F(R))<1 \]
\(c\) ni regularization order. Ikiwa \(c=0\) na \(R=\bar{\mu}I\), suluhisho hupungua hadi namna ya traditional L2-norm regularization. Ikiwa \(c\geq1\), inverse mapping hukadiriwa kwa terms nyingi za matrix series, na ndiyo maana utafiti unaiita “high-order” regularization.
Kwa nini L2 inachukuliwa kuwa hali maalum ya HR?
Katika HR, ikiwa \(c=0\), series ina identity term pekee:
\[ \sum_{i=0}^{0}F^i(R)=I \]
na:
\[ \hat{\beta}_{hr} = (H^\top H+R)^{-1}H^\top Y \]
hupatikana. Kuchagua \(R=\bar{\mu}I\) hutoa suluhisho la kawaida la L2/Tikhonov. Appendix A pia inaonyesha kwamba expected loss ya dropout inayotumika kwenye hidden layer ya mwisho inaweza kubadilishwa kuwa norm regularization:
\[ L(\beta)= \frac{1}{2N}\|y-H\beta\|_2^2+ \frac{1-p}{2pN} \beta^\top \operatorname{diag}(H^\top H) \beta \]
. Katika derivation hii maalum ya dropout, regularization coefficient \((1-p)/p\) inahusishwa na variance ya dropout noise.
Convergence ya suluhisho la HR inaelezwaje?
Katika utafiti, HR error inafafanuliwa:
\[ e_\beta=\hat{\beta}_{hr}-\beta_{opt} \]
. Theorem 1 inaonyesha kwamba chini ya masharti yaliyotolewa ya positive definiteness na spectral radius, HR solution error inaelekea sifuri regularization matrix inapokaribia sifuri au regularization order inapokwenda infinity:
\[ \lim_{R\rightarrow O}\|e_\beta\|=0, \qquad \lim_{c\rightarrow+\infty}\|e_\beta\|=0 \]
. Matokeo haya yanawezesha truncation error ya HR series kuhusishwa moja kwa moja na regularization matrix na order ya series.
Kwa nini kosa linachukuliwa kuwa linaweza kukokotolewa?
Inverse-matrix approximation error inafafanuliwa:
\[ F_{ar}(R) = (H^\top H)^{-1} - (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
. Chini ya masharti yanayofaa:
\[ F_{ar}(R) = (H^\top H)^{-1}F^{c+1}(R) \]
hupatikana. Utafiti kisha hutoa lower na upper bounds kwa HR solution error:
\[ \frac{1}{1-\lambda_{\min}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \leq \|e_\beta\| \]
na:
\[ \|e_\beta\| \leq \frac{1}{1-\lambda_{\max}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \]
. Kwa hiyo tofauti inayotokana na regularization ikilinganishwa na theoretical solution si penalty term ya kihisia tu, bali ni approximate inversion error inayoweza kufungiwa mipaka chini ya \(R\) na \(c\) zilizochaguliwa.
Kwa nini regularization inatafsiriwa kama contraction?
Katika Theorem 2, chini ya symmetric positive semidefinite \(R\) na positive definite \(H^\top H\), inaonyeshwa kuwa regularization matrix inaleta contraction kwenye approximation-error norm ya \(F_{ar}(R)\). Contraction rate inadhibitiwa na \(R\) pamoja na regularization order \(c\).
Kwa mtazamo huu, order ndogo inaweza kutengeneza umbali mkubwa kati ya theoretical optimum na regularized solution; terms nyingi zaidi za series huboresha inverse-mapping approximation. Kwa upande mwingine, lazima kuwe na trade-off kati ya uwezo wa regularization kupunguza ill-conditioning na estimation bias.
“Maximum generalization” inamaanisha nini?
Badala ya kupima generalization moja kwa moja kwenye test distributions zote zinazowezekana, utafiti unaicharacterize kupitia \(H^\top H+R\) condition number kupitia
\[ \operatorname{Cond}(R) = \|H^\top H+R\| \, \|(H^\top H+R)^{-1}\| \]
. Condition number ndogo humaanisha tatizo lililo better conditioned, ambapo mabadiliko madogo kwenye training data hayageuki kuwa mabadiliko makubwa kupita kiasi kwenye weight solution. Balance criterion ya utafiti ni:
\[ \operatorname{Obj}(R) = \|F_{ar}(R)\| \operatorname{Cond}(R) \]
. Objective hii inazingatia estimation bias na ill-conditioning kwa pamoja.
Katika Proposition 2, ikiwa eigenvalues za \(H^\top H\) ni \(\lambda_i\), regularization matrix iliyoundwa kama:
\[ \lambda_{R,i} = \max\{\bar{\mu}-\lambda_i,0\} \]
inachunguzwa. Katika kigezo cha mathematical generalization cha utafiti, karibu na \(\bar{\mu}=\lambda_1\), condition number inaweza kupunguzwa hadi 1. Kauli ya “maximum generalization” iko ndani ya definition hii ya kinadharia based on condition number; haipaswi kutafsiriwa kama dhamana ya universal maximum performance kwenye real-world distributions zote.
Kielelezo 4 kinaelezaje regularization?
Kielelezo 4 ni muhtasari wa kuona wa maelezo ya kinadharia. Duara kubwa zaidi linawakilisha possible solutions za original network kwa training data na information matrix \(H^\top H\); kituo kinawakilisha theoretical optimal solution. Miduara midogo inaonyesha regularized solutions chini ya \(R\) matrices tofauti. Radius ya duara la dashed inawakilisha estimation bias kwa \(c\) fulani.
Ujumbe mkuu ni kwamba regularization yenye nguvu zaidi si bora moja kwa moja. Lengo ni kupata mchanganyiko wa \(R\) na \(c\) unaostabilize suluhisho bila kulisogeza mbali na theoretical optimum bila sababu.
HR inapanuliwaje kwa mappings singular au kubwa?
Network scale inapoongezeka, \(H^\top H\) inaweza kuwa singular. Utafiti unapanua general inverse-mapping approach kwa kutumia Moore–Penrose pseudoinverse. Approach inafafanuliwa:
\[ F_{aim}(H,R,c) = (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
na:
\[ F_{ar}(R) = (H^\top H)^\dagger-F_{aim}(H,R,c) \]
sasa inawakilisha general inversion approximation error. Theorem 3 inatoa:
\[ \lim_{c\rightarrow+\infty}F_{ar}(R) = (H^\top H)^\dagger-R^{-1} \]
. Tafsiri ya chanzo ni kwamba uchaguzi unaofaa wa \(R\) huruhusu approximate inversion error na conditioning kudhibitiwa pamoja hata katika mappings singular.
Incremental HR inafanyaje kazi?
Incremental High-Order Regularization (IHR) hu-update information matrix na weights zilizopo badala ya kufundisha mtandao mzima kutoka mwanzo kila mini-batch mpya inapokuja. Update ya msingi ni:
\[ \hat{\beta}_{t+1} = K_{t+1}(c)\hat{\beta}_t + F_{aim,t+1}H_{ic}^{\top}Y_{ic} \]
. Hapa mini-batch mpya \(H_{ic},Y_{ic}\) inaongezwa kwenye model iliyopo. Utafiti unajadili structure hii hasa katika learning-based control kwa muktadha wa kupunguza overfitting inayoweza kusababishwa na data chache na zenye ubora mdogo mwanzoni mwa learning.
Tafsiri ya HR kama “learning, memory na forgetting” ni nini?
Waandishi wanatafsiri regularization inayopunguza athari ya data isiyotosha au yenye bias katika hatua za mwanzo kama aina ya adaptive forgetting. Training inapoendelea na ubora pamoja na kiasi cha information kuongezeka, regularization inaweza kubadilika, na hili hutumiwa kueleza uhusiano kati ya kujifunza information mpya na uzito unaotolewa kwa information ya zamani.
Hii si ushahidi wa neurobiological memory mechanism; ni interpretation ya learning-based control ya mathematical regularization behavior.
Nini kilipatikana katika jaribio la Cart-Pole?
Tatizo la OpenAI Gym Cart-Pole lilitumika kulinganisha Q-network, EQLM na HR-EQLM. Katika majaribio bila time-step limit, wastani wa reward wa episodes 50 za mwisho katika runs 50 ulikuwa:
| Mbinu | Wastani wa reward wa episodes 50 za mwisho | AUC (×10³) |
|---|---|---|
| Q-network | 207,4 (176,2–236,3) | 107,8 (103,8–111,8) |
| EQLM | 208,2 (188,51–224,98) | 97,2 (90,3–103,3) |
| HR iliyopendekezwa | 273,4 (166,1–340,3) | 116,3 (86,1–136,8) |
HR ilitoa wastani mkubwa zaidi wa reward. Hata hivyo, katika Jedwali 4 hilo hilo standard deviation ni 108,7 kwa Q-network, 66,2 kwa EQLM na 323,7 kwa HR. Wastani mkubwa wa HR umeathiriwa na runs chache zenye reward kubwa zaidi ya time steps 200; hivyo variability kati ya runs inapaswa kuzingatiwa pamoja na ongezeko la wastani.
Matokeo yanabadilikaje katika jaribio la time steps 200?
Kwa kikomo cha kawaida cha time steps 200, ulinganisho ulifanywa katika performance range nyembamba zaidi:
| Mbinu | Wastani wa reward wa episodes 50 za mwisho | AUC (×10³) |
|---|---|---|
| Q-network | 123,8 (112,4–135,5) | 71,0 (68,8–73,5) |
| HR iliyopendekezwa | 175,2 (169,6–180,9) | 87,5 (84,7–90,5) |
Chanzo kinaripoti HR imeboresha reward ya episodes 50 za mwisho kwa %41,5 na AUC kwa %23,2. Standard deviation ya HR ni 20,3 na ya Q-network ni 41,9.
Matokeo ya IRIS na MNIST yanaonyesha nini?
Katika classification experiments, FNN, Dropout, L2-norm na HR ya \(c=1\) zililinganishwa:
Verianla Live: Accuracy ya classification ya mbinu za regularization
Ulinganisho unaonyesha test accuracies zilizoripotiwa katika Jedwali 6. Jaribio la MNIST lilifanywa kwa picha 1.000 tu za mafunzo; kwa hiyo thamani hizi hazipaswi kutafsiriwa kama standard benchmark kwa full MNIST training set.
| Data set | FNN | Dropout | L2-norm (c=0) | HR iliyopendekezwa (c=1) | Kitengo | Chanzo |
|---|---|---|---|---|---|---|
| IRIS | 87,5 | 94,2 | 93,3 | 95,0 | Test accuracy (%) | Jedwali 6 |
| MNIST | 59,0 | 83,4 | 82,7 | 84,1 | Test accuracy (%) | Jedwali 6 |
HR ilitoa test accuracy ya juu katika data sets zote mbili. Hata hivyo, tofauti kati ya HR na Dropout ni percentage point 0,8 katika IRIS na 0,7 katika MNIST. Kwa kuwa hakuna statistical significance test au confidence interval ya repeated runs, tofauti hizi ndogo hazipaswi kutafsiriwa kama faida ya jumla inayoweza ku-generalize.
Nini kilipatikana katika regression experiments?
Katika regression tasks, Root Mean Squared Error (RMSE) ndogo inaashiria performance bora:
| Data set | FNN RMSE | Dropout RMSE | L2-norm RMSE | HR (c=1) RMSE |
|---|---|---|---|---|
| Weather prediction | 4,2274 | 2,1575 | 2,7061 | 2,0888 |
| Power consumption | 0,7488 | 0,7140 | 0,7474 | 0,7096 |
| Appliances energy | 87,7197 | 79,0572 | 79,4058 | 77,3815 |
HR ilitoa RMSE ya chini zaidi katika regression tests zote tatu. Katika Weather prediction tofauti kati ya Dropout na HR ni ndogo kiasi, huku FNN bila regularization ikiwa na kosa kubwa zaidi.
Vielelezo 12 na 13 vinaonyesha nini?
Kielelezo 12 cha Appliances Energy kinaonyesha prediction-minus-actual error kwa muda kwa FNN, L2, HR na Dropout. Kielelezo 13 kinalinganisha distributions za makosa hayo. Error distributions za regularized models zinajikusanya kwa namna inayofanana karibu na sifuri.
Ili kupunguza bias inayotokana na regularization katika regression models, bias correction ilitumika kwa validation data iliyotengwa na training data. Kwa hiyo matokeo ya regression kwenye jedwali yanajumuisha athari ya raw regularized solution pamoja na validation-based correction process.
Matokeo yanayoungwa mkono na utafiti
- HR imeundwa wazi kama truncated matrix-power-series approximate inversion.
- L2-norm regularization inaweza kuandikwa kama hali maalum ya \(c=0\) ndani ya HR.
- Chini ya masharti ya matrix yaliyoainishwa, convergence ya HR solution na error bounds zinazoweza kukokotolewa zimetolewa kinadharia.
- Regularization matrix na order hudhibiti contraction rate ya approximate inversion error.
- Katika definition ya condition-number-based ya utafiti, eigenvalue structure ya \(R\) inaweza kutengenezwa ili ku-optimize generalization criterion.
- Katika Cart-Pole, classification na regression tests zilizochaguliwa, HR yenye \(c=1\) ilitoa matokeo bora kuliko mbinu zilizolinganishwa kwa main metrics zilizoripotiwa.
Matokeo ambayo utafiti haujathibitisha au haujajaribu
- Haijaonyeshwa kwamba HR ni bora kuliko L2, Dropout au regularization nyingine katika machine-learning tasks zote.
- Minimum condition number haimaanishi maximum test performance katika real-world distributions zote.
- Scalability ya HR kwenye CNN, RNN au transformer kubwa haijathibitishwa kwa majaribio.
- Cart-Pole results si field validation kwenye robot halisi au safety-critical control system.
- Hakuna statistical superiority test iliyotolewa kwa tofauti ndogo za IRIS, MNIST na regression tables.
- MNIST result si benchmark ya full standard training set; picha 1.000 tu zilitumika.
- “Explainability” katika chanzo inalenga zaidi kueleza mathematical effect ya regularization kuliko kutoa example-based explanations kama SHAP.
Mbinu na Matokeo ya Utafiti
Mbinu ya kinadharia
Sehemu ya kinadharia inawakilisha output ya hidden layer ya mwisho kwa mapping matrix \(H\) na kuchambua learnable output weights kupitia \(\beta\). Badala ya kutumia \(H^\top H\) au Moore–Penrose inverse yake moja kwa moja, HR huunda approximate inverse kutoka regularized matrix na truncated power series.
| Kipengele | Usemi wa chanzo | Kazi |
|---|---|---|
| Information/mapping matrix | \(H^\top H\) | Inawakilisha mapping information kutoka training data. |
| Regularization matrix | \(R\) | Inabadilisha trade-off kati ya conditioning na estimation bias. |
| Series matrix | \(F(R)=R(H^\top H+R)^{-1}\) | Inaunda power series ya approximate inversion. |
| Regularization order | \(c\) | Inaamua idadi ya high-order terms zinazohifadhiwa. |
| Approximate inverse | \(F_{aim}(H,R,c)\) | HR approximation ya general inverse mapping. |
| Approximation residual | \(F_{ar}(R)\) | Tofauti kati ya theoretical inverse na HR approximate inverse. |
Mpangilio wa jaribio la Cart-Pole
| Sifa ya jaribio | Thamani katika chanzo |
|---|---|
| Action space | Kushoto, kulia |
| State variables | Nafasi ya cart, kasi ya cart, angle ya pole, angular velocity ya pole |
| Pole angle limit | Termination nje ya (−12°, 12°) |
| Cart position limit | Termination nje ya (−2,4, 2,4) |
| Standard maximum time step | 200 |
| Reward | Kila step +1 |
| Initial state | Random ndani ya (−0,05, 0,05) |
| Total runs | 50 |
Network hyperparameters
| Hyperparameter | Q-network | ELM / EQLM-HR |
|---|---|---|
| Learning rate | 0,0065 | Haitumiki |
| Regularization parameter | Haitumiki | 1,827×10−5 |
| Hidden nodes | 29 | 25 |
| Initial exploration probability | 0,670 | 0,599 |
| Exploration decay period | 400 episodes | 360 episodes |
| Discount factor | 0,99 | 0,93 |
| Mini-batch | 26 | 2 |
| Target-network update step | 70 | 48 |
| Regularization order | Haitumiki | EQLM: c=0; HR experiments: c=1 |
Utafiti hautumii network architecture au hyperparameters zote zinazofanana kati ya Q-network na mbinu za ELM. Katika ulinganisho wa HR na EQLM, chanzo kinasema regularization parameter ileile ilihifadhiwa na tofauti kuu ilikuwa HR order.
Mpangilio wa machine-learning experiments
IRIS na MNIST zilitumika kwa classification; Individual Household Electric Power Consumption, Appliances Energy Prediction na weather data zilitumika kwa regression.
Katika MNIST, picha 1.000 tu, yaani takriban %1,7 ya training data yote, zilitumika kwa mafunzo. Katika data sets nyingine, badala ya split ya kawaida 80/20, utafiti ulitumia %20 training na %80 test. Waandishi wanasema uchaguzi huu uliundwa ili kuiga limited-training-data settings kwa kufanya model ziwe prone zaidi kwa overfitting.
Katika machine-learning experiments zote, hidden-node count ni 1.000. FNN zilitumia hidden layer moja kwa classification na mbili kwa regression. Kwa \(R=\bar{\mu}I\), \(\bar{\mu}=1,0\); dropout rate ni 0,5. Hyperparameters zilichaguliwa kwa standard default values badala ya extensive dataset-specific optimization.
Performance metrics
Classification ilitumia test accuracy, regression ikatumia RMSE. Cart-Pole ilitumia episode reward na area under learning curve (AUC) kama metrics kuu. Cart-Pole plots zinaonyesha mean reward ya runs 50 kwa episode na %95 confidence interval kama shaded band.
Computing environment
Cart-Pole networks zilifundishwa kwenye desktop yenye Intel i7-12700, 16 GB memory na 12 GB RTX 3060 GPU. Chanzo kinasema kila network training, ikiwa ni pamoja na ku-run game, ilichukua zaidi ya saa moja.
Ujumbe wa pamoja wa Vielelezo 5–11
Q-network yenye gradient-descent updates inaonyesha fluctuations kubwa zaidi kati ya runs, wakati EQLM inaonyesha average learning curve iliyo consistent zaidi. Katika HR bila time-step limit, baadhi ya runs zilifikia rewards kubwa na kuongeza mean reward. Katika experiment ya standard 200 steps, HR learning curve ina plateau ya juu na stable zaidi kuliko Q-network.
Kielelezo 10 kinaonyesha performance haiongezeki monotonically bila mwisho \(\bar{\mu}\) inapobadilishwa; baada ya eneo fulani plateau hutokea. Kielelezo 11 kinaonyesha exploration decay period inaweza kubadilisha learning speed kwa kiasi kikubwa. Hivyo performance haitegemei HR formula pekee bali pia exploration setting.
Reproducibility na mipaka ya tafsiri
Utafiti unaeleza experiment hyperparameters kuu na data-set sources; lakini hauonyeshi independent code/data repository ndani ya paper. Kwa classification/regression single performance values, run count, standard deviation au confidence interval hazijatolewa; hivyo method variance haiwezi kutathminiwa.
Waandishi pia wanasema full integration ya HR katika deep multilayer networks, convolutional networks, attention structures, recurrent networks na transformer-based models bado ni open research problem. Computing cost na numerical stability katika large-scale problems pia ni maeneo ya baadaye.
Dokezo la Chanzo na Mbinu
Jina kamili la kazi asilia: High-order regularization for explainable generalization in machine learning and learning-based control
Waandishi na mpangilio: Xinghua Liu; Ming Cao.
Equal contribution/co-first authorship: Chanzo hakina tamko la namna hiyo.
Corresponding/contact author: Hakuna alama maalum ya “corresponding author” katika maandishi ya chanzo. Rekodi rasmi ya SSRN inamtaja Xinghua Liu kama “Contact Author”.
Taasisi: Engineering and Technology institute Groningen (ENTEG), University of Groningen, 9747 AG Groningen, the Netherlands.
Aina ya chanzo: Research preprint yenye mathematical-method development, machine-learning experiments na learning-based-control experiment.
Peer-review status: Kazi hii ni preprint ambayo haijapitia peer review; matokeo yanapaswa kutathminiwa kwa kuzingatia hatua hii ya uchapishaji.
Platform: SSRN.
DOI: 10.2139/ssrn.6963250
Tarehe ya SSRN: 18 Juni 2026.
Tarehe katika source text: “Preprint submitted to XXX June 6, 2026”. “XXX” ni placeholder iliyobaki katika chanzo na haijatafsiriwa kama jina halisi la journal.
Official link: https://ssrn.com/abstract=6963250
DOI link: https://doi.org/10.2139/ssrn.6963250
Journal/volume/issue/article number: Hakuna peer-reviewed journal, volume, issue au article number iliyothibitishwa katika version iliyochunguzwa.
Publisher: Publisher wa peer-reviewed publication hajabainishwa; “XXX” haikutumika kama jina la publisher au journal.
License: Creative Commons au open-reuse license sawa haijatajwa wazi. Kwa hiyo original figures hazikunakiliwa moja kwa moja kwenye Verianla HTML.
Funding: Kazi iliungwa mkono kwa sehemu na Netherlands Organization for Scientific Research kupitia NWO-Vici-19902 na China Scholarship Council.
Data/code availability: Chanzo hakina tamko tofauti la data/code sharing. Open data sources na OpenAI Gym references zimetajwa katika bibliography.
Conflict of interest: Hakuna tamko maalum lililobainishwa katika version iliyochunguzwa.
CRediT contributions: Xinghua Liu — Conceptualization, Writing – review & editing, Writing – original draft, Methodology, Validation, Formal analysis. Ming Cao — Writing – review & editing, Validation, Supervision, Funding acquisition.
Generative AI statement: Waandishi wanasema walitumia ChatGPT kwa grammar/spelling check na kuboresha ubora wa maandishi; kisha walipitia na kuhariri content na wanakubali responsibility ya content ya kazi.
Source inconsistency 1: Section 3.7 inapoitambulisha Algorithm 2 inasema regularization order ya HR iliyopendekezwa ni \(c=1\), na line 8 ya Algorithm 2 pia inaonyesha wazi \(c=1\). Hata hivyo, sentensi nyingine katika section hiyo hiyo inasema Algorithm 2 hufix \(c=0\) katika updates. Contradiction hii haikusahihishwa kimya kimya; experimental tables na explicit algorithm line zinaripoti HR kama \(c=1\).
Source inconsistency 2: Sehemu moja ya main computational-complexity discussion hutumia symbol \(k\) kwa regularization order, wakati mathematical definition na Appendix D hutumia \(c\), na additional complexity inaandikwa \(O(cn)\).
Scientific boundary kuu: Theoretical generalization analysis imejengwa hasa juu ya last-hidden-layer mapping na conditioning ya information matrix \(H^\top H\). Experimental validation imewekewa mipaka kwenye Cart-Pole na selected low/medium-scale classification-regression tasks. Performance, computing cost na scalability katika large modern deep-network architectures hazijathibitishwa ndani ya utafiti huu.
Scientific-content boundary: HR equations, theorems, algorithms, data splits, hyperparameters, experimental results, plot interpretations na limitations katika makala hii ya Verianla zinatokana tu na kazi iliyochunguzwa. External sources zilitumika tu kwa bibliographic verification; hakuna external experiment au performance result mpya iliyoongezwa kwenye main scientific text.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *