

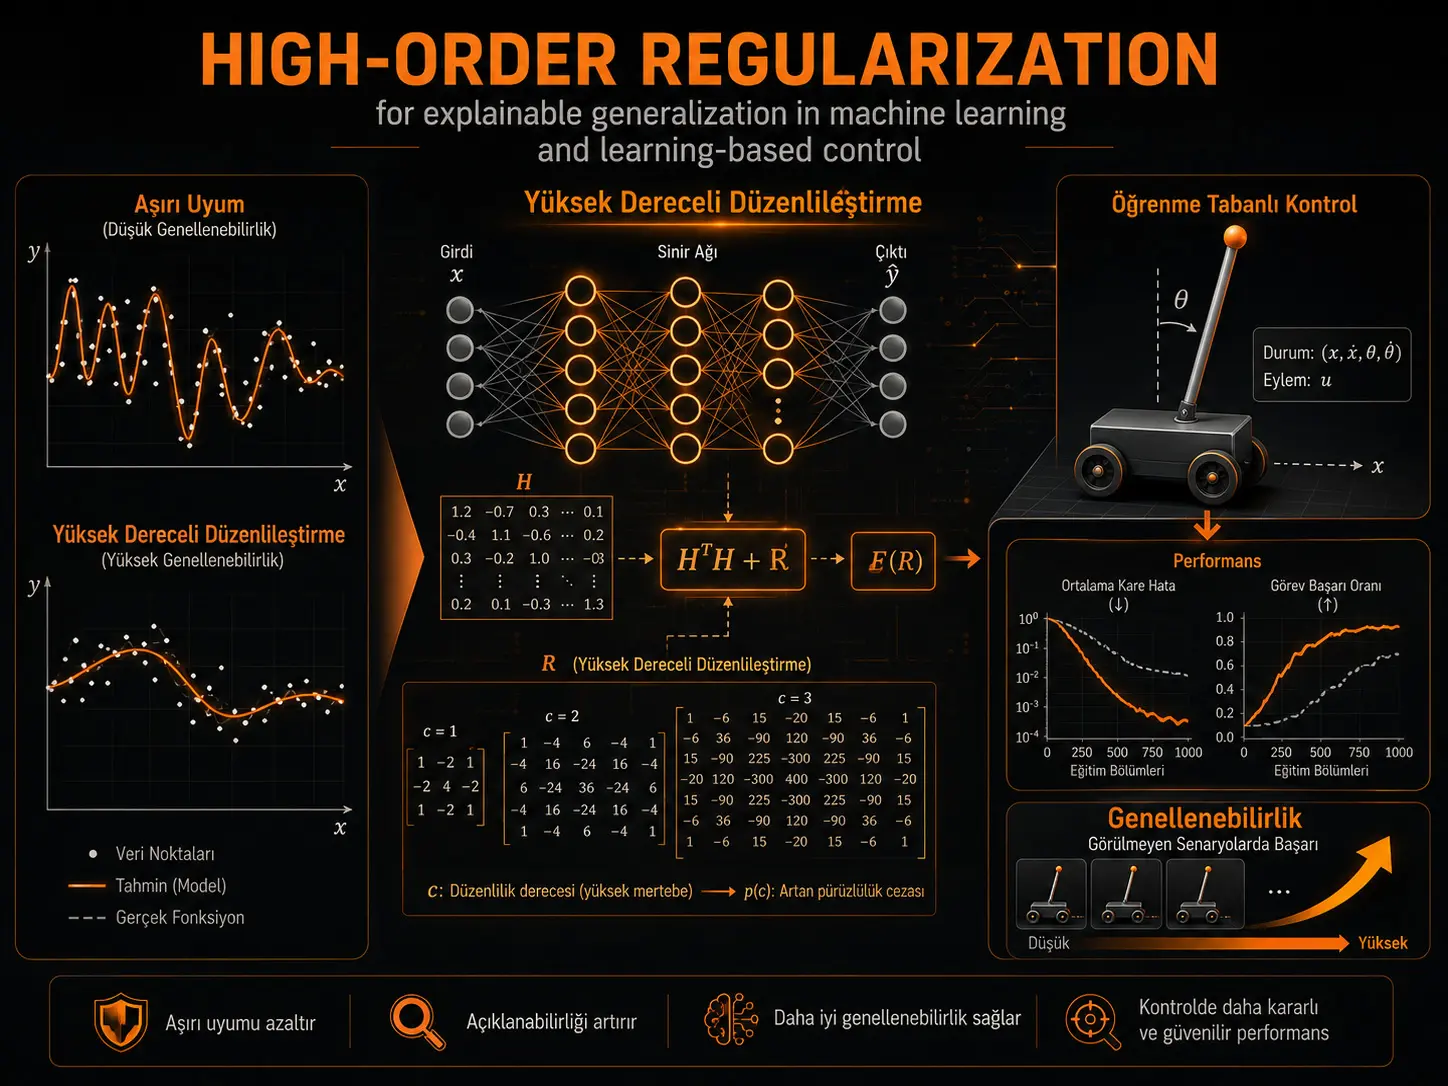
Bu tədqiqat neyron şəbəkələrində həddindən artıq uyğunlaşmanı azaltmaqla yanaşı, nizamlamanın genelləşmə qabiliyyətini niyə və necə dəyişdirdiyini riyazi cəhətdən izah etmək məqsədilə High-Order Regularization (HR) — Yüksək Dərəcəli Nizamlama adlı üsul təklif edir. HR, neyron şəbəkəsinin son gizli qatından çıxışa uzanan öyrənilə bilən çəkilərin hesablanmasını tərs xəritələmə problemi kimi nəzərdən keçirir və \(H^\top H\) informasiya matrisinin tərsini sonlu matris qüvvət sırası ilə yaxınlaşdırır. Ənənəvi L2-norm nizamlaması bu çərçivədə \(c=0\) olan aşağı dərəcəli xüsusi hal kimi ortaya çıxır, tətbiqlərdə isə əsasən \(c=1\) istifadə olunur. Nəzəri hissə yaxınlaşmanı, hesablana bilən aşağı və yuxarı xəta sərhədlərini və nizamlama matrisi vasitəsilə şərt ədədini idarə edən genelləşmə meyarını çıxarır. Təcrübələrdə HR; Cart-Pole idarəetməsində, IRIS və MNIST təsnifatında və üç reqressiya problemində müqayisə edilən üsullarla müqayisədə daha yüksək mükafat/dəqiqlik və ya daha aşağı RMSE dəyərləri vermişdir. Bununla belə, təcrübələr məhdud sayda problem üzərində aparılmış, məlumat bölünmələri xüsusi olaraq həddindən artıq uyğunlaşmanı təşviq edəcək şəkildə qurulmuş və böyük müasir dərin şəbəkə arxitekturalarında miqyaslana bilməsi hələ eksperimental olaraq göstərilməmişdir.
Cart-Pole təcrübəsində zaman addımı məhdudiyyətinin aradan qaldırıldığı müqayisədə son 50 epizodun orta mükafatı Q-network üçün 207,4, EQLM üçün 208,2 və təklif olunan HR üçün 273,4 olaraq bildirilmişdir. Müəlliflər bu nəticəni Q-network ilə müqayisədə %31,8, EQLM ilə müqayisədə isə %31,3 yaxşılaşma kimi ifadə edirlər. Lakin HR nəticəsində qaçışlararası dəyişkənlik yüksəkdir; eyni cədvəldə HR üçün standart sapma 323,7 göstərilir. Buna görə yüksək orta performans daha aşağı variasiya demək deyil.
Standart 200 zaman addımı məhdudiyyətinə malik Cart-Pole təcrübəsində HR-nin son 50 epizod üzrə mükafatı 175,2 olduğu halda Q-network üçün 123,8-dir; AUC dəyərləri müvafiq olaraq \(87,5\times10^3\) və \(71,0\times10^3\) kimi bildirilmişdir. Müəlliflər bunları müvafiq olaraq %41,5 və %23,2 artım kimi qiymətləndirirlər. Bu nəzarətli təcrübədə HR-nin mükafat nəticələrinin paylanması məhdudiyyətsiz zaman addımlı təcrübəyə nisbətən daha dardır.
Maşın öyrənməsi təcrübələrində də eyni meyl müşahidə olunur. IRIS test dəqiqliyi HR ilə %95,0; Dropout ilə %94,2; L2-norm ilə %93,3 və nizamlamasız FNN ilə %87,5-dir. MNIST-də yalnız 1.000 təlim görüntüsü istifadə edildikdə HR %84,1, Dropout %83,4, L2-norm %82,7 və FNN %59,0 dəqiqlik vermişdir. Bu müqayisələr seçilmiş testlərdə HR-nin üstünlüyünü göstərir; lakin iş bu cədvəl nəticələri üçün təkrarlanan təcrübə paylanması, etibar intervalı və ya üsullar arasında statistik əhəmiyyətlilik testi bildirmir.
Türkiyə baxımından: HR yanaşması Türkiyədə maşın öyrənməsi, robototexnika, adaptiv idarəetmə, sənaye avtomatlaşdırılması və ya məhdud/qərəzli təlim məlumatları ilə işləyən qərar sistemlərində araşdırıla biləcək riyazi üsul təqdim edir. Lakin işdəki performans dəyərləri Türkiyədəki hər hansı real sistemə birbaşa köçürülə bilməz. Yerli istifadə üçün müvafiq məlumat paylanması, şəbəkə arxitekturası, hesablama avadanlığı, real vaxt məhdudiyyətləri, təhlükəsizlik tələbləri və mövcud üsullarla müstəqil benchmark müqayisələri ayrıca yoxlanmalıdır.
Tədqiqatın əsas problemi nədir?
Nizamlama neyron şəbəkəsinin təlim məlumatlarına həddindən artıq uyğunlaşmasının qarşısını almaq və görülməmiş məlumatlar üzərində daha yaxşı davranmasını təmin etmək üçün geniş istifadə olunur. L2, L1, dropout, mixup, erkən dayandırma və oxşar üsulların praktik uğuru yaxşı məlum olsa da, işin hədəflədiyi boşluq nizamlamanın ilkin həlli riyazi olaraq necə dəyişdirdiyini, hansı qərəzi yaratdığını və bu qərəzlə genelləşmə arasındakı tarazlığın necə hesablana biləcəyini daha aydın göstərməkdir.
Şəkil 1 bu problemi reqressiya və təsnifat üzərindən vizuallaşdırır. Təlim nöqtələrinə həddindən artıq əyilərək uyğunlaşan mürəkkəb modellər mavi, daha aşağı mürəkkəbliyə malik nizamlanmış modellər isə qara xətlərlə göstərilir. Vizualın əsas mesajı budur ki, təlim nümunələrini daha yaxşı izləyən model mütləq görülməmiş məlumat üçün daha yaxşı model deyil.
Analiz niyə Extreme Learning Machine üzərindən qurulur?
Tədqiqat nəzəriyyəni aydın şəkildə çıxara bilmək üçün Extreme Learning Machine (ELM) arxitekturasından istifadə edir. ELM tək gizli qatlı irəli qidalanan şəbəkədir; girişdən gizli qata gedən çəkilər və mümkün bias təsadüfi təyin edilir, yalnız gizli qatdan çıxışa gedən \(\beta\) çəkiləri analitik olaraq hesablanır.
Şəkil 2-də giriş düyünlərinin gizli düyünlərə, gizli düyünlərin isə çıxışlara qoşulduğu ELM arxitekturası göstərilir. Bir giriş nümunəsi \(x_j\) üçün şəbəkə çıxışı:
\[ \sum_{i=1}^{L}\beta_i g_i(x_j) = \sum_{i=1}^{L}\beta_i g_i(w_i\cdot x_j+b_i) = o_j \]
kimi ifadə edilir. Burada \(L\) gizli düyün sayını, \(w_i\) təsadüfi giriş çəkilərini, \(b_i\) bias-ı, \(g_i\) aktivasiya funksiyasını və \(\beta_i\) öyrənilə bilən çıxış çəkisini göstərir.
Əsas təlim problemi:
\[ \min_{\beta\in\mathbb{R}^{L\times k}} \left\|H\beta-Y\right\|^2 \]
kimi yazılır. \(H\) gizli qatın çıxış matrisi, \(Y\) isə təlim etiketidir. Nizamlama olmadan minimum normlu ən kiçik kvadratlar həlli Moore–Penrose psevdotərsi ilə:
\[ \hat{\beta}=H^\dagger Y \]
şəklində əldə edilir.
L2 nizamlaması bu strukturda necə görünür?
Mənbədə klassik L2 nizamlanmış həll:
\[ \hat{\beta} = \left( H^\top H+\frac{I}{\mu} \right)^\dagger H^\top Y \]
kimi verilir. Bu əməliyyat pis şərtlənmiş \(H^\top H\) matrisini ədədi baxımdan daha sabit edə bilər; lakin nizamlama eyni zamanda nəzəri optimal həllə nisbətən qiymətləndirmə qərəzi yaradır. HR yanaşması bu qərəzi birbaşa təxmini tərs xəritələmə xətası kimi müəyyənləşdirməyə çalışır.
Yüksək Dərəcəli Nizamlama necə çıxarılır?
HR-nin başlanğıc nöqtəsi:
\[ F(R) := R\left(H^\top H+R\right)^{-1} \]
tərifidir. Burada \(R\) seçilə bilən nizamlama matrisidir. Uyğun spektral radius şərti altında:
\[ (I-F(R))^{-1} = \sum_{i=0}^{\infty}F^i(R), \qquad \rho(F(R))<1 \]
matris qüvvət sırasından istifadə oluna bilər. Sonsuz sıra \(c+1\) termindən sonra kəsildikdə işdə təklif olunan HR həlli alınır:
\[ \hat{\beta}_{hr} = \left(H^\top H+R\right)^{-1} \sum_{i=0}^{c} F^i(R)H^\top Y, \qquad \rho(F(R))<1 \]
\(c\) nizamlama dərəcəsidir. \(c=0\) və \(R=\bar{\mu}I\) seçildikdə həll ənənəvi L2-norm nizamlamasının formasına endirilir. \(c\geq1\) olduqda tərs xəritələmə bir neçə matris-sırası termini ilə yaxınlaşdırıldığı üçün iş bunu “high-order” nizamlama adlandırır.
L2 niyə HR-nin xüsusi halı sayılır?
HR-də \(c=0\) seçildikdə sıra yalnız vahid matris terminini ehtiva edir:
\[ \sum_{i=0}^{0}F^i(R)=I \]
və:
\[ \hat{\beta}_{hr} = (H^\top H+R)^{-1}H^\top Y \]
alınır. \(R=\bar{\mu}I\) seçimi klassik L2/Tikhonov tipli həlli verir. Appendix A həmçinin son gizli qata tətbiq olunan dropout-un gözlənilən itkisinin:
\[ L(\beta)= \frac{1}{2N}\|y-H\beta\|_2^2+ \frac{1-p}{2pN} \beta^\top \operatorname{diag}(H^\top H) \beta \]
şəklində norm nizamlamasına çevrilə bildiyini göstərir. Bu xüsusi dropout çıxarışında nizamlama əmsalı \((1-p)/p\), dropout səs-küyünün variasiyası ilə əlaqələndirilir.
HR həllinin yaxınlaşması necə izah olunur?
İşdə HR xətası:
\[ e_\beta=\hat{\beta}_{hr}-\beta_{opt} \]
kimi təyin edilir. Teorem 1 göstərilən müsbət müəyyənlik və spektral radius şərtləri altında nizamlama matrisi sıfıra yaxınlaşdıqda və ya nizamlama dərəcəsi sonsuzluğa getdikdə HR həll xətasının sıfıra yaxınlaşdığını göstərir:
\[ \lim_{R\rightarrow O}\|e_\beta\|=0, \qquad \lim_{c\rightarrow+\infty}\|e_\beta\|=0 \]
Bu nəticə HR-nin sıra kəsmə xətasının nizamlama matrisi və sıra dərəcəsi ilə birbaşa əlaqələndirilməsinə imkan verir.
Xəta niyə hesablana bilən hesab olunur?
Tərs matris yaxınlaşdırma xətası:
\[ F_{ar}(R) = (H^\top H)^{-1} - (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
kimi təyin olunur. Uyğun şərtlər altında:
\[ F_{ar}(R) = (H^\top H)^{-1}F^{c+1}(R) \]
alınır. Tədqiqat daha sonra HR həll xətası üçün aşağı və yuxarı sərhədlər çıxarır:
\[ \frac{1}{1-\lambda_{\min}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \leq \|e_\beta\| \]
və:
\[ \|e_\beta\| \leq \frac{1}{1-\lambda_{\max}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \]
şəklindədir. Beləliklə, nizamlama səbəbindən nəzəri həllə nisbətən yaranan fərq yalnız intuitiv cəza termini deyil, seçilmiş \(R\) və \(c\) altında sərhədləndirilə bilən təxmini tərsləmə xətası kimi şərh olunur.
Nizamlama niyə daralma əməliyyatı kimi şərh olunur?
Teorem 2-də uyğun simmetrik müsbət yarım-müəyyən \(R\) və müsbət müəyyən \(H^\top H\) şərtləri altında nizamlama matrisinin \(F_{ar}(R)\) yaxınlaşdırma xətası normu üzərində daralma yaratdığı göstərilir. Daralma nisbətini həm \(R\), həm də nizamlama dərəcəsi \(c\) müəyyən edir.
Bu baxışda aşağı dərəcə nəzəri optimum ilə nizamlanmış həll arasında daha böyük məsafə yarada bilər; daha çox sıra termini isə tərs xəritələmə yaxınlaşmasını yaxşılaşdırır. Bunun qarşılığında nizamlamanın pis şərtlənməni azaltma təsiri ilə qiymətləndirmə qərəzi arasında tarazlıq qurulmalıdır.
“Maksimum genelləşmə” nə deməkdir?
İş genelləşməni bütün mümkün test paylanmaları üzərində birbaşa ölçmək əvəzinə \(H^\top H+R\) matrisinin şərt ədədi vasitəsilə xarakterizə edir:
\[ \operatorname{Cond}(R) = \|H^\top H+R\| \, \|(H^\top H+R)^{-1}\| \]
Şərt ədədinin kiçilməsi təlim məlumatındakı kiçik dəyişikliklərin çəki həllində həddindən artıq böyük dəyişikliklərə çevrilməsini azaldan daha yaxşı şərtlənmiş problem deməkdir. İşin tarazlıq meyarı:
\[ \operatorname{Obj}(R) = \|F_{ar}(R)\| \operatorname{Cond}(R) \]
kimi təyin olunur. Bu məqsəd funksiyası qiymətləndirmə qərəzi ilə pis şərtlənməni birlikdə nəzərə alır.
Təklif 2-də \(H^\top H\)-nin özqiymətləri \(\lambda_i\) olduqda:
\[ \lambda_{R,i} = \max\{\bar{\mu}-\lambda_i,0\} \]
şəklində qurulmuş nizamlama matrisi nəzərdən keçirilir. İşin riyazi genelləşmə meyarında \(\bar{\mu}=\lambda_1\) ətrafında şərt ədədi 1-ə qədər endirilə bilər. Bu “maksimum genelləşmə” ifadəsi işin şərt-ədədi əsaslı nəzəri tərifi daxilindədir; bütün real dünya paylanmalarında universal maksimum performans zəmanəti kimi şərh edilməməlidir.
Şəkil 4 nizamlamanı necə izah edir?
Şəkil 4 nəzəri izahın vizual xülasəsidir. Ən böyük dairə verilmiş təlim məlumatı və \(H^\top H\) informasiya matrisi üçün ilkin şəbəkənin mümkün həllərini, mərkəz isə nəzəri optimal həlli göstərir. Daha kiçik dairələr müxtəlif \(R\) matrisləri altında əldə edilən nizamlanmış həlləri göstərir. Kəsik dairənin radiusu müəyyən \(c\) üçün qiymətləndirmə qərəzini təmsil edir.
Şəklin əsas mesajı odur ki, daha güclü nizamlama avtomatik olaraq daha yaxşı deyil. Məqsəd həlli sabitləşdirərkən nəzəri optimumdan lazımsız dərəcədə uzaqlaşdırmayan \(R\) və \(c\) kombinasiyasını tapmaqdır.
Singulyar və ya böyük xəritələmələrdə HR necə genişləndirilir?
Şəbəkə miqyası böyüdükdə \(H^\top H\) singulyar ola bilər. Tədqiqat bu halda Moore–Penrose psevdotərsindən istifadə edərək ümumi tərs xəritələmə yanaşmasını genişləndirir. Yanaşma:
\[ F_{aim}(H,R,c) = (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
ilə təyin olunur və:
\[ F_{ar}(R) = (H^\top H)^\dagger-F_{aim}(H,R,c) \]
artıq ümumi tərsləmə yaxınlaşdırma xətasını təmsil edir. Teorem 3-də:
\[ \lim_{c\rightarrow+\infty}F_{ar}(R) = (H^\top H)^\dagger-R^{-1} \]
nəticəsi verilir. Mənbənin şərhinə görə, uyğun \(R\) seçimi singulyar xəritələmələrdə də təxmini tərsləmə xətası ilə şərtlənməni birlikdə idarə etməyə imkan verir.
Artımlı HR necə işləyir?
Incremental High-Order Regularization (IHR), yeni mini-batch məlumatı gəldikdə bütün şəbəkəni sıfırdan öyrətmək əvəzinə mövcud informasiya matrisini və çəkiləri yeniləyir. Əsas yeniləmə:
\[ \hat{\beta}_{t+1} = K_{t+1}(c)\hat{\beta}_t + F_{aim,t+1}H_{ic}^{\top}Y_{ic} \]
şəklindədir. Burada yeni \(H_{ic},Y_{ic}\) mini-batch-i mövcud modelə əlavə olunur. İş xüsusilə öyrənmə əsaslı idarəetmədə təlimin erkən mərhələsində aşağı keyfiyyətli və məhdud məlumatların yarada biləcəyi həddindən artıq uyğunlaşmanın zamanla azaldılması kontekstində bu artımlı quruluşu müzakirə edir.
HR-nin “öyrənmə, yaddaş və unutma” şərhi nədir?
Müəlliflər nizamlamanın erkən təlimdə yetərsiz və ya qərəzli məlumatın təsirini azaltmasını adaptiv unutmanın bir növü kimi şərh edirlər. Təlim irəlilədikcə məlumat keyfiyyəti və informasiya miqdarı artdıqda nizamlamanın təsirinin dəyişə bilməsi sistemin yeni məlumat öyrənməsi ilə köhnə məlumata verdiyi çəki arasındakı əlaqəni izah etmək üçün istifadə olunur.
Bu ifadə neyrobioloji yaddaş mexanizminin sübutu deyil; işin riyazi nizamlama davranışına verdiyi öyrənmə əsaslı idarəetmə şərhidir.
Cart-Pole təcrübəsində nə tapıldı?
OpenAI Gym Cart-Pole problemi Q-network, EQLM və HR-EQLM yanaşmasını müqayisə etmək üçün istifadə edilmişdir. Zaman addımı məhdudiyyətinin aradan qaldırıldığı təcrübələrdə 50 qaçış üzrə son 50 epizodun orta mükafatları:
| Üsul | Son 50 epizodun orta mükafatı | AUC (×10³) |
|---|---|---|
| Q-network | 207,4 (176,2–236,3) | 107,8 (103,8–111,8) |
| EQLM | 208,2 (188,51–224,98) | 97,2 (90,3–103,3) |
| Təklif olunan HR | 273,4 (166,1–340,3) | 116,3 (86,1–136,8) |
HR orta mükafatda ən yüksək dəyəri vermişdir. Bununla belə, eyni Cədvəl 4-də standart sapma Q-network üçün 108,7, EQLM üçün 66,2 və HR üçün 323,7 kimi bildirilir. HR-nin yüksək ortalaması bəzi qaçışlarda 200 zaman addımından xeyli yuxarı əldə edilən yüksək mükafatlardan təsirlənir; buna görə orta artımla yanaşı qaçışlararası dəyişkənlik də nəzərə alınmalıdır.
200 zaman addımlı təcrübədə nəticə necə dəyişir?
Standart 200 zaman addımı məhdudiyyəti tətbiq edildikdə müqayisə daha dar performans diapazonunda aparılmışdır:
| Üsul | Son 50 epizodun orta mükafatı | AUC (×10³) |
|---|---|---|
| Q-network | 123,8 (112,4–135,5) | 71,0 (68,8–73,5) |
| Təklif olunan HR | 175,2 (169,6–180,9) | 87,5 (84,7–90,5) |
Mənbə HR-nin son 50 epizod mükafatında %41,5 və AUC-də %23,2 yaxşılaşma verdiyini bildirir. HR mükafatlarının standart sapması 20,3, Q-network-un isə 41,9-dur.
IRIS və MNIST nəticələri nə göstərir?
Təsnifat təcrübələrində FNN, Dropout, L2-norm və \(c=1\) HR müqayisə edilmişdir:
Verianla Live: Nizamlama üsullarının təsnifat dəqiqliyi
Müqayisə işin Cədvəl 6-da bildirilmiş test dəqiqliklərini göstərir. MNIST təcrübəsi yalnız 1.000 təlim görüntüsü ilə aparılmışdır; buna görə dəyərlər tam MNIST təlim dəsti ilə əldə edilən standart benchmark dəyərləri kimi şərh edilməməlidir.
| Məlumat dəsti | FNN | Dropout | L2-norm (c=0) | Təklif olunan HR (c=1) | Vahid | Mənbə |
|---|---|---|---|---|---|---|
| IRIS | 87,5 | 94,2 | 93,3 | 95,0 | Test dəqiqliyi (%) | Cədvəl 6 |
| MNIST | 59,0 | 83,4 | 82,7 | 84,1 | Test dəqiqliyi (%) | Cədvəl 6 |
HR hər iki məlumat dəstində ən yüksək test dəqiqliyini vermişdir. Lakin IRIS-də HR ilə Dropout arasındakı fərq 0,8 faiz bəndi, MNIST-də isə 0,7 faiz bəndidir. İş bu fərqlər üçün statistik əhəmiyyətlilik testi və ya təkrarlanan qaçış etibar intervalı bildirmədiyindən kiçik fərqləri ümumiləşdirilən üstünlük kimi şərh etmək uyğun deyil.
Reqressiya təcrübələrində nə tapıldı?
Reqressiya tapşırıqlarında aşağı Root Mean Squared Error (RMSE) daha yaxşı performansı göstərir:
| Məlumat dəsti | FNN RMSE | Dropout RMSE | L2-norm RMSE | HR (c=1) RMSE |
|---|---|---|---|---|
| Weather prediction | 4,2274 | 2,1575 | 2,7061 | 2,0888 |
| Power consumption | 0,7488 | 0,7140 | 0,7474 | 0,7096 |
| Appliances energy | 87,7197 | 79,0572 | 79,4058 | 77,3815 |
HR işdəki üç reqressiya testinin hamısında ən aşağı RMSE-ni vermişdir. Weather prediction-da Dropout ilə HR arasındakı fərq nisbətən kiçikdir, nizamlamasız FNN-nin xətası isə daha yüksəkdir.
Şəkil 12 və 13 nə göstərir?
Appliances Energy təcrübəsinin Şəkil 12-si təxmin minus real dəyər xətasını zaman boyunca FNN, L2, HR və Dropout üçün göstərir. Şəkil 13 eyni xətaların paylanmalarını müqayisə edir. Nizamlanmış modellərin xəta paylanmaları sıfır ətrafında oxşar şəkildə sıxlaşır.
Reqressiya modellərində nizamlama mənşəli qərəzi azaltmaq üçün təlim məlumatından ayrılmış doğrulama məlumatları ilə qərəz düzəlişi tətbiq edilmişdir. Buna görə cədvəldə verilən reqressiya nəticələri təkcə xam nizamlanmış həllin deyil, işdə müəyyənləşdirilmiş doğrulama əsaslı düzəliş prosesinin də təsirini daşıyır.
İşin dəstəklədiyi nəticələr
- HR matris qüvvət sırasının kəsilmiş təxmini tərsləmə forması kimi açıq şəkildə formullaşdırılmışdır.
- L2-norm nizamlaması HR çərçivəsində \(c=0\) xüsusi halı kimi ifadə edilə bilər.
- Göstərilən matris şərtləri altında HR həllinin yaxınlaşması və hesablana bilən xəta sərhədləri nəzəri olaraq çıxarılmışdır.
- Nizamlama matrisi və dərəcəsi təxmini tərsləmə xətasının daralma sürətini idarə edir.
- İşin şərt-ədədi əsaslı tərifi altında \(R\) matrisinin özqiymət quruluşu genelləşmə meyarını optimallaşdırmaq üçün layihələndirilə bilər.
- Seçilmiş Cart-Pole, təsnifat və reqressiya təcrübələrində \(c=1\) HR bildirilən əsas performans ölçülərində müqayisə olunan üsullardan daha yüksək nəticələr vermişdir.
İşin sübut etmədiyi və ya hələ sınaqdan keçirmədiyi nəticələr
- HR-nin bütün maşın öyrənməsi tapşırıqlarında L2, Dropout və ya digər nizamlama üsullarından üstün olduğu göstərilməmişdir.
- Şərt ədədinin minimum olması bütün real məlumat paylanmalarında maksimum test performansını zəmanət etmir.
- HR-nin böyük CNN, RNN və ya transformer arxitekturalarında miqyaslana bilməsi eksperimental olaraq təsdiqlənməmişdir.
- Cart-Pole nəticələri real robot və ya təhlükəsizlik-kritik idarəetmə sistemində sahə doğrulaması deyil.
- IRIS, MNIST və reqressiya cədvəlindəki kiçik performans fərqləri üçün statistik üstünlük testi bildirilməmişdir.
- MNIST nəticəsi tam standart təlim dəsti ilə əldə edilmiş benchmark deyil; yalnız 1.000 təlim görüntüsü istifadə edilmişdir.
- Mənbədə təqdim olunan “izah edilə bilənlik” SHAP və ya xüsusiyyət atribusiyası üsulu kimi nümunə-bazlı izah yaratmaqdan çox nizamlamanın riyazi təsirini izah etməyə yönəlib.
İşin Metodu və Nəticələri
Nəzəri üsul
İşin nəzəri hissəsi neyron şəbəkəsinin son gizli qat çıxışını \(H\) xəritələmə matrisi ilə təmsil edir və öyrənilə bilən çıxış çəkilərini \(\beta\) vasitəsilə araşdırır. HR, \(H^\top H\) və ya bunun Moore–Penrose ümumi tərsini birbaşa istifadə etmək əvəzinə nizamlanmış matris və kəsilmiş qüvvət sırasından təxmini tərs yaradır.
| Komponent | Mənbədə istifadə olunan ifadə | Funksiya |
|---|---|---|
| İnformasiya/xəritələmə matrisi | \(H^\top H\) | Təlim məlumatından gələn xəritələmə məlumatını təmsil edir. |
| Nizamlama matrisi | \(R\) | Şərtlənmə və qiymətləndirmə qərəzi arasındakı tarazlığı dəyişir. |
| Sıra matrisi | \(F(R)=R(H^\top H+R)^{-1}\) | Təxmini tərsləmə qüvvət sırasını yaradır. |
| Nizamlama dərəcəsi | \(c\) | Sırada saxlanılan yüksək dərəcəli terminlərin sayını müəyyən edir. |
| Təxmini tərs | \(F_{aim}(H,R,c)\) | Ümumi tərs xəritələmənin HR yaxınlaşdırmasıdır. |
| Yaxınlaşdırma qalığı | \(F_{ar}(R)\) | Nəzəri tərs ilə HR təxmini tərsi arasındakı fərqdir. |
Cart-Pole təcrübə quruluşu
| Təcrübə xüsusiyyəti | Mənbədə verilən dəyər |
|---|---|
| Əməl məkanı | Sol, sağ |
| Vəziyyət dəyişənləri | Arabanın mövqeyi, arabanın sürəti, çubuğun bucağı, çubuğun bucaq sürəti |
| Çubuq bucağı sərhədi | (−12°, 12°) xaricinə çıxıldıqda dayandırma |
| Araba mövqeyi sərhədi | (−2,4, 2,4) xaricinə çıxıldıqda dayandırma |
| Standart maksimum zaman addımı | 200 |
| Mükafat | Hər addım +1 |
| Başlanğıc vəziyyəti | (−0,05, 0,05) aralığında təsadüfi |
| Ümumi qaçış | 50 |
Şəbəkə hiperparametrləri
| Hiperparametr | Q-network | ELM / EQLM-HR strukturu |
|---|---|---|
| Öyrənmə sürəti | 0,0065 | Tətbiq edilmir |
| Nizamlama parametri | Tətbiq edilmir | 1,827×10−5 |
| Gizli düyün | 29 | 25 |
| Başlanğıc exploration ehtimalı | 0,670 | 0,599 |
| Exploration azaltma müddəti | 400 epizod | 360 epizod |
| Endirim əmsalı | 0,99 | 0,93 |
| Mini-batch | 26 | 2 |
| Target-network yeniləmə addımı | 70 | 48 |
| Nizamlama dərəcəsi | Tətbiq edilmir | EQLM: c=0; HR təcrübələri: c=1 |
İş Q-network və ELM əsaslı üsullarda eyni şəbəkə arxitekturası və ya eyni bütün hiperparametrlərdən istifadə etmir. HR ilə EQLM müqayisəsində isə mənbə eyni nizamlama parametrinin saxlandığını və əsas fərqin HR dərəcəsi olduğunu bildirir.
Maşın öyrənməsi təcrübə quruluşu
Təsnifatda IRIS və MNIST; reqressiyada Individual Household Electric Power Consumption, Appliances Energy Prediction və hava məlumatlarından istifadə edilmişdir.
MNIST təcrübəsində yalnız 1.000 görüntü, yəni mənbənin ifadəsi ilə ümumi təlim məlumatının təxminən %1,7-si təlim üçün istifadə edilmişdir. Digər məlumat dəstlərində iş ənənəvi 80/20 bölgüsünün əksinə %20 təlim və %80 test bölgüsündən istifadə etmişdir. Müəlliflər bu seçimlərin modelləri həddindən artıq uyğunlaşmaya daha meylli hala gətirərək məhdud təlim məlumatı şərtlərini təqlid etmək məqsədi daşıdığını bildirirlər.
Bütün maşın öyrənməsi təcrübələrində gizli düyün sayı 1.000-dir. FNN-lərdə təsnifat üçün bir, reqressiya üçün iki gizli qat istifadə edilmişdir. \(R=\bar{\mu}I\) üçün \(\bar{\mu}=1,0\); Dropout nisbəti isə 0,5 müəyyən edilmişdir. Hiperparametrlərin məlumat dəstinə xüsusi geniş optimallaşdırma əvəzinə standart ilkin dəyərlərlə seçildiyi açıq şəkildə bildirilir.
Performans ölçüləri
Təsnifatda test dəqiqliyi, reqressiyada RMSE istifadə edilmişdir. Cart-Pole təcrübəsində isə epizod mükafatı və öyrənmə əyrisinin sahəsi (AUC) əsas nəticə ölçüləridir. Cart-Pole qrafiklərində 50 qaçışın epizod üzrə orta mükafatı və %95 etibar intervalı kölgəli zolaqla göstərilir.
Hesablama mühiti
Cart-Pole şəbəkələri Intel i7-12700 prosessoru, 16 GB yaddaş və 12 GB RTX 3060 GPU olan masaüstü sistemdə öyrədilmişdir. Mənbə oyunun işlədilməsi daxil olmaqla hər şəbəkə təliminin bir saatdan çox çəkdiyini bildirir.
Şəkil 5–11-in ümumi mesajı
Q-network-un gradient-descent əsaslı yeniləmələrində qaçışlar arasında daha nəzərəçarpan dalğalanmalar görünür, EQLM isə daha sabit orta öyrənmə əyrisi göstərir. HR-nin məhdudiyyətsiz zaman-addımı təcrübəsində bəzi qaçışlar daha yüksək mükafata çatmış və orta mükafatı yüksəltmişdir. Standart 200 addımlı təcrübədə HR öyrənmə əyrisi Q-network ilə müqayisədə daha yüksək və daha sabit plato göstərir.
Şəkil 10 nizamlama parametri \(\bar{\mu}\) dəyişdirilərkən performansın monoton şəkildə sonsuza qədər artmadığını, müəyyən bölgədən sonra təxminən plato yarandığını göstərir. Şəkil 11 isə exploration ehtimalının azaldılma müddəti dəyişdirilərək öyrənmə sürətinin nəzərəçarpacaq dərəcədə dəyişə bildiyini göstərir. Bu nəticə performansın yalnız HR düsturundan deyil, öyrənmə prosesində exploration ayarından da asılı olduğunu göstərir.
Yenidən istehsal edilə bilmə və şərh sərhədləri
İş əsas təcrübə hiperparametrlərini və məlumat dəsti mənbələrini açıqlayır; lakin məqalə daxilində müstəqil kod/məlumat paylaşım deposu göstərilmir. Təsnifat və reqressiya cədvəllərindəki tək performans dəyərləri üçün qaçış sayı, standart sapma və ya etibar intervalı verilmədiyindən bu təcrübələrdə üsulun variasiyası qiymətləndirilə bilmir.
Müəlliflərin öz nəticə bölməsində də HR-nin dərin çoxqatlı şəbəkələrə, convolutional şəbəkələrə, attention strukturlarına, recurrent şəbəkələrə və transformer əsaslı modellərə tam inteqrasiyasının hələ açıq tədqiqat mövzusu olduğu bildirilir. Böyük miqyaslı problemlərdə hesablama dəyəri və ədədi sabitlik də gələcəkdə öyrənilməli sahələr sırasındadır.
Mənbə və Metod Qeydi
Tam orijinal iş adı: High-order regularization for explainable generalization in machine learning and learning-based control
Müəlliflər və sıra: Xinghua Liu; Ming Cao.
Bərabər töhfə/bərabər birinci müəlliflik: Mənbədə bərabər töhfə və ya bərabər birinci müəlliflik bəyanı yoxdur.
Məsul/əlaqə müəllifi: Mənbə mətnində ayrıca “corresponding author” işarəsi görünmür. SSRN-in rəsmi biblioqrafik qeydi Xinghua Liu-nu “Contact Author” kimi göstərir.
Qurum: Engineering and Technology institute Groningen (ENTEG), University of Groningen, 9747 AG Groningen, the Netherlands.
Mənbə növü: Riyazi üsul inkişafı, maşın öyrənməsi təcrübələri və öyrənmə əsaslı idarəetmə təcrübəsini ehtiva edən tədqiqat preprinti.
Rəyçilik statusu: Bu iş rəy prosesindən keçməmiş preprintdir; nəticələri bu nəşr mərhələsi nəzərə alınmaqla qiymətləndirilməlidir.
Platforma: SSRN.
DOI: 10.2139/ssrn.6963250
SSRN nəşr tarixi: 18 iyun 2026.
Mənbə mətnindəki tarix: “Preprint submitted to XXX June 6, 2026”. Buradakı “XXX” mənbədə saxlanmış yer tutucudur və real jurnal adı kimi şərh edilməmişdir.
Rəsmi keçid: https://ssrn.com/abstract=6963250
DOI keçidi: https://doi.org/10.2139/ssrn.6963250
Jurnal/cild/say/məqalə nömrəsi: Baxılan versiyada təsdiqlənmiş rəyli jurnal, cild, say və ya məqalə nömrəsi yoxdur.
Nəşriyyat: Mənbə işin rəyli nəşr nəşriyyatı müəyyən edilməmişdir; “XXX” ifadəsi nəşriyyat və ya jurnal adı kimi istifadə edilməmişdir.
Lisenziya: Baxılan versiyada Creative Commons və ya ekvivalent açıq təkrar istifadə lisenziyası açıq göstərilmir. Buna görə orijinal şəkillər bu Verianla HTML-inə birbaşa köçürülməmişdir.
Maliyyələşdirmə: İş Netherlands Organization for Scientific Research çərçivəsində NWO-Vici-19902 və China Scholarship Council tərəfindən qismən dəstəklənmişdir.
Məlumat/kod əlçatanlığı: Mənbədə ayrıca məlumat və ya kod paylaşım bəyanı yoxdur. Təcrübələrdə istifadə olunan açıq məlumat mənbələri və OpenAI Gym istinadları ədəbiyyatda göstərilmişdir.
Maraq toqquşması: Baxılan versiyada ayrıca maraq toqquşması bəyanı müəyyən edilməmişdir.
CRediT töhfələri: Xinghua Liu — Conceptualization, Writing – review & editing, Writing – original draft, Methodology, Validation, Formal analysis. Ming Cao — Writing – review & editing, Validation, Supervision, Funding acquisition.
Generativ süni intellekt bəyanı: Müəlliflər ChatGPT-dən qrammatika və yazı yoxlaması ilə mətn keyfiyyətinin yaxşılaşdırılması məqsədilə istifadə etdiklərini, daha sonra məzmunu nəzərdən keçirib redaktə etdiklərini və işin məzmununa görə məsuliyyət daşıdıqlarını bildirirlər.
Mənbədaxili uyğunsuzluq 1: Bölmə 3.7 Algorithm 2-ni təqdim edərkən təklif olunan HR üçün nizamlama dərəcəsinin \(c=1\) olduğunu bildirir və Algorithm 2-nin 8-ci sətri də açıq şəkildə \(c=1\) verir. Buna baxmayaraq, eyni bölmədə bir cümlə Algorithm 2-nin yeniləmə proseslərində \(c=0\)-ı sabit saxladığını söyləyir. Bu ziddiyyət səssizcə düzəldilməmişdir; təcrübə cədvəlləri və alqoritmin açıq sətri HR-ni \(c=1\) kimi bildirir.
Mənbədaxili uyğunsuzluq 2: Əsas hesablama mürəkkəbliyi müzakirəsinin bir hissəsində nizamlama dərəcəsi üçün \(k\) simvolu istifadə olunur, halbuki işin riyazi tərifi və Appendix D boyunca nizamlama dərəcəsi \(c\) ilə göstərilir və əlavə mürəkkəblik \(O(cn)\) şəklində ifadə edilir.
Əsas elmi sərhəd: İşin nəzəri genelləşmə analizi əsasən son gizli qat xəritələməsi və \(H^\top H\) informasiya matrisinin şərtlənməsi üzərində qurulub. Eksperimental doğrulama Cart-Pole və seçilmiş aşağı/orta miqyaslı təsnifat-reqressiya tapşırıqları ilə məhduddur. Böyük müasir dərin şəbəkə arxitekturalarında performans, hesablama dəyəri və miqyaslana bilmə bu iş daxilində təsdiqlənməyib.
Elmi məzmun sərhədi: Bu Verianla məqaləsindəki HR tənlikləri, teoremlər, alqoritmlər, məlumat bölünmələri, hiperparametrlər, təcrübə nəticələri, qrafik şərhləri və məhdudiyyətlər yalnız baxılan işə əsaslanır. Xarici mənbələr yalnız biblioqrafik kimliyin doğrulanması üçün istifadə edilmiş, əsas elmi mətnə xarici təcrübə və ya yeni performans nəticəsi əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib