

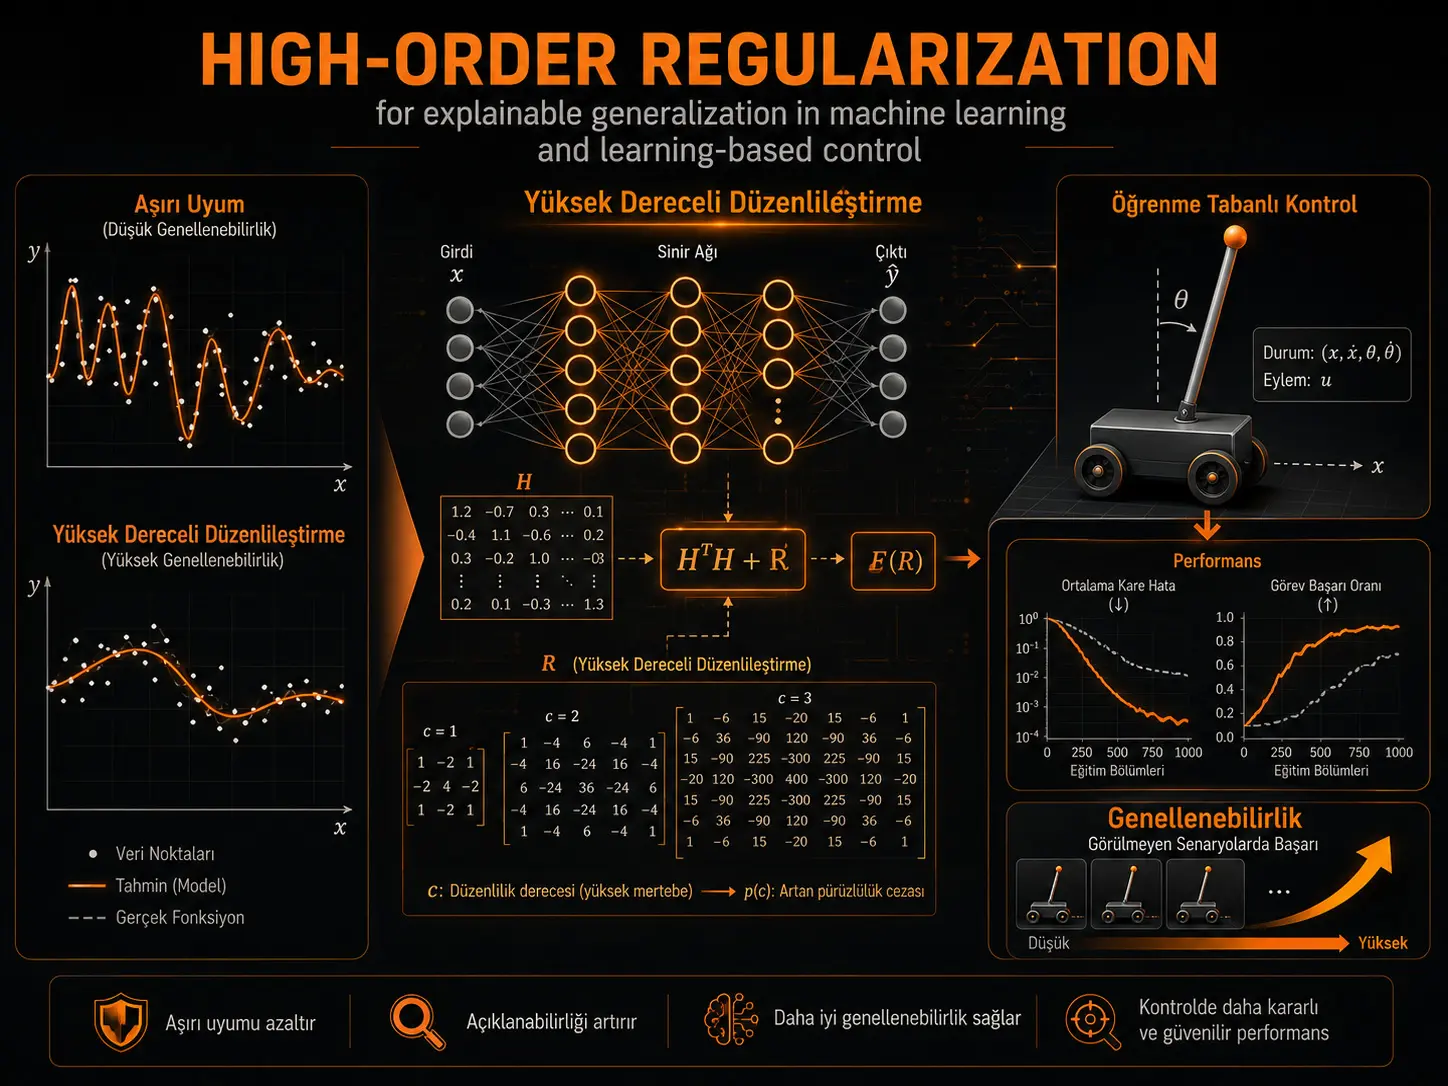
Ин таҳқиқот бо мақсади шарҳи математикӣ дар бораи он ки танзимсозӣ ҳангоми коҳиш додани overfitting дар шабакаҳои нейронӣ чаро ва чӣ гуна қобилияти умумисозиро тағйир медиҳад, усуле бо номи High-Order Regularization (HR) — Танзимсозии Дараҷаи Баланд пешниҳод мекунад. HR ҳисобкунии вазнҳои омӯзишшавандаро аз қабати ниҳонии охирини шабакаи нейронӣ то баромад ҳамчун масъалаи харитасозии баръакс баррасӣ намуда, баръакси матритсаи иттилоотии \(H^\top H\)-ро бо қатори маҳдуди қувваҳои матритсавӣ тақриб мекунад. Танзимсозии анъанавии L2-norm дар ин чаҳорчӯба ҳамчун ҳолати махсуси дараҷаи паст бо \(c=0\) пайдо мешавад, дар ҳоле ки дар татбиқҳо бештар \(c=1\) истифода шудааст. Қисми назариявӣ конвергенсия, ҳудудҳои поёнӣ ва болоии хатои ҳисобшаванда ва меъёри умумисозиро, ки тавассути матритсаи танзимсозӣ condition number-ро назорат мекунад, ҳосил менамояд. Дар таҷрибаҳо HR дар идоракунии Cart-Pole, таснифоти IRIS ва MNIST ва се масъалаи регрессия нисбат ба усулҳои муқоисашуда мукофот/дақиқии баландтар ё RMSE-и пасттар нишон додааст. Бо вуҷуди ин, таҷрибаҳо танҳо дар шумораи маҳдуди масъалаҳо иҷро шудаанд, тақсимоти додаҳо махсусан барои ташвиқи overfitting тарҳрезӣ шудаанд ва scalability дар меъмориҳои бузурги муосири шабакаҳои амиқ ҳанӯз таҷрибавӣ нишон дода нашудааст.
Дар муқоисаи таҷрибаи Cart-Pole, ки маҳдудияти қадами вақт бардошта шудааст, миёнаи мукофоти 50 эпизоди охир барои Q-network 207,4, барои EQLM 208,2 ва барои HR-и пешниҳодшуда 273,4 гузориш шудааст. Муаллифон ин натиҷаро нисбат ба Q-network ҳамчун беҳбудии %31,8 ва нисбат ба EQLM ҳамчун %31,3 ифода мекунанд. Аммо тағйирпазирии байни run-ҳо барои HR баланд аст; дар ҳамон ҷадвал стандарт deviation барои HR 323,7 дода шудааст. Аз ин рӯ, миёнаи баланд маънои variance-и камтарро надорад.
Дар таҷрибаи Cart-Pole бо маҳдудияти стандартии 200 қадами вақт, мукофоти 50 эпизоди охири HR 175,2 аст, дар ҳоле ки барои Q-network 123,8; қиматҳои AUC мутаносибан \(87,5\times10^3\) ва \(71,0\times10^3\) гузориш шудаанд. Муаллифон инҳоро мутаносибан ҳамчун афзоиши %41,5 ва %23,2 арзёбӣ мекунанд. Дар ин таҷрибаи назоратшуда тақсимоти мукофотҳои HR нисбат ба таҷрибаи бе маҳдудияти қадами вақт тангтар аст.
Дар таҷрибаҳои омӯзиши мошинӣ низ ҳамин тамоюл дида мешавад. Дақиқии тестии IRIS бо HR %95,0; бо Dropout %94,2; бо L2-norm %93,3 ва бо FNN-и бидуни танзимсозӣ %87,5 мебошад. Дар MNIST ҳангоми истифодаи танҳо 1.000 тасвири омӯзишӣ HR %84,1, Dropout %83,4, L2-norm %82,7 ва FNN %59,0 дақиқӣ додааст. Ин муқоисаҳо бартарии HR-ро дар тестҳои интихобшуда нишон медиҳанд; аммо таҳқиқот барои ин натиҷаҳои ҷадвал тақсимоти таҷрибаҳои такрорӣ, confidence interval ё санҷиши аҳамияти оморӣ байни усулҳоро гузориш намекунад.
Аз нигоҳи Туркия: Равиши HR усули математикӣ пешниҳод мекунад, ки метавонад дар таҳқиқоти омӯзиши мошинӣ, роботика, идоракунии адаптивӣ, автоматизатсияи саноатӣ ё системаҳои қароргирие, ки бо додаҳои омӯзишии маҳдуд/ғаразнок кор мекунанд, дар Туркия санҷида шавад. Аммо қиматҳои performance-и ин таҳқиқотро ба ягон системаи воқеӣ дар Туркия мустақиман интиқол додан мумкин нест. Барои истифодаи маҳаллӣ тақсимоти додаҳо, меъмории шабака, таҷҳизоти ҳисоббарорӣ, маҳдудиятҳои real-time, талаботи бехатарӣ ва benchmark-ҳои мустақил бо усулҳои мавҷуда бояд алоҳида санҷида шаванд.
Масъалаи асосии таҳқиқот чист?
Танзимсозӣ барои пешгирии аз ҳад мувофиқшавии шабакаи нейронӣ ба додаҳои омӯзишӣ ва беҳтар кардани рафтор дар додаҳои нодида васеъ истифода мешавад. Гарчанде муваффақияти амалии L2, L1, dropout, mixup, early stopping ва усулҳои монанд хуб маълум аст, холигие, ки таҳқиқот ҳадаф гирифтааст, ин аст, ки танзимсозӣ ҳалли аслиро математикӣ чӣ гуна тағйир медиҳад, кадом bias-ро ба вуҷуд меорад ва чӣ гуна тавозуни байни ин bias ва умумисозӣ ҳисоб карда мешавад.
Шакли 1 ин масъаларо тавассути регрессия ва таснифот тасвир мекунад. Моделҳои мураккабе, ки ба нуқтаҳои омӯзишӣ аз ҳад печида мувофиқ мешаванд, бо кабуд ва моделҳои танзимшудаи камтар мураккаб бо хатҳои сиёҳ нишон дода мешаванд. Паёми асосӣ ин аст, ки модели беҳтар мутобиқшуда ба намунаҳои омӯзишӣ ҳатман барои додаҳои нодида беҳтарин нест.
Чаро таҳлил бар Extreme Learning Machine сохта шудааст?
Барои ҳосил кардани назария ба таври возеҳ, таҳқиқот аз меъмории Extreme Learning Machine (ELM) истифода мебарад. ELM шабакаи feedforward бо як қабати ниҳонӣ аст; вазнҳои аз даромад ба қабати ниҳонӣ ва bias-и эҳтимолӣ тасодуфӣ таъин мешаванд ва танҳо вазнҳои \(\beta\), ки аз қабати ниҳонӣ ба баромад мераванд, аналитикӣ ҳисоб карда мешаванд.
Дар Шакли 2 меъмории ELM нишон дода мешавад, ки гиреҳҳои даромад ба гиреҳҳои ниҳонӣ ва онҳо ба баромадҳо пайваст мешаванд. Барои намунаи даромади \(x_j\), баромади шабака:
\[ \sum_{i=1}^{L}\beta_i g_i(x_j) = \sum_{i=1}^{L}\beta_i g_i(w_i\cdot x_j+b_i) = o_j \]
ифода мешавад. Дар ин ҷо \(L\) шумораи гиреҳҳои ниҳонӣ, \(w_i\) вазнҳои тасодуфии даромад, \(b_i\) bias, \(g_i\) функсияи activation ва \(\beta_i\) вазни омӯзишшавандаи баромадро ифода мекунад.
Масъалаи асосии омӯзиш:
\[ \min_{\beta\in\mathbb{R}^{L\times k}} \left\|H\beta-Y\right\|^2 \]
навишта мешавад. \(H\) матритсаи баромади қабати ниҳонӣ ва \(Y\) нишони омӯзиш аст. Бе танзимсозӣ, ҳалли least-squares бо minimum norm тавассути Moore–Penrose pseudoinverse:
\[ \hat{\beta}=H^\dagger Y \]
ба даст меояд.
L2 дар ин сохтор чӣ гуна пайдо мешавад?
Дар манбаъ ҳалли классикии L2-танзимшуда:
\[ \hat{\beta} = \left( H^\top H+\frac{I}{\mu} \right)^\dagger H^\top Y \]
дода шудааст. Ин амал метавонад матритсаи badly-conditioned \(H^\top H\)-ро аз ҷиҳати ададӣ устувортар кунад; аммо танзимсозӣ ҳамзамон нисбат ба ҳалли назариявии optimal bias-и баҳодиҳиро ба вуҷуд меорад. HR кӯшиш мекунад ин bias-ро мустақиман ҳамчун хатои approximate inverse mapping таъриф кунад.
High-Order Regularization чӣ гуна ҳосил мешавад?
Нуқтаи оғозии HR:
\[ F(R) := R\left(H^\top H+R\right)^{-1} \]
мебошад. Дар ин ҷо \(R\) матритсаи танзимсозии интихобшаванда аст. Дар шарти мувофиқи spectral radius:
\[ (I-F(R))^{-1} = \sum_{i=0}^{\infty}F^i(R), \qquad \rho(F(R))<1 \]
қатори қувваҳои матритсавӣ истифода мешавад. Вақте қатори беохир пас аз \(c+1\) аъзо бурида мешавад, ҳалли пешниҳодшудаи HR ба даст меояд:
\[ \hat{\beta}_{hr} = \left(H^\top H+R\right)^{-1} \sum_{i=0}^{c} F^i(R)H^\top Y, \qquad \rho(F(R))<1 \]
\(c\) дараҷаи танзимсозӣ аст. Ҳангоми \(c=0\) ва \(R=\bar{\mu}I\), ҳалли HR ба шакли классикии L2-norm regularization коҳиш меёбад. Вақте \(c\geq1\), mapping-и баръакс бо якчанд аъзои қатори матритсавӣ тақриб карда мешавад ва таҳқиқот онро “high-order” меномад.
Чаро L2 ҳолати махсуси HR ҳисоб мешавад?
Дар HR агар \(c=0\) интихоб шавад, қатор танҳо аъзои identity-ро дар бар мегирад:
\[ \sum_{i=0}^{0}F^i(R)=I \]
ва:
\[ \hat{\beta}_{hr} = (H^\top H+R)^{-1}H^\top Y \]
ба даст меояд. Интихоби \(R=\bar{\mu}I\) ҳалли классикии L2/Tikhonov-ро медиҳад. Appendix A инчунин нишон медиҳад, ки expected loss-и dropout дар қабати ниҳонии охирин ба:
\[ L(\beta)= \frac{1}{2N}\|y-H\beta\|_2^2+ \frac{1-p}{2pN} \beta^\top \operatorname{diag}(H^\top H) \beta \]
яъне norm regularization табдил дода мешавад. Дар ин ҳосилкунии махсуси dropout коэффициенти танзимсозӣ \((1-p)/p\) ба variance-и dropout noise вобаста аст.
Конвергенсияи ҳалли HR чӣ гуна шарҳ дода мешавад?
Дар таҳқиқот хатои HR:
\[ e_\beta=\hat{\beta}_{hr}-\beta_{opt} \]
таъриф шудааст. Теоремаи 1 нишон медиҳад, ки дар шароити муайяни positive definiteness ва spectral radius, вақте матритсаи танзимсозӣ ба сифр наздик мешавад ё дараҷаи танзимсозӣ ба беохир меравад, хатои HR ба сифр наздик мешавад:
\[ \lim_{R\rightarrow O}\|e_\beta\|=0, \qquad \lim_{c\rightarrow+\infty}\|e_\beta\|=0 \]
Ин имкон медиҳад truncation error-и қатори HR мустақиман ба R ва дараҷаи қатор вобаста карда шавад.
Чаро хато ҳисобшаванда дониста мешавад?
Хатои тақрибии матритсаи баръакс:
\[ F_{ar}(R) = (H^\top H)^{-1} - (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
таъриф мешавад. Дар шароити мувофиқ:
\[ F_{ar}(R) = (H^\top H)^{-1}F^{c+1}(R) \]
ба даст меояд. Сипас барои хатои HR ҳудудҳои поёнӣ ва болоӣ ҳосил мешаванд:
\[ \frac{1}{1-\lambda_{\min}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \leq \|e_\beta\| \]
ва:
\[ \|e_\beta\| \leq \frac{1}{1-\lambda_{\max}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \]
Аз ин рӯ, фарқе, ки аз танзимсозӣ нисбат ба ҳалли назариявӣ ба вуҷуд меояд, танҳо penalty-и интуитивӣ нест, балки хатои approximate inversion мебошад, ки дар зери \(R\) ва \(c\)-и интихобшуда маҳдуд карда мешавад.
Чаро танзимсозӣ ҳамчун contraction тафсир мешавад?
Дар Теоремаи 2 нишон дода мешавад, ки дар шароити мувофиқи symmetric positive semidefinite \(R\) ва positive definite \(H^\top H\), матритсаи танзимсозӣ ба нормаи хатои тақрибии \(F_{ar}(R)\) таъсири contraction дорад. Таносуби contraction-ро ҳам \(R\) ва ҳам \(c\) муайян мекунанд.
Дар ин нигоҳ, дараҷаи паст метавонад байни optimum-и назариявӣ ва ҳалли танзимшуда фосилаи калонтар эҷод кунад; аъзои бештари қатор бошад, approximation-и inverse mapping-ро беҳтар мекунанд. Дар иваз бояд байни коҳиш додани ill-conditioning ва bias-и баҳодиҳӣ тавозун ба вуҷуд оварда шавад.
“Максималии умумисозӣ” чӣ маъно дорад?
Таҳқиқот умумисозиро на дар ҳамаи тақсимоти имконпазири тест, балки тавассути \(H^\top H+R\) condition number-и тавсиф мекунад:
\[ \operatorname{Cond}(R) = \|H^\top H+R\| \, \|(H^\top H+R)^{-1}\| \]
Коҳиши condition number маънои масъалаи беҳтар шартшударо дорад, ки тағйироти хурди додаҳои омӯзиширо ба тағйироти аз ҳад калони вазнҳо табдил намедиҳад. Меъёри тавозуни таҳқиқот:
\[ \operatorname{Obj}(R) = \|F_{ar}(R)\| \operatorname{Cond}(R) \]
мебошад. Ин objective ҳам bias-и баҳодиҳӣ ва ҳам ill-conditioning-ро якҷо ба ҳисоб мегирад.
Дар Proposition 2, агар eigenvalue-ҳои \(H^\top H\) \(\lambda_i\) бошанд:
\[ \lambda_{R,i} = \max\{\bar{\mu}-\lambda_i,0\} \]
матритсаи танзимсозии сохторёфта баррасӣ мешавад. Дар меъёри математикӣ бо \(\bar{\mu}=\lambda_1\) condition number то 1 паст карда мешавад. Ин “максималии умумисозӣ” танҳо дар дохили таърифи назариявии based-on-condition-number-и таҳқиқот аст ва набояд ҳамчун кафолати performance-и универсалӣ дар ҳамаи тақсимоти воқеӣ фаҳмида шавад.
Шакли 4 танзимсозиро чӣ гуна шарҳ медиҳад?
Шакли 4 хулосаи визуалии шарҳи назариявӣ аст. Доираи калонтарин маҷмӯи ҳалли эҳтимолии шабакаи аслӣ барои додаҳои омӯзишӣ ва матритсаи \(H^\top H\)-ро, марказ ҳалли назариявии optimal-ро нишон медиҳад. Доираҳои хурдтар ҳалли танзимшударо барои \(R\)-ҳои гуногун нишон медиҳанд. Радиуси доираи dashed bias-и баҳодиҳиро барои \(c\)-и муайян ифода мекунад.
Паёми асосӣ ин аст, ки regularization-и қавитар худкор беҳтар нест. Ҳадаф — ёфтани \(R\) ва \(c\), ки ҳалли устувор месозанд, вале онро аз optimum-и назариявӣ бе зарурат дур намекунанд.
HR дар mapping-ҳои singular ё калон чӣ гуна васеъ мешавад?
Ҳангоми калон шудани шабака \(H^\top H\) метавонад singular шавад. Таҳқиқот дар ин ҳолат Moore–Penrose pseudoinverse-ро истифода бурда, усули умумии inverse mapping-ро васеъ мекунад. Наздиксозӣ:
\[ F_{aim}(H,R,c) = (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
таъриф мешавад ва:
\[ F_{ar}(R) = (H^\top H)^\dagger-F_{aim}(H,R,c) \]
ҳоло хатои general inverse approximation-ро ифода мекунад. Дар Теоремаи 3:
\[ \lim_{c\rightarrow+\infty}F_{ar}(R) = (H^\top H)^\dagger-R^{-1} \]
дода мешавад. Тафсири манбаъ ин аст, ки интихоби мувофиқи \(R\) имкон медиҳад дар mapping-ҳои singular ҳам approximation error ва conditioning якҷо идора шаванд.
Incremental HR чӣ гуна кор мекунад?
Incremental High-Order Regularization (IHR) ҳангоми омадани mini-batch-и нав ба ҷои аз нав омӯзонидани тамоми шабака, матритсаи иттилоотӣ ва вазнҳои мавҷударо нав мекунад. Навсозии асосӣ:
\[ \hat{\beta}_{t+1} = K_{t+1}(c)\hat{\beta}_t + F_{aim,t+1}H_{ic}^{\top}Y_{ic} \]
мебошад. Дар ин ҷо mini-batch-и нави \(H_{ic},Y_{ic}\) ба модели мавҷуда илова мешавад. Таҳқиқот ин сохторро махсусан дар learning-based control барои коҳиш додани overfitting, ки аз додаҳои пастсифат ва маҳдуди марҳилаи аввали омӯзиш ба вуҷуд меояд, баррасӣ мекунад.
Тафсири “омӯзиш, хотира ва фаромӯшӣ” дар HR чист?
Муаллифон фишор додани таъсири додаҳои нокифоя ё ғаразнок аз ҷониби regularization-ро дар марҳилаи аввал ҳамчун навъи adaptive forgetting тафсир мекунанд. Бо пешрафти омӯзиш ва афзоиши сифату миқдори иттилоот, тағйир ёфтани таъсири regularization барои шарҳи муносибати байни омӯзиши маълумоти нав ва вазни додаи маълумоти кӯҳна истифода мешавад.
Ин далели механизми нейробиологии хотира нест; ин тафсири learning-based control-и рафтори математии regularization мебошад.
Дар таҷрибаи Cart-Pole чӣ ёфт шуд?
Масъалаи OpenAI Gym Cart-Pole барои муқоисаи Q-network, EQLM ва HR-EQLM истифода шудааст. Дар таҷрибаҳои бидуни маҳдудияти қадами вақт, барои 50 run миёнаи мукофоти 50 эпизоди охир:
| Усул | Миёнаи мукофоти 50 эпизоди охир | AUC (×10³) |
|---|---|---|
| Q-network | 207,4 (176,2–236,3) | 107,8 (103,8–111,8) |
| EQLM | 208,2 (188,51–224,98) | 97,2 (90,3–103,3) |
| HR-и пешниҳодшуда | 273,4 (166,1–340,3) | 116,3 (86,1–136,8) |
HR баландтарин миёнаи мукофотро додааст. Бо вуҷуди ин, дар ҳамон Ҷадвали 4 standard deviation барои Q-network 108,7, EQLM 66,2 ва HR 323,7 мебошад. Миёнаи баланди HR аз run-ҳое таъсир гирифтааст, ки баъзе мукофотҳо хеле болотар аз 200 қадами вақт буданд; бинобар ин, тағйирпазирии байни run-ҳо низ бояд ба ҳисоб гирифта шавад.
Дар таҷрибаи 200 қадами вақт натиҷа чӣ гуна тағйир ёфт?
Ҳангоми татбиқи маҳдудияти стандартии 200 қадами вақт, муқоиса дар доираи performance-и тангтар анҷом шудааст:
| Усул | Миёнаи мукофоти 50 эпизоди охир | AUC (×10³) |
|---|---|---|
| Q-network | 123,8 (112,4–135,5) | 71,0 (68,8–73,5) |
| HR-и пешниҳодшуда | 175,2 (169,6–180,9) | 87,5 (84,7–90,5) |
Манбаъ беҳбудии HR-ро дар мукофоти 50 эпизоди охир %41,5 ва дар AUC %23,2 гузориш мекунад. Standard deviation-и HR 20,3 ва Q-network 41,9 аст.
Натиҷаҳои IRIS ва MNIST чӣ нишон медиҳанд?
Дар таҷрибаҳои таснифот FNN, Dropout, L2-norm ва HR бо \(c=1\) муқоиса шудаанд:
Verianla Live: Дақиқии таснифоти усулҳои танзимсозӣ
Муқоиса дақиқии тестии Ҷадвали 6-ро нишон медиҳад. Таҷрибаи MNIST танҳо бо 1.000 тасвири омӯзишӣ анҷом шудааст; аз ин рӯ ин қиматҳо набояд ҳамчун benchmark-и стандартӣ бо тамоми маҷмӯи омӯзишии MNIST тафсир шаванд.
| Маҷмӯи додаҳо | FNN | Dropout | L2-norm (c=0) | HR-и пешниҳодшуда (c=1) | Воҳид | Манбаъ |
|---|---|---|---|---|---|---|
| IRIS | 87,5 | 94,2 | 93,3 | 95,0 | Дақиқии тест (%) | Ҷадвали 6 |
| MNIST | 59,0 | 83,4 | 82,7 | 84,1 | Дақиқии тест (%) | Ҷадвали 6 |
HR дар ҳар ду dataset баландтарин дақиқии тестиро додааст. Аммо фарқи HR ва Dropout дар IRIS 0,8 percentage point ва дар MNIST 0,7 point аст. Азбаски санҷиши аҳамияти оморӣ ё confidence interval-и run-ҳои такрорӣ дода нашудааст, ин фарқҳои хурд набояд ҳамчун бартарии умумӣ фаҳмида шаванд.
Дар таҷрибаҳои регрессия чӣ ёфт шуд?
Дар вазифаҳои регрессия Root Mean Squared Error (RMSE)-и пасттар performance-и беҳтарро нишон медиҳад:
| Маҷмӯи додаҳо | FNN RMSE | Dropout RMSE | L2-norm RMSE | HR (c=1) RMSE |
|---|---|---|---|---|
| Weather prediction | 4,2274 | 2,1575 | 2,7061 | 2,0888 |
| Power consumption | 0,7488 | 0,7140 | 0,7474 | 0,7096 |
| Appliances energy | 87,7197 | 79,0572 | 79,4058 | 77,3815 |
HR дар ҳамаи се регрессияи таҳқиқот RMSE-и пасттарин додааст. Дар Weather prediction фарқи Dropout ва HR нисбатан хурд аст, аммо хатои FNN-и бе танзимсозӣ баландтар мебошад.
Шаклҳои 12 ва 13 чӣ нишон медиҳанд?
Шакли 12-и Appliances Energy хатои prediction minus actual-ро дар вақт барои FNN, L2, HR ва Dropout нишон медиҳад. Шакли 13 тақсимоти ҳамин хатоҳоро муқоиса мекунад. Тақсимоти хатои моделҳои танзимшуда дар атрофи сифр ба шакли монанд ҷамъ мешаванд.
Барои кам кардани bias-и regularization дар моделҳои регрессия, бо истифода аз validation data-и ҷудошуда аз training data ислоҳи bias иҷро шудааст. Аз ин рӯ, натиҷаҳои регрессия дар ҷадвал ҳам таъсири ҳалли хоми танзимшуда ва ҳам раванди validation-based correction-ро дар бар мегиранд.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- HR ҳамчун шакли truncated matrix-power-series approximate inversion ба таври возеҳ формула шудааст.
- L2-norm regularization дар HR ҳамчун ҳолати махсуси \(c=0\) ифода мешавад.
- Дар шароити муайяни матритсавӣ конвергенсияи HR ва ҳудудҳои ҳисобшавандаи хато назариявӣ ҳосил шудаанд.
- Матритса ва дараҷаи regularization суръати contraction-и approximate inversion error-ро назорат мекунанд.
- Дар таърифи condition-number-based-и таҳқиқот сохтори eigenvalue-и \(R\) метавонад барои оптимизатсияи меъёри умумисозӣ тарҳрезӣ шавад.
- Дар таҷрибаҳои интихобшудаи Cart-Pole, таснифот ва регрессия HR бо \(c=1\) дар меъёрҳои асосии гузоришшуда аз усулҳои муқоисашуда беҳтар натиҷа додааст.
Натиҷаҳое, ки таҳқиқот исбот накардааст ё ҳанӯз насанҷидааст
- Бартарии HR аз L2, Dropout ё дигар regularization дар ҳамаи вазифаҳои ML нишон дода нашудааст.
- Minimum condition number дар ҳамаи тақсимоти воқеӣ maximum test performance-ро кафолат намедиҳад.
- Scalability-и HR дар CNN, RNN ё transformer-ҳои калон таҷрибавӣ тасдиқ нашудааст.
- Натиҷаҳои Cart-Pole санҷиши саҳроӣ дар роботи воқеӣ ё системаи safety-critical control нестанд.
- Барои фарқҳои хурди IRIS, MNIST ва регрессия санҷиши statistical superiority гузориш нашудааст.
- Натиҷаи MNIST benchmark бо маҷмӯи пурраи стандартӣ нест; танҳо 1.000 тасвир истифода шудааст.
- “Explainability” дар манбаъ бештар шарҳи mathematical effect-и regularization аст, на мисли SHAP шарҳи example-based attribution.
Усул ва Натиҷаҳои Таҳқиқот
Усули назариявӣ
Қисми назариявӣ баромади қабати ниҳонии охиринро ҳамчун матритсаи mapping \(H\) ва вазнҳои баромадро ҳамчун \(\beta\) таҳлил мекунад. HR ба ҷои истифодаи мустақими \(H^\top H\) ё Moore–Penrose inverse-и он, аз матритсаи танзимшуда ва қатори буридаи қувваҳо inverse-и тақрибӣ месозад.
| Ҷузъ | Ифода дар манбаъ | Вазифа |
|---|---|---|
| Матритсаи иттилоот/mapping | \(H^\top H\) | Иттилооти mapping-и гирифташуда аз training data. |
| Матритсаи regularization | \(R\) | Тавозуни conditioning ва estimation bias-ро тағйир медиҳад. |
| Матритсаи қатор | \(F(R)=R(H^\top H+R)^{-1}\) | Қатори қувваҳои approximate inversion-ро месозад. |
| Дараҷаи regularization | \(c\) | Шумораи high-order term-ҳои нигоҳдошташударо муайян мекунад. |
| Approximate inverse | \(F_{aim}(H,R,c)\) | HR approximation-и general inverse mapping. |
| Approximation residual | \(F_{ar}(R)\) | Фарқи inverse-и назариявӣ ва HR approximate inverse. |
Тарҳи таҷрибаи Cart-Pole
| Хусусият | Қимати манбаъ |
|---|---|
| Action space | Чап, рост |
| State variables | Мавқеи ароба, суръати ароба, кунҷи сутун, суръати кунҷии сутун |
| Ҳадди кунҷи сутун | Берун аз (−12°, 12°) — termination |
| Ҳадди мавқеи ароба | Берун аз (−2,4, 2,4) — termination |
| Максимуми стандартии қадам | 200 |
| Мукофот | Ҳар қадам +1 |
| Ҳолати оғоз | Тасодуфӣ дар (−0,05, 0,05) |
| Шумораи run | 50 |
Гиперпараметрҳои шабака
| Гиперпараметр | Q-network | ELM / EQLM-HR |
|---|---|---|
| Learning rate | 0,0065 | Татбиқ намешавад |
| Regularization parameter | Татбиқ намешавад | 1,827×10−5 |
| Hidden node | 29 | 25 |
| Initial exploration probability | 0,670 | 0,599 |
| Exploration decay | 400 эпизод | 360 эпизод |
| Discount factor | 0,99 | 0,93 |
| Mini-batch | 26 | 2 |
| Target-network update | 70 | 48 |
| Дараҷаи regularization | Татбиқ намешавад | EQLM: c=0; HR: c=1 |
Таҳқиқот барои Q-network ва ELM-based method-ҳо як меъморӣ ё ҳамаи гиперпараметрҳои якхеларо истифода намекунад. Дар муқоисаи HR ва EQLM манбаъ мегӯяд, ки regularization parameter якхела нигоҳ дошта шуда, фарқи асосӣ дараҷаи HR мебошад.
Тарҳи таҷрибаҳои омӯзиши мошинӣ
Барои тасниф IRIS ва MNIST; барои регрессия Individual Household Electric Power Consumption, Appliances Energy Prediction ва додаҳои обу ҳаво истифода шудаанд.
Дар MNIST танҳо 1.000 тасвир, яъне тақрибан %1,7 аз тамоми training data истифода шудааст. Барои дигар dataset-ҳо баръакси 80/20-и маъмул, %20 training ва %80 test истифода шудааст. Муаллифон мегӯянд, ки ин интихобҳо барои тақлид кардани limited-data setting ва афзоиши tendency ба overfitting анҷом шудаанд.
Дар ҳамаи таҷрибаҳо шумораи hidden node 1.000 аст. Дар FNN барои classification як ва барои regression ду hidden layer истифода шудааст. Барои \(R=\bar{\mu}I\), \(\bar{\mu}=1,0\); dropout rate 0,5 аст. Гиперпараметрҳо на бо optimization-и густурдаи dataset-specific, балки бо default value-ҳои стандартӣ интихоб шудаанд.
Меъёрҳои performance
Дар тасниф test accuracy, дар регрессия RMSE истифода шудааст. Дар Cart-Pole episode reward ва area under learning curve (AUC) меъёрҳои асосӣ мебошанд. Дар графикҳо миёнаи 50 run ва %95 confidence interval ҳамчун shaded band нишон дода мешавад.
Муҳити ҳисоббарорӣ
Шабакаҳои Cart-Pole дар системаи desktop бо Intel i7-12700, 16 GB RAM ва 12 GB RTX 3060 GPU омӯзонида шудаанд. Манбаъ мегӯяд, ки ҳар training, бо иҷрои бозӣ ҳамроҳ, зиёда аз як соат давом кардааст.
Паёми умумии Шаклҳои 5–11
Q-network бо gradient descent байни run-ҳо fluctuation-и бештар нишон медиҳад, дар ҳоле ки EQLM average learning curve-и муттасилтар дорад. Дар HR бе step limit баъзе run-ҳо ба reward-и баландтар расида, миёнаро боло бурдаанд. Дар таҷрибаи 200-қадамӣ HR нисбат ба Q-network plateau-и баландтар ва устувортар нишон медиҳад.
Шакли 10 нишон медиҳад, ки performance бо тағйири \(\bar{\mu}\) беохир монотонӣ зиёд намешавад ва пас аз як минтақа plateau пайдо мешавад. Шакли 11 нишон медиҳад, ки exploration decay period метавонад learning speed-ро назаррас тағйир диҳад. Яъне performance танҳо аз formula-и HR не, аз exploration setting ҳам вобаста аст.
Reproducibility ва ҳудуди тафсир
Таҳқиқот гиперпараметрҳои асосӣ ва манбаъҳои dataset-ро шарҳ медиҳад, аммо repository-и мустақили code/data пешниҳод намекунад. Барои classification/regression table-ҳо run count, standard deviation ва confidence interval дода нашудааст, бинобар ин variance-и method баҳогузорӣ намешавад.
Муаллифон мегӯянд, ки integration-и пурраи HR ба deep multilayer network, CNN, attention, RNN ва transformer ҳанӯз open research problem мебошад. Cost ва numerical stability дар масъалаҳои калон низ самтҳои оянда мебошанд.
Эзоҳи Манбаъ ва Усул
Номи пурраи аслии кор: High-order regularization for explainable generalization in machine learning and learning-based control
Муаллифон ва тартиб: Xinghua Liu; Ming Cao.
Equal contribution/co-first: Дар манбаъ чунин изҳорот нест.
Contact author: Дар матн corresponding author алоҳида нишон дода нашудааст. SSRN Xinghua Liu-ро “Contact Author” индекс мекунад.
Муассиса: Engineering and Technology institute Groningen (ENTEG), University of Groningen, 9747 AG Groningen, the Netherlands.
Навъи манбаъ: Research preprint бо рушди усули математикӣ, ML experiment ва learning-based control experiment.
Ҳолати peer review: Ин кор peer-reviewed нест; натиҷаҳо бо назардошти марҳилаи preprint арзёбӣ шаванд.
Платформа: SSRN.
DOI: 10.2139/ssrn.6963250
Санаи SSRN: 18 июни 2026.
Сана дар матни манбаъ: “Preprint submitted to XXX June 6, 2026”. “XXX” placeholder аст ва ҳамчун номи журнал тафсир нашудааст.
Пайванди расмӣ: https://ssrn.com/abstract=6963250
Пайванди DOI: https://doi.org/10.2139/ssrn.6963250
Журнал/том/шумора/мақола: Дар версияи баррасишуда маълумоти тасдиқшудаи peer-reviewed journal мавҷуд нест.
Ношир: Ношири peer-reviewed муайян нашудааст; “XXX” номи ношир ё журнал нест.
Литсензия: Creative Commons ё иҷозати кушоди ҳамсон ба таври равшан нишон дода нашудааст. Аз ин рӯ, расмҳои аслӣ бевосита нусхабардорӣ нашудаанд.
Маблағгузорӣ: Кор аз Netherlands Organization for Scientific Research (NWO-Vici-19902) ва China Scholarship Council қисман дастгирӣ шудааст.
Дода/код: Изҳороти ҷудогонаи code/data sharing нест. Dataset-ҳои кушода ва OpenAI Gym дар references оварда шудаанд.
Conflict of interest: Дар версияи баррасишуда изҳороти ҷудогона муайян нашудааст.
CRediT: Xinghua Liu — Conceptualization, Writing – review & editing, Writing – original draft, Methodology, Validation, Formal analysis. Ming Cao — Writing – review & editing, Validation, Supervision, Funding acquisition.
Изҳороти generative AI: Муаллифон мегӯянд, ки ChatGPT барои grammar/spelling ва беҳтар кардани сифати матн истифода шудааст; баъдан матнро баррасӣ ва таҳрир карда, масъулияти мундариҷаро қабул кардаанд.
Номувофиқати манбаъ 1: Section 3.7 ҳангоми муаррифии Algorithm 2 мегӯяд, ки дараҷаи regularization барои HR-и пешниҳодшуда \(c=1\) аст ва сатри 8-и Algorithm 2 низ ошкоро \(c=1\) медиҳад. Аммо як ҷумла дар ҳамон section мегӯяд, ки Algorithm 2 дар update-ҳо \(c=0\)-ро собит мекунад. Ин зиддият хомӯшона ислоҳ нашудааст; table-ҳо ва сатри равшани алгоритм HR-ро \(c=1\) гузориш мекунанд.
Номувофиқати манбаъ 2: Дар як қисми complexity discussion барои дараҷаи regularization \(k\) истифода мешавад, дар ҳоле ки дар таъриф ва Appendix D \(c\) истифода шуда, complexity ҳамчун \(O(cn)\) дода шудааст.
Ҳудуди асосии илмӣ: Таҳлили умумисозии назариявӣ асосан ба mapping-и қабати ниҳонии охирин ва conditioning-и \(H^\top H\) асос ёфтааст. Validation таҷрибавӣ бо Cart-Pole ва баъзе classification/regression task-ҳои хурд/миёна маҳдуд аст. Performance, cost ва scalability дар меъмориҳои калони муосир санҷида нашудаанд.
Ҳудуди мундариҷаи илмӣ: Ҳама equation, theorem, algorithm, data split, hyperparameter, experiment result, graph interpretation ва limitation дар ин мақолаи Verianla танҳо аз кори баррасишуда гирифта шудаанд. Манбаъҳои беруна танҳо барои bibliographic verification истифода шудаанд ва ба матни асосӣ натиҷаи нави беруна илова нашудааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд