

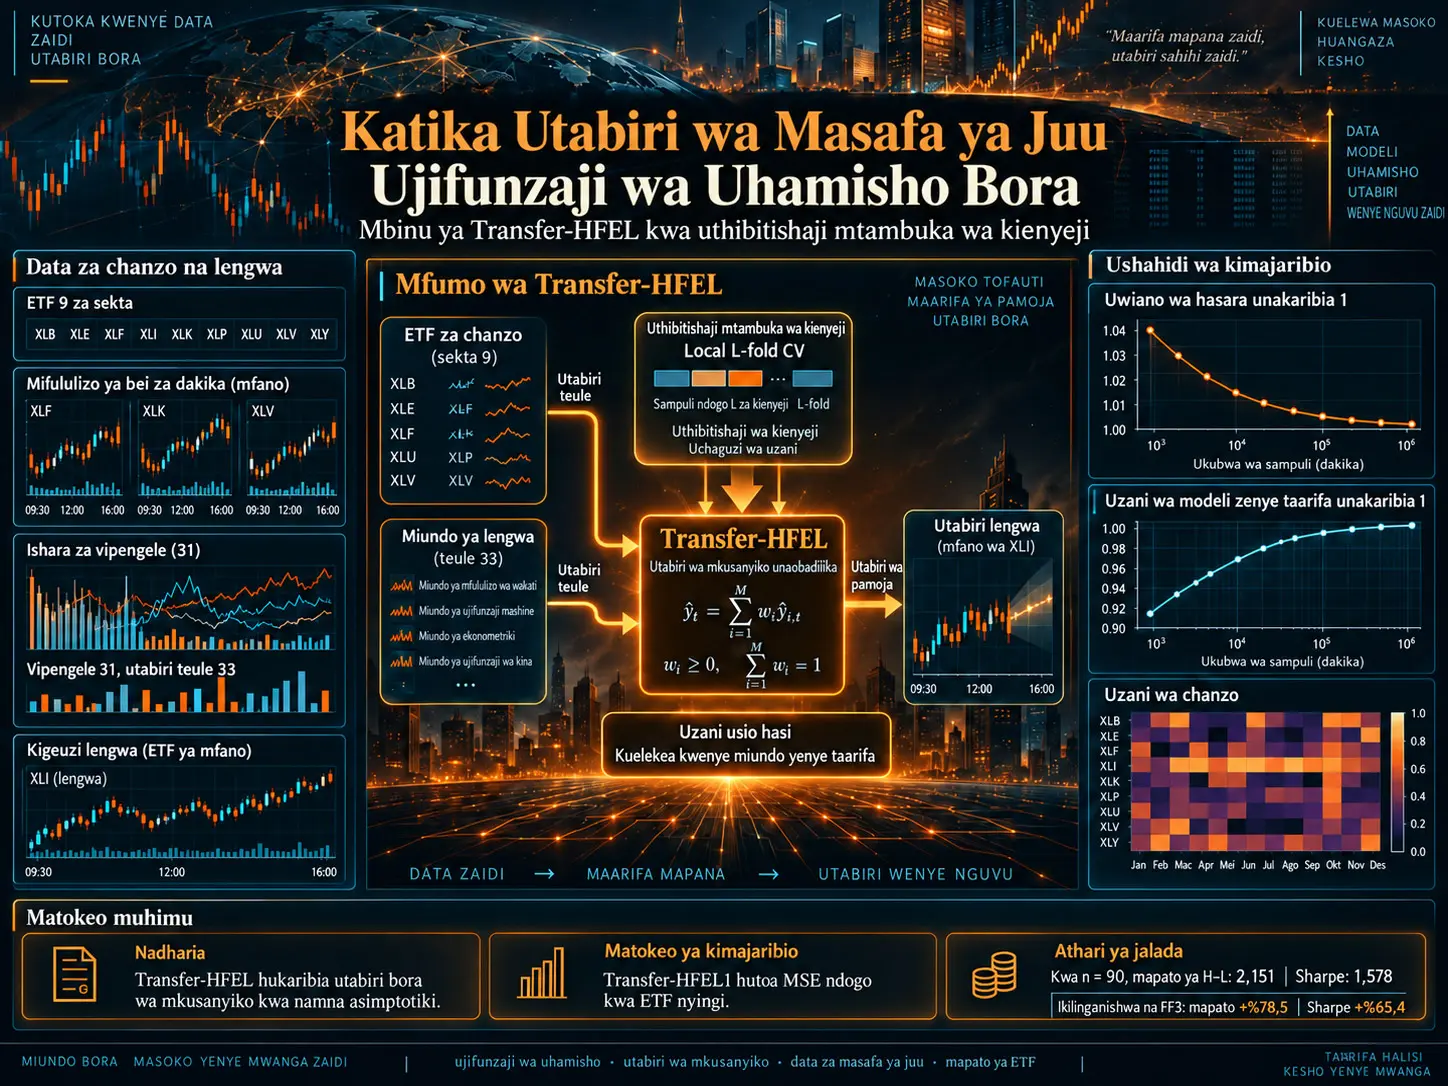
Ujifunzaji wa Uhamisho kupitia Ujifunzaji wa Mkusanyiko wa Masafa ya Juu (Transfer Learning through High-Frequency Ensemble Learning; Transfer-HFEL) ni mfumo wa ujifunzaji wa uhamisho na utabiri wa mkusanyiko unaounganisha utabiri kadhaa wa masafa ya juu unaozalishwa kutoka kwa mali lengwa na mali chanzo zisizo sawa, chini ya uzani usio hasi wenye jumla ya moja ambao huchaguliwa kwa uthibitishaji mtambuka wa kienyeji wa tabaka L. Utafiti huunda muundo wa state-space ambamo idadi za chanzo na lengwa zinaweza kuwa na michakato tofauti ya kuzalisha data, seti tofauti za taarifa na modeli zilizobainishwa kimakosa. Kinadharia inaonyeshwa kuwa hata ikiwa modeli zote zinazogombea zimebainishwa kimakosa, Transfer-HFEL inaweza kukaribia kwa njia ya asimptotiki hasara ya utabiri ya mkusanyiko bora usioweza kufikiwa; na inapokuwapo modeli sahihi na zenye taarifa, uzani hukusanyika kwenye modeli hizo. Katika matumizi ya faida za kiwango cha dakika za ETF tisa za sekta katika mwaka 2015, mbinu hii katika hali nyingi hutoa kosa dogo la utabiri kuliko kulinganisha na simple averaging, FULL, Fama–French three-factor na Fama–French five-factor plus momentum. Katika jaribio la jalada la utafiti wenyewe, kwa \(n=90\), faida ya H–L iliyowekwa kwa mwaka ya Transfer-HFEL1 huzidi benchmark ya FF3 kwa takriban %78,5; na uwiano wa Sharpe kwa takriban %65,4. Matokeo haya ni mahususi kwa sampuli na muundo wa jalada uliotajwa; si dhamana ya utendaji wa soko wa baadaye.
Ugunduzi mwingine usio wa kawaida zaidi wa utafiti ni kwamba uhamishaji wa taarifa inayobaki kuwa orthogonal kwa vigezo elezi vinavyotumiwa katika mali chanzo na inayofanana, kwa lugha ya kawaida ya factor, na sehemu ya idiosyncratic, huzalisha manufaa makubwa zaidi ya utabiri kuliko muundo unaohamisha moja kwa moja vigezo vya pamoja vya systematic kutoka mali nyingine. Waandishi hawatafsiri matokeo haya kama “kuwapo kwa idiosyncratic risk premium” kwa maana ya kawaida. Maelezo yanayowezekana ni pamoja na model misspecification, risk premia zinazobadilika kwa kasi, common factors zinazokosekana, pamoja na misuguano ya muundo mdogo kama order-flow imbalance, bid–ask bounce, asynchronous trading na ETF arbitrage.
Tatizo: Kwa nini kuchagua modeli moja tu ya utabiri wa masafa ya juu huenda kusitoshe?
Katika data za kifedha za masafa ya juu, modeli nyingi zinazokubalika za utabiri zinaweza kujengwa kwa kigezo kilekile lengwa. Modeli zinaweza kutumia seti tofauti za predictor, kubeba taarifa kutoka mali nyingine, kutegemea mbinu tofauti za econometric, au kuwepo kwa cross-sectional heterogeneity halisi kati ya idadi lengwa na chanzo. Katika hali hii, tatizo analokabili mtafiti si tu “ni modeli ipi bora zaidi?” Tatizo kuu ni ni kwa uzani gani taarifa muhimu inayobebwa na kila modeli inapaswa kuunganishwa.
Sehemu kubwa ya mbinu za kawaida za model averaging ziliundwa kwa data za masafa ya chini kutoka idadi moja. Transfer-HFEL, kwa upande mwingine, inalenga kuunganisha utabiri unaotoka kwa idadi tofauti katika mkusanyiko mmoja na kuruhusu muundo wa state-space wa masafa ya juu ambamo vigezo si lazima viwe vya kudumu.
Mchakato wa jumla wa kuzalisha data kwa idadi lengwa na chanzo
Data lengwa:
\[ \{Y^{(0)},V^{(0)}\}_{0\leq t\leq T} \]
na kwa \(m=1,\ldots,M\), data chanzo:
\[ \{Y^{(m)},V^{(m)}\}_{0\leq t\leq T} \]
hufafanuliwa hivyo.
Increment ya masafa ya juu ya idadi ya m:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} + R_{n,i}^{(m)} \]
ina sura hii.
Hapa \(g^{(m)}(\cdot)\) inawakilisha kazi ya jumla inayounganisha feature zinazoonekana au latent na vigezo; \(\theta^{(m)}\) ni vekta ya vigezo inayoweza kubadilika kwa wakati; \(Z^{(m)}\) ni sehemu ya hitilafu ya aina ya martingale; na \(R^{(m)}\) ni sehemu ya residual/discretization ya kiwango cha chini zaidi.
Muundo wa feature wa state-space:
\[ V_{t_{n,i}}^{(m)} = \int V^{(m)} \left( \zeta_{t_{n,i}}, \epsilon_{t_{n,i}} \right) F_\epsilon(d\epsilon) \]
umeandikwa kwa namna hii. \(\zeta_t\) ni mchakato latent, \(\epsilon_t\) ni shock ya muda ya i.i.d., na \(V^{(m)}(\cdot)\) ni ubadilishaji unaounda feature inayoonekana kutoka hali latent na ambao si lazima ujulikane.
Muundo huu wa jumla hautumiki kwa return regression pekee. Mfumo wa utafiti umejengwa ili uweze kutumika pia kwa trading volume, bid–ask spread, duration, turnover na vigezo vingine vya masafa ya juu.
Hali maalum ya high-frequency regression
Katika mfano wa kwanza wa utafiti, increment ya predictor ni Itô semimartingale ya jumla:
\[ V_{t_{n,i}}^{(m)}=\Delta_i^nX^{(m)} \]
na modeli inaruhusu sehemu za continuous na jump:
\[ \Delta_i^nY^{(m)} = \left(\beta_{t_{n,i-1}}^{(m)}\right)^\top \Delta_i^nX^{(m)\circ} + \left(\ddot{\beta}_{t_{n,i-1}}^{(m)}\right)^\top \sum_{t_{n,i-1}\leq s\leq t_{n,i}} \Delta X_s^{(m)} + \Delta_i^nZ^{(m)} + R_{n,i}^{(m)} \]
Hapa kuna sehemu tofauti za coefficient kwa continuous regressors na jump regressors. \(R_{n,i}^{(m)}\) hubeba hitilafu ya approximation/discretization inayotokana na discrete sampling.
Hali maalum ya general feature
Katika mfano wa pili, modeli inaweza kufanya kazi na feature zinazoonekana moja kwa moja lakini zenye kelele, kama lagged returns, trading volume, bid–ask spread, turnover na transaction-return autocovariance:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} \]
Muundo huu unaonyesha kuwa Transfer-HFEL haifungwi tu na factor regression ya kawaida ya mstari.
Transfer-HFEL ni nini?
Transfer-HFEL huunganisha utabiri mbadala unaozalishwa kutoka idadi lengwa na utabiri unaohamishwa kutoka idadi chanzo zisizo sawa ndani ya convex ensemble moja, na huchagua uzani wake kwa kigezo cha uthibitishaji mtambuka wa kienyeji wa tabaka L kinachozingatia utegemezi wa wakati katika data za masafa ya juu.
Utabiri unaogombea unatengenezwa vipi?
Katika utafiti kuna jumla ya utabiri \(M+K\). Kati yake:
- \(M\) hutoka kwenye source domain,
- \(K\) hutoka kwenye modeli tofauti za predictor za target domain.
Utabiri wa m unaogombea unaonyeshwa kwa jumla kama:
\[ \Delta_i^n\widehat{Y}^{(0)}_m \]
.
Katika modeli za chanzo, vigezo vinaweza kwanza kukadiriwa kwa kutumia data chanzo na taarifa iliyopatikana kuhamishwa hadi kwenye utabiri wa target domain. Katika modeli za target, model-selection uncertainty huingizwa katika mkusanyiko kwa kutumia subset tofauti za predictor.
Uzani wa mkusanyiko
Vekta ya uzani:
\[ w\in\mathcal W \]
na:
\[ \mathcal W= \left\{ w\in[0,1]^{M+K}: \sum_{m=0}^{M+K-1}w^{(m)}=1 \right\} \]
huwekewa kizuizi hiki.
Kwa hiyo kila uzani hauwezi kuwa hasi na jumla ya uzani wote ni moja.
Forecast iliyounganishwa:
\[ \Delta_i^n\widehat{Y}^{(0)}(w) = \sum_{m=0}^{M+K-1} w^{(m)} \Delta_i^n\widehat{Y}^{(0)}_m \]
ina sura hii.
Constraint hizi huzuia modeli kutumia ishara ya chanzo kama hedge isiyo na kikomo yenye ishara kinyume. Badala yake, mbinu hujaribu kugawa uzani chanya kwa vyanzo vinavyobeba taarifa muhimu.
Transfer-HFEL1: uhamishaji wa sehemu ya idiosyncratic/orthogonal
Aina ya kwanza ya uhamishaji katika matumizi ya empiri ya utafiti hubeba hadi kwenye utabiri lengwa sehemu ya mali chanzo isiyoelezewa na regressors zake:
\[ h= \Delta_i^nY^{(m)} - \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(m)} \,1_{\{ \|\Delta_i^nX^{(m)}\| \leq u_n^{(m)} \}} \]
Sehemu hii inafasiriwa kama taarifa inayobaki kuwa orthogonal kwa conditioning variables za regression ya chanzo. Makala inaifananisha na sehemu ya diversifiable au idiosyncratic risk katika istilahi za kawaida za asset-pricing.
Transfer-HFEL2: parameter transfer
Mbinu ya pili hutumia vigezo vilivyokadiriwa kwenye chanzo kwa predictor za mali lengwa:
\[ h= \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(0)} \,1_{\{ \|\Delta_i^nX^{(0)}\| \leq u_n^{(0)} \}} \]
Muundo huu unawakilisha uhamishaji wa taarifa ya pamoja au systematic kupitia parameter.
Tofauti kati ya mbinu hizi mbili ni muhimu: Transfer-HFEL1 hubeba taarifa ya residual/cross-sectional ya mali chanzo ambayo target predictors haiwakilishi moja kwa moja, wakati Transfer-HFEL2 inategemea zaidi kutumia muundo wa pamoja wa coefficient kwenye target.
Kwa nini Uthibitishaji Mtambuka wa Kienyeji wa Tabaka L unahitajika?
Uthibitishaji mtambuka wa kienyeji wa tabaka L hufanya validation ndani ya blok fupi na zilizo karibu kwa wakati kwa sababu katika data za masafa ya juu random au global folds zinazofunika sampuli nzima zinaweza kuvuruga utegemezi wa wakati na muundo wa covariance unaobadilika; hivyo lengo ni kuhakikisha folds zinatoka takriban katika mchakato uleule wa kienyeji wa kuzalisha data.
Tatizo la cross-validation ya kawaida
Katika ujifunzaji wa mashine wa masafa ya chini, kugawa observations kwa nasibu katika vikundi vya train na validation mara nyingi kunakubalika. Lakini high-frequency returns zinaweza kuwa na:
- serial dependence,
- volatility clustering,
- time-varying covariance,
- microstructure noise,
- asynchronous observation
.
Mgawanyo wa nasibu unaweza kutenganisha observations tegemezi zilizo karibu kwa wakati na kufanya validation set isiwe rahisi kuwakilisha hali ambazo kwa kweli zitakabiliwa baadaye. Global folds ndefu sana pia huongeza hatari ya kuchukulia tawala tofauti za soko kuwa DGP moja.
Muundo wa local L-fold
Mbinu kwanza hugawa kipindi \([0,T]\) katika \(H_n\) blok za wakati za kienyeji. Wakati upana wa muda wa kila blok unapungua kwa njia ya asimptotiki, idadi ya observation kwa kila blok huongezeka kwa kiwango cha \(k_n\).
Kisha kila blok ya kienyeji hugawanywa katika \(L\) fold.
Kwa blok ya j na fold ya p, modeli hukadiriwa baada ya kuacha fold ya p ya blok hiyo. Validation error huhesabiwa tu kwenye fold hiyo ya kienyeji.
Cross-validation criterion:
\[ CV(w) = \sum_{j=1}^{H_n} \sum_{p=1}^{L} \sum_i \left( \Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w) - \Delta_i^nY^{(0)}_{[j,p]} \right)^2 \]
ina sura hii.
\(\Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w)\) ni muunganiko wenye uzani wa target-side forecast unaopatikana baada ya kuondoa fold ya p ya validation.
Maelezo muhimu ya kiufundi ni kwamba local L-fold inatumika kwenye target data. Source-domain parameter estimates hazihesabiwi upya kwa sababu fold ya p ya target imeondolewa; fold hii si sehemu ya source data.
Lengo la kitakwimu la uenyeji
Local windows hufanya folds ziwe karibu zaidi na utawala uleule wa covariance wa muda mfupi. Badala ya kudhani global stationarity kwa kipindi kirefu katika soko la masafa ya juu, mbinu ya utafiti hutumia conditional stationarity ya muda mfupi.
Uboraji wa Asimptotiki unamaanisha nini?
Uboraji wa asimptotiki wa Transfer-HFEL unamaanisha kuwa sampuli inapozidi kuwa mnene, uwiano wa quadratic prediction loss wa mkusanyiko ulioundwa kwa uzani uliochaguliwa kupitia local cross-validation dhidi ya loss ya uzani infeasible optimal ambao ungechaguliwa kama mchakato halisi wa kuzalisha data ungejulikana, hukaribia 1 katika uwezekano.
Prediction loss
Utafiti hupima utendaji wa utabiri kwa:
\[ L(w) = \sum_{i=k_n+1}^{n} \left( \Delta_i^n\widehat Y^{(0)}(w) - \Delta_i^n\mu^{(0)} \right)^2 \]
.
Hapa \(\Delta_i^n\mu^{(0)}\) ni sehemu inayoweza kutabirika/predictable ya target DGP.
Theorem 1: mpaka wa chini kwa infeasible minimum loss
Wakati candidate models zote ni misspecified, utafiti hupata chini ya regularity conditions fulani mpaka chanya wa chini unaozuia infeasible minimum loss kwenda sifuri kwa namna iliyodorora. Matokeo haya ya kiufundi husaidia kujenga uthibitisho wa baadaye wa asymptotic-optimality.
Theorem 2: optimality
Matokeo makuu ni:
\[ \frac{ L(\widehat w) }{ \inf_{w\in\mathcal W}L(w) } \xrightarrow{p}1 \]
.
Kwa maneno mengine, hata kama candidate models zote si sahihi kwa viwango tofauti, mkusanyiko wenye uzani wa local-CV hukaribia kwa njia ya asimptotiki risk ya muunganiko bora zaidi usioweza kufikiwa ndani ya candidate set iliyopo.
Hii haimaanishi “Transfer-HFEL hupata DGP halisi kwa uhakika.” Optimality ni kulingana na quadratic-loss benchmark ndani ya familia ya candidate forecast.
Theorem 3: uzani wa modeli zenye taarifa
Tuseme target model imebainishwa kwa usahihi na seti ya informative models inayoshiriki pseudo-true parameter information ileile na target ni \(\mathcal D\).
Jumla ya uzani unaotolewa kwa modeli hizi:
\[ \tau= \sum_{m\in\mathcal D}w^{(m)} \]
na makadirio yake:
\[ \widehat\tau= \sum_{m\in\mathcal D}\widehat w^{(m)} \]
ikiwa hivyo, utafiti hupata:
\[ \widehat\tau\xrightarrow{p}1 \]
.
Yaani, sampuli inapokua, uzani wote wa mkusanyiko hukusanyika kwenye modeli zenye taarifa. Uzani wa vyanzo vilivyo tofauti sana au visivyo na manufaa unaweza kukaribia sifuri kwa njia ya asimptotiki.
Hali maalum ya modeli moja sahihi
Matokeo ya asili ya hili ni kwamba ikiwa modeli moja tu ndiyo sahihi, mbinu hukaribia kwa njia ya asimptotiki kuipa modeli hiyo uzani wote. Kwa hivyo hatari inayowezekana ya negative-transfer katika transfer learning inajaribiwa kudhibitiwa kupitia uteuzi wa uzani.
Theorem 4: parameter consistency
Wakati target model kubwa zaidi imebainishwa kwa usahihi, chanzo kinatoa kwa shared-parameter estimator kiwango:
\[ \left\| \widehat\beta_t(\widehat w) - \beta^{(0)}_{t-\Delta_n} \right\| = O_p \left( k_n^{1/2}\Delta_n^{1/2} + k_n^{-1/2} \right) \]
.
Chini ya small-window scheme inayotumiwa na utafiti:
\[ k_n\asymp\Delta_n^{-\varsigma}, \qquad \varsigma<\frac12 \]
na sehemu kuu ya hitilafu:
\[ O_p(k_n^{-1/2}) \]
inakuwa ndiyo inayotawala.
Kikomo cha matokeo haya ya kinadharia
Matokeo yote ya asimptotiki ni halali chini ya regularity conditions zilizotolewa katika utafiti. Katika matumizi ya kifedha haiwezi kuhitimishwa kwamba “kwa sababu kuna theorem, mbinu itatoa utabiri bora katika kila utawala wa soko.” Tabia ya finite-sample hujaribiwa kando kwa simulation na matumizi ya data halisi.
Mbinu na Matokeo ya Utafiti
Muundo wa Monte Carlo
Utafiti kwanza huchunguza tabia ya finite-sample kupitia michakato miwili ya kuzalisha data.
DGP1 — muundo unaohamishika kikamilifu:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + Z_t^{(m)} \]
DGP2 — muundo unaohamishika kwa sehemu:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + \left( \alpha_t^{(m)} \right)^\top dU_t^{(m)} + Z_t^{(m)} \]
Katika DGP2, \(\beta_t^{(m)}\) inaweza kuhamishwa kati ya idadi, wakati \(\alpha_t^{(m)}\) hubeba taarifa model-specific.
Michakato ya predictor na residual ina sehemu zote za continuous diffusion na jump. Michakato ya volatility imemodeliwa kwa dynamics ya aina ya Cox–Ingersoll–Ross, na jump sizes kwa usambazaji wa double-exponential.
| Kipengele | Thamani/muundo uliotumika kwenye chanzo |
|---|---|
| Kipimo cha msingi cha predictor | d = 40 |
| Idadi ya modeli chanzo M | 3, 5, 7 |
| Sample size n | 3600, 8800, 12300, 17600, 21100 |
| Muundo wa sampling | masafa ya dakika 1 |
| Source-target parameter shift | \(\delta_m=0.1(m-1)(-1)^m\) |
| Predictor jump intensity | \(\lambda_X^J=7\) |
| DGP2 U jump intensity | \(\lambda_U^J=6\) |
| Residual jump intensity | \(\lambda_Z^J=14\) |
Kutokulingana katika maelezo ya simulation ya chanzo
Kuna kutokulingana ndani ya matini ya chanzo katika uorodheshaji wa scenario za simulation. Katika ufafanuzi wa kwanza imeandikwa kuwa Scenario 1 ni target model correctly specified na Scenario 2 ni target model misspecified. Lakini katika aya ya matokeo ya baadaye, namba hizi mbili za scenario zimetumiwa kinyume. Kwa kuwa vichwa vya vielelezo vinatoa hali moja kwa moja kama “model misspecification” na “target model correctly specified”, katika maelezo ya Verianla hali ya kisayansi imechukuliwa kuwa msingi na namba ya scenario haijathibitishwa kwa uhakika.
Zaidi ya hayo, matini kuu inasema kwamba misspecified target imepunguzwa hadi vipimo 37 kwa kuondoa vipengele vitatu vya mwisho kati ya predictor 40, wakati dokezo la jedwali la parameter za simulation linasema kuwa katika hali ya misspecified vipengele vitano vya mwisho vimeondolewa. Chanzo hakielezi tofauti hii.
Kielelezo 1: kukaribia oracle loss
Kielelezo 1 katika ukurasa wa 26 wa chanzo, chini ya model misspecification, kinaonyesha uwiano:
\[ \frac{ L(\widehat w) }{ \inf_w L(w) } \]
dhidi ya sample size.
Katika usanidi wote wa DGP1 na DGP2 pamoja na \(M=3,5,7\), uwiano hukaribia 1 sampuli inapokua. Katika mfano wa chanzo, kwa DGP2 na \(M=5\), uwiano ni karibu 1,020 kwa \(n=3600\), na hushuka chini ya 1,001 kwa \(n=21100\).
Muundo huu unaendana na matokeo ya asymptotic optimality ya Theorem 2.
Kielelezo 2: uzani wa modeli zenye taarifa
Kielelezo 2 katika ukurasa wa 27 kinaonyesha jumla ya uzani unaotolewa kwa modeli zenye taarifa wakati target model correctly specified.
Katika usanidi wote wa simulation, uzani hukaribia 1 sampuli inapokua. Katika mfano wa chanzo, kwa DGP2, \(M=3\), jumla ya informative-weight huzidi 0,95 kwa \(n=8800\) na kukaribia 1 kwa sampuli kubwa zaidi.
Ugunduzi huu unatafsiriwa kama kilinganishi cha finite-sample cha Theorem 3.
Data halisi: ETF tisa za sekta
Utafiti wa empiri hutumia minute-level log returns za ETF tisa za sekta za Marekani kuanzia Januari hadi Desemba 2015.
| Msimbo | Sekta |
|---|---|
| XLB | Materials |
| XLE | Energy |
| XLF | Financials |
| XLI | Industrials |
| XLK | Technology |
| XLP | Consumer Staples |
| XLU | Utilities |
| XLV | Healthcare |
| XLY | Consumer Discretionary |
Kila ETF inapochaguliwa kuwa target, ETF nane zilizobaki hutumika kama source domain.
31 predictor/factor
Modeli hutumia jumla ya 31 exogenous factor. Kati yake, 25 hutoka katika seti ya factor-zoo ya utafiti na sita hutoka katika muundo wa Fama–French five-factor-plus-momentum.
Factors zimegawanywa kimsingi katika makundi:
- Size,
- Profitability,
- Low Risk,
- Leverage
.
Jedwali la chanzo lina vigezo kama short interest, cash-flow-to-price variance, pension funding status, operating profitability, R&D capital-to-assets, Altman Z-score, market beta, downside beta, return volatility, turnover na zero-trade measures.
Factors hupitishwa kwenye ubadilishaji wa log na differencing ili kulingana na masafa ya return.
Utabiri 33 unaogombea unatokeaje?
Kwa kila target ETF, candidate set ina:
- modeli 1 ya target FULL inayotumia factors zote 31,
- modeli 8 za source-ETF,
- modeli 24 za target-domain subset
na hivyo jumla:
utabiri 33
.
Modeli 24 za subset zina:
- 12 single-factor,
- 4 three-factor,
- 4 five-factor,
- 4 ten-factor
modeli.
Mbinu zilizolinganishwa
Matumizi ya empiri yanalinganisha:
- Transfer-HFEL1,
- Transfer-HFEL2,
- SA1,
- SA2,
- FULL,
- Fama–French three-factor (FF3),
- Fama–French five-factor plus momentum (FF5P1)
.
SA1 na SA2 ni matoleo ya equal-weight ya candidate set husika za Transfer-HFEL. Hivyo thamani ya uteuzi wa uzani bora inajaribiwa kutenganishwa na utofautishaji wa modeli zinazotumiwa pekee.
Jaribio la data inayokosekana
Chini ya dhana ya Covariates missing completely at random:
\[ p\in\{0,\ 25\%,\ 45\%,\ 65\%\} \]
viwango vya missing vimetumiwa.
Asynchronous missing pattern huundwa ili target domain tofauti ziwe na hasara tofauti za observation. Complete-case analysis hutumiwa kwa parameter estimation.
Usahihi wa utabiri wa Transfer-HFEL
Kulingana na matokeo ya chanzo, mbinu za Transfer-HFEL huzishinda mbinu za simple averaging zinazotumia candidate set zilezile katika ETF nyingi na hali nyingi za missing-rate.
Bila missing data, maboresho ya MSE ya Transfer-HFEL1 dhidi ya SA1 yanaelezwa katika matini ya chanzo kuwa takriban:
%15,9–%49,2
.
Faida za Transfer-HFEL2 dhidi ya SA2 ziko katika takriban:
%10,0–%15,7
.
Chanzo pia kinaripoti kuwa kwa missing-rate ya %45, katika baadhi ya target maboresho dhidi ya simple averaging yanafikia takriban %52.
Matokeo yaliyochaguliwa ya MSE
| Missing | Target | Transfer-HFEL1 | SA1 | Transfer-HFEL2 | FULL | FF3 |
|---|---|---|---|---|---|---|
| 0% | XLB | 0.820 | 1.347 | 1.364 | 1.162 | 1.458 |
| 0% | XLI | 0.479 | 0.914 | 0.963 | 0.861 | 1.110 |
| 0% | XLY | 0.517 | 1.017 | 1.052 | 0.941 | 1.204 |
| 45% | XLI | 0.220 | 0.447 | 0.435 | 0.713 | 0.566 |
| 45% | XLY | 0.239 | 0.499 | 0.472 | 0.772 | 0.616 |
| 65% | XLB | 0.556 | 0.951 | 0.897 | 1.405 | 1.079 |
| 65% | XLK | 0.444 | 0.865 | 0.823 | 1.295 | 1.008 |
| 65% | XLY | 0.344 | 0.726 | 0.685 | 1.111 | 0.885 |
Badala ya kutafsiri viwango vya absolute MSE katika mistari tofauti ya missing-rate kwa kauli rahisi kama “kadri data inayokosekana inavyoongezeka, MSE ilishuka/ilipanda”, inapaswa kuzingatiwa, kama utafiti wa chanzo unavyofanya, kulinganisha mbinu ndani ya missing-rate ileile.
Kwa nini Uhamishaji wa Taarifa ya Idiosyncratic unaweza kuwa na mafanikio zaidi kuliko Uhamishaji wa Common-Parameter?
Katika matumizi ya ETF ya utafiti, Transfer-HFEL1 hubeba cross-sectional information kutoka sehemu za source assets zinazobaki orthogonal kwa factor regressors, wakati Transfer-HFEL2 huhamisha hasa general parameter information hadi target; MSE ya chini ya Transfer-HFEL1 inaonyesha kuwa sehemu hii ya residual inaweza kuwa na taarifa muhimu kwa utabiri kutokana na model misspecification, risk premia zinazobadilika kwa wakati au athari za market-microstructure.
Ulinganisho wa moja kwa moja katika Jedwali 4
Safu ya “Gain (%)” katika Jedwali 4 la chanzo inaonyesha faida ya MSE ya Transfer-HFEL1 dhidi ya Transfer-HFEL2. Kwa mfano:
- XLB, missing %0: %39,9,
- XLI, missing %0: %50,3,
- XLY, missing %0: %50,8,
- XLK, missing %45: %46,5,
- XLY, missing %65: %49,8.
Ulinganisho huu unaonyesha kuwa katika matumizi ya utafiti, idiosyncratic-component transfer ni yenye nguvu zaidi kuliko toleo la parameter-transfer.
Weight heatmap zinaonyesha nini?
Kielelezo 3 katika ukurasa wa 28 wa chanzo kinaonyesha uzani wa Transfer-HFEL1, na Kielelezo 4 katika ukurasa wa 29 kinaonyesha uzani wa Transfer-HFEL2 kwa target ETF na mwezi.
Uzani si sawa kati ya source ETF; hubadilika kwa kiasi kikubwa kulingana na target na mwezi. Kwa mfano, XLE inapokuwa target, uzani unaotolewa kwa XLB unaonekana kuwa mkubwa katika miezi mingi. Chanzo kinasema kuwa katika utabiri wa XLE, uzani wa XLB ulikuwa juu ya 0,4 katika miezi tisa kati ya miezi kumi na miwili.
Katika mfano wa Januari 2015, XLE ikiwa target:
Transfer-HFEL1 → uzani wa XLB 0,76
Transfer-HFEL2 → uzani wa XLB 0,33
umeripotiwa.
Mbinu zote mbili huchagua source ETF ileile kwa uzani wa juu zaidi, lakini magnitude ya uzani hutofautiana sana.
Maelezo ya kiuchumi ya waandishi
Shughuli za exploration na extraction za nishati hutegemea material inputs; kunaweza kuwa na uhusiano wa upstream–downstream kati ya sekta za energy na materials. Kwa hiyo ni jambo linalokubalika kiuchumi kwamba taarifa chanzo ya XLB inaweza kubeba leading information kwa faida za XLE.
Hata hivyo, utafiti hauundi mfano huu kama jaribio la kisababishi la mnyororo wa uzalishaji. Unatoa tafsiri kati ya weight pattern na uhusiano wa kiuchumi wa sekta.
Je, ugunduzi huu kweli unapingana na asset pricing ya kawaida?
Kwa mtazamo wa kwanza, kuwa na sehemu ya idiosyncratic yenye manufaa zaidi kwa utabiri kunaweza kuonekana kuwa katika mvutano na mtazamo wa kawaida wa asset-pricing kwamba diversifiable idiosyncratic risk haipaswi kubeba risk premium.
Chanzo kinajadili maelezo matatu.
1. Model misspecification
Sehemu muhimu ya factors 31 hutokana na low-frequency characteristics. Baadhi ya common factors muhimu kwa high-frequency return dynamics huenda hazikujumuishwa kabisa kwenye modeli. Katika hali hiyo, taarifa inayoonekana kama “idiosyncratic” ndani ya regression residual inaweza kwa kweli kubeba omitted systematic information.
2. Time-varying risk premia
Historically estimated factor loadings zinaweza kuonyesha risk exposure, lakini hazionyeshi kikamilifu jinsi thamani ya sasa ya compensation ya risk hiyo inavyobadilika. Ikiwa high-frequency return dynamics zinaathiriwa na risk premia zinazobadilika haraka sana, sehemu za cross-sectional residual zinaweza kubeba sehemu ya mabadiliko hayo.
3. Market microstructure
Order-flow imbalance, bid–ask bounce, asynchronous trading na ETF arbitrage pressures zinaweza kuunda mienendo ya muda ya bei iliyo orthogonal kwa low-frequency characteristics lakini cross-sectionally correlated. Hata kama factor regression inaziainisha kama “idiosyncratic”, zinaweza kuwa muhimu kwa utabiri wa upeo mfupi.
Utafiti hautenganishi kwa identification design tofauti ni lipi kati ya maelezo haya matatu ndilo kuu. Haya ni maelezo yanayowezekana ya ugunduzi wa empiri.
Source information chini ya missing data
Chanzo kinaonyesha kuwa thamani ya jamaa ya source data huongezeka target covariates zinapokosekana. Kwa mfano, kwa XLB, uboreshaji wa MSE wa Transfer-HFEL1 dhidi ya modeli FULL unaripotiwa kuwa takriban %59,4–%60,4 kwa missing rate kati ya %25–%65. Kwa target hiyo hiyo, uboreshaji dhidi ya FF3 ni takriban %47,3–%48,5.
Matokeo haya yanafasiriwa kuwa wakati idadi ya observation katika target domain inapopungua, kuhamisha taarifa kutoka source domain zilizo karibu au zinazohusiana kunaweza kupunguza kosa la utabiri.
Jaribio la utendaji wa kiuchumi
Safu ya pili ya empiri ya utafiti hutoka ETF za sekta kwenda faida za hisa binafsi. Jumla ya hisa 80 huchaguliwa kwa zamu kuwa target asset. ETF ya sekta ya hisa target yenyewe huondolewa kutoka source set na ETF nane za sekta zilizobaki hutumiwa kama source dataset.
Ndani ya kila estimation window, stock-return predictions huhesabiwa na hisa hugawanywa katika 10 decile portfolio kulingana na utabiri wao.
Low ni decile yenye faida ya chini zaidi iliyotabiriwa, na High ni decile yenye faida ya juu zaidi iliyotabiriwa.
Matokeo ya long-short:
\[ H-L = R_{\mathrm{High}} - R_{\mathrm{Low}} \]
huhesabiwa hivyo.
Katika Jedwali 5, chanzo kinatoa:
- \(k_n=30\),
- \(L=5\),
- missing rate = %70,
- kwa forecast horizon \(n=40\) na \(n=90\)
.
Matokeo ya jalada kwa n = 40
| Mbinu | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 1.586 | 1.566 |
| SA1 | 0.858 | 0.919 |
| Transfer-HFEL2 | 1.421 | 1.409 |
| SA2 | 1.411 | 1.504 |
| FF3 | 1.035 | 1.132 |
| FF5P1 | 1.248 | 1.333 |
Matokeo ya jalada kwa n = 90
| Mbinu | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 2.151 | 1.578 |
| SA1 | 1.154 | 0.883 |
| Transfer-HFEL2 | 2.085 | 1.531 |
| SA2 | 1.939 | 1.478 |
| FF3 | 1.205 | 0.954 |
| FF5P1 | 1.662 | 1.282 |
Kwa n=90, chanzo kinaripoti:
\[ \frac{2.151-1.205}{1.205} \approx 78.5\% \]
annualized-return improvement na:
\[ \frac{1.578-0.954}{0.954} \approx65.4\% \]
Sharpe improvement.
Ulinganisho huu wa asilimia ni dhidi ya benchmark ya FF3. Kwa kuwa jedwali linatoa kiwango cha mistari ya return kama \(10^{-2}\), katika matini ya Verianla namba 2,151 haijatafsiriwa upya moja kwa moja kama “faida ya %215,1”.
Matokeo haya ya jalada yanamaanisha nini?
Matokeo yanaonyesha kwamba chini ya sample, prediction horizon, muundo wa missingness, stock sorting na mbinu ya long-short portfolio iliyowekwa na utafiti, utabiri wa Transfer-HFEL1 hubeba taarifa yenye nguvu zaidi ya cross-sectional ranking.
Matokeo yenyewe hayaonyeshi kwamba:
- utendaji huohuo utadumu baada ya gharama za miamala,
- slippage na market impact hazina umuhimu,
- matokeo yale yale yatatokea katika vipindi vya soko nje ya 2015,
- utendaji uleule utapatikana katika asset class nyingine,
- uwiano wa Sharpe wa baadaye utakuwa 1,578.
Chanzo hakiripoti tabaka la transaction-cost au live-execution katika jedwali. Kwa hiyo utendaji wa kiuchumi unapaswa kutafsiriwa katika muktadha wa jaribio la portfolio-return lililoundwa na utafiti.
Matokeo yanayoungwa mkono na utafiti
- Transfer-HFEL inayounganisha source na target forecast zisizo sawa katika ensemble ya local-CV inaweza kufafanuliwa kinadharia.
- Chini ya regularity conditions zilizotajwa, candidate models zinapokuwa misspecified, Transfer-HFEL hukaribia asymptotically optimal loss.
- Informative models zinapokuwapo, uzani wote hukusanyika kwa njia ya asimptotiki kwenye modeli hizo.
- Matokeo ya Monte Carlo yanaunga mkono mifumo ya kinadharia ya convergence katika finite sample.
- Katika matumizi ya nine-sector-ETF ya 2015, Transfer-HFEL katika kulinganisha nyingi hutoa MSE ya chini kuliko simple averaging na factor benchmarks.
- Target data inapopungua, manufaa ya jamaa ya source-domain information huongezeka kwa kiasi kikubwa katika baadhi ya target.
- Katika matumizi yaliyopimwa, idiosyncratic-component transfer hutoa forecast gains kubwa kuliko parameter transfer.
- Katika jaribio la 80-stock portfolio, Transfer-HFEL1 chini ya muundo uliotolewa hutoa H–L return na Sharpe kubwa kuliko FF3 na benchmark nyingine.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kuwa Transfer-HFEL ndiyo forecast method bora katika masoko yote ya fedha na vipindi vyote.
- Haijathibitishwa kuwa idiosyncratic risk inapangiwa bei kwa utaratibu katika maana ya kawaida ya asset-pricing.
- Utaratibu halisi wa mafanikio ya Transfer-HFEL1 haujatenganishwa kati ya model misspecification, time-varying risk premium au microstructure.
- Matokeo ya jalada si live trading execution wala net transaction-cost performance.
- Uboraji wa asimptotiki haumaanishi utabiri usio na hitilafu katika finite sample.
- Sababisho la kiuchumi la informative source haliwezi kuhitimishwa kutoka weight heatmap pekee.
- Matokeo ya missing data si ushahidi wa moja kwa moja kwa muundo wa missing-not-at-random au arbitrary missingness; jaribio la empiri linatumia mpangilio wa MCAR.
Maeneo ya matumizi na utafiti wa baadaye
Chanzo kinasema kuwa Transfer-HFEL inaweza kupanuliwa zaidi ya high-frequency return prediction hadi:
- new-product pricing,
- portfolio optimization,
- factor selection,
- utabiri wa bidhaa mpya za kifedha zenye historia ndogo ya data
.
Katika mali kama equities zilizoorodheshwa hivi karibuni, novel derivatives au emerging cryptocurrency pairs, target history inaweza kuwa fupi huku mali zinazohusiana zikitoa historia ndefu zaidi ya data. Pia asynchronous trading na irregular observations zinaweza kuathiri ukubwa wa sampuli za source-target kwa njia tofauti. Waandishi wanasema masuala haya ni maeneo ambayo Transfer-HFEL inaweza kupanuliwa baadaye; utafiti wa sasa hautekelezi upanuzi huu.
Maelezo ya Chanzo na Mbinu
Utafiti asili:Optimal Transfer Learning for High-Frequency Prediction by Local Cross-validation.
Waandishi: Dachuan Chen; Jia Li; Yuying Sun; Yue Tang.
Corresponding author: Yuying Sun.
Taasisi: Dachuan Chen na Jia Li — School of Economics, Singapore Management University. Yuying Sun na Yue Tang — State Key Laboratory of Mathematical Sciences, Academy of Mathematics and Systems Science, Chinese Academy of Sciences; School of Economics and Management, University of Chinese Academy of Sciences.
Jukwaa: SSRN.
SSRN DOI: 10.2139/ssrn.7189238.
Tarehe ya bibliografia: Katika rekodi ya SSRN, Date Written 27 Julai 2026; Posted 6 Agosti 2026.
Aina ya chanzo: Makala ya utafiti/preprint. Katika rekodi ya bibliografia iliyokaguliwa, uchapishaji wa jarida uliopitiwa na wenzao haujathibitishwa.
Hali ya leseni/hakimiliki: Rekodi ya SSRN haitoi leseni wazi ya Creative Commons ya matumizi tena na inaeleza kuwa ruhusa inahitajika kwa matumizi tena. Kwa hiyo matini ya Verianla hainakili sentensi, aya, mchoro au uwasilishaji wa jedwali asili wa utafiti chanzo. Ukweli wa kisayansi, mbinu, hisabati na matokeo yanaelezwa katika muundo huru wa kielimu.
Ufadhili: Kwa Dachuan Chen — Singapore Ministry of Education Tier 1 Grant No. 24-SOE-SMU-042 na National Natural Science Foundation of China Grant No. 12571515; kwa Jia Li — Singapore Ministry of Education Tier 2 Grant T2EP40124-0021; kwa Yuying Sun — Beijing Natural Science Foundation Grant JQ25030 na NSFC Grant Nos. 72322016 na 72073126 zimetajwa katika chanzo.
Data za empiri: Matumizi makuu ya ETF hutumia minute-level log returns za ETF tisa za sekta kati ya Januari–Desemba 2015. Exogenous factor 31 na candidate forecast 33 kwa kila target hutengenezwa.
Simulation: DGP1 na DGP2 ni michakato ya high-frequency regression yenye diffusion, CIR-type variance dynamics na sehemu za jump. Idadi ya source model \(M=3,5,7\), sample size \(n=3600,8800,12300,17600,21100\) zimechunguzwa.
Matokeo makuu ya kinadharia: Chini ya regularity conditions zilizotajwa, quadratic prediction loss ya Transfer-HFEL hukaribia kwa njia ya asimptotiki infeasible optimal combination loss ndani ya candidate set. Correctly specified/informative models zinapokuwapo, uzani hukusanyika kwenye modeli hizo.
Matokeo makuu ya empiri: Katika matumizi ya ETF yaliyopimwa, Transfer-HFEL1 huonyesha MSE ya chini katika kulinganisha nyingi; uhamishaji wa idiosyncratic/orthogonal source information unaonekana kufanikiwa zaidi kuliko parameter transfer.
Kikomo cha matokeo ya kiuchumi: Chanzo kinaripoti portfolio returns na Sharpe ratios, lakini sehemu hii haijaundwa kama live execution, market impact na transaction-cost backtest ya kina. Kwa hiyo matokeo ni vipimo vya utendaji wa jalada la utafiti lililobainishwa.
Kutokulingana ndani ya chanzo: Katika simulation, ugawaji wa Scenario 1/Scenario 2 kwa hali za correctly specified na misspecified hutumiwa kinyume katika aya ya matokeo ikilinganishwa na ufafanuzi wa kwanza. Pia matini kuu na dokezo la Table 1 havilingani kuhusu kama predictor tatu au predictor tano zimeondolewa katika misspecified target. Mambo haya hayajasahihishwa kimyakimya.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *