

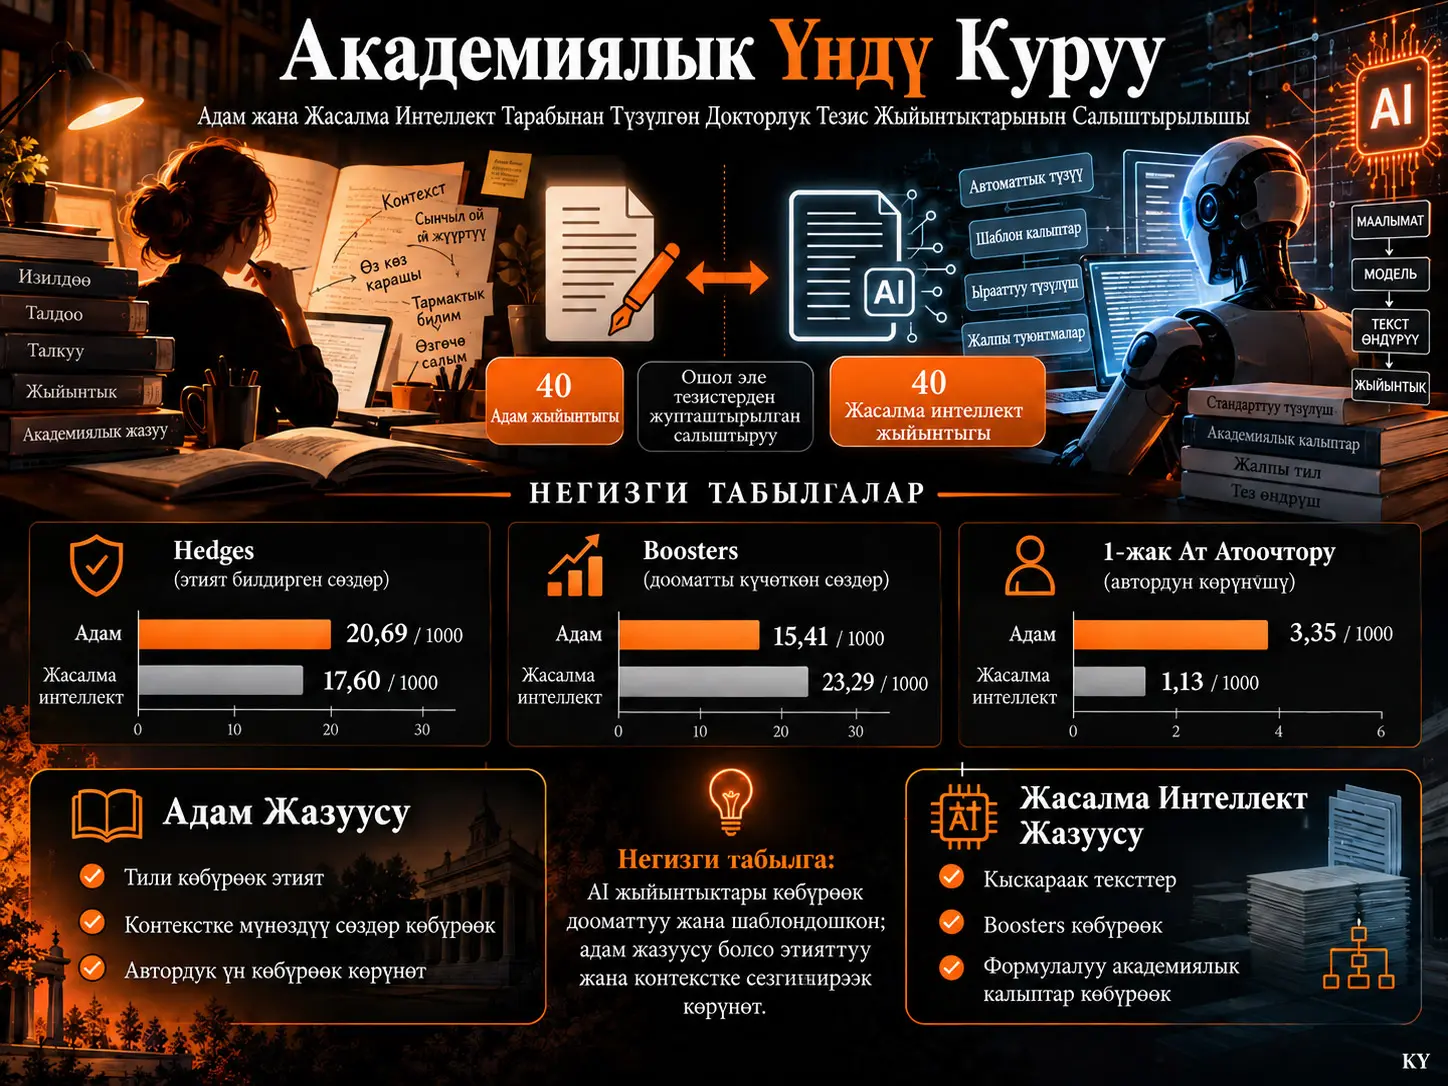
Генеративдүү жасалма интеллект системалары академиялык формага окшогон жатык тексттерди жаза алат; бирок академиялык жазуу жалгыз гана грамматикалык тууралыктан турбай турганын унутпоо керек. Илимий авторлор өз дооматтарынын канчалык так экенин, кайсы учурларда этият мамиле кылышын, баалоолорун кандай билдирерин жана текстте өз автордук инсандыгын канчалык деңгээлде көрүнүктүү кыларын ар түрдүү тилдик каражаттар аркылуу жөнгө салышат. Бул өзгөчөлүктөр чогуу академиялык үндүн маанилүү бөлүгүн түзөт.
Бул изилдөө Applied Linguistics тармагындагы 40 докторлук диссертациянын түпкү General Conclusion бөлүмдөрүн, ошол эле диссертациялардын жыйынтык бөлүмү алынып салынгандан кийин Google Gemini 3 Flash Preview тарабынан түзүлгөн 40 жаңы General Conclusion тексти менен салыштырат. Ошентип, жалпы 40 дал келтирилген human–AI текст жуптары түзүлгөн.
Талдоо Hylandдын stance моделиндеги hedges, boosters, attitude markers жана self-mentions категорияларына багытталган. Адам корпусунда hedges 1.000 сөзгө 20,69, AI корпусунда 17,60 деңгээлинде табылган. Ал эми boosters AI тексттеринде кыйла жогору көрүнөт: адам корпусунда 15,41, AI корпусунда 23,29/1.000 сөз.
Attitude markers боюнча эки корпус бири-бирине абдан жакын: 10,77ге каршы 11,10/1.000 сөз. Биринчи жактагы ат атоочтор адам жыйынтыктарында 3,35/1.000, AI жыйынтыктарында болгону 1,13/1.000 деңгээлинде кездешкен. Адам авторлор “I” жана “we” сыяктуу түз автордук көрүнүүгө көбүрөөк кайрылганы, AI тексттери болсо “this study” жана “the present thesis” сыяктуу изилдөөнү сүйлөмдүн ээси кылган калыптарды көбүрөөк колдонгону билдирилген.
AI жыйынтыктары орточо болжол менен 730 сөз, адам жыйынтыктары болжол менен 1.351 сөздөн турат. AI ошондой эле “in conclusion”, “this study set out to...” жана “future research” сыяктуу стандарттуу академиялык жыйынтыктоо калыптарын көбүрөөк колдонгон. Бул үлгү колдонулган модель менен prompt шартында AI тексттери кыскараак, көбүрөөк ишенимдүү билдирген жана формулалык академиялык үн жаратууга жакын экенин колдойт.
Ошол эле учурда булакта маанилүү отчет берүү жана методологиялык көйгөйлөр бар. Self-mention категориясынын 500–600/1.000 сөз сыяктуу өтө жогорку маанилери башка таблицалар менен оңой шайкеш келбейт. Table 2нин direction тилкесинде үч категориянын белгиси тескери жазылган. Abstract адам тексттеринде lexical diversity көбүрөөк деп айтса, макаланын TTR таблицалары AI үчүн жогору маанилерди көрсөтөт. Мындан тышкары, маалыматтар жупталган болгонуна карабастан, колдонулган Mann–Whitney U жана Welch t-test көз карандысыз тандалма тесттер. Ошондуктан айрым жыйынтыктарды кайра талдоо пайдалуу болушу мүмкүн.
Академиялык үн деген эмне?
Академиялык үн илимий тексттин эмнени айтканын гана эмес, автор айтылган билимге кандай позиция ээлерин да камтыйт. Изилдөөчү бир табылганы так чындык катары бере алат, ыктымалдык катары чектей алат, жеке баалоо кошо алат же өзүнүн илимий жоопкерчилигин түздөн-түз көрүнүктүү кыла алат.
Hylandдын stance ыкмасы бул функцияларды төрт негизги топто карайт: hedges, boosters, attitude markers жана self-mentions.
Hedge эмне үчүн керек?
Hedge илимий дооматтын тактык деңгээлин чектейт. “May”, “might”, “suggest” жана ушул сыяктуу түзүлүштөр автор бир тыянакты абсолюттук чындык катары эмес, далил мүмкүндүк берген деңгээлде гана сунуштап жатканын көрсөтөт.
Изилдөөдө адам корпусу үчүн 20,69, AI корпусу үчүн 17,60 hedge/1.000 сөз билдирилген.
Бирок статистикалык жыйынтыктар ыкмага жараша өзгөрөт. Mann–Whitney U жана Welch t-testтеринде айырма p<0,05 эмес; aggregate log-likelihood тести болсо маанилүү жыйынтык берет. Ошондуктан адам авторлор көбүрөөк epistemic caution көрсөтөт деген багытта жыштык айырмасы бар, бирок статистикалык далил бардык тесттерде бирдей эмес.
Booster деген эмне?
Booster дооматтын тактыгын же күчүн жогорулатуучу тилдик белги. “Clearly demonstrates”, “reveals” жана “establishes” сыяктуу сөз айкаштары автордун бир билдирүүгө күчтүүрөөк берилгенин көрсөтөт.
AI корпусу:
23,29 booster / 1.000 сөз
өндүрсө, адам корпусу:
15,41 / 1.000 сөз
өндүргөн.
Бул айырма изилдөөнүн статистикалык жактан эң туруктуу жыйынтыктарынын бири. Булактын үч тести тең booster колдонууда маанилүү корпус айырмасын билдирет.
Ошондуктан изилдөө колдонулган Gemini модели жана prompt шартында AI жыйынтыктары адам жыйынтыктарына караганда көбүрөөк assertive тон жаратат деп ырастайт.
Attitude markers айырмаланабы?
Эки корпустун ортосунда чоң айырма жок.
Адам:
10,77 / 1.000
AI:
11,10 / 1.000
жана Welch тести p=0,8352.
Демек, изилдөө evaluative attitude колдонууда айкын human–AI айырмасын тапкан эмес.
Адам Жыйынтыктары менен AI Жыйынтыктары Узундугу Боюнча Канча Айырмаланат?
| Көрсөткүч | Адам Корпусу | AI Корпусу |
|---|---|---|
| Текст саны | 40 | 40 |
| Жалпы сөз саны | 54.046 | 29.197 |
| Жалпы сүйлөм саны | 2.051 | 1.257 |
| Орточо сөз саны | 1.351,2 | 729,9 |
| Орточо сүйлөм саны | 51,3 | 31,4 |
Адам жазган жыйынтык бөлүмдөрү орточо эсеп менен AI жыйынтыктарынан болжол менен 1,85 эсе узун.
Бул айырма AI табиятынан эле кыскараак жазарын өзүнчө далилдебейт. Булак prompt дизайны жана моделдин input/output чектөөлөрү conclusion узундугуна таасир эткен болушу мүмкүн экенин ачык айтат.
Адамбы же AIбы Сөз Ар Түрдүүлүгүн Көбүрөөк Колдонот?
Бул маселе боюнча булактын ичинде маанилүү карама-каршылык бар.
Abstract адам авторлор көбүрөөк lexical diversity көрсөтөт деп айтат. Бирок Table 1де Type-Token Ratio:
Human = 0,0854
AI = 0,1262
деп берилген.
Кийинки standardize TTR таблицасында да AI 138,11, адам корпусу 91,06 деп билдирилген. Мындан тышкары, дал келтирилген 40 жыйынтыктын баарында AI TTR мааниси адамдагы тиешелүү мааниден жогору көрсөтүлгөн.
Ошондуктан изилдөөнүн өзүнүн сандык маалыматтары “адамдар көбүрөөк lexical diversity көрсөттү” деген тыянакты колдобойт.
Булак жакшыраак колдогон айырма төмөнкүдөй:
AI жогору lexical-variety көрсөткүчтөрүн көрсөтсө, адам авторлор көбүрөөк context-specific vocabulary колдонушат.
Адам корпусунда “teachers”, “teaching”, “writing” сыяктуу изилдөөнүн чыныгы контекстине байланыштуу сөздөр өзгөчөлөнсө, AI корпусунда “doctoral”, “transition”, “landscape” жана “underscores” сыяктуу жалпы академиялык сөздөр мүнөздүү.
AI Эмне Үчүн Көбүрөөк Формулалык Көрүнөт?
Phraseological analysis AI жыйынтыктарында айрым academic-summary калыптары кайталанарын көрсөтөт.
Мисалы, “in conclusion” адам корпусунда эки жолу, AI корпусунда 31 жолу кездешкен.
“This study set out to investigate...” калыбынын беш сөздөн турган формасы AI корпусунда 10 жолу; “The present doctoral thesis set out to...” сыяктуу түзүлүш болсо сегиз жолу кездешкен.
Бул үлгү AI жыйынтыкты уюштуруу үчүн ыктымалдыгы жогору академиялык шаблондорго көбүрөөк кайрыларын көрсөтөт.
Бул формулалуулук грамматикалык ката эмес. Текст абдан туура болушу мүмкүн, бирок ар башка изилдөөлөрдө окшош rhetorical packaging колдонушу мүмкүн.
“Future Research” Колдонулушу Эмне Үчүн Көңүл Бурдурат?
“Future research” сөз айкашы адам корпусунда тогуз, AI корпусунда 43 жолу табылган.
AI корпусу адам корпусунан кыйла кыска экенин эске алганда, нормалдаштырылган айырма андан да чоң болот.
Бул жыйынтык AI докторлук диссертациянын conclusion жанрын аяктап жатканда келечектеги изилдөөгө чакырууну кадимки genre marker катары колдонууга жакын экенине шайкеш келет.
Бирок бардык recommendation жыйынтыктары бирдей ишенимдүү эмес. Булак айрым recommendation калыптарын жалаң чийки жыштыктар менен салыштырып, корпус көлөмүндөгү айырманы эсепке албайт. Ошондуктан кайсы корпус жалпысынан “түзүрөөк сунуш бергенин” айтууда этият болуу керек.
Автордун Өзүн Текстте Көрсөтүшү Кандайча Айырмаланат?
Биринчи жактагы ат атоочтор боюнча айырма кыйла так:
| Көрсөткүч | Адам | AI |
|---|---|---|
| 1-жак ат атоочтору / 1.000 | 3,35 | 1,13 |
| Passive constructions / 1.000 | 12,84 | 6,23 |
| Орточо сүйлөм узундугу | 26,4 | 23,2 |
Адам авторлор “I” жана “we” сыяктуу түзүлүштөр аркылуу өз академиялык жоопкерчилигин түздөн-түз көрүнүктүү кылууга көбүрөөк жакын.
AI болсо изилдөөнү сүйлөмдүн ээси кылган “this study” жана “the present thesis” сыяктуу authorial proxy формаларына көбүрөөк кайрылат.
Ошондуктан жалаң жалпы “self-mention” санын эмес, authorial presence кандай курулганын карап чыгуу алда канча маалыматтуу.
Self-Mention Жыйынтыгында Эмне Үчүн Көйгөй Бар?
Булактын Table 2синде адам корпусу үчүн 27.171, AI корпусу үчүн 17.611 self-mention эсептелген. Нормалдаштырылган көрсөткүчтөр тиешелүүлүгүнө жараша 502,74 жана 603,18/1.000 сөз.
Бул болжол менен ар бир эки сөздүн бири self-mention катары классификациялангандай чоңдуктагы жыйынтык.
Ошол эле булак биринчи жактагы ат атоочторду болгону 3,35 жана 1,13/1.000 деңгээлинде билдирсе, кеңири таралган “this study/research/thesis/paper” калыбы да болгону 128 жана 200 жолу эсептелген.
Ошондуктан self-mention жалпы саны кантип мынчалык жогору болуп кеткенин макаланын азыркы отчетунан түшүнүү мүмкүн эмес.
Эсептөө сөздүгү жана Python коду жарыяланмайынча бул категорияны көз карандысыз текшерүү мүмкүн эмес. Ошондуктан self-mention жыйынтыгы изилдөөнүн эң күчтүү сандык табылгаларынын катарына киргизилбеши керек.
Table 2де Отчет Берүү Катасы Барбы?
Ооба. “Direction” тилкесинде бардык категориялар үчүн HC > AIC деп жазылган.
Бирок нормалдаштырылган сандар boosters, attitude markers жана source-defined self-mentions категорияларында AIC жогору экенин көрсөтөт.
Кийинки түшүндүрмө тексти туура багытты колдонгондуктан, бул таблицаны терүүдөгү же отчет берүүдөгү ката болушу ыктымал.
Жупталган Дизайн Статистикалык Талдоого Толук Өткөрүлгөнбү?
Жок. Изилдөөнүн маанилүү күчтүү жагы 40 human–AI текст жуптары бир эле булак диссертациядан алынганында. Ар бир AI conclusion түздөн-түз дал келген human conclusionга ээ.
Ошого карабастан статистикалык салыштырууда Mann–Whitney U жана Welch t-test колдонулган. Булар көз карандысыз тандалма тесттер жана thesis-level pairing маалыматын түз колдонбойт.
Ошондуктан paired t-test же Wilcoxon signed-rank сыяктуу жупталган тесттер менен кайра талдоо жыйынтыктардын статистикалык туруктуулугун жакшыраак баалоого жардам берет.
Айрыкча hedges үчүн ар башка тесттер ар башка маанилүүлүк жыйынтыгын бериши бул кайра талдоону маанилүү кылат.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Корпустун түзүлүшү
Изилдөө 40 human-written жана 40 AI-generated General Conclusionдан турган 40 жупталган текст жуптарын колдонгон.
Адам корпусунун булагы
Англис тилинде жазылган, Applied Linguistics же жакын тармактагы жана Алжир университеттеринен ачык жеткиликтүү докторлук диссертациялар тандалган.
AI өндүрүү
Ар бир диссертациянын түпкү General Conclusion бөлүмү алынып салынган; киришүү, адабият, ыкма, жыйынтыктар жана discussion сыяктуу башка бөлүмдөр Gemini 3 Flash Preview моделине берилген.
Prompt көзөмөлү
40 диссертациянын баарында бирдей, атайын жөнөкөй prompt колдонулган. Prompt моделден stance же белгилүү бир академиялык стилди атайын колдонушун талап кылган эмес.
Аналитикалык алкак
Hylandдын stance моделине ылайык hedges, boosters, attitude markers жана self-mentions талданган.
Нормалдаштыруу
Stance-marker жыштыктары корпус узундугундагы айырманы азайтуу үчүн 1.000 сөзгө нормалдаштырылган.
Статистика
Mann–Whitney U, Welch t-test жана log-likelihood колдонулган. Дизайн жупталган болгону менен алгачкы эки тест pairingди түз баалабайт.
Негизги stance жыйынтыктары
| Категория | Адам / 1.000 | AI / 1.000 | Эң этият чечмелөө |
|---|---|---|---|
| Hedges | 20,69 | 17,60 | Адам жогору; тесттер маанилүүлүк боюнча шайкеш келбейт |
| Boosters | 15,41 | 23,29 | AI айкын түрдө жогору |
| Attitude markers | 10,77 | 11,10 | Айкын айырма жок |
| Self-mentions | 502,74 | 603,18 | Булактагы эсеп текшерилмейинче колдонулбашы керек |
Биринчи жактагы автордук көрүнүү
Адам тексттери 3,35 first-person pronoun/1.000, AI тексттери 1,13/1.000 көрсөтөт.
Риторикалык калыптар
AI “in conclusion”, “this study...” жана “future research” сыяктуу standardized academic expressionsды көбүрөөк колдонгон.
Лексикалык жыйынтык
Булактагы TTR таблицалары AI үчүн жогору lexical-variety маанилерин көрсөтсө, keyword жана bundle талдоолору адам жазуусу көбүрөөк context-specific экенин көрсөтөт. Бул эки өзгөчөлүктү бири-биринен ажыратуу керек.
Sentence complexity
Адам жыйынтыктары орточо 26,4 сөздүк, AI жыйынтыктары 23,2 сөздүк сүйлөмдөрдү колдонгон.
Passive voice
Адам корпусунда passive constructions 12,84/1.000, AI корпусунда 6,23/1.000 деп билдирилген.
Изилдөө колдогон жыйынтыктар
Бул маалымат топтомунда AI conclusionдары адам conclusionдарынан кыскараак. AI boostersды көбүрөөк тыгыздыкта колдонот. Attitude-marker колдонууда айкын айырма жок. Адам авторлор биринчи жактагы authorial presenceты көбүрөөк колдонушат. AI көбүрөөк standardized conclusion formula жана generic academic phrasing көрсөтөт. Адам тексттери болсо изилдөөнүн чыныгы контекстине тиешелүү сөздөрдү көбүрөөк колдонушат.
Изилдөө колдобогон жыйынтыктар
Бардык жасалма интеллект моделдери адамдардан көбүрөөк ишенимдүү тон менен жазат деп айтууга болбойт. AI универсалдуу түрдө төмөн lexical diversityге ээ деген тыянак бул изилдөөдөн чыгарылбайт. Self-mention 603/1.000 деңгээлинде экени көз карандысыз текшерилген эмес. Адам менен AIнин академиялык жазуу жөндөмүнүн жалпы сапат рейтинги түзүлгөн эмес. Изилдөө бир гана модель, бир стандарттуу prompt, белгилүү бир дисциплина жана Алжир университеттеринен алынган 40 диссертация менен чектелет.
Булак жана Ыкма Жөнүндө Эскертүү
Түпкү изилдөө:Constructing Academic Voice: A Corpus-Based Comparison of Human- and AI-Generated Doctoral Thesis Conclusions
Автор: Dhaya Eddine Ayachi.
PDFдеги мекеме: Mohammed Seddik Ben Yahia University, Faculty of Letters and Languages, Department of English.
Платформа: SSRN.
SSRN жарыяланган күнү: 10 июнь 2026.
SSRN DOI: 10.2139/ssrn.6911006.
Булактын түрү: 36 беттик preprint research paper.
Рецензия статусу: Preprint not peer reviewed.
Лицензия: All rights reserved; no reuse allowed without permission.
Негизги AI модели: Google Gemini 3 Flash Preview.
Корпус: 40 жупталган human–AI General Conclusion жуптары.
Теориялык алкак: Hylandдын stance модели.
Талдоо куралдары: Python; NLTK; SciPy; regex негизиндеги marker сканери; Mann–Whitney U, Welch t-test жана log-likelihood.
Негизги чектөөлөр: Бир LLM жана бир prompt колдонулушу; human корпусу бир дисциплина жана бир өлкөнүн контексти менен чектелиши; адам жана AI тексттеринин узундугу олуттуу айырмаланышы; жупталган дизайнга карабастан көз карандысыз тандалма тесттердин колдонулушу; self-mention категориясында түшүндүрүлбөгөн жогорку жыштыктар; айрым rhetorical-move талдоолорунун нормалдаштырылбаган чийки сандарга таянуусу; Table 2деги direction белгилериндеги каталар; abstractтагы lexical-diversity чечмелөөсү менен TTR жыйынтыктарынын карама-каршылыгы.
Verianla баяндоо принциби: Бул мазмун булак preprintтин толук текст котормосу эмес. Корпус дизайны, stance-marker жыйынтыктары, phraseological табылгалар жана булак ичиндеги методологиялык көйгөйлөр сакталып, өз алдынча жана сынчыл окутуучу түзүлүш түзүлгөн. Булактагы conclusion тексттери жана таблицалар механикалык түрдө кайра колдонулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген