

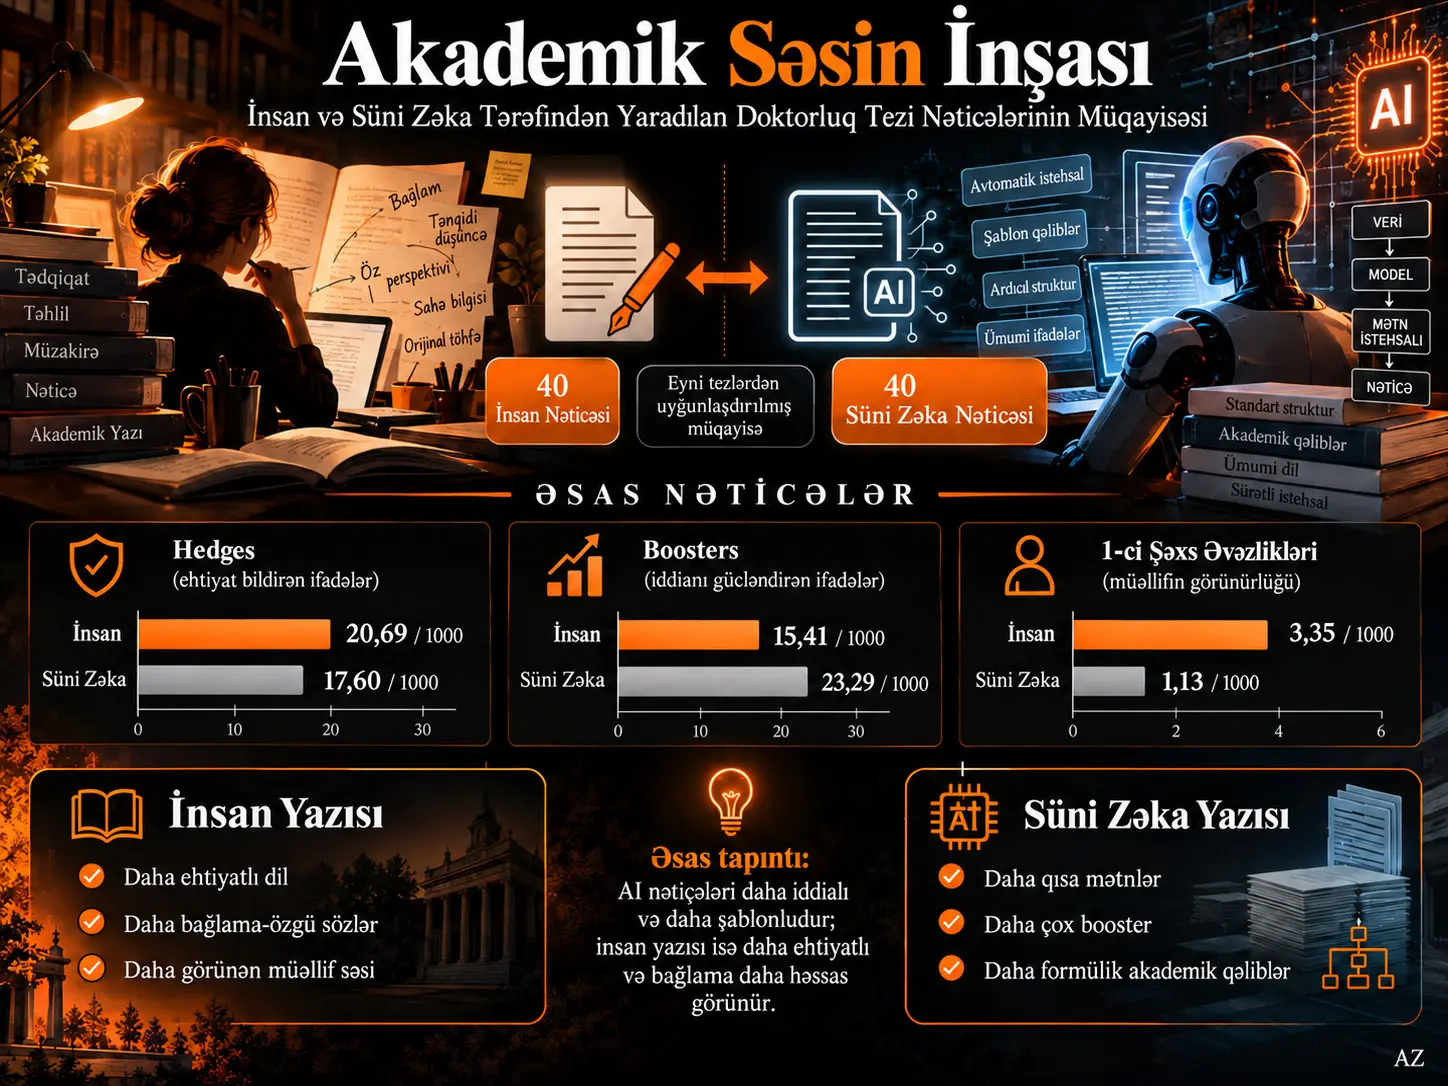
Generativ süni intellekt sistemləri akademik formaya bənzəyən səlis mətnlər yaza bilər; lakin akademik yazının yalnız qrammatik düzgünlükdən ibarət olmadığı unudulmamalıdır. Elmi müəlliflər iddialarının nə qədər qəti olduğunu, hansı məqamlarda ehtiyatlı davrandıqlarını, qiymətləndirmələrini necə ifadə etdiklərini və mətndə öz müəllif kimliklərini nə dərəcədə görünən etdiklərini müxtəlif dil vasitələri ilə tənzimləyirlər. Bu xüsusiyyətlər birlikdə akademik səsin mühüm bir hissəsini təşkil edir.
Bu tədqiqat Applied Linguistics sahəsindəki 40 doktorluq dissertasiyasının orijinal General Conclusion bölmələrini, həmin dissertasiyaların nəticə bölməsi çıxarıldıqdan sonra Google Gemini 3 Flash Preview tərəfindən yaradılmış 40 yeni General Conclusion mətni ilə müqayisə edir. Beləliklə, ümumilikdə 40 uyğunlaşdırılmış insan–AI mətn cütü yaradılmışdır.
Təhlil Hylandın stance modelindəki hedges, boosters, attitude markers və self-mentions kateqoriyalarına fokuslanır. İnsan korpusunda hedges 1.000 sözə 20,69, AI korpusunda isə 17,60 nisbətində müəyyən edilmişdir. Bunun əksinə, boosters AI mətnlərində xeyli yüksək görünür: insan korpusunda 15,41, AI korpusunda 23,29/1.000 söz.
Attitude markers baxımından iki korpus bir-birinə çox yaxındır: 10,77-yə qarşı 11,10/1.000 söz. Birinci şəxs əvəzlikləri isə insan nəticələrində 3,35/1.000, AI nəticələrində yalnız 1,13/1.000 nisbətində müşahidə edilmişdir. İnsan müəlliflərin “I” və “we” kimi birbaşa müəllif görünürlüğünə daha çox müraciət etdiyi, AI mətnlərinin isə “this study” və “the present thesis” kimi tədqiqatı mübtəda edən qəliblərə daha tez-tez yönəldiyi bildirilmişdir.
AI nəticələri orta hesabla təxminən 730 söz, insan nəticələri isə təxminən 1.351 sözdür. AI həmçinin “in conclusion”, “this study set out to...” və “future research” kimi standart akademik yekunlaşdırma qəliblərinə daha tez-tez müraciət etmişdir. Bu nümunə, istifadə olunan model və prompt şəraitində AI mətnlərinin daha qısa, daha iddialı və daha formullu akademik səs yaratmağa meylli olduğunu dəstəkləyir.
Bununla yanaşı, mənbədə mühüm hesabatvermə və metodoloji problemlər mövcuddur. Self-mention kateqoriyasının 500–600/1.000 söz kimi qeyri-adi dərəcədə yüksək göstəriciləri digər cədvəllərlə asanlıqla uzlaşdırılmır. Table 2-nin direction sütununda üç kateqoriyanın işarəsi tərsinə yazılmışdır. Abstract insanlarda daha çox lexical diversity olduğunu iddia etdiyi halda, məqalənin TTR cədvəlləri AI üçün daha yüksək dəyərlər göstərir. Bundan əlavə, məlumatlar uyğunlaşdırılmış olsa da, istifadə olunan Mann–Whitney U və Welch t-testləri müstəqil seçmə testləridir. Buna görə bəzi nəticələrin yenidən təhlili faydalı ola bilər.
Akademik səs nədir?
Akademik səs elmi mətnin yalnız nə dediyini deyil, müəllifin söylədiyi məlumata necə mövqeləndiyini də əhatə edir. Tədqiqatçı bir tapıntını qəti həqiqət kimi təqdim edə, ehtimal kimi çərçivələyə, şəxsi qiymətləndirmə əlavə edə və ya birbaşa öz elmi məsuliyyətini görünən edə bilər.
Hylandın stance yanaşması bu funksiyaları dörd əsas qrupda araşdırır: hedges, boosters, attitude markers və self-mentions.
Hedge nə işə yarayır?
Hedge elmi iddianın qətiyyətini məhdudlaşdırır. “May”, “might”, “suggest” və oxşar strukturlar müəllifin bir nəticə çıxarışını mütləq həqiqət kimi deyil, sübutun imkan verdiyi ölçüdə irəli sürdüyünü göstərir.
Tədqiqatda insan korpusu üçün 20,69, AI korpusu üçün 17,60 hedge/1.000 söz bildirilmişdir.
Lakin statistik nəticələr metoda görə dəyişir. Mann–Whitney U və Welch t-testlərində fərq p<0,05 deyil; aggregate log-likelihood testi isə mənalı nəticə verir. Buna görə insan müəlliflərin daha çox epistemic caution göstərdiyinə dair tezlik fərqi mövcuddur, lakin statistik sübut bütün testlərdə eyni deyil.
Booster nədir?
Booster iddianın qətiyyətini və ya gücünü artıran dil işarəsidir. “Clearly demonstrates”, “reveals” və “establishes” kimi ifadələr müəllifin bir müddəaya daha güclü şəkildə bağlı olduğunu göstərir.
AI korpusu:
23,29 booster / 1.000 söz
istehsal etdiyi halda insan korpusu:
15,41 / 1.000 söz
istehsal etmişdir.
Bu fərq tədqiqatın statistik baxımdan ən ardıcıl nəticələrindən biridir. Mənbənin üç testi də booster istifadəsində mənalı korpus fərqi bildirir.
Buna görə tədqiqat, istifadə olunan Gemini modeli və prompt şəraitində AI nəticələrinin insan nəticələrindən daha assertive ton yaratdığını irəli sürür.
Attitude markers fərqlidirmi?
İki korpus arasında böyük fərq yoxdur.
İnsan:
10,77 / 1.000
AI:
11,10 / 1.000
və Welch testi p=0,8352-dir.
Beləliklə, tədqiqat evaluative attitude istifadəsində nəzərəçarpan insan–AI fərqi aşkar etməmişdir.
İnsan Nəticələri ilə AI Nəticələri Uzunluq Baxımından Nə Qədər Fərqlənir?
| Xüsusiyyət | İnsan Korpusu | AI Korpusu |
|---|---|---|
| Mətn sayı | 40 | 40 |
| Ümumi söz sayı | 54.046 | 29.197 |
| Ümumi cümlə sayı | 2.051 | 1.257 |
| Orta söz sayı | 1.351,2 | 729,9 |
| Orta cümlə sayı | 51,3 | 31,4 |
İnsan nəticə bölmələri orta hesabla AI nəticələrindən təxminən 1,85 dəfə uzundur.
Bu fərq AI-nın təbii olaraq daha yığcam olduğunu öz-özlüyündə sübut etmir. Mənbə prompt dizaynının və modelin input/output məhdudiyyətlərinin conclusion uzunluğuna təsir etmiş ola biləcəyini açıq şəkildə bildirir.
İnsan, yoxsa AI Daha Çox Söz Müxtəlifliyindən İstifadə Edir?
Bu məsələdə mənbə daxilində mühüm ziddiyyət mövcuddur.
Abstract insan müəlliflərin daha çox lexical diversity göstərdiyini bildirir. Bunun əksinə, Table 1-də Type-Token Ratio:
Human = 0,0854
AI = 0,1262
kimi verilmişdir.
Sonrakı standardize TTR cədvəlində də AI 138,11, insan korpusu isə 91,06 kimi bildirilmişdir. Bundan əlavə, 40 uyğunlaşdırılmış nəticənin hamısında AI TTR dəyəri insan uyğunluğundan daha yüksək göstərilmişdir.
Beləliklə, tədqiqatın öz ədədi məlumatları “insanlar daha çox lexical diversity göstərdi” nəticəsini dəstəkləmir.
Mənbənin daha yaxşı dəstəklədiyi fərq belədir:
AI daha yüksək lexical-variety ölçüləri göstərdiyi halda, insan müəlliflər daha context-specific vocabulary istifadə edirlər.
İnsan korpusunda “teachers”, “teaching”, “writing” kimi tədqiqatın real kontekstinə aid sözlər önə çıxarkən, AI korpusunda “doctoral”, “transition”, “landscape” və “underscores” kimi ümumi akademik sözlər daha xarakterikdir.
AI Niyə Daha Formullu Görünür?
Phraseological analysis AI nəticələrində müəyyən academic-summary qəliblərinin təkrarlandığını göstərir.
Məsələn, “in conclusion” insan korpusunda iki dəfə, AI korpusunda 31 dəfə müşahidə edilmişdir.
“This study set out to investigate...” qəlibinin beş sözlük forması AI korpusunda 10 dəfə; “The present doctoral thesis set out to...” bənzəri struktur isə səkkiz dəfə müşahidə edilmişdir.
Bu nümunə AI-nın nəticəni təşkil etmək üçün yüksək ehtimallı akademik şablonlara daha tez-tez müraciət etdiyini düşündürür.
Bu formulluq qrammatik xəta deyil. Mətn son dərəcə düzgün ola bilər, lakin fərqli tədqiqatlar arasında oxşar rhetorical packaging istifadə edə bilər.
“Future Research” İstifadəsi Niyə Diqqət Çəkir?
“Future research” ifadəsi insan korpusunda doqquz, AI korpusunda 43 dəfə tapılmışdır.
AI korpusunun insan korpusundan xeyli qısa olduğu nəzərə alındıqda, normallaşdırılmış fərq daha da böyüyür.
Bu nəticə AI-nın doktorluq dissertasiyası conclusion janrını yekunlaşdırarkən gələcək tədqiqat çağırışını rutin genre marker kimi istifadə etmə meyli ilə uyğundur.
Lakin bütün recommendation nəticələri eyni dərəcədə etibarlı deyil. Mənbə bəzi recommendation qəliblərini yalnız xam tezliklərlə müqayisə edir və korpus ölçüsü fərqini nəzərə almır. Buna görə hansı korpusun ümumilikdə “daha birbaşa tövsiyə verdiyi” barədə daha ehtiyatlı olmaq lazımdır.
Müəllifin Özünü Mətndə Göstərməsi Necə Fərqlənir?
Birinci şəxs əvəzlikləri baxımından fərq olduqca aydındır:
| Göstərici | İnsan | AI |
|---|---|---|
| 1-ci şəxs əvəzlikləri / 1.000 | 3,35 | 1,13 |
| Passive constructions / 1.000 | 12,84 | 6,23 |
| Orta cümlə uzunluğu | 26,4 | 23,2 |
İnsan müəlliflər “I” və “we” kimi strukturlarla öz akademik məsuliyyətlərini birbaşa görünən etməyə daha meyllidirlər.
AI isə tədqiqatı mübtəda edən “this study” və “the present thesis” kimi authorial proxy formalarına daha çox yönəlir.
Buna görə yalnız ümumi “self-mention” sayını deyil, authorial presence-ın necə qurulduğunu araşdırmaq daha çox məlumat verir.
Self-Mention Nəticəsində Niyə Problem Var?
Mənbənin Table 2-sində insan korpusu üçün 27.171, AI korpusu üçün 17.611 self-mention sayılır. Normallaşdırılmış nisbətlər müvafiq olaraq 502,74 və 603,18/1.000 sözdür.
Bu, təxminən hər iki sözdən birinin self-mention kimi təsnif edildiyi miqyasda nəticədir.
Eyni mənbə birinci şəxs əvəzliklərini yalnız 3,35 və 1,13/1.000 səviyyəsində bildirdiyi halda, geniş yayılmış “this study/research/thesis/paper” qəlibi də yalnız 128 və 200 dəfə sayılmışdır.
Buna görə self-mention cəminin necə bu qədər yüksəldiyi məqalənin mövcud hesabatından anlaşıla bilmir.
Sayım lüğəti və Python kodu yayımlanmadan bu kateqoriya müstəqil şəkildə doğrulana bilməz. Buna görə self-mention nəticəsi tədqiqatın ən güclü kəmiyyət nəticələri sırasına daxil edilməməlidir.
Table 2-də Hesabatvermə Xətası Varmı?
Bəli. “Direction” sütununda bütün kateqoriyalar üçün HC > AIC yazılmışdır.
Halbuki normallaşdırılmış rəqəmlər boosters, attitude markers və source-defined self-mentions kateqoriyalarında AIC-nin daha yüksək olduğunu göstərir.
Sonrakı izah mətni düzgün istiqamətdən istifadə etdiyi üçün bunun cədvəl tərtibatı və ya hesabatvermə xətası olması ehtimalı yüksəkdir.
Uyğunlaşdırılmış Dizayn Statistik Təhlilə Tam Şəkildə Köçürülübmü?
Xeyr. Tədqiqatın mühüm üstünlüyü 40 human–AI mətn cütünün eyni mənbə dissertasiyadan gəlməsidir. Hər AI conclusion-ın birbaşa uyğun gələn human conclusion-ı vardır.
Buna baxmayaraq, statistik müqayisədə Mann–Whitney U və Welch t-test istifadə edilmişdir. Bunlar müstəqil seçmə testləridir və thesis-level pairing məlumatını birbaşa istifadə etmir.
Buna görə paired t-test və ya Wilcoxon signed-rank kimi uyğunlaşdırılmış testlərlə yenidən təhlil nəticələrin statistik dayanıqlığını daha yaxşı qiymətləndirə bilər.
Xüsusilə hedges üçün fərqli testlərin fərqli mənalılıq nəticələri verməsi bu yenidən təhlili mühüm edir.
Tədqiqatın Metodu və Nəticələri
Korpus quruluşu
Tədqiqat 40 human-written və 40 AI-generated General Conclusion-dan ibarət 40 uyğunlaşdırılmış mətn cütündən istifadə etmişdir.
İnsan korpusunun mənbəyi
İngilis dilində yazılmış, Applied Linguistics və ya yaxın sahəyə aid və Əlcəzair universitetlərindən açıq girişli doktorluq dissertasiyaları seçilmişdir.
AI istehsalı
Hər dissertasiyanın orijinal General Conclusion bölməsi çıxarılmış; giriş, ədəbiyyat, metod, nəticələr və discussion kimi digər bölmələr Gemini 3 Flash Preview modelinə verilmişdir.
Prompt nəzarəti
40 dissertasiyanın hamısında eyni, qəsdən sadə prompt istifadə edilmişdir. Prompt modeldən stance və ya müəyyən akademik üslubdan xüsusi olaraq istifadə etməsini istəməmişdir.
Analitik çərçivə
Hylandın stance modelinə əsasən hedges, boosters, attitude markers və self-mentions təhlil edilmişdir.
Normallaşdırma
Stance-marker tezlikləri korpus uzunluğundakı fərqi azaltmaq üçün 1.000 sözə görə normallaşdırılmışdır.
Statistika
Mann–Whitney U, Welch t-test və log-likelihood istifadə edilmişdir. Dizayn uyğunlaşdırılmış olsa da, ilk iki test pairing-i birbaşa qiymətləndirmir.
Əsas stance nəticələri
| Kateqoriya | İnsan / 1.000 | AI / 1.000 | Ən təhlükəsiz şərh |
|---|---|---|---|
| Hedges | 20,69 | 17,60 | İnsan daha yüksək; testlər mənalılıq baxımından uyğunlaşmır |
| Boosters | 15,41 | 23,29 | AI nəzərəçarpacaq dərəcədə daha yüksək |
| Attitude markers | 10,77 | 11,10 | Nəzərəçarpan fərq yoxdur |
| Self-mentions | 502,74 | 603,18 | Mənbə sayımı doğrulanmadan istifadə edilməməlidir |
Birinci şəxs müəllif görünürlüğü
İnsan mətnləri 3,35 first-person pronoun/1.000, AI mətnləri 1,13/1.000 göstərir.
Ritorik qəliblər
AI “in conclusion”, “this study...” və “future research” kimi standardized academic expressions-a daha çox müraciət etmişdir.
Leksik nəticə
Mənbənin TTR cədvəlləri AI üçün daha yüksək lexical-variety dəyərləri verdiyi halda, keyword və bundle təhlilləri insan yazısının daha context-specific olduğunu göstərir. Bu iki xüsusiyyət bir-birindən ayrılmalıdır.
Sentence complexity
İnsan nəticələri orta hesabla 26,4 sözlük, AI nəticələri isə 23,2 sözlük cümlələrdən istifadə etmişdir.
Passive voice
İnsan korpusunda passive constructions 12,84/1.000, AI korpusunda 6,23/1.000 kimi bildirilmişdir.
Tədqiqatın dəstəklədiyi nəticələr
Bu məlumat dəstində AI conclusion-ları insan conclusion-larından daha qısadır. AI boosters-dan daha intensiv istifadə edir. Attitude-marker istifadəsində nəzərəçarpan fərq yoxdur. İnsan müəlliflər birinci şəxs authorial presence-dan daha çox istifadə edirlər. AI daha çox standardized conclusion formula və generic academic phrasing nümayiş etdirir. İnsan mətnləri isə tədqiqatın real kontekstinə aid sözlərdən daha tez-tez istifadə edir.
Tədqiqatın dəstəkləmədiyi nəticələr
Bütün süni intellekt modellərinin insanlardan daha iddialı yazdığı deyilə bilməz. AI-nın universal şəkildə daha aşağı lexical diversity-yə malik olduğu bu tədqiqatdan çıxarıla bilməz. Self-mention-ın 603/1.000 səviyyəsində olduğu müstəqil şəkildə doğrulanmamışdır. İnsan və AI-nın akademik yazı qabiliyyətinin ümumi keyfiyyət sıralaması aparılmamışdır. Tədqiqat yalnız bir model, bir standart prompt, müəyyən bir fənn və Əlcəzair universitetlərindən götürülmüş 40 dissertasiya ilə məhduddur.
Mənbə və Metod Qeydi
Orijinal tədqiqat:Constructing Academic Voice: A Corpus-Based Comparison of Human- and AI-Generated Doctoral Thesis Conclusions
Müəllif: Dhaya Eddine Ayachi.
PDF-dəki qurum: Mohammed Seddik Ben Yahia University, Faculty of Letters and Languages, Department of English.
Platforma: SSRN.
SSRN nəşr tarixi: 10 iyun 2026.
SSRN DOI: 10.2139/ssrn.6911006.
Mənbə növü: 36 səhifəlik preprint research paper.
Rəy statusu: Preprint not peer reviewed.
Lisenziya: All rights reserved; no reuse allowed without permission.
Əsas AI modeli: Google Gemini 3 Flash Preview.
Korpus: 40 uyğunlaşdırılmış human–AI General Conclusion cütü.
Nəzəri çərçivə: Hylandın stance modeli.
Təhlil alətləri: Python; NLTK; SciPy; regex əsaslı marker skanı; Mann–Whitney U, Welch t-test və log-likelihood.
Əsas məhdudiyyətlər: Tək LLM və tək prompt istifadə edilməsi; human korpusunun tək fənn və ölkə konteksti ilə məhdud olması; insan və AI mətn uzunluqlarının ciddi şəkildə fərqlənməsi; uyğunlaşdırılmış dizayna baxmayaraq müstəqil seçmə testlərinin istifadə edilməsi; self-mention kateqoriyasındakı izah olunmayan yüksək tezliklər; bəzi rhetorical-move təhlillərinin normallaşdırılmamış xam saylara əsaslanması; Table 2 direction etiketlərindəki xətalar; abstract-dakı lexical-diversity şərhi ilə TTR nəticələrinin ziddiyyət təşkil etməsi.
Verianla izah prinsipi: Bu məzmun mənbə preprintin tam mətn tərcüməsi deyil. Korpus dizaynı, stance-marker nəticələri, phraseological tapıntılar və mənbə daxilindəki metodoloji problemlər qorunaraq müstəqil və tənqidi öyrədici struktur yaradılmışdır. Mənbə conclusion mətnləri və cədvəlləri mexaniki şəkildə yenidən istifadə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib