

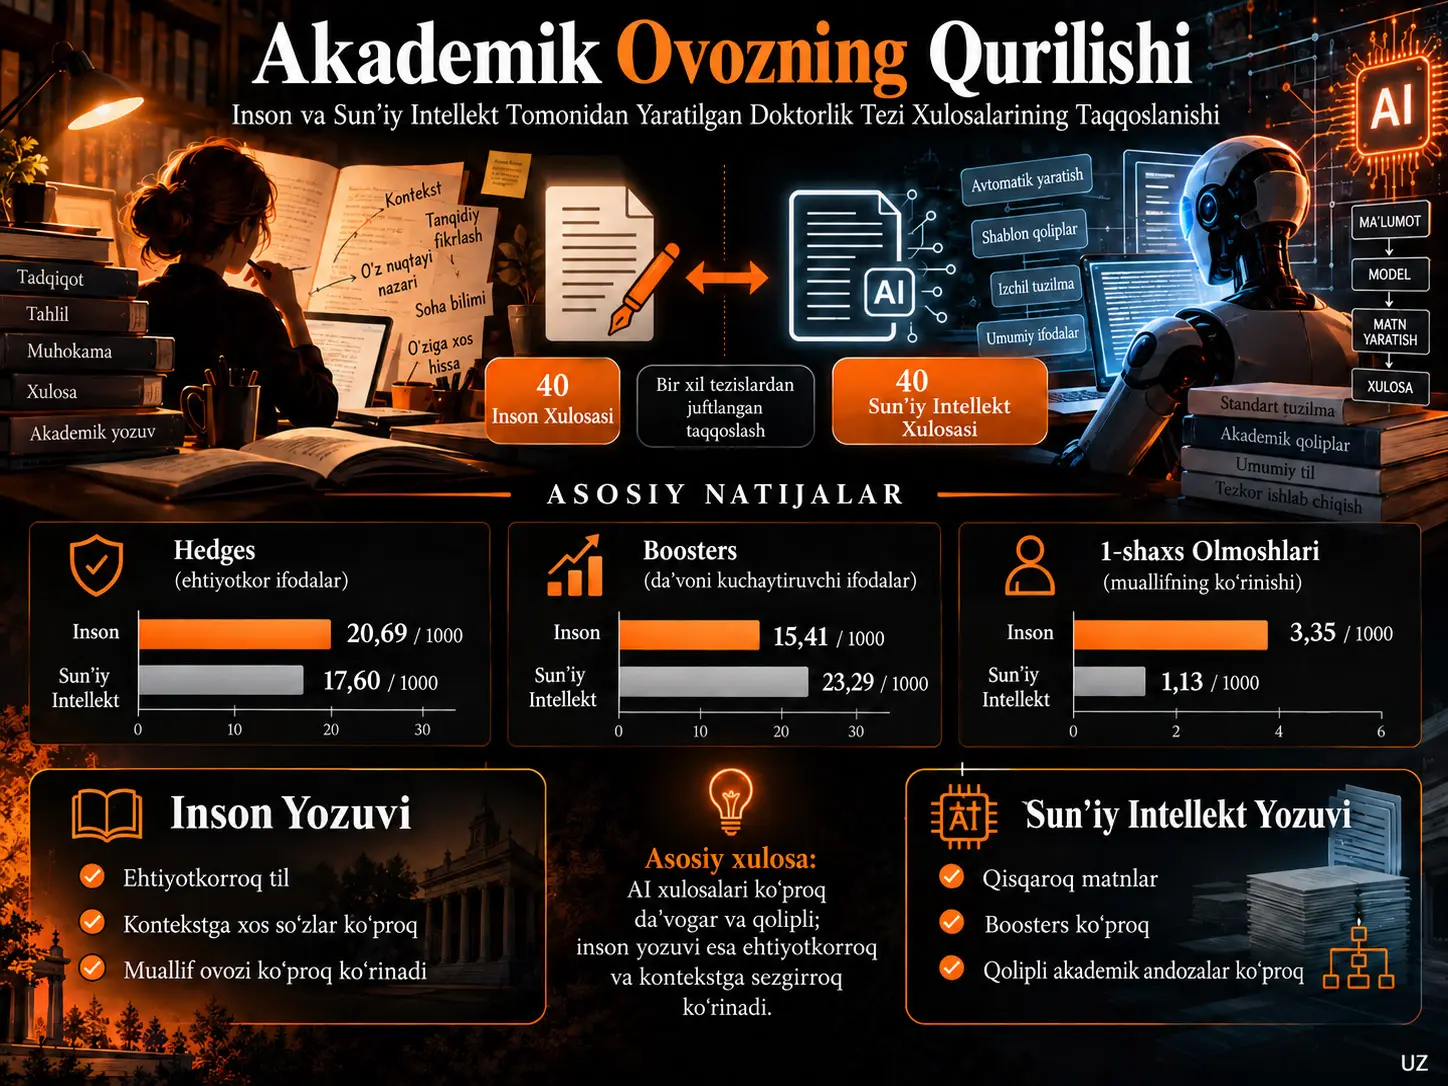
Generativ sun’iy intellekt tizimlari akademik shaklga oʻxshash ravon matnlar yozishi mumkin; biroq akademik yozuv faqat grammatik toʻgʻrilikdan iborat emasligini unutmaslik kerak. Ilmiy mualliflar oʻz da’volari qanchalik qat’iy ekanini, qaysi nuqtalarda ehtiyotkor boʻlishlarini, baholashlarini qanday ifodalashlarini va matnda oʻz mualliflik shaxsini qay darajada koʻrinadigan qilishlarini turli lingvistik vositalar orqali boshqaradilar. Bu xususiyatlar birgalikda akademik ovozning muhim qismini tashkil etadi.
Ushbu tadqiqot Applied Linguistics sohasidagi 40 ta doktorlik dissertatsiyasining asl General Conclusion boʻlimlarini, xuddi shu dissertatsiyalarning xulosa boʻlimi olib tashlangandan keyin Google Gemini 3 Flash Preview tomonidan yaratilgan 40 ta yangi General Conclusion matni bilan taqqoslaydi. Shu tariqa jami 40 ta moslashtirilgan human–AI matn juftligi tuzilgan.
Tahlil Hylandning stance modelidagi hedges, boosters, attitude markers va self-mentions kategoriyalariga qaratilgan. Inson korpusida hedges 1.000 soʻzga 20,69, AI korpusida esa 17,60 nisbatida topilgan. Aksincha, boosters AI matnlarida ancha yuqori koʻrinadi: inson korpusida 15,41, AI korpusida 23,29/1.000 soʻz.
Attitude markers boʻyicha ikki korpus bir-biriga juda yaqin: 10,77 ga qarshi 11,10/1.000 soʻz. Birinchi shaxs olmoshlari esa inson xulosalarida 3,35/1.000, AI xulosalarida atigi 1,13/1.000 nisbatida kuzatilgan. Inson mualliflari “I” va “we” kabi bevosita muallif koʻrinishiga koʻproq murojaat qilgani, AI matnlari esa “this study” va “the present thesis” kabi tadqiqotni ega qiluvchi qoliplarga tez-tez yoʻnalgani bildirilgan.
AI xulosalari oʻrtacha taxminan 730 soʻz, inson xulosalari esa taxminan 1.351 soʻzdan iborat. AI shuningdek “in conclusion”, “this study set out to...” va “future research” kabi standart akademik yakunlash qoliplariga koʻproq murojaat qilgan. Ushbu andoza qoʻllangan model va prompt sharoitida AI matnlari qisqaroq, qat’iyroq va formulaviyroq akademik ovoz yaratishga moyil ekanini qoʻllab-quvvatlaydi.
Biroq manbada muhim hisobot berish va metodologik muammolar mavjud. Self-mention kategoriyasining 500–600/1.000 soʻz kabi gʻayrioddiy yuqori qiymatlari boshqa jadvallar bilan osonlikcha moslashtirilmaydi. Table 2 dagi direction ustunida uch kategoriyaning belgisi teskari yozilgan. Abstract insonlarda koʻproq lexical diversity borligini da’vo qilsa-da, maqolaning TTR jadvallari AI uchun yuqoriroq qiymatlarni koʻrsatadi. Bundan tashqari, ma’lumotlar juftlangan boʻlsa ham, qoʻllangan Mann–Whitney U va Welch t-testlari mustaqil namuna testlaridir. Shu sababli ayrim natijalarni qayta tahlil qilish foydali boʻlishi mumkin.
Akademik ovoz nima?
Akademik ovoz ilmiy matn faqat nimani aytishini emas, balki muallif aytilgan bilimga qanday pozitsiyada turishini ham qamrab oladi. Tadqiqotchi bir topilmani qat’iy haqiqat sifatida taqdim etishi, ehtimol sifatida ramkalashi, shaxsiy baho qoʻshishi yoki bevosita oʻz ilmiy mas’uliyatini koʻrinadigan qilishi mumkin.
Hylandning stance yondashuvi bu funksiyalarni toʻrtta asosiy guruhda koʻrib chiqadi: hedges, boosters, attitude markers va self-mentions.
Hedge nima vazifa bajaradi?
Hedge ilmiy da’voning qat’iylik darajasini cheklaydi. “May”, “might”, “suggest” va shunga oʻxshash tuzilmalar muallif bir xulosani mutlaq haqiqat sifatida emas, dalillar imkon bergan darajada ilgari surayotganini koʻrsatadi.
Tadqiqotda inson korpusi uchun 20,69, AI korpusi uchun 17,60 hedge/1.000 soʻz qayd etilgan.
Biroq statistik natijalar usulga qarab oʻzgaradi. Mann–Whitney U va Welch t-testlarida farq p<0,05 emas; aggregate log-likelihood testi esa ahamiyatli natija beradi. Shuning uchun inson mualliflari koʻproq epistemic caution koʻrsatishi tomonida chastota farqi mavjud, ammo statistik dalil barcha testlarda bir xil emas.
Booster nima?
Booster da’voning qat’iyligi yoki kuchini oshiruvchi lingvistik belgidir. “Clearly demonstrates”, “reveals” va “establishes” kabi ifodalar muallifning bir mulohazaga kuchliroq bogʻlanganini koʻrsatadi.
AI korpusi:
23,29 booster / 1.000 soʻz
ishlab chiqargan boʻlsa, inson korpusi:
15,41 / 1.000 soʻz
ishlab chiqargan.
Bu farq tadqiqotning statistik jihatdan eng izchil natijalaridan biridir. Manbadagi uchala test ham booster ishlatilishida ahamiyatli korpus farqini bildiradi.
Shu sababli tadqiqot qoʻllangan Gemini modeli va prompt sharoitida AI xulosalari inson xulosalariga qaraganda assertive ohangni kuchliroq yaratishini ilgari suradi.
Attitude markers farqlanadimi?
Ikki korpus oʻrtasida katta farq yoʻq.
Inson:
10,77 / 1.000
AI:
11,10 / 1.000
va Welch testi p=0,8352 dir.
Demak, tadqiqot evaluative attitude ishlatilishida aniq human–AI farqini topmagan.
Inson Xulosalari bilan AI Xulosalari Uzunlik Jihatidan Qanchalik Farq Qiladi?
| Xususiyat | Inson Korpusi | AI Korpusi |
|---|---|---|
| Matn soni | 40 | 40 |
| Jami soʻz | 54.046 | 29.197 |
| Jami gap | 2.051 | 1.257 |
| Oʻrtacha soʻz | 1.351,2 | 729,9 |
| Oʻrtacha gap | 51,3 | 31,4 |
Inson xulosa boʻlimlari oʻrtacha AI xulosalaridan taxminan 1,85 baravar uzun.
Bu farq AI tabiatan ixchamroq ekanini oʻz-oʻzidan isbotlamaydi. Manba prompt dizayni va modelning input/output chegaralari conclusion uzunligiga ta’sir qilgan boʻlishi mumkinligini ochiq aytadi.
Insonmi yoki AI Koʻproq Soʻz Xilma-xilligidan Foydalanadi?
Bu masalada manba ichida muhim ziddiyat mavjud.
Abstract inson mualliflari koʻproq lexical diversity koʻrsatishini aytadi. Bunga qarshi ravishda Table 1 da Type-Token Ratio:
Human = 0,0854
AI = 0,1262
deb berilgan.
Keyingi standardize TTR jadvalida ham AI 138,11, inson korpusi 91,06 deb qayd etilgan. Bundan tashqari, 40 ta juftlangan xulosaning barchasida AI TTR qiymati inson juftligidan yuqori berilgan.
Shuning uchun tadqiqotning oʻz raqamli ma’lumotlari “insonlar koʻproq lexical diversity koʻrsatdi” degan xulosani qoʻllab-quvvatlamaydi.
Manba yaxshiroq qoʻllab-quvvatlaydigan farq quyidagicha:
AI yuqoriroq lexical-variety oʻlchovlarini koʻrsatsa, inson mualliflari koʻproq context-specific vocabulary ishlatadilar.
Inson korpusida “teachers”, “teaching”, “writing” kabi tadqiqotning haqiqiy kontekstiga oid soʻzlar ajralib tursa, AI korpusida “doctoral”, “transition”, “landscape” va “underscores” kabi umumiy akademik soʻzlar xarakterliroqdir.
AI Nega Koʻproq Formulaviy Koʻrinadi?
Phraseological analysis AI xulosalarida ayrim academic-summary qoliplari takrorlanishini koʻrsatadi.
Masalan, “in conclusion” inson korpusida ikki marta, AI korpusida 31 marta uchragan.
“This study set out to investigate...” qolipining besh soʻzli shakli AI korpusida 10 marta; “The present doctoral thesis set out to...” ga oʻxshash tuzilma esa sakkiz marta uchragan.
Bu andoza AI xulosani tashkil etish uchun yuqori ehtimolli akademik shablonlarga koʻproq murojaat qilishini koʻrsatadi.
Bu formulaviylik grammatik xato emas. Matn nihoyatda toʻgʻri boʻlishi mumkin, biroq turli tadqiqotlar orasida oʻxshash rhetorical packaging ishlatishi mumkin.
“Future Research” Ishlatilishi Nega Diqqatga Sazovor?
“Future research” iborasi inson korpusida toʻqqiz, AI korpusida 43 marta topilgan.
AI korpusi inson korpusidan ancha qisqa ekani hisobga olinsa, normallashtirilgan farq yanada kattalashadi.
Bu natija AI doktorlik dissertatsiyasi conclusion janrini yakunlar ekan, kelajak tadqiqotiga chaqiriqni rutin genre marker sifatida ishlatishga moyilligi bilan mos keladi.
Biroq barcha recommendation natijalari bir xil darajada ishonchli emas. Manba ayrim recommendation qoliplarini faqat xom chastotalar bilan taqqoslaydi va korpus hajmidagi farqni hisobga olmaydi. Shu sababli qaysi korpus umuman olganda “toʻgʻridan-toʻgʻriroq tavsiya bergani” haqida ehtiyotkorroq boʻlish kerak.
Muallifning Oʻzini Matnda Koʻrsatishi Qanday Farq Qiladi?
Birinchi shaxs olmoshlari boʻyicha farq juda aniq:
| Koʻrsatkich | Inson | AI |
|---|---|---|
| 1-shaxs olmoshlari / 1.000 | 3,35 | 1,13 |
| Passive constructions / 1.000 | 12,84 | 6,23 |
| Oʻrtacha gap uzunligi | 26,4 | 23,2 |
Inson mualliflari “I” va “we” kabi tuzilmalar orqali oʻz akademik mas’uliyatini bevosita koʻrinadigan qilishga koʻproq moyil.
AI esa tadqiqotni ega qiluvchi “this study” va “the present thesis” kabi authorial proxy shakllariga koʻproq yoʻnaladi.
Shu sababli faqat umumiy “self-mention” sonini emas, authorial presence qanday qurilganini tekshirish ancha ma’lumotliroqdir.
Self-Mention Natijasida Nega Muammo Bor?
Manbaning Table 2 sida inson korpusi uchun 27.171, AI korpusi uchun 17.611 self-mention sanalgan. Normallashtirilgan nisbatlar mos ravishda 502,74 va 603,18/1.000 soʻzdir.
Bu taxminan har ikki soʻzdan birining self-mention sifatida tasniflangan miqyosdagi natijadir.
Xuddi shu manba birinchi shaxs olmoshlarini atigi 3,35 va 1,13/1.000 darajasida qayd etar ekan, keng tarqalgan “this study/research/thesis/paper” qolipi ham atigi 128 va 200 marta sanalgan.
Shu sababli self-mention jami qanday qilib bunchalik yuqorilagani maqolaning mavjud hisobotidan tushunilmaydi.
Hisoblash lugʻati va Python kodi e’lon qilinmaguncha bu kategoriya mustaqil ravishda tasdiqlab boʻlmaydi. Shu sababli self-mention natijasi tadqiqotning eng kuchli miqdoriy topilmalari qatoriga qoʻyilmasligi kerak.
Table 2 da Hisobot Xatosi Bormi?
Ha. “Direction” ustunida barcha kategoriyalar uchun HC > AIC yozilgan.
Holbuki normallashtirilgan sonlar boosters, attitude markers va source-defined self-mentions kategoriyalarida AIC yuqoriroq ekanini koʻrsatadi.
Keyingi tushuntirish matni toʻgʻri yoʻnalishni ishlatgani uchun bu jadval terilishi yoki hisobot xatosi boʻlishi ehtimol.
Juftlangan Dizayn Statistik Tahlilga Toʻliq Oʻtkazilganmi?
Yoʻq. Tadqiqotning muhim kuchli tomoni 40 human–AI matn juftligi bir xil manba dissertatsiyadan kelganidir. Har bir AI conclusion bevosita mos keladigan human conclusion ga ega.
Shunga qaramay, statistik taqqoslashda Mann–Whitney U va Welch t-test ishlatilgan. Bular mustaqil namuna testlari boʻlib, thesis-level pairing ma’lumotini bevosita ishlatmaydi.
Shu sababli paired t-test yoki Wilcoxon signed-rank kabi juftlangan testlar bilan qayta tahlil natijalarning statistik barqarorligini yaxshiroq baholashi mumkin.
Ayniqsa hedges uchun turli testlar turlicha ahamiyatlilik natijalarini berishi bu qayta tahlilni muhim qiladi.
Tadqiqot Usuli va Natijalari
Korpus tuzilishi
Tadqiqot 40 human-written va 40 AI-generated General Conclusion dan iborat 40 ta juftlangan matn juftligidan foydalangan.
Inson korpusining manbasi
Ingliz tilida yozilgan, Applied Linguistics yoki yaqin sohadagi va Jazoir universitetlaridan ochiq kirishdagi doktorlik dissertatsiyalari tanlangan.
AI ishlab chiqarishi
Har bir dissertatsiyaning asl General Conclusion boʻlimi olib tashlangan; kirish, adabiyot, usul, natijalar va discussion kabi boshqa boʻlimlar Gemini 3 Flash Preview modeliga berilgan.
Prompt nazorati
40 ta dissertatsiyaning barchasida bir xil, ataylab sodda prompt ishlatilgan. Prompt modeldan stance yoki muayyan akademik uslubni maxsus qoʻllashni soʻramagan.
Analitik doira
Hylandning stance modeliga koʻra hedges, boosters, attitude markers va self-mentions tahlil qilingan.
Normallashtirish
Stance-marker chastotalari korpus uzunligidagi farqni kamaytirish uchun 1.000 soʻzga normallashtirilgan.
Statistika
Mann–Whitney U, Welch t-test va log-likelihood ishlatilgan. Dizayn juftlangan boʻlsa-da, dastlabki ikki test pairing ni bevosita baholamaydi.
Asosiy stance natijalari
| Kategoriya | Inson / 1.000 | AI / 1.000 | Eng ehtiyotkor talqin |
|---|---|---|---|
| Hedges | 20,69 | 17,60 | Inson yuqoriroq; testlar ahamiyatlilik boʻyicha mos kelmaydi |
| Boosters | 15,41 | 23,29 | AI aniq darajada yuqoriroq |
| Attitude markers | 10,77 | 11,10 | Aniq farq yoʻq |
| Self-mentions | 502,74 | 603,18 | Manba hisobi tasdiqlanmasdan ishlatilmasligi kerak |
Birinchi shaxs muallif koʻrinishi
Inson matnlari 3,35 first-person pronoun/1.000, AI matnlari 1,13/1.000 koʻrsatadi.
Ritorik qoliplar
AI “in conclusion”, “this study...” va “future research” kabi standardized academic expressions ga koʻproq murojaat qilgan.
Leksik natija
Manbadagi TTR jadvallari AI uchun yuqoriroq lexical-variety qiymatlarini bersa-da, keyword va bundle tahlillari inson yozuvi koʻproq context-specific ekanini koʻrsatadi. Bu ikki xususiyat bir-biridan ajratilishi kerak.
Sentence complexity
Inson xulosalari oʻrtacha 26,4 soʻzli, AI xulosalari esa 23,2 soʻzli gaplardan foydalangan.
Passive voice
Inson korpusida passive constructions 12,84/1.000, AI korpusida 6,23/1.000 deb qayd etilgan.
Tadqiqot qoʻllab-quvvatlaydigan natijalar
Ushbu ma’lumotlar toʻplamida AI conclusion lari inson conclusion laridan qisqaroq. AI boosters ni zichroq ishlatadi. Attitude-marker ishlatilishida aniq farq yoʻq. Inson mualliflari birinchi shaxs authorial presence ni koʻproq ishlatadilar. AI koʻproq standardized conclusion formula va generic academic phrasing koʻrsatadi. Inson matnlari esa tadqiqotning haqiqiy kontekstiga oid soʻzlarni tez-tez ishlatadi.
Tadqiqot qoʻllab-quvvatlamaydigan natijalar
Barcha sun’iy intellekt modellari insonlardan qat’iyroq yozadi deb boʻlmaydi. AI universal ravishda pastroq lexical diversity ga ega degan xulosa ushbu tadqiqotdan chiqarilmaydi. Self-mention 603/1.000 darajasida ekani mustaqil ravishda tasdiqlanmagan. Inson va AI akademik yozish qobiliyatining umumiy sifat reytingi tuzilmagan. Tadqiqot faqat bitta model, bitta standart prompt, muayyan fan va Jazoir universitetlaridan olingan 40 ta dissertatsiya bilan cheklangan.
Manba va Usul Haqida Izoh
Asl tadqiqot:Constructing Academic Voice: A Corpus-Based Comparison of Human- and AI-Generated Doctoral Thesis Conclusions
Muallif: Dhaya Eddine Ayachi.
PDF dagi muassasa: Mohammed Seddik Ben Yahia University, Faculty of Letters and Languages, Department of English.
Platforma: SSRN.
SSRN nashr sanasi: 10 iyun 2026.
SSRN DOI: 10.2139/ssrn.6911006.
Manba turi: 36 sahifalik preprint research paper.
Taqriz holati: Preprint not peer reviewed.
Litsenziya: All rights reserved; no reuse allowed without permission.
Asosiy AI modeli: Google Gemini 3 Flash Preview.
Korpus: 40 juftlangan human–AI General Conclusion juftligi.
Nazariy doira: Hylandning stance modeli.
Tahlil vositalari: Python; NLTK; SciPy; regex asosidagi marker skaneri; Mann–Whitney U, Welch t-test va log-likelihood.
Asosiy cheklovlar: Bitta LLM va bitta prompt ishlatilishi; human korpusi bitta fan va mamlakat konteksti bilan cheklangani; inson va AI matn uzunliklarining jiddiy farqlanishi; juftlangan dizaynga qaramay mustaqil namuna testlarining ishlatilishi; self-mention kategoriyasidagi tushuntirib boʻlmaydigan yuqori chastotalar; ayrim rhetorical-move tahlillari normallashtirilmagan xom sonlarga tayanishi; Table 2 dagi direction yorliqlaridagi xatolar; abstract dagi lexical-diversity talqini bilan TTR natijalarining zidligi.
Verianla bayon tamoyili: Ushbu mazmun manba preprintning toʻliq matn tarjimasi emas. Korpus dizayni, stance-marker natijalari, phraseological topilmalar va manba ichidagi metodologik muammolar saqlangan holda mustaqil va tanqidiy oʻquv tuzilmasi yaratilgan. Manbadagi conclusion matnlari va jadvallar mexanik tarzda qayta ishlatilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan