

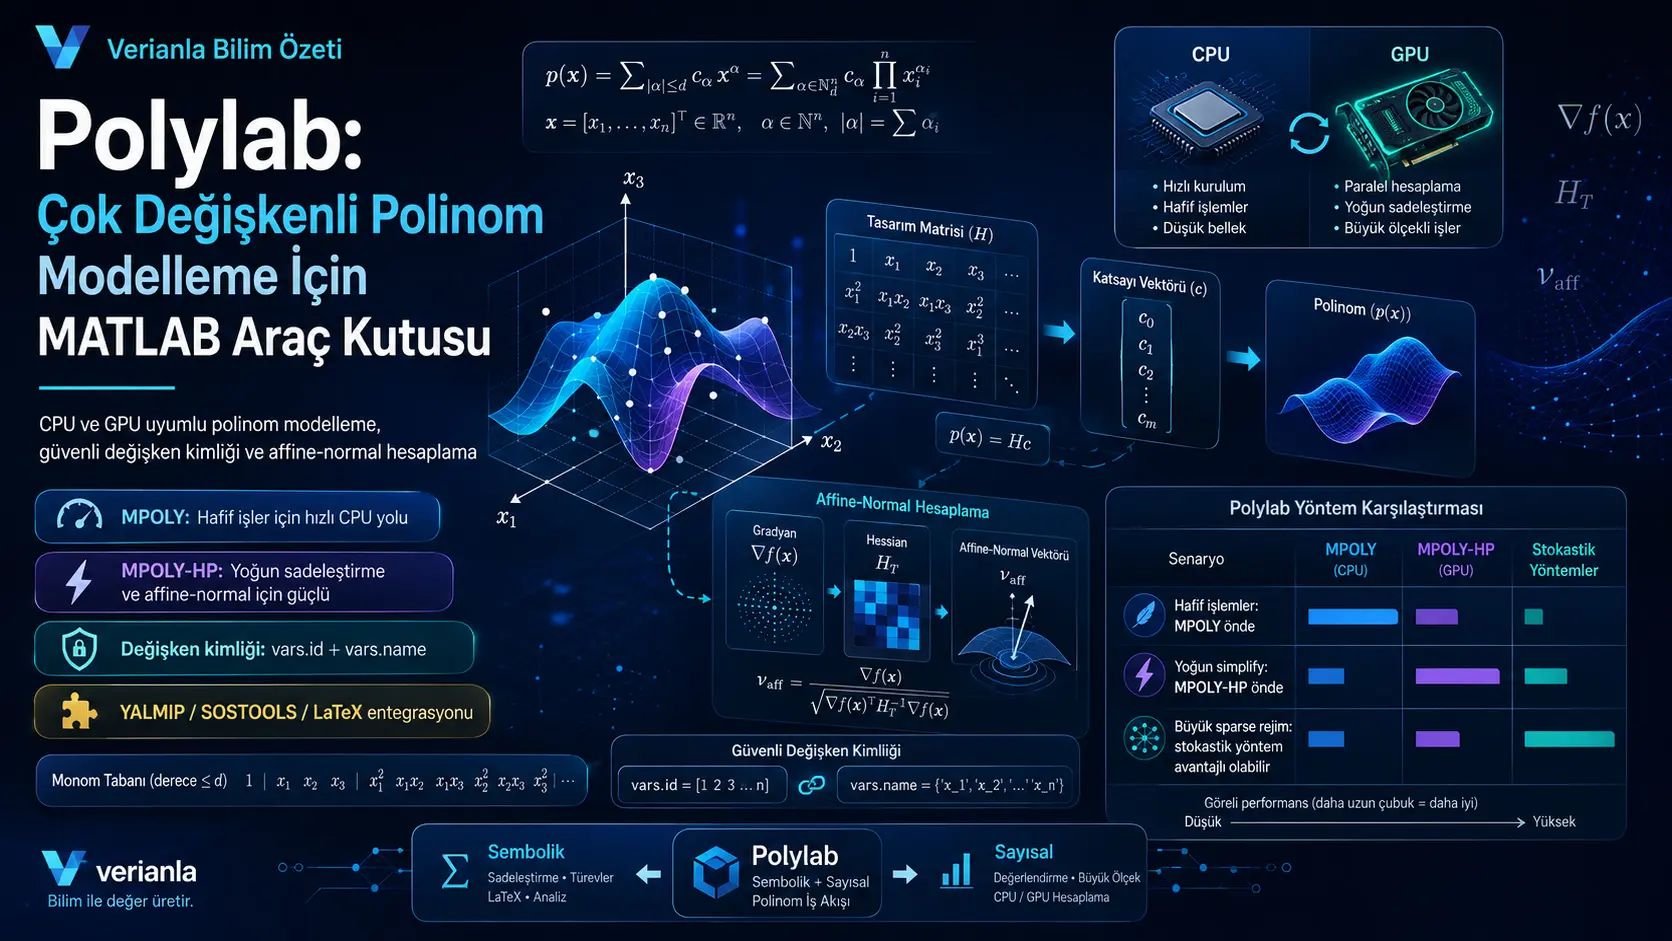
Polylab ni kisanduku cha zana cha kiishara-kihesabu kinachounganisha, chini ya modeli moja ya kitu, uundaji wa polinomu za vigeu vingi ndani ya MATLAB, utoaji wa vihisishi, urahisishaji, tathmini na uhamishaji kati ya backend zinazolenga CPU na GPU. Utafiti umechunguza backend tatu zinazooana—MPOLY, MPOLY_GPU na MPOLY_HP—na umeeleza kwa kina hasa utambulisho wazi wa vigeu ulioanzishwa katika Polylab 3.0 pamoja na ukokotoaji wa mwelekeo wa affine-normal ulioongezwa katika Polylab 3.1. Majaribio yanaonyesha kuwa kwa shughuli ndogo na shirikishi MPOLY mara nyingi huwa na gharama ya ziada ya chini zaidi, ilhali katika urahisishaji mzito na ukokotoaji wa affine-normal wa ukubwa wa kati hadi mkubwa MPOLY-HP inaweza kutoa faida dhahiri. Hata hivyo, matokeo yalipatikana chini ya maunzi maalumu, toleo la MATLAB, miundo ya polinomu na vigezo vilivyochaguliwa vya ulinganishi; hivyo hayapaswi kufasiriwa kama uthibitisho wa ubora wa GPU kwa kila tatizo la polinomu.
Mojawapo ya ubunifu muhimu zaidi wa usanifu wa programu katika utafiti huu ni kufanya vigeu viwe na utambulisho wazi kupitia taarifa za vars.id na vars.name badala ya kuvitofautisha kwa nafasi zao pekee katika matriki ya vipeo. Kwa njia hii, hatari ya vigeu kuoanisha na safu zisizo sahihi inapunguzwa wakati polinomu zilizoundwa nyakati tofauti au katika nafasi tofauti za vigeu zinaunganishwa.
Polylab 3.1 pia inaleta uhusiano kati ya jiometri tofauti ya affine na uboreshaji wa polinomu katika tabaka la programu. Kiolesura cha affineNormalDirection kinaunga mkono mbinu ya ad inayotegemea utoaji wa vihisishi kiotomatiki, mbinu kamili isiyotegemea matriki ya log-determinant MF-logDet-Exact na mbinu ya MF-logDet-Stochastic inayotumia ukadiriaji wa stochastic wa trace.
Polylab inalenga kutatua tatizo gani?
Polinomu za vigeu vingi ni lugha ya kawaida ya uundaji modeli katika uboreshaji, udhibiti, jiometri ya kialjebra na hisabati ya kikokotozi. Kwa upande wa programu, changamoto ni kwamba vitu hivi si vya kiishara pekee wala vya nambari pekee. Mtumiaji anaweza kutaka kwa wakati mmoja kuhifadhi miundo ya vigawo na vipeo, kufanya kazi na matriki za polinomu, kupata vihisishi, kutathmini katika nukta ya nambari, kuhamia kwenye programu nyingine za uboreshaji na kutumia ukokotoaji wa GPU inapohitajika.
Badala ya kugawanya mahitaji haya katika zana tofauti, Polylab inalenga kuyaunganisha chini ya kitu kimoja cha polinomu. Utafiti unafafanua madarasa makuu matatu:
- MPOLY: Utekelezaji rejea wa CPU na msingi wa kimaana wa kisanduku cha zana.
- MPOLY_GPU: Utekelezaji wa zamani wa GPU unaohifadhi kiolesura cha msingi.
- MPOLY_HP: Utekelezaji unaolenga GPU uliotengenezwa hasa kwa urahisishaji, uzidishaji, shughuli za reduction na ukokotoaji wa affine-normal.
Kwa nini utambulisho wa kigeu ni muhimu?
Njia mojawapo ya kawaida ya kuwakilisha polinomu kwenye kompyuta ni kuhifadhi kila monomu kwa kigawo na mstari wa vipeo. Lakini maneno mawili yanapoundwa kwa kujitegemea, maana ya kimahali ya “kigeu cha kwanza” na “kigeu cha pili” pekee si salama. Safu ileile katika vitu viwili tofauti inaweza kuwakilisha vigeu tofauti vya kihisabati.
Polylab 3.0 inashughulikia tatizo hili kwa kutoa sehemu mbili za metadata kwa kila kigeu: vars.id huhifadhi kitambulishi cha ndani na thabiti, na vars.name huhifadhi jina linalosomeka na mtumiaji. Vitu vinapounganishwa, nafasi za vigeu kwanza huwekwa sambamba kisha shughuli ya kialjebra hufanywa.
Katika mfano wa utafiti, polinomu mbili zenye vigeu x na y vilivyoundwa kwa kujitegemea zinapojumlishwa, nafasi ya matokeo huhifadhiwa kama {x1, x2, y1, y2} . Ubunifu hapa si majina mazuri zaidi ya vigeu pekee; lengo kuu ni kuzuia makosa ya kimya ya uoanishaji wa vigeu wakati sehemu tofauti za modeli zinaunganishwa.
Kiolesura cha polinomu kilicho karibu na tabia ya MATLAB
Polylab inaendeleza tofauti inayofahamika kwa watumiaji wa MATLAB kati ya shughuli za kipengele kwa kipengele na shughuli za matriki. times na power hufanya kazi kwa kipengele, ilhali mtimes na mpower hutekeleza aljebra ya matriki. sum na prod hufanya shughuli za reduction katika mwelekeo wa vipimo vya safu za polinomu.
Kwa mfano
\[ A(x)= \begin{bmatrix} x_1 & 1\\ 0 & x_2 \end{bmatrix} \]
mraba wa kipengele kwa kipengele na mraba wa matriki si kitu kimoja kwa:
\[ A(x)^{\circ 2}= \begin{bmatrix} x_1^2 & 1\\ 0 & x_2^2 \end{bmatrix}, \qquad A(x)^2= \begin{bmatrix} x_1^2 & x_1+x_2\\ 0 & x_2^2 \end{bmatrix}. \]
Tofauti hii inaonyesha kuwa Polylab si tabaka la kuonyesha tu maneno ya polinomu, bali ni miundombinu ya ukokotoaji iliyolinganishwa na semantiki ya matriki ya MATLAB.
Kihisishi, Jacobian, Hessian na tathmini
Kwa polinomu skala, diff(p,i) hutoa kihisishi kwa kigeu kilichochaguliwa, na jacobian(p) hutoa gradient; kwa kutumia Jacobian tena, safu za polinomu zinazofanana na Hessian zinaweza kupatikana.
Katika utafiti, polinomu ifuatayo imetumika
\[ p(x_1,x_2,x_3)=x_1^3+2x_1x_2-x_3+1 \]
kwa polinomu hiyo
\[ \frac{\partial p}{\partial x_1}=3x_1^2+2x_2 \]
na
\[ \nabla p(x)= \left[ 3x_1^2+2x_2,\; 2x_1,\; -1 \right] \]
hupatikana. Matokeo ya tathmini katika nukta \(x=(1,2,3)\) ni \(p(1,2,3)=3\).
Ikiwa kernel iliyokusanywa ya mexeval kwa tathmini ya double precision inapatikana upande wa CPU, hali chaguomsingi ya auto hujaribu kwanza njia ya MEX na, ikiwa haiwezekani, hurudi kwenye utekelezaji wa MATLAB. Mtumiaji anaweza kuchagua wazi hali za matlab, auto au mex .
Misingi ya polinomu na shughuli za uboreshaji zilizopangwa
monolist(n,d), huunda vekta ya safu ya monomu zote zenye vigeu \(n\) na shahada jumla isiyozidi \(d\). Kwa mfano, kwa vigeu vitatu na shahada ya pili, idadi ya monomu
\[ \binom{n+d}{d}= \binom{5}{2}=10 \]
huwa hivyo. Kipengele hiki kinaweza kutumika kama kijenzi cha msingi katika ukokotoaji wa ukaribu, mbinu za moment na modeli za uboreshaji zinazotegemea sums-of-squares (SOS).
quadprod huunda polinomu zilizopangwa za umbo \(b^\top Qb\) bila kuhitaji kuzifungua kwa mkono. Kazi ya transmatconvex pia huzalisha matriki zinazohitajika kwa ubadilishaji kati ya kuratibu za vigawo vya monomu za polinomu homogeneous na misingi iliyopangwa ya convex.
Ubadilishanaji wa data na LaTeX na mifumo mingine ya MATLAB
Madarasa yote makuu ya Polylab yanaunga mkono uhamishaji kwenda LaTeX, huku MPOLY.fromlatex ikiweza kuunda tena polinomu upande wa CPU. Hivyo, usemi unaweza kuhamishwa katika mazingira ya ripoti au makala kisha kurejeshwa tena kuwa kitu cha Polylab.
Kazi za ubadilishaji wa pande mbili zinatolewa kwa YALMIP. Kwa SOSTOOLS, toleo la sasa lina uhamishaji kutoka Polylab kwenda SOSTOOLS, lakini ubadilishaji wa kurudi haujatekelezwa. Hakuna adapta maalumu ya moja kwa moja kwa MATLAB Symbolic Math Toolbox; utafiti unaonyesha daraja jepesi linalotegemea kubadilisha maandishi ya LaTeX.
Mwelekeo wa affine-normal ni nini?
Mojawapo ya ubunifu wa kiufundi zaidi katika Polylab 3.1 ni ukokotoaji wa mwelekeo wa affine-normal. Kwa level set ya kawaida
\[ \Sigma_c=\{x\in\mathbb{R}^{n}:f(x)=c\}, \qquad \nabla f(x)\neq 0 \]
normal ya Euclidean huamuliwa kwa taarifa ya kihisishi cha kwanza pekee, huku affine normal ikitumia pia muundo wa daraja la pili na la tatu wa jiometri ya eneo hilo.
Katika nukta fulani
\[ g=\nabla f(x), \qquad e=\frac{g}{\|g\|} \]
fafanua na uchague fremu orthonormal ambayo mhimili wake wa mwisho umelinganishwa na mwelekeo wa gradient:
\[ Q=[Q_T,e] \]
Kizuizi cha Hessian tangential na neno mchanganyiko
\[ H_T=Q_T^\top\nabla^2 f(x)Q_T, \qquad h=Q_T^\top\nabla^2f(x)e \]
vina umbo hilo.
Kipengele cha \(i\) cha marekebisho ya log-determinant
\[ a_i= \operatorname{tr} \left( H_T^{-1} \frac{\partial H_T}{\partial t_i} \right), \qquad i=1,\ldots,n-1 \]
hutolewa hivyo. Mwelekeo wa affine-normal unaorudishwa na Polylab
\[ \nu_{\mathrm{aff}} = Q \begin{bmatrix} \tau\\ -1 \end{bmatrix}, \qquad \tau= H_T^{-1} \left( h- \frac{\|g\|}{n+1}a \right) \]
huonyeshwa kwa umbo hilo.
Majukumu ya mbinu tatu za affine-normal si sawa
AD, kwa kuwa huhesabu moja kwa moja kupitia vihisishi vinavyorudiwa vya polinomu, hutumika kama njia rejea inayoeleweka. MF-logDet-Exact, ni mbinu isiyotegemea matriki inayolenga kukokotoa marekebisho yale yale bila kuunda wazi tensor kamili ya daraja la tatu. MF-logDet-Stochastic hukadiria ukokotoaji wa trace kwa makadirio ya stochastic ya aina ya Hutchinson na vitatuzi vya mstari vya Krylov.
Kwa hiyo, mbinu ya stochastic si “mbinu ya haraka zaidi katika kila hali”. Majaribio ya utafiti yenyewe yanaonyesha kuwa mbinu hiyo huwa na faida tu wakati ukubwa wa tatizo, muundo wa sparsity na vigezo vya approximation vinafaa.
Matokeo ya utendaji yanaonyesha nini?
Katika shughuli nyepesi za kernel, matokeo kwa ujumla yanaipendelea CPU. Kwa mfano, muda wa kuunda monolist ni sekunde 0,0023 kwa MPOLY, 0,1014 kwa MPOLY_GPU na 0,0972 kwa MPOLY_HP. Katika ukokotoaji wa Jacobian, MPOLY kwa sekunde 0,0056 ni haraka kuliko backend zote mbili zinazolenga GPU. Katika shughuli ya eval kwenye nukta moja, MPOLY_HP kwa sekunde 0,0006 ni haraka kuliko matokeo ya sekunde 0,0010 ya MPOLY.
Tofauti kuu huonekana katika mzigo wa kazi wa simplify ambapo monomu zilezile zinapaswa kuunganishwa tena na tena baada ya upanuzi mkubwa. Katika benchmark ya vigeu vitano yenye monomu msingi 126, njia ya CPU ilichukua takribani sekunde 6,13, MPOLY_GPU takribani 0,162 na MPOLY_HP takribani 0,158. Hii ni sawa na kasi ya takribani mara 38,8 kwa MPOLY_HP chini ya hali zilezile za majaribio.
Kwa nini mbinu exact inaonekana bora katika usahihi wa affine-normal?
Katika jaribio wakilishi la sparse quartic lenye vigeu sita na monomu 17, AD ilipochukuliwa kama rejea, kosa la mwelekeo wa unit wa MF-logDet-Exact kwenye MPOLY liliripotiwa kuwa \(1{,}99\times10^{-8}\), huku tofauti ya pembe ikiwa \(1{,}21\times10^{-6}\) degree pekee. Muda wa utekelezaji ulikuwa sekunde 0,1093 kwa AD na sekunde 0,0068 kwa mbinu exact.
Katika mfano huohuo, AD kwenye MPOLY-HP ilichukua sekunde 0,0738, huku MF-logDet-Exact ikichukua 0,0021. Tofauti iliyoonekana kati ya backend katika matokeo ya single-seed ya mbinu ya stochastic ilitoweka katika jaribio la ziada lenye probe seed 10 tofauti: kwa backend zote mbili, kosa la wastani la mwelekeo lilikuwa \(0{,}0523\pm0{,}0229\), na pembe ya wastani \(2{,}99^\circ\pm1{,}31^\circ\).
Ugunduzi huu unaweka tofauti muhimu ya matumizi: kwa matatizo ya affine-normal ya ukubwa wa kati yanayohitaji usahihi wa juu, mbinu exact ndiyo chaguo chaguomsingi la kawaida la utafiti; mbinu ya stochastic ni chaguo la approximation linalolenga kupunguza gharama ya ukokotoaji katika matatizo makubwa zaidi yenye sparsity.
Mbinu ya stochastic ina faida katika hali gani?
Katika jaribio kubwa-sparse la utafiti, matatizo yenye ukubwa wa support 2 na idadi ya monomu \(m=3d\), kwa \(d=80\) hadi \(500\), yalijaribiwa. Hapa mbinu ya stochastic iliendeshwa hasa kwa vigezo vinavyolenga kasi: idadi ya probe \(q=1\), regularization \(5\times10^{-4}\), tolerance ya Krylov \(2\times10^{-2}\) na idadi ya juu ya iteration 6.
Kwa vigeu 260, mbinu exact ya MPOLY-HP ilichukua sekunde 1,141 na mbinu ya stochastic 0,225; kasi iliyoonekana ilikuwa takribani mara 5,07 . Kwa vigeu 500, kasi kwenye MPOLY-HP ilikuwa takribani mara 1,52. Mabadiliko haya yanaonyesha kwamba faida ya mbinu ya stochastic haihusiani na ukubwa wa tatizo pekee, bali pia na sparsity na mipangilio ya approximation.
Je, single precision huwa haraka kila wakati?
Hapana. Majaribio ya precision katika utafiti, hasa kwenye njia ya CPU, yanaonyesha kuwa single precision haitoi moja kwa moja faida ya kasi. Kwa mfano, shughuli ya affine-normal MF-logDet-Exact kwenye MPOLY ilichukua sekunde 0,0025 kwa double precision na 0,0076 kwa single precision. Kwa MPOLY-HP, shughuli hiyo hiyo ilichukua 0,0026 kwa double precision na 0,0020 kwa single precision.
Waandishi wanahusisha tabia hii na ukomavu wa njia za sasa za sparse na compatibility katika MATLAB, njia ya tathmini ya CPU inayosaidiwa na MEX, na muundo wa precision-specific kernel wa kisanduku cha zana. Kwa hiyo, hitimisho kwamba “single huwa haraka katika kila hali” haliungwi mkono na utafiti.
Uchaguzi wa backend kwa vitendo
| Hali ya matumizi | Backend inayopendekezwa na utafiti | Sababu |
|---|---|---|
| Uundaji modeli shirikishi, kuunda msingi wa monomu, Jacobian na aljebra ya matriki ndogo | MPOLY | Gharama ya ziada ya chini; njia ya haraka zaidi katika benchmark nyingi za kernel nyepesi. |
| Upanuzi mkubwa wa kiishara, simplify nzito, kuunganisha monomu mara kwa mara | MPOLY-HP | Njia za GPU-native reduction hutoa faida dhahiri katika semi kubwa za kati. |
| Ukokotoaji wa affine-normal wa ukubwa wa kati hadi mkubwa | MPOLY-HP | Faida ya GPU huonekana katika njia exact na, katika hali zinazofaa, njia za stochastic log-det. |
| Msimbo wa zamani wa GPU na uoanifu wa nyuma | MPOLY_GPU | Inahifadhiwa kama legacy backend; njia mpya yenye utendaji wa juu kwa kiasi kikubwa ni MPOLY-HP. |
Hitimisho kuu: Katika Polylab, uchaguzi sahihi wa backend si uamuzi wa jumla wa “CPU au GPU?”; unapaswa kufanywa kulingana na aina ya rejimu ya ukokotoaji ambamo shughuli ya polinomu ipo.
Nguvu za utafiti
- Hautoi orodha ya API pekee, bali pia mifano halisi ya matumizi ya MATLAB na matokeo yanayotarajiwa.
- Unalinganisha CPU na backend mbili zinazolenga GPU ndani ya familia ileile ya majaribio.
- Unatathmini shughuli nyepesi na shughuli za reduction-heavy kama rejimu tofauti za benchmark.
- Hautathmini mbinu ya stochastic kwa seed moja pekee, bali unatoa jaribio la uthabiti lenye probe seed 10.
- Seed za nasibu na vigezo vya msingi vimebainishwa katika script za benchmark.
- Unaongeza kazi mpya za affine-normal juu ya miundombinu iliyopo ya polinomu ambayo hapo awali imetumiwa katika matumizi tofauti ya utafiti.
Vikwazo vya utafiti ni vipi?
Benchmark zilifanywa kwenye jukwaa moja kuu la maunzi: MATLAB R2023b, Windows 10 Pro, Intel Core i9-12900K na NVIDIA GeForce RTX 4090. Kwa hiyo haijaonyeshwa kwamba uwiano uleule wa kasi utadumu kwenye usanifu tofauti wa GPU, matoleo ya MATLAB, mifumo ya uendeshaji au miundo ya data sparse.
Mifano ya utendaji iliyotumika katika utafiti inawakilisha familia maalumu za polinomu. Ingawa imeonyeshwa kuwa faida ya GPU hujitokeza hasa katika kazi za reduction-heavy na affine-geometric, ramani kamili ya utendaji kwa miundo yote ya polinomu haijatolewa.
Faida ya kasi ya mbinu ya stochastic affine-normal ni nyeti kwa vigezo vya approximation. Vigezo katika jaribio la crossover linalolenga kasi vinatofautiana sana na mipangilio ya probe 64 iliyotumika katika majedwali ya usahihi. Kwa hiyo kasi na usahihi wa mwelekeo si malengo yanayolingana moja kwa moja chini ya hali zilezile za benchmark.
Katika Polylab 3.1 hakuna adapta ya moja kwa moja kwa MATLAB Symbolic Math Toolbox wala ubadilishaji wa kurudi kutoka SOSTOOLS kwenda Polylab. Waandishi pia wanataja violesura vya tensor-derivative na precision-specific sparse kernel zilizopevuka zaidi kama maeneo ya maendeleo yajayo.
Utafiti unaunga mkono nini?
- Kwamba Polylab inaunganisha shughuli za polinomu zinazolenga CPU na GPU chini ya kiolesura cha pamoja cha MATLAB.
- Kwamba utambulisho wazi wa vigeu umeundwa ili kuruhusu polinomu zilizoundwa kwa kujitegemea kuwekwa sambamba kwa usalama.
- Kwamba MPOLY ina gharama ya ziada ya chini zaidi katika shughuli nyingi nyepesi zilizochunguzwa.
- Kwamba MPOLY-HP inaweza kutoa faida kubwa ya kasi katika jaribio la reduction-heavy simplify.
- Kwamba mbinu ya MF-logDet-Exact ilitoa mwelekeo ulio karibu sana na rejea ya AD katika jaribio wakilishi la usahihi wa affine-normal.
- Kwamba mbinu ya MF-logDet-Stochastic inaweza kutoa faida ya kasi katika baadhi ya rejimu kubwa za sparse.
Utafiti hauthibitishi nini?
- Hauthibitishi kwamba GPU ni haraka kuliko CPU katika shughuli zote za polinomu.
- Hauonyeshi kwamba MPOLY-HP itatoa uwiano uleule wa kasi kwenye kila maunzi na kila toleo la MATLAB.
- Hauonyeshi kwamba mbinu ya stochastic affine-normal ni haraka kuliko exact kwa kila ukubwa wa tatizo.
- Hauonyeshi kwamba matokeo ya benchmark yanaweza kujumlishwa kwa programu zote za hisabati ya kiishara.
- Haudai kwamba Polylab inachukua nafasi ya YALMIP, SOSTOOLS au Symbolic Math Toolbox; utafiti unaweka zana hizi kama mifumo inayokamilishana.
- Hauthibitishi kwamba kisanduku cha zana kitatoa suluhisho la haraka au sahihi zaidi kwa matatizo yote yanayowezekana ya uboreshaji katika ulimwengu halisi.
Hii ina maana gani kwa Uturuki?
Utafiti haujumuishi jaribio maalumu kwa Uturuki wala tathmini ya utendaji wa ndani. Hata hivyo, kwa vikundi vya vyuo vikuu na uhandisi vinavyotumia uboreshaji wa polinomu, udhibiti, uundaji modeli wa kialjebra na MATLAB kwa utafiti, modeli ya pamoja ya data ya CPU/GPU ya Polylab inaweza kutoa miundombinu ya utafiti yenye manufaa. Tathmini hii haimaanishi kwamba utafiti umethibitisha moja kwa moja utendaji nchini Uturuki; benchmark tofauti kwa GPU mbalimbali, matoleo ya MATLAB na familia za matatizo zinahitajika katika miundombinu ya utafiti ya ndani.
Mbinu na Matokeo ya Utafiti
Mazingira ya majaribio
| Kipengee | Thamani iliyoripotiwa katika utafiti |
|---|---|
| MATLAB | R2023b |
| Mfumo wa uendeshaji | Windows 10 Pro, build 26200 |
| CPU | 12th Gen Intel Core i9-12900K, 24 logical processor |
| GPU | NVIDIA GeForce RTX 4090 |
| Affine exact regularization | \(10^{-8}\) |
| Idadi ya stochastic probe inayolenga usahihi | 64 |
| Kikomo cha iteration za Krylov kinacholenga usahihi | 80 |
Shughuli nyepesi za kernel
| Shughuli | MPOLY (s) | MPOLY-GPU (s) | MPOLY-HP (s) | Haraka zaidi |
|---|---|---|---|---|
| Kuunda monolist | 0,0023 | 0,1014 | 0,0972 | MPOLY |
| simplify baada ya upanuzi wa ujazo | 0,0954 | 0,0431 | 0,0134 | MPOLY-HP |
| Elementwise times | 0,0050 | 0,0261 | 0,0172 | MPOLY |
| Matrix mtimes | 0,0149 | 0,0207 | 0,0209 | MPOLY |
| Matrix mpower | 0,0051 | 0,0187 | 0,0149 | MPOLY |
| Reduction sum | 0,0028 | 0,0077 | 0,0081 | MPOLY |
| Reduction prod | 0,0013 | 0,0038 | 0,0051 | MPOLY |
| Jacobian | 0,0056 | 0,0172 | 0,0157 | MPOLY |
| eval katika nukta moja | 0,0010 | 0,0022 | 0,0006 | MPOLY-HP |
Ujumbe mkuu wa jedwali ni kwamba backend zinazolenga GPU hazitoi faida kiotomatiki katika shughuli ndogo. Faida za mapema zinazoonekana zaidi za MPOLY-HP ziko katika urahisishaji baada ya upanuzi wa ujazo na tathmini katika nukta moja.
Urahisishaji wa reduction-heavy
Katika familia ya majaribio
\[ p_d(x)=\sum_{|\alpha|\le d}x^\alpha, \qquad f_d(x)=\operatorname{simplify}\left(p_d(x)^3\right) \]
ilitumika. Kwa polinomu za vigeu vitano, \(d\in\{2,3,4\}\), na monomu msingi 21, 56 na 126 zilijaribiwa.
Kwa monomu 56, kasi takriban ilikuwa 6,83× kwa MPOLY-GPU na 11,44× kwa MPOLY-HP. Kwa monomu 126, MPOLY ilifikia sekunde 6,13, huku njia zote mbili za GPU zikibaki karibu na sekunde 0,16. Matokeo yenye nguvu zaidi ya GPU katika utafiti yanatoka katika rejimu hii ya reduction-heavy.
Ulinganisho wa mbinu za affine-normal
| Backend | Mbinu | Muda (s) | Kosa la mwelekeo wa unit dhidi ya AD | Tofauti ya pembe |
|---|---|---|---|---|
| MPOLY | AD | 0,1093 | 0 | 0° |
| MPOLY | MF-logDet-Exact | 0,0068 | \(1,99\times10^{-8}\) | \(1,21\times10^{-6}\)° |
| MPOLY | MF-logDet-Stochastic | 0,0266 | 0,1088 | 6,24° |
| MPOLY-HP | AD | 0,0738 | 0 | 0° |
| MPOLY-HP | MF-logDet-Exact | 0,0021 | \(1,99\times10^{-8}\) | \(1,21\times10^{-6}\)° |
| MPOLY-HP | MF-logDet-Stochastic | 0,0284 | 0,0290 | 1,66° |
Katika mfano huu wa fixed-seed, mbinu exact iko karibu sana na rejea ya AD na imekokotolewa kwa muda mfupi sana kuliko AD. Hata hivyo, tofauti za pembe za single-seed za mbinu ya stochastic hazipaswi kufasiriwa kama tofauti ya backend; jaribio la seed 10 linaonyesha kwamba tofauti hiyo kwa kiasi kikubwa inatokana na probe realization.
Uthabiti wa stochastic kwa probe seed 10
| Backend | Muda wa wastani | Kosa la wastani la unit ± std | Pembe ya wastani ± std |
|---|---|---|---|
| MPOLY | 0,0250 s | 0,0523 ± 0,0229 | 2,99° ± 1,31° |
| MPOLY-HP | 0,0238 s | 0,0523 ± 0,0229 | 2,99° ± 1,31° |
Stochastic crossover katika rejimu kubwa ya sparse
| Ukubwa \(d\) | Monomu \(m\) | MPOLY exact/stochastic (s) | Kasi ya MPOLY | MPOLY-HP exact/stochastic (s) | Kasi ya MPOLY-HP |
|---|---|---|---|---|---|
| 80 | 240 | 0,139 / 0,128 | 1,09× | 0,203 / 0,111 | 1,84× |
| 260 | 780 | 1,453 / 1,295 | 1,12× | 1,141 / 0,225 | 5,07× |
| 500 | 1500 | 5,285 / 4,776 | 1,11× | 0,788 / 0,518 | 1,52× |
Matokeo ya stochastic katika jedwali hili yalipatikana kwa mipangilio ya approximation inayolenga kasi. Kwa hiyo hayapaswi kufasiriwa moja kwa moja kama hali zilezile za majaribio na matokeo ya probe 64 yanayolenga usahihi.
Matokeo ya precision
Utafiti unaonyesha wazi kwamba uhusiano kati ya single na double precision hubadilika kulingana na aina ya shughuli. Katika jaribio la MPOLY simplify, double ilichukua sekunde 0,0419 na single 0,0051; kwa MPOLY affine MF-logDet-Exact, double ilichukua 0,0025 na single 0,0076. Katika jaribio la MPOLY-HP affine exact, double ilipimwa kuwa 0,0026 na single 0,0020.
Kikomo cha tafsiri ya kimethodolojia: Thamani hizi zinahusu toleo la msimbo lililotumika katika utafiti na mchanganyiko wa MATLAB R2023b, RTX 4090 na i9-12900K. Utafiti haujajaribu kama utendaji wa precision katika mazingira mengine ya MATLAB/GPU utaonyesha mpangilio huohuo.
Maelezo ya Chanzo na Mbinu
Jina kamili asilia la utafiti: Polylab: A MATLAB Toolbox for Multivariate Polynomial Modeling
Waandishi: Yi-Shuai Niu; Shing-Tung Yau.
Mpangilio wa waandishi: Yi-Shuai Niu → Shing-Tung Yau.
Mchango sawa/mwandishi wa kwanza sawa: Toleo lililochunguzwa halina tamko wazi la mchango sawa.
Mwandishi wa mawasiliano: Makala inatoa taarifa za mawasiliano kwa waandishi wote wawili, lakini katika toleo lililochunguzwa hakuna mwandishi mmoja aliyetambuliwa wazi kama “corresponding author”.
Taasisi: Yi-Shuai Niu — Beijing Institute of Mathematical Sciences and Applications (BIMSA), China. Shing-Tung Yau — Yau Mathematical Sciences Center, Tsinghua University, China; Beijing Institute of Mathematical Sciences and Applications (BIMSA), China.
Aina ya chanzo: Preprint inayohifadhi kumbukumbu ya kazi ya programu ya kisayansi / programu ya kihisabati.
Hali ya mapitio ya kitaalamu:Utafiti huu ni preprint na haupaswi kutathminiwa kama makala ya jarida iliyopitia mapitio ya kitaalamu.
Jukwaa: arXiv.
arXiv: 2604.06575v2.
DOI: 10.48550/arXiv.2604.06575. DOI hii ni DOI ya rekodi ya arXiv/DataCite; haimaanishi kwamba kuna DOI tofauti ya jarida lililopitia mapitio ya kitaalamu.
Historia ya uchapishaji: v1 — 8 Aprili 2026; v2 — 9 Aprili 2026.
Jarida: Toleo lililochunguzwa halitaji utambulisho wa jarida lililochapishwa na kupitiwa kitaalamu.
Mchapishaji: Hakuna taarifa tofauti ya mchapishaji wa jarida kwa preprint iliyochunguzwa.
Rekodi rasmi ya uchapishaji: arXiv:2604.06575.
Leseni: arXiv non-exclusive distribution license. Leseni hii haijatathminiwa kama leseni ya jumla ya matumizi tena kama CC BY. Kwa hiyo SVG za Verianla si nakala za moja kwa moja za vielelezo vya chanzo.
Ufadhili: Kwa Yi-Shuai Niu, National Natural Science Foundation of China, Grant No. 42450242 na Beijing Overseas High-Level Talent Program; pia msaada wa kitaasisi wa BIMSA na Yau Mathematical Sciences Center umetajwa.
Upatikanaji wa data/msimbo: Utafiti unasema majaribio yalizalishwa kutoka kwenye repository scripts na kwamba msimbo utawekwa wazi baada ya uchapishaji. Katika toleo lililochunguzwa hakuna tamko tofauti na kamili la upatikanaji wa data.
Mgongano wa maslahi: Hakuna tamko tofauti la mgongano wa maslahi lililogunduliwa katika toleo lililochunguzwa.
CRediT/michango ya waandishi: Katika toleo lililochunguzwa hakuna jedwali au tamko tofauti la michango ya CRediT.
Upeo wa maudhui ya kisayansi: Vipengele vya programu, milinganyo, thamani za benchmark na mipaka ya tafsiri katika makala hii ya Verianla vinategemea utafiti uliopakiwa wenye kurasa 21. Uthibitishaji wa nje ulitumika tu kwa sehemu za kibibliografia kama kitambulisho cha arXiv, tarehe ya toleo, DOI na leseni; hakuna matokeo mapya ya majaribio au algoriti yaliyoongezwa kutoka vyanzo vya nje.
Kikomo kikuu: Vipimo vya utendaji vilifanywa kwa familia maalumu za benchmark na mazingira moja kuu ya maunzi/programu. Matokeo hayaonyeshi kwamba Polylab itatoa uwiano uleule wa utendaji kwa matatizo yote, maunzi yote na matoleo yote ya MATLAB.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *