

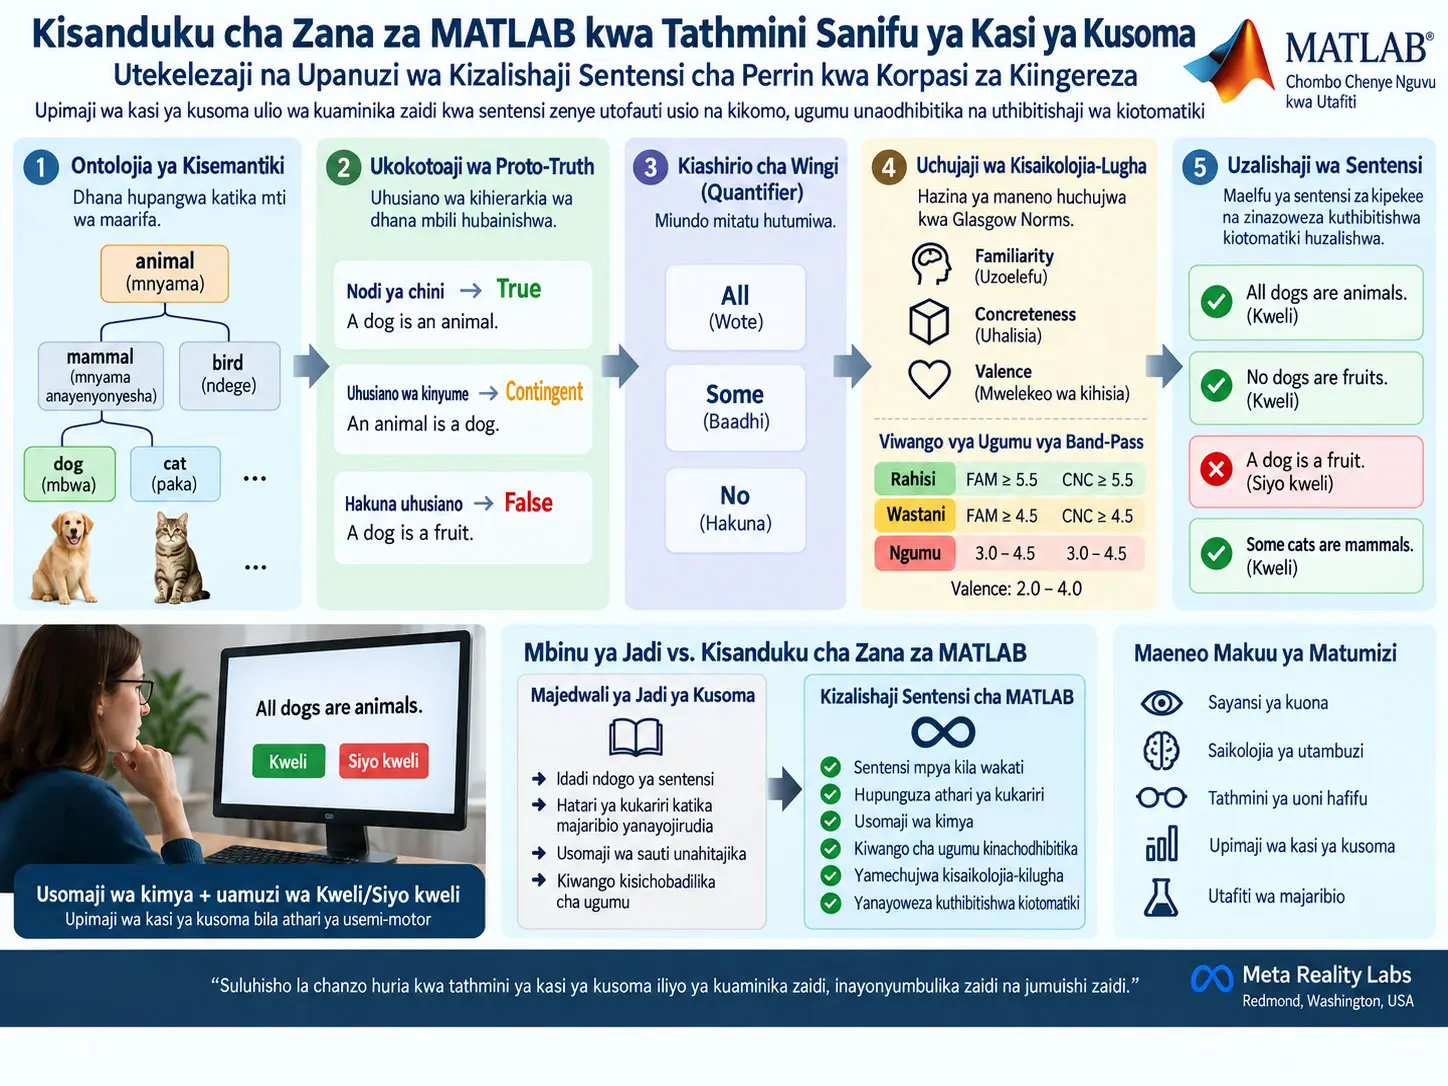
Proto-truth, katika utafiti huu ni uainishaji wa uhusiano wa kisemantiki kati ya dhana mbili zinazotumiwa katika sentensi kuwa “kweli”, “sharti” au “siyo kweli” kabla ya kubadilishwa kuwa lugha asilia, kwa kuzingatia nafasi za dhana hizo katika mti wa ontolojia. Kisanduku cha zana za MATLAB kilichotengenezwa na Daniel P. Spiegel na Romain Bachy hutumia mantiki hii kuzalisha maelfu ya sentensi za kipekee zinazoweza kuthibitishwa kiotomatiki kwa ajili ya kupima kasi ya kusoma.
Msingi wa utafiti ni kwamba majedwali sanifu ya kusoma kama MNREAD yanaweza kuleta athari ya kukariri katika majaribio yanayorudiwa kwa sababu ya idadi ndogo ya sentensi, na mbinu za kusoma kwa sauti zinaweza kuchanganya michakato ya usemi na mwendo katika kasi ya uchakataji wa taarifa za kuona. Kisanduku cha zana kinaunga mkono paradigma ya kipimo inayotegemea kusoma kimya na uamuzi wa True/False ili kupunguza matatizo haya.
Mfumo unabadilisha mkabala wa ontolojia ya kisemantiki wa Perrin, Paillé na Baccino wa mwaka 2014 kwa Kiingereza. Aidha, kwa kutumia Glasgow Norms, hazina ya maneno huchujwa kulingana na vigezo vya familiarity, concreteness na valence; mifumo ya ziada ya usalama hutumiwa kwa nomino zisizohesabika za Kiingereza, wingi usiofuata kanuni, homonimu na utata wa kuvuka makundi unaotokana na maarifa ya ulimwengu halisi.
Ubunifu mwingine muhimu wa kisanduku cha zana ni uchujaji wa kisaikolojia-lugha wa band-pass, unaoweka mipaka ya juu na chini badala ya kutumia kizingiti cha chini pekee. Hivyo, vikundi vya sentensi rahisi, za kati na ngumu vinaweza kuundwa, na mfumo unaweza kutumiwa si tu kupima kasi ya juu ya kusoma bali pia katika majaribio ya mzigo wa utambuzi unaodhibitiwa.
Kwa nini zana mpya ya kupima kasi ya kusoma inahitajika?
Kasi ya kusoma ni kipimo muhimu cha utendaji katika sayansi ya kuona, oftalmolojia ya kliniki na saikolojia ya majaribio.
Hata hivyo, majedwali ya kawaida ya kusoma yaliyochapishwa yana matatizo mawili ya msingi.
- Idadi ndogo ya sentensi inaweza kusababisha athari ya kukariri katika majaribio yanayorudiwa.
- Kusoma kwa sauti hupima, pamoja na kasi ya kusoma kwa kuona, michakato ya usemi na upangaji wa mwendo.
Kwa hiyo, utendaji unaopimwa huenda usiwakilishe tu uwezo wa kuona au wa utambuzi katika kusoma.
Kisanduku Hiki cha Zana za MATLAB Kinatofautianaje na Majedwali ya Kawaida ya Kusoma?
Badala ya kutumia orodha isiyobadilika ya sentensi, kisanduku cha zana huzalisha sentensi mpya kila mara kupitia ontolojia ya kisemantiki na kanuni za kimantiki; pia kinalenga kupunguza kuingilia kwa utendaji wa usemi-mwendo katika kipimo kwa kutumia paradigma ya kusoma kimya inayotegemea uamuzi wa kweli/siyo kweli.
Kutoka mkabala wa Crossland hadi mkabala wa Perrin
Crossland, Legge na Dakin mwaka 2008 walitengeneza mkabala wa kuzalisha sentensi kiotomatiki kwa kuchanganya kwa nasibu quantifier, kitu na sifa.
Ingawa mfumo huu ulikuwa na faida katika kuzalisha sentensi nyingi, baadhi ya mchanganyiko ungeweza kuwa na utata wa kisemantiki.
Perrin, Paillé na Baccino mwaka 2014 walijaribu kutatua tatizo hili kwa ontolojia ya kisemantiki. Dhana ziliwekwa ndani ya muundo wa mti, na uhusiano kati ya dhana ulitolewa moja kwa moja na mfumo kutoka katika nafasi ya kiontolojia.
Ontolojia inafanyaje kazi kama ramani ya maarifa?
Mfumo unawakilisha dhana katika mti wenye mzizi kama ifuatavyo:
\[ O=(N,E,r) \]
Hapa:
- \(N\), huwakilisha nodi,
- \(E\), huwakilisha miunganisho kati ya nodi,
- \(r\), huwakilisha nodi ya mzizi
.
Nodi hugawanywa katika makundi mawili makuu:
- Classes: makundi mapana kama animal, fruit, tool,
- Entities: vitu maalum kama dog, apple, hammer.
Kwa mfano, ikiwa nodi ya “dog” iko chini ya nodi ya “mammal”, na “mammal” iko chini ya “animal”, mfumo hujua kiotomatiki uhusiano wa kitaksonomia kati ya dog na animal.
Proto-Truth Inahesabiwaje?
Proto-truth huamuliwa kulingana na uhusiano wa kihierarkia wa dhana mbili katika mti wa ontolojia: ikiwa dhana ya kwanza ni nodi ndogo ya dhana ya pili huainishwa kuwa True; ikiwa uhusiano uko kinyume huainishwa kuwa Contingent; na ikiwa hakuna uhusiano wa moja kwa moja wa ukoo huainishwa kuwa False.
Hali tatu za proto-truth
| Hali | Uhusiano | Mfano |
|---|---|---|
| True | \(e_1\) ni nodi ndogo ya \(e_2\) | A dog is an animal |
| Contingent | Uhusiano uko kinyume | An animal is a dog |
| False | Hakuna uhusiano wa moja kwa moja wa ukoo | A dog is a fruit |
Matumizi ya quantifier
Mfumo hutumia quantifier tatu wakati wa kuzalisha sentensi:
- All
- Some
- No
Thamani ya proto-truth kisha hutathminiwa pamoja na quantifier ili kuunda thamani ya mwisho ya True/False ya sentensi.
Kwa mfano, jozi ya proto-false ya dog–fruit inapounganishwa na “No” inaweza kuunda kauli sahihi ya “No dogs are fruits”.
Kwa nini baadhi ya sentensi zilizo sahihi kimantiki zinakatazwa?
Utafiti unakataza hasa mchanganyiko wa “Some + Proto-True”.
Kwa mfano:
Some dogs are animals.
Ni sahihi kimantiki; hata hivyo, kipragmatiki inaweza kutoa taswira kwamba baadhi ya mbwa si wanyama.
Ili athari kama hizi za Gricean implicature zisilete mkanganyiko usio wa lazima kwa msomaji, mchanganyiko huo huondolewa kabisa.
Mchanganyiko halali pia hupewa uzito kwa namna inayoweka uwezekano wa sentensi za True na False katika 0,5 hasa.
Kwa nini Mfumo Huzalisha Sentensi za True na False kwa %50–%50?
Mgawanyo uliosawazishwa wa True/False hutumiwa kuzuia mkakati wa majibu wa mshiriki kuelemea upande wa kundi moja na kuweka muundo wa maamuzi wa kazi ya kusoma katika usawa; katika chanzo, mchanganyiko halali wa sentensi hupewa uzito ili kuweka mgawanyo huu katika uwezekano wa 0,5 hasa.
Uchujaji wa kisaikolojia-lugha kwa Glasgow Norms
Hazina ya maneno ya Kiingereza huchujwa kupitia seti ya data ya Glasgow Norms yenye maneno 5.554.
Vipimo vitatu vikuu hutumiwa:
| Kigezo | Maana | Kizingiti sanifu |
|---|---|---|
| Familiarity (FAM) | Kiwango ambacho neno linamfahamu msomaji | ≥ 4,5 / 7 |
| Concreteness (CNC) | Kiwango cha udhahiri wa dhana | ≥ 4,5 |
| Valence (VAL) | Mwelekeo chanya/hasi wa kihisia | ≥ 4,0 |
Kwa nini familiarity inadhibitiwa?
Ufahamivu hutumiwa kupunguza athari ya mchakato wa kukumbuka maneno adimu katika kasi ya kusoma.
Maneno yenye thamani kubwa ya familiarity kwa kawaida hukutwa mara nyingi zaidi na huchakatwa kwa kasi zaidi.
Kwa nini concreteness ni muhimu?
Kulingana na mkabala wa Dual Coding Theory wa Paivio, dhana dhahiri zinaweza kuamsha mifumo ya maneno na ya picha.
Kwa hiyo, maneno dhahiri kwa kawaida yanaweza kuchakatwa kwa kasi zaidi kuliko maneno ya kufikirika.
Kwa nini valence huchujwa?
Maudhui hasi yanaweza kuvuta umakini kwa nguvu zaidi na kubadilisha muda wa uchakataji.
Katika kipimo sanifu, maneno yasiyoegemea upande wowote au chanya hupendelewa ili kupunguza athari hii ya kihisia.
Uchujaji wa Kisaikolojia-Lugha wa Band-Pass ni Nini?
Uchujaji wa band-pass ni kutenga masafa maalum ya ugumu wa kisaikolojia-lugha kwa kuweka mipaka ya chini na juu badala ya kuweka tu kizingiti cha chini cha familiarity, concreteness au valence; hivyo inaweza kuzuiwa hali ambapo maneno rahisi hutawala mgawanyo wote, na viwango vya ugumu vinavyodhibitiwa vinaweza kuundwa.
Viwango vitatu sanifu vya ugumu
| Kiwango | Familiarity | Concreteness | Valence |
|---|---|---|---|
| Easy | \([5.5,\infty)\) | \([5.5,\infty)\) | Sanifu |
| Medium | \([4.5,\infty)\) | \([4.5,\infty)\) | Sanifu |
| Hard | \([3.0,4.5]\) | \([3.0,4.5]\) | \([2.0,4.0]\) |
Mpangilio wa Medium unalingana na vigezo vya awali vya Perrin na wenzake.
Hali ya Hard inalenga kuunda mzigo wa utambuzi kwa kuchagua mahsusi maneno yasiyofahamika sana, ya kufikirika zaidi na yenye valence ya chini zaidi.
Kuondoa homonimu
Maneno kama “Bank” au “arm” yenye maana zaidi ya moja iliyo wazi huondolewa katika hazina hai ya maneno kwa sababu yanaweza kuleta utata wa kisemantiki.
Katika Glasgow Norms, vipengele vilivyo na utenganishaji wa maana kwa mabano huondolewa kiotomatiki.
Mabadiliko ya kimuundo yaliyofanywa kwa Kiingereza
Ontolojia ya sasa hutumia 97 entity na 23 class.
Wakati wa kubadilisha kwa Kiingereza, ilibidi kutatuliwa baadhi ya matatizo muhimu ya kimofolojia.
Kuondoa nomino zisizohesabika
Kwa kuwa violezo vya sentensi hutumia nomino za wingi, maneno yenye sifa ya mass noun yalileta matatizo.
Chanzo huondoa mifano ifuatayo kutoka hazina hai:
- beef,
- pork,
- bacon,
- ham,
- rice,
- wheat,
- oats,
- milk,
- butter,
- honey,
- corn.
Pia “scissors” imeondolewa kwa sababu ni nomino ya plurale tantum isiyo na umbo la umoja.
Kubadilisha majina ya madarasa
Darasa la “Clothing” limebadilishwa kuwa garment, na darasa la “furniture” kuwa furnishing.
Lengo ni kuzalisha misemo ya kisarufi iliyo ya kawaida katika violezo vya sentensi za wingi.
Wingi usiofuata kanuni
Kisanduku cha zana hutumia irregular plural lookup table yenye vipengele 38.
Muundo huu:
- aircraft,
- watercraft,
- bus → buses
hushughulikia kwa usalama maumbo ambayo kanuni za kawaida za regex zinaweza kuyasababishia matatizo.
Kwa nini Utata wa Matawi ya Animal–Food Huchujwa Mahususi?
Kwa sababu animal na food ziko katika matawi tofauti ya mti wa ontolojia, mfumo unaweza, kwa mfano, kuainisha jozi ya chicken–food kuwa False; hata hivyo, katika ulimwengu halisi kuku pia ni chakula. Kwa hiyo kisanduku cha zana huondoa jozi za mnyama–chakula ambazo zinaweza kuwa si sahihi kiontolojia lakini sahihi katika ulimwengu halisi kwa kutumia kichujio maalum cha matawi tofauti.
Tatizo la cross-branch ambiguity
Wakati muundo wa kiontolojia unatenganisha makundi, dhana za ulimwengu halisi wakati mwingine zinaweza kuwa na kazi zaidi ya moja.
Kwa mfano, “animal” na “food” ni matawi tofauti; hata hivyo, baadhi ya wanyama wanaweza kuliwa kama chakula.
Katika hali hii:
Some frogs are foods.
au
A chicken is not a food.
sentensi kama hizi, ingawa hupata thamani kulingana na mantiki ya ontolojia, huwa zenye mjadala kwa mtazamo wa ulimwengu halisi.
Kichujio cha isAmbiguousCrossBranch huondoa jozi hizi kiotomatiki na kuhakikisha kwamba sentensi za False zinategemea utengano halisi wa kisemantiki.
Udhibiti wa umbali wa kisemantiki
Kisanduku cha zana hakizalishi sentensi tu; kinaweza pia kudhibiti umbali wa kisemantiki kwa kutumia idadi ya kingo kati ya nodi katika mti wa ontolojia.
Kipengele hiki kinaweza kutumiwa kuunda ugumu wa utambuzi.
Muathiriano wa kisemantiki
Sentensi za False zinaweza kuzalishwa kutoka makundi dada yaliyo karibu lakini tofauti:
A dog is a cat.
Kwa sababu dog na cat ziko chini ya kundi moja la juu, uthibitishaji unaweza kuleta muathiriano mkubwa zaidi wa kisemantiki kuliko jozi zilizo mbali kama dog–fruit.
Usahihi wa kitaksonomia
Umbali unaweza pia kubadilishwa katika sentensi za True.
A dog is an animal.
hutumia maarifa mapana zaidi ya kundi, ilhali:
A dog is a mammal.
inahitaji maarifa mahususi zaidi ya kitaksonomia.
Je, Kisanduku Hiki cha Zana Kinaweza Kupima Tu Kasi ya Juu ya Kusoma?
Hapana. Kutokana na uchujaji wa band-pass na udhibiti wa umbali wa kisemantiki, mfumo unaweza pia kuunda sentensi za majaribio za “stress test” zinazotia changamoto michakato maalum ya utambuzi kama uchakataji wa maneno adimu, uchakataji wa lugha ya kufikirika, muathiriano wa kihisia na mgongano wa kisemantiki.
Matumizi yaliyopanuliwa ya majaribio
Chanzo kinatoa mifano mitatu:
- Kwa kupunguza Familiarity, mzigo wa lexical retrieval unaweza kuongezwa kwa kutumia maneno adimu.
- Kwa kupunguza Concreteness, uchakataji wa maneno unaweza kupimwa kwa kutumia maneno ya kufikirika.
- Kwa kuchuja Valence kinyume, affective interference inaweza kuchunguzwa kwa kutumia maneno hasi.
Mbinu na Matokeo ya Utafiti
Muundo wa kimetodolojia
Utafiti huu ni zaidi makala ya ukuzaji wa programu na mbinu kuliko jaribio jipya la kliniki.
Vipengele vikuu ni:
- Kuunda ontolojia ya kisemantiki,
- kuhesabu proto-truth,
- True/False mapping inayotegemea quantifier,
- uchujaji wa Glasgow Norms,
- mofolojia ya Kiingereza na kanuni za wingi,
- cross-branch ambiguity filtering,
- band-pass difficulty control,
- semantic distance manipulation.
Uthibitishaji wa mbinu asili
Chanzo kinaeleza uthibitishaji uliofanywa na Perrin na wenzake mwaka 2014 katika korpasi ya Kifaransa.
Utafiti wa awali:
- ulitumia washiriki \(N=41\),
- kati ya kazi ya kusoma kimya ya True/False na oral MNREAD ya jadi
- uliripoti uwiano mkubwa wa \(r=0.836\), \(p<0.001\)
.
Pia inaelezwa kwamba mbinu ya uthibitishaji wa True/False ilitoa matokeo yaliyo sawa kitakwimu na kusoma kwa oral.
Je, Toleo la Kiingereza la MATLAB Limethibitishwa Kisaikometria?
Bado. Ingawa mbinu asili ya Perrin ya Kifaransa ilithibitishwa hapo awali, utekelezaji wa Kiingereza wa MATLAB unaowasilishwa katika makala hii bado haujakamilisha uthibitishaji rasmi wa kisaikometria dhidi ya vipimo vya Kiingereza vilivyoimarika kama English MNREAD au IReST.
Kwa nini tofauti hii ni muhimu?
Mafanikio ya mbinu ya Kifaransa hayathibitishi kwamba uhamishaji kwenda Kiingereza una sifa zilezile za kisaikometria kiotomatiki.
Kati ya lugha:
- marudio ya maneno,
- mofolojia,
- kanuni za kisaikolojia-lugha,
- tabia ya kusoma
zinaweza kutofautiana.
Kwa hiyo, waandishi wanawasilisha kisanduku cha zana kama programu huria iliyokamilika huku wakitarajia jumuiya ya kisayansi kufanya uthibitishaji rasmi wa Kiingereza.
Hitimisho linaloungwa mkono na utafiti
- Uzalishaji wa kiotomatiki wa sentensi za True/False unaweza kufanywa kwa kutumia ontolojia ya kisemantiki.
- Marekebisho maalum yanahitajika kwa mofolojia na madarasa ya maneno ya Kiingereza.
- Uchujaji wa band-pass unaweza kuunda masafa ya ugumu wa kisaikolojia-lugha yanayodhibitiwa.
- Cross-branch ambiguity filtering inaweza kupunguza migongano kati ya maarifa ya ulimwengu halisi na ontolojia.
- Umbali wa kisemantiki unaweza kutumiwa kudhibiti ugumu wa utambuzi.
- Kisanduku cha zana kinalenga kutoa utofauti usio na kikomo kwa vitendo katika majaribio yanayorudiwa.
Hitimisho lisiloungwa mkono na utafiti
- Bado haijaonyeshwa kwamba kisanduku cha zana cha Kiingereza ni kiwango cha dhahabu cha kliniki.
- Uthibitishaji rasmi dhidi ya English MNREAD au IReST haujakamilika.
- Matokeo ya uthibitishaji wa Kifaransa ya N=41 si matokeo ya moja kwa moja ya utekelezaji wa Kiingereza.
- Haijaonyeshwa kwamba hali ya Hard hutenganisha kwa uchunguzi tatizo fulani la kliniki.
- Haidaiwi kwamba vichujio vya band-pass ni viwango vya kizingiti vya kliniki.
Faida Kubwa Zaidi ya Kisayansi ya Kisanduku Hiki cha Zana ni Nini?
Faida kubwa zaidi ni uwezo wa kudhibiti kiparameta ugumu wa maneno, umbali wa kisemantiki na sifa za kihisia huku kikizalisha sentensi nyingi za kipekee zilizodhibitiwa kisemantiki na ambazo thamani yake ya kweli/siyo kweli inajulikana kiotomatiki; hivyo kinaweza kupunguza athari ya kukariri katika majaribio yanayorudiwa na pia kuunda hali tofauti za mzigo wa utambuzi.
Mipaka ya kimetodolojia
Kizuizi cha kwanza ni kwamba utekelezaji wa Kiingereza bado hauna uthibitishaji rasmi wa kisaikometria.
Pili, ontolojia ya sasa ina 97 entity na 23 class pekee; kwa hiyo, ingawa utofauti “usio na kikomo” ni mpana kwa maana ya mchanganyiko, ulimwengu wa dhana si usio na mipaka kabisa.
Tatu, kiwango ambacho semantic distance ina uhusiano wa mstari na ugumu wa utambuzi hakijapimwa kwa njia ya majaribio katika utafiti huu.
Nne, haijathibitishwa kwamba mchanganyiko wa valence ya chini na concreteness ya chini ndani ya Hard preset huunda mzigo uleule wa utambuzi katika makundi tofauti ya washiriki.
Maelezo ya Chanzo na Mbinu
Kichwa asili:A MATLAB Toolbox for Standardized Reading Speed Assessment: Implementing and Extending the Perrin Sentence Generator for English Corpora
Waandishi: Daniel P. Spiegel, Romain Bachy.
Taasisi: Meta Reality Labs, 9805 Willows Rd, Redmond, WA 98052, USA.
arXiv: 2606.06297v1 [cs.HC].
Tarehe: 4 Juni 2026.
Aina ya chanzo: Programu huria ya MATLAB na makala ya ukuzaji wa mbinu.
Chanzo kikuu cha data: Glasgow Norms, maneno 5.554; CC BY 4.0.
Mbinu kuu: Ontolojia ya kisemantiki yenye mzizi, uainishaji wa proto-truth, truth mapping inayotegemea quantifier, psycholinguistic band-pass filtering, ukaguzi wa usalama wa kimofolojia wa Kiingereza na semantic-distance manipulation.
Hali ya uthibitishaji: Mkabala asili wa Kifaransa wa Perrin na wenzake ulithibitishwa kwa N=41 na uliripoti uwiano wa \(r=0.836,\ p<0.001\) kati ya kazi ya kimya ya True/False na oral MNREAD. Utekelezaji wa Kiingereza wa MATLAB katika makala hii bado unasubiri uthibitishaji rasmi wa kisaikometria dhidi ya English MNREAD au IReST.
Maelezo ya leseni: Glasgow Norms inayotumiwa katika kisanduku cha zana ni seti ya data ya mtu wa tatu inayotolewa chini ya leseni ya CC BY 4.0; leseni asili na taarifa za hakimiliki lazima zihifadhiwe wakati wa kusambaza upya.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *